eval 告诉你,你的应用或 skill 在具体任务上表现如何。但设计 eval 很难,在 eval 上提分而不自欺欺人也很难。我们在 claude-api skill 里加了这两方面的指引。
装上这个 skill 后,可以运行 /claude-api build-eval 在自己的代码库里搭一套 eval,再运行 /claude-api hillclimb 针对它逐步改进应用。每次只改一处,并用一组留出的样例来发现过拟合。
本文先讲好的 eval 设计和 hillclimb 的原则,再讲 Claude Code 配合 claude-api skill 如何落实这些原则,最后给几个使用这两个命令的例子。
eval 设计
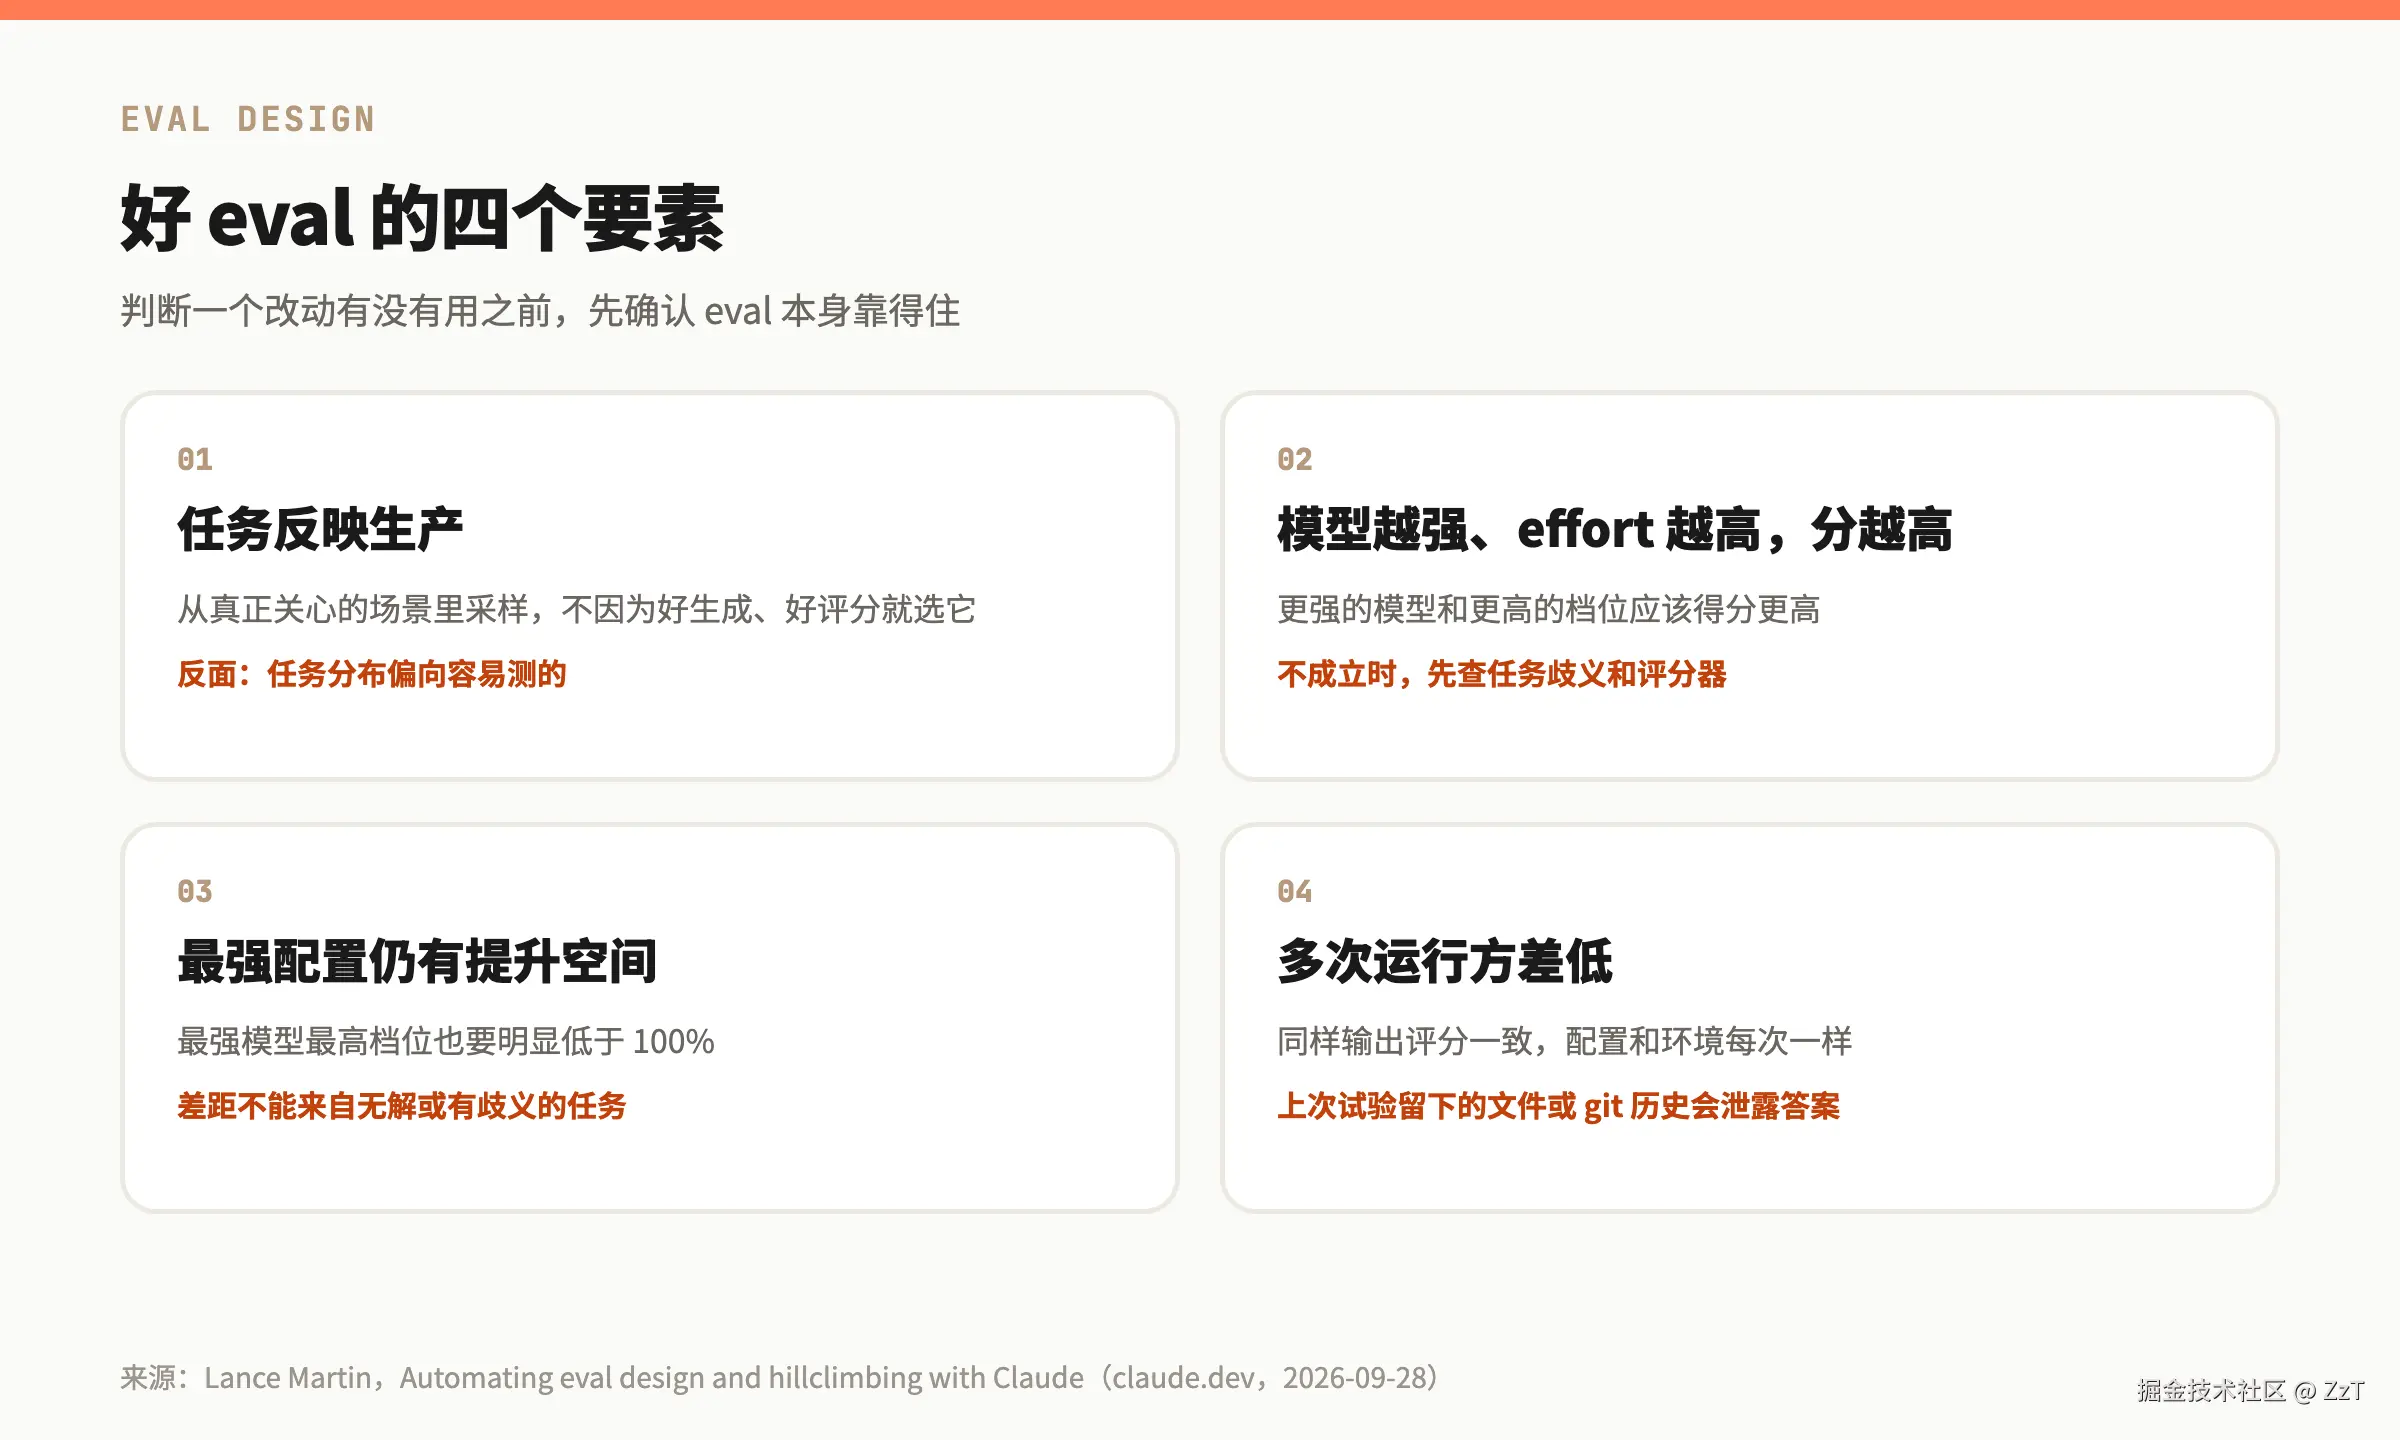
设计良好的 eval 有几个共同点:
- eval 任务要反映生产环境。从你关心的「生产」场景里采样任务,也就是被测能力或应用实际使用的场景。有时人们挑任务,是因为它容易生成或容易评分。但要确保任务分布代表你真正关心的东西。
- 模型越强、思考越多,分数应该越高。能力更强的模型、更高的 effort 档位,通常应该在 eval 上表现更好。如果没有,往往是任务有歧义,或者评分器没校准,拖累了表现。
- 最强的配置上仍有「合理的」提升空间。最强的模型在最高 effort 下,分数也应该明显低于 100%,否则你无法可靠判断某个改动对表现的影响。重要的是,这个差距不能来自不可能完成或有歧义的任务。一个常见信号是某个任务无论重复多少次都失败。好任务的标准是,两位领域专家会得出同样的判断,评分器检查的每一点都在任务里写明了。
- 多次运行之间方差低。方差高通常是因为任务设计得差、有歧义,或者评分器对同样的输出给出不同判定。方差也可能藏在配置里,比如 effort 没有被一致地应用。环境也会影响结果,上一次试验留下的状态(一个文件、一段 git 历史)可能直接把答案交给 agent。
对抗采样
模型能力是参差不齐的。如果你挑用例的标准是今天的模型会失败,那你采样到的只是这个模型能力曲面上的低谷。最后 eval 测到的可能只是这个模型的失败特征,而不是对你的应用来说真正困难或有价值的东西。
要选难的用例,理由应该是人判断它难。一个有用的检验是,在纳入一个任务之前,你能说出它为什么难。可以纳入你的应用在生产中出现过的具体失败,来源包括生产流量、bug 报告和工单。但不要盲目相信用户流量。用户有时只尝试他们预期能成功的事,所以完全从用户流量里抽出的任务分布可能偏简单。
/claude-api build-eval
claude-api skill 里的 build-eval 命令把这些原则做成了一个引导式流程。在 Claude Code 里运行 /claude-api build-eval,Claude 会先问你一轮问题,然后在你的代码库里搭好 eval,并在几个节点停下来等你确认。
设计样例
Claude 按下面的顺序帮你采样输入:
- 生产环境的对话记录,会先询问数据保留和敏感数据的情况。
- bug 报告和客服工单。
- 你手写的 5 到 10 个用例。
- 从代码库合成的用例。
skill 优先使用生产流量,也可以基于你给的几个真实样例生成合成数据。skill 会让 Claude 生成一个简单页面,列出每条输入,等你确认。下面以一个邮件路由应用为例,展示 skill 可能请用户审阅的一组输入。
校验评分器
确定输入之后,Claude 会根据应用的输出形态,提出成本最低的评分方式:
- 程序化校验。如果输出的可能性有限,就用代码检查,比如完全匹配、固定集合里的标签、符合 schema 的 JSON、测试是否通过。
- LLM 评审。如果输出是开放的,有很多正确答案但质量标准清楚,默认用这种方式。第二个模型读取输入、输出和一份写成可检查陈述的评分标准(不用 1 到 5 分的量表),返回分数和理由。如果有基线可以对比,评审模型会以随机顺序读两份输出,不告诉它哪份是基线,让它选更好的那份。评审模型由你挑,而且不应该是被测的那个模型。
Claude 会先给一小批用例打分,问你是否会给出不同的分数。一般来说,在相信评分器之前,读一批打过分的对话记录很重要。评分出错是 eval 配置错误最常见的原因之一。
评分器校验通过后,skill 会告诉你 eval 的规模(用例数 × 重复次数 × 模型数,以及大概要跑多久),跑一遍基线,打印出分数和置信区间。你拿到的东西包括:用例、评分器、运行脚本、每个用例一行 JSON 和一份完整对话记录,以及一个列出每个用例分数、并链接到对应对话记录的简单页面。如果想看这个页面之外的东西,比如图表,直接说,Claude 会在旁边另建一个页面。这些额外页面默认是本地打开的静态文件,不从网络加载任何内容。
诊断检查
在上面的基线运行中,Claude 会检查几件事:
- 评分器:对同一份输出跑两次评分器,报告判定是否变了。
- 管线:检查超时、API 错误和被截断的回答,防止基础设施噪声被当成模型的方差。
- 提升空间:如果基线已经在 95% 左右或更高,skill 会提醒用户,建议 hillclimb 转向优化成本或延迟,而不是质量。
hillclimb
有了可靠的评分手段,就可以尝试改进了。hillclimb 适合调节 effort、prompt 这类在成本和表现之间做权衡的参数。选择在哪里做 hillclimb,有几点通用建议:
- 迭代便宜。你要改的那一层,修改起来在时间、费用和工作量上都应该便宜。很多内部项目和客户把 hillclimb 用在文本上,比如 prompt 和 skill,这些容易改也容易回退。相比之下,在 hillclimb 中对 agent harness 做开放式修改,可能涉及大量代码改动。
- 可归因。eval 分数的变化应该能归因到你正在改的那一层。比如,几个成功的 hillclimb 案例都聚焦在 skill 的触发上,评估指标(skill 的触发率)和被修改的 skill 描述直接相关。
- 目标范围明确。一种常见的失败是笼统地要求「提升表现」,却没有仔细看 eval 还剩多少提升空间。接近饱和的 eval,或者范围不清的修改对象(比如笼统地要求改 harness),更容易停滞。在很多项目里都表现不错的一个目标是成本。即使 eval 已经饱和,你也可以让 Claude 在保持表现不变的前提下找办法降低成本。
过拟合
即使 eval 设计得好,也很少能和你在生产中关心的任务分布完全一致。所以「过拟合」到 eval 是常见问题,结果是系统在 eval 上的表现好于在生产流量上的表现。
eval 有很多方式「泄漏」进你的 harness,也就是模型之外的那部分代码,包括 prompt、工具和调用 Claude 的循环。比如,一个 eval 任务用 OCR 会有帮助,但 OCR 在你的生产任务里很少有用。hillclimb 可能会给应用加一个 OCR 工具,benchmark 分数提高了,生产却没有任何改善。更广泛地说,hillclimb 可能往 harness 里加一些功能,专门处理你选的那批 eval 样例里的边界情况。这些改动提高了 eval 分数,却不会转化成生产上的改进。
有三件事可以帮助应对:
- 拆分用例。一部分作为训练集,hillclimb 可以读;另一部分作为测试集,永远不让它看到。如果训练集分数上升而测试集持平,这是常见的过拟合信号。
- 不要把失败内容贴进 prompt。hillclimb 读了失败的对话记录,也绝不能把失败内容直接贴进 prompt。
- 从结构上让答案够不着。模型有时会「奖励作弊」,直接去找 eval 的答案。
claude-api skill 会替你落实这些原则,下面具体说。
/claude-api hillclimb
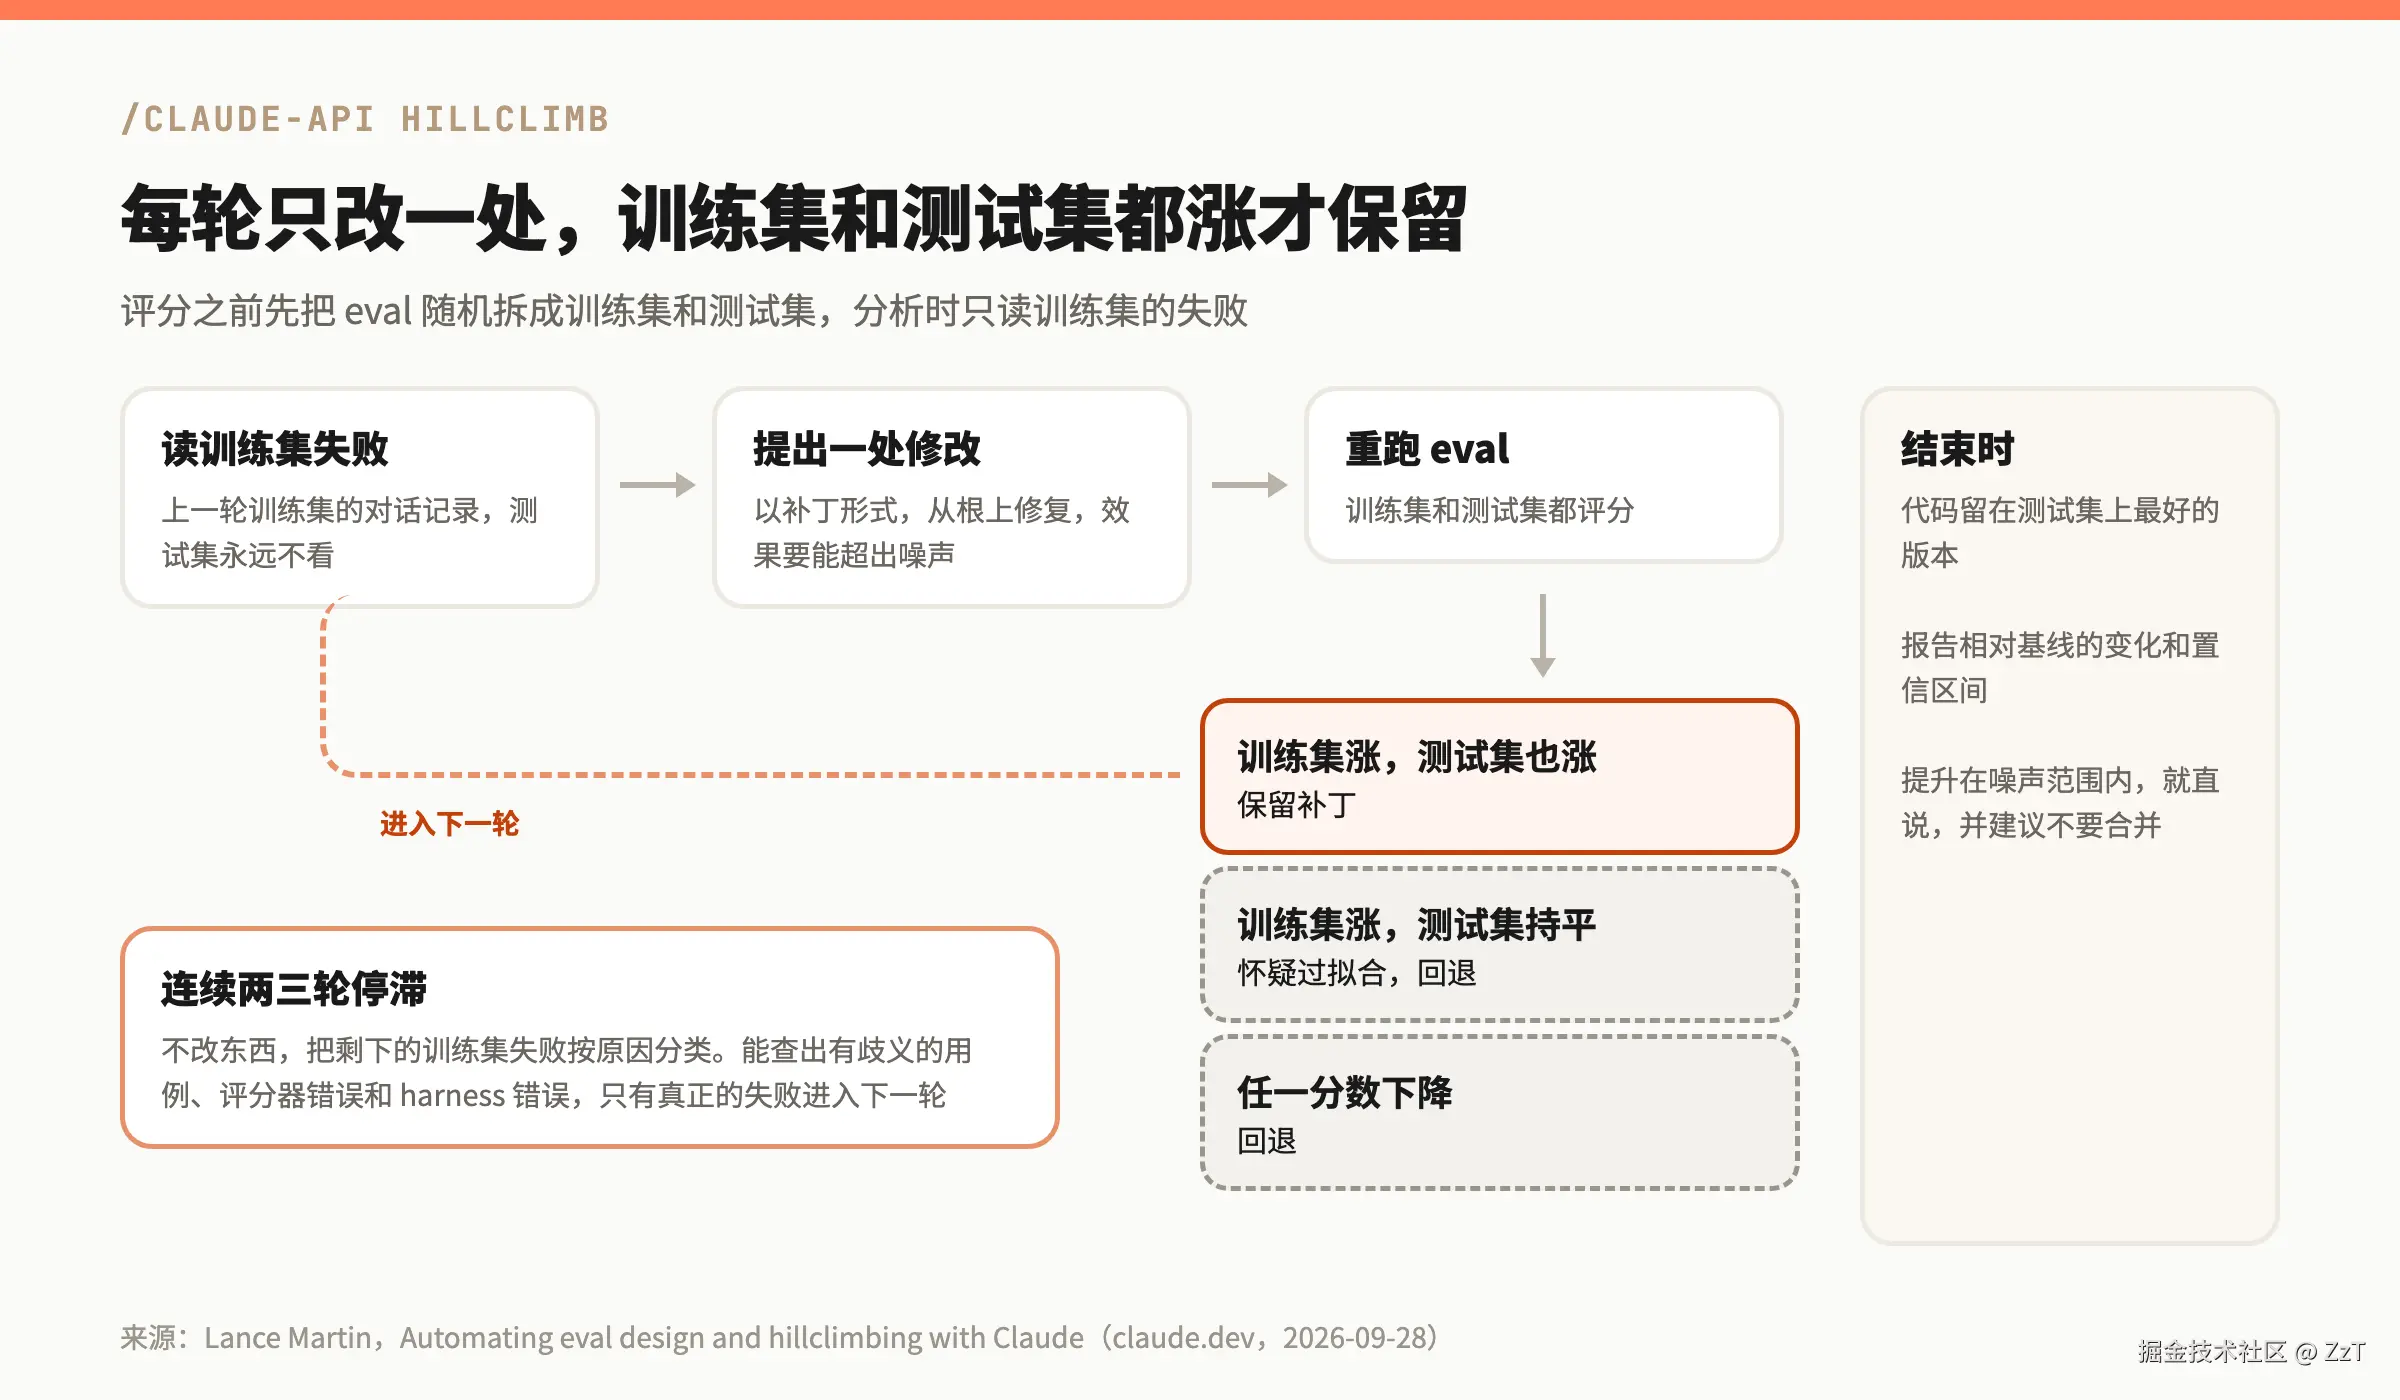
claude-api skill 里的 hillclimb 命令把这些原则做成了引导式流程。在 Claude Code 里运行 /claude-api hillclimb,Claude 会针对给定的 eval 反复迭代改进。你来决定它能改哪些东西,包括:
- 系统 prompt
- skill 或指令文件
- 工具描述
- 模型选择、effort 档位和其他 API 参数
- harness 代码
开始之前,Claude 会问你要优化什么,比如提升表现,或者在表现不降的前提下降低成本,然后把 eval 集随机拆成测试集和训练集。如果目标是成本,它会考虑几个常见的成本来源,包括 prompt caching、检查 prompt 是否适配所选模型,以及模型和 effort 的选择。
第一轮之前,Claude 会检查 eval 的噪声(分数单凭偶然能波动多少)是否小于你认为值得采纳的最小改进。如果不是,它会告诉你,并建议增加重复次数或用例。
每一轮,Claude 读上一轮训练集的对话记录,以补丁的形式提出一处修改。它会让每一轮的修改效果能超出 eval 的噪声,所以会从根上修复失败的行为,比如重写导致问题的那一段或补上缺失的规则,而不是改一行措辞。然后用打过补丁的版本跑 eval。这时 Claude 会做一次检查:训练集提升而测试集持平,就怀疑过拟合,回退补丁;出现退步,也回退;训练集和测试集都提升,才保留补丁。
如果分数连续两三轮停滞,Claude 会逐条读剩下的训练集失败,按原因分类。如果没有哪一处修复的收益能超过 eval 的噪声,它也会提前做这一步,并建议增加重复次数或用例,而不是把轮次花在小到测不出来的改动上。这一步能发现有歧义的 eval 用例、harness 错误或多次运行之间的方差。
只有真正的失败才会进入后续的 hillclimb 轮次。
hillclimb 结束时,Claude 会把你的代码留在针对你的目标、在测试集上表现最好的那个版本,并报告测试结果相对基线的变化和置信区间。如果提升在噪声范围内,它会直说,并建议不要合并。
例子
为降低成本做 hillclimb
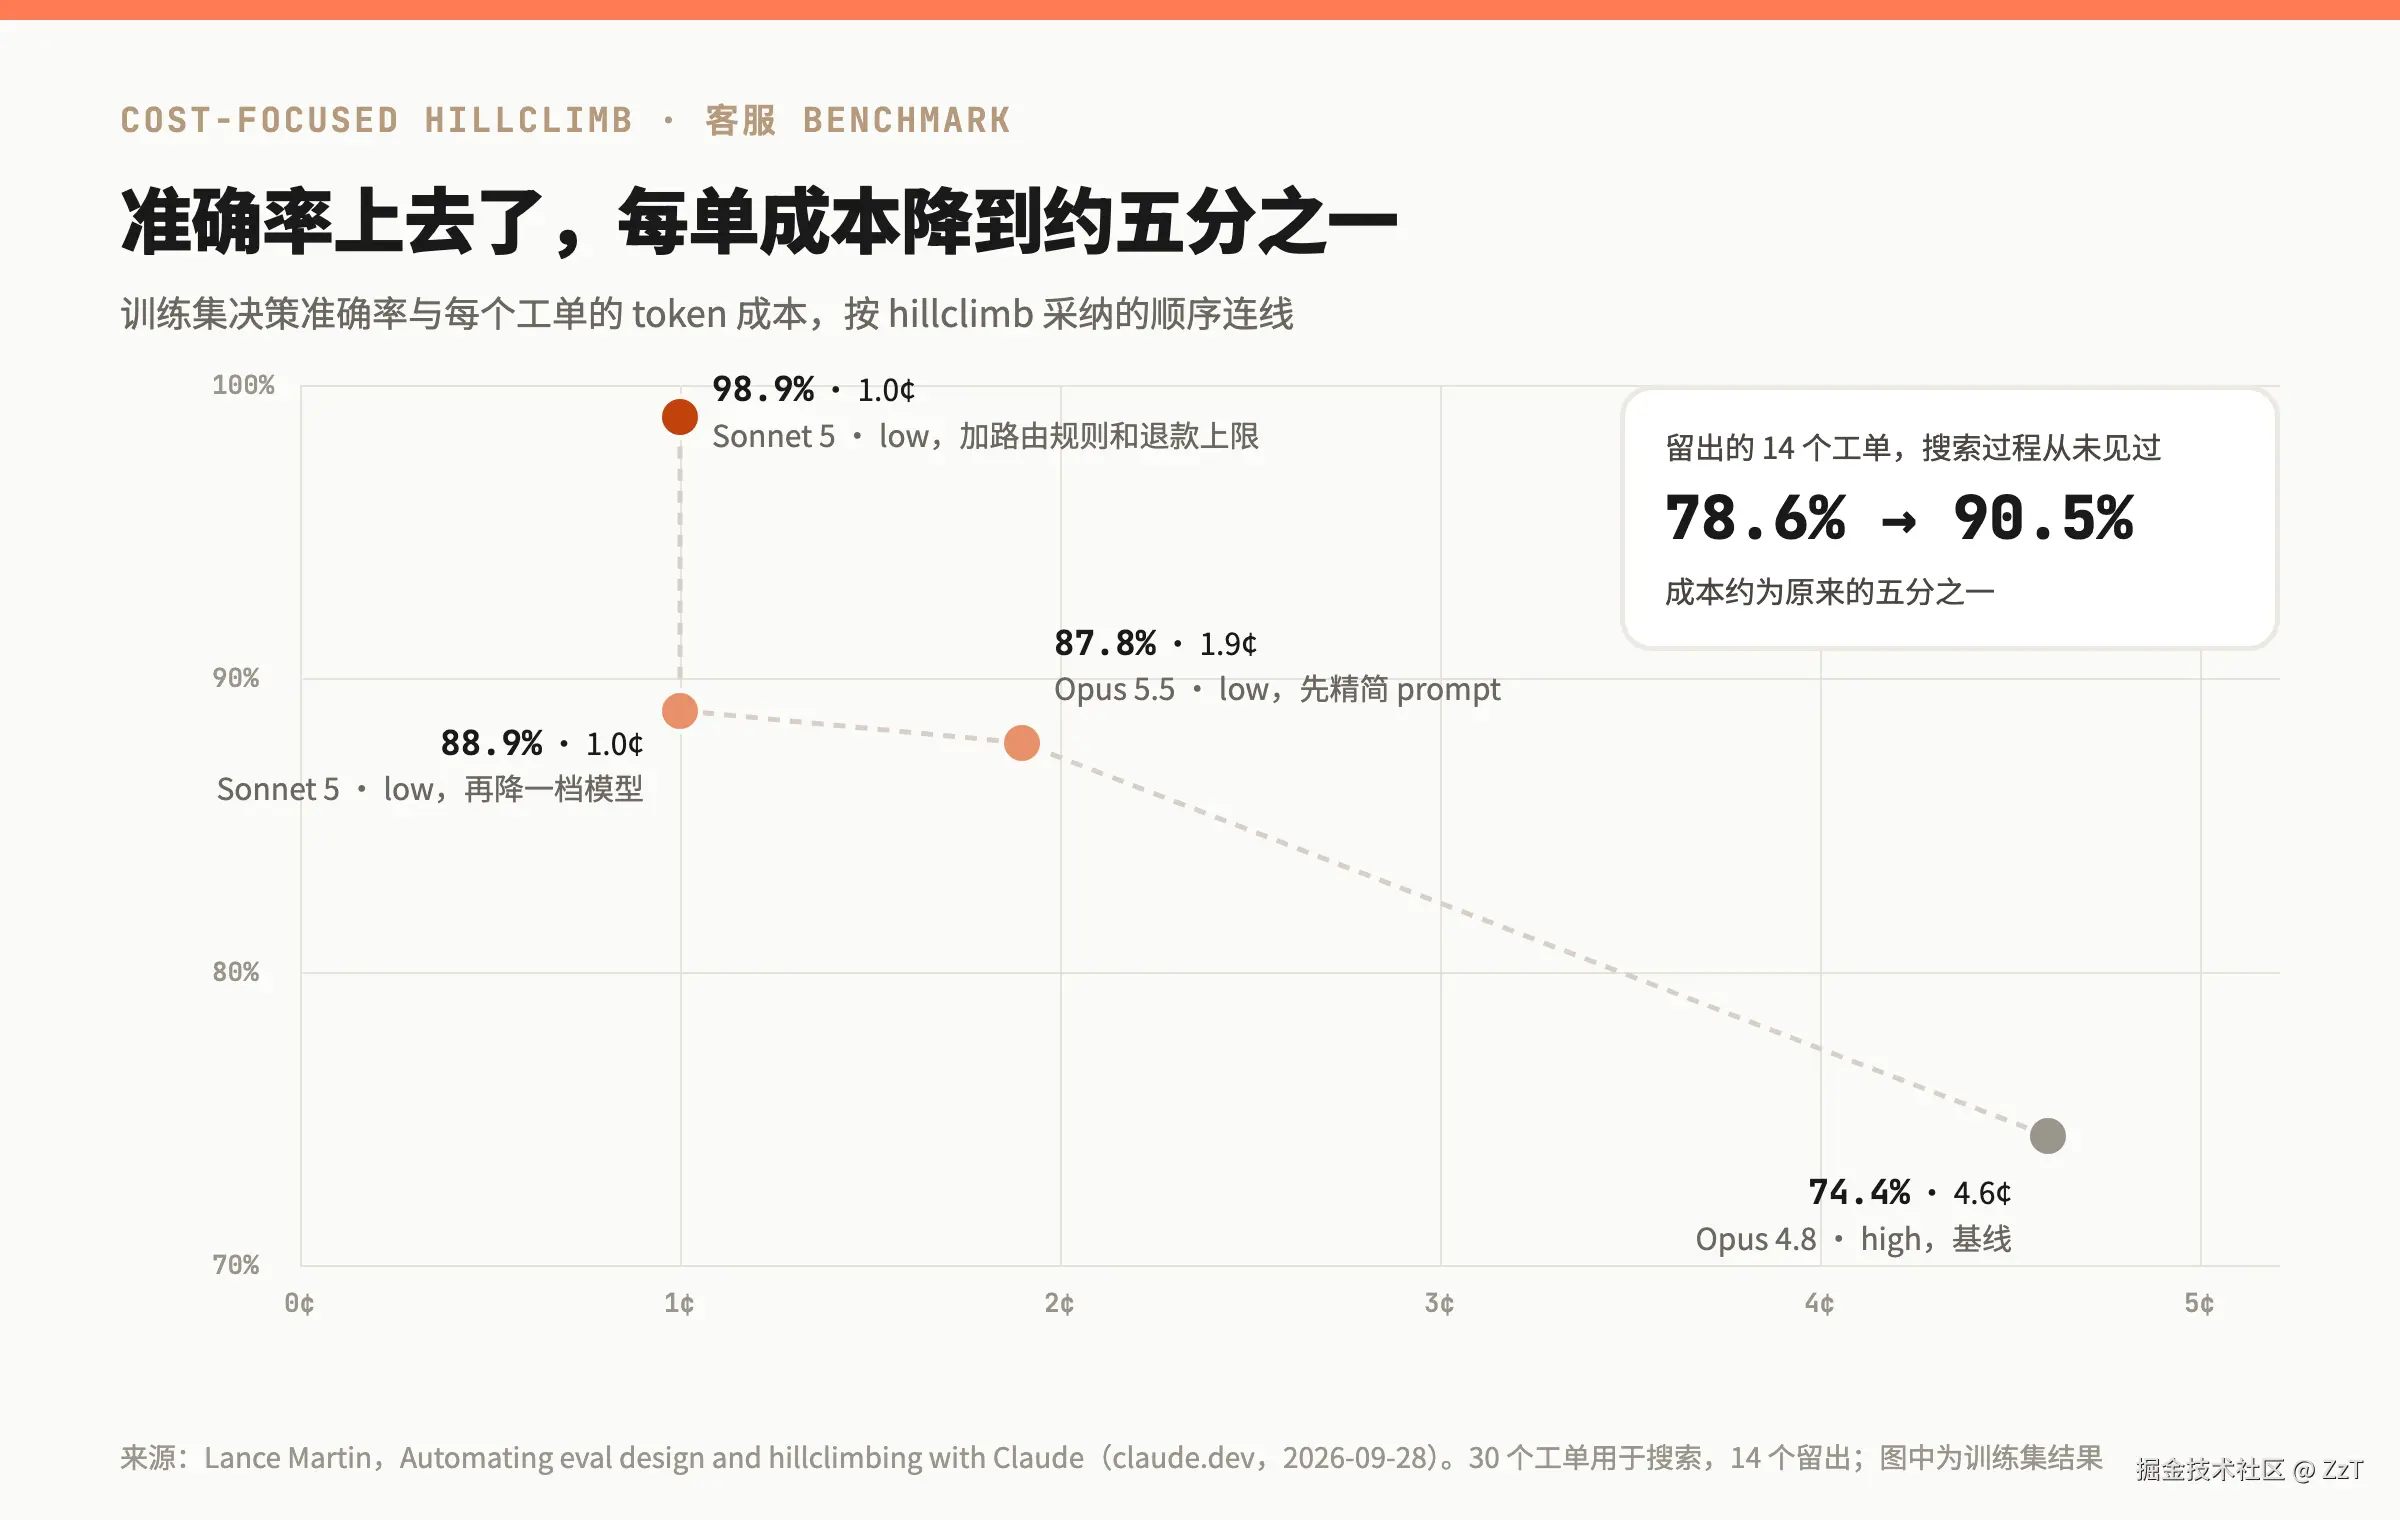
我们在一个内部客服 benchmark 上运行了 /claude-api hillclimb,目标是降低成本、提升表现。benchmark 共 44 个工单,30 个用于搜索,14 个留出。起点是 Opus 4.8 默认的 high effort,在搜索集上的决策准确率是 74.4%,每个工单的 token 成本是 4.6 美分。
hillclimb 先审查了 prompt,删掉了强制性的工具调用仪式、一个 scratchpad 步骤和互相矛盾的规则。然后试了 Opus 5.5 的 low effort。准确率达到 87.8%,超过了基线,成本降到每个工单 1.9 美分,不到起点的一半。
一部分节省来自 Opus 5.5 的定价,输入和输出 token 比 Opus 4.8 便宜 20%,缓存读取便宜 60%。既然 Opus 5.5 过了线,hillclimb 又降一档,看更便宜的模型能不能也过线。Sonnet 5 在 low effort 下的得分差不多,88.9%,成本约为一半,每个工单 1 美分。
最后,Claude 在 prompt 里加了路由规则和一条退款上限的交叉引用,让 Sonnet 5 在成本基本不变的情况下达到 98.9%。在搜索过程从未见过的 14 个留出工单上,最终配置得分 90.5%,原配置是 78.6%,成本约为原来的五分之一。
为提升表现做 hillclimb
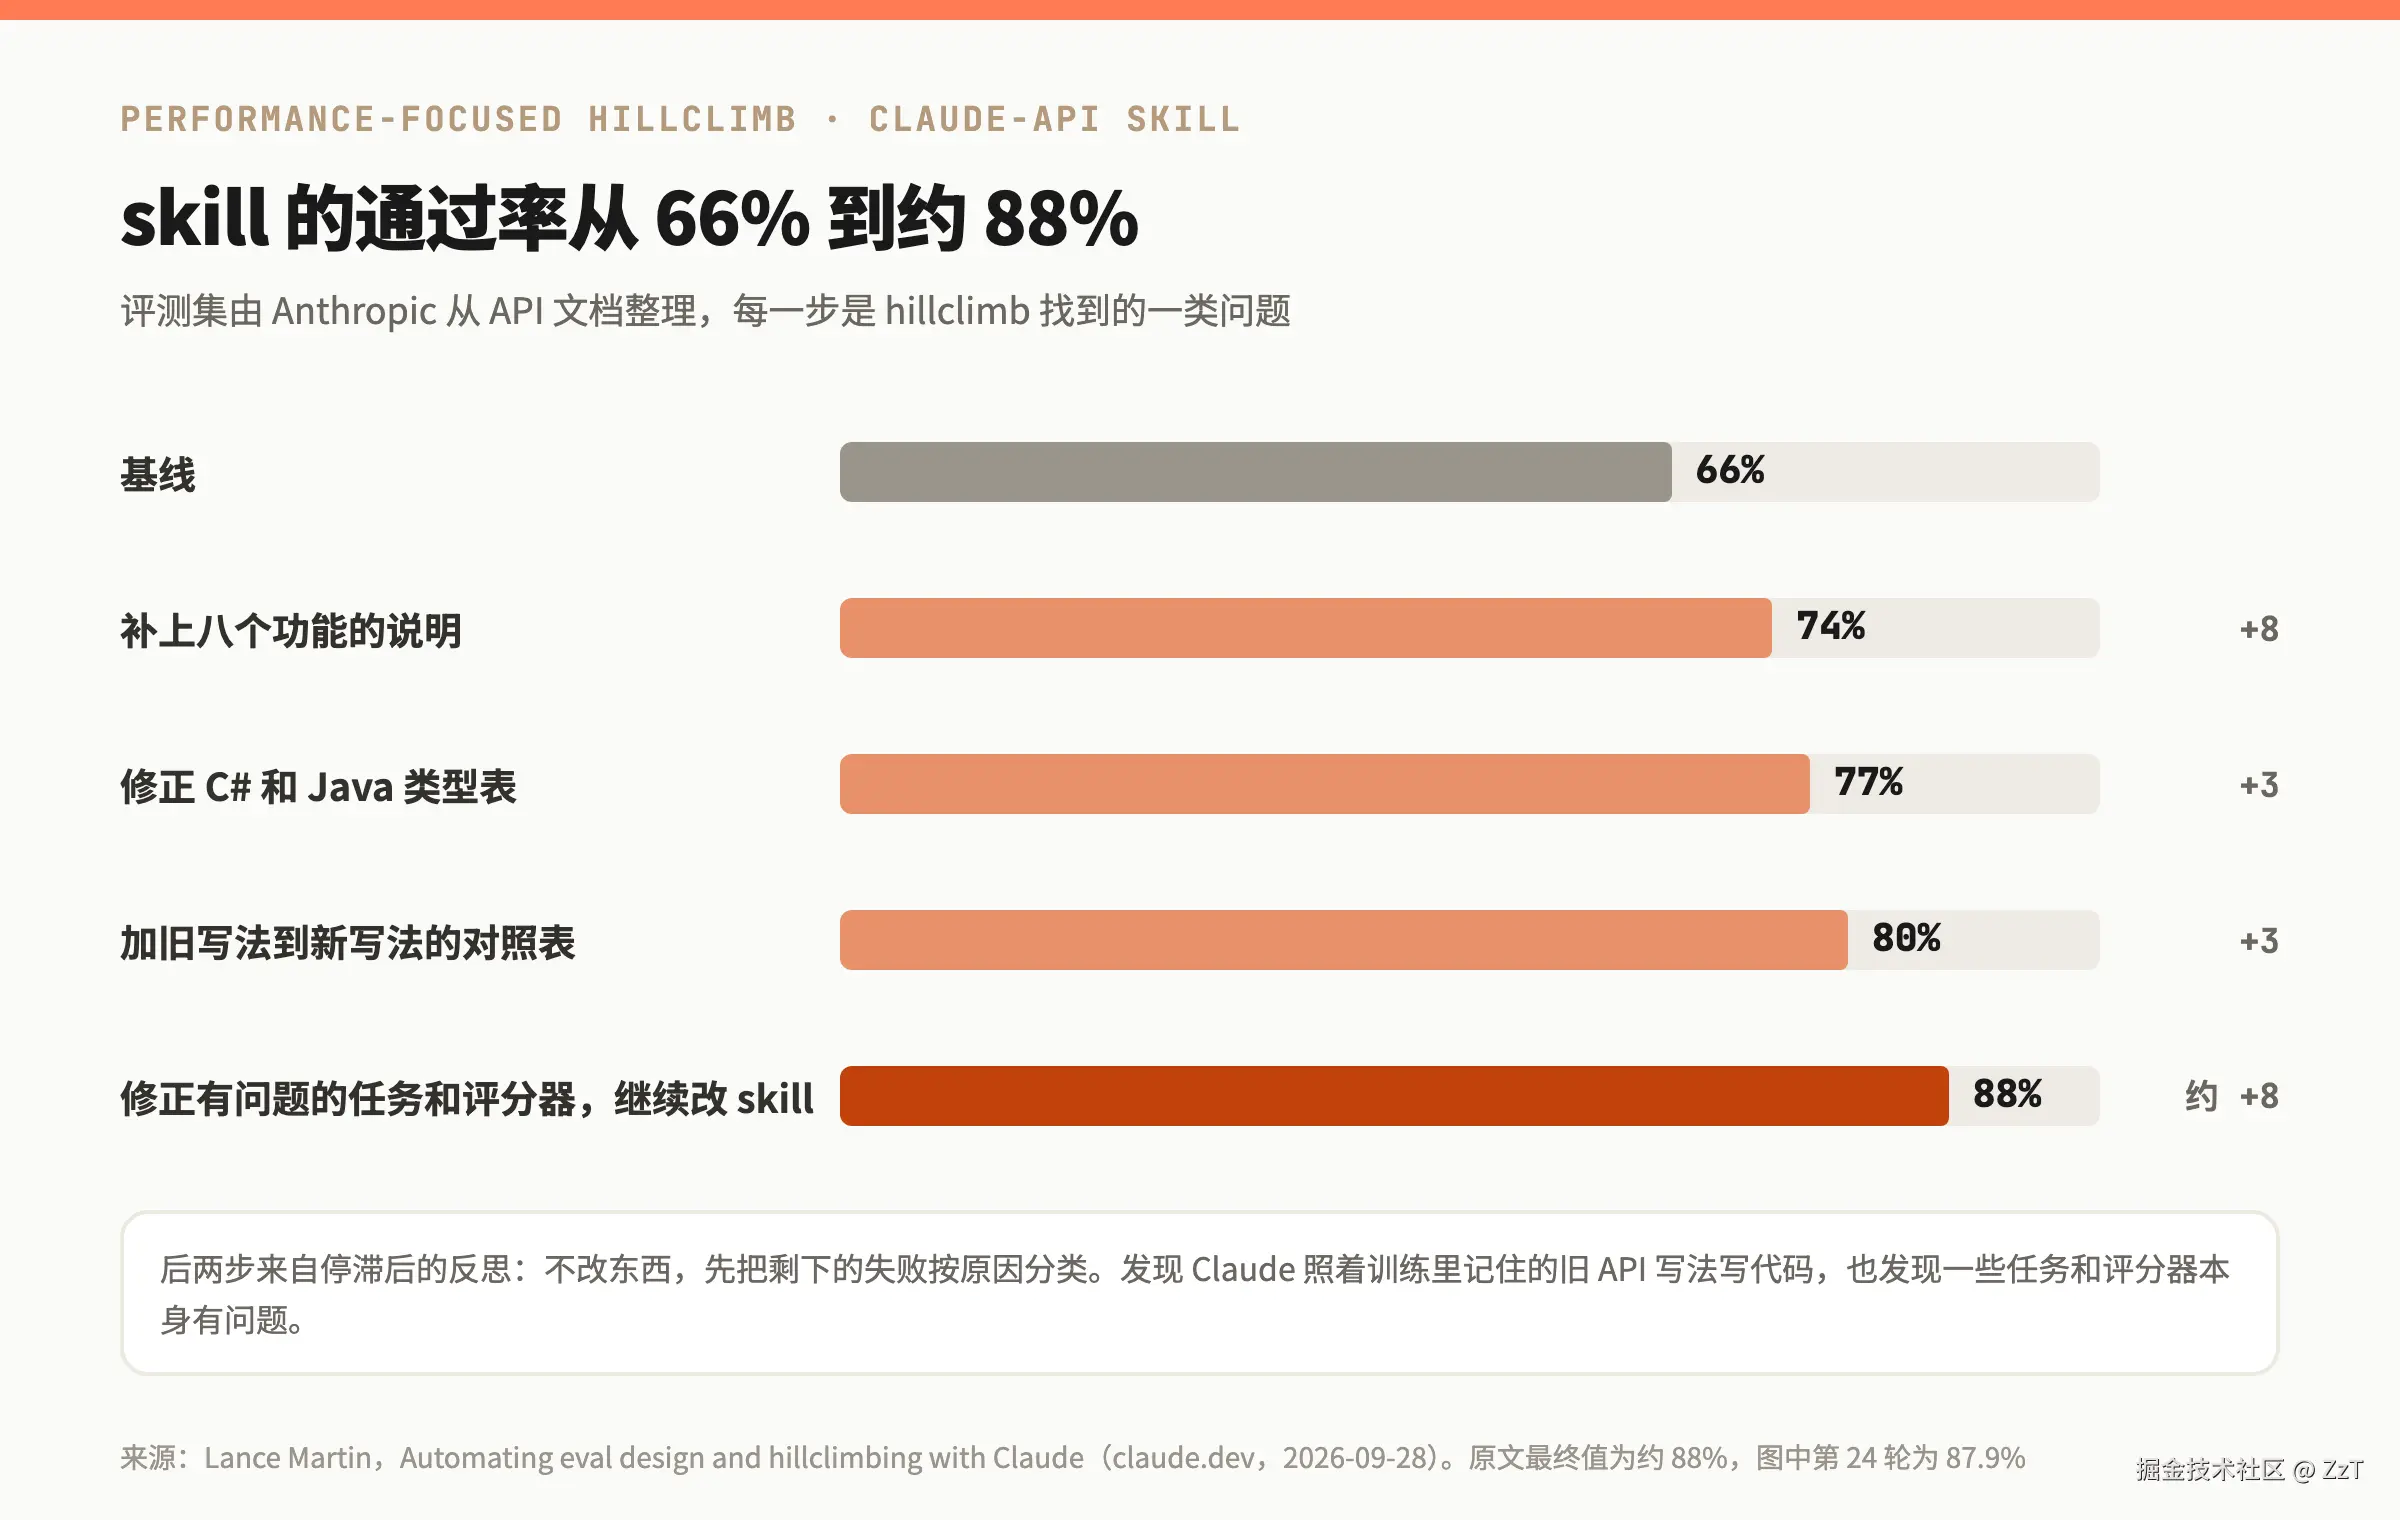
另一个例子是我们自己的 claude-api skill。它提供使用我们 API 的指引和与 Claude 协作的通用建议,也包括本文讲的这两个子命令。我们希望这个 skill 能正确写出调用我们 API 的代码,于是从文档中整理出一套 eval 来测试它。
在这套 eval 上,skill 起始分数是 66%。我们让 hillclimb 能访问文档和 SDK,Claude 可以自己发现错误并修正。Claude 发现 skill 缺了八个功能的说明。
补上这些章节后,分数提升到 74%。它接着发现 C# 和 Java 类型表里有错误,修正后提升到 77%。
分数连续两轮停滞后,Claude 分析了剩下的失败,按根本原因分类。正常的一轮会针对最常见的失败做一处修改,这一步不做修改,只把剩下的失败全部按原因归类。这个反思步骤在几个方面有用:
- 把一批失败放在一起看,hillclimb 发现 skill 里其实有相关内容,只是 Claude 照着训练中记住的旧 API 写法在写代码。为此,它在 skill 开头附近加了一张表,把 Claude 记忆里的旧写法对应到现在的写法。比如,把固定 token 预算的 extended thinking(最近的 Opus 模型上 API 已经不接受)换成 adaptive thinking,把旧版的 web search 和 web fetch 工具换成现在的版本。它还把 C# 和 Java 里关于不要用固定预算 thinking 的警告移到了 adaptive thinking 示例的上方。分数提升到 80%。
- 明显的内容缺口补上后仍然毫无起色的任务,说明是样例或评分器有问题。有一个任务要求代码捕获一种错误类型,它的评分器却要求至少三层的错误链,Claude 改写了任务描述。另一个评分器的说明和我们的文档相矛盾,调用真实 API 测试后证明文档是对的。处理这些问题,再加上更多对 skill 的修改,分数达到约 88%。
开始使用
这两个子命令可以通过 claude-api skill 在 Claude Code 里直接使用。
如果想为某个问题生成一套 eval,运行 /claude-api build-eval。可以给它提供样例(比如 trace)来引导。Claude 会按本文的指引设计样例和评分器,并确保你确认过样例和评分器。
如果已经有 eval,想让 Claude 按你的目标(比如提升表现,或者在表现不降的前提下降低成本)改进,运行 /claude-api hillclimb。Claude 会按本文的指引,在爬坡过程中检查过拟合,并检查 eval 本身的 bug,比如把看起来正确的答案判错的评分器,或者 harness 错误。这些检查在第一轮之前做一次,之后每次分数停滞时再做。
原文致谢:感谢 Misha Khalman 开发这个 skill;感谢 Misha Khalman、Michael Segner、Matt Bell 和 Matt Thanabalan 的审阅、贡献和产品支持。
原文:Automating eval design and hillclimbing with Claude,作者 Lance Martin(Anthropic),2026-09-28。本文为中文翻译。