上下文压缩为什么会反复失败
这篇文章用大白话记录一次真实故障: 制标会话做到一半, 界面上一遍遍弹出红色的「上下文压缩失败」, 每次要等一两分钟, 压缩却完不成. 后面说明白三个数字分别是什么, 旧办法为什么会卡死, 以及这次为什么改成「分段写摘要, 旧摘要原样留着」.
发到 CSDN 时, 下面三张图的本地路径在网站上不会显示. 请把同目录 compaction-article-images 里的三张 png 上传到编辑器, 替换对应位置.
1. 当时卡在什么现象
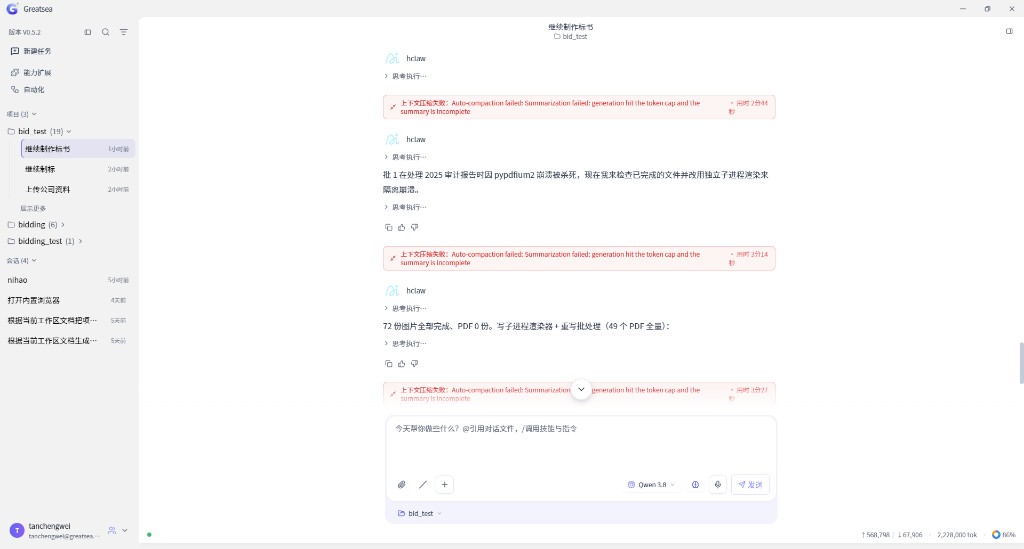
会话是「继续制作标书」, 工作区是 bid_test, 输入框里选的模型是 Qwen 3.8. 模型一边在做公司资料的图片和 PDF 识别, 一边不断插入红色失败条. 失败原文是:
上下文压缩失败: Auto-compaction failed: Summarization failed: generation hit the token cap and the summary is incomplete
翻成白话: 自动压缩失败, 因为摘要写到长度上限就停了, 这份摘要不完整, 所以整份作废.
图 1. 压缩失败的同时, 制标还在往下做. 能看到 72 份图片已经识别完, PDF 还是 0, 以及一次大约 2 分 14 秒的失败.
图 2. 连续三次都是同一句错误. 中间模型还在说 49 个 PDF 里有 35 份是扫描合同, 准备做第二批识别.
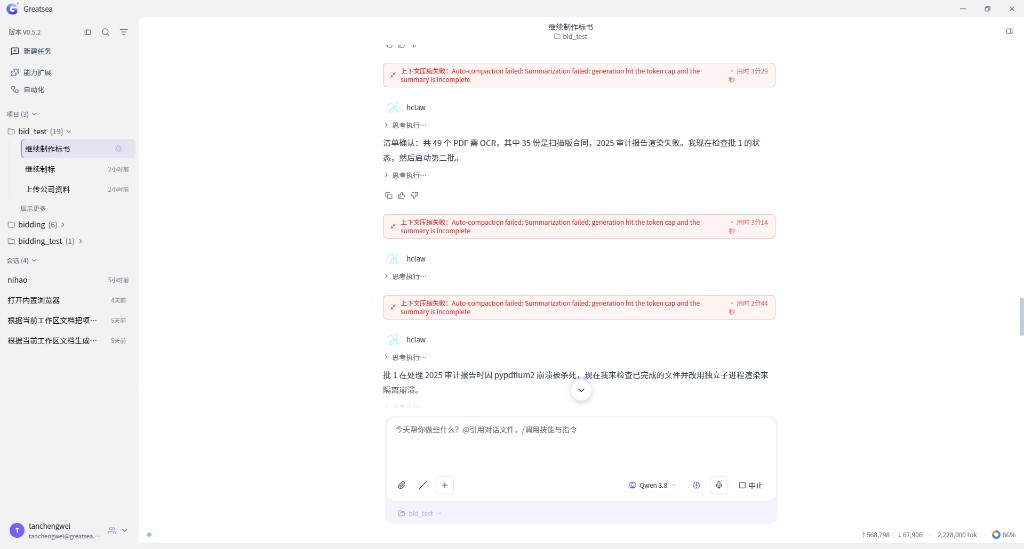
图 3. 这里有一次是成功的, 卡片写着上下文从 66.0k 降到 36.0k, 用时 3 分 15 秒. 成功之后, 下面又出现红色失败, 用时 2 分 39 秒. 所以不是「从来没成功过」, 而是成功一次之后, 活继续干, 上下文再涨上去, 下一次摘要又写不完.
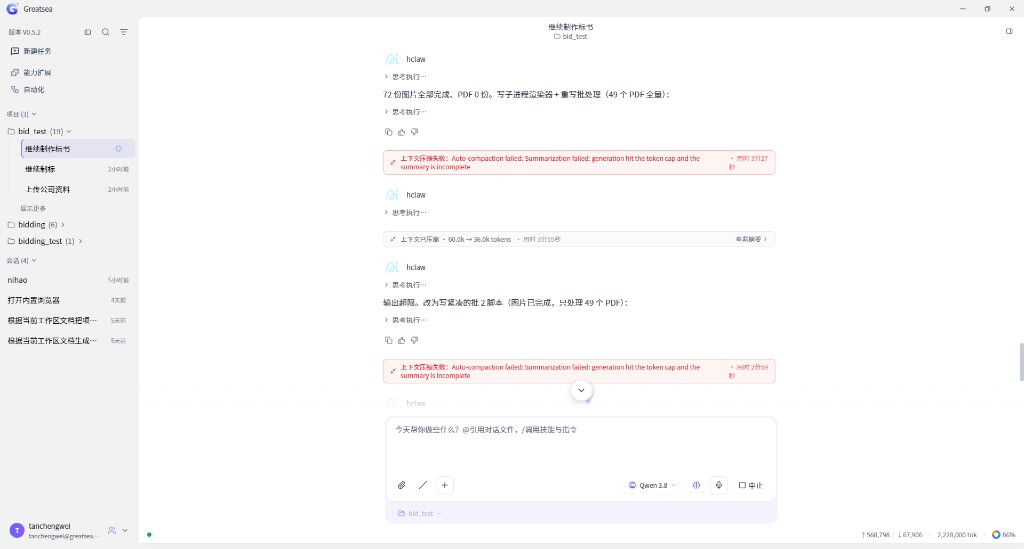
这三张图里, 单次等待大约从 1 分 19 秒到 3 分 15 秒. 失败的那几次, 上下文大小没有降下来, 所以下一步开始前又会再压一次.
右下角那串很大的数字, 例如一百多万, 两百多万, 是这一整段会话从开头累计发给模型和模型累计写回来的 token, 再加上一个总消耗. 它不是「当前脑子里装着两百多万」. 当前这次压缩前后装了多少, 要看卡片上的 66.0k 和 36.0k. 圆环旁边的百分比, 是当前上下文占工作窗口的比例, 和那串累计大数不是同一个东西.
2. 这次调用的是哪个模型, 两个上限分别是多少
界面上的名字是 Qwen 3.8. 配置里的模型编号是 self-hosted-chat, 接口类型是 openai-responses, 请求发到公司的网关, 再由网关转到这台自建对话模型. 压缩没有另找一个专门写摘要的模型, 写摘要的还是这同一个 Qwen 3.8.
token 可以先理解成篇幅的计量单位. 中文一个字往往不止 1 个 token, 所以下面不把 token 换算成汉字字数, 全部用配置里的原数.
这次和压缩有关的数是这几个:
| 名字 | 数值 | 它管什么 |
|---|---|---|
| 工作窗口 contextWindow | 64000 | 鸿睿声明给这次会话使用的上下文容量. 这不是模型出厂的物理上限. 2026-09-18 把声明从 128000 降到 64000, 因为 Qwen 3.8 在上下文快装满时会说半句就停, 界面显示会话完成, 活其实没干完 |
| 单次回复上限 maxTokens | 8192 | 模型这一次回复最多写多长. 普通回答和压缩摘要都受它限制. 它不会因为对话轮数变多而变大 |
| 预留 reserveTokens | 16384 | 距离窗口顶还留出这么多空位时, 就提前压缩, 避免真的顶满 |
| 触发线 | 47616 | 算法是 64000 减 16384. 当前上下文估计超过大约 4.8 万, 就自动压缩 |
| 近期原文保留 keepRecentTokens | 20000 | 最近大约 2 万 token 的原话原样留下. 这是压缩程序自己的默认值, 设置里没有单独改过它 |
| 摘要这一次最多写多长 | 8192 | 压缩程序先按预留的 80% 算出 13107, 再和模型的单次回复上限 8192 取更小的那个, 所以摘要回复仍然是 8192 |
可以记成两句话.
64000 是「这次允许它记住的工作台有多大」.
8192 是「它一次开口最多能说多长」.
工作台比一次开口大很多. 旧的压缩却要求用一次开口, 把工作台上较早的内容全部讲完.
3. 压缩本来想干什么
对话里有用户的话, 模型的话, 还有大量工具结果, 比如读了哪个文件, 识别了哪一页. 这些都占上下文. 快超过 4.8 万时, 程序做三件事:
- 最近大约 2 万 token 不动, 原样留给下一步继续看.
- 更早的内容交给 Qwen 3.8, 写成一份结构化摘要. 摘要里要有目标, 限制, 做完了什么, 正在做什么, 卡住什么, 决定, 下一步, 以及关键的文件路径和报错.
- 用这份摘要替换那一大段旧对话. 上下文变小, 下一步才能继续.
摘要如果写完了, 就存下来, 当作检查点. 摘要如果因为写到 8192 还没写完而停住, 程序认定它不完整, 整份丢掉, 不存. 上下文也就不会变小.
界面上的红字 Auto-compaction failed 表示这是「涨过警戒线之后的自动压缩」. 它和另一种「模型已经报上下文溢出, 再抢救一次」不是同一条路径. 溢出抢救一轮里只会试一次, 而且用的也是同一次 8192 的摘要.
4. 旧办法为什么会一直失败
旧办法把「要被忘掉的那一整段历史」放进同一次请求, 让模型一次回复写完整份摘要.
如果这已经是第二次压缩, 旧办法还多一条规矩: 新回复必须保住上一份摘要里的所有信息, 再把新进展加进去. 上一份摘要被放进提示词, 模型要在这 8192 个 token 里把旧的和新的一起重写出来.
制标这种活会让这份摘要越来越长. 截图里的进展包括: 72 张图片识别完, 49 个 PDF, 其中 35 份是扫描合同, 某个 2025 年审计报告读的时候 pypdfium2 崩溃, 以及这些文件的路径. 这些都不能丢, 否则下一步会忘记做到哪了. 可是它们堆在一起, 一次回复写不下.
失败之后发生的事是固定的:
- 半截摘要被丢掉.
- 上下文还是那么大, 仍然超过 4.8 万的触发线.
- 模型每要再往下说一句, 程序都先检查一次. 发现还超线, 就再发起一次同样的摘要.
- 材料没变短, 8192 的上限也没变大, 所以下一次还是写不完.
这不是多试几次就会碰巧变短. 同一次材料, 同一个上限, 结果是稳定地失败. 只有摘要恰好写得比较短的那一次能过去. 图 3 里 66.0k 降到 36.0k 就是这样一次过去了. 活继续做, 上下文再次超过触发线时, 模型又要把已经很长的旧摘要重写进新的 8192 里, 于是再次失败. 失败不缩小上下文, 等待就一轮接一轮.
每次等待都是一次真的模型调用, 所以会真实地过去一两分钟, 甚至更久. 制标步骤夹在这些等待中间, 看起来还在动, 但每动一步都要先付一次压缩的时间.
5. 改的时候怎么取舍
目标有两个, 要同时满足: 少等, 而且下一步仍然知道路径, 进度, 决定和未做完的事.
当时排除了这几条路.
把 Qwen 的 8192 全局调大. 这个数管的是每一次普通回复, 不只是摘要. 网关和模型是否允许更大的单次输出, 没有在这次改动里验证. 调大之后, 平时的回答也会变长, 不是只修压缩.
关掉自动压缩. 等待会消失, 但上下文会一直堆着. 之前把工作窗口声明成 64000, 就是因为 Qwen 3.8 在上下文很满时会提前说完. 关掉压缩会把那个问题请回来.
失败了也把半截摘要存下来. 半截摘要会在句子中间断开, 下一步可能拿到一份缺了后半的检查点. 短对话如果一次就写满上限, 现在仍然拒绝保存, 避免把不完整的文字当成检查点.
所以留下的办法是: 8192 这个单次回复上限不动, 压缩仍然要做, 不完整的摘要仍然不保存. 改变的是「不要逼同一次回复写完全部历史」.
6. 现在的压缩怎么做
程序仍然在上下文超过大约 4.8 万时启动压缩, 最近大约 2 万 token 仍然原样保留. 变的是摘要怎么生成.
第一, 待压缩的原文如果比 8192 还长, 就按篇幅切成几段. 每一段单独请模型写一份小摘要. 每一份都要求写完目标, 限制, 进度, 决定, 下一步, 以及这段里出现的文件路径和报错. 大段工具输出不要原文照抄, 记下路径和结果即可. 程序再把这几份小摘要接在一起, 存成一份检查点. 一次压缩最多调用模型 8 次. 某一段还是写满 8192, 而且这段文字还够长, 就把这一段再对半拆开重试, 拆分有层数限制, 避免无限拆.
第二, 已经有旧摘要时, 程序把旧摘要原样留着, 不再把全文塞回给模型要求重写. 模型只概括「这次新多出来的那一截」. 写完后, 程序把旧摘要放在前面, 新摘要接在后面. 已经记下来的路径和决定不会在重写时被模型漏掉, 新的 8192 也不用再容纳越来越长的旧账.
第三, 送给摘要模型的文字里去掉思考过程. 检查点需要的是做了什么, 不需要模型当时的草稿. 压缩请求还强制关闭思考. 需要说清楚: 这次 Qwen 3.8 的配置里推理本来就是关的, 截图里的失败不是思考把 8192 占满. 强制关闭思考是预防. 以后如果打开思考, 思考和摘要正文共用同一次回复的 8192, 正文会更容易写不完.
第四, 如果这次仍然因为写满上限而失败, 半截文字还是丢掉, 上下文这次不会变小. 但是同一轮里不再自动反复压缩. 制标可以继续往下做, 不用每一步都再等一两分钟. 你发出下一条消息时, 才允许再试一次压缩. 如果模型是因为上下文真的溢出而报错, 原来的那一次溢出抢救仍然会做.
对话还短, 一次回复写得下时, 仍然只调用一次模型, 用原来的整段摘要格式. 这种短摘要如果写满上限, 照旧整份丢弃.
7. 为什么这样会更可用, 任务质量怎么留住
等待变少, 是因为失败不再用同一份材料无限重放. 历史很长时, 一次压缩可能变成几次较短的调用, 最多 8 次, 然后应当能存下一份接好的检查点. 存下之后上下文变小, 下一步不会立刻再撞上同一次失败. 如果仍然失败, 这一轮只付一次等待, 后面的步骤不再被自动压缩拦住.
质量留下, 靠的是下面几件事同时成立.
最近大约 2 万 token 的原话还在, 模型能直接看到刚做过的事.
更早的内容按段写成结构化摘要, 每段都要求留下路径, 报错, 决定和未做完的事. 接在一起的检查点可以长于 8192, 因为长度限制只约束每一次模型回复, 不约束程序拼接后的全文.
旧检查点原样保留. 第二次, 第三次压缩不会把前面已经写对的内容再交回去重写一遍.
原来压缩成功后, 还会在摘要末尾附上读过和改过的文件名单. 这一步还在, 没有拿掉.
要实话实说的边界也有. 某一小段如果短到不能再拆, 却仍然写满 8192, 这一次压缩还是失败, 上下文要等下一次成功才会缩小. 改动去掉的是「失败了还无限重试」, 没有把 8192 这个单次回复上限取消.
8. 这种改法适合什么场景
适合下面这些情况.
同一次回复的上限, 明显小于工作窗口, 而且会话里有很多工具结果. 这次就是 Qwen 3.8 的 8192 对上 64000, 制标识别又不断往历史里加页码和路径.
已经成功压缩过, 旧摘要本身已经不短, 下一次如果还要求在 8192 里重写整份旧摘要, 就一定会再次写不完. 图 3 就是这个节奏: 先成功一次, 活继续做, 再失败.
不该指望这套改动解决的情况也写清楚.
网关超时, 例如 504, 页面上会是另一句错误. 这次改的是摘要怎么拆开写, 没有改网关等待时间.
很短的聊天, 一次摘要就写得下. 行为与改动前相同, 仍然是一次调用.
如果你换成单次回复上限很大的模型, 不太会在 8192 这个位置被截断. 代码里另外两个出厂模型的默认单次回复上限大得多. 这次实际选中的是 Qwen 3.8, 所以按 8192 来处理. 窗口满了以后, 那些模型同样需要压缩, 只是不容易出现「摘要正文写满单次上限」这一类失败.
9. 改动放在哪里, 怎样才生效
压缩逻辑在内置的 pi 程序里, 不在页面组件里. 开发时鸿睿跑的是编译后的 pi/packages/coding-agent/dist/cli.js. 只改源码, 不重新编译这个 dist, 正在跑的进程还是旧策略.
这次已经重新编译 dist, 并重新启动了鸿睿. 新开或继续的会话会走分段摘要. 启动日志里如果还有一句 reserveTokens is not defined, 那是写入压缩配置时的另一处旧错误, 没有挡住程序启动, 也不是这次分段摘要的逻辑.