摘要
随着医学影像分析技术和深度学习方法的快速发展,基于皮肤镜图像的皮肤病变智能分类逐渐成为辅助临床诊断的重要研究方向。传统皮肤病变识别方法较多依赖医生经验,不仅诊断效率受限,而且在面对复杂病灶类型时容易受到主观因素影响。为提高皮肤病变分类的自动化与准确性,本文设计并实现了一种基于 DenseNet 的皮肤病变分类算法系统。
本文以 HAM10000 皮肤镜图像数据集为基础,围绕数据准备、模型训练、实验评估和在线预测构建了完整的系统流程。在数据处理阶段,对原始元数据和图像数据进行标准化整理,并按照病灶级别完成训练集、验证集和测试集划分,以避免数据泄漏;在模型构建阶段,采用 DenseNet121 作为主干网络,结合迁移学习思想完成 7 类皮肤病变分类任务;在训练过程中,引入图像增强、Mixup/CutMix、加权采样、warmup 以及分阶段微调等策略,以提升模型的特征提取能力与泛化性能;在系统实现方面,基于 FastAPI 构建后端推理接口,并结合前端可视化页面实现实验结果展示与单图预测功能。
实验结果表明,本文所设计的模型在主实验 main_v2 中取得了较好的分类效果,最优轮次为第 47 轮,验证集 macro F1 值达到 0.746877,测试集 macro F1 值达到 0.683923,测试集准确率达到 0.82。结果说明,基于 DenseNet 的皮肤病变分类方法能够较有效地完成皮肤镜图像识别任务,并具有一定的实际应用价值。
关键词: DenseNet;皮肤病变分类;HAM10000;迁移学习;医学图像分析
Abstract
With the rapid development of medical image analysis and deep learning, intelligent classification of skin lesions based on dermoscopic images has become an important research direction for computer-aided diagnosis. Traditional skin lesion recognition methods rely heavily on clinical experience, which not only limits diagnostic efficiency but also makes the results susceptible to subjective factors when dealing with complex lesion categories. To improve the automation and accuracy of skin lesion classification, this paper designs and implements a skin lesion classification algorithm system based on DenseNet.
This study is built on the HAM10000 dermoscopic image dataset and constructs a complete workflow covering data preparation, model training, experimental evaluation, and online prediction. In the data processing stage, the metadata and image samples are standardized, and the dataset is divided into training, validation, and test sets at the lesion level to avoid data leakage. In the model construction stage, DenseNet121 is adopted as the backbone network, and transfer learning is applied to accomplish the seven-class skin lesion classification task. During training, image augmentation, Mixup/CutMix, weighted sampling, warmup, and staged fine-tuning strategies are introduced to improve feature extraction capability and generalization performance. In system implementation, FastAPI is used to build the backend inference interface, and a frontend visualization page is developed to support result presentation and single-image prediction.
Experimental results show that the proposed model achieves good classification performance in the main experiment main_v2. The best result is obtained at epoch 47, with a validation macro F1 score of 0.746877, a test macro F1 score of 0.683923, and a test accuracy of 0.82. These results indicate that the DenseNet-based method can effectively accomplish dermoscopic image classification and has certain practical application value.
****Key words:****DenseNet; Skin lesion classification; HAM10000; Transfer learning; Medical image analysis
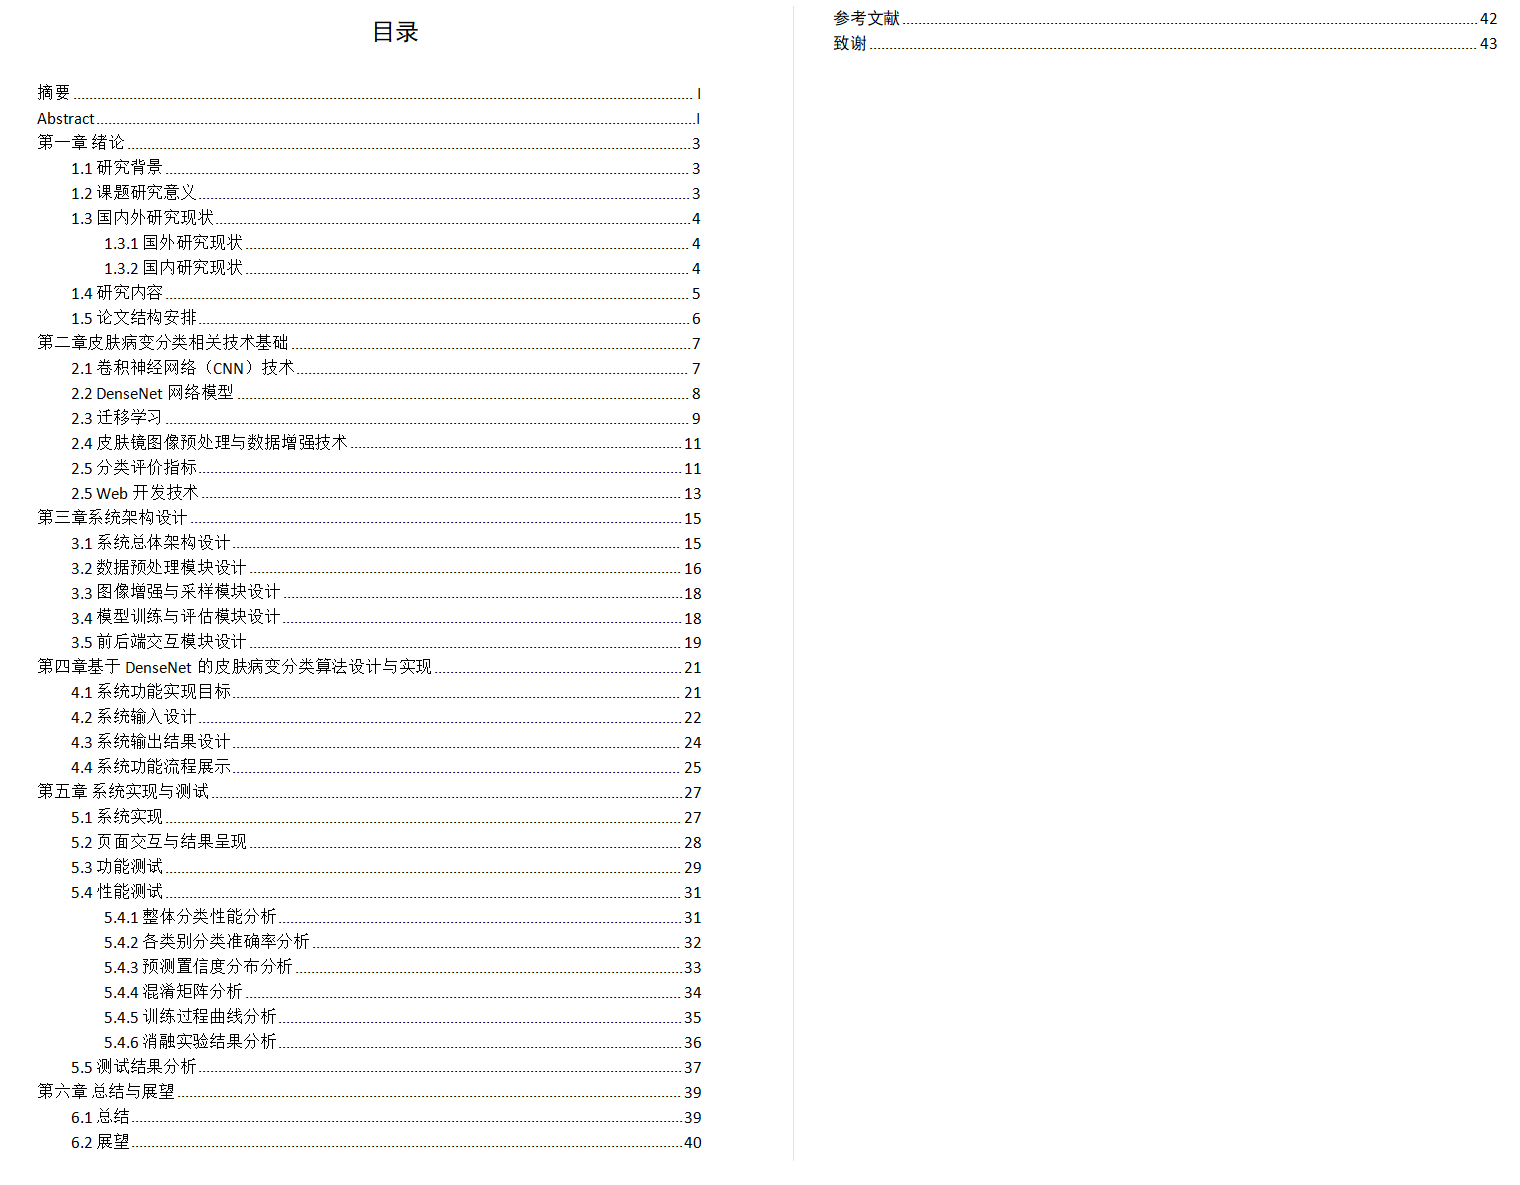
目录
[++++第一章 绪论++++](#第一章 绪论)
[++++1.1 研究背景++++](#1.1 研究背景)
[++++1.2 课题研究意义++++](#1.2 课题研究意义)
[++++1.3 国内外研究现状++++](#1.3 国内外研究现状)
[++++1.3.1 国外研究现状++++](#1.3.1 国外研究现状)
[++++1.3.2 国内研究现状++++](#1.3.2 国内研究现状)
[++++1.4 研究内容++++](#1.4 研究内容)
[++++1.5 论文结构安排++++](#1.5 论文结构安排)
[++++2.1 卷积神经网络(CNN)技术++++](#2.1 卷积神经网络(CNN)技术)
[++++2.2 DenseNet网络模型++++](#2.2 DenseNet网络模型)
[++++2.3 迁移学习++++](#2.3 迁移学习)
[++++2.5 分类评价指标++++](#2.5 分类评价指标)
[++++2.5 Web开发技术++++](#2.5 Web开发技术)
[++++3.1 系统总体架构设计++++](#3.1 系统总体架构设计)
[++++3.4 模型训练与评估模块设计++++](#3.4 模型训练与评估模块设计)
[++++3.5 前后端交互模块设计++++](#3.5 前后端交互模块设计)
++++第四章基于DenseNet的皮肤病变分类算法设计与实现++++
[++++4.1 系统功能实现目标++++](#4.1 系统功能实现目标)
[++++4.2 系统输入设计++++](#4.2 系统输入设计)
[++++4.3 系统输出结果设计++++](#4.3 系统输出结果设计)
[++++4.4 系统功能流程展示++++](#4.4 系统功能流程展示)
[++++第五章 系统实现与测试++++](#第五章 系统实现与测试)
[++++5.1 系统实现++++](#5.1 系统实现)
[++++5.2 页面交互与结果呈现++++](#5.2 页面交互与结果呈现)
[++++5.3 功能测试++++](#5.3 功能测试)
[++++5.4 性能测试++++](#5.4 性能测试)
[++++5.4.1 整体分类性能分析++++](#5.4.1 整体分类性能分析)
[++++5.4.2 各类别分类准确率分析++++](#5.4.2 各类别分类准确率分析)
[++++5.4.3 预测置信度分布分析++++](#5.4.3 预测置信度分布分析)
[++++5.4.4 混淆矩阵分析++++](#5.4.4 混淆矩阵分析)
[++++5.4.5 训练过程曲线分析++++](#5.4.5 训练过程曲线分析)
[++++5.4.6 消融实验结果分析++++](#5.4.6 消融实验结果分析)
[++++5.5 测试结果分析++++](#5.5 测试结果分析)
[++++第六章 总结与展望++++](#第六章 总结与展望)
[++++6.1 总结++++](#6.1 总结)
[++++6.2 展望++++](#6.2 展望)
第一章 绪论
1.1 研究背景
随着医学影像分析技术和人工智能技术的不断发展,基于皮肤镜图像的皮肤病变自动分类逐渐成为医学图像处理领域的重要研究方向。皮肤病变种类繁多,部分恶性病变如黑色素瘤具有较强的侵袭性和较高的致死风险,因此提高皮肤病变的早期识别能力具有重要意义。皮肤镜图像能够较为清晰地呈现病灶边界、颜色分布及局部纹理特征,为计算机辅助诊断提供了可靠的数据基础1。
传统皮肤病变识别方法多依赖医生临床经验或人工设计特征,这类方法虽然在一定场景下具有可行性,但存在诊断效率较低、主观性较强以及对复杂特征表达不足等问题。当面对类别多样、样本分布不平衡的皮肤病变图像时,传统方法难以保证分类结果的稳定性与准确性2。
近年来,深度学习特别是卷积神经网络在图像分类领域取得了显著成果。与传统方法相比,深度学习能够自动从原始图像中学习多层次特征表示,减少人工特征设计带来的局限。DenseNet 通过密集连接机制实现特征复用,能够有效缓解梯度消失问题并提升模型特征表达能力。因此,研究基于 DenseNet 的皮肤病变分类算法,对于提高皮肤镜图像自动识别水平具有较高的研究价值和应用前景3。
1.2 课题研究意义
本课题围绕皮肤镜图像智能分类问题,设计并实现了基于 DenseNet 的皮肤病变分类算法系统,具有一定的理论意义与现实意义。
在理论意义方面,本文将深度卷积神经网络应用于皮肤病变图像分类任务,研究 DenseNet 网络在医学图像特征提取与类别判别中的表现,并结合数据增强、迁移学习、分阶段微调等策略对模型训练过程进行优化。这对于丰富深度学习在医学图像分析领域的研究内容、提升皮肤病变自动分类方法的研究深度具有一定价值。
在实际意义方面,皮肤病变诊断通常对专业经验要求较高,而人工判读存在一定主观性。通过构建自动化分类模型,可以在一定程度上提高皮肤病变识别效率,为医生提供辅助判断依据,减轻临床筛查压力。同时,本文实现了从数据准备、模型训练、实验评估到单图预测和可视化展示的完整系统流程,可为后续皮肤病变辅助诊断系统的开发提供参考。
1.3 国内外研究现状
1.3.1 国外研究现状
国外在分类算法设计与实现方面起步较早,相关研究覆盖了搜索优化、分类预测、深度学习应用以及推荐系统等多个方向。Nag等人4提出了一种面向已知分类协变量的高效搜索算法,用于实现多处理组之间的平衡分配设计,该研究为后续分类任务中的样本分配优化与算法设计提供了参考。Jiawei5设计并实现了一种基于随机森林算法的学生成绩分类与预测系统,说明传统机器学习方法在分类预测系统中的应用仍具有较好的实用价值。Gunaseelan等人6提出了一种基于创新型深度学习算法的垃圾分类设计与实现方法,表明深度学习技术在复杂图像分类任务中具有较强的特征提取与识别能力。Chibuzor等人7设计并实现了结合关联规则与聚类算法的产品推荐系统,说明分类、聚类与推荐机制的融合已成为国外智能系统研究的重要方向。
总体来看,国外研究更加注重算法设计的系统性与实际应用场景结合,研究范围已从传统分类方法逐步扩展到深度学习和多算法融合方向。这些研究成果为图像分类算法、智能识别系统以及深度学习模型在实际场景中的部署应用提供了良好的理论和技术基础。
1.3.2 国内研究现状
国内在分类算法设计与实现方面的研究近年来发展较快,相关成果广泛分布于图像分类、目标检测、文本分类、医学信号分类等多个应用领域。李东阳等人8提出了基于 K-means 和 Dlib 的脸型分类算法设计与实现方法,将聚类方法与图像特征分析相结合,提升了人脸相关分类任务的应用效果。杨俊9围绕领域泛化图像分类算法开展研究,提出了相应的设计与实现方案,为提升模型跨域泛化能力提供了研究思路。亢明珠10提出了基于 CNN 的抽油机示功图分类算法设计与实现方法,验证了卷积神经网络在工业图像分类任务中的有效性。曹子利11针对多元不平衡小数据集条件下的图片分类问题开展研究,提出了相应的算法设计与实现方案,为解决小样本和类别不均衡条件下的分类任务提供了借鉴。李美新12研究了高光谱图像地物分类算法的设计与实现,体现了图像分类技术在遥感领域中的应用拓展。杨帆13提出了应用于垃圾分类的轻量化目标检测算法设计及 SoC 实现方法,说明国内研究已开始关注分类算法的轻量化与硬件部署问题。许文华14围绕长文本分类任务,提出了基于深度神经网络的分类算法设计与实现方法,拓展了深度学习分类技术在自然语言处理领域的应用。冯凯15研究了基于分类算法的工业控制系统蜜罐设计与实现,体现了分类思想在网络安全场景中的应用价值。刘思璇16提出了动态单导心电图自动分类算法设计与实现方法,表明分类算法在医学信号智能分析领域也具有重要应用前景。
总体来看,国内研究已从传统图像分类逐步扩展到跨领域、多任务和多场景应用,尤其是在卷积神经网络、深度神经网络、小样本分类、轻量化部署和医学相关分类任务方面取得了较多成果。然而,现有研究多集中于特定任务场景,针对医学图像尤其是皮肤镜图像分类的系统化研究仍有进一步深化空间。因此,开展基于 DenseNet 的皮肤病变分类算法设计与实现研究,具有较强的理论意义和现实价值。
1.4 研究内容
本文围绕基于 DenseNet 的皮肤病变分类任务,设计并实现了一套较为完整的算法与系统方案,主要研究内容如下。
(1)完成皮肤病变图像数据准备与预处理。以 HAM10000 数据集为基础,读取元数据文件与图像数据,对图像路径、标签信息进行标准化整理,并按照病灶级别划分训练集、验证集和测试集,以避免同一病灶跨数据集造成数据泄漏。
(2)完成基于 DenseNet121 的皮肤病变分类模型构建。采用 DenseNet121 作为主干网络,并结合迁移学习思想重建分类头,使其适配 7 类皮肤病变分类任务,从而提高模型对皮肤镜图像特征的提取能力。
(3)完成模型训练策略优化。针对医学图像样本分布不均衡和模型泛化能力不足的问题,在训练过程中引入图像增强、Mixup/CutMix、加权采样、warmup、分阶段微调、梯度裁剪与学习率调度等策略,以提升模型训练稳定性和分类性能。
(4)完成实验评估与消融分析。通过准确率、召回率、Macro F1 值、混淆矩阵以及类别错误率等指标对模型性能进行评估,并通过消融实验分析采样策略、数据增强策略和分阶段微调策略对分类结果的影响。
(5)完成在线预测与可视化系统实现。基于 FastAPI 构建后端接口,实现单张皮肤镜图像预测功能,并结合前端页面展示实验指标、图表和在线预测结果,形成从模型训练到推理展示的完整闭环系统。
1.5 论文结构安排
第二章 皮肤病变分类相关技术基础
2.1 卷积神经网络(CNN)技术
卷积神经网络(Convolutional Neural Network,CNN)是一种专门用于处理具有网格结构数据的深度学习模型,最初被广泛应用于图像识别和分类任务中,由于其在特征提取方面的卓越性能,后来逐渐被应用于音频、文本等其他类型数据的处理。在本课题的音乐分类系统中,CNN技术是核心技术之一,用于从音乐频谱图中提取特征并进行分类。
图2-1 卷积神经网络结构示意图结构图
CNN的核心思想是通过卷积操作提取数据的局部特征,并利用池化操作对特征进行降维,同时保持特征的平移不变性。CNN的网络结构通常包括输入层、卷积层、池化层、全连接层和输出层。输入层接收原始数据,对于本课题来说,输入数据是224×224×3的对数梅尔谱图;卷积层通过卷积核与输入数据进行卷积运算,提取数据的局部特征,每个卷积核对应一种特征模式,通过多个卷积核可以提取多种不同的特征;池化层对卷积层输出的特征图进行下采样操作,减少特征图的维度,降低计算量,同时提高模型的泛化能力,常见的池化操作有最大池化和平均池化;全连接层将池化层输出的特征映射为一维向量,并通过激活函数进行非线性变换,最后通过输出层输出分类结果。
CNN具有局部感受野特性,即每个神经元只关注输入数据的局部区域,而不是整个输入空间。这种特性使得CNN能够有效地提取数据的局部特征,对于音乐频谱图来说,局部区域往往对应着音乐的特定频率成分和时间片段,通过局部感受野可以捕捉到音乐的局部特征,如节奏、旋律、和声等。同时,CNN通过权值共享机制,即同一个卷积核在整个输入数据上共享权重,减少了模型的参数数量,降低了计算复杂度,提高了模型的训练效率,并且有助于防止模型过拟合。
在进行音乐分类任务时,将音乐信号转换为频谱图后,频谱图的每一个像素点都代表某一个频率和对应时间点上的音频能量,频谱图类似于图像结构的数据。CNN能够像处理图像数据那样处理频谱图数据,利用卷积层提取频谱图局部的特征,这些特征可能代表着音乐不同的频率成分,节奏模式等,CNN能够随着网络的深度不断增加提取更复杂、更抽象的特征,从低层次的频率特征逐渐提取到高级的音乐风格特征,音乐流派特征等,从而对音乐进行准确的分类。
在本课题中将采用ResNet-50模型作为本模型的核心分类模型,ResNet-50属于一种深度卷积神经网络。ResNet-50是随着残差连接结构被提出而提出的,它是解决训练过程中深层CNNs梯度消失和梯度爆炸的技术,能够搭建更加深的CNN网络结构以提取更加深层次的特征。而CNN技术是ResNet-50模型的母技术,它是模型本身的特征提取和分类模型的性能保障技术,也是实现音乐准确分类的关键技术之一。
2.2 DenseNet网络模型
DenseNet(Dense Convolutional Network)是一种具有密集连接结构的卷积神经网络,其核心思想是在同一 Dense Block 内,将前面各层的特征图直接传递给后续层,使每一层都能够接收之前所有层的输出信息。与传统卷积神经网络仅依赖相邻层传递特征不同,DenseNet 通过密集连接机制实现了特征的重复利用,增强了特征传播能力,缓解了深层网络训练过程中可能出现的梯度消失问题,同时在一定程度上减少了参数冗余,提高了模型的训练效率和分类性能。
在医学图像分类任务中,皮肤镜图像通常具有纹理细节丰富、病灶边界复杂、颜色分布差异明显等特点,这对模型的特征提取能力提出了较高要求。DenseNet 能够在较深网络结构中保留浅层细节特征,并将其与高层语义特征进行融合,因此较适合用于皮肤病变图像分类任务。与普通卷积网络相比,DenseNet 更有利于挖掘病灶区域中的细粒度特征,提高对不同类别皮肤病变的区分能力。
本课题采用 DenseNet121 作为皮肤病变分类任务的主干网络。项目中以 DenseNet121 作为唯一主干模型,并基于 torchvision 加载预训练权重,在此基础上重建分类头,使其适配 HAM10000 数据集的 7 类皮肤病变分类任务。训练过程中,模型输入为经过增强和归一化处理后的皮肤镜图像张量,经过 DenseNet 特征提取后,由分类头输出各类别的 logits,再通过 softmax 得到各类别的预测概率。为了进一步提升模型效果,系统还结合迁移学习思想,对网络的冻结策略、分阶段学习率、warmup、梯度裁剪、优化器和学习率调度进行统一配置,从而增强模型的收敛稳定性和分类性能。
2.3 迁移学习
迁移学习(Transfer Learning)是一种机器学习方法,其核心思想是将从一个或多个源任务中学习到的知识应用于一个相关的目标任务中。在传统的机器学习和深度学习方法中,模型通常需要在大量标注数据上进行训练才能取得较好的性能,然而在实际应用中,许多目标任务往往缺乏足够的标注数据,导致模型训练困难。迁移学习通过利用源任务的知识,能够有效解决目标任务数据不足的问题,提高模型的泛化能力和训练效率,在图像分类、音频处理、自然语言处理等领域得到了广泛的应用。在本课题的音乐分类算法系统中,迁移学习是提高模型性能的关键技术之一。基于本文的迁移学习结构图如图2-3。
图2-3 迁移学习结构图
迁移学习的基本原理是基于源任务和目标任务之间的相似性。如果源任务和目标任务在数据分布、特征空间、任务目标等方面具有一定的相似性,那么从源任务中学习到的特征和知识就可以迁移到目标任务中,帮助目标任务的模型更好地学习。在本课题中,源任务是ImageNet图像分类任务,目标任务是音乐分类任务。虽然图像数据和音乐数据在形式上存在差异,但将音乐信号转换为对数梅尔谱图后,频谱图在结构上与图像数据具有一定的相似性,都是二维网格结构,且都包含局部特征和全局特征。因此,在ImageNet数据集上预训练好的深度学习模型(如ResNet-50)所学习到的特征提取能力,能够有效地迁移到音乐频谱图的特征提取中。
在本课题中,迁移学习的具体应用方式是采用预训练的ResNet-50模型进行微调(Fine-tuning)。首先,加载在ImageNet数据集上预训练好的ResNet-50模型权重,这些权重包含了模型在图像分类任务中学习到的通用特征提取能力。然后,根据音乐分类任务的需求,替换模型的全连接层,将输出维度从ImageNet任务的1000类修改为音乐分类任务的10类。在训练过程中,冻结模型的部分卷积层参数,只训练全连接层和部分顶层卷积层的参数,或者逐渐解冻更多的卷积层进行微调。这种方式既能够利用预训练模型的特征提取能力,又能够让模型适应音乐频谱图的特定特征,从而在有限的音乐数据集上取得较好的分类性能。
迁移学习在本课题中具有重要的意义和优势。首先,迁移学习能够有效解决音乐数据集规模较小的问题。GTZAN数据集虽然是常用的音乐分类数据集,但仅有1000首音频,对于深层神经网络来说,数据量相对较少,容易导致模型过拟合。通过迁移学习,利用ImageNet数据集的大量数据所训练出的模型参数,能够为音乐分类模型提供良好的初始化,减少模型对目标任务数据的依赖,提高模型的泛化能力。其次,迁移学习能够缩短模型的训练时间。预训练模型已经学习到了一定的特征提取能力,在目标任务上进行微调时,模型能够快速收敛,无需从零开始训练,大大减少了训练时间和计算资源消耗。最后,迁移学习能够提高模型的分类准确率。预训练模型能够提取到更复杂、更抽象的特征,这些特征对于音乐分类任务具有一定的通用性,通过微调后能够更好地适应音乐数据的特征,从而提高分类准确率。
2.4皮肤镜图像预处理与数据增强技术
皮肤镜图像预处理与数据增强是医学图像分类任务中的重要环节,其主要作用是提升输入数据质量、增强样本多样性,并降低模型过拟合风险。由于皮肤镜图像在采集设备、拍摄角度、光照条件以及病灶分布上存在一定差异,如果直接将原始图像输入模型,往往会影响模型的训练稳定性和最终分类效果。因此,在模型训练之前,有必要对图像进行统一的预处理和增强操作。
在本课题中,首先对 HAM10000 数据集中的图像与元数据进行标准化整理。系统从 HAM10000_metadata.csv 中读取 image_id、lesion_id、dx 等关键信息,并完成图像路径绑定、标签标准化以及训练集、验证集、测试集的无泄漏划分。其中,以 lesion_id 为最小单位进行数据集划分,能够有效避免同一病灶图像同时出现在不同数据集中,从而减少数据泄漏对实验结果造成的干扰。
在图像增强方面,本课题对训练集与验证集、测试集采用了不同的处理策略。训练集主要使用 Resize、Flip、Rotate、ColorJitter 和 Normalize 等增强操作,以模拟图像在方向、位置、颜色分布等方面的变化,提升模型对复杂输入场景的适应能力。验证集和测试集则仅保留 Resize + Normalize,避免因额外增强导致评估结果失真。除此之外,系统还在训练阶段引入了较低强度的 Mixup/CutMix 批级增强,以平衡泛化能力提升和训练后期收敛稳定性之间的关系;同时结合 WeightedRandomSampler 和类别权重损失缓解类别分布不均衡问题,从而提升模型对少数类病变的识别能力。
总体来看,图像预处理保证了输入数据格式与标签信息的一致性,数据增强则通过扩展样本分布和引入扰动,提高了模型的鲁棒性与泛化能力,为后续 DenseNet121 模型训练提供了高质量的数据基础。
2.5 分类评价指标
为了客观评价皮肤病变分类模型的性能,本文在实验中采用了多种分类评价指标,包括准确率(Accuracy)、召回率(Recall)、Macro F1 值、混淆矩阵以及类别错误率等。这些指标能够从整体性能、类别平衡性以及误分类分布等多个角度对模型效果进行综合分析。项目在验证集和测试集阶段均输出 accuracy、recall 和 macro F1,并生成分类报告、混淆矩阵图以及类别错误率图,用于后续实验结果分析。
准确率是分类正确的样本数占总样本数的比例,用于衡量模型整体预测正确程度。其计算公式为:
其中,
表示真正例,
表示真负例,
表示假正例,
表示假负例。对于多分类任务,准确率反映的是模型整体分类能力,但在类别分布不均衡的情况下,该指标可能无法充分体现模型对少数类样本的识别能力。
召回率表示在所有真实属于某一类别的样本中,被模型正确识别出来的比例,其计算公式为:
召回率反映模型对正类样本的检出能力。在皮肤病变分类任务中,某些恶性病变类别样本数量较少,但临床意义较大,因此召回率是评价模型性能时不可忽视的重要指标。
F1 值是精确率(Precision)与召回率(Recall)的调和平均数,用于综合衡量模型分类的准确性与完整性,其计算公式为:
除上述数值指标外,本文还采用混淆矩阵对模型误分类情况进行可视化分析。混淆矩阵能够直观展示各类别之间的预测与真实分布关系,有助于发现模型容易混淆的病种类别。类别错误率图则进一步反映不同类别的识别薄弱点,为后续模型优化和消融实验分析提供依据。综上所述,本文通过准确率、召回率、Macro F1、混淆矩阵和类别错误率等多维指标,对 DenseNet 皮肤病变分类模型进行了较为全面的性能评价。
2.5 Web开发技术
Web开发技术用于实现系统的应用层和表示层功能,构建用户友好的Web界面,实现音频文件的上传、处理和分类结果的展示。本课题中采用的Web开发技术包括Flask 2.x、HTML5、CSS3、JavaScript以及相关的前端库和框架。他们之间的联系如图2-4:
图2-4 Web开发技术前后端关系示意图
Flask 2.x是一款轻量级的Python Web框架,具有简洁、灵活、易于扩展的特点,适合构建中小型Web应用。在本系统中,Flask 2.x用于实现应用层的功能,包括文件校验、异步任务调度、缓存管理、接口开发等。文件校验功能用于验证用户上传的音频文件格式是否符合要求(如MP3、WAV等),文件大小是否在允许范围内。异步任务调度功能用于处理音频文件的预处理和模型推理等耗时操作,采用Celery作为异步任务队列,通过Redis作为消息代理,实现任务的异步执行,提高系统的响应速度和并发处理能力。缓存管理功能采用LRU(Least Recently Used)策略,缓存生成的对数梅尔谱图,减少重复计算,提高系统的处理效率。同时,Flask 2.x提供了RESTful API开发支持,能够方便地实现应用层与推理层、表示层之间的数据交互。
HTML5(HyperText Markup Language 5)是用于构建Web页面的标记语言,提供了丰富的语义化标签和新的API,能够实现更复杂的Web功能。在本系统的表示层中,HTML5用于构建Web界面的结构,包括音频上传区域、波形可视化区域、分类结果展示区域等。HTML5的File API支持文件的拖拽上传和分片传输,能够方便地实现用户音频文件的上传功能。同时,HTML5的Audio API支持音频的播放和控制,为音频波形可视化提供了基础。
CSS3(Cascading Style Sheets 3)即样式表3,是用来美容Web页面的语言,提供了样式效果和布局方式。在本系统中,会使用CSS3来设计Web端界面的外观和布局,包括页面的颜色,字体,排版,动画效果等内容,CSS3的Flexbox布局和Grid布局可以对页面进行自由排版,以适应不同大小的设备屏幕。CSS3的动画和过渡效果可以为页面添加美观的交互效果,如按钮的hover效果,分类结果展示的动画效果等等。
JavaScript是用于实现Web页面交互功能的脚本语言,能够为Web页面添加动态效果和交互逻辑。在本系统中,JavaScript用于实现音频波形可视化、分类结果图表绘制、用户交互响应等功能。WaveSurfer.js是一款基于Web Audio API和Canvas的音频波形可视化库,能够将音频文件转换为直观的波形图,并支持波形的缩放、拖动等操作,本系统中采用WaveSurfer.js实现音频波形的可视化展示。Chart.js是一款简单易用的图表绘制库,支持条形图、雷达图、折线图等多种图表类型,本系统中采用Chart.js绘制分类置信度条形图和雷达图,直观展示TOP3音乐流派及对应置信度。此外,JavaScript还用于实现用户上传文件的验证、异步请求的发送和响应处理等功能,提高用户界面的交互性和响应速度。
第三章 系统架构设计
3.1 系统总体架构设计
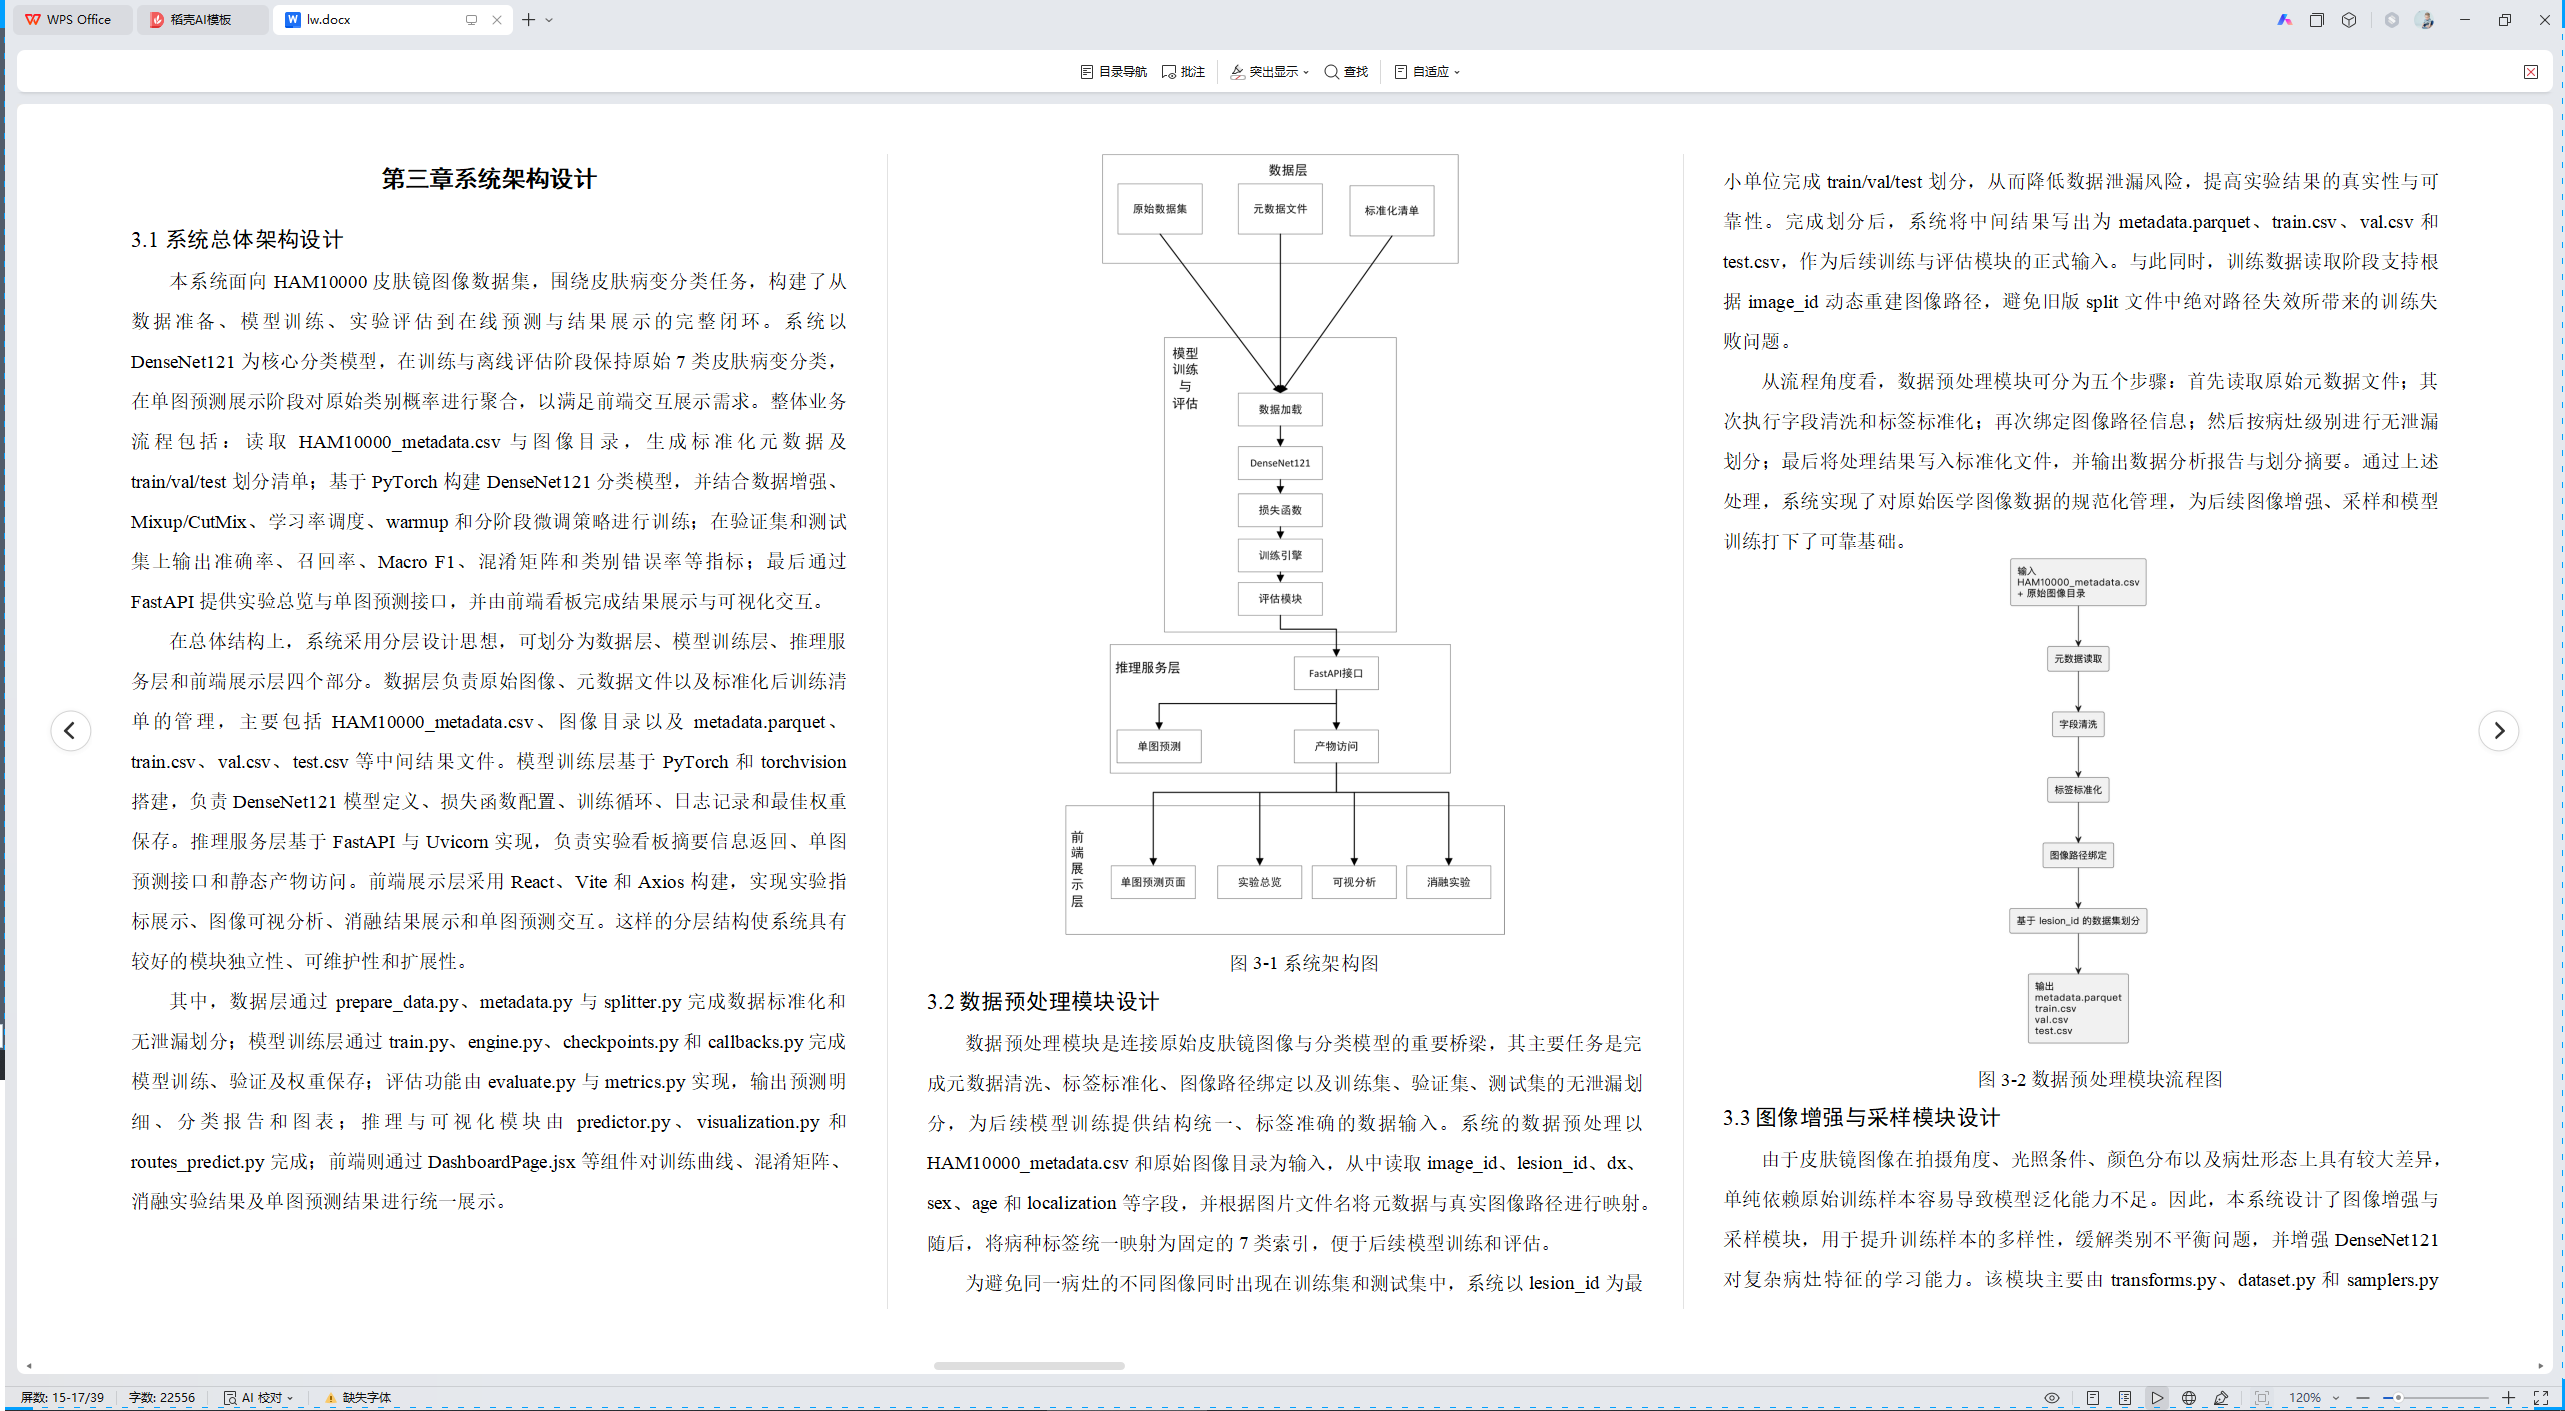
本系统面向 HAM10000 皮肤镜图像数据集,围绕皮肤病变分类任务,构建了从数据准备、模型训练、实验评估到在线预测与结果展示的完整闭环。系统以 DenseNet121 为核心分类模型,在训练与离线评估阶段保持原始 7 类皮肤病变分类,在单图预测展示阶段对原始类别概率进行聚合,以满足前端交互展示需求。整体业务流程包括:读取 HAM10000_metadata.csv 与图像目录,生成标准化元数据及 train/val/test 划分清单;基于 PyTorch 构建 DenseNet121 分类模型,并结合数据增强、Mixup/CutMix、学习率调度、warmup 和分阶段微调策略进行训练;在验证集和测试集上输出准确率、召回率、Macro F1、混淆矩阵和类别错误率等指标;最后通过 FastAPI 提供实验总览与单图预测接口,并由前端看板完成结果展示与可视化交互。
在总体结构上,系统采用分层设计思想,可划分为数据层、模型训练层、推理服务层和前端展示层四个部分。数据层负责原始图像、元数据文件以及标准化后训练清单的管理,主要包括 HAM10000_metadata.csv、图像目录以及 metadata.parquet、train.csv、val.csv、test.csv 等中间结果文件。模型训练层基于 PyTorch 和 torchvision 搭建,负责 DenseNet121 模型定义、损失函数配置、训练循环、日志记录和最佳权重保存。推理服务层基于 FastAPI 与 Uvicorn 实现,负责实验看板摘要信息返回、单图预测接口和静态产物访问。前端展示层采用 React、Vite 和 Axios 构建,实现实验指标展示、图像可视分析、消融结果展示和单图预测交互。这样的分层结构使系统具有较好的模块独立性、可维护性和扩展性。
其中,数据层通过 prepare_data.py、metadata.py 与 splitter.py 完成数据标准化和无泄漏划分;模型训练层通过 train.py、engine.py、checkpoints.py 和 callbacks.py 完成模型训练、验证及权重保存;评估功能由 evaluate.py 与 metrics.py 实现,输出预测明细、分类报告和图表;推理与可视化模块由 predictor.py、visualization.py 和 routes_predict.py 完成;前端则通过 DashboardPage.jsx 等组件对训练曲线、混淆矩阵、消融实验结果及单图预测结果进行统一展示。
图3-1 系统架构图
3.2数据预处理模块设计
数据预处理模块是连接原始皮肤镜图像与分类模型的重要桥梁,其主要任务是完成元数据清洗、标签标准化、图像路径绑定以及训练集、验证集、测试集的无泄漏划分,为后续模型训练提供结构统一、标签准确的数据输入。系统的数据预处理以 HAM10000_metadata.csv 和原始图像目录为输入,从中读取 image_id、lesion_id、dx、sex、age 和 localization 等字段,并根据图片文件名将元数据与真实图像路径进行映射。随后,将病种标签统一映射为固定的 7 类索引,便于后续模型训练和评估。
为避免同一病灶的不同图像同时出现在训练集和测试集中,系统以 lesion_id 为最小单位完成 train/val/test 划分,从而降低数据泄漏风险,提高实验结果的真实性与可靠性。完成划分后,系统将中间结果写出为 metadata.parquet、train.csv、val.csv 和 test.csv,作为后续训练与评估模块的正式输入。与此同时,训练数据读取阶段支持根据 image_id 动态重建图像路径,避免旧版 split 文件中绝对路径失效所带来的训练失败问题。
从流程角度看,数据预处理模块可分为五个步骤:首先读取原始元数据文件;其次执行字段清洗和标签标准化;再次绑定图像路径信息;然后按病灶级别进行无泄漏划分;最后将处理结果写入标准化文件,并输出数据分析报告与划分摘要。通过上述处理,系统实现了对原始医学图像数据的规范化管理,为后续图像增强、采样和模型训练打下了可靠基础。
图3-2 数据预处理模块流程图
3.3图像增强与采样模块设计
由于皮肤镜图像在拍摄角度、光照条件、颜色分布以及病灶形态上具有较大差异,单纯依赖原始训练样本容易导致模型泛化能力不足。因此,本系统设计了图像增强与采样模块,用于提升训练样本的多样性,缓解类别不平衡问题,并增强 DenseNet121 对复杂病灶特征的学习能力。该模块主要由 transforms.py、dataset.py 和 samplers.py 实现。
在图像增强策略上,系统对训练集和验证集、测试集采用不同的变换方案。训练集使用 Resize + Flip + Rotate + ColorJitter + Normalize 组合,对输入图像进行尺寸统一、翻转扰动、旋转变换和颜色扰动,从而模拟实际采集环境中图像方向和光照变化,提高模型对不同图像分布的适应能力。验证集和测试集仅保留 Resize + Normalize,避免由于过度增强而影响模型评估的客观性。这样可以保证训练阶段注重泛化,评估阶段注重真实性。
在批级增强方面,系统进一步引入较低强度的 Mixup/CutMix 策略。该方法通过在样本之间进行线性混合或区域替换,扩展训练样本分布,增强模型对类别边界的学习能力,并在一定程度上抑制过拟合。与此同时,针对 HAM10000 数据集中类别分布不均衡的问题,系统支持 WeightedRandomSampler 与类别权重损失两种方式对少数类样本进行补偿,使模型在训练过程中能够更充分地关注难分类和低频类别。经过增强与采样处理后,数据最终被组织为可直接送入 PyTorch 的 DataLoader,每个 batch 中包含 images、labels 及相关元数据,为后续模型训练提供规范输入。
图3-3图像增强与采样模块流程图
3.4 模型训练与评估模块设计
模型训练与评估模块是系统的核心部分,其主要作用是将预处理后的皮肤镜图像输入 DenseNet121 网络,完成参数优化、最佳模型保存以及分类性能评估。本系统以 DenseNet121 作为唯一主干网络,并通过 torchvision 加载 ImageNet 预训练骨干,在此基础上重建分类头以适配 7 类皮肤病变分类任务。训练时,模型输入为经过增强和归一化后的图像张量,网络首先完成特征提取,再通过分类头输出 logits,最后利用 softmax 得到各类别概率分布。
训练过程由 train.py 统一组织,将配置文件、数据集、模型、损失函数、优化器与学习率调度器串联起来。系统支持 CrossEntropyLoss 和 FocalLoss 两类损失函数,并通过 factory.py 控制 device、优化器、学习率调度与冻结阶段。为了提升训练稳定性与收敛效果,系统采用了分阶段微调策略:在不同 epoch 阶段动态调整网络冻结与解冻范围,并配合 warmup、阶段学习率缩放与梯度裁剪,提升训练后期的平稳收敛能力。训练过程中,每个 epoch 记录 train_loss、train_accuracy、train_recall、train_f1、val_loss、val_accuracy、val_recall、val_f1 以及 learning_rate 等指标,同时自动保存 latest.pt 和 best_val_f1.pt 两类权重文件,以便恢复训练和部署最佳模型。
在评估阶段,系统通过 evaluate.py 加载最佳 checkpoint,对验证集和测试集逐批进行推理,并利用 metrics.py 和 plotting.py 计算与输出分类报告、混淆矩阵、类别错误率图、预测明细 CSV 以及 Markdown/JSON 格式评估报告。当前主实验 main_v2 采用 50 个 epoch 训练,最优轮次出现在第 47 轮,验证集 macro_f1 达到 0.746877,测试集 macro_f1 达到 0.683923,测试集准确率为 0.82,说明该模块能够较稳定地支撑 DenseNet121 在皮肤病变分类任务中的训练与评估需求。
3.5 前后端交互模块设计
本文设计了RESTful风格的API接口,web交互结果展示流程图如图3-4所示。
图3-4 Web交互结果展示流程图
接口1:GET /------ 首页路由,对应上图的用户浏览器到前端页面上传音频模块,该接口的作用是返回 HTML 模板,也就是用户在浏览器打开网页时,加载出包含文件上传控件、波形容器、结果图表的前端页面,是整个交互流程的入口,对应流程图最左侧的两个初始步骤。
接口2:POST /classify------核心分类接口。对应流程图的中间核心链路,覆盖从请求接收、处理到结果返回的全流程,接收 multipart/form-data 格式的单个音频文件。需要说明的是,当前前端交互页面采用单文件上传设计,一次仅允许用户选择或拖拽 1 个音频文件;若需继续分类,需重新选择文件并再次提交请求。后端设计了严格的文件类型白名单校验(Whitelist Validation)和文件大小限制(<50MB),确保系统安全。响应数据为 JSON 格式,包含预测标签、置信度分数及 TOP3 概率分布。
第四章 基于DenseNet的皮肤病变分类算法设计与实现
4.1 系统功能实现目标
本系统面向皮肤镜图像分类任务,围绕 HAM10000 数据集构建了一个集数据准备、模型训练、实验评估、在线预测与结果展示于一体的皮肤病变分类系统。系统以 DenseNet121 作为核心分类模型,在训练与离线评估阶段完成原始 7 类皮肤病变识别,在前端单图预测展示阶段,将模型输出的原始 7 类概率进一步聚合为 4 类结果,以便于用户理解和交互展示。当前系统已经完成主实验 main_v2,最优轮次为第 47 轮,验证集 macro_f1 达到 0.746877,测试集 macro_f1 达到 0.683923,测试集准确率达到 0.82,说明系统已具备较好的分类性能和应用基础。
从功能层面来看,本系统主要实现了四个方面的目标。第一,实现了皮肤镜图像的规范化输入处理。系统能够读取用户上传的单张图片,并完成格式接收、数据预处理和标准化变换,使不同来源的图像能够以统一形式输入模型。第二,实现了基于 DenseNet121 的皮肤病变自动分类。系统利用预训练骨干网络和重构分类头完成 7 类皮肤病变识别,并通过训练策略优化提高分类性能。第三,实现了实验评估与结果分析功能。系统能够输出准确率、召回率、Macro F1、混淆矩阵和类别错误率等指标,并通过消融实验分析不同策略对模型效果的影响。第四,实现了在线预测与可视化展示功能。后端通过 /predict 接口返回预测结果、Top-K 概率、输入预览图和概率图,前端通过实验总览和单图预测页面完成结果可视化展示。
因此,本文所设计的系统不仅完成了皮肤病变分类算法本身的实现,也形成了"数据输入---模型识别---结果输出---可视化展示"的完整应用闭环。这种实现方式既能够满足模型实验验证需求,也为后续皮肤病变辅助诊断系统的进一步扩展提供了基础。
图4-1 系统功能实现流程图
4.2 系统输入设计
本系统的输入对象主要包括两部分:一部分是模型训练阶段所需的标准化数据清单,另一部分是在线预测阶段由用户上传的单张皮肤镜图像。在训练与评估阶段,系统以 HAM10000_metadata.csv 和原始图像目录为基础输入,通过数据准备模块完成元数据清洗、标签标准化、图像路径绑定以及训练集、验证集、测试集划分,最终生成 metadata.parquet、train.csv、val.csv 和 test.csv 等标准化文件,作为后续训练与评估的正式输入。这样的设计能够保证训练数据来源统一、标签结构明确,并为模型训练提供稳定的数据基础。
在训练数据输入过程中,系统会根据 image_id 读取对应图像,并结合配置文件完成尺寸调整、归一化以及图像增强操作。训练集采用 Resize、Flip、Rotate、ColorJitter 和 Normalize 等增强策略,以提升样本多样性和模型鲁棒性;验证集和测试集则仅执行 Resize + Normalize,以保证评估结果的客观性。经过预处理后的图像最终被组织成可直接输入 PyTorch 模型的张量数据,并由 DataLoader 统一输出。
图4-2 系统输入处理流程图
在在线预测阶段,系统输入为用户通过前端上传的单张皮肤镜图像文件,接口形式为 multipart/form-data。与训练阶段不同,在线预测主要关注单张图像的即时处理与结果返回,因此系统在接收到图片后,会先完成格式读取和预处理,然后调用训练好的最佳权重模型进行前向推理。由于系统采用单图预测模式,用户在前端交互页面一次仅需上传一张图片即可完成识别,这种方式操作简单,适合皮肤病变分类的实际演示和应用展示场景。
从输入设计角度来看,本系统并不是简单接收一张原始图像,而是通过"原始文件接收---图像预处理---标准化张量构建"的过程,将多样化的输入统一映射为符合 DenseNet121 模型要求的数据形式,从而保证后续分类结果的稳定性和准确性。
4.3 系统输出结果设计
本系统的输出结果主要包括模型预测结果输出和可视化结果输出两个层面。在核心分类结果方面,系统通过 /predict 接口返回当前输入图像的预测类别、预测索引、置信度以及 Top-K 概率排序结果。其中,predicted_label 表示当前图像最可能对应的类别,confidence 表示 Top-1 预测概率,top_k 则用于展示多个候选类别及其对应概率,从而使用户不仅能看到最终结论,还能了解其他可能类别的分布情况。根据当前系统设计,前端展示使用的是聚合后的 4 类结果,而不是训练阶段的原始 7 类标签,这样更有利于页面展示和用户理解。
从返回数据结构来看,系统后端以 JSON 形式输出结果,接口示例中除类别和概率信息外,还包括 inference_time_ms、input_preview_path 和 probability_chart_path 等字段。其中,inference_time_ms 用于反映单次推理耗时,input_preview_path 指向输入图像预览文件,probability_chart_path 指向概率柱状图文件。通过这样的结构设计,系统不仅实现了分类结果返回,也为前端页面提供了可直接渲染的图像产物和统计信息。
在可视化输出层面,系统并不只是显示一个文字标签,而是通过前端看板和单图预测页面对实验结果和预测结果进行多维展示。实验总览页面通过 /dashboard/overview 接口获取主实验指标、当前模型信息、训练曲线图路径、混淆矩阵图路径和消融实验结果;单图预测页面则展示类别名称、置信度、Top-K 概率、输入图像预览和概率分布图。前端还支持图像点击放大和不同视图切换,使结果展示更直观、更易理解。
总体而言,本系统的输出结果设计具有两个特点:一方面,结果表达清晰,既能满足用户快速获取分类结论的需求,也能提供较完整的概率分布信息;另一方面,系统通过图表与图像可视化增强了结果的可解释性,使模型输出不再只是抽象数字,而是具有较强可读性的展示结果。
4.4 系统功能流程展示
从系统整体运行流程来看,本系统已经实现了从训练到在线预测、从接口服务到前端展示的完整功能链路。若从训练流程出发,系统首先由 prepare_data.py 生成标准化元数据和 train/val/test 划分清单,然后由 train.py 读取配置文件并构建 DataLoader,再通过 factory.py 构建 DenseNet121 模型、优化器和学习率调度器,接着由 engine.py 执行训练与验证,训练日志和曲线图通过 callbacks.py 输出,最佳权重则由 checkpoints.py 保存。该过程构成了系统的训练闭环。
在评估流程中,系统通过 evaluate.py 加载最佳 checkpoint,对验证集和测试集逐批执行推理,并计算分类报告、混淆矩阵和类别错误率等结果,随后由绘图模块输出图表,并将预测明细和评估报告写入对应目录。这一流程实现了模型效果的量化评估与分析。
在在线预测与展示流程中,用户首先通过前端页面上传单张皮肤镜图像,后端 /predict 接口接收该图像文件并完成预处理,然后调用已部署的最佳权重模型进行前向推理,生成预测类别、置信度、Top-K 概率以及输入预览图和概率分布图,最终将结果以 JSON 形式返回给前端。前端再根据返回内容将类别信息、概率图和图像预览显示在页面中。与此同时,实验总览页面通过 /dashboard/overview 接口拉取训练曲线、混淆矩阵和消融实验结果,从而形成算法训练结果与在线推理结果并行展示的功能结构。
因此,系统的整体功能流程可以概括为:原始数据整理与划分 → 图像预处理与增强 → DenseNet121 模型训练 → 验证与测试评估 → 最佳模型部署 → 前端上传图像 → 在线预测与结果展示。这一流程清晰体现了系统从算法实现到应用展示的完整闭环,也说明本文所设计的皮肤病变分类系统已经具备较为完整的工程实现能力。
第五章 系统实现 与测试
5.1 系统实现
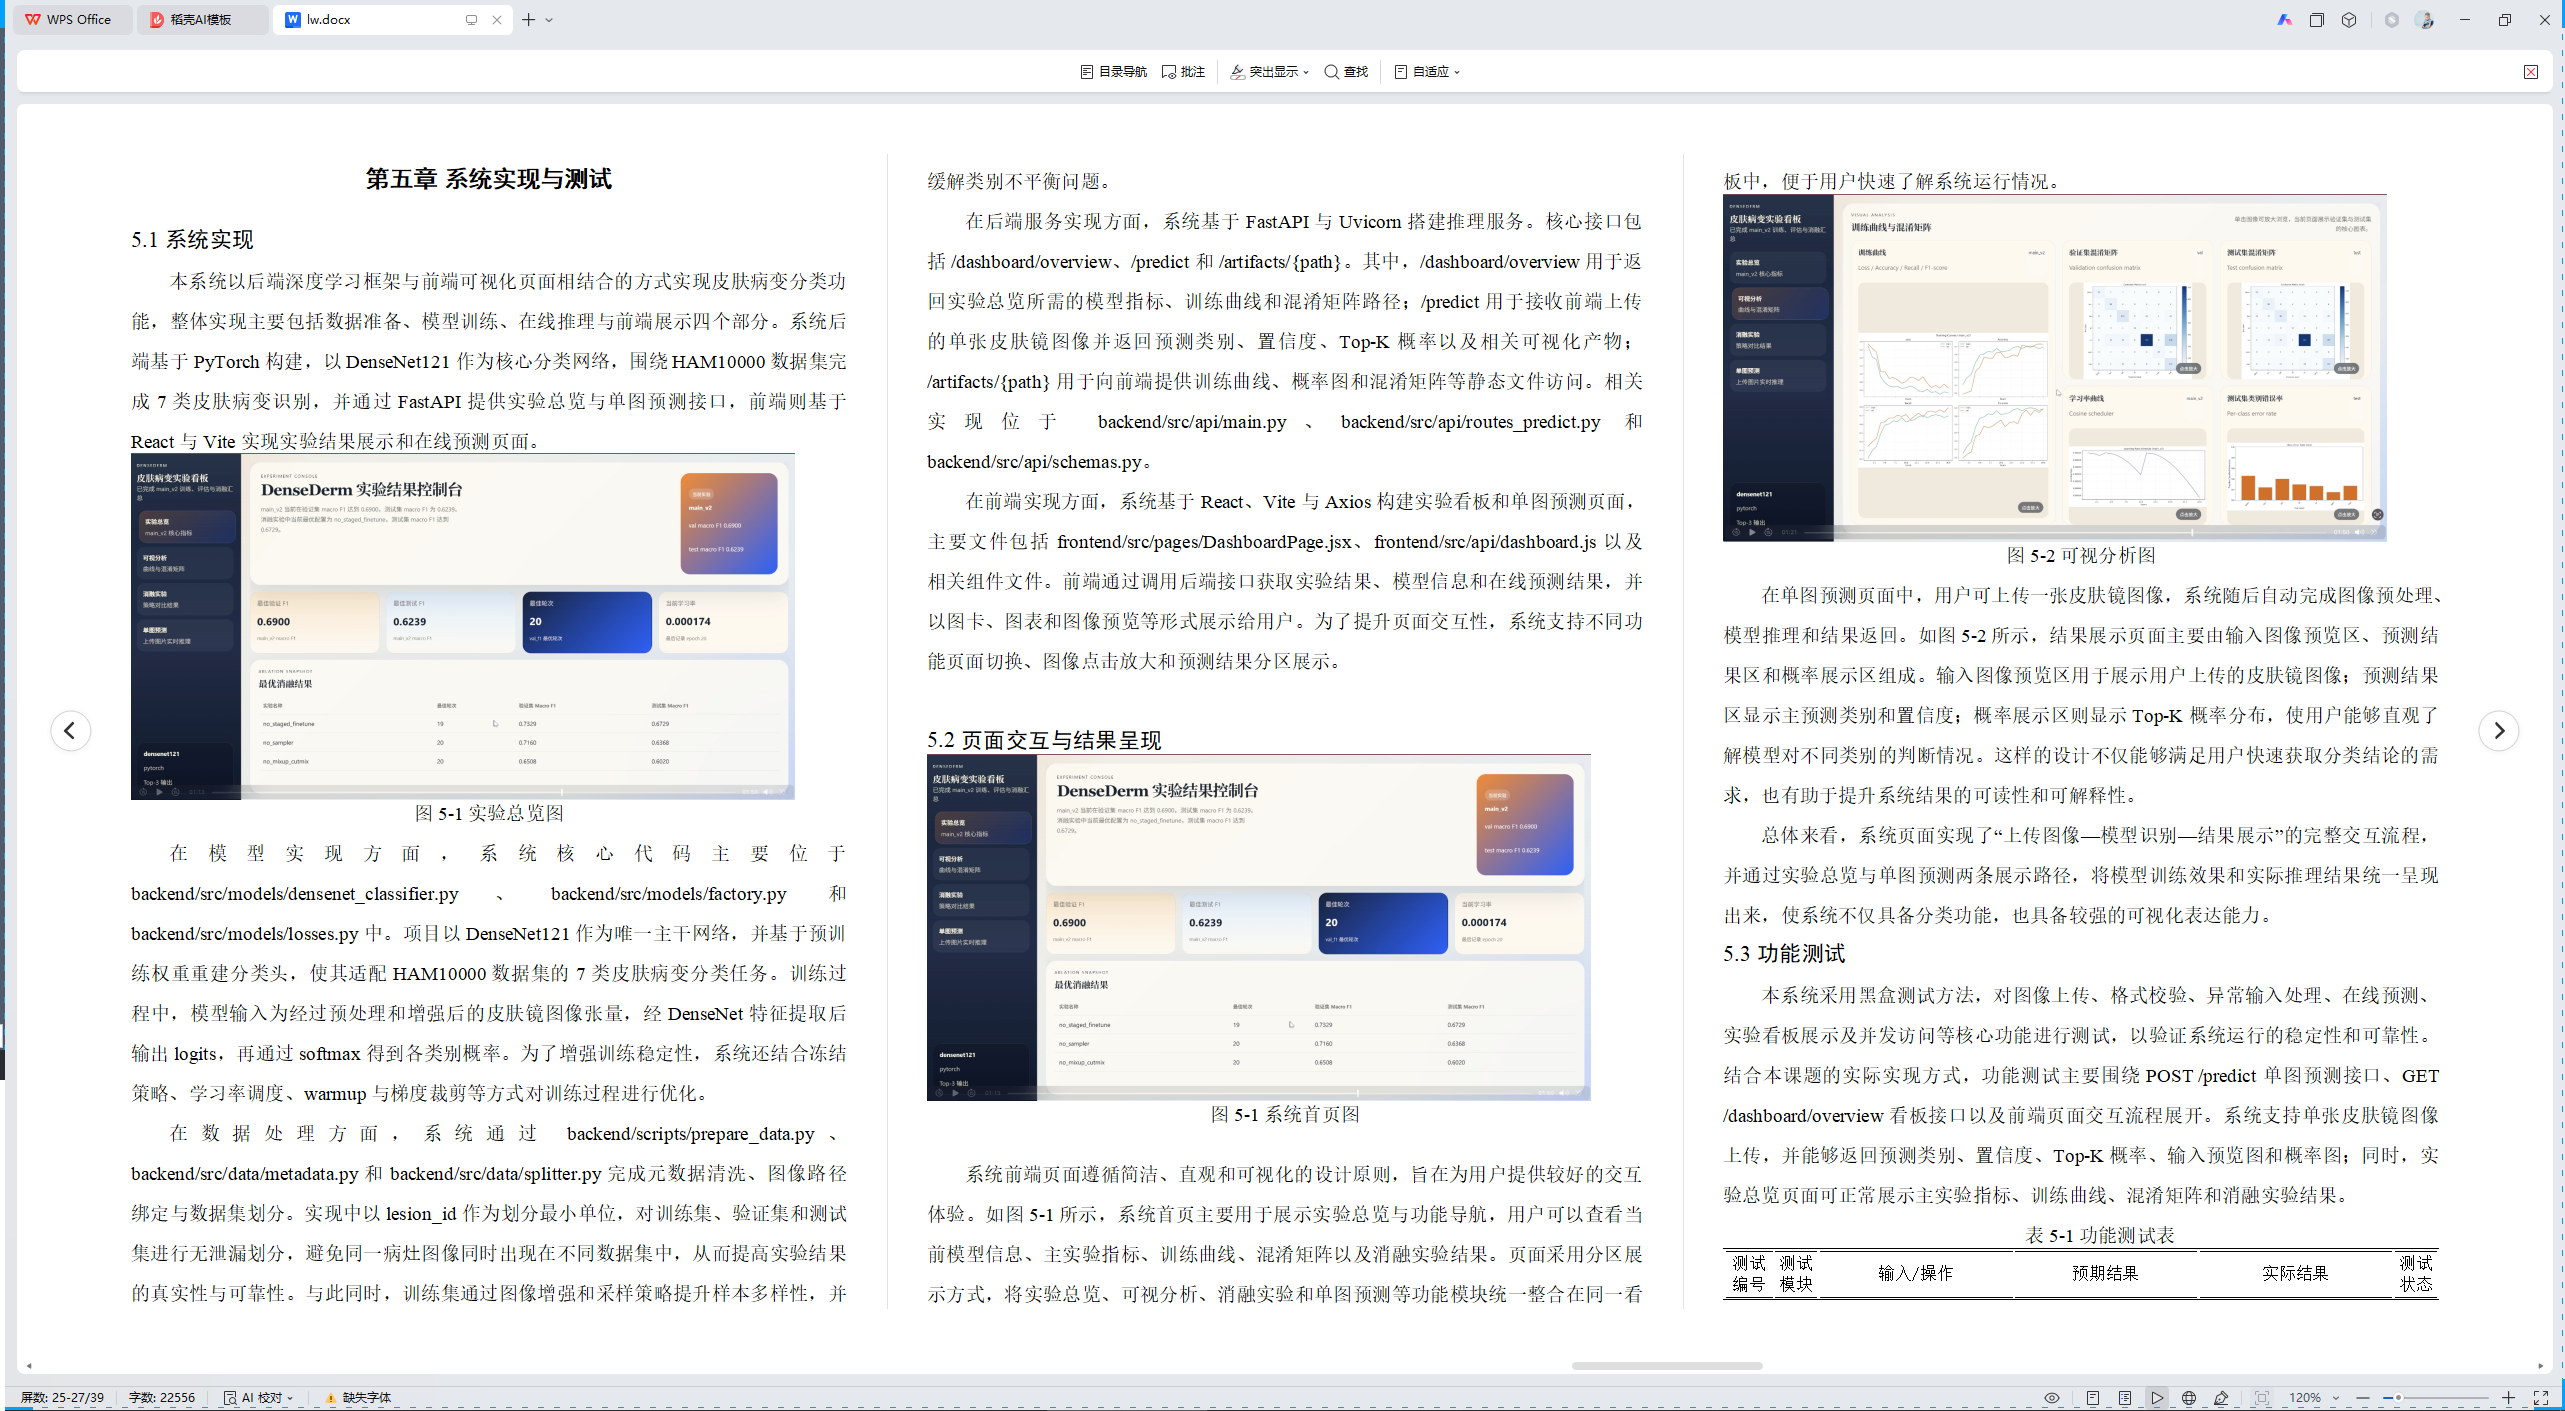
本系统以后端深度学习框架与前端可视化页面相结合的方式实现皮肤病变分类功能,整体实现主要包括数据准备、模型训练、在线推理与前端展示四个部分。系统后端基于 PyTorch 构建,以 DenseNet121 作为核心分类网络,围绕 HAM10000 数据集完成 7 类皮肤病变识别,并通过 FastAPI 提供实验总览与单图预测接口,前端则基于 React 与 Vite 实现实验结果展示和在线预测页面。
图5-1 实验总览图
在模型实现方面,系统核心代码主要位于 backend/src/models/densenet_classifier.py、backend/src/models/factory.py 和 backend/src/models/losses.py 中。项目以 DenseNet121 作为唯一主干网络,并基于预训练权重重建分类头,使其适配 HAM10000 数据集的 7 类皮肤病变分类任务。训练过程中,模型输入为经过预处理和增强后的皮肤镜图像张量,经 DenseNet 特征提取后输出 logits,再通过 softmax 得到各类别概率。为了增强训练稳定性,系统还结合冻结策略、学习率调度、warmup 与梯度裁剪等方式对训练过程进行优化。
在数据处理方面,系统通过 backend/scripts/prepare_data.py、backend/src/data/metadata.py 和 backend/src/data/splitter.py 完成元数据清洗、图像路径绑定与数据集划分。实现中以 lesion_id 作为划分最小单位,对训练集、验证集和测试集进行无泄漏划分,避免同一病灶图像同时出现在不同数据集中,从而提高实验结果的真实性与可靠性。与此同时,训练集通过图像增强和采样策略提升样本多样性,并缓解类别不平衡问题。
在后端服务实现方面,系统基于 FastAPI 与 Uvicorn 搭建推理服务。核心接口包括 /dashboard/overview、/predict 和 /artifacts/{path}。其中,/dashboard/overview 用于返回实验总览所需的模型指标、训练曲线和混淆矩阵路径;/predict 用于接收前端上传的单张皮肤镜图像并返回预测类别、置信度、Top-K 概率以及相关可视化产物;/artifacts/{path} 用于向前端提供训练曲线、概率图和混淆矩阵等静态文件访问。相关实现位于 backend/src/api/main.py、backend/src/api/routes_predict.py 和 backend/src/api/schemas.py。
在前端实现方面,系统基于 React、Vite 与 Axios 构建实验看板和单图预测页面,主要文件包括 frontend/src/pages/DashboardPage.jsx、frontend/src/api/dashboard.js 以及相关组件文件。前端通过调用后端接口获取实验结果、模型信息和在线预测结果,并以图卡、图表和图像预览等形式展示给用户。为了提升页面交互性,系统支持不同功能页面切换、图像点击放大和预测结果分区展示。
5.2 页面交互与结果呈现
图5-1 系统首页图
系统前端页面遵循简洁、直观和可视化的设计原则,旨在为用户提供较好的交互体验。如图5-1所示,系统首页主要用于展示实验总览与功能导航,用户可以查看当前模型信息、主实验指标、训练曲线、混淆矩阵以及消融实验结果。页面采用分区展示方式,将实验总览、可视分析、消融实验和单图预测等功能模块统一整合在同一看板中,便于用户快速了解系统运行情况。
图5-2 可视分析图
在单图预测页面中,用户可上传一张皮肤镜图像,系统随后自动完成图像预处理、模型推理和结果返回。如图5-2所示,结果展示页面主要由输入图像预览区、预测结果区和概率展示区组成。输入图像预览区用于展示用户上传的皮肤镜图像;预测结果区显示主预测类别和置信度;概率展示区则显示 Top-K 概率分布,使用户能够直观了解模型对不同类别的判断情况。这样的设计不仅能够满足用户快速获取分类结论的需求,也有助于提升系统结果的可读性和可解释性。
总体来看,系统页面实现了"上传图像---模型识别---结果展示"的完整交互流程,并通过实验总览与单图预测两条展示路径,将模型训练效果和实际推理结果统一呈现出来,使系统不仅具备分类功能,也具备较强的可视化表达能力。
5.3 功能测试
本系统采用黑盒测试方法,对图像上传、格式校验、异常输入处理、在线预测、实验看板展示及并发访问等核心功能进行测试,以验证系统运行的稳定性和可靠性。结合本课题的实际实现方式,功能测试主要围绕 POST /predict 单图预测接口、GET /dashboard/overview 看板接口以及前端页面交互流程展开。系统支持单张皮肤镜图像上传,并能够返回预测类别、置信度、Top-K 概率、输入预览图和概率图;同时,实验总览页面可正常展示主实验指标、训练曲线、混淆矩阵和消融实验结果。
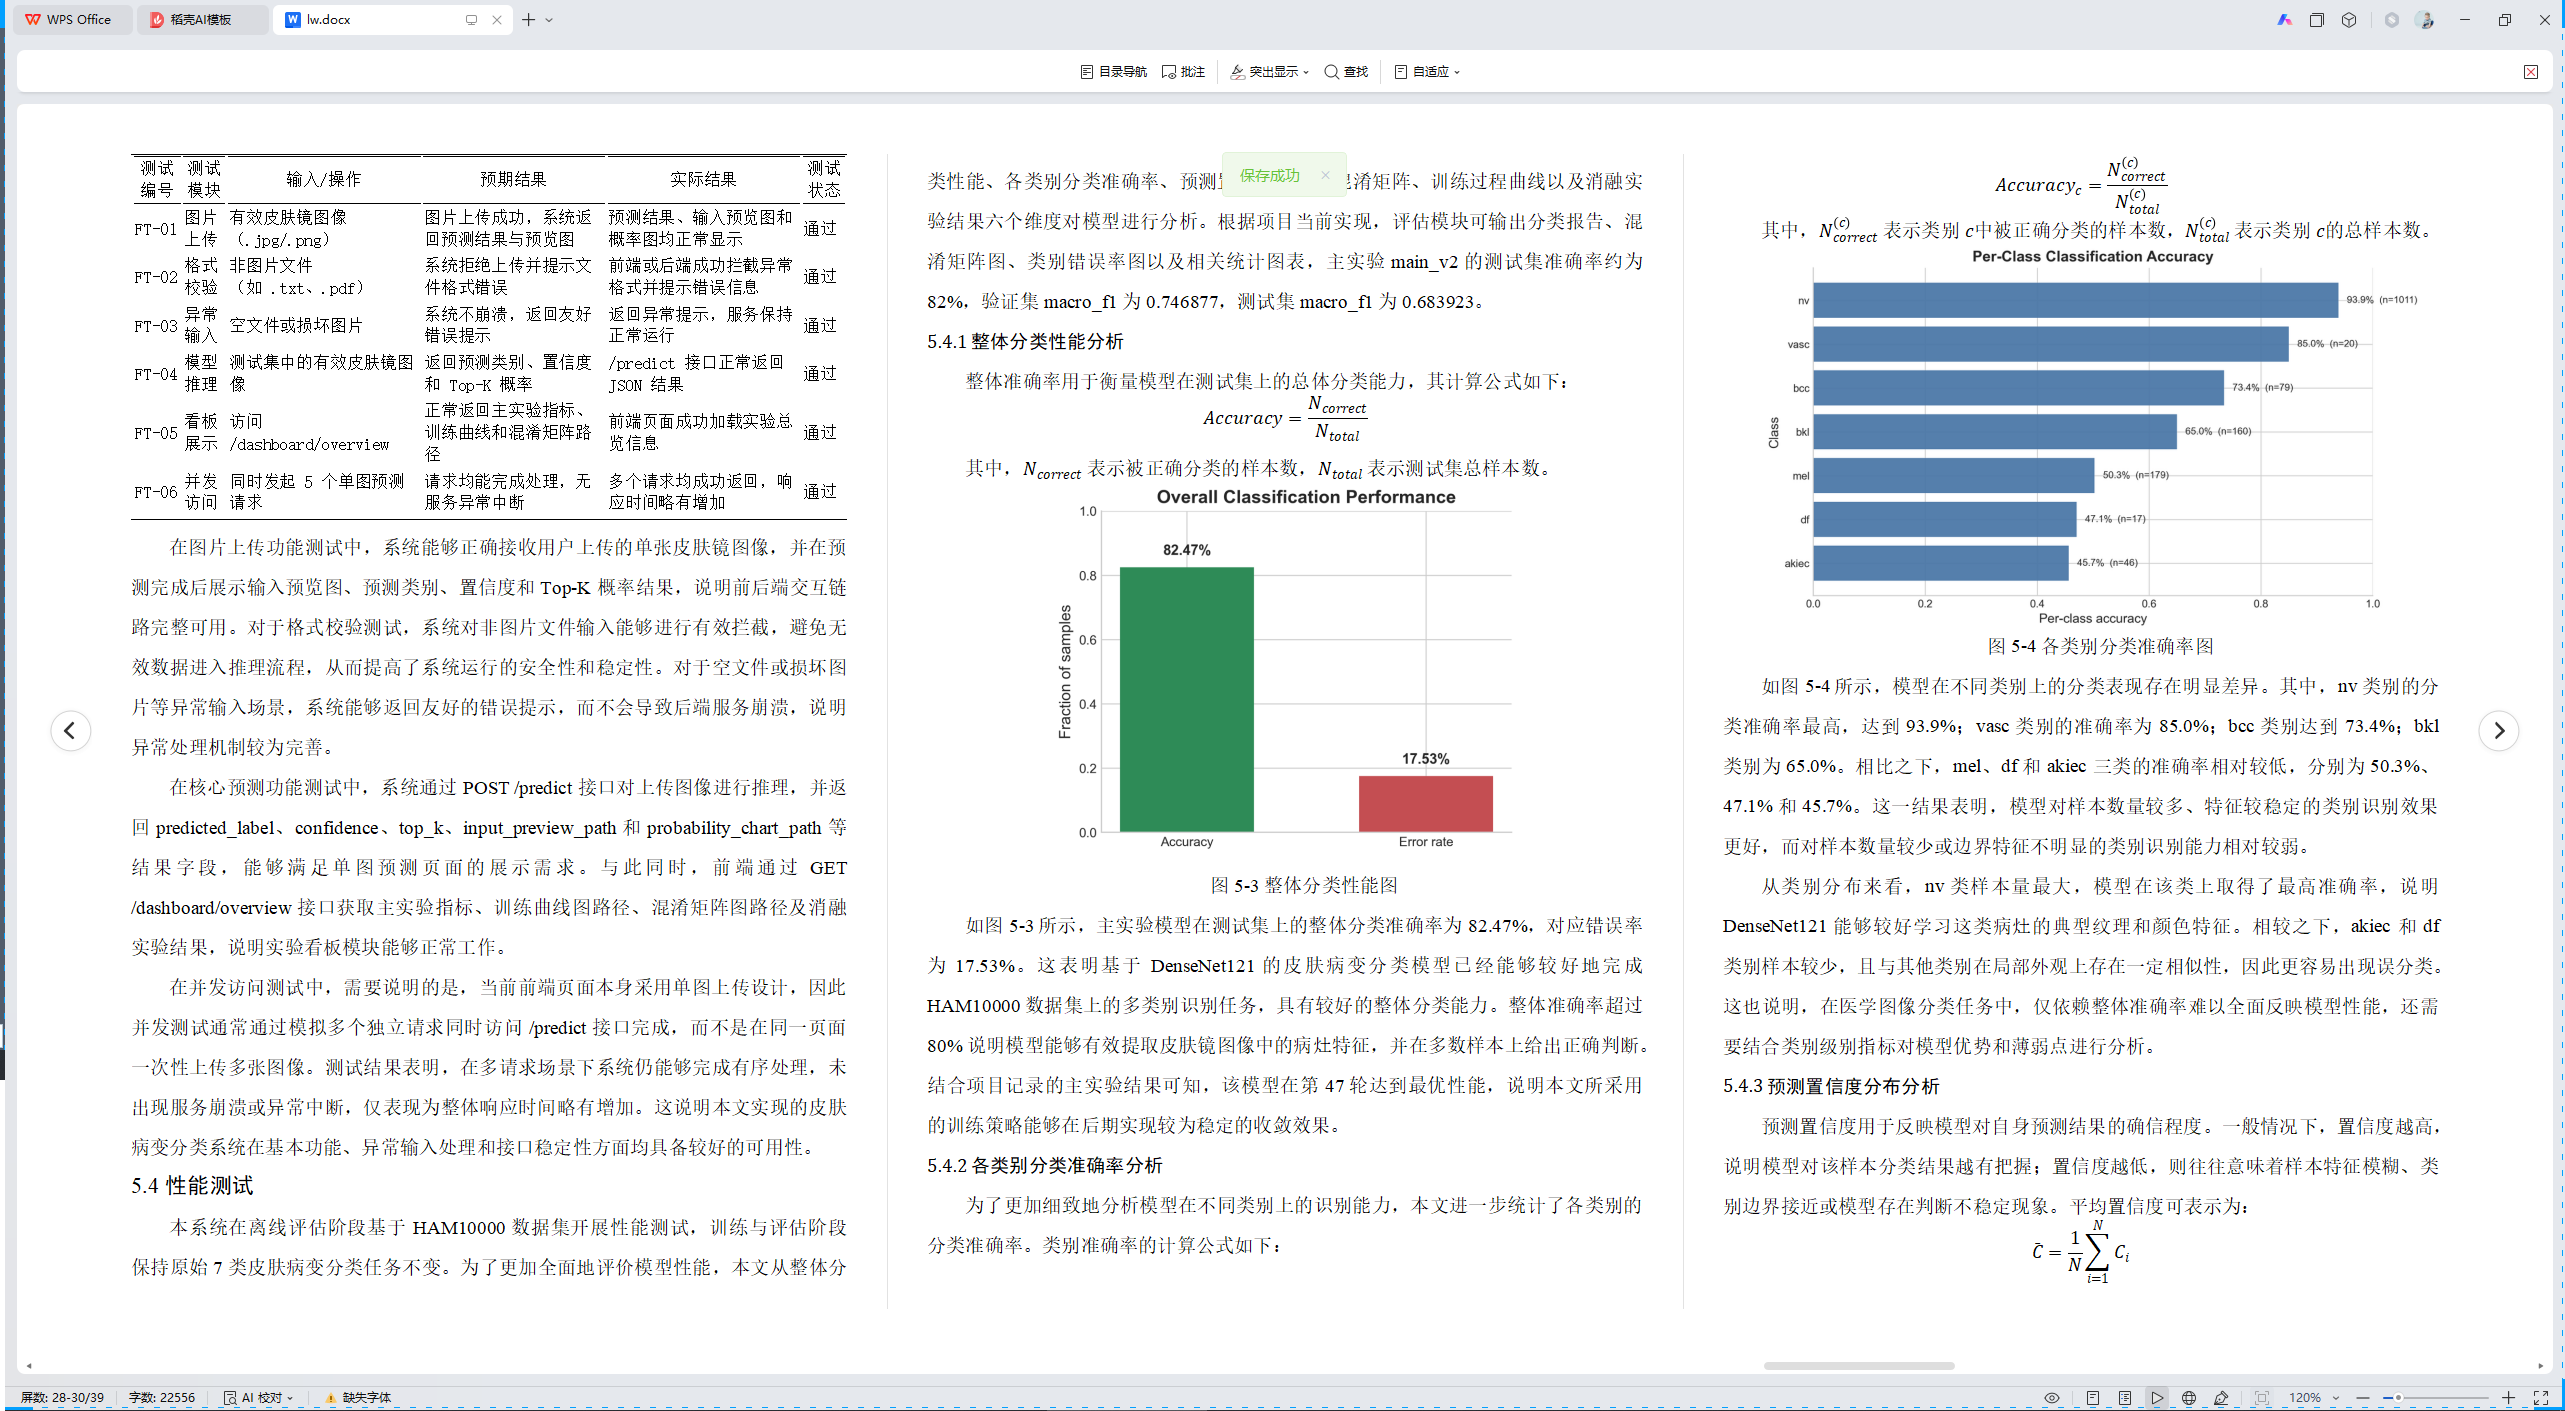
表5-1 功能测试表
|-------|------|------------------------|-----------------------|-------------------------|------|
| 测试编号 | 测试模块 | 输入/操作 | 预期结果 | 实际结果 | 测试状态 |
| FT-01 | 图片上传 | 有效皮肤镜图像(.jpg/.png) | 图片上传成功,系统返回预测结果与预览图 | 预测结果、输入预览图和概率图均正常显示 | 通过 |
| FT-02 | 格式校验 | 非图片文件(如 .txt、.pdf) | 系统拒绝上传并提示文件格式错误 | 前端或后端成功拦截异常格式并提示错误信息 | 通过 |
| FT-03 | 异常输入 | 空文件或损坏图片 | 系统不崩溃,返回友好错误提示 | 返回异常提示,服务保持正常运行 | 通过 |
| FT-04 | 模型推理 | 测试集中的有效皮肤镜图像 | 返回预测类别、置信度和 Top-K 概率 | /predict 接口正常返回 JSON 结果 | 通过 |
| FT-05 | 看板展示 | 访问 /dashboard/overview | 正常返回主实验指标、训练曲线和混淆矩阵路径 | 前端页面成功加载实验总览信息 | 通过 |
| FT-06 | 并发访问 | 同时发起 5 个单图预测请求 | 请求均能完成处理,无服务异常中断 | 多个请求均成功返回,响应时间略有增加 | 通过 |
在图片上传功能测试中,系统能够正确接收用户上传的单张皮肤镜图像,并在预测完成后展示输入预览图、预测类别、置信度和 Top-K 概率结果,说明前后端交互链路完整可用。对于格式校验测试,系统对非图片文件输入能够进行有效拦截,避免无效数据进入推理流程,从而提高了系统运行的安全性和稳定性。对于空文件或损坏图片等异常输入场景,系统能够返回友好的错误提示,而不会导致后端服务崩溃,说明异常处理机制较为完善。
在核心预测功能测试中,系统通过 POST /predict 接口对上传图像进行推理,并返回 predicted_label、confidence、top_k、input_preview_path 和 probability_chart_path 等结果字段,能够满足单图预测页面的展示需求。与此同时,前端通过 GET /dashboard/overview 接口获取主实验指标、训练曲线图路径、混淆矩阵图路径及消融实验结果,说明实验看板模块能够正常工作。
在并发访问测试中,需要说明的是,当前前端页面本身采用单图上传设计,因此并发测试通常通过模拟多个独立请求同时访问 /predict 接口完成,而不是在同一页面一次性上传多张图像。测试结果表明,在多请求场景下系统仍能够完成有序处理,未出现服务崩溃或异常中断,仅表现为整体响应时间略有增加。这说明本文实现的皮肤病变分类系统在基本功能、异常输入处理和接口稳定性方面均具备较好的可用性。
5.4 性能测试
本系统在离线评估阶段基于 HAM10000 数据集开展性能测试,训练与评估阶段保持原始 7 类皮肤病变分类任务不变。为了更加全面地评价模型性能,本文从整体分类性能、各类别分类准确率、预测置信度分布、混淆矩阵、训练过程曲线以及消融实验结果六个维度对模型进行分析。根据项目当前实现,评估模块可输出分类报告、混淆矩阵图、类别错误率图以及相关统计图表,主实验 main_v2 的测试集准确率约为 82%,验证集 macro_f1 为 0.746877,测试集 macro_f1 为 0.683923。
5.4.1 整体分类性能分析
整体准确率用于衡量模型在测试集上的总体分类能力,其计算公式如下:
其中, 表示被正确分类的样本数, 表示测试集总样本数。
图5-3 整体分类性能图
如图5-3所示,主实验模型在测试集上的整体分类准确率为 82.47%,对应错误率为 17.53%。这表明基于 DenseNet121 的皮肤病变分类模型已经能够较好地完成 HAM10000 数据集上的多类别识别任务,具有较好的整体分类能力。整体准确率超过 80% 说明模型能够有效提取皮肤镜图像中的病灶特征,并在多数样本上给出正确判断。结合项目记录的主实验结果可知,该模型在第 47 轮达到最优性能,说明本文所采用的训练策略能够在后期实现较为稳定的收敛效果。
5.4.2 各类别分类准确率分析
为了更加细致地分析模型在不同类别上的识别能力,本文进一步统计了各类别的分类准确率。类别准确率的计算公式如下:
其中, 表示类别 中被正确分类的样本数, 表示类别 的总样本数。
图5-4 各类别分类准确率图
如图5-4所示,模型在不同类别上的分类表现存在明显差异。其中,nv 类别的分类准确率最高,达到 93.9%;vasc 类别的准确率为 85.0%;bcc 类别达到 73.4%;bkl 类别为 65.0%。相比之下,mel、df 和 akiec 三类的准确率相对较低,分别为 50.3%、47.1% 和 45.7%。这一结果表明,模型对样本数量较多、特征较稳定的类别识别效果更好,而对样本数量较少或边界特征不明显的类别识别能力相对较弱。
从类别分布来看,nv 类样本量最大,模型在该类上取得了最高准确率,说明 DenseNet121 能够较好学习这类病灶的典型纹理和颜色特征。相较之下,akiec 和 df 类别样本较少,且与其他类别在局部外观上存在一定相似性,因此更容易出现误分类。这也说明,在医学图像分类任务中,仅依赖整体准确率难以全面反映模型性能,还需要结合类别级别指标对模型优势和薄弱点进行分析。
5.4.3 预测置信度分布分析
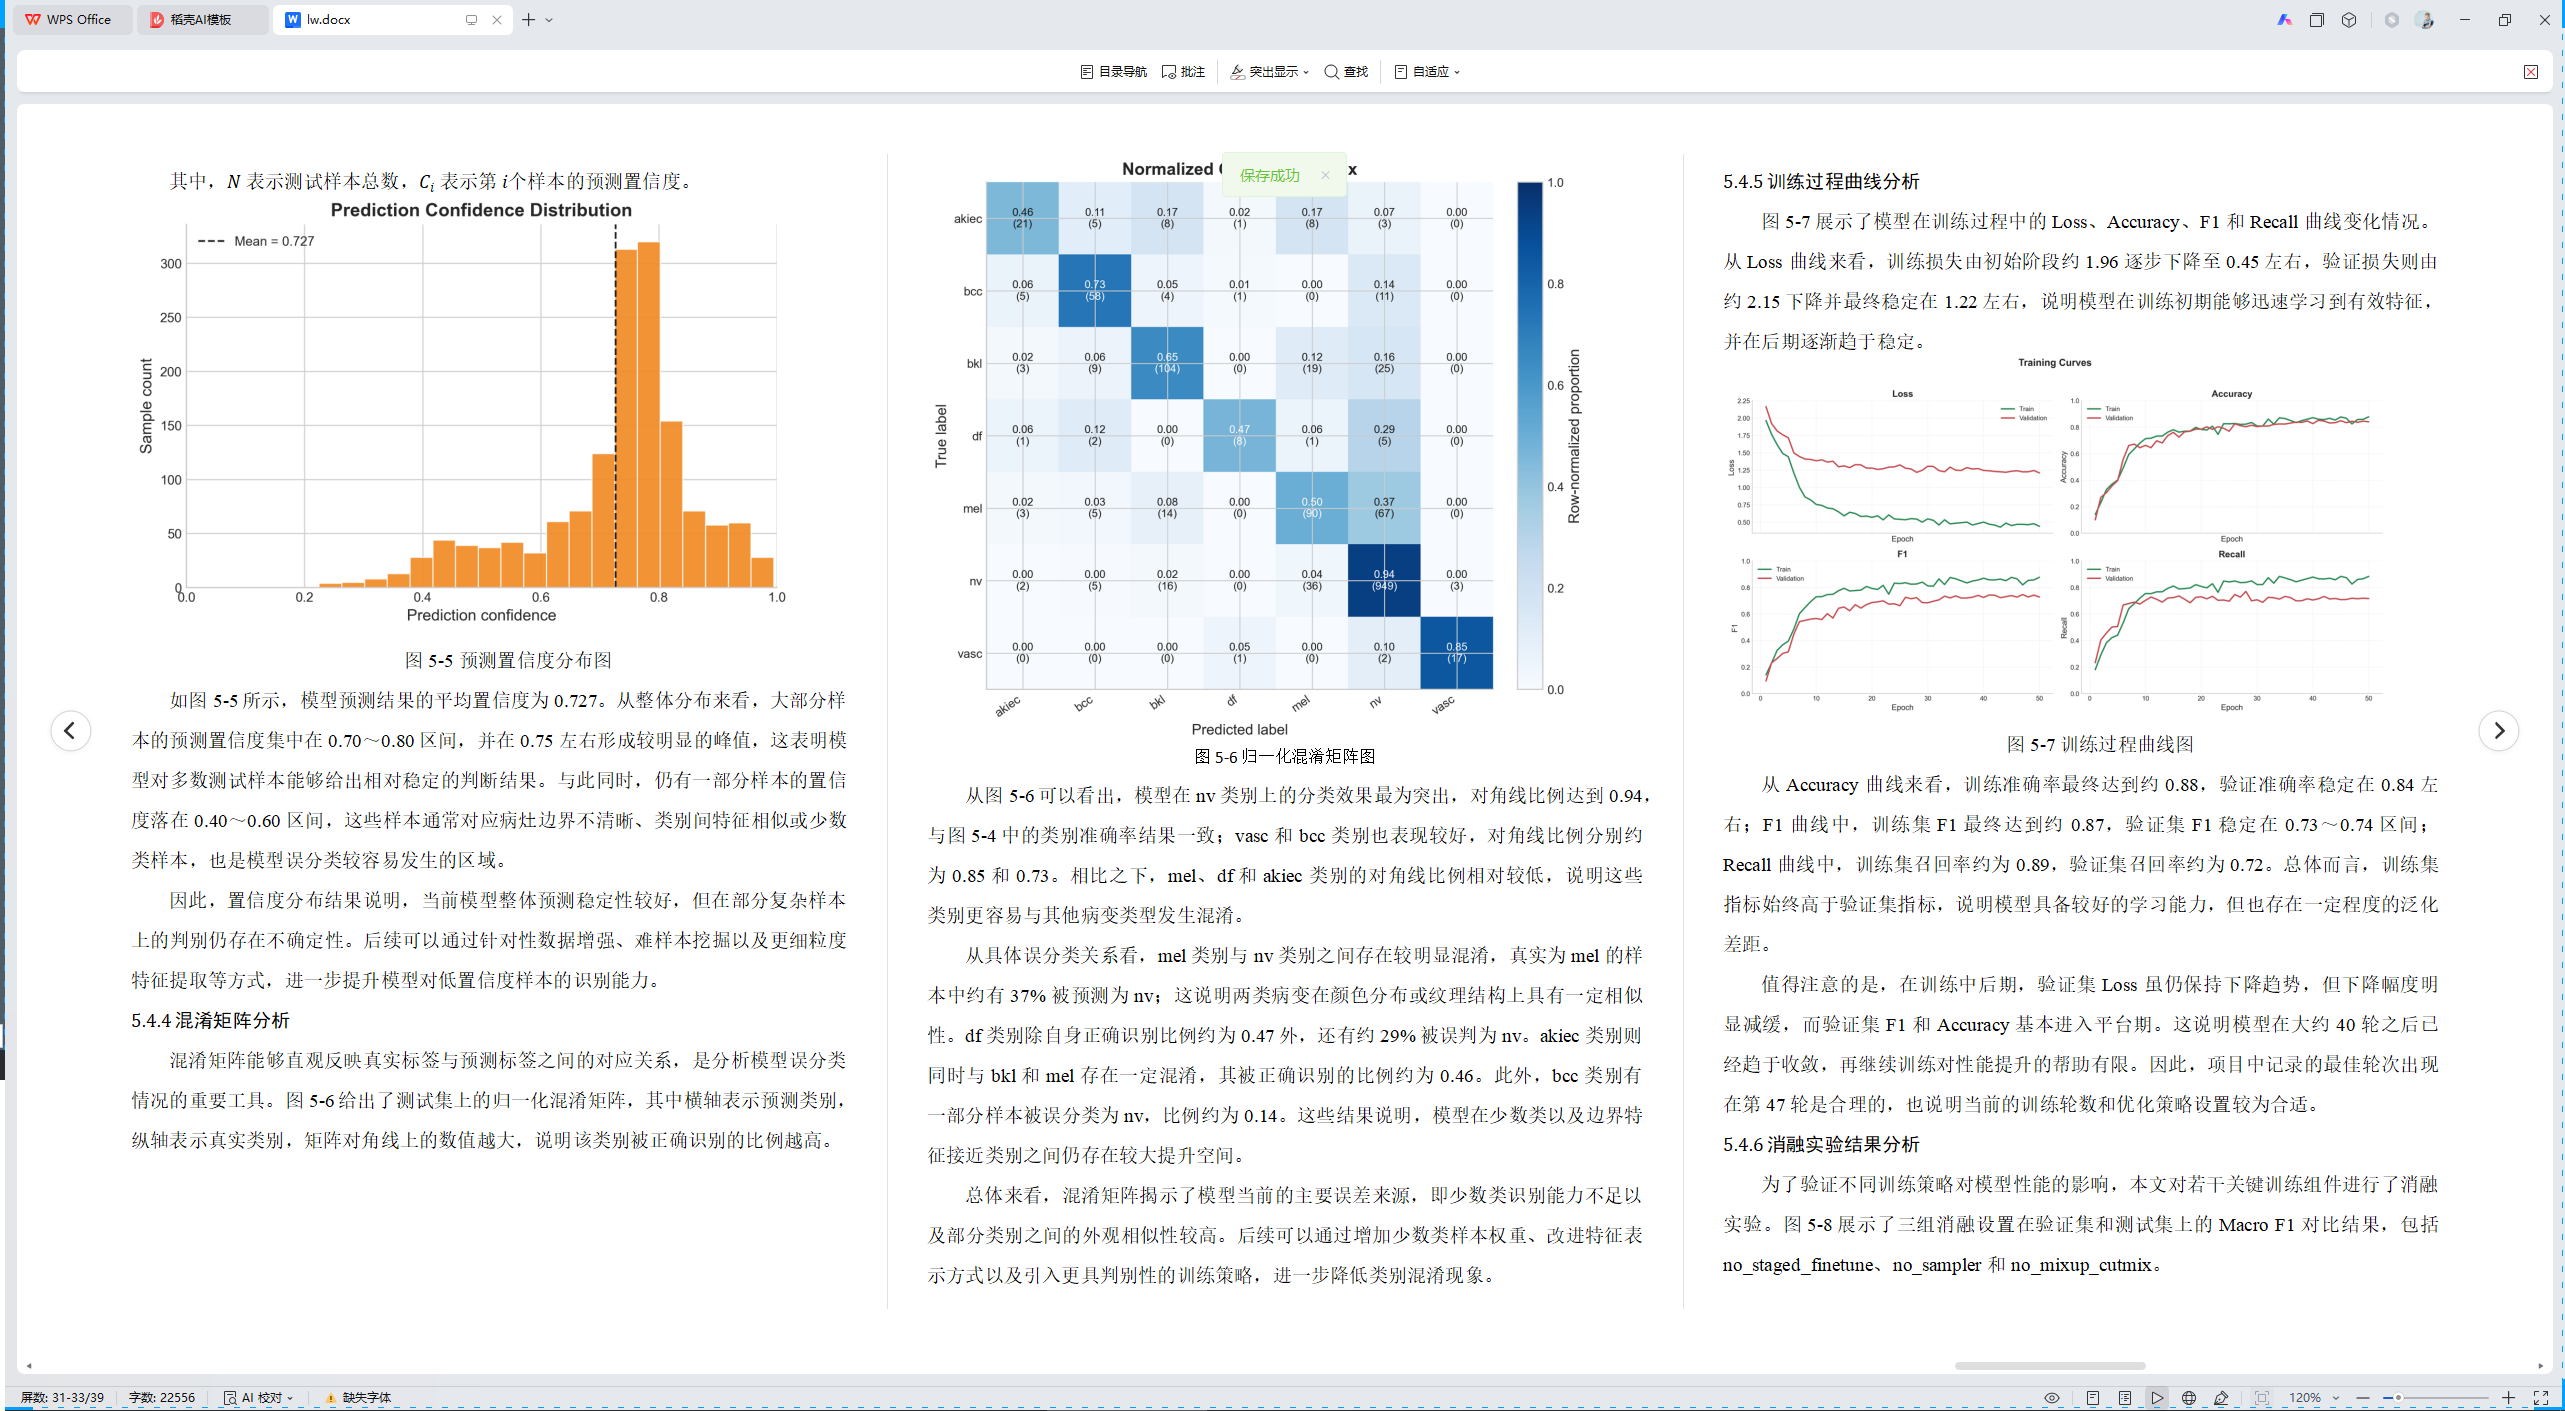
预测置信度用于反映模型对自身预测结果的确信程度。一般情况下,置信度越高,说明模型对该样本分类结果越有把握;置信度越低,则往往意味着样本特征模糊、类别边界接近或模型存在判断不稳定现象。平均置信度可表示为:
其中, 表示测试样本总数, 表示第 个样本的预测置信度。
图5-5 预测置信度分布图
如图5-5所示,模型预测结果的平均置信度为 0.727。从整体分布来看,大部分样本的预测置信度集中在 0.70~0.80 区间,并在 0.75 左右形成较明显的峰值,这表明模型对多数测试样本能够给出相对稳定的判断结果。与此同时,仍有一部分样本的置信度落在 0.40~0.60 区间,这些样本通常对应病灶边界不清晰、类别间特征相似或少数类样本,也是模型误分类较容易发生的区域。
因此,置信度分布结果说明,当前模型整体预测稳定性较好,但在部分复杂样本上的判别仍存在不确定性。后续可以通过针对性数据增强、难样本挖掘以及更细粒度特征提取等方式,进一步提升模型对低置信度样本的识别能力。
5.4.4 混淆矩阵分析
混淆矩阵能够直观反映真实标签与预测标签之间的对应关系,是分析模型误分类情况的重要工具。图5-6给出了测试集上的归一化混淆矩阵,其中横轴表示预测类别,纵轴表示真实类别,矩阵对角线上的数值越大,说明该类别被正确识别的比例越高。
图5-6 归一化混淆矩阵图
从图5-6可以看出,模型在 nv 类别上的分类效果最为突出,对角线比例达到 0.94,与图5-4中的类别准确率结果一致;vasc 和 bcc 类别也表现较好,对角线比例分别约为 0.85 和 0.73。相比之下,mel、df 和 akiec 类别的对角线比例相对较低,说明这些类别更容易与其他病变类型发生混淆。
从具体误分类关系看,mel 类别与 nv 类别之间存在较明显混淆,真实为 mel 的样本中约有 37% 被预测为 nv;这说明两类病变在颜色分布或纹理结构上具有一定相似性。df 类别除自身正确识别比例约为 0.47 外,还有约 29% 被误判为 nv。akiec 类别则同时与 bkl 和 mel 存在一定混淆,其被正确识别的比例约为 0.46。此外,bcc 类别有一部分样本被误分类为 nv,比例约为 0.14。这些结果说明,模型在少数类以及边界特征接近类别之间仍存在较大提升空间。
总体来看,混淆矩阵揭示了模型当前的主要误差来源,即少数类识别能力不足以及部分类别之间的外观相似性较高。后续可以通过增加少数类样本权重、改进特征表示方式以及引入更具判别性的训练策略,进一步降低类别混淆现象。
5.4.5 训练过程曲线分析
图5-7展示了模型在训练过程中的 Loss、Accuracy、F1 和 Recall 曲线变化情况。从 Loss 曲线来看,训练损失由初始阶段约 1.96 逐步下降至 0.45 左右,验证损失则由约 2.15 下降并最终稳定在 1.22 左右,说明模型在训练初期能够迅速学习到有效特征,并在后期逐渐趋于稳定。
图5-7 训练过程曲线图
从 Accuracy 曲线来看,训练准确率最终达到约 0.88,验证准确率稳定在 0.84 左右;F1 曲线中,训练集 F1 最终达到约 0.87,验证集 F1 稳定在 0.73~0.74 区间;Recall 曲线中,训练集召回率约为 0.89,验证集召回率约为 0.72。总体而言,训练集指标始终高于验证集指标,说明模型具备较好的学习能力,但也存在一定程度的泛化差距。
值得注意的是,在训练中后期,验证集 Loss 虽仍保持下降趋势,但下降幅度明显减缓,而验证集 F1 和 Accuracy 基本进入平台期。这说明模型在大约 40 轮之后已经趋于收敛,再继续训练对性能提升的帮助有限。因此,项目中记录的最佳轮次出现在第 47 轮是合理的,也说明当前的训练轮数和优化策略设置较为合适。
5.4.6 消融实验结果分析
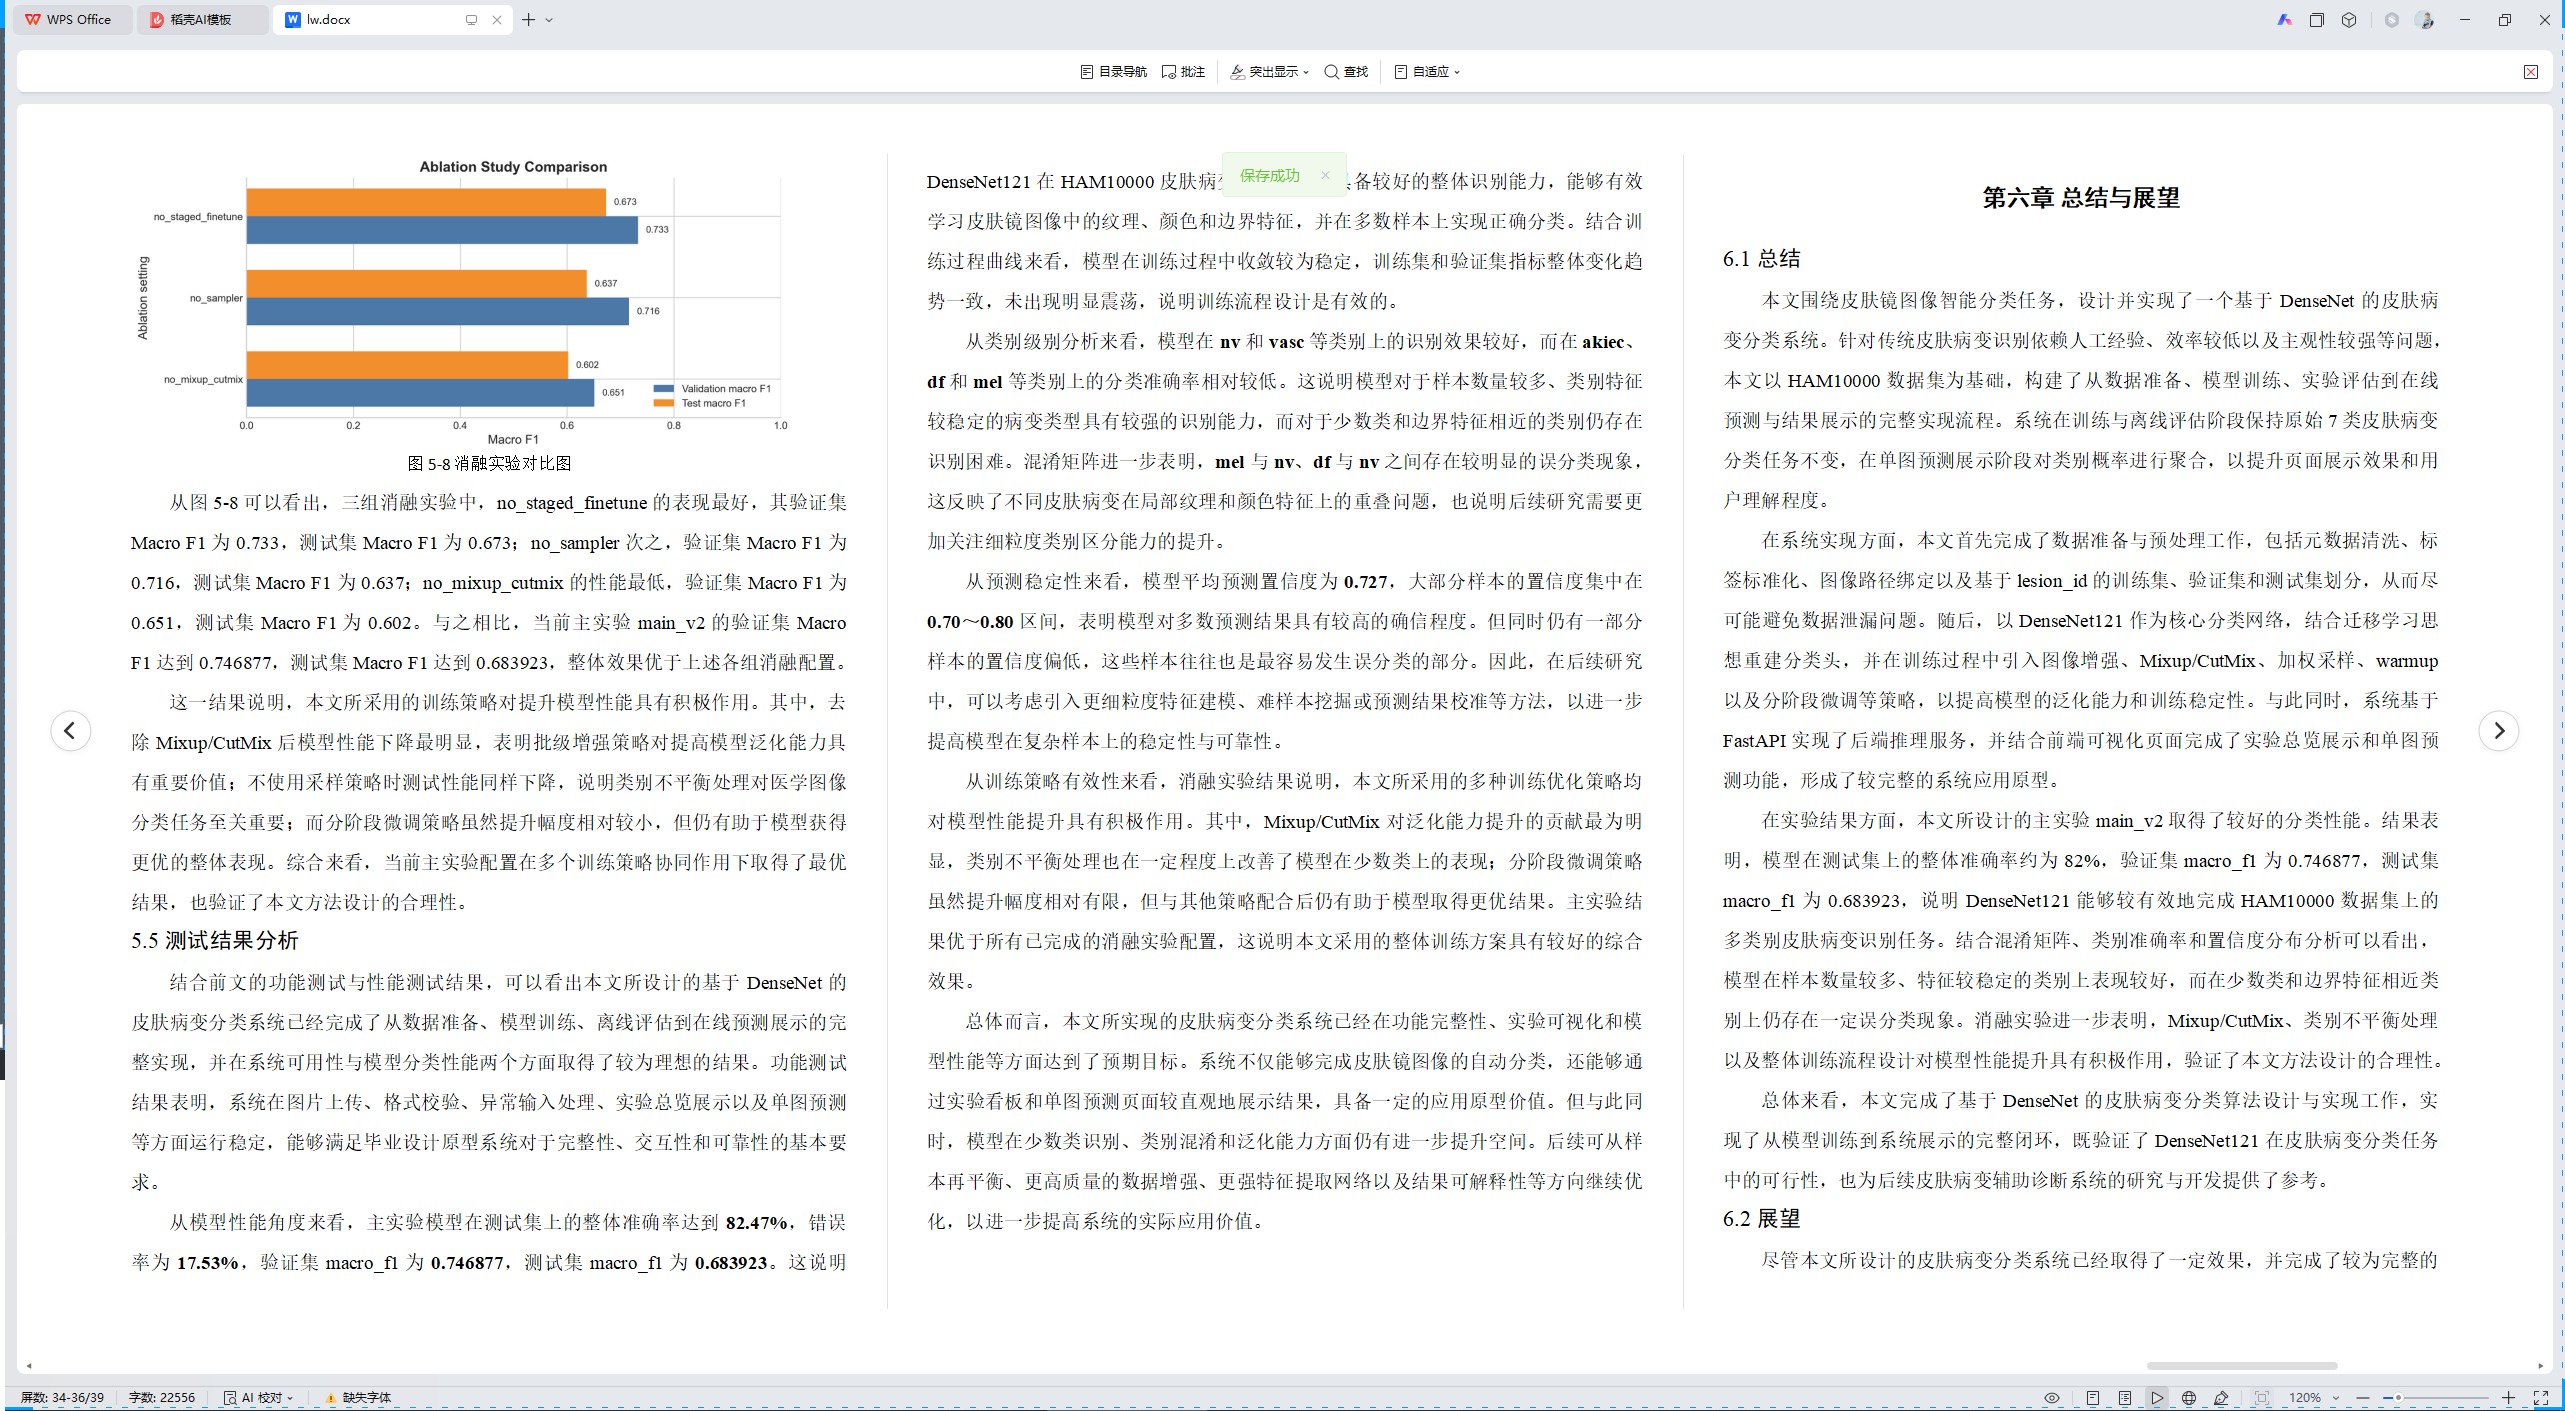
为了验证不同训练策略对模型性能的影响,本文对若干关键训练组件进行了消融实验。图5-8展示了三组消融设置在验证集和测试集上的 Macro F1 对比结果,包括 no_staged_finetune、no_sampler 和 no_mixup_cutmix。
图5-8 消融实验对比图
从图5-8可以看出,三组消融实验中,no_staged_finetune 的表现最好,其验证集 Macro F1 为 0.733,测试集 Macro F1 为 0.673;no_sampler 次之,验证集 Macro F1 为 0.716,测试集 Macro F1 为 0.637;no_mixup_cutmix 的性能最低,验证集 Macro F1 为 0.651,测试集 Macro F1 为 0.602。与之相比,当前主实验 main_v2 的验证集 Macro F1 达到 0.746877,测试集 Macro F1 达到 0.683923,整体效果优于上述各组消融配置。
这一结果说明,本文所采用的训练策略对提升模型性能具有积极作用。其中,去除 Mixup/CutMix 后模型性能下降最明显,表明批级增强策略对提高模型泛化能力具有重要价值;不使用采样策略时测试性能同样下降,说明类别不平衡处理对医学图像分类任务至关重要;而分阶段微调策略虽然提升幅度相对较小,但仍有助于模型获得更优的整体表现。综合来看,当前主实验配置在多个训练策略协同作用下取得了最优结果,也验证了本文方法设计的合理性。
5.5 测试结果分析
结合前文的功能测试与性能测试结果,可以看出本文所设计的基于 DenseNet 的皮肤病变分类系统已经完成了从数据准备、模型训练、离线评估到在线预测展示的完整实现,并在系统可用性与模型分类性能两个方面取得了较为理想的结果。功能测试结果表明,系统在图片上传、格式校验、异常输入处理、实验总览展示以及单图预测等方面运行稳定,能够满足毕业设计原型系统对于完整性、交互性和可靠性的基本要求。
从模型性能角度来看,主实验模型在测试集上的整体准确率达到 82.47% ,错误率为 17.53% ,验证集 macro_f1 为 0.746877 ,测试集 macro_f1 为 0.683923。这说明 DenseNet121 在 HAM10000 皮肤病变分类任务中具备较好的整体识别能力,能够有效学习皮肤镜图像中的纹理、颜色和边界特征,并在多数样本上实现正确分类。结合训练过程曲线来看,模型在训练过程中收敛较为稳定,训练集和验证集指标整体变化趋势一致,未出现明显震荡,说明训练流程设计是有效的。
从类别级别分析来看,模型在 nv 和 vasc 等类别上的识别效果较好,而在 akiec 、df 和 mel 等类别上的分类准确率相对较低。这说明模型对于样本数量较多、类别特征较稳定的病变类型具有较强的识别能力,而对于少数类和边界特征相近的类别仍存在识别困难。混淆矩阵进一步表明,mel 与 nv 、df 与 nv 之间存在较明显的误分类现象,这反映了不同皮肤病变在局部纹理和颜色特征上的重叠问题,也说明后续研究需要更加关注细粒度类别区分能力的提升。
从预测稳定性来看,模型平均预测置信度为 0.727 ,大部分样本的置信度集中在 0.70~0.80 区间,表明模型对多数预测结果具有较高的确信程度。但同时仍有一部分样本的置信度偏低,这些样本往往也是最容易发生误分类的部分。因此,在后续研究中,可以考虑引入更细粒度特征建模、难样本挖掘或预测结果校准等方法,以进一步提高模型在复杂样本上的稳定性与可靠性。
从训练策略有效性来看,消融实验结果说明,本文所采用的多种训练优化策略均对模型性能提升具有积极作用。其中,Mixup/CutMix 对泛化能力提升的贡献最为明显,类别不平衡处理也在一定程度上改善了模型在少数类上的表现;分阶段微调策略虽然提升幅度相对有限,但与其他策略配合后仍有助于模型取得更优结果。主实验结果优于所有已完成的消融实验配置,这说明本文采用的整体训练方案具有较好的综合效果。
总体而言,本文所实现的皮肤病变分类系统已经在功能完整性、实验可视化和模型性能等方面达到了预期目标。系统不仅能够完成皮肤镜图像的自动分类,还能够通过实验看板和单图预测页面较直观地展示结果,具备一定的应用原型价值。但与此同时,模型在少数类识别、类别混淆和泛化能力方面仍有进一步提升空间。后续可从样本再平衡、更高质量的数据增强、更强特征提取网络以及结果可解释性等方向继续优化,以进一步提高系统的实际应用价值。
第六章 总结与展望
6.1 总结
本文围绕皮肤镜图像智能分类任务,设计并实现了一个基于 DenseNet 的皮肤病变分类系统。针对传统皮肤病变识别依赖人工经验、效率较低以及主观性较强等问题,本文以 HAM10000 数据集为基础,构建了从数据准备、模型训练、实验评估到在线预测与结果展示的完整实现流程。系统在训练与离线评估阶段保持原始 7 类皮肤病变分类任务不变,在单图预测展示阶段对类别概率进行聚合,以提升页面展示效果和用户理解程度。
在系统实现方面,本文首先完成了数据准备与预处理工作,包括元数据清洗、标签标准化、图像路径绑定以及基于 lesion_id 的训练集、验证集和测试集划分,从而尽可能避免数据泄漏问题。随后,以 DenseNet121 作为核心分类网络,结合迁移学习思想重建分类头,并在训练过程中引入图像增强、Mixup/CutMix、加权采样、warmup 以及分阶段微调等策略,以提高模型的泛化能力和训练稳定性。与此同时,系统基于 FastAPI 实现了后端推理服务,并结合前端可视化页面完成了实验总览展示和单图预测功能,形成了较完整的系统应用原型。
在实验结果方面,本文所设计的主实验 main_v2 取得了较好的分类性能。结果表明,模型在测试集上的整体准确率约为 82%,验证集 macro_f1 为 0.746877,测试集 macro_f1 为 0.683923,说明 DenseNet121 能够较有效地完成 HAM10000 数据集上的多类别皮肤病变识别任务。结合混淆矩阵、类别准确率和置信度分布分析可以看出,模型在样本数量较多、特征较稳定的类别上表现较好,而在少数类和边界特征相近类别上仍存在一定误分类现象。消融实验进一步表明,Mixup/CutMix、类别不平衡处理以及整体训练流程设计对模型性能提升具有积极作用,验证了本文方法设计的合理性。
总体来看,本文完成了基于 DenseNet 的皮肤病变分类算法设计与实现工作,实现了从模型训练到系统展示的完整闭环,既验证了 DenseNet121 在皮肤病变分类任务中的可行性,也为后续皮肤病变辅助诊断系统的研究与开发提供了参考。
6.2 展望
尽管本文所设计的皮肤病变分类系统已经取得了一定效果,并完成了较为完整的工程实现,但仍存在进一步改进和扩展的空间。
首先,在模型性能方面,当前模型在少数类和边界特征相近类别上的识别能力仍有待提升。后续研究可以进一步从类别重平衡、难样本挖掘和更高质量的数据增强等角度进行优化,以增强模型对复杂样本和低频类别的判别能力。同时,也可以尝试引入更强的主干网络结构、注意力机制或多尺度特征融合方法,以提升模型对细粒度病灶特征的表达能力。
其次,在结果解释性方面,本文当前系统主要输出预测类别、置信度和概率分布,尚未对模型决策依据进行更深入说明。医学图像分类任务具有较强的应用敏感性,因此后续可引入 Grad-CAM 等可视化方法,对模型关注区域进行热力图展示,从而提高系统结果的可解释性,增强模型在辅助诊断场景中的参考价值。
再次,在系统应用层面,本文当前实现主要面向实验展示和单图预测,功能相对基础。后续可以考虑扩展批量预测、历史记录保存、用户管理、结果导出以及模型在线更新等功能,使系统更加接近实际应用场景。同时,也可以进一步优化后端推理效率,探索 ONNX 或其他轻量化部署方式,以提升系统响应速度和跨平台部署能力。
最后,在数据与任务扩展方面,本文主要基于 HAM10000 数据集开展研究,数据来源和场景仍具有一定局限性。未来可考虑结合更多来源的皮肤镜图像数据,扩大样本规模,提高模型泛化能力;也可以进一步研究多任务学习方法,将皮肤病变分类与病灶分割、风险评估等任务结合起来,从而提升系统在智能辅助诊断中的综合应用价值。