2026 年 9 月,AI 圈被一个"不会说话"的模型刷屏了。
它叫 Jev,由 TypeSafe AI 发布------创始人是前 OpenAI 研究员 Diogo Almeida,参与过 ChatGPT 的指令跟随方法。这个模型有个奇怪的特点:它一个 token 的文本都不会生成。
不聊天、不写文章、不写代码。你给它输入,它只返回一个数、一个选项、一个概率。
就是这样一款"哑巴模型",宣称比 GPT 快 193 倍、便宜 444 倍,而且零幻觉。
它是怎么做到的?答案藏在两个反直觉的设计里。
一、为什么传统 LLM 做决策又慢又贵
先看传统 LLM 是怎么"做一个决策"的。
假设你要让 GPT 判断"这条用户评论是好评还是差评"。它不会直接说"好评"。它得像写作文一样,一个字一个字往外蹦:
arduino
"这"
"这条"
"这条评"
"这条评论"
"这条评论是"
"这条评论是好"
"这条评论是好评"
一个 8 个字的答案,要跑 8 次模型推理,每次都要等上一个字蹦出来才能算下一个字。这种一个字一个字往外蹦的方式,叫自回归生成(autoregressive generation)。
更烦人的是,模型可能在蹦到第 5 个字的时候"改主意"了------前面生成的都白费。为了稳妥,实际工程里往往还要采样多次、投票表决(比如"让模型回答 8 次取多数"),成本直接乘 8。
结果就是:一个二选一的小决策,可能要花 3 秒到 329 秒,烧掉几千个 token。
用写一篇文章的力气,去回答一个是非题。 这就是传统 LLM 做决策的荒诞之处。
二、Jev 的第一刀:把"串行"改成"并行"
Jev 的核心设计,是把"一个字一个字蹦"换成"一次性全算出来"。
打个比方。传统 LLM 像一个学生,面对选择题时要在草稿纸上把每个选项的答案都写一遍,再挑一个。Jev 像一个练过多年速答的学生------所有选项在脑子里同时过一遍,直接报出"A 的可能性 73%,B 的 27%"。
技术上,Jev 的采样器是并行的:不生成任何 token,而是对所有候选答案一次性做评估,单次前向传播就吐出完整的概率分布。它官网的说法是"Generates all outputs in a single query"。
这就是它快的原因:选择题不再需要"写 8 个字",也不需要"回答 8 次投票"。一次前向,70 到 500 毫秒出结果。
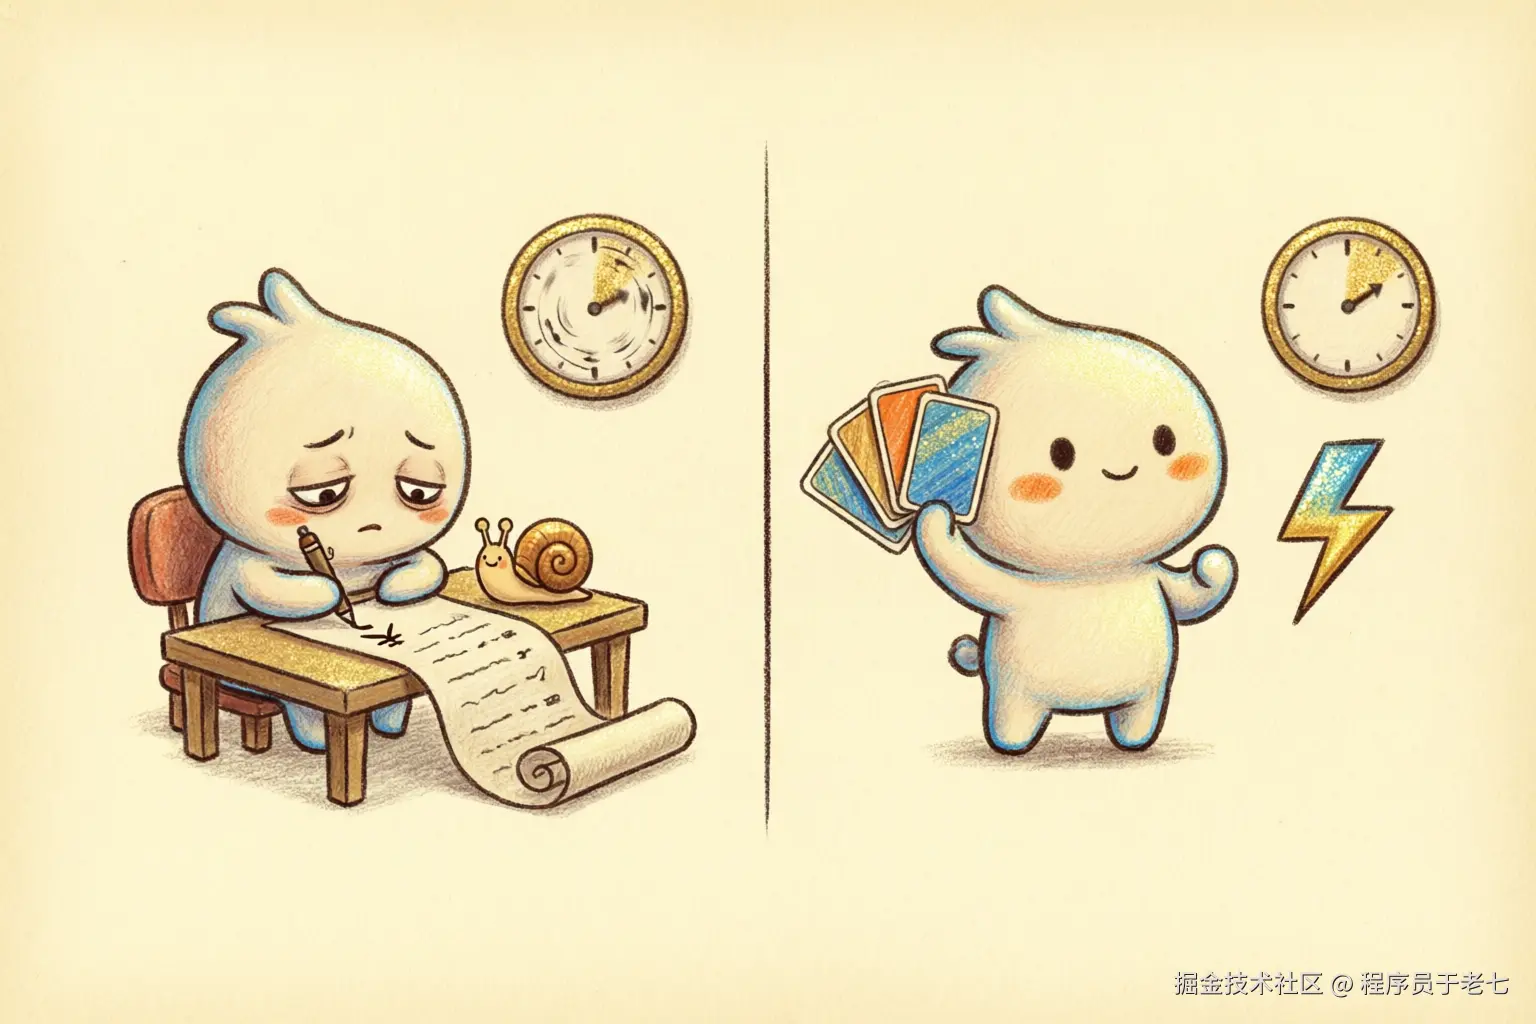
你的直觉"不就是换个 LLM 头吗"------对了一半。它确实把"文本生成头"换成了"并行决策头"。但这个"头"不是普通的分类层,它连着整个采样方式的改变:从自回归的串行生成 ,变成了并行评估。
三、Jev 的第二刀:从"讨好人类"到"概率要诚实"
光快还不够。传统 LLM 做决策还有个致命问题:它的概率不可信。
你问 GPT"这个判断你有几成把握",它说"九成"。但这个"九成"是它为了把话说得漂亮而生成的文字,不是真的统计过------实际正确率可能只有六成。这叫不校准(miscalibration):说九成把握,实际只有六成,你敢拿它做自动决策吗?
传统 LLM 的训练目标是什么?RLHF------强化学习对齐人类偏好。说白了就是让生成的文本人爱看:通顺、礼貌、自信。它不关心"说的概率和现实对不对得上"。
Jev 换了一个训练目标,叫 RLCD(Reinforcement Learning for Calibrated Decisions,面向校准决策的强化学习)。
校准是什么意思?一句话:模型说"八成把握"时,统计上就该有八成的正确率。
没校准的模型:说九成把握 → 实际对六成(嘴硬)
校准好的模型:说七成把握 → 实际就是七成(诚实)
RLCD 训练 Jev 的方式,就是反复用真实结果去检验它的概率预测。预测"80% 是好评论",就把大量真实评论拿来对答案------如果实际只有 60% 是好评论,就惩罚它。练到最后,模型输出的每一个概率,都是拿真实结果打磨过的、统计学意义上的诚实数字。
数学上,RLCD 的目标和 RLHF 有本质区别。
RLHF 的目标是最大化奖励模型的打分(人类觉得好不好):
scss
目标(RLHF) = 最大化 R(回答) ------ R 是奖励模型给的"人类偏好分"RLCD 的目标是让预测概率等于真实频率 (校准)。用的是统计学里一个老工具:恰当评分规则 (proper scoring rule)。它有个优雅的性质------只有诚实的模型才能拿到最高分,任何"虚报概率"的行为都会被数学惩罚。
对二元判断(Noul),就是交叉熵损失:
ini
损失 = −[ y·log(p) + (1−y)·log(1−p) ]

y = 真实结果(1 或 0)
p = 模型预测的概率
对多选一(Choice),推广成分类交叉熵:
css
损失 = −Σᵢ yᵢ·log(pᵢ)

yᵢ = 真实答案的 one-hot(正确选项为 1,其余为 0)
pᵢ = 模型给每个选项的概率
为什么这个损失能逼出"诚实"?看一个反例。模型预测"80% 是好评论",假设它想虚报成"95%"(显得更自信):
matlab
诚实报 80%:真实 80% 对、20% 错
  期望损失 = −[ 0.8·log(0.8) + 0.2·log(0.2) ] ≈ 0.50

虚报 95%:真实仍然是 80% 对、20% 错
  期望损失 = −[ 0.8·log(0.95) + 0.2·log(0.05) ] ≈ 0.64
虚报之后,损失从 0.50 涨到了 0.64。 嘴硬会被数学惩罚------这就是恰当评分规则的厉害之处:最优策略就是说实话。
校准的数学定义也因此变得清晰:
css
E[y | p] = p (在所有模型说过"概率为 p"的样本里,真实为 1 的比例恰好是 p)说人话:模型说过 100 次"80% 把握",统计下来就该有 80 次是对的。RLHF 训练的模型做不到这点(它只说人类爱听的话),RLCD 训练的 Jev 做到了。
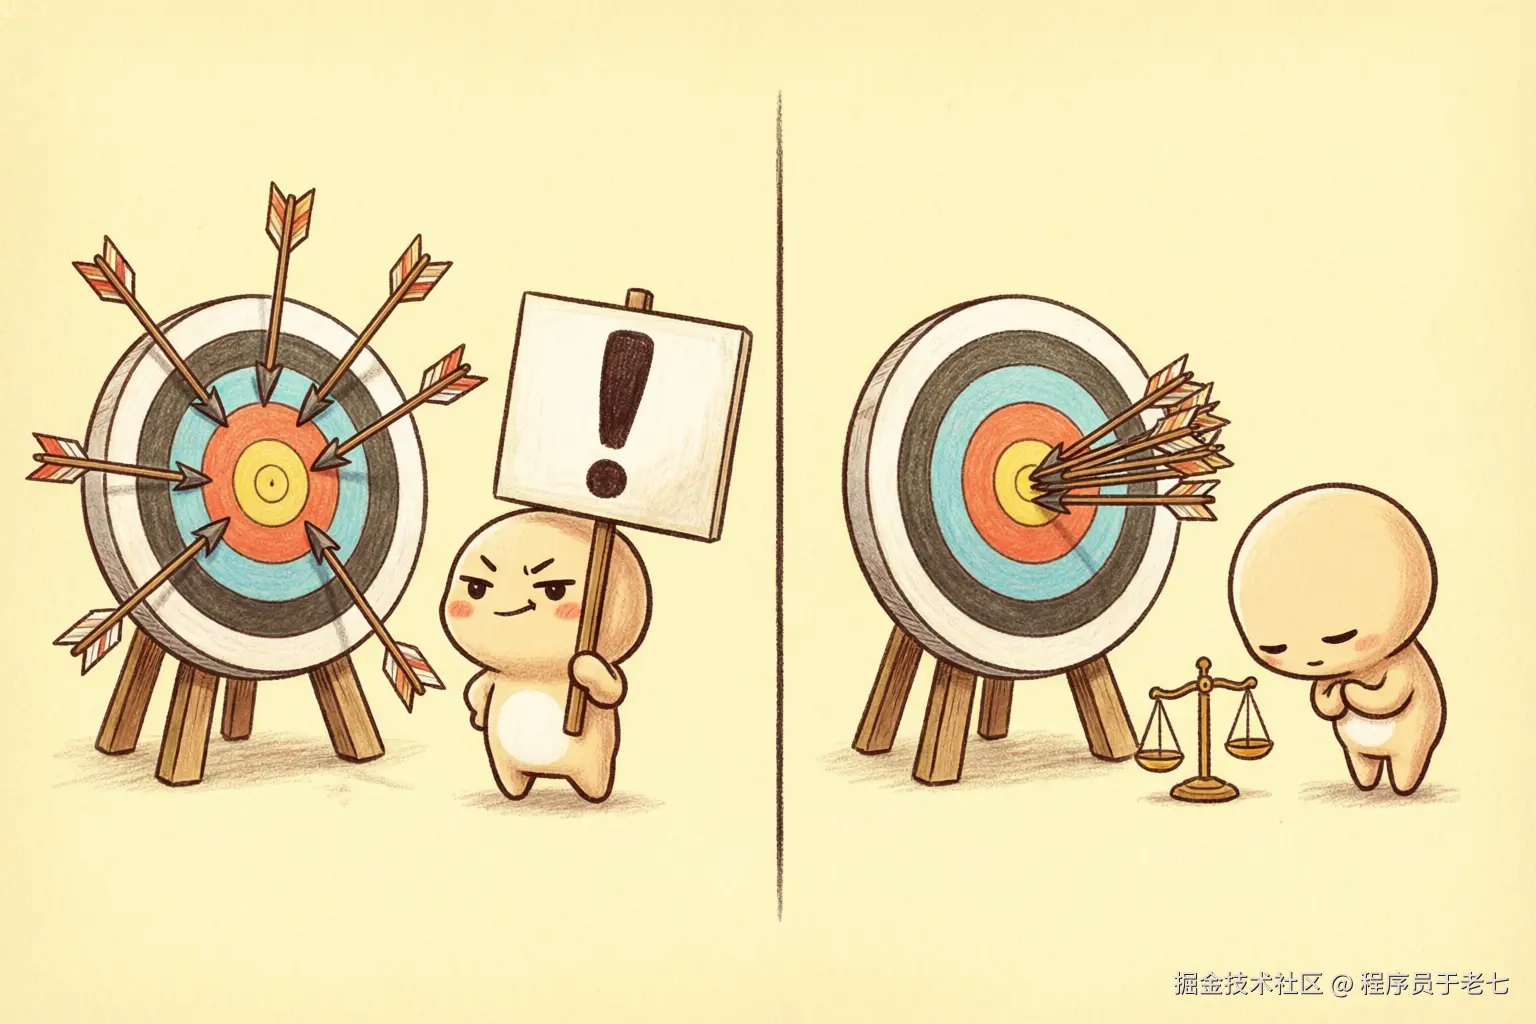
这个"诚实"是决策系统最珍贵的东西。因为有了可信的概率,调用方才能做分层处理:
erlang
置信度 95% → 直接自动执行
置信度 70% → 交给人工确认
置信度 50% → 升级给更强的模型重新判断
四、三个输出原语
Jev 的输出只有三种,都带着概率:
Noul(二元判断):"是/否" + 一个 0 到 1 的概率。
Choice(多选一):选中项 + 完整概率分布 + 置信度。比如把 10 条候选回答排出来,谁最好、好多少,一目了然。
Score(打分):概率加权的连续值 + 分段概率。不是"这个产品 8 分"这种拍脑袋,而是"8.3 分,其中 70% 概率落在 7 到 9 分区间"。
三种原语,覆盖了智能体里绝大多数"决策"场景:分类、路由、打分、抽取、分叉判断。TypeSafe 给它起了个外号:"会思考的 if 语句"。
五、零幻觉的真相
"零幻觉"是 Jev 最响的卖点,但需要掰开说清楚。
Jev 的输出被约束在调用方预先定义的选项集 里。你给它的选项是"好评/差评",它就只能回这两个之一------不可能给你蹦出个"这条评论让我想起了外婆"。格式上的幻觉,结构上就杜绝了。
但注意:格式不错 ≠ 答案就对。它说"差评",实际是好评论------这仍可能发生。TypeSafe 自己也不断强调这点:类型安全不保证选择正确。
所以"零幻觉"的准确说法是:它不会"胡说",但可能会"选错"。 前者靠架构保证,后者靠 RLCD 的校准能力尽量压低。
六、System 1 和 System 2
Jev 的定位,用卡尼曼《思考,快与慢》的框架说最清楚:
System 2(慢思考):深思熟虑,写长文、解数学题、做复杂规划。这是 GPT、Claude 的战场------慢,但能处理复杂任务。
System 1(快思考):瞬间直觉,"这条路堵不堵""这个人靠不靠谱"。这是 Jev 的战场------快、便宜、概率诚实。
TypeSafe 管 Jev 叫 "System One Model"。它没打算取代 GPT,而是填一个空白:智能体循环里那些每秒要做几百次的小判断。评论要不要精选?这个问题该路由给哪个模型?这个工具调用有没有风险?这类判断用 GPT 做是杀鸡用牛刀,用 Jev 做正合适。
LangChain 已经集成了 ModelRouterMiddleware(按复杂度把请求路由给 Jev 或大模型)和 AutoModeMiddleware(执行工具前先用 Jev 判断风险等级)。Vercel 也加了直接调用 Jev 的接口。
七、所以 Jev 到底是什么
一句话:Jev 是一个不做生成、只做判断的决策引擎。 它砍掉了自回归生成(换并行采样),砍掉了人类偏好对齐(换校准训练),换来 200 倍速度和结构性的零幻觉。
它不是 LLM 的替代品,是 LLM 的互补品。大模型负责"想",Jev 负责"判"------一个管慢思考,一个管快直觉。
一个有趣的猜想留给读者:如果智能体里的"快判断"都被 Jev 这类模型接管了,那 Agent 的架构会怎么变?路由、护栏、验证这些胶水层,可能才是下一个竞争焦点。
参考资料: