张量(Tensor)基本使用
在深度学习中,我们需要处理各种类型的数据(如图像、文本、声音),而这些数据最终都要被计算机转换成数字进行运算。
在 PyTorch 中,所有的数据存储和计算都依赖于一个核心的数据结构 ------张量(Tensor)。它可以理解为是 NumPy 数组的升级版,不仅能存储多维数据,还能在 GPU 上进行加速运算,这是实现深度学习模型训练的基础。
1 张量(Tensor)创建
有了数据(如图片的像素值、表格的数值),第一步就是把它们装进Tensor这个"容器"里。创建Tensor是编写 PyTorch 代码的最基础操作。
1.1 基于内容创建张量
torch.tensor() 是最常用的张量创建方法,我们可以通过传入不同类型的输入数据,快速生成对应维度、对应数据的张量,下面通过 5 个典型场景,详细拆解张量的创建逻辑与维度规律。
1.1.1 创建标量张量(0 维张量)
标量是深度学习中最基础的数值单元,仅包含一个单独的数值,没有维度概念,对应 0 维张量。
常用于存储损失值、准确率等单一数值结果
(1)代码示例
python
import torch

# 创建标量张量
scalar1 = torch.tensor(10)
scalar2 = torch.tensor(3.14)

# 输出结果
print("标量张量1:", scalar1)
print("标量张量2:", scalar2)
print("张量维度:", scalar1.dim())
print("张量形状:", scalar1.shape)
(2)运行结果
标量张量1: tensor(10)
标量张量2: tensor(3.1400)
张量维度: 0
张量形状: torch.Size([])
(3)详细说明
- 当我们给 torch.tensor() 传入一个单独的数字(如 1)时,PyTorch 会生成一个0 维张量,也就是标量。
- 输出的 tensor(1) 表示张量内存储的数值为 1;
- dim()返回 0,代表 0 维张量;shape为空,代表无维度
1.1.2 创建一维张量(向量)
一维张量也叫向量,对应线性代数中的一维数组,只有一个维度,常用于存储序列数据、特征向量等。
python
import torch

# 创建一维张量
vec1 = torch.tensor([1, 2, 3, 4])
vec2 = torch.tensor([0.1, 0.2, 0.3])

# 输出结果
print("一维张量1:", vec1)
print("一维张量2:", vec2)
print("张量维度:", vec1.dim())
print("张量形状:", vec1.shape)
(2)运行结果
一维张量1: tensor([1, 2, 3, 4])
一维张量2: tensor([0.1000, 0.2000, 0.3000])
张量维度: 1
张量形状: torch.Size([4])
(3)详细说明
- 传入单层列表,创建一维张量
- dim() 返回 1,代表 1 维张量;shape 代表元素个数
1.1.3 创建二维张量(矩阵)
二维张量对应线性代数中的矩阵,有行、列两个维度,是深度学习中最常用的张量结构之一,常用于存储批量数据、特征矩阵等。
(1)代码示例
python
# 传入一个二维列表(矩阵)
t1 = torch.tensor([[1, 2, 3], [10, 20, 30]])
print(t1)
print(t1.shape)
(2)运行结果
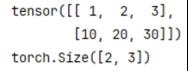
(3)详细说明
- 给 torch.tensor() 传入一个二维嵌套列表(外层列表代表行,内层列表代表列),会生成一个二维张量。
- 输出的张量呈现 2 行 3 列的矩阵结构,
torch.Size([2, 3])表示该张量有 2 个维度:第 0 维(行)长度为 2,第 1 维(列)长度为 3,即 2 行 3 列的矩阵。 - 二维张量是深度学习中批量数据的标准存储形式,例如批量输入的图像特征、表格数据等,都以二维张量的形式存储。
1.1.4 创建高维张量(三维及以上)
在深度学习中,我们经常需要处理三维、四维甚至更高维度的数据(如彩色图像、视频序列、批量图像等),torch.tensor() 可以通过传入多层嵌套列表,轻松创建高维张量。
(1)代码示例(三维张量)
python
# 传入高维数组
t1 = torch.tensor([ [ [1,2,3], [4,5,6] ], [[7,8,9], [10,11,12]]  ] )
print(t1)
print(t1.shape)
(2)运行结果
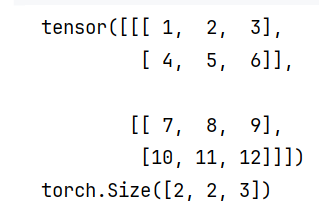
(3)详细说明
- 给
torch.tensor()传入一个三层嵌套列表,会生成一个三维张量。 torch.Size([2, 2, 3])表示该张量有 3 个维度:第 0 维长度为 2,第 1 维长度为 2,第 2 维长度为 3。- 三维张量的典型应用场景:单张彩色图像(形状为 高度, 宽度, 通道数,如 224, 224, 3 代表 224×224 的 RGB 三通道图像)、单条时间序列数据等。
- 若需要创建四维张量(如批量彩色图像,形状为 批量数, 高度, 宽度, 通道数),只需传入四层嵌套列表即可,维度规律完全一致。
1.1.5 基于 NumPy 数组创建张量
PyTorch 与 NumPy 有非常好的兼容性,我们可以直接将 NumPy 的 ndarray 数组转换为 PyTorch 张量,实现两个库之间的数据无缝衔接。
(1)代码示例
python
# 传入numpy的ndarray
import numpy as np

t1 = torch.tensor(np.array([10, 20, 30]))
print(t1)
print(t1.shape)
(2)运行结果
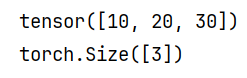
(3)详细说明
- 给
torch.tensor()传入一个 NumPy ndarray 数组,PyTorch 会自动将其转换为对应维度、对应数据的张量。 - 本例中传入的是一维 NumPy 数组,因此生成的是一维张量,形状为 3,与直接传入 Python 列表的效果完全一致。
- 该方法的核心价值:可以复用 NumPy 中成熟的数据处理、数值计算能力,处理完数据后直接转换为张量,用于深度学习模型的训练与推理,实现数据处理与模型训练的无缝衔接。
- 补充说明:除了
torch.tensor(),torch.from_numpy()也可以实现 NumPy 数组到张量的转换,二者的核心区别是:torch.tensor()会创建数据的副本,修改原数组不会影响张量;torch.from_numpy()会共享数据内存,修改原数组会同步修改张量,使用时需根据需求选择。
1.1.6 核心知识点总结
(1)张量是 PyTorch 的基础数据结构,所有数据运算都基于张量完成
(2)张量维度与输入结构的对应关系:传入数据的嵌套层数 = 张量的维度数:
- 单个数字 → 0 维张量(标量)
- 一维列表 / 数组 → 一维张量(向量)
- 二维嵌套列表 → 二维张量(矩阵)
- N 层嵌套列表 → N 维张量
(3)shape 的含义:torch.Size() 中的列表长度代表张量的维度数,列表中的每个元素对应对应维度的长度(元素个数)。
(4)数据兼容性:torch.tensor() 支持 Python 列表、NumPy 数组、标量等多种输入类型,是创建张量最灵活、最常用的方法。
(5)实际应用场景:
- 0 维张量:存储损失值、准确率等单个指标
- 一维张量:存储特征向量、序列数据
- 二维张量:存储批量表格数据、特征矩阵
- 三维张量:存储单张彩色图像、单条时间序列
- 四维张量:存储批量彩色图像、视频帧序列
1.2 基于形状创建张量
在深度学习开发中,我们经常需要预先创建指定形状的空张量,用于后续填充数据、初始化模型参数、构建计算图等场景。PyTorch 提供了多种基于形状创建张量的方法,其中最基础的就是 torch.Tensor()(注意首字母大写),它可以直接根据传入的维度参数,快速生成指定形状的张量。
(1)代码示例
python
t1 = torch.Tensor(2,3,5)
print(t1)
print(t1.shape)
(2)运行结果
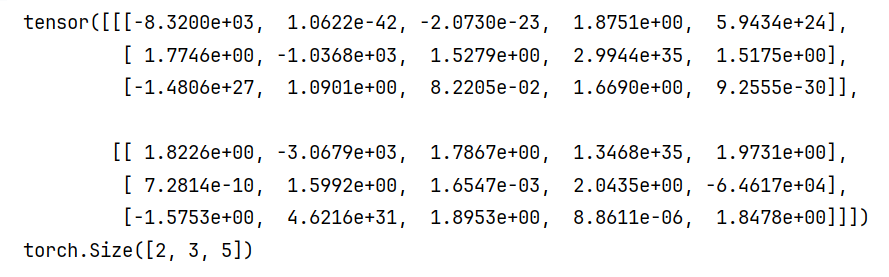
(3)详细说明
torch.Tensor(2, 3, 5):这是核心创建语句,传入的三个整数 2、3、5 分别代表张量的三个维度的长度,PyTorch 会自动生成一个对应形状的三维张量。print(t1):打印张量的具体内容,我们可以看到张量内的所有元素初始值均为 0.(浮点数类型)。print(t1.shape):打印张量的形状,用于验证创建的维度是否符合预期。
(4)运行结果说明
输出的 torch.Size([2, 3, 5]) 清晰定义了张量的结构:
- 第 0 维(最外层)长度为 2:代表张量包含 2 个 "大模块"
- 第 1 维(中间层)长度为 3:每个大模块包含 3 个 "子模块"
- 第 2 维(最内层)长度为 5:每个子模块包含 5 个元素
- 整体结构:2 × 3 × 5 的三维数组,总元素个数为 2×3×5=30 个
1.3 张量的数据类型的确定
在 PyTorch 中,张量(Tensor)的数据类型(dtype)直接决定了内存占用、计算精度和运算效率。本节我们将通过代码实例,彻底搞懂张量数据类型的自动推断规则,以及大小写 tensor/Tensor 的核心差异。
1.3.1 核心规则
- 小写 torch.tensor()(函数):基于具体数据创建张量,数据类型完全遵循输入数据的类型,自动推断。
- 大写 torch.Tensor()(类):基于形状创建张量,数据类型默认固定为 float32,不受输入数据影响。
1.3.2 基于内容创建张量(torch.tensor())
这类场景是我们最常用的:传入具体的数值、列表,PyTorch 自动推断张量的 dtype。
(1)代码示例:
python
# 1. 基于内容
t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])
print(t1.dtype)

t1 = torch.tensor([[1.0, 2, 3], [4, 5, 6]])
print(t1.dtype)

t1 = torch.Tensor([[1, 2, 3], [4, 5, 6]])
print(t1.dtype)
(2)运行结果:
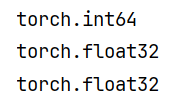
(3)详细解析:
- 第 1 个示例:输入的 \[1, 2, 3, 4, 5, 6 ] 是纯整数列表,PyTorch 会自动将张量类型设为 torch.int64(64 位整数,也叫长整型),这是整数输入的默认类型。
- 第 2 个示例:输入中包含 1.0 这个浮点数,PyTorch 会自动将整个张量的类型提升为 torch.float32(32 位浮点数),这是浮点数输入的默认类型,也是深度学习模型的标准计算类型。
- 第 3 个示例:即使输入的是纯整数列表,只要用了大写 torch.Tensor(),就会强制将张量转为 float32 类型,这是大写类的固定规则,不推荐用这种方式传数据创建张量,极易造成类型混乱。
1.3.3 基于形状创建张量(torch.Tensor())
这类场景是我们预先创建空张量容器,后续填充数据,大写 torch.Tensor() 是这类场景的基础用法。
(1)代码示例:
python
# 2. 基于形状
t1 = torch.Tensor(2,3,5)
print(t1.dtype)
(2)运行结果:
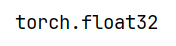
(3)详细解析:
- 大写
torch.Tensor()仅根据传入的形状参数创建张量,完全不依赖输入数据,因此默认数据类型固定为 torch.float32,和上一节的结论完全一致。 - 补充:如果需要创建指定类型的形状张量,推荐用语义更清晰的方法,比如
torch.zeros(2, 3, 5, dtype=torch.int64),而不是用大写 Tensor。
1.4 创建指定类型的张量
在 PyTorch 中,创建张量时可通过指定 dtype 参数或调用特定类型的构造函数,定义张量的数据类型。以下为不同数据类型张量的创建示例及类型验证代码。
(1)代码示例
python
t1 = torch.tensor([[1, 2, 3], [4, 5, 6]], dtype=torch.float64)
print(t1.dtype)

t1 = torch.IntTensor(2,3)
print(t1.dtype)

t1 = torch.LongTensor(2,3)
print(t1.dtype)

t1 = torch.FloatTensor(2,3)
print(t1.dtype)

t1 = torch.DoubleTensor(2,3)
print(t1.dtype)

t1 = torch.BoolTensor(2,3)
print(t1.dtype)

t1 = torch.ByteTensor(2,3)
print(t1.dtype)

t1 = torch.HalfTensor(2,3)
print(t1.dtype)
(2)运行结果
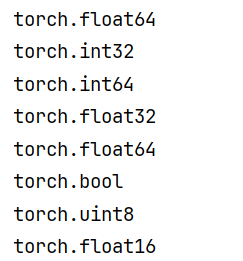
(3)关键说明
-
数据类型映射:PyTorch 中不同构造函数对应固定的数据类型,如 IntTensor 对应 torch.int32、FloatTensor 对应 torch.float32,与下方输出结果一一对应。
-
创建逻辑差异:
torch.tensor(..., dtype=...):基于传入的初始数据,指定数据类型创建张量。torch.xxxTensor(shape):创建指定形状的未初始化张量,其数据类型由构造函数本身决定。
-
类型等价性:torch.DoubleTensor 与 torch.float64 本质是同一数据类型的两种表示方式,因此二者输出结果一致。
1.5 根据数据区间创建张量
在 PyTorch 中,针对均匀区间、线性间隔、对数间隔的数值序列生成需求,提供了 arange、linspace、logspace 等核心 API。
5.1 固定步长生成:torch.arange
基于「起始值、终止值、步长」生成一维张量,不包含终止值,是最基础的区间生成函数。
(1)代码示例:
python
t1 = torch.arange(10)  # start = 0 end = 10 step = 1
print("生成的张量:", t1)
print("张量形状:", t1.shape)
(2)运行结果
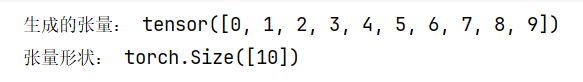 (3)代码示例:
python
# 双参数形式(指定 start、end),最后一个参数表示步长
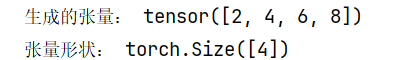
t1 = torch.arange(2, 10, 2)   #  [start, end)
print("生成的张量:", t1)
print("张量形状:", t1.shape)
(4)运行结果
(5)关键说明:
- 核心参数:start(起始值,默认 0)、end(终止值,不包含在结果内)、step(步长,默认 1)。
- 适用场景:快速生成连续整数、固定间隔的数值序列。
1.5.2 固定数量线性生成:torch.linspace
基于「起始值、终止值、生成个数」生成均匀间隔的一维张量,包含起始和终止值,步长自动计算。
(1)代码示例:
python
# 最后一个表示生成的个数. 步长会自动计算   step = (end -start) / (steps - 1)
t1 = torch.linspace(2, 10, 6)  # [start, end, steps]
print(t1)
print(t1.shape)
(2)运行结果
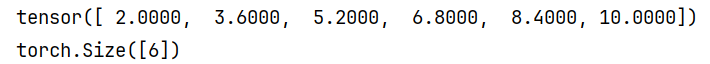
(3)关键说明:
- 核心参数:start、end、steps(生成的总个数,必填)。
- 计算逻辑:步长 = (终止值 - 起始值) / (生成个数 -- 1),保证数值均匀分布。
- 适用场景:需要固定数量的均匀采样场景。
1.5.3 对数间隔生成:torch.logspace
生成对数空间下的均匀间隔张量,默认以 10 为底,也可自定义底数,数值呈指数级分布。
(1)代码示例:
python
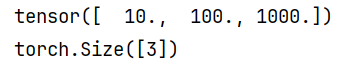
t1 = torch.logspace(1, 3, 3)  # 实数函数 生成: 3个值 10^1  10^2  10^3
print(t1)
print(t1.shape)
(2)运行结果:
(3)代码示例
python
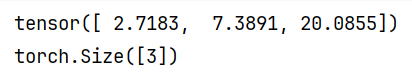
t1 = torch.logspace(1, 3, 3, base=np.e)  # 指定底数  生成 e^1  e^2  e^3
print(t1)
print(t1.shape)
(4)运行结果
(5)关键说明:
- 核心参数:start(指数起始值,对应 base^start)、end(指数终止值,对应 base^end)、steps(生成个数)、base(底数,默认 10)。
- 适用场景:指数分布的数值采样、对数尺度数据可视化等场景
1.5.4 对比总结
      API           名称	       核心逻辑	包含终止值	 关键参数特点
torch.arange	固定步长线性生成	  ❌     不包含	  步长手动指定,支持整数 / 浮点数
torch.linspace	固定数量线性生成	  ✅     包含	  个数固定,步长自动计算
torch.logspace	对数空间指数生成	  ✅     包含	  指数级分布,支持自定义底数
1.6 根据填充创建张量
在 PyTorch 中,除了通过数据区间创建张量,还常使用全 1、全 0、指定常量、单位矩阵等填充规则,快速构建特定结构的张量。这类操作是初始化神经网络参数、构建网络层结构的基础。
1.6.1 全 1 张量:torch.ones & torch.ones_like
用于生成元素全为 1 的张量,支持直接指定形状,或基于现有张量复制形状生成。
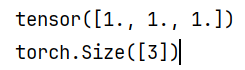
(1)代码示例:
python
t1 = torch.ones(3)
print(t1)
print(t1.shape)
(2)运行结果
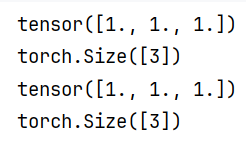
(3)代码示例:
python
t1 = torch.ones(3)
print(t1)
print(t1.shape)

t2 = torch.ones_like(t1)
print(t2)
print(t2.shape)
(4)运行结果
(5)关键说明
torch.ones(*size):*size 为形状参数,如 3 表示一维,(2, 3) 表示二维矩阵。torch.ones_like(input):继承输入张量 input 的形状和数据类型,生成全 1 张量。
1.6.2 未初始化张量:torch.empty
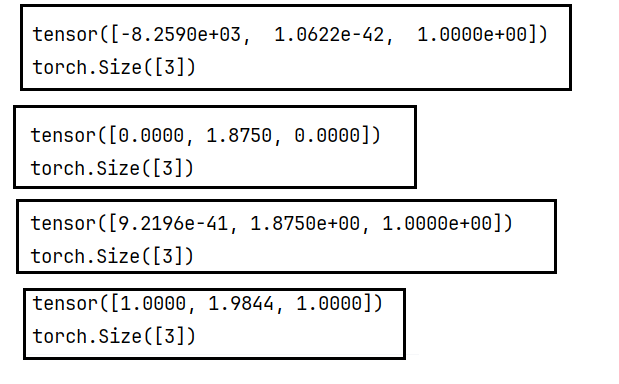
创建指定形状的张量,内容未初始化(内存中残留随机值),后续需手动赋值,效率最高但需谨慎使用。
(1)代码示例:
python
t1 = torch.empty(3)
print(t1)
print(t1.shape)
(2)运行结果
(3)关键说明:
- 与 zeros/ones 不同,该函数不初始化内存,因此生成速度快。
- 生成后必须通过索引赋值等方式填充数据,否则直接使用会导致结果不可控。
1.6.3 全常量张量:torch.full
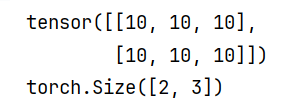
创建指定形状的张量,所有元素填充为自定义常量值,灵活性更高。
(1)代码示例:
python
t1 = torch.full((2,3), 10)  # 参数形状  填充值
print(t1)
print(t1.shape)
(2)运行结果
(3)关键说明:
核心参数:size(形状)、fill_value(填充的常量值,支持整数、浮点数等)。
适用场景:需要固定默认值填充的张量初始化场景。
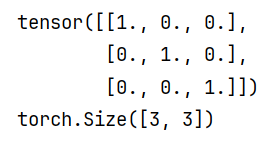
1.6.4 单位矩阵:torch.eye
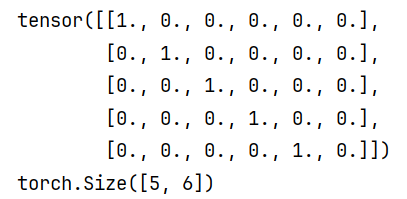
生成二维单位矩阵(对角线元素为 1,其余为 0),参数为 (n, m),分别表示行数和列数。
(1)代码示例:
python
t1 = torch.eye(3)  # 单位矩阵
print(t1)
print(t1.shape)
(2)运行结果
(3)代码示例
python
t2 = torch.eye(5, 6)
print(t2)
print(t2.shape)
(4)运行结果
(5)关键说明
torch.eye(n, m=None):若只传 n,则生成 n×n 的方阵;传 (n, m) 则生成 n×m 的矩阵。- 数学应用:单位矩阵是线性代数中的核心矩阵,对应张量运算中的恒等变换。
1.6.5 方法对比总结
  API名称		   	核心功能			填充值					适用场景
torch.ones	      生成全 1 张量			全 1			初始化权重为 1 的场景
torch.ones_like	 复制形状生成全 1 张量		全 1			与现有张量同形状的初始化
torch.empty		 生成未初始化张量		  随机残留值			追求极致生成速度的场景
torch.full		生成自定义常量张量	     自定义值			需固定非标准值的场景
torch.eye		   生成单位矩阵		对角线 1,其余 0		线性代数、恒等变换场景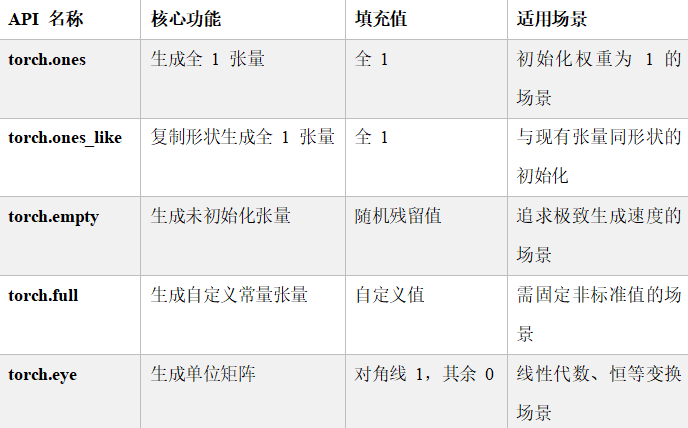
1.7 随机创建张量
在深度学习与科学计算中,随机张量常用于模型参数初始化、数据增强、蒙特卡洛模拟等场景。PyTorch 提供了丰富的随机数生成 API,涵盖均匀分布、正态分布、随机打乱等多种策略。
1.7.1 均匀分布随机张量
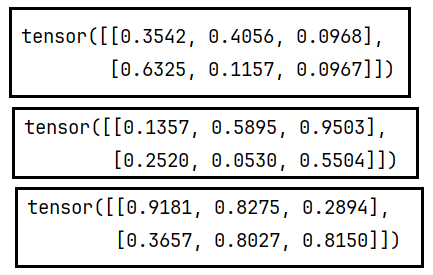
(1)代码示例:区间 [0, 1) 均匀分布
生成元素取值范围在 [0, 1) 之间的均匀分布随机张量。
python
# 均匀分布: [0, 1)
t2 = torch.rand(2,3)
print(t2)
(2)运行结果
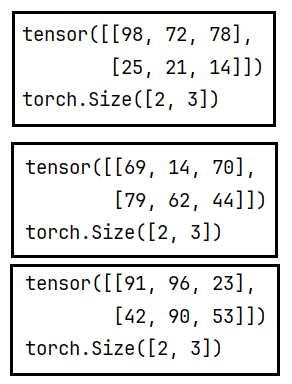
(3)代码示例:整数范围均匀分布
生成指定区间内的整数型随机张量。
python
# 均匀分布整数
t2 = torch.randint(1, 100, size=(2,3))
print(t2)
print(t2.shape)
(4)运行结果
1.7.2 正态分布随机张量
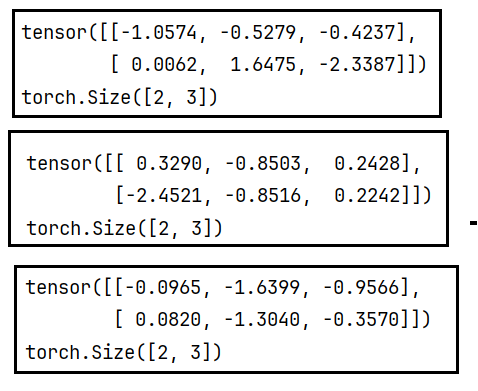
(1)代码示例:标准正态分布(均值 = 0,标准差 = 1)
生成服从标准正态分布 N(0,1) 的随机张量。
python
# 标准正态分布
t2 = torch.randn(2,3)
print(t2)
print(t2.shape)
(2)运行结果
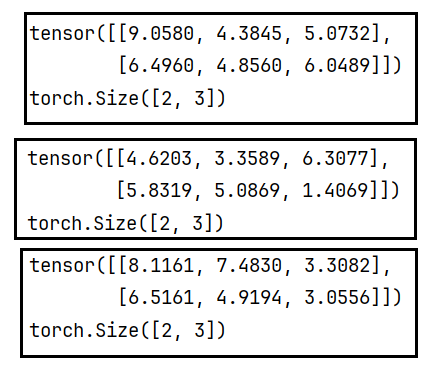
(3)代码示例:自定义均值与标准差的正态分布
生成服从指定均值(mean)和标准差(std)的正态分布 N(μ,σ2)。
python
# 普通正态分布:  均值5 标准差 2
t2 = torch.normal(5, 2, size=(2,3))
print(t2)
print(t2.shape)
(4)运行结果
1.7.3 随机打乱与随机种子
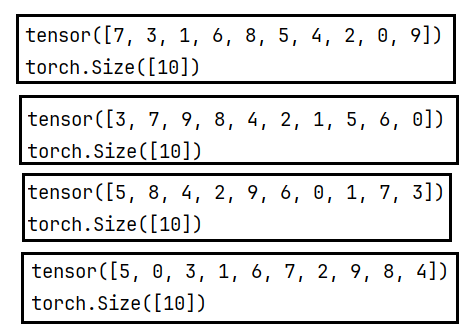
(1)代码示例:随机打乱(洗牌)
将一个整数序列进行随机打乱,常用于数据集索引的随机化。
python
# 洗牌(打乱)   [0, 10) 随机打乱这10个整数
t2 = torch.randperm(10)
print(t2)
print(t2.shape)
(2)运行结果
(3)代码示例:随机种子的设置与获取
随机种子是复现实验结果的关键。固定种子后,每次运行生成的随机数将完全一致。
python
# 查看随机数种子
seed = torch.random.initial_seed()
print(seed)

# 设置随机数种子
torch.manual_seed(42)

seed = torch.random.initial_seed()
print(seed)
(4)运行结果
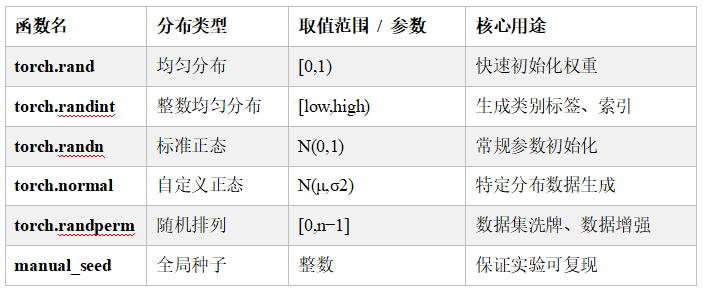
1.7.4 核心API汇总
2 张量(Tensor)转换
张量转换是 PyTorch 中数据预处理、模型适配的核心操作,本节将系统介绍张量的元素数据类型转换方法,涵盖不同转换方式的语法、适用场景与最佳实践。
2.1 元素类型转换
在深度学习中,不同运算、模型层对张量的数据类型有明确要求(如卷积层通常要求 float32,整数标签需用 int64),因此需要灵活转换张量的元素类型。PyTorch 提供了 3 种主流的类型转换方式,以下为详细说明与代码示例。
(1)代码示例:
python
# 1. 初始化一个默认类型的张量(整数输入默认 dtype 为 torch.int64)
t1 = torch.tensor([1, 2, 3])
print("初始张量的数据类型:", t1.dtype)

# type方法
# -----------
# 方式1:type() 方法(通用类型转换)
# ----------
# 将张量转换为 torch.float32 类型
t1 = t1.type(torch.float32)
print(t1.dtype)

# --------------------------
# 方式2:to() 方法(推荐,功能更全面)
# --------------------------
# 将张量转换为 torch.int32 类型
# to() 同时支持 dtype、device(CPU/GPU)、requires_grad 等多维度转换
t1 = t1.to(torch.int32)
print(t1.dtype)

# --------------------------
# 方式3:直接调用类型方法(便捷写法)
# --------------------------
# 快速转换为 float32 类型(等价于 t1.to(torch.float32))
t1 = t1.float()
print(t1.dtype)
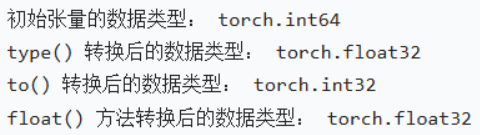
(2)运行结果:
2.2 Tensor与numpy的ndarray转换
在 PyTorch 开发中,张量(Tensor)与 NumPy 数组(ndarray)的互转是数据预处理、结果可视化、第三方库适配的核心操作。两者的转换本质是内存的共享 / 拷贝,理解其底层逻辑可避免数据污染、提升代码性能。
2.2.1 tensor => ndarray
1)基础转换:numpy() 方法
将 PyTorch 张量转换为 NumPy 数组,默认共享同一块内存,修改其中一个会同步影响另一个。
(1)代码示例
python
t1 = torch.tensor([1, 2, 3])
print(t1.dtype)
print(type(t1))
(2)运行结果
(3)代码示例
python
# 转成 ndarray   转换后的ndarray和tensor是内存共享的
a1 = t1.numpy()
print(type(a1))
(4)运行结果
2.2.2 内存共享特性验证
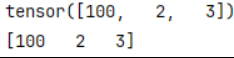
由于默认共享内存,修改张量元素会同步反映到 NumPy 数组中。
(1)代码示例
python
# 验证内存共享
t1[0] = 100
print(t1)
print(a1)
(2)运行结果
2.2.3 避免内存共享:深拷贝 .copy()
若需要完全独立的两份数据,可在转换后调用 .copy() 方法,创建新的内存副本。
(1)代码示例
python
# 避免内存共享
a2 = t1.numpy().copy()
t1[0] = 200
print(t1)
print(a2)
(2)运行结果
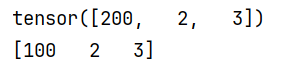
2.3 NumPy ndarray => Tensor
2.3.1 基础转换:torch.from_numpy() 方法
将 NumPy 数组转换为 PyTorch 张量,同样默认共享内存,修改数组会同步影响张量。
(1)代码示例
python
a1 = np.array([1, 2, 3])
print("数组初始类型:", type(a1))
t1 = torch.from_numpy(a1)  # t1和a1也是内存共享的
print("转换后张量类型:",type(t1))
(2)运行结果
2.3.2 避免内存共享:.clone() 方法
若需要独立的张量,可在转换后调用 .clone() 方法,创建张量的深拷贝。
(1)代码示例
python
t1 = torch.from_numpy(a1).clone() # 避免内存共享
print(type(t1))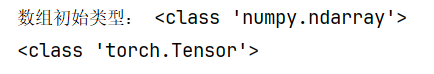
2.4 张量(Tensor)=> 标量(Scalar)
如果一个tensor中,只有一个元素,不管这个元素是几阶的,都可以变成标量。
看起来多此一举,但是可以将很高维度的一个元素的张量取出,变成标量
(1)代码示例
python
t1 = torch.tensor(10)
t2 = torch.tensor([10])
t3 = torch.tensor([[10]])

print(t1.item())
print(t2.item())
print(t3.item())
(2)运行结果

(3)关键说明:
item() 方法的核心作用:
- 仅当张量的元素总数为 1 时可调用,否则会抛出 ValueError
- 将张量中的单个数值提取为 Python 原生数据类型(如 int、float)
- 提取后的数据与原张量完全独立,修改原张量不会影响标量值
3.3 tensor数值计算
3.1 基本运算
在 PyTorch 中,张量支持丰富的数学运算,核心分为运算符重载和方法调用两类,同时遵循原地操作(in-place)与非原地操作的设计规范,是张量运算的基础。
3.1.1)核心运算分类
(1)加减乘除基础运算
PyTorch 为张量提供了两种等价的运算方式,同时区分「不修改原数据」和「修改原数据」两种操作:
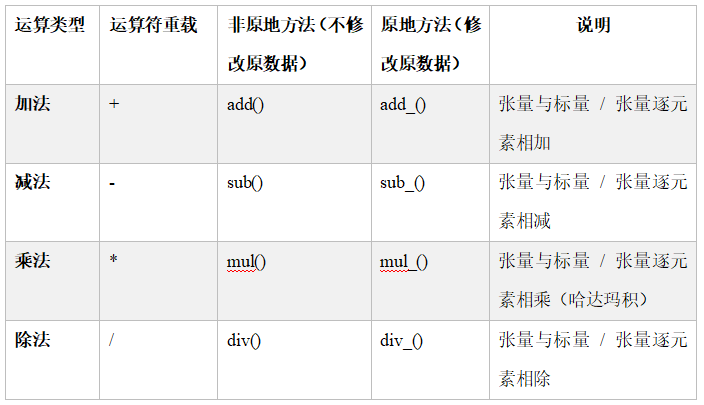
运算类型	运算符重载	非原地方法(不修改原数据)	原地方法(修改原数据)	说明
 加法		+		 add()					add_()	    张量与标量 / 张量逐元素相加
 减法		-		 sub()					sub_()	    张量与标量 / 张量逐元素相减
 乘法		*		 mul()					mul_()	    张量与标量 / 张量逐元素相乘(哈达玛积)
 除法		/		 div()					div_()	    张量与标量 / 张量逐元素相除
关键规则:
- 非原地方法(无下划线后缀):返回运算后的新张量,原张量完全不变。
- 原地方法(下划线后缀):直接修改原张量的内存数据,无返回值,节省内存开销。
3.1.2)其他常用数学运算
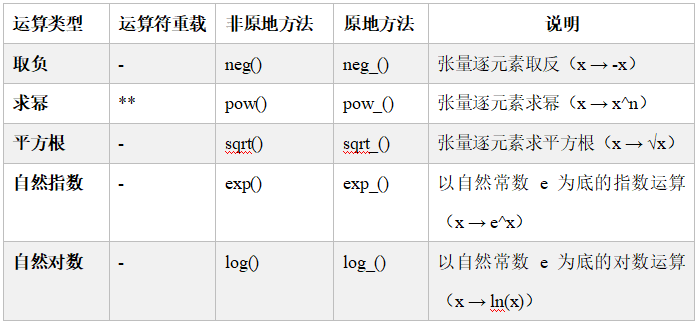
3.1.3)代码示例
python
import torch
# 初始化 2×3 张量
t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])

# 1. 运算符重载:+ (非原地,不修改原张量)
print("=== 运算符 + 运算结果 ===")
print(t1 + 10)
print("原张量 t1(未修改):\n", t1)

# 2. 非原地方法:add() (不修改原张量)
print("\n=== add() 方法运算结果 ===")
print(t1.add(10))
print("原张量 t1(未修改):\n", t1)

# 3. 原地方法:add_() (直接修改原张量)
print("\n=== add_() 方法运算结果 ===")
print(t1.add_(10))
print("原张量 t1(已修改):\n", t1)
3.1.4)运行结果
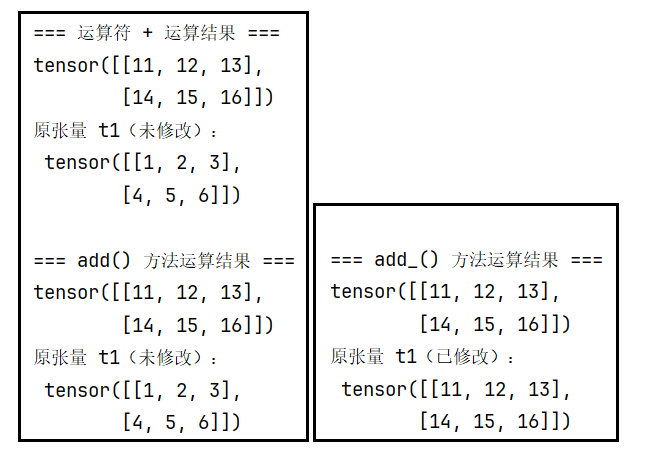
3.1.5)关键说明
(1)原地操作的注意事项
- 内存效率:原地操作直接修改原张量内存,无需分配新内存,适合大张量运算,可显著降低内存占用。
- 数据风险:原地操作会永久覆盖原张量数据,若后续需要原数据,必须提前备份。
- 梯度安全:在需要计算梯度的场景(如模型训练),原地操作可能破坏计算图,导致梯度计算错误,训练阶段不推荐使用。
(2)运算符与方法的等价性 - 运算符重载(如 +、*)本质是对应方法的语法糖,t1 + 10 完全等价于 t1.add(10)。
- 原地方法统一以下划线 _ 结尾,是 PyTorch 的命名规范,便于快速识别。
3.2 元素级运算(张量与张量)
元素级运算(Element-wise Operation)是张量运算中最基础、最常用的操作。其核心规则是对应位置的元素逐一进行运算,要求两个张量形状相同(或满足广播机制),运算结果的形状与输入张量的广播后形状一致。
3.2.1)形状要求
- 严格一致:当两个张量形状完全相同时,直接按位置对应进行运算。
- 广播机制(Broadcasting):当形状不同时,PyTorch 会自动将较小的张量扩展为与较大张量相同的形状,再进行逐元素运算。
3.2.2)常用运算 API 对比
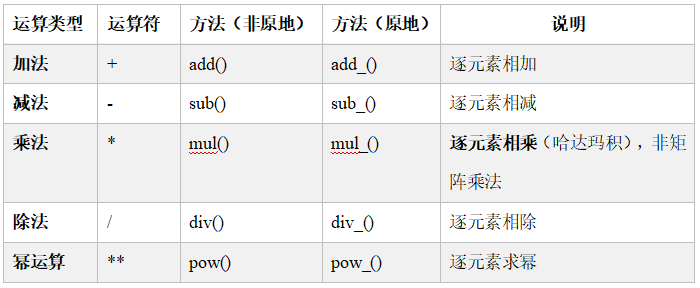
运算类型	运算符	方法(非原地)	方法(原地)	说明
 加法	  +			add()		  add_()	逐元素相加
 减法	  -			sub()		  sub_()	逐元素相减
 乘法	  *			mul()		  mul_()	逐元素相乘(哈达玛积),非矩阵乘法
 除法	  /			div()		  div_()	逐元素相除
 幂运算	  **		pow()		  pow_()	逐元素求幂
3.2.3)代码示例
(1)初始化张量
python
import torch
# 初始化 2x3 张量
t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])
t2 = torch.tensor([[10, 20, 30], [40, 50, 60]])
(2)张量加法(逐元素相加)
利用运算符 + 或方法 add() 实现。
python
# 张量 + 张量:对位相加
print("=== 张量加法结果 ===")
print(t1 + t2)
# 等价写法:t1.add(t2)
运算逻辑:
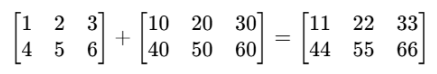
(3)张量乘法(逐元素相乘 / 哈达玛积)
PyTorch 中 * 符号默认执行的是元素级乘法,也称为哈达玛积(Hadamard Product)。
python
# 1. 使用运算符 *
print("\n=== 张量逐元素乘法(*)结果 ===")
print(t1 * t2)
# 2. 使用方法 mul()
print("\n=== 张量逐元素乘法(mul())结果 ===")
print(t1.mul(t2))
运算逻辑:

(4)原地操作(修改原数据)
若需要直接修改原张量 t1 的数据,可使用带下划线的后缀方法 mul_()。
python
# 注意:取消注释后会直接修改 t1 的值
# print(t1.mul_(t2))
# print(t1) # 此时 t1 的值已被覆盖
3.3 矩阵相乘
矩阵乘法是线性代数与深度学习的核心运算,PyTorch 提供了多种矩阵相乘的实现方式,需根据张量维度、使用场景选择合适的 API。本节系统梳理二维矩阵、高维张量的矩阵相乘规则与用法。
3.3.1 二维矩阵相乘
1)三种等价实现方式
PyTorch 为二维矩阵相乘提供了 3 种完全等价的写法,适用于不同代码风格:
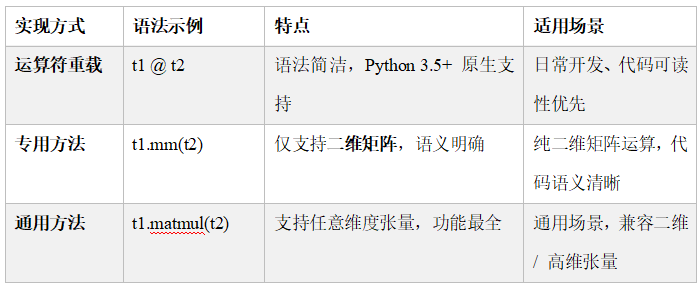
实现方式		 语法示例		特点								适用场景
运算符重载	 t1 @ t2		语法简洁,Python 3.5+ 原生支持	  日常开发、代码可读性优先
专用方法		t1.mm(t2)		仅支持二维矩阵,语义明确	     纯二维矩阵运算,代码语义清晰
通用方法		t1.matmul(t2)	支持任意维度张量,功能最全	    通用场景,兼容二维 / 高维张量
(1)代码示例
python
# 1. 初始化二维矩阵
# t1 形状:(2, 3),t2 形状:(3, 4),满足矩阵相乘条件(3 == 3)
t1 = torch.tensor([[1, 2, 3], [4, 5, 6]])
t2 = torch.tensor([[10, 20, 30, 40], [40, 50, 60, 70], [40, 50, 60, 70]])

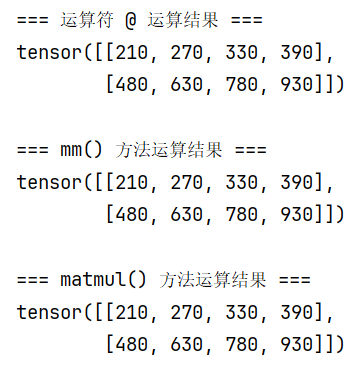
# 2. 三种等价的矩阵相乘
print("=== 运算符 @ 运算结果 ===")
print(t1 @ t2) # (2,3) @ (3,4) => (2,4)

print("\n=== mm() 方法运算结果 ===")
print(t1.mm(t2)) # 仅支持二维矩阵

print("\n=== matmul() 方法运算结果 ===")
print(t1.matmul(t2)) # 通用矩阵乘法
(2)运行结果:
3.3.2 高维张量相乘(批量矩阵乘法)
对于三维及以上张量,PyTorch 会自动执行 批量矩阵乘法:
- 核心规则 :仅要求张量的最后两个维度满足矩阵相乘条件(前张量列数 = 后张量行数)
- 前面的维度会被视为「批量维度」,批量维度需满足广播规则
- 运算逻辑:对每个批量内的二维矩阵独立执行矩阵乘法
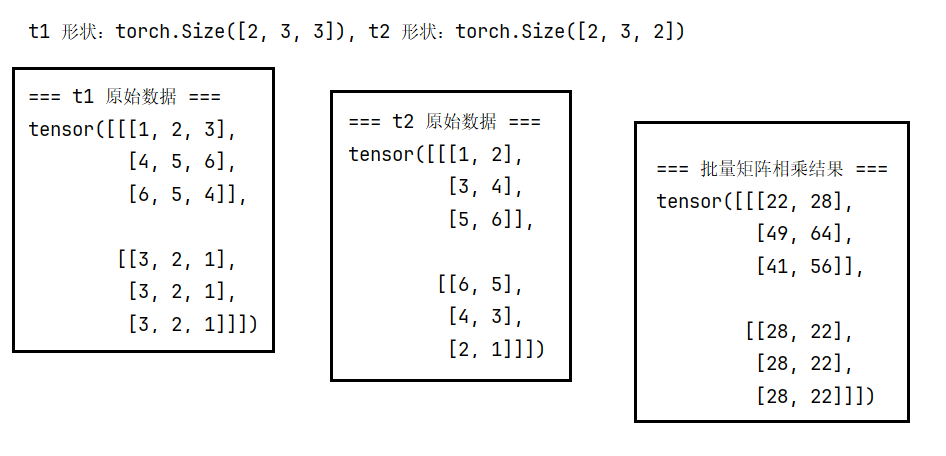
(1)代码示例:
python
import torch
# 1. 初始化三维张量
# t1 形状:(2, 3) → 批量维度 2,矩阵维度 (3,3)
# t2 形状:(2, 3, 2) → 批量维度 2,矩阵维度 (3,2)
# 最后两个维度满足:3 == 3,可执行批量矩阵相乘
t1 = torch.tensor([[[1, 2, 3], [4, 5, 6], [6, 5, 4]], [[3, 2, 1], [3, 2, 1], [3, 2, 1]]])
t2 = torch.tensor([[[1, 2], [3, 4], [5, 6]], [[6, 5], [4, 3], [2, 1]]])

# 2. 打印张量形状与原始数据
print(f"t1 形状:{t1.shape}, t2 形状:{t2.shape}")
print("\n=== t1 原始数据 ===")
print(t1)
print("\n=== t2 原始数据 ===")
print(t2)

# 3. 执行批量矩阵相乘(@ 等价于 matmul())
print("\n=== 批量矩阵相乘结果 ===")
print(t1 @ t2)
# 等价写法:print(t1.matmul(t2))
(2)运行结果
(3)关键对比
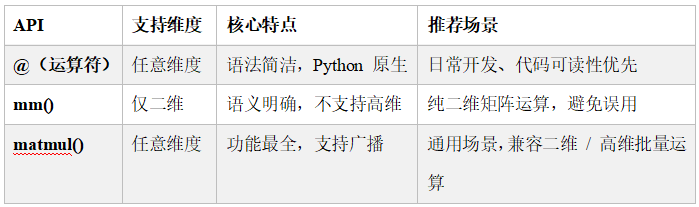
API			支持维度		核心特点					推荐场景
@(运算符)	任意维度		语法简洁,Python 原生		日常开发、代码可读性优先
mm()		仅二维		语义明确,不支持高维		纯二维矩阵运算,避免误用
matmul()	任意维度		功能最全,支持广播			通用场景,兼容二维 / 高维批量运算
4 Tensor统计运算函数
在 PyTorch 中,统计运算函数是数据分析、模型评估、特征处理的核心工具。这类函数支持按指定维度(dim)降维聚合,可灵活实现求和、均值、最值、方差等统计操作,同时保留张量的维度结构。
4.1 初始化测试张量
首先创建一个形状为 (2, 3, 4) 的三维随机整数张量,用于后续所有统计运算的演示:
python
import torch
# 生成 [1,10) 区间内、形状为 (2, 3, 4) 的随机整数张量
t1 = torch.randint(1, 10, (2, 3, 4))
print("原始张量 t1:")
print(t1)
print(f"张量形状:{t1.shape}")
张量维度说明:(2, 3, 4) 可理解为 2 个 3×4 的矩阵,维度索引从 0 开始:dim=0(批量维度)、dim=1(行维度)、dim=2(列维度)。
4.2 核心统计运算详解
- 降维逻辑:指定 dim=N 后,该维度会被压缩(长度从原长度变为 1,最终从形状中移除),其余维度保留。
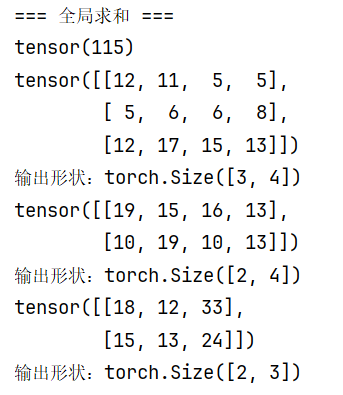
4.2.1)求和运算:sum()
对张量元素按指定维度求和,支持全局求和与按维度降维求和。
python
# 1. 全局求和:所有元素相加,返回 0 维标量张量
print("=== 全局求和 ===")
print(t1.sum())

# 2. 按 dim=0 求和:压缩第 0 维,将 2 个 3×4 矩阵对应位置相加,输出形状 (3,4) print("\n=== 按 dim=0 求和(降维:去掉第0维) ===")
print(t1.sum(dim=0))
print(f"输出形状:{t1.sum(dim=0).shape}")

# 3. 按 dim=1 求和:压缩第 1 维,每个 3×4 矩阵按行求和,输出形状 (2,4) print("\n=== 按 dim=1 求和(降维:去掉第1维) ===")
print(t1.sum(dim=1))
print(f"输出形状:{t1.sum(dim=1).shape}")

# 4. 按 dim=2 求和:压缩第 2 维,每个 3×4 矩阵按列求和,输出形状 (2,3) print("\n=== 按 dim=2 求和(降维:去掉第2维) ===")
print(t1.sum(dim=2))
print(f"输出形状:{t1.sum(dim=2).shape}")
运行结果:
4.2.2)均值运算:mean()
计算张量元素的平均值,仅支持浮点型张量,需先将整数张量转换为浮点型。
python
# 按 dim=0 求均值:压缩第0维,计算2个矩阵对应位置的平均值,输出形状 (3,4) print("=== 按 dim=0 求均值 ===")
print(t1.float().mean(dim=0))
print(f"输出形状:{t1.float().mean(dim=0).shape}")
补充:mean() 也支持全局均值(t1.float().mean()),返回标量;支持任意合法维度的降维均值计算
4.2.3)最值运算:max() / min()
返回指定维度的最大值 / 最小值,同时返回对应元素的索引(常用于分类任务的类别预测)。
python
# 按 dim=1 求最大值:压缩第1维,每个3×4矩阵按行取最大值,同时返回索引 print("=== 按 dim=1 求最大值 ===")
max_val, max_idx = t1.float().max(dim=1)
print("最大值:")
print(max_val)
print("最大值索引:")
print(max_idx)
print(f"输出形状:{max_val.shape}")

# 按 dim=1 求最小值(用法完全一致)
# min_val, min_idx = t1.float().min(dim=1)
运行结果 :
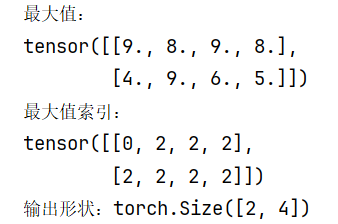
输出结构:max(dim=N) 返回一个元组 (values, indices),values 是最值张量,indices 是对应位置的索引张量。
4.2.4)方差与标准差:var() / std()
计算张量的方差(var)与标准差(std),衡量数据的离散程度,同样仅支持浮点型张量。
python
# 按 dim=1 求方差
print("=== 按 dim=1 求方差 ===")
print(t1.float().var(dim=1))

# 按 dim=1 求标准差(方差的平方根)
print("\n=== 按 dim=1 求标准差 ===")
print(t1.float().std(dim=1))
运行结果 :
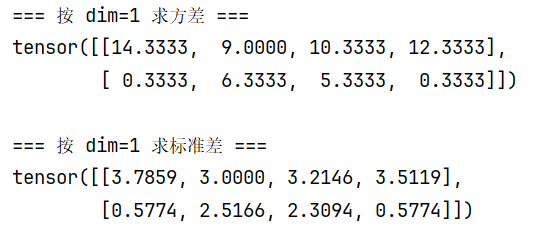
补充:默认按无偏估计计算(unbiased=True),可通过参数 unbiased=False 切换为有偏估计。
4.2.5)去重运算:unique()
对张量所有元素去重,返回排序后的唯一值列表,常用于统计类别、过滤重复数据。
python
# 对张量所有元素去重,返回一维张量
print("=== 元素去重结果 ===")
print(t1.float().unique())
扩展参数:return_counts=True 可同时返回每个唯一值的出现次数;sorted=False 可关闭自动排序。
4.2.6)排序运算:sort()
对张量按指定维度排序,默认返回排序后的值与对应索引。
python
# 按 dim=2 排序:对每个3×4矩阵的每一行单独排序(默认升序)
print("=== 按 dim=2 排序结果 ===")
sorted_val, sorted_idx = t1.float().sort(dim=2)
print("排序后的值:")
print(sorted_val)
print("排序索引:")
print(sorted_idx)
运行结果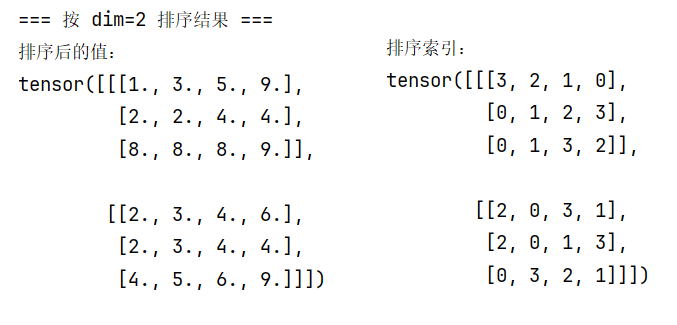
4.3 核心函数速查表
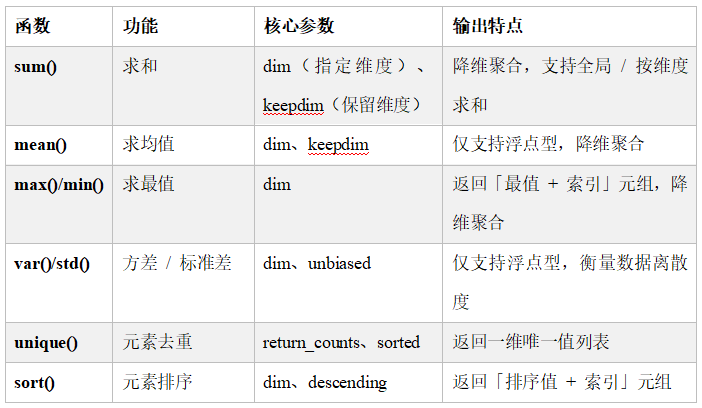
 函数	  	  功能	     核心参数							   输出特点
sum()	 	  求和		dim(指定维度)、keepdim(保留维度)	降维聚合,支持全局 / 按维度求和
mean()	  	 求均值		dim、keepdim						仅支持浮点型,降维聚合
max()/min()	 求最值		dim									返回「最值 + 索引」元组,降维聚合
var()/std()	方差 / 标准差	dim、unbiased						仅支持浮点型,衡量数据离散度
unique()	 元素去重	return_counts、sorted				返回一维唯一值列表
sort()	     元素排序	dim、descending						返回「排序值 + 索引」元组
5 矩阵索引操作
张量索引是 PyTorch 中数据切片、筛选、提取的核心操作,支持简单索引、范围索引、列表索引等多种方式,可灵活实现对张量任意维度、任意位置元素的精准访问。
5.1 初始化测试张量
首先创建一个形状为 (2, 5, 4) 的三维随机整数张量,用于后续所有索引操作的演示:
python
import torch

# 生成 [0,10) 区间内、形状为 (2, 5, 4) 的随机整数张量
# 维度说明:(2, 5, 4) 可理解为 2 个 5行×4列 的矩阵
# 维度索引:dim=0(矩阵维度)、dim=1(行维度)、dim=2(列维度)
t = torch.randint(0, 10, (2, 5, 4))
print("原始张量 t:")
print(t)
print(f"张量形状:{t.shape}")
5.2 简单索引
简单索引通过整数下标直接访问张量指定位置的元素,支持链式索引和逗号分隔两种等价写法,是最基础的索引方式。
(1)代码示例:
python
# 1. 链式索引:逐层访问
# 取第0个矩阵、第0行、第0列的单个元素
print("=== 链式索引 t[0][0][0] ===")
print(t[0][0][0])

# 2. 逗号分隔索引:等价于链式索引,更简洁
print("\n=== 逗号索引 t[0,0,0] ===")
print(t[0,0,0])

# 3. 取第1个矩阵(dim=0 为1),输出形状 (5,4)
print("\n=== 取第1个矩阵 t[1] ===")
print(t[1])
print(f"输出形状:{t[1].shape}")
print('----')

# 4. 取第1个矩阵、第2行(dim=0=1, dim=1=2),输出形状 (4)
print("\n=== 取第1个矩阵第2行 t[1, 2] ===")
print(t[1, 2])
print(f"输出形状:{t[1, 2].shape}")
print('------')

# 5. 取第1个矩阵、第2行、第3列的单个元素(dim=0=1, dim=1=2, dim=2=3) print("\n=== 取第1个矩阵第2行第3列 t[1, 2, 3] ===")
print(t[1, 2, 3])
(2)运行结果 :
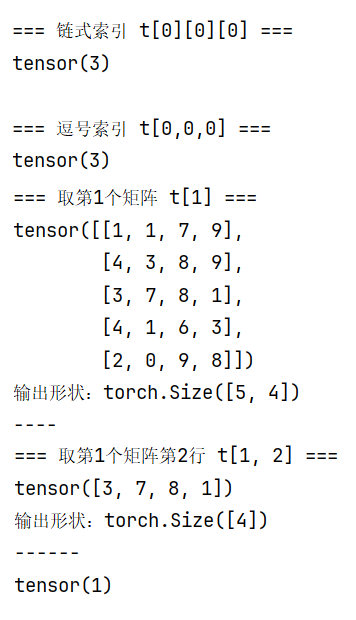
(3)关键说明
- 索引从 0 开始计数,dim=0 对应最外层维度,dim=-1 对应最后一个维度(如本示例中 dim=2)。
- 索引会降维:每指定一个整数下标,对应维度会被压缩,最终单个元素为 0 维标量张量。
- 两种写法完全等价:t000 与 t0,0,0 结果一致,推荐使用逗号分隔写法,代码更简洁。
5.3 范围索引
范围索引(切片)通过 start🔚step 语法,批量提取张量某一维度的连续元素,支持省略参数、负数索引,是数据切片的核心方式。
(1)切片语法规则
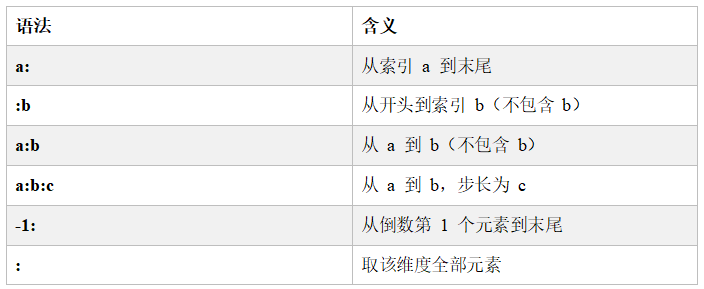
语法						含义
a:					从索引 a 到末尾
:b					从开头到索引 b(不包含 b)
a:b					从 a 到 b(不包含 b)
a:b:c				从 a 到 b,步长为 c
-1:					从倒数第 1 个元素到末尾
:					取该维度全部元素
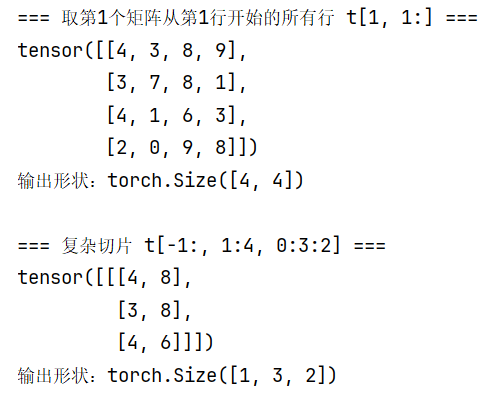
(2)代码示例:
python
# 1. 取第1个矩阵(dim=0=1),从第1行(dim=1=1)到末尾的所有行、所有列
# 等价于 t[1, 1:, :],输出形状 (4,4)
print("=== 取第1个矩阵从第1行开始的所有行 t[1, 1:] ===")
print(t[1, 1:])
print(f"输出形状:{t[1, 1:].shape}")

# 2. 复杂切片:从倒数第1个矩阵(dim=0=-1:)开始,
# 行维度:从第1行(包含)到第4行(不包含),即行索引1、2、3
# 列维度:从第0列到第2列(不包含),步长2,即列索引0
print("\n=== 复杂切片 t[-1:, 1:4, 0:3:2] ===")
print(t[-1:, 1:4, 0:3:2])
print(f"输出形状:{t[-1:, 1:4, 0:3:2].shape}")
(3)运行结果 :
(4)关键说明
- 切片不会降维:即使只取 1 个元素,仍保留原维度结构(如 t1:2, :, : 形状仍为 (1,5,4))。
- 负数索引:-1 代表最后一个元素,-2 代表倒数第二个,以此类推。
- 步长为负:可实现逆序切片,如 t1, ::-1 会将第 1 个矩阵的行逆序排列。
5.4 列表索引
列表索引通过列表 / 数组作为下标,批量提取张量非连续位置的元素,支持广播匹配,可实现灵活的元素筛选。
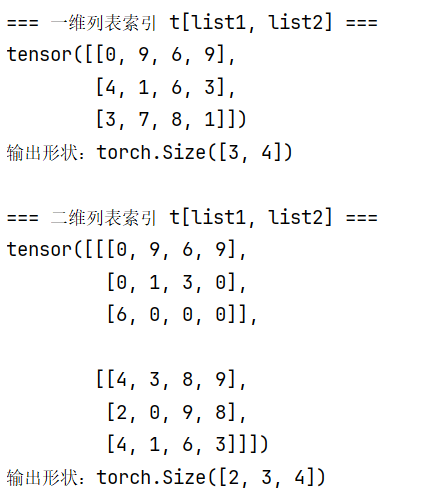
(1)代码示例:
python
# 1. 一维列表索引:按位置一一对应提取元素
# list1 对应 dim=0(矩阵维度),list2 对应 dim=1(行维度)
# 提取位置:(0,1)、(1,3)、(1,2),最终取对应位置的整行(dim=2 全取)
list1 = [0, 1, 1]
list2 = [1, 3, 2]
print("=== 一维列表索引 t[list1, list2] ===")
print(t[list1, list2])
print(f"输出形状:{t[list1, list2].shape}") # 输出形状 (3,4)

# 2. 二维列表索引:广播匹配,批量提取多维度元素
# list1 为 [[0], [1]](对应2个矩阵),list2 为 [1,4,3](对应3行)
# 广播后提取:第0个矩阵的第1、4、3行,第1个矩阵的第1、4、3行
list1 = [[0], [1]]
list2 = [1, 4, 3]
print("\n=== 二维列表索引 t[list1, list2] ===")
print(t[list1, list2])
print(f"输出形状:{t[list1, list2].shape}") # 输出形状 (2,3,4)
(2)运行结果 :
(3)关键说明
- 广播规则:当两个列表维度不同时,PyTorch 会自动广播对齐,生成所有组合位置。
- 索引维度匹配:列表长度需与对应维度的长度兼容,否则会报索引越界错误。
- 等价写法:可使用
torch.tensor作为下标,如t[torch.tensor(list1), torch.tensor(list2)],效果完全一致。
5.5 布尔索引
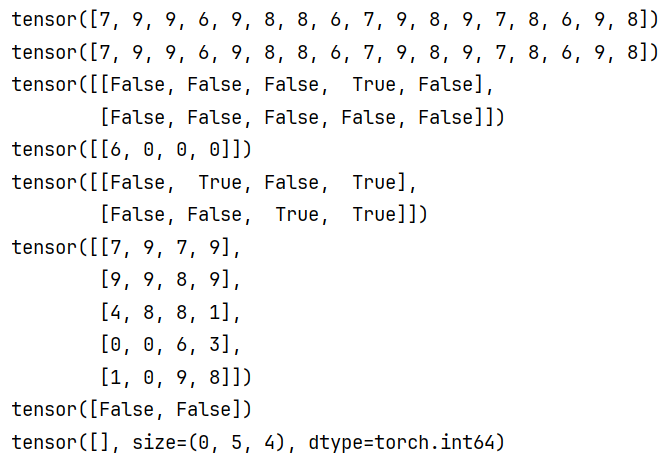
Tensor 的布尔索引(Boolean Indexing)本质就是:用一个布尔类型的 mask(True/False)去选择数据,True 的位置被取出,False 的被丢弃。
这是 PyTorch里非常重要的索引方式,在数据筛选、条件过滤、损失计算里大量使用。
python
# 1. 取出所有大于5的值
#  先做一个布尔掩码: 里面只有true或false
mask = t > 5
#print(mast)
# 用布尔掩码取索引数据
print(t[mask])
print(t[t > 5])

# 2. 取出满足条件的行: 每行的首元素大于5
mask = t[:, :, 0] > 5
print(mask)
print(t[mask])

# 3. 取出满足条件的列: 每列的首元素大于5
mask = t[:, 0, :] > 5
print(mask)
print(t.mT[mask].mT)

# 4. 选取符合条件的矩阵:(1, 2) 元素小于1
mask = t[:, 1, 2] < 1
print(mask)
print(t[mask])
运行结果 :
6 张量形状操作
张量的形状(shape),简单说就是:这个张量有几维、每一维有多少个元素。形状操作就是不改变张量里的数据内容,只改变它的维度结构。主要包括三类:
- 交换维度顺序
- 重新调整维度大小
- 增加或删除维度
深度学习中,模型对输入数据的形状有严格要求,不匹配就会直接报错。张量里的数据是内容,形状是格式;内容对但格式不对,模型就 "读不进去",所以必须做形状操作。
6.1 维度交换
在深度学习中,不同任务对张量维度顺序有不同要求(如 PyTorch 图像格式为C,H,W,OpenCV 为H,W,C),维度交换就是用来调整维度顺序的操作。
首先创建一个3维张量作为演示对象。
python
# 0.创建形状为(3,2,6)的3维张量,元素取值1-10
t1 = torch.randint(1, 10, (3,2,6))
print(t1)
6.1.1)转置所有维度(.T属性)
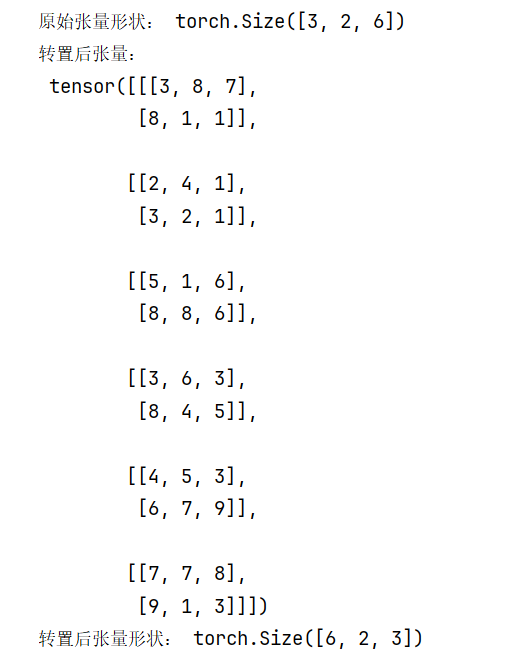
.T是张量的转置属性,会完全反转所有维度的顺序,适用于任意维度张量。
- 转置前形状(3,2,6) → 转置后形状(6,2,3)
- 坐标对应关系:原坐标(0,1,4) → 转置后坐标(4,1,0)
python
# 1.转置所有维度:  转置前形状  (3,2,6) =>  (6,2,3)
# 假设转置前的坐标是  (0, 1, 4)  => (4, 1, 0)
print("原始张量形状:", t1.shape)
t2 = t1.T
print("转置后张量:\n", t2)
print("转置后张量形状:", t2.shape)
运行结果:
6.1.2)只转置最后两个维度(.mT属性)
.mT是矩阵转置的简写,仅交换张量的最后两个维度,其余维度保持不变,等价于二维矩阵的转置操作,在矩阵运算中常用。
python
# 2. 只转置最后两个维度: 就是矩阵转置
print(t1.mT)
print(t1.mT.shape)
运行结果 :
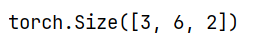
说明:原形状(3,2,6) → 仅交换最后两个维度,最终形状(3,6,2),第一个维度3保持不变。
6.1.3)交换两个指定维度(transpose()方法)
transpose(dim1, dim2)用于交换两个指定维度,其余维度顺序不变,是最常用的维度交换方法。
python
# 3. 交换两个维度
print(t1.transpose(0,1))
print(t1.transpose(0,1).shape)
运行结果 :
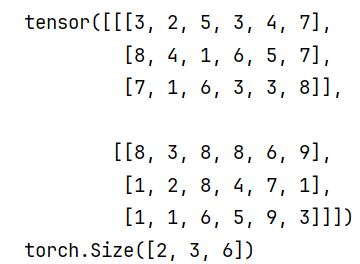
说明:原形状(3,2,6) → 交换 0、1 维后,形状变为(2,3,6),仅调整指定两个维度的顺序。
6.1.4)重新排列所有维度(permute()方法)
permute(*dims)是最灵活的维度操作,可自定义所有维度的排列顺序,完全满足任意维度转换需求。
python
# 4. 重新排列所有维度
print(t1.permute(1,0, 2))
说明:permute可实现.T、.mT、transpose的所有功能,是维度交换的通用方法。
6.2 调整形状
调整形状是在不改变张量元素总数的前提下,修改张量的维度结构,常用于将高维张量展平、适配模型输入格式等场景。
6.2.1)reshape()方法
reshape() 是最常用的形状调整方法,核心规则:变换后各维度的乘积必须等于原张量元素总数,否则会报错。
支持用-1自动推导维度大小,-1代表该维度由其他维度自动计算得出。
python
# 1. reshape   变换后维度数相乘应该不变  比如:(m, n)  变换后也应该等于 m*n
print(t1.reshape(36))
print(t1.reshape(3, 1, -1))
运行结果 :
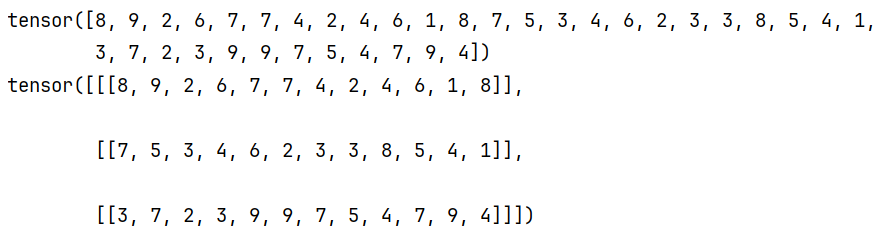
说明:reshape()不要求张量内存连续,兼容性强,是形状调整的首选方法。
6.2.2)view()方法
view() 也可调整张量形状,但要求张量内存必须连续,否则会报错。
- 对于内存不连续的张量,需先调用
contiguous()强制连续,再使用 view()。 - 一般推荐优先使用 reshape(),无需手动处理内存连续性。
python
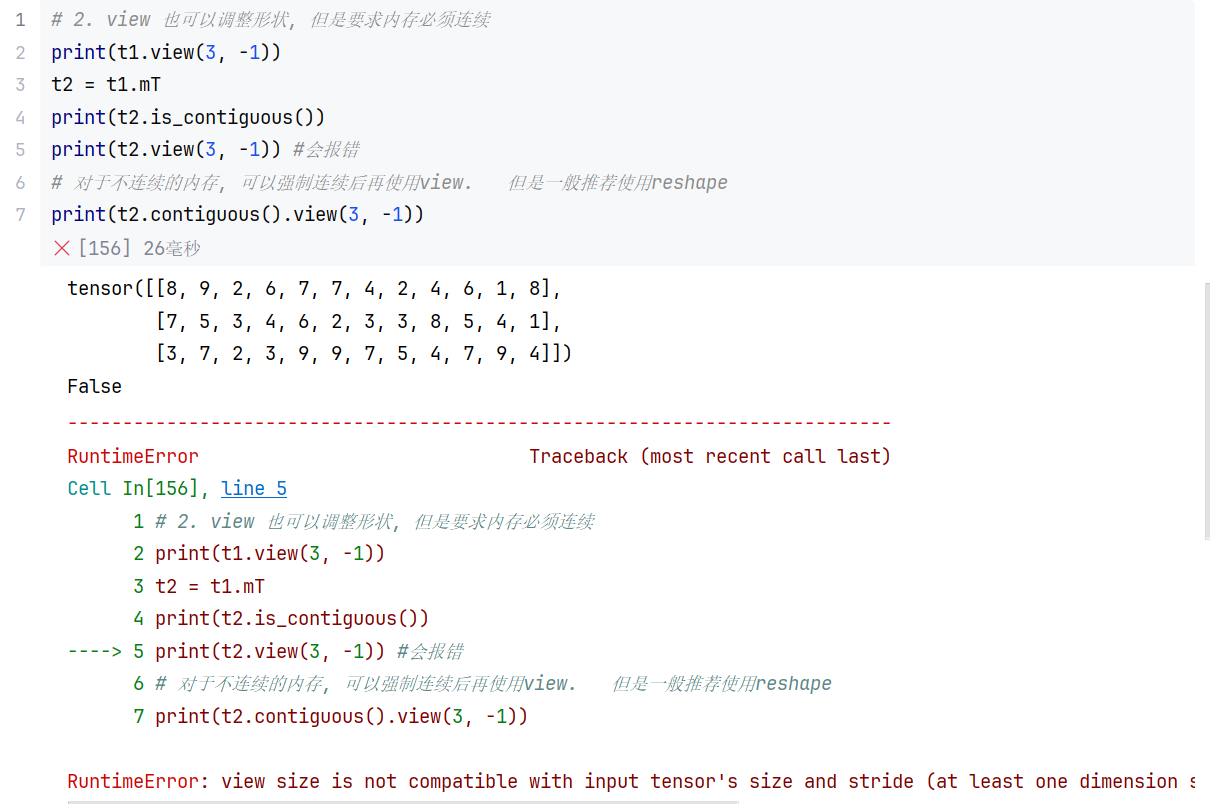
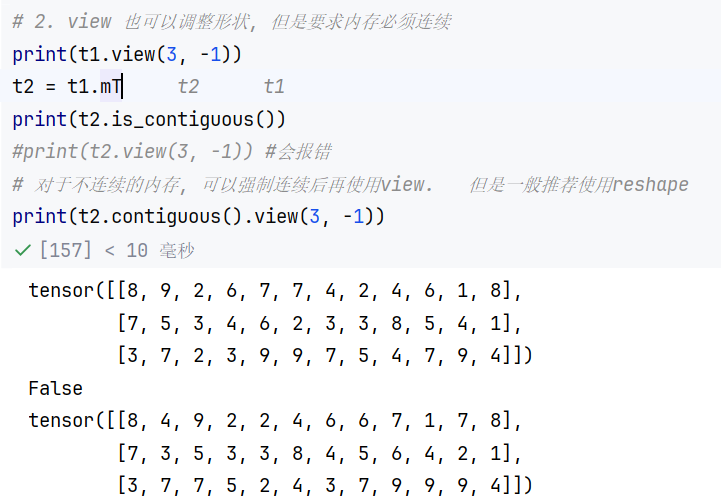
# 2. view 也可以调整形状, 但是要求内存必须连续
print(t1.view(3, -1))
t2 = t1.mT
print(t2.is_contiguous())
print(t2.view(3, -1))
# 对于不连续的内存, 可以强制连续后再使用view.   但是一般推荐使用reshape
print(t2.contiguous().view(3, -1))
运行结果 :
6.3 增删维度
增删维度用于在张量中添加 / 删除大小为 1 的维度,是数据预处理中适配模型输入的常用操作(如给单张图像添加批量维度)。
我们先创建一个 2 维张量作为演示对象:
python
t1 = torch.randint(1, 10, (2, 4))
print(t1)
print(t1.reshape(2,1, 4))
6.3.1)增加维度(unsqueeze()方法)
unsqueeze(dim)用于在指定位置 dim 添加一个大小为 1 的维度,不改变张量元素总数,仅调整维度结构。
python
# 增加维度: 指定位置
print(t1.unsqueeze(dim=2))
#print(t1.unsqueeze(dim=2).shape)
运行结果 :
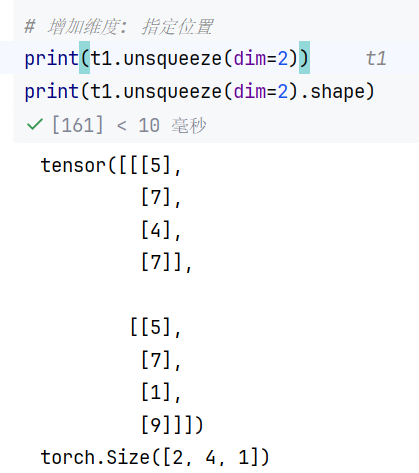
说明:dim 支持负数索引,如dim=-1代表在最后一个维度添加维度。
6.3.2)删除维度(squeeze()方法)
squeeze()用于删除所有大小为 1 的维度,也可通过dim 指定删除某个位置的维度(仅当该维度大小为 1 时生效)。
python
# squeeze 降维: 删除为1的维度
t2 = t1.unsqueeze(dim=0)
print(t2.squeeze())
#print(t2.squeeze().shape)
运行结果 :
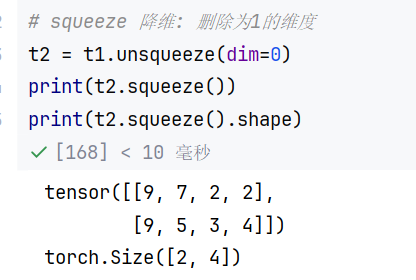
说明:squeeze() 仅删除大小为 1 的维度,不会影响其他维度,是unsqueeze()的逆操作。
7 张量拼接
张量拼接用于将多个张量合并为一个张量,是数据批量处理、特征融合的核心操作,PyTorch 提供 cat() 和 stack() 两种核心方法,二者逻辑完全不同,需重点区分。
7.1 torch.cat():按指定维度拼接(维度不变)
cat() 是拼接操作,核心规则:除拼接维度外,其他维度必须完全相同,拼接后张量维度数不变,仅拼接维度的大小增加。
python
# 1. cat: 按指定维度拼接, 其他维度必须相同
t1 = torch.randint(1, 10, (2, 1, 3))
t2 = torch.randint(1, 10, (2, 3, 3))

print(torch.cat([t1, t2], dim=1))
运行结果 :
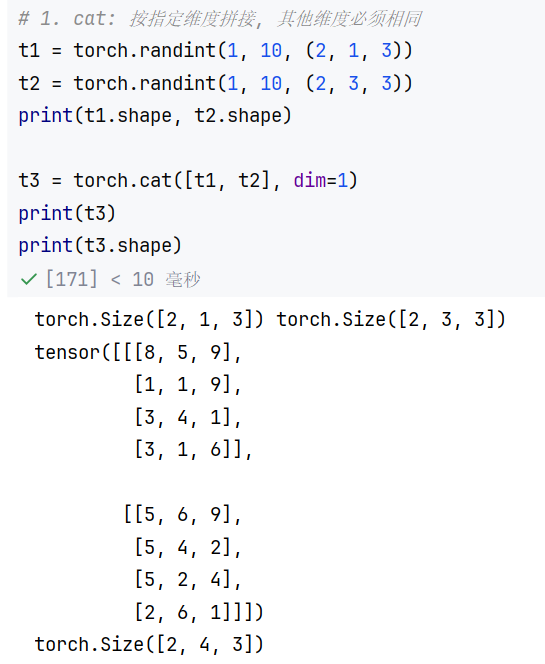
说明:原两个张量第 1 维大小分别为 1 和 3,拼接后第 1 维大小为 1+3=4,其他维度保持不变,张量维度数仍为 3。
7.2 torch.stack():堆叠操作(新增维度)
stack() 是堆叠操作,本质是先给每个张量在指定位置添加一个大小为 1 的维度(unsqueeze),再按该维度拼接(cat),因此堆叠后张量会新增一个维度。
核心要求:所有待堆叠张量的形状必须完全相同。
python
# 2. 堆叠
t1 = torch.randint(1, 10, (3, 4, 5))
t2 = torch.randint(1, 10, (3, 4, 5))
# stack: 本质先squeeze, 再cat
t3 = torch.stack([t1, t2], dim=0)
print(t3.shape)
print(t3)
运行结果 :
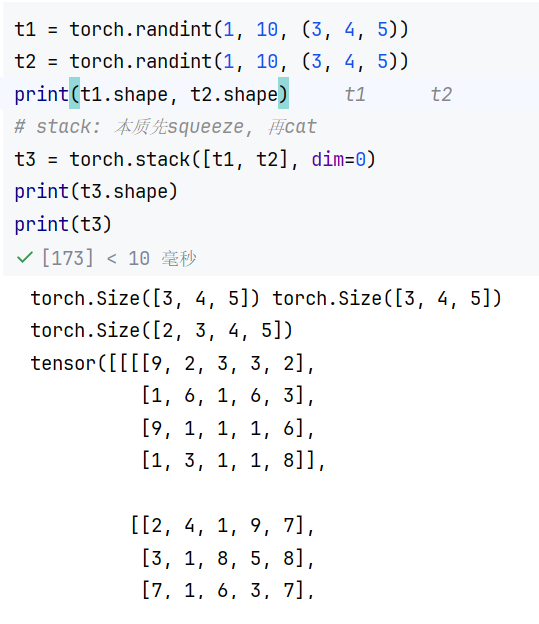
说明:两个形状为 (3,4,5) 的张量,按 dim=0 堆叠后,新增第 0 维,最终形状为 (2,3,4,5),等价于torch.cat([t1.unsqueeze(0), t2.unsqueeze(0)], dim=0) 。