专栏:AI Agent 开发|16
|-----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| 上一篇 15《自动把 Python 函数变成 Tool》已经把"普通函数 → Tool"的重复劳动压下去了:Tool name、description 和参数模型都可以从函数本身生成。现在 Agent Loop 里还剩最后一块明显的执行逻辑:模型已经返回 Tool Call,谁来按 name 找到工具、校验 arguments、真正执行函数,再把结果组织成模型能继续读取的 Tool Result?这一篇只解决这一层------Tool Dispatcher。 |
一、先从 Agent Loop 里最后一段执行代码开始
上一篇结束以后,Loop 大概会出现下面这段代码:
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| for call in output.tool_calls: tool = registry.get(call.name) args = tool.validate(call.arguments) result = tool.func(**args) state.append(tool_result(call.id, result)) |
这段代码能跑,但它把四件事都塞进了 Loop:找工具、校验参数、执行函数、整理结果。Tool 一多,异常处理、日志、超时、同步/异步适配也会继续往这里堆。
所以 Dispatcher 的意义不是"少写四行代码",而是把"怎样执行一次 Tool Call"从"Agent 要不要继续循环"里拆出去。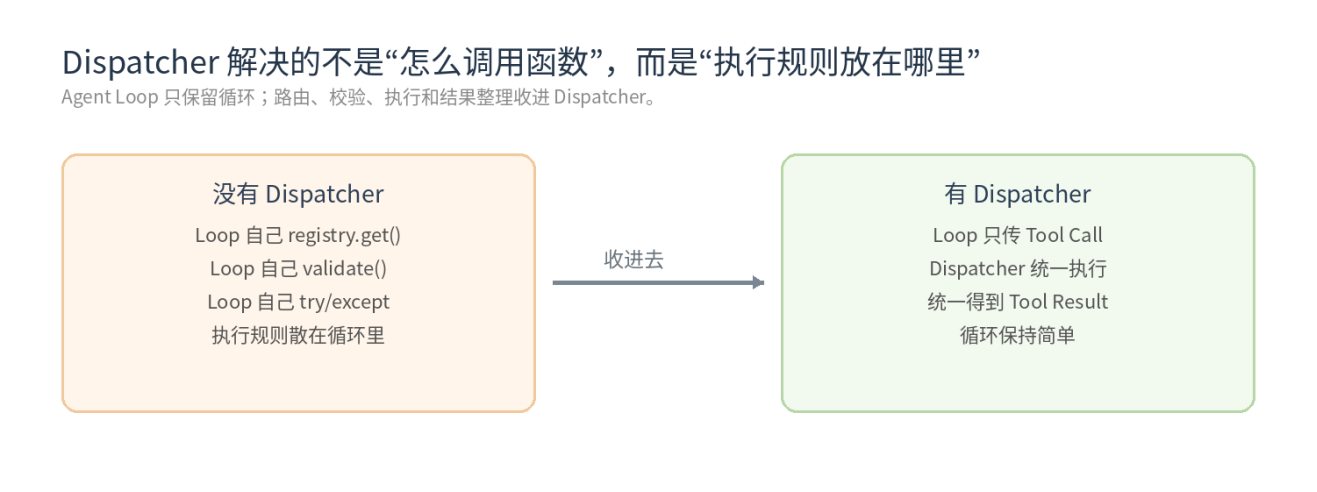
图 1 Dispatcher 把一次 Tool Call 的执行规则从 Agent Loop 中收拢出来
二、Tool Dispatcher 到底是什么
最简单地理解:
Tool Dispatcher = 把一条 Tool Call 变成一次受控的 Tool 执行。
它接收的不是自然语言,而是一条已经结构化的调用请求;它返回的也不是最终答案,而是一条 Tool Result,供 Agent Loop 继续放回消息历史。
• 输入: call_id、tool name、arguments。
• 查找: 通过 Registry 找到唯一的 Tool 对象。
• 校验: 继续复用 Tool.validate(),不要另起一套参数规则。
• 执行: 调用 Tool 绑定的真实函数。
• 输出: 保留原 call_id,把成功结果或可恢复错误整理成 Tool Result。
三、Dispatcher 应该管什么,不应该管什么
|-------------------------------|-----------------------|
| 适合放在 Dispatcher | 先不要放进 Dispatcher |
| 按 name 从 Registry 找 Tool | Tool 注册与 Schema 生成 |
| arguments 解析与 Tool.validate() | 模型为什么选择这个 Tool |
| 调用真实函数 | 权限审批 / 高风险操作确认 |
| 把执行错误整理成 Tool Result | Agent Loop 的停止条件 |
| 保留 call_id 并回传结果 | 全局 Retry / Backoff 策略 |
这个边界和前两篇是一致的:Registry 管"工具是什么",Generator 管"契约怎么从函数产生",Dispatcher 管"这一次调用怎么落地"。别因为写了 Dispatcher,又把所有 Runtime 逻辑重新揉成一个万能类。
四、先把 Provider 返回的调用统一成自己的 ToolCall
不同 Provider 的 Tool Call 外壳可能不同,但 Dispatcher 最好不要到处判断某一家 API 的字段。进入 Dispatcher 前,先统一成一个内部对象:
|------------------------------------------------------------------------------------------------|
| from dataclasses import dataclass @dataclass class ToolCall: id: str name: str arguments: dict |
如果某个 Provider 把 arguments 返回成 JSON 字符串,就在 Adapter / 解析边界先 json.loads();Dispatcher 从这里开始只处理 dict。这样以后换 Provider,不需要重写执行层。
五、最小 Dispatcher:get → validate → func
|----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| class ToolDispatcher: def init(self, registry): self.registry = registry def dispatch(self, call: ToolCall): tool = self.registry.get(call.name) args = tool.validate(call.arguments) return tool.func(**args) |
这 7 行就是 Dispatcher 的骨架。它没有自己研究函数签名,也没有自己再做一遍类型强转,因为这些职责上一篇已经交给 Tool.args_model / Pydantic 了。
六、参数为什么一定要先走 Tool.validate()
模型生成的 arguments 属于外部输入。即使 Schema 已经告诉模型"应该传什么",运行时仍然不能直接 tool.func(**call.arguments)。
• 模型可能漏字段。
• 模型可能多传不存在的字段。
• 字段看起来像数字,实际却是字符串。
• Schema 约束和运行时函数可能在演进中出现不一致。
上一版 Tool.validate() 已经是参数边界,所以 Dispatcher 最重要的原则之一就是:复用它,而不是再写第二套 inspect.signature() 校验器。单一事实来源只有真的被复用,才叫单一事实来源。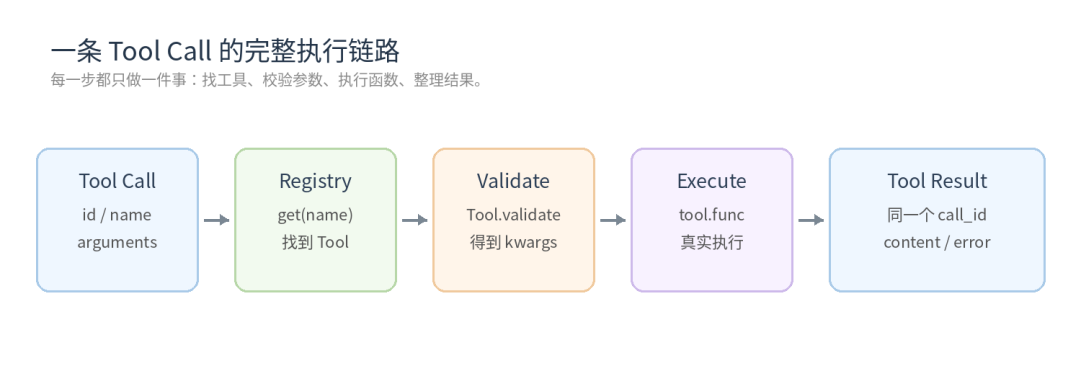
图 2 一条 Tool Call 的完整执行链路:找 Tool、校验、执行,再形成 Tool Result
七、tool_call_id 为什么一定要原样保留
一轮里模型可能同时发出多个 Tool Call。结果回去时,模型需要知道"这条结果对应刚才哪一次调用"。所以 call_id 不是日志编号,而是调用与结果之间的关联键。
|------------------------------------------------------------------------|
| @dataclass class ToolResult: call_id: str content: str ok: bool = True |
Dispatcher 不应该重新生成 id,也不应该只留下 tool name。name 可以重复调用,call_id 才能区分"同一个工具的第 1 次"和"第 2 次"。
八、执行失败以后,是抛异常还是返回错误结果
这里不要走两个极端:既不能让每个普通 Tool 异常直接把整个 Agent Loop 炸掉,也不能把所有错误都机械包装成"让模型自己修"。
|-------------------|---------------------------------|
| 错误类型 | 更合适的处理 |
| 未知 Tool / 参数校验失败 | 整理成可读 Tool Result,让模型有机会修正 |
| 普通业务执行失败 | 记录日志,返回简洁错误结果 |
| 权限拒绝 / 高风险操作 | 交给 Policy / Approval,不伪装成普通工具错误 |
| Dispatcher 自身程序错误 | 记录完整异常,必要时向上抛出 |
关键不是"永远不抛异常",而是区分:哪些错误属于一次 Tool Call 的正常失败,哪些错误说明系统本身出了问题。
九、一轮多个 tool_calls,要不要默认并发
Dispatcher 可以提供 dispatch_many(),但不要因为模型一次返回了多个 Tool Call,就无条件并行。
• 适合并发: 彼此独立的查询,例如同时查多个城市天气。
• 不适合乱并发: 两个调用共享可变状态,或者后一个依赖前一个的结果。
• 写操作更谨慎: 写文件、发邮件、改数据库这类副作用工具,需要额外的执行策略。
所以最小版可以先串行,等你明确 Tool 的执行属性后,再让 Runtime 决定哪些调用允许并发。并发是执行策略,不是 Dispatcher 这个名字自动附带的功能。
十、Agent Loop 是 async 时,同步 Tool 怎么办
这和 F15 的结论完全一致:async Loop 里不能直接塞一个会长时间阻塞的同步 I/O。最简单的约定是让 Tool 明确自己是同步还是异步,再由执行层选择调用方式。
|-------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| import inspect, asyncio async def invoke(tool, kwargs): if inspect.iscoroutinefunction(tool.func): return await tool.func(**kwargs) # 只适合项目约定的"阻塞 I/O 型同步 Tool" return await asyncio.to_thread(tool.func, **kwargs) |
如果 Tool 做的是纯 Python CPU 重计算,to_thread 也不是通用加速器;这类任务仍然要按 F15 的 Bound 判断,交给更合适的执行环境。
十一、一个够用的完整 Dispatcher
|--------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------|
| import json from dataclasses import dataclass @dataclass class ToolResult: call_id: str content: str ok: bool class ToolDispatcher: def init(self, registry): self.registry = registry def dispatch(self, call: ToolCall) -> ToolResult: try: tool = self.registry.get(call.name) args = tool.validate(call.arguments) value = tool.func(**args) content = json.dumps(value, ensure_ascii=False, default=str) return ToolResult(call.id, content, True) except (KeyError, ValueError) as e: return ToolResult(call.id, str(e), False) except Exception as e: return ToolResult( call.id, f"tool execution failed: {type(e).name}", False, ) |
这个版本刻意不把 Retry、权限审批、并发池、进程隔离全部塞进来。它先把最核心的四件事固定住:唯一查找入口、唯一参数校验入口、call_id 保真、执行失败不会把普通循环直接打断。
十二、把 Dispatcher 接回 Agent Loop
|-------------------------------------------------------------------------------------------------------------------------------------------------------------|
| for call in normalize_tool_calls(output): result = dispatcher.dispatch(call) state.append( tool_result( call_id=result.call_id, content=result.content, ) ) |
这时 Loop 已经不需要知道 Tool 用 Pydantic 还是别的校验器,也不需要知道函数具体叫什么。它只负责把"模型的调用请求"交给 Dispatcher,再把"工具结果"放回对话。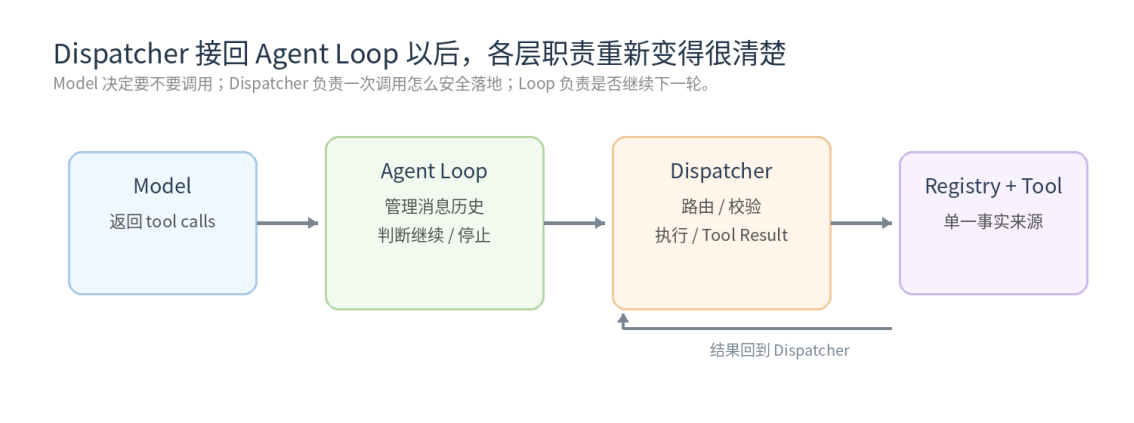
图 3 Model、Agent Loop、Dispatcher、Registry / Tool 各管一层,执行链路重新清晰
十三、几个最容易理解错的地方
• 误区 1:Dispatcher 就是一个 if/else。 它的价值是统一执行边界,而不是换一种分支语法。
• 误区 2:Dispatcher 应该重新校验函数签名。 上一篇已经有 Tool.validate(),这里继续复用。
• 误区 3:所有错误都应该交给模型自愈。 权限、安全和系统内部错误要有独立处理路径。
• 误区 4:一轮多个 Tool Call 就应该全部并发。 是否并发取决于依赖关系、副作用和工具执行属性。
• 误区 5:同步函数都能安全 to_thread。 它更适合阻塞 I/O;CPU 密集任务仍要单独处理。
• 误区 6:Tool Result 只要有 content 就行。 call_id 必须和原调用保持关联。
十四、下一篇
下一篇 17《实现 Agent 最大执行步数》会继续往 Agent Loop 上层走:Dispatcher 已经保证"每一次 Tool 调用能落地",接下来要解决"模型会不会一直调用下去"。我们会给循环加 MAX_STEPS,让 Agent 会做事,也知道什么时候必须停。