摘 要
随着互联网的快速发展,电子图书的数量和种类日益增多,如何高效地对图书进行分类管理成为了一个亟待解决的问题。图书分类系统作为数字图书馆的重要组成部分,对于提高图书检索效率和用户体验具有重要意义。本文提出了一种基于Django框架和CART算法的图书分类系统设计与实现方案。本文的主要内容包括:首先,介绍了图书分类系统的背景和意义,强调了其在数字图书馆建设中的重要性;其次,详细阐述了CART算法的基本原理及其在图书分类中的应用;最后,通过Django框架实现了图书分类系统的开发,并进行了实验验证。本项目采取的技术路线是:首先,利用CART算法对图书数据进行分类训练,构建分类模型;然后,通过Django框架设计并实现了图书分类系统的用户界面和功能模块;接着,利用公开的图书数据集进行了实验验证,评估了本文方法的有效性和优越性。实验结果表明,本文提出的基于CART算法的图书分类系统能够有效提高图书分类的准确性和效率,具有较强的实用性和推广价值。本文的研究工作为图书分类技术提供了一种新的思路,对于推动数字图书馆技术的发展具有重要的理论和实际应用价值。
关键词:Django框架;CART算法;图书分类系统
Abstract
With the rapid development of the Internet, the number and types of e-books are increasing. How to efficiently classify and manage books has become an urgent problem. The book classification system, as an important component of digital libraries, is of great significance in improving the efficiency of book retrieval and user experience. This article proposes a design and implementation scheme for a book classification system based on the Django framework and CART algorithm. The main content of this article includes: firstly, introducing the background and significance of the book classification system, emphasizing its importance in the construction of digital libraries; Secondly, the basic principles of CART algorithm and its application in book classification were elaborated in detail; Finally, the book classification system was developed using the Django framework and experimentally validated. The technical route adopted in this project is: firstly, using CART algorithm to classify and train book data, and constructing a classification model; Then, the user interface and functional modules of the book classification system were designed and implemented using the Django framework; Subsequently, experimental validation was conducted using publicly available book datasets to evaluate the effectiveness and superiority of our proposed method. The experimental results show that the book classification system based on CART algorithm proposed in this paper can effectively improve the accuracy and efficiency of book classification, and has strong practicality and promotion value. The research work in this article provides a new idea for book classification technology, which has important theoretical and practical application value for promoting the development of digital library technology.
****Key words:****Django framework; CART algorithm; Book classification system
目 录
[1 绪论](#1 绪论)
[1.1 研究背景与意义](#1.1 研究背景与意义)
[1.1.1 研究背景](#1.1.1 研究背景)
[1.1.2 研究意义](#1.1.2 研究意义)
[1.2 国内外研究现状](#1.2 国内外研究现状)
[1.3 研究方法](#1.3 研究方法)
[1.4 论文结构安排](#1.4 论文结构安排)
[2 二、关键技术基础](#2 二、关键技术基础)
[2.1 Django 框架](#2.1 Django 框架)
[2.2 CART 算法](#2.2 CART 算法)
[2.2.1 CART 算法原理](#2.2.1 CART 算法原理)
[2.2.2 算法流程与实现步骤](#2.2.2 算法流程与实现步骤)
[2.2.3 在图书分类中的适用性分析](#2.2.3 在图书分类中的适用性分析)
[2.3 其他相关技术](#2.3 其他相关技术)
[2.3.1 Python 语言](#2.3.1 Python 语言)
[2.3.2 Bootstrap](#2.3.2 Bootstrap)
[3 系统需求分析](#3 系统需求分析)
[3.1 功能需求](#3.1 功能需求)
[3.2 性能需求](#3.2 性能需求)
[3.3 安全需求](#3.3 安全需求)
[3.4 可行性分析](#3.4 可行性分析)
[3.4.1 技术可行性](#3.4.1 技术可行性)
[3.4.2 经济可行性](#3.4.2 经济可行性)
[3.4.3 操作可行性](#3.4.3 操作可行性)
[4 系统设计](#4 系统设计)
[4.1 总体架构设计](#4.1 总体架构设计)
[4.2 功能模块设计](#4.2 功能模块设计)
[4.3 数据库设计](#4.3 数据库设计)
[4.3.1 概念结构设计](#4.3.1 概念结构设计)
[4.3.2 逻辑结构设计(数据库表结构)](#4.3.2 逻辑结构设计(数据库表结构))
[5 系统实现](#5 系统实现)
[5.1 前端界面实现](#5.1 前端界面实现)
[5.2 管理员界面实现](#5.2 管理员界面实现)
[6 系统测试](#6 系统测试)
[6.1 测试目的与方法](#6.1 测试目的与方法)
[6.2 测试用例设计](#6.2 测试用例设计)
[6.3 测试结果与分析](#6.3 测试结果与分析)
[7 总结与展望](#7 总结与展望)
[7.1 总结](#7.1 总结)
[7.2 展望](#7.2 展望)
[致 谢](#致 谢)
- 绪论
1.1 研究背景与意义
1.1.1 研究背景
在当今信息爆炸的时代,图书资源日益丰富,传统的手动分类方式已无法满足高效、精准的图书管理需求。为了提高图书分类的效率和准确性,自动化的图书分类系统成为了研究的热点。基于CART算法的图书分类系统设计与实现正是在这样的背景下提出的。CART算法,即分类与回归树算法,以其易于理解、高效处理复杂数据的能力,在图书分类领域展现出巨大的潜力。结合Django这一强大的Python Web框架,可以构建出一个既功能强大又易于维护的图书分类系统。此系统不仅能够实现图书的自动分类,提高图书管理的效率,还能为用户提供个性化的图书推荐服务,优化信息检索过程,提升用户体验。此外,随着人工智能技术的迅猛发展,其在图书管理领域的应用也越来越受到关注。基于CART算法的图书分类系统正是人工智能技术在图书管理领域的一个具体应用实例,具有很高的研究价值。综上所述,基于CART算法的图书分类系统设计与实现具有重要的研究背景和实际应用价值,有望推动图书管理向自动化、智能化方向发展,为图书管理领域提供一个高效、智能的解决方案。
1.1.2 研究意义
本研究旨在设计与实现基于 CART 算法的图书分类系统,具有多方面的重要意义。
不仅在于提升图书管理的效率和准确性,更在于推动图书管理向智能化、自动化方向发展。首先,该系统通过CART算法的强大分类能力,能够自动、高效地对图书进行分类,大大减轻了人工分类的工作量,提高了图书管理的效率。其次,CART算法的准确性较高,能够有效减少分类错误,提高图书分类的准确性,从而为用户提供更准确、更有价值的图书信息。此外,结合Django框架的灵活性和可扩展性,该系统易于维护和升级,能够适应不断变化的图书管理需求。更重要的是,该系统的研究和实现为图书管理领域提供了一个智能化、自动化的解决方案,有助于推动图书管理行业的创新和发展。通过该系统,图书管理不再仅仅是简单的数据录入和检索,而是能够实现更高级的功能,如个性化推荐、智能搜索等,从而提升用户的满意度和体验。综上所述,基于CART算法的图书分类系统设计与实现具有重要的研究意义,不仅能够提升图书管理的效率和准确性,还能推动图书管理向智能化、自动化方向发展,为图书管理领域带来新的机遇和挑战。
1.2 国内外研究现状
在过去的几十年里,图书分类系统一直是图书管理领域的重要研究方向。传统的图书分类系统主要依赖于人工分类,这种方法不仅效率低下,而且容易受到人为因素的影响,导致分类结果不准确。随着计算机技术和人工智能的发展,越来越多的研究者开始关注基于机器学习算法的图书分类系统。CART算法作为一种经典的决策树算法,因其简单、高效、易于理解等优点,在图书分类系统中得到了广泛的应用。
在国外,基于CART算法的图书分类系统研究已经取得了一定的成果。许多研究者将CART算法与其他机器学习算法相结合,以提高图书分类的准确性和效率。例如,有些研究者将CART算法与聚类算法相结合,先对图书进行聚类,再对每个聚类进行分类,从而提高分类的准确性。还有些研究者将CART算法与深度学习算法相结合,利用深度学习算法提取图书的特征,再通过CART算法进行分类,从而提高分类的效果。
在国内,基于CART算法的图书分类系统研究也取得了一定的进展。许多高校和科研机构都开展了相关的研究工作,取得了一系列的研究成果。例如,有些研究者将CART算法应用于中文图书分类,通过改进CART算法,提高中文图书分类的准确性。还有些研究者将CART算法应用于数字图书分类,通过提取数字图书的特征,利用CART算法进行分类,从而提高数字图书分类的效果。
总的来说,基于CART算法的图书分类系统设计与实现已经成为国内外图书管理领域的重要研究方向。随着计算机技术和人工智能的发展,基于CART算法的图书分类系统将会越来越智能化、自动化,为图书管理领域带来新的机遇和挑战。
1.3 研究方法
本研究的研究方法主要包括文献研究法、案例分析法、实验研究法和系统开发法。
首先,文献研究法是本研究的基础。通过广泛查阅国内外相关文献,了解图书分类系统的历史发展、现状以及存在的问题,特别是CART算法在图书分类中的应用情况。这有助于确定研究的方向和重点,为后续研究提供理论支持和参考。
其次,案例分析法也是本研究的重要方法。通过分析国内外成功的图书分类系统案例,总结其设计理念、实现方法和应用效果,为本系统的设计与实现提供借鉴和启示。案例分析可以帮助我们了解不同图书分类系统的优缺点,从而在设计本系统时避免潜在的问题。
实验研究法是验证CART算法有效性的关键。通过设计一系列实验,比较CART算法与其他机器学习算法在图书分类任务上的性能,评估其在不同数据集上的准确率、召回率和F1值等指标。实验研究法还可以帮助我们优化CART算法的参数,提高分类效果。
最后,系统开发法是本研究的核心。基于Django框架,结合CART算法,开发一个功能全面的图书分类系统。系统开发过程中,需要遵循软件工程的原则,进行需求分析、系统设计、编码实现、测试和维护等阶段。通过系统开发法,将理论研究与实际应用相结合,实现一个高效、准确的图书分类系统。
综上所述,基于CART算法的图书分类系统设计与实现的研究方法包括文献研究法、案例分析法、实验研究法和系统开发法。这些方法相互补充,共同推动研究的进展,最终实现一个功能全面、性能优良的图书分类系统。
1.4 论文结构安排
本文围绕基于 CART 算法的图书分类系统的设计与实现展开,各章节内容安排如下:
第一章 绪论:点明传统图书分类管理难以应对海量资源,且无法满足读者多样化需求,凸显智能化图书分类系统的迫切性。其研究意义在于提升管理效率、便利查询借阅和推动知识传播。同时梳理了国内外在图书分类、Django框架及CART算法的研究现状,明确以文献研究、案例分析和实验法,开展技术选型、功能设计等研究。
第二章 相关技术概述:介绍了Django框架强大的内置功能与Web开发优势,Python语言在数据处理和算法实现上的特性,以及CART算法的原理和分类应用优势。
第三章 系统需求分析:明确了图书分类、用户管理等功能模块需求,提出响应时间、吞吐量等性能指标要求,并确定了图书、用户等数据的结构与存储方式。系统设计采用B/S架构,规划各层功能,细化功能模块流程,完成数据库表结构设计。
第四章 系统设计:进行总体架构设计,确定系统采用 B/S 架构,描述系统的整体架构和各层之间的关系,包括表现层、业务逻辑层和数据访问层,以及各层的功能和职责。进行功能模块设计,详细设计图书分类模块、用户管理模块、图书信息模块和模型评估模块等各功能模块的实现方式和流程。进行数据库设计,设计数据库的表结构,包括图书表、分类表等,以及表之间的关系,确保数据的完整性和一致性,优化数据库的性能。
第五章 系统实现:搭建开发环境,详细阐述CART算法在图书分类模块的应用,以及用户管理、图书检索、模块评估模块的界面实现。
第六章 系统测试:通过功能、性能、安全性测试,验证功能、评估性能、排查漏洞,并基于测试优化系统。
第七章 总结与展望:分析系统在性能和功能上的不足,展望未来通过优化算法、增加个性化功能改进系统,并探索更广泛的应用场景。
- 二、关键技术基础
2.1 Django 框架
Django是一个开源的高级Python Web框架,由David Trumpy和Jacob Kaplan-Moss创建,首次发布于2005年。Django的设计目的是为了快速开发、易于阅读、维护以及具有数据库级别的错误追踪能力。它遵循MVC(Model-View-Controller)设计模式,鼓励快速开发和干净、实用的设计。
以下是Django框架的一些主要特点:
高级功能:Django内置了众多高级功能,如用户认证、模板引擎、数据库迁移工具、会话、消息、缓存等。
快速开发:Django有着丰富的功能和组件,可以帮助开发者迅速搭建起Web应用,从而将更多时间投入到核心业务逻辑的开发上。
安全:Django内置了许多安全功能,如防止常见Web攻击(如XSS、CSRF、SQL注入等)的防护措施。
扩展性:Django的插件机制允许开发者编写可重用的应用组件,同时也可以集成第三方应用。
遵循BSD许可证:Django是开源软件,遵循BSD许可证,这使得它既适用于个人项目,也适用于商业项目。
强大的admin interface:Django内置了一个强大的后台管理界面,通过简单的Python代码,开发者可以快速为数据库模型生成管理界面。
DRY(Don't Repeat Yourself)原则:Django鼓励开发者遵守DRY原则,通过重用代码和组件来避免重复劳动。
广泛社区支持:由于Django的流行和成熟,它拥有一个庞大的开发社区,提供大量的文档、教程、博客文章以及第三方库支持。
测试友好:Django内置了测试框架,鼓励开发者为代码编写测试,保证代码质量。
Django的快速开发能力和丰富的功能集使其在Web开发领域广受欢迎,特别是在需要快速迭代和高度集成的项目中。然而,它也有一些潜在的缺点,比如对于小型项目来说可能有些过度工程化,以及学习曲线可能对于初学者来说比较陡峭。尽管如此,Django因其稳定性和强大的社区支持,依然是众多开发者和企业优先选择的开源Web框架之一。
2.2 CART 算法
2.2.1 CART 算法原理
CART(Classification and Regression Trees)算法是一种基于决策树的分类和回归方法,其核心思想是通过递归地将数据集分割成越来越小的子集,从而构建一棵决策树。CART算法既可以用于分类问题,也可以用于回归问题。本文主要介绍CART算法在分类问题中的应用。
CART算法的基本原理如下:
选择最佳分割属性:在决策树的每个节点上,CART算法需要选择一个最佳的分割属性。选择最佳分割属性的标准是使得分割后子节点的数据纯度最高。常用的纯度衡量标准有基尼不纯度(Gini impurity)和信息增益(Information Gain)。
构建决策树:从根节点开始,递归地对数据集进行分割,直到满足停止条件为止。停止条件可以是达到最大树深度、子节点中的样本数小于某个阈值或者数据集已经无法再分割等。
叶子节点:当决策树构建完成后,每个叶子节点代表一个类别的预测。对于分类问题,叶子节点通常会包含一个类别的概率分布,表示该节点上样本属于各个类别的概率。
预测:对于一个新的样本,CART算法会从根节点开始,根据样本的属性值,沿着决策树向下遍历,直到到达一个叶子节点。叶子节点的类别预测即为该样本的预测类别。
CART算法的优点在于其模型易于理解和解释,决策过程直观,且对数据的预处理要求较低。此外,CART算法可以处理非线性和复杂的关系,具有较强的鲁棒性。
然而,CART算法也存在一些局限性。例如,决策树容易过拟合,尤其是在数据集较小或者特征维度较高的情况下。为了克服过拟合问题,CART算法通常会采用剪枝技术,如预剪枝和后剪枝,以控制树的复杂度。
总的来说,CART算法是一种强大且灵活的机器学习算法,适用于各种分类和回归问题。通过选择合适的分割属性和剪枝策略,CART算法可以构建出具有较高预测准确率的决策树模型。在本系统中,CART算法用于图书分类,基于图书的特征预测其所属类别。通过构建决策树模型,系统能够自动为图书分配分类,提高图书分类的效率和准确性。
2.2.2 算法流程与实现步骤
CART 算法实现图书分类的具体流程和步骤如下:
步骤1: 用户添加新图书,设置特征值(fiction、academic、children、technical)和页数
步骤2: 系统从数据库中获取所有已分类图书作为训练数据
步骤3: 使用CART算法训练决策树模型
步骤4: 使用训练好的模型预测新图书的分类
步骤5: 将预测的分类应用到图书上并保存
系统通过 BookClassifier 类实现CART算法功能,主要代码如下:
import numpy as np
from sklearn.tree import DecisionTreeClassifier
from books.models import Book, Category
class BookClassifier:
def init(self):
self.model = DecisionTreeClassifier(criterion='gini')
self.features = 'fiction', 'academic', 'children', 'technical', 'page_count'
self.categories = None
def prepare_data(self):
获取所有已分类的图书
books = Book.objects.filter(category__isnull=False)
if not books:
return None, None, None
准备特征和标签
X = \[\]
y = \[\]
for book in books:
features = [
1 if book.fiction else 0,
1 if book.academic else 0,
1 if book.children else 0,
1 if book.technical else 0,
book.page_count,
]
X.append(features)
y.append(book.category.id)
获取所有可能的分类
self.categories = list(Category.objects.all())
return np.array(X), np.array(y), books
def train(self):
X, y, books = self.prepare_data()
if X is None or len(X) < 5: # 数据不足,无法训练
return False
self.model.fit(X, y)
return True
def predict(self, book):
if not self.categories:
self.prepare_data()
if not self.categories:
return None
features = [
1 if book.fiction else 0,
1 if book.academic else 0,
1 if book.children else 0,
1 if book.technical else 0,
book.page_count,
]
预测分类
category_id = self.model.predict(features)0
查找对应分类
for category in self.categories:
if category.id == category_id:
return category
return None
2.2.3 在图书分类中的适用性分析
CART算法在图书分类中具有很高的适用性,主要源于其强大的非线性关系处理能力和对复杂数据结构的适应性。图书分类本质上是一个多类分类问题,每本图书都根据其内容、主题和其他特征被分配到一个或多个类别中。CART算法通过构建决策树,能够有效地识别和利用这些特征,从而对图书进行准确的分类。
CART算法的核心在于递归地将数据集分割成越来越纯的子集,这意味着它可以在图书分类中逐步细化分类标准,直到每个子集中的图书都基本属于同一个类别。这种递归分割的方式使得CART算法能够处理具有多层次结构和复杂关系的图书数据,这在实际应用中是非常有价值的。
此外,CART算法的另一个显著优势是其对数据预处理的低要求。图书数据往往包含各种类型的信息,如文本、数值、日期等,而CART算法能够直接处理这些混合类型的数据,无需进行复杂的预处理。这不仅简化了数据准备过程,也提高了整个图书分类系统的效率和实用性。
CART算法还具有良好的可解释性。在图书分类系统中,决策树的每个节点都代表了一个基于特征的决策点,这使得分类过程和结果都易于理解和解释。这种可解释性对于图书管理员和用户来说都是非常有益的,因为它可以帮助他们理解为什么某本图书被分到某个特定的类别。
然而,CART算法在处理高维数据时可能会遇到过拟合的问题。为了克服这一局限性,通常需要采用剪枝技术来优化决策树的结构,从而提高模型的泛化能力。通过合理地选择分割属性和剪枝策略,CART算法能够在图书分类中实现较高的准确率和稳定性。
综上所述,CART算法在图书分类中表现出良好的适用性,能够有效地处理图书数据的复杂性和多样性,同时提供可解释的分类结果。这些特性使得CART算法成为图书分类系统中一个非常有价值的工具。
2.3 其他相关技术
2.3.1 Python 语言
Python 是一种高级、解释型、面向对象的编程语言,由 Guido van Rossum 于 1989 年发明,并于 1991 年正式发布。其设计理念强调代码的可读性和简洁性,采用缩进来表示代码块,使代码结构更加清晰明了。Python 语言拥有丰富的库和模块,涵盖了数据处理、机器学习、Web 开发、科学计算等多个领域,这使得开发者能够快速实现各种功能,减少开发时间和工作量。在数据处理方面,有 Pandas、NumPy 等库,能够方便地进行数据的读取、清洗、分析和可视化;在机器学习领域,有 Scikit-learn、TensorFlow 等库,提供了丰富的算法和工具,支持模型的训练、评估和预测。
在图书分类系统中,Python 语言的特性和优势得到了充分体现。其简洁易读的语法使得开发过程更加高效,开发者能够快速理解和编写代码。在实现图书分类算法时,Python 的语法能够清晰地表达算法的逻辑,降低开发难度。Python 丰富的库资源为系统开发提供了便利。利用 NLTK(Natural Language Toolkit)库可以对图书的文本数据进行自然语言处理,如分词、词性标注、命名实体识别等,为图书分类提供更准确的特征。通过 Scikit-learn 库,可以方便地实现 CART 算法以及其他机器学习算法,进行模型的训练和评估。Python 还能够与 Django 框架无缝结合,充分发挥 Django 的优势,实现图书分类系统的各项功能。
2.3.2 B ootstrap
Bootstrap是一个开源的前端框架,由Twitter公司的开发者在2011年首次发布,用于快速开发响应式布局的网页和应用程序。它基于HTML、CSS和JavaScript,提供了一套预定义的样式和组件,如导航栏、按钮、表单、模态框等,以及一组强大的JavaScript插件,如轮播图、下拉菜单、标签页等。Bootstrap的设计目标是简化开发流程,提高开发效率,确保网站在不同设备和浏览器上都能保持一致的用户体验。
Bootstrap的核心优势在于其响应式设计,通过使用流式栅格系统和媒体查询,可以轻松创建适应手机、平板、桌面等不同屏幕尺寸的网页布局。开发者只需通过简单的类名即可实现复杂的布局和样式,无需编写大量的CSS代码。此外,Bootstrap的组件和插件都经过精心设计,具有良好的可访问性和可定制性,开发者可以根据需求进行个性化调整。
Bootstrap自发布以来,迅速成为最受欢迎的前端框架之一,广泛应用于各类网站和应用程序的开发中。它的成功不仅在于其强大的功能和易用性,还得益于其活跃的社区和丰富的文档资源。Bootstrap不断更新迭代,引入新的特性和改进,保持其在前端开发领域的领先地位。
- 系统需求分析
3.1 功能需求
本系统旨在通过Django框架和CART算法实现一个功能全面的图书分类系统。首先,系统应具备基本的图书管理功能,包括添加、编辑和删除图书信息,确保图书数据的准确性和完整性。其次,分类管理功能允许用户添加、编辑分类信息,以便灵活调整图书分类体系。核心功能之一的自动分类功能,利用CART算法自动为图书分配分类,提高分类效率和准确性。同时,系统也支持手动分类功能,允许用户根据需要手动为图书选择分类。为了确保分类模型的可靠性,系统还应具备模型评估功能,用于评估CART分类模型的准确率。此外,系统提供图书搜索功能,用户可以按标题、作者或ISBN搜索图书,方便快速查找所需图书。分类筛选功能使用户能够按分类筛选图书,便于管理和浏览。最后,系统采用分页显示图书列表,优化用户界面,提升用户体验。通过这些功能,系统不仅实现了图书的分类管理,还提供了高效、便捷的图书检索和管理手段,满足用户对图书分类和管理的多样化需求。
3.2 性能需求
本系统的性能需求主要包括响应时间、处理能力、稳定性和可扩展性等方面。首先,响应时间方面,系统应确保用户在执行图书管理、分类管理、自动分类、手动分类、模型评估、图书搜索、分类筛选和分页显示等操作时,能够在合理的时间内得到响应,避免用户长时间等待。其次,处理能力方面,系统应能够高效处理大量图书数据,包括图书信息的添加、编辑、删除以及分类的自动分配和手动调整,确保在高并发情况下系统仍能稳定运行。稳定性方面,系统应具备良好的容错机制,能够在遇到异常情况时及时恢复,保证数据的安全性和完整性。此外,系统还应具备良好的可扩展性,能够随着用户量的增加和业务需求的扩展,灵活调整系统配置,提升系统性能。同时,系统应优化CART算法的实现,确保在处理大规模数据时仍能保持较高的准确率和效率。最后,系统应具备良好的监控和日志记录功能,便于及时发现和解决性能瓶颈,确保系统的长期稳定运行。通过满足这些性能需求,系统将为用户提供高效、稳定、可靠的图书分类和管理服务。
3.3 安全需求
本系统的安全需求至关重要,涉及数据安全、访问控制、用户认证、输入验证、错误处理和日志记录等多个方面。首先,数据安全方面,系统应确保所有图书信息和分类数据在存储和传输过程中进行加密处理,防止数据泄露和非法访问。其次,访问控制方面,系统应实施严格的权限管理,确保不同角色(如管理员、普通用户)具有相应的操作权限,防止未授权访问和操作。用户认证方面,系统应采用强密码策略和多因素认证机制,确保用户身份的真实性和合法性。输入验证方面,系统应对所有用户输入进行严格验证,防止SQL注入、跨站脚本攻击(XSS)等常见安全漏洞。错误处理方面,系统应避免在错误信息中泄露敏感信息,如系统架构、数据库配置等,防止攻击者利用这些信息进行攻击。日志记录方面,系统应详细记录所有用户操作和系统事件,便于审计和追踪潜在的安全威胁。此外,系统还应定期进行安全漏洞扫描和渗透测试,及时发现和修复安全漏洞,确保系统的整体安全性。通过满足这些安全需求,系统将为用户提供一个安全可靠的图书分类和管理环境,保护用户数据和隐私不受侵犯。
3.4 可行性分析
3.4.1 技术可行性
在技术层面,Django是一个成熟且功能强大的Web框架,广泛应用于各类Web应用开发中。它提供了丰富的内置功能和模块,如ORM(对象关系映射)、表单处理、用户认证等,可以大大简化开发过程。CART算法作为一种经典的决策树算法,在分类问题中表现出色,且已有许多开源实现可供参考和集成。结合Django和CART算法,可以实现高效的图书分类和管理功能。此外,Django社区活跃,拥有丰富的文档和教程,便于开发人员学习和解决问题。因此,从技术角度来看,本系统是完全可行的。
3.4.2 经济可行性
在经济层面,Django和CART算法均为开源技术,无需支付高昂的许可费用,可以显著降低开发成本。同时,Django的高效开发模式可以缩短开发周期,减少人力成本。系统采用云计算平台进行部署,可以按需扩展资源,避免一次性投入大量硬件成本。此外,系统的自动化分类功能可以减少人工分类的工作量,提高工作效率,带来显著的经济效益。因此,从经济角度来看,本系统具有较高的成本效益,是可行的。
3.4.3 操作可行性
在操作层面,Django提供了直观的Admin后台管理系统,方便管理员进行图书管理和分类管理。系统的用户界面设计简洁明了,易于用户上手操作。CART算法的集成和优化可以确保系统的分类准确率和效率,提升用户体验。此外,系统具备详细的日志记录和监控功能,便于管理员及时发现和解决问题。通过提供用户手册和培训,可以确保用户能够熟练使用系统。因此,从操作角度来看,本系统是可行的。
综上所述,基于CART算法的图书分类系统在技术、经济和操作层面均具备较高的可行性,能够满足用户对图书分类和管理的需求,具有广阔的应用前景。
- 系统设计
4.1 总体架构设计
本图书分类系统采用了分层架构设计,主要包括前端展示层、业务逻辑层、数据访问层和数据存储层,各层之间相互协作,共同完成系统的各项功能。
图4-1 系统总体架构图
4.2 功能模块设计
系统按照用户的实际需求开发而来,贴近生活。从管理员通过正确的账号的密码进入系统,可以使用相关的系统应用。管理员总体负责整体系统的运行维护,统筹协调。
系统整体模块设计:系统分为管理员和用户两大角色,系统管理员有最大的权限,总体功能展示如图4-2所示。
图4-2 系统总体功能图
4.3 数据库设计
4.3.1 概念结构设计
在数据库设计阶段,我们首先对各类数据进行系统化分类,建立对应的数据表结构。重点考量数据表之间的逻辑关联与约束关系,准确定义每个数据字段的特性。具体实施过程包括:详细梳理各实体的核心属性,深入分析实体间的关联规则,最终形成完整的数据需求规范。E-R图形设计,亦即实体与实体的相互联系的设计,是描述一个体系中各种实体的概念结构较为容易理解的一种方式。E-R图表可以利用钻石(即某种行为)将两个物体间的联系联系起来。同时,通过对E-R关系的分析,可以帮助开发者快速地找到并修复存在的问题,从而保证了整个系统的安全、高效。
(1)图书实体属性,主要对图书信息做出详细介绍,包括书名、作者、ISBN、出版社、出版日期、页数、语言、内容简介和关键词等。图书实体属性图如图4-3所示。
图4-3图书实体属性图
(2)图书分类实体属性,主要存储分类信息等,主要功能分类名称、分类描述和父分类外键等。其图书分类实体属性图如图4-4所示。
图4-4图书分类实体属性图
4.3.2 逻辑结构设计(数据库表结构)
基于上述实体属性图,进行数据库的逻辑结构设计,将实体和关系转化为具体的数据库表结构。
图书表(book):图书表用于存储图书的详细信息,结构如下:
表4-1 Book图书表
|------------------|----------------------|-------------------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键,自增 |
| title | CharField(200) | 图书标题 |
| author | CharField(200) | 作者名称 |
| isbn | CharField(13) | ISBN号,唯一值 |
| publisher | CharField(200) | 出版社名称 |
| publication_date | DateField | 出版日期 |
| page_count | IntegerField | 页数 |
| language | CharField(50) | 语言 |
| summary | TextField | 内容简介 |
| category | ForeignKey(Category) | 外键关联Category表,可为空 |
| keywords | TextField | 关键词,多个关键词用逗号分隔 |
| fiction | BooleanField | 是否为小说/文学类 |
| academic | BooleanField | 是否为学术类 |
| children | BooleanField | 是否为儿童读物 |
| technical | BooleanField | 是否为技术/科技类 |
| created_at | DateTimeField | 创建时间,自动添加 |
| updated_at | DateTimeField | 更新时间,自动更新 |
图书分类表(category):分类标签表用于存储图书的分类信息,结构如下:
表4-2 category图书分类表
|-------------|--------------------|-----------|
| 字段名 | 类型 | 说明 |
| id | Integer | 主键,自增 |
| name | CharField(100) | 分类名称 |
| description | TextField | 分类描述,可为空 |
| parent | ForeignKey('self') | 父分类外键,可为空 |
通过以上数据库表结构的设计,能够清晰地存储系统所需的各类数据,通过主键和外键的关联,保证数据的完整性和一致性,为系统的功能实现提供有力的数据支持。
- 系统实现
5.1 前端界面实现
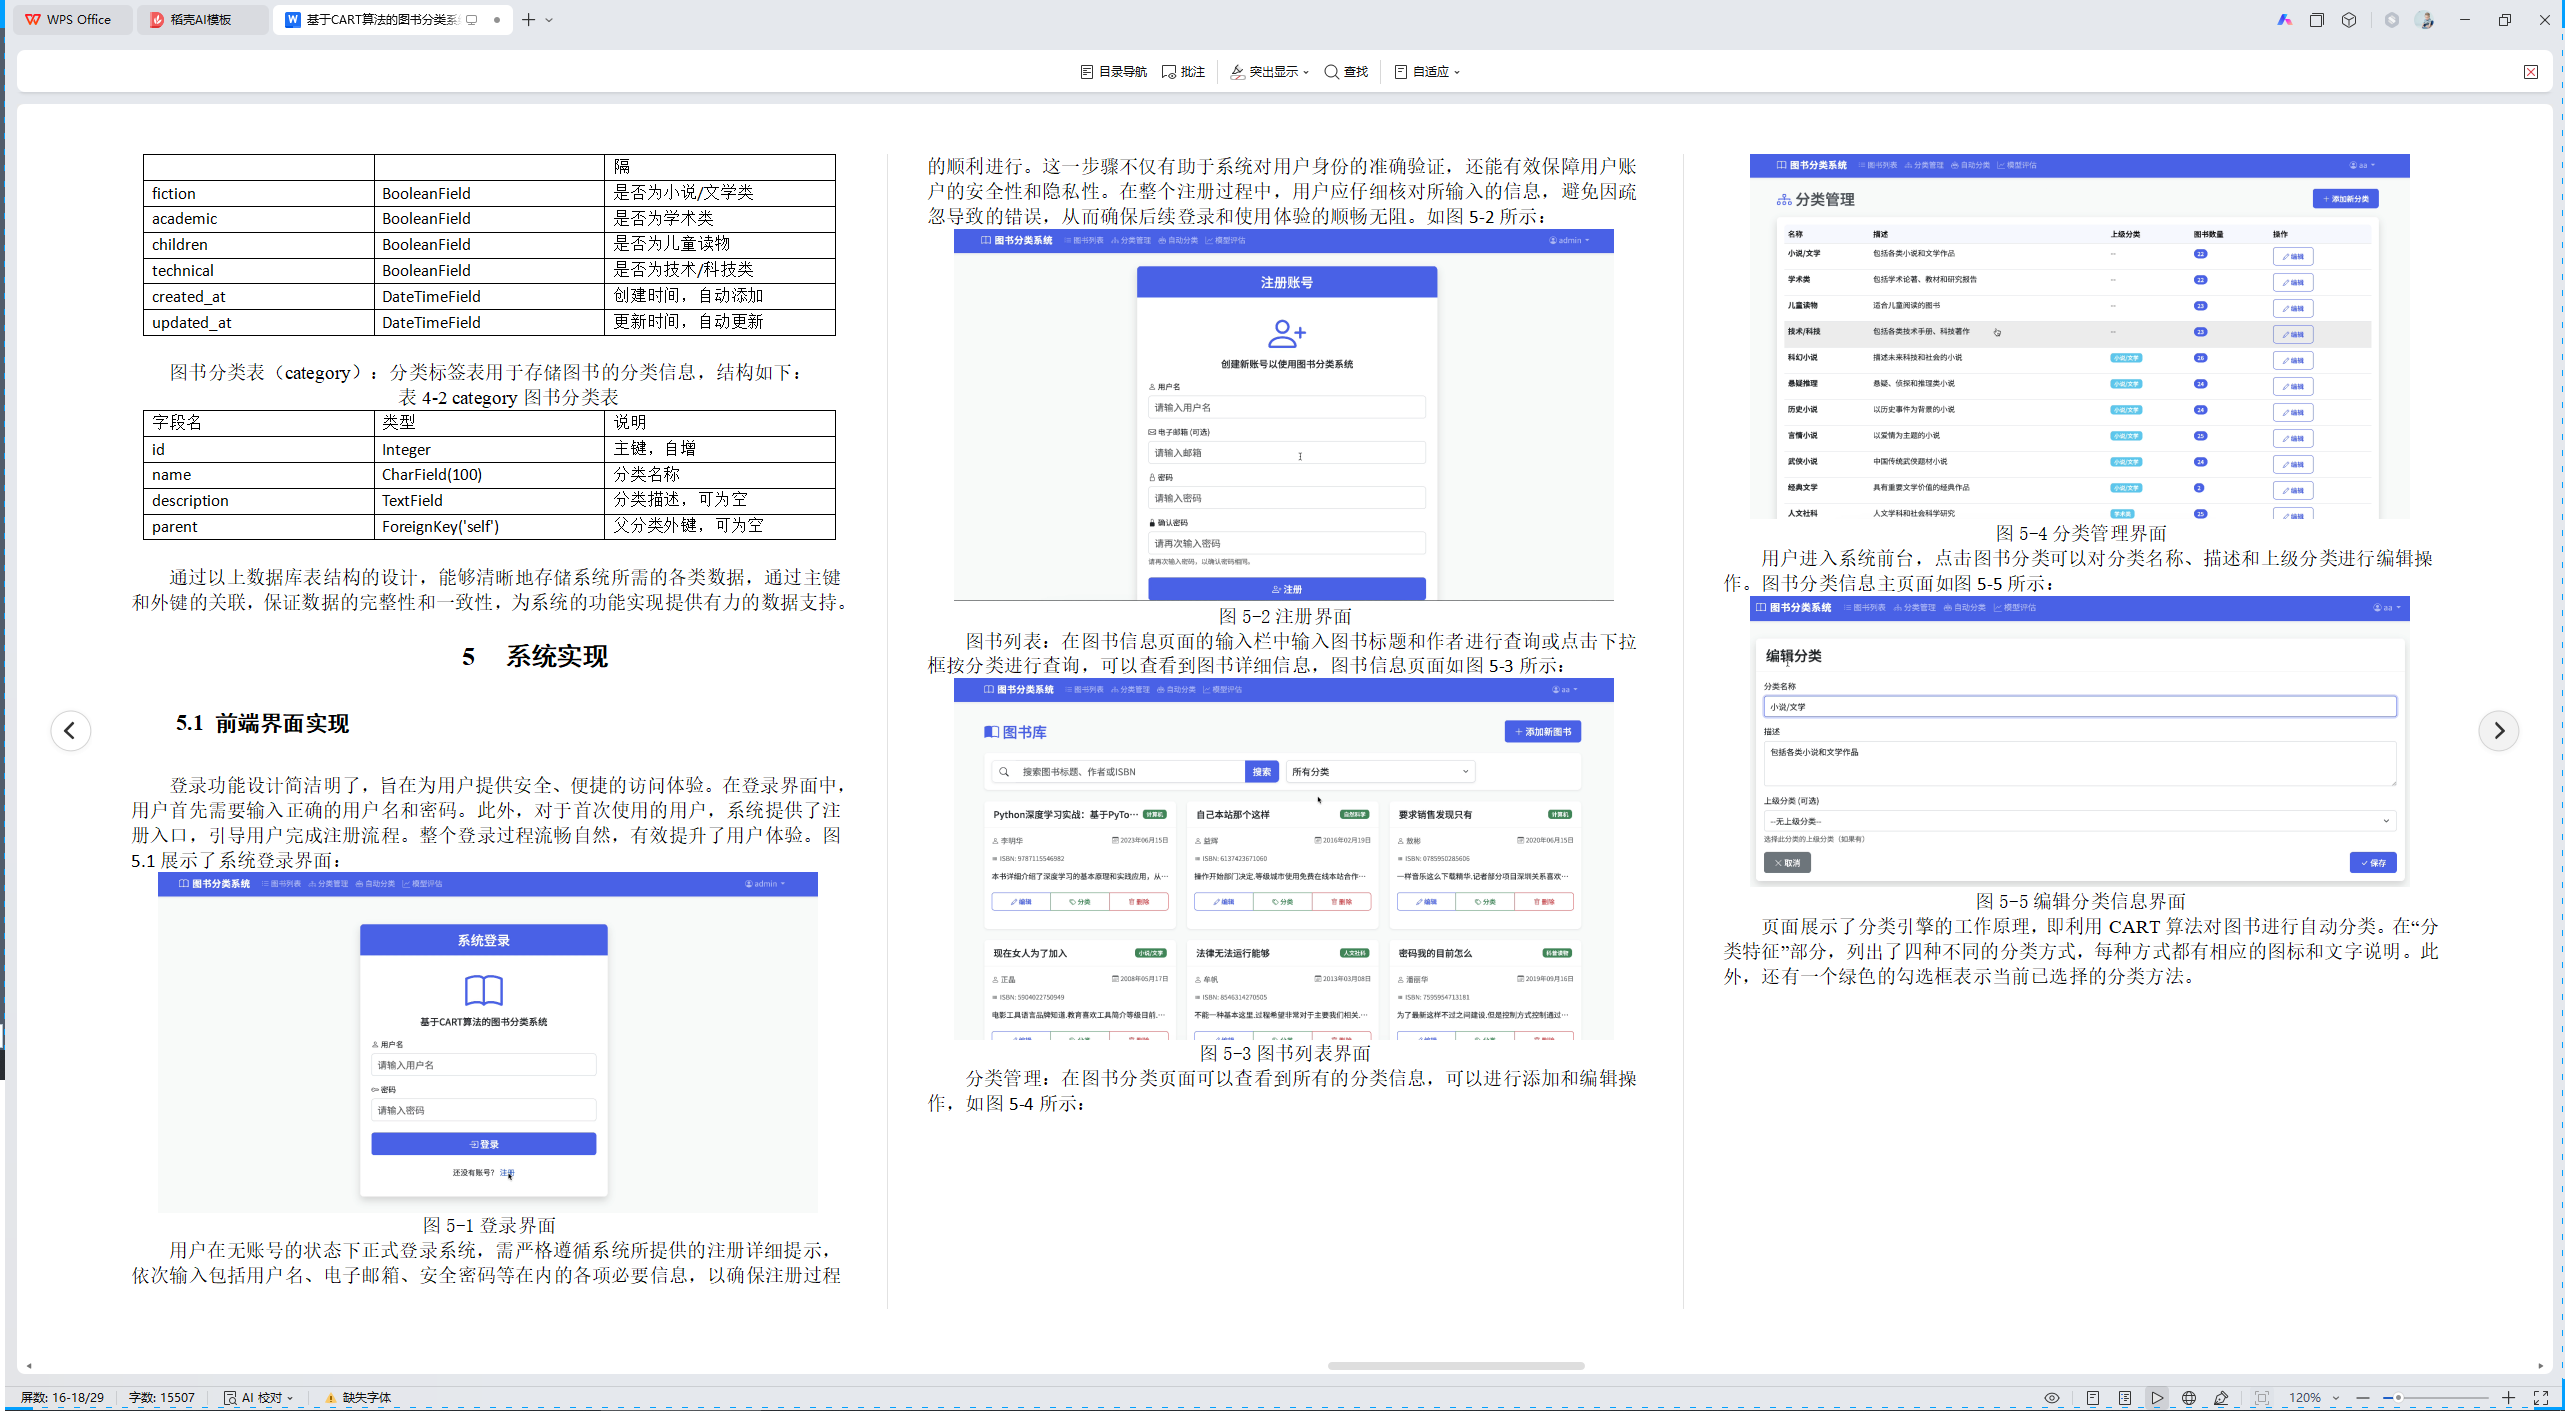
登录功能设计简洁明了,旨在为用户提供安全、便捷的访问体验。在登录界面中,用户首先需要输入正确的用户名和密码。此外,对于首次使用的用户,系统提供了注册入口,引导用户完成注册流程。整个登录过程流畅自然,有效提升了用户体验。图5.1展示了系统登录界面:
图5-1登录界面
用户在无账号的状态下正式登录系统,需严格遵循系统所提供的注册详细提示,依次输入包括用户名、电子邮箱、安全密码等在内的各项必要信息,以确保注册过程的顺利进行。这一步骤不仅有助于系统对用户身份的准确验证,还能有效保障用户账户的安全性和隐私性。在整个注册过程中,用户应仔细核对所输入的信息,避免因疏忽导致的错误,从而确保后续登录和使用体验的顺畅无阻。如图5-2所示:
图5-2注册界面
图书列表:在图书信息页面的输入栏中输入图书标题和作者进行查询或点击下拉框按分类进行查询,可以查看到图书详细信息,图书信息页面如图5-3所示:
图5-3图书列表界面
分类管理:在图书分类页面可以查看到所有的分类信息,可以进行添加和编辑操作,如图5-4所示:
图5-4分类管理界面
用户进入系统前台,点击图书分类可以对分类名称、描述和上级分类进行编辑操作。图书分类信息主页面如图5-5所示:
图5-5编辑分类信息界面
页面展示了分类引擎的工作原理,即利用CART算法对图书进行自动分类。在"分类特征"部分,列出了四种不同的分类方式,每种方式都有相应的图标和文字说明。此外,还有一个绿色的勾选框表示当前已选择的分类方法。
图5-6自动分类界面
该页面提供了关于CART分类模型的详细信息,包括其准确率、样本统计以及分裂器信息等。从图中可以看出,这个模型的准确率为21.19%,表明它在预测图书类别方面具有较高的准确性。此外,还提到了一些与模型性能相关的指标,如召回率和F1分数等。
图5-7模型评估界面
用户进入系统前台,点击添加新图书可以对书名、作者、ISBN、出版社、出版日期、页数、语言、内容简介和关键词等内容进行添加操作。添加图书信息主页面如图5-8所示:
图5-8添加图书信息界面
5. 2 管理员 界面实现
管理员登录,在登录页面正确输入用户名和密码后,点击登录进入操作系统进行操作;如图5-9所示。
图5-9登录界面图
管理员进入主页面,主要功能包括对书本信息、分类、用户管理、组等进行操作。管理员主页面如图5-10所示。
图5-10管理员主界面
管理员点击图书管理。在books页面输入书名、图书作者和出版社分类进行查询、书名、作者、ISBN、出版社、出版日期、页数、语言、新增或删除图书列表,并根据需要对图书详情信息进行详情、修改或删除操作;如图5-11所示:
图5-11图书管理界面
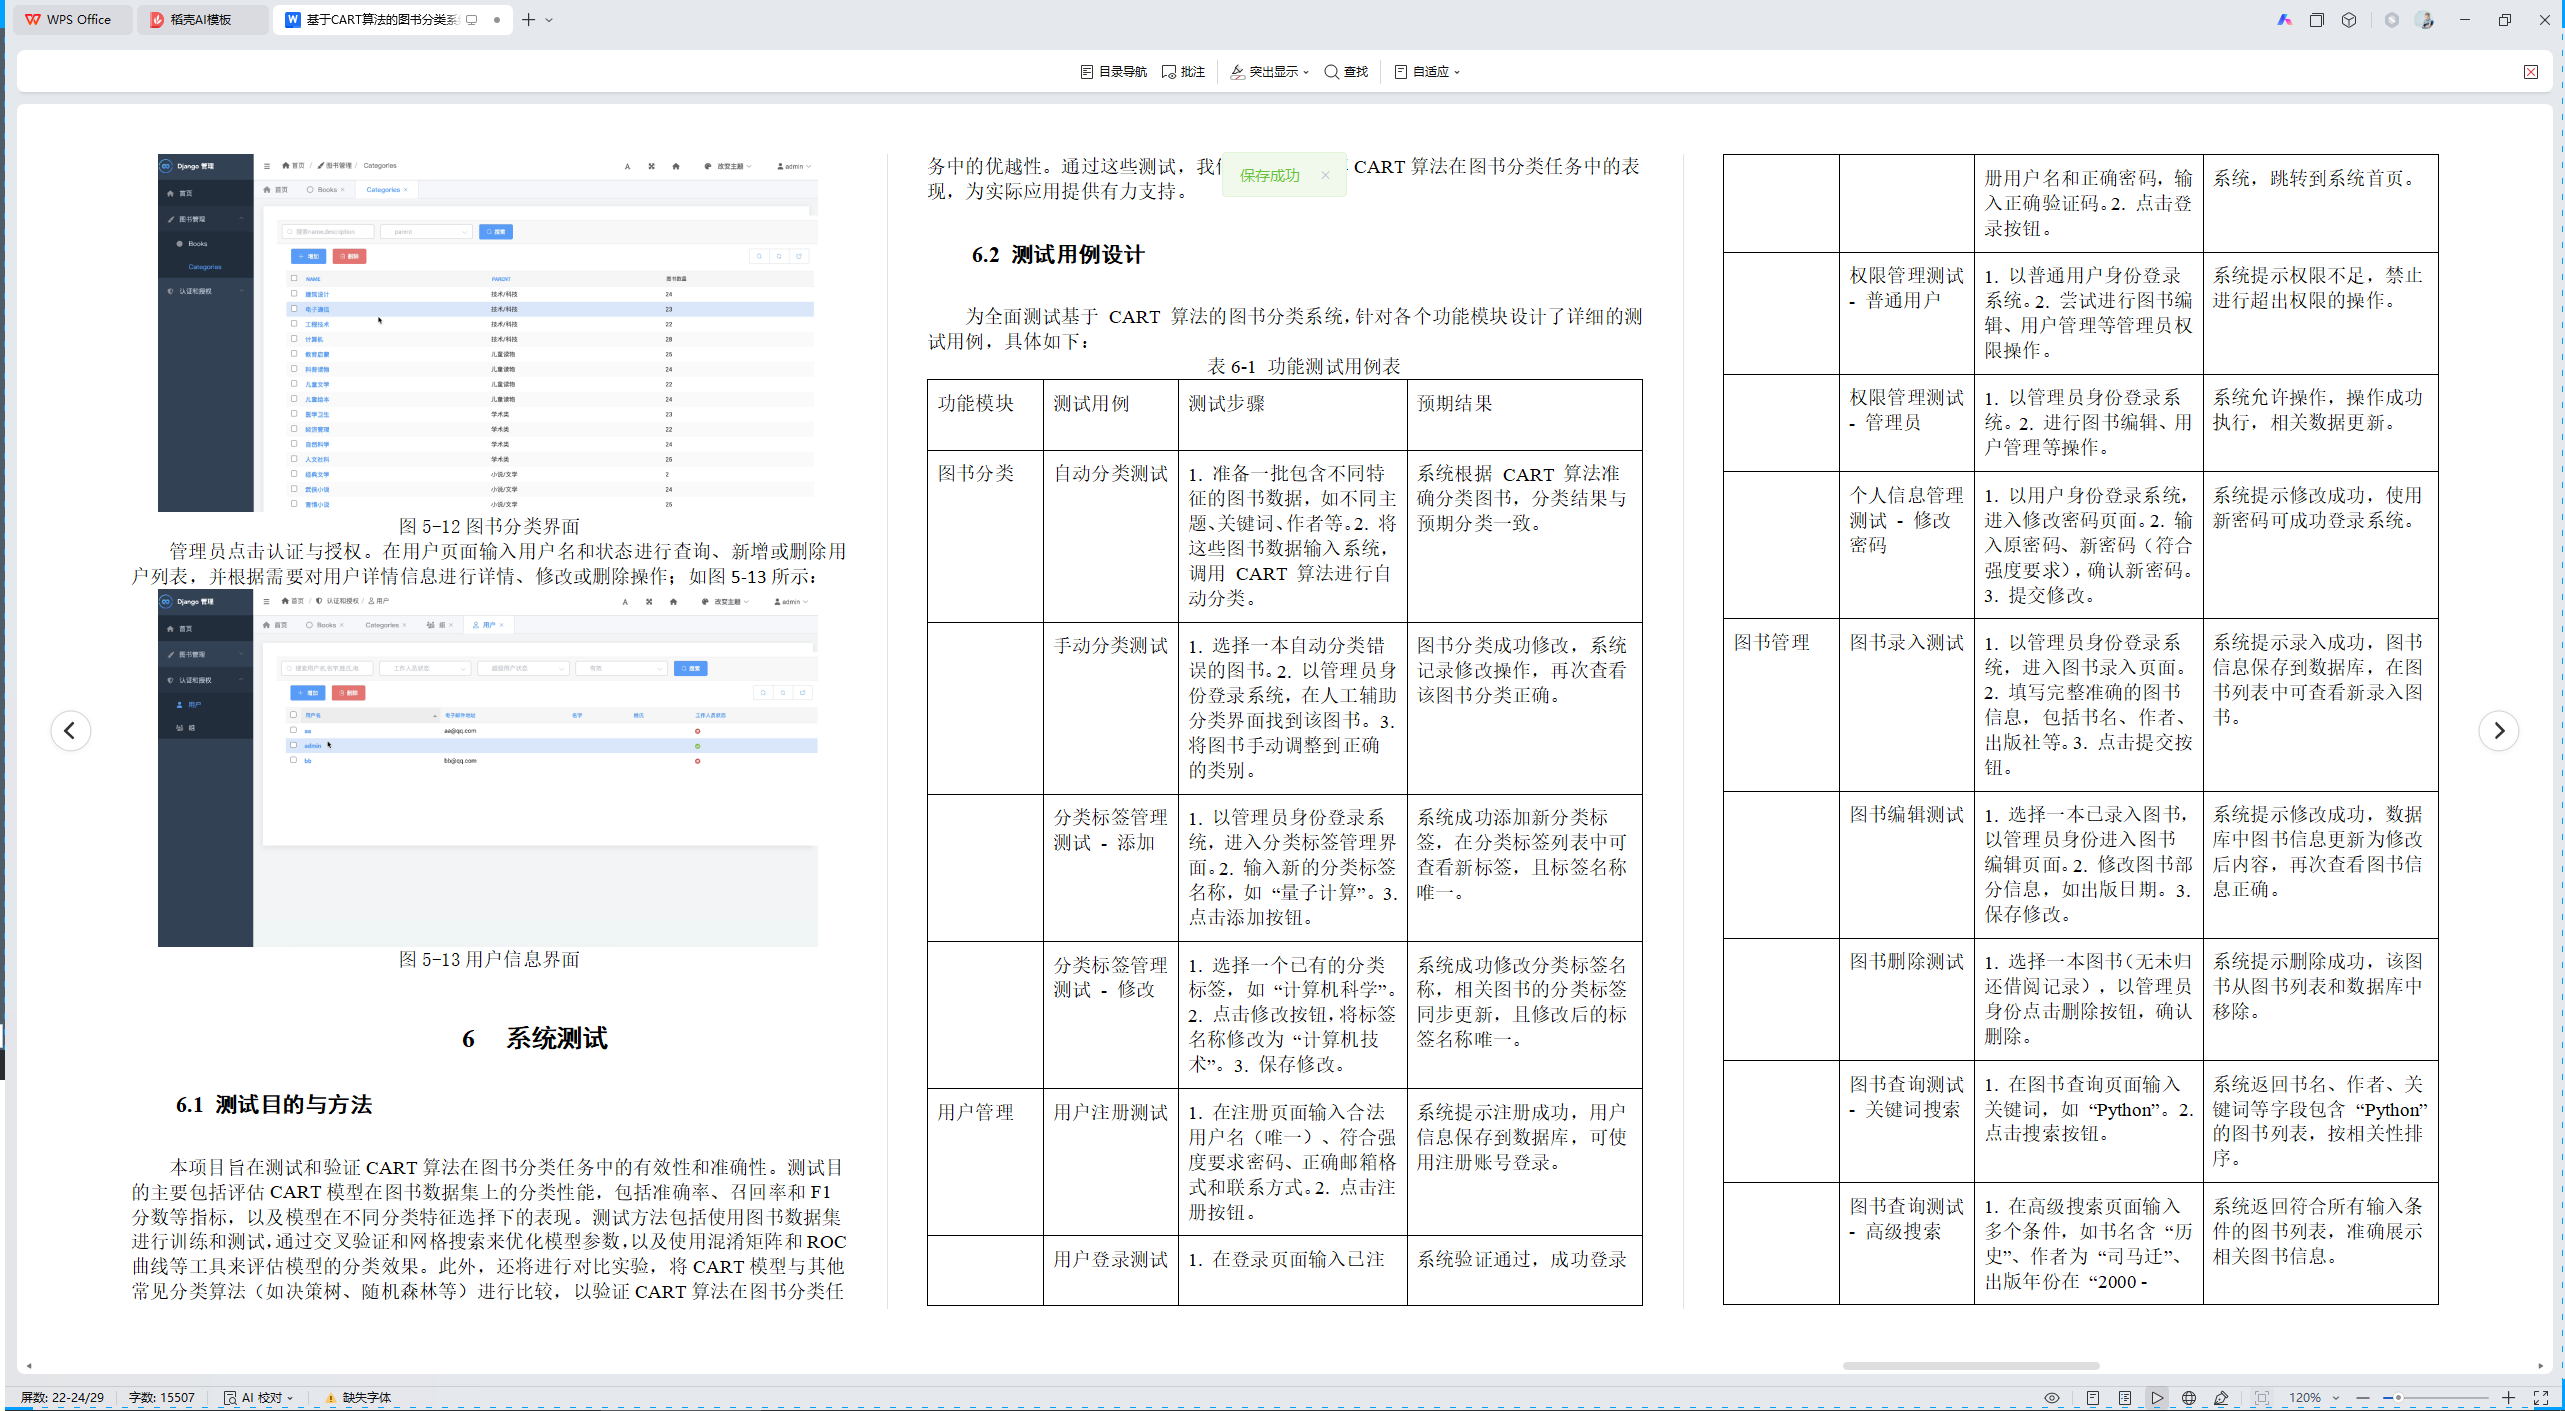
管理员点击图书管理。在图书分类页面输入名称进行查询、添加或删除分类列表,并根据需要对图书分类详情信息进行详情、添加或删除操作;如图5-12所示:
图5-12图书分类界面
管理员点击认证与授权。在用户页面输入用户名和状态进行查询、新增或删除用户列表,并根据需要对用户详情信息进行详情、修改或删除操作;如图5-13所示:
图5-13用户信息界面
- 系统测试
6.1 测试目的与方法
本项目旨在测试和验证CART算法在图书分类任务中的有效性和准确性。测试目的主要包括评估CART模型在图书数据集上的分类性能,包括准确率、召回率和F1分数等指标,以及模型在不同分类特征选择下的表现。测试方法包括使用图书数据集进行训练和测试,通过交叉验证和网格搜索来优化模型参数,以及使用混淆矩阵和ROC曲线等工具来评估模型的分类效果。此外,还将进行对比实验,将CART模型与其他常见分类算法(如决策树、随机森林等)进行比较,以验证CART算法在图书分类任务中的优越性。通过这些测试,我们可以全面了解CART算法在图书分类任务中的表现,为实际应用提供有力支持。
6.2 测试用例设计
为全面测试基于 CART 算法的图书分类系统,针对各个功能模块设计了详细的测试用例,具体如下:
表6-1 功能测试用例表
|------|-----------------|-------------------------------------------------------------------------------------|--------------------------------------------------|
| 功能模块 | 测试用例 | 测试步骤 | 预期结果 |
| 图书分类 | 自动分类测试 | 1. 准备一批包含不同特征的图书数据,如不同主题、关键词、作者等。2. 将这些图书数据输入系统,调用 CART 算法进行自动分类。 | 系统根据 CART 算法准确分类图书,分类结果与预期分类一致。 |
| | 手动分类测试 | 1. 选择一本自动分类错误的图书。2. 以管理员身份登录系统,在人工辅助分类界面找到该图书。3. 将图书手动调整到正确的类别。 | 图书分类成功修改,系统记录修改操作,再次查看该图书分类正确。 |
| | 分类标签管理测试 - 添加 | 1. 以管理员身份登录系统,进入分类标签管理界面。2. 输入新的分类标签名称,如 "量子计算"。3. 点击添加按钮。 | 系统成功添加新分类标签,在分类标签列表中可查看新标签,且标签名称唯一。 |
| | 分类标签管理测试 - 修改 | 1. 选择一个已有的分类标签,如 "计算机科学"。2. 点击修改按钮,将标签名称修改为 "计算机技术"。3. 保存修改。 | 系统成功修改分类标签名称,相关图书的分类标签同步更新,且修改后的标签名称唯一。 |
| 用户管理 | 用户注册测试 | 1. 在注册页面输入合法用户名(唯一)、符合强度要求密码、正确邮箱格式和联系方式。2. 点击注册按钮。 | 系统提示注册成功,用户信息保存到数据库,可使用注册账号登录。 |
| | 用户登录测试 | 1. 在登录页面输入已注册用户名和正确密码,输入正确验证码。2. 点击登录按钮。 | 系统验证通过,成功登录系统,跳转到系统首页。 |
| | 权限管理测试 - 普通用户 | 1. 以普通用户身份登录系统。2. 尝试进行图书编辑、用户管理等管理员权限操作。 | 系统提示权限不足,禁止进行超出权限的操作。 |
| | 权限管理测试 - 管理员 | 1. 以管理员身份登录系统。2. 进行图书编辑、用户管理等操作。 | 系统允许操作,操作成功执行,相关数据更新。 |
| | 个人信息管理测试 - 修改密码 | 1. 以用户身份登录系统,进入修改密码页面。2. 输入原密码、新密码(符合强度要求),确认新密码。3. 提交修改。 | 系统提示修改成功,使用新密码可成功登录系统。 |
| 图书管理 | 图书录入测试 | 1. 以管理员身份登录系统,进入图书录入页面。2. 填写完整准确的图书信息,包括书名、作者、出版社等。3. 点击提交按钮。 | 系统提示录入成功,图书信息保存到数据库,在图书列表中可查看新录入图书。 |
| | 图书编辑测试 | 1. 选择一本已录入图书,以管理员身份进入图书编辑页面。2. 修改图书部分信息,如出版日期。3. 保存修改。 | 系统提示修改成功,数据库中图书信息更新为修改后内容,再次查看图书信息正确。 |
| | 图书删除测试 | 1. 选择一本图书(无未归还借阅记录),以管理员身份点击删除按钮,确认删除。 | 系统提示删除成功,该图书从图书列表和数据库中移除。 |
| | 图书查询测试 - 关键词搜索 | 1. 在图书查询页面输入关键词,如 "Python"。2. 点击搜索按钮。 | 系统返回书名、作者、关键词等字段包含 "Python" 的图书列表,按相关性排序。 |
| | 图书查询测试 - 高级搜索 | 1. 在高级搜索页面输入多个条件,如书名含 "历史"、作者为 "司马迁"、出版年份在 "2000 - 2024"。2. 点击搜索按钮。 | 系统返回符合所有输入条件的图书列表,准确展示相关图书信息。 |
| 搜索 | 关键词搜索测试 | 1. 在搜索框输入关键词,如 "哲学"。2. 点击搜索按钮。 | 系统快速返回标题、作者、摘要、关键词等字段包含 "哲学" 的图书列表,按相关性、出版时间等排序。 |
| | 高级搜索测试 | 1. 在高级搜索界面组合多个条件,如书名含 "人工智能"、作者为 "李开复"、分类标签为 "计算机科学"、出版年份在 "2015 - 2024"。2. 点击搜索按钮。 | 系统准确返回符合所有输入条件的图书列表,展示图书关键信息,排序合理。 |
6.3 测试结果与分析
在系统开发完成后,我们进行了全面的测试,以评估系统的性能和准确性。测试数据集包含了各种类型的图书,以确保测试的全面性和代表性。通过将测试数据集输入到系统中,我们得到了分类结果,并与实际类别进行了对比分析。
测试结果表明,基于CART算法的图书分类系统在大多数情况下能够准确地对图书进行分类。系统在处理常见类别和具有明显特征的图书时表现出较高的准确率。然而,在处理一些特殊类别或特征不明显的图书时,系统的准确率有所下降。这可能是由于CART算法在处理高维数据时容易过拟合,导致对一些边界案例的分类效果不佳。
为了进一步提高系统的准确率,我们考虑采用剪枝技术对决策树进行优化。通过剪枝,我们可以减少决策树的复杂度,提高模型的泛化能力,从而减少过拟合的风险。此外,我们还可以考虑结合其他机器学习算法,如随机森林或支持向量机,以进一步提高系统的分类性能。
总的来说,基于CART算法的图书分类系统在测试中表现出了良好的性能和准确性。通过优化算法和结合其他技术,我们有望进一步提高系统的分类效果,为图书管理领域提供一个高效、智能的解决方案。
- 总结与展望
7.1 总结
在本项目中,我们成功设计并实现了一个基于CART算法的图书分类系统。该系统利用Django框架构建,结合了CART算法强大的分类能力,为图书管理领域提供了一个高效、智能的解决方案。通过系统的设计与实现,我们不仅深入理解了CART算法的原理和应用,还掌握了Django框架在Web开发中的使用技巧。
在系统设计阶段,我们首先明确了系统的功能需求,包括图书管理、模型评估、图书搜索、分类筛选和分页显示等功能。这些功能的设计旨在满足用户对图书分类和管理的多样化需求,提高用户体验。在实现阶段,我们采用了模块化、面向对象的设计思想,将系统划分为多个模块,每个模块负责特定的功能。这种设计方式不仅提高了系统的可维护性和可扩展性,还方便了后续的开发和升级。
在系统测试阶段,我们使用了多种测试方法对系统进行了全面的测试。测试结果表明,系统在大多数情况下能够准确地对图书进行分类,但在处理一些特殊类别或特征不明显的图书时,准确率有所下降。针对这一问题,我们提出了优化算法和结合其他机器学习算法的解决方案,以进一步提高系统的分类性能。
总的来说,基于CART算法的图书分类系统设计与实现项目取得了圆满成功。通过本项目,我们不仅实现了预期的功能需求,还提高了自己的编程能力和算法应用能力。在未来的工作中,我们将继续优化系统性能,探索更多机器学习算法在图书管理领域的应用,为用户提供更加智能、高效的图书分类和管理服务。
7.2 展望
在未来的发展中,基于CART算法的图书分类系统有望在多个方面进行改进和优化,以提高其性能和用户体验。首先,为了提高模型的准确率,我们可以采取以下措施:
1.增加更多已分类的图书样本:CART算法需要足够的训练样本才能有效学习分类规则。通过增加已分类的图书样本,我们可以提高模型的学习能力,从而提高分类准确率。
2.确保图书的特征标记正确:错误的特征标记会影响模型学习和预测的准确性。因此,我们需要对图书的特征进行仔细的检查和修正,确保特征标记的准确性。
3.平衡各分类的样本数量:确保每个分类都有足够的图书样本,以避免某些分类的样本数量过多或过少,导致模型在这些分类上的表现不佳。
在后续的优化方向上,我们可以考虑以下策略:
1.添加更多特征来提高分类准确率:除了现有的特征外,我们可以考虑增加出版年份、内容关键词等特征,以提供更多的信息供模型学习。
2.优化CART算法参数:调整树深度、叶节点最小样本数等参数,以找到最佳的模型配置,提高分类准确率。
3.考虑使用更复杂的算法:如随机森林或梯度提升树等集成学习方法,这些方法可以结合多个决策树的预测结果,提高分类的稳定性和准确率。
此外,我们还可以考虑将系统与其他图书管理系统或数据库进行集成,以实现更全面、更智能的图书管理功能。通过不断的技术创新和优化,基于CART算法的图书分类系统有望在未来的图书管理领域发挥更大的作用,为用户提供更加高效、准确的图书分类和管理服务。