 @bit::Shadow
✧(≖ ◡ ≖✿
目录
[*合并查询union all](#*合并查询union [all])
本文系统讲解多表查询核心概念,涵盖笛卡尔积、连表查询、子查询(单行、多行、多列)及ALL/ANY与MIN/MAX的等价关系,强调循序渐进的查询设计思路。通过实例演示部门与员工信息关联、工资比较、平均工资筛选等场景,并介绍UNION与UNION ALL合并结果集的用法,适用于SQL进阶学习者。
基本查询
1.查询工资高于 500 或岗位为 MANAGER 的雇员,同时还要满足他们的姓名首字母为大写的 J
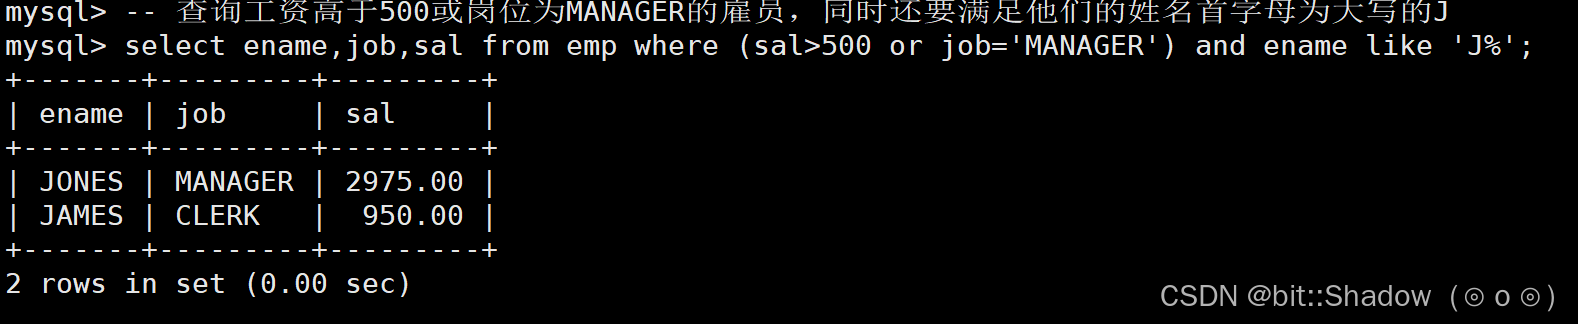
单位是"雇员",未分组 --- 使用where限定
2.按照部门号升序而雇员的工资降序排序
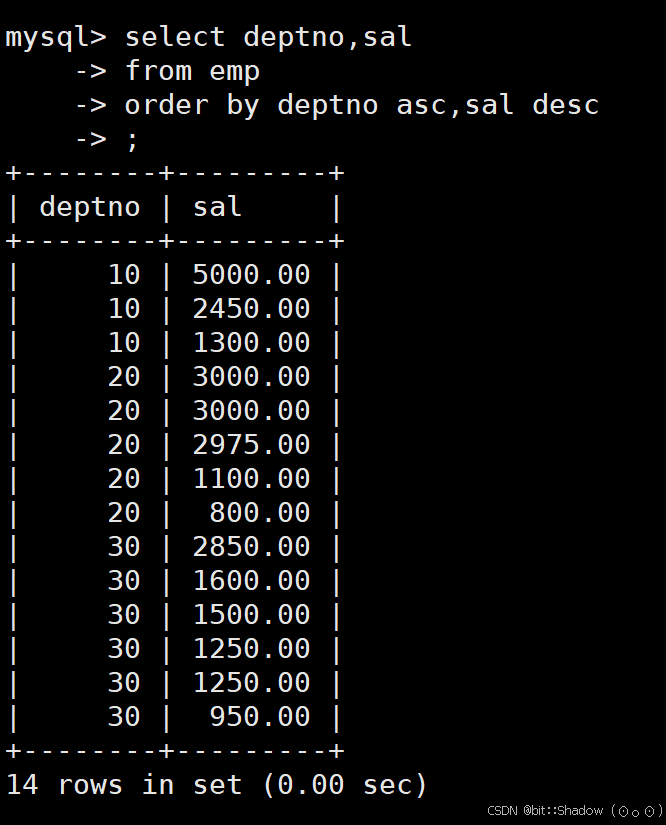
单位是雇员
拥有排序要求(注意:多排序限定条件使用" , "隔开而不是or and什么的)
3.使用年薪进行降序排序
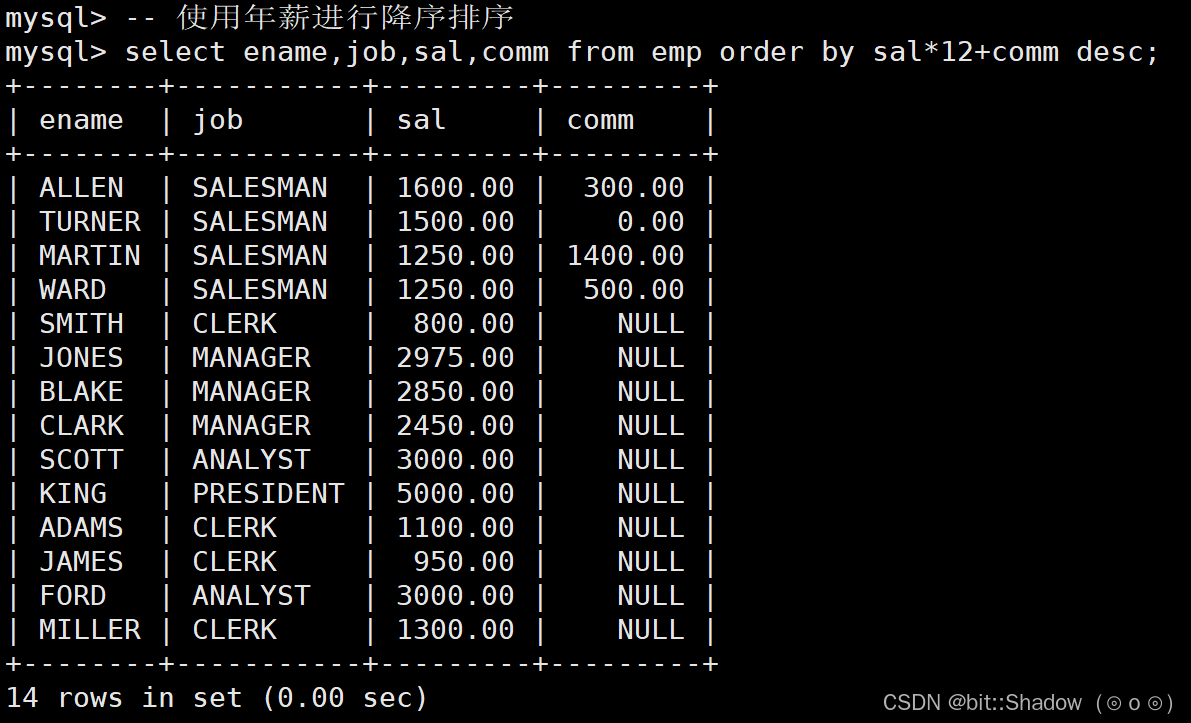
单位是雇员
降序要求
"年薪"的构成分析:月薪*12+奖金(comm)
3.显示工资最高的员工的名字和工作岗位
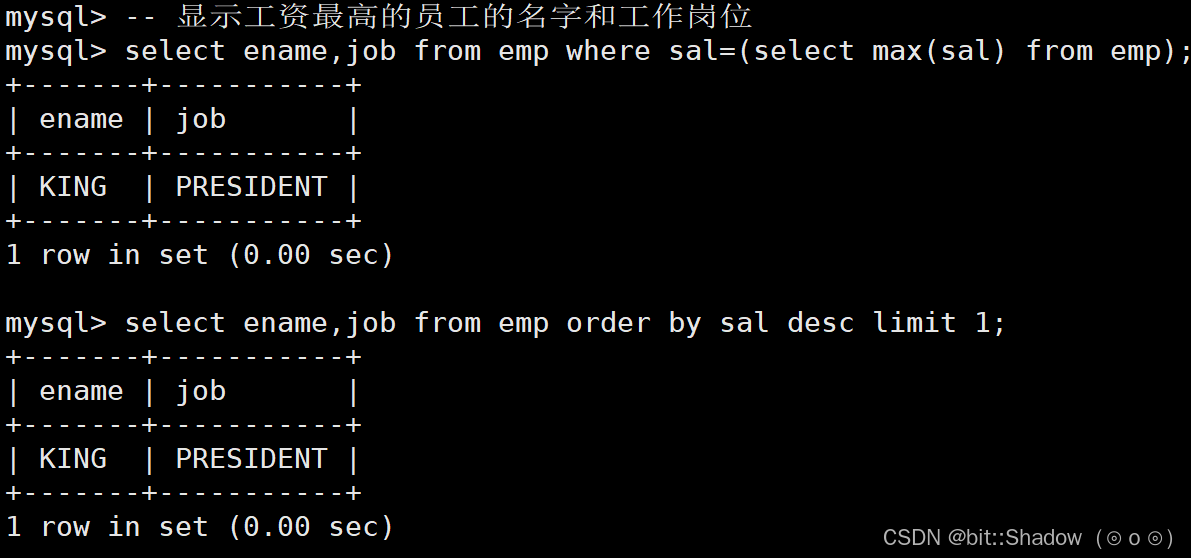
两种解法
1."工资最高"本身可以作为一个查询的返回结果(表)。
2.order排序+limit限定
4.显示工资高于平均工资的员工信息
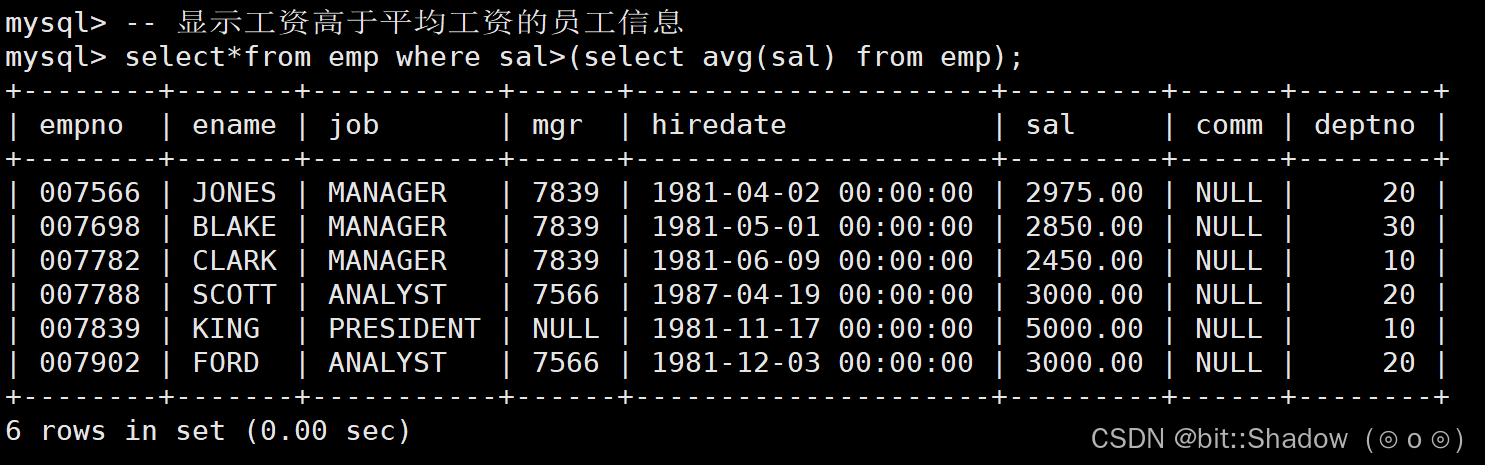
"平均工资"本身就可以作为一个查询的返回结果(表)。
5.显示每个部门的平均工资与最高工资
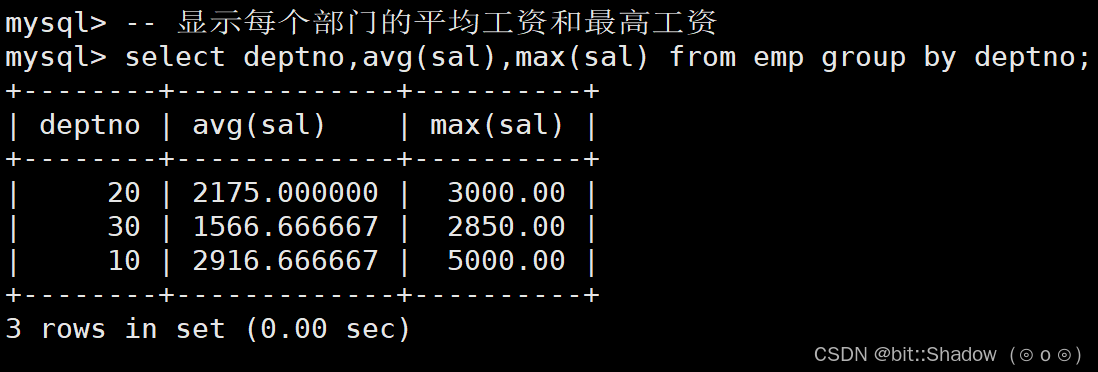
"部门"作为单位。
6.显示平均工资低于 2000 的部门号和它的平均工资
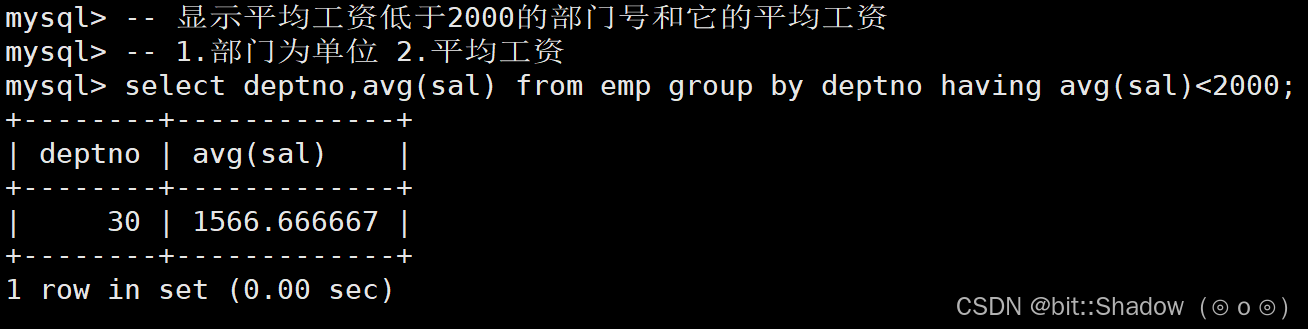
"部门"是单位。
限定的"平均工资"同样是部门。(having)
7.显示每种岗位的雇员总数,平均工资
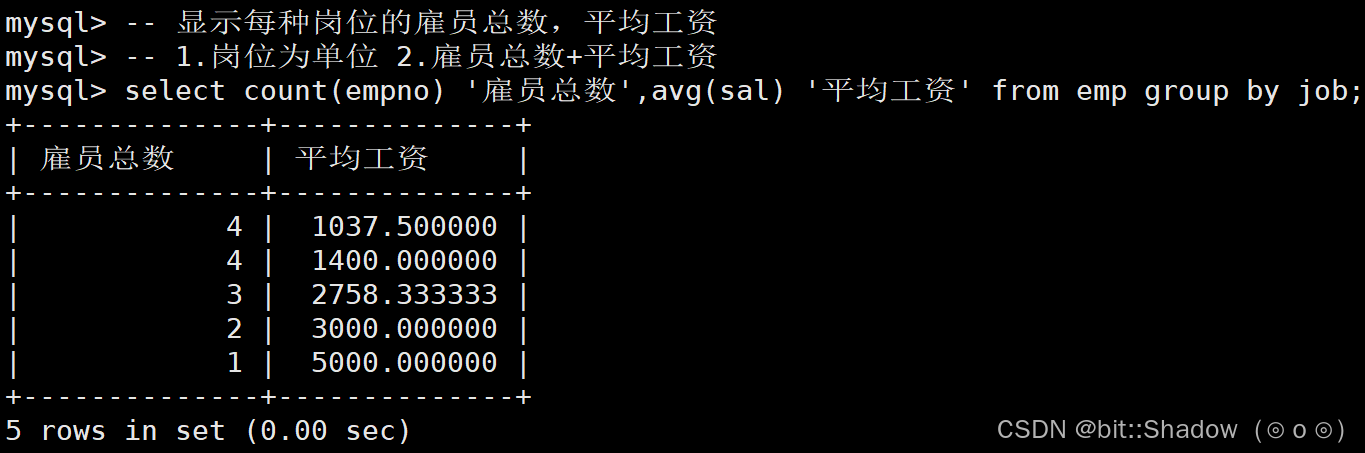
"聚合"作为分类依据的下一单位。(像:平均工资统计的是同一类job下每个人)
总结
基本查询下没有使用到多表连接的情况(from后仅一张表)
顺序
from --
单位是什么(单人/岗位/)+ 需求单位(最高、平均、最低、大于、等于)--
where/group/order/ --
select 输出要求
知识点基础
1.执行顺序牢记(重点在select与having的执行优先级---聚合函数的执行)
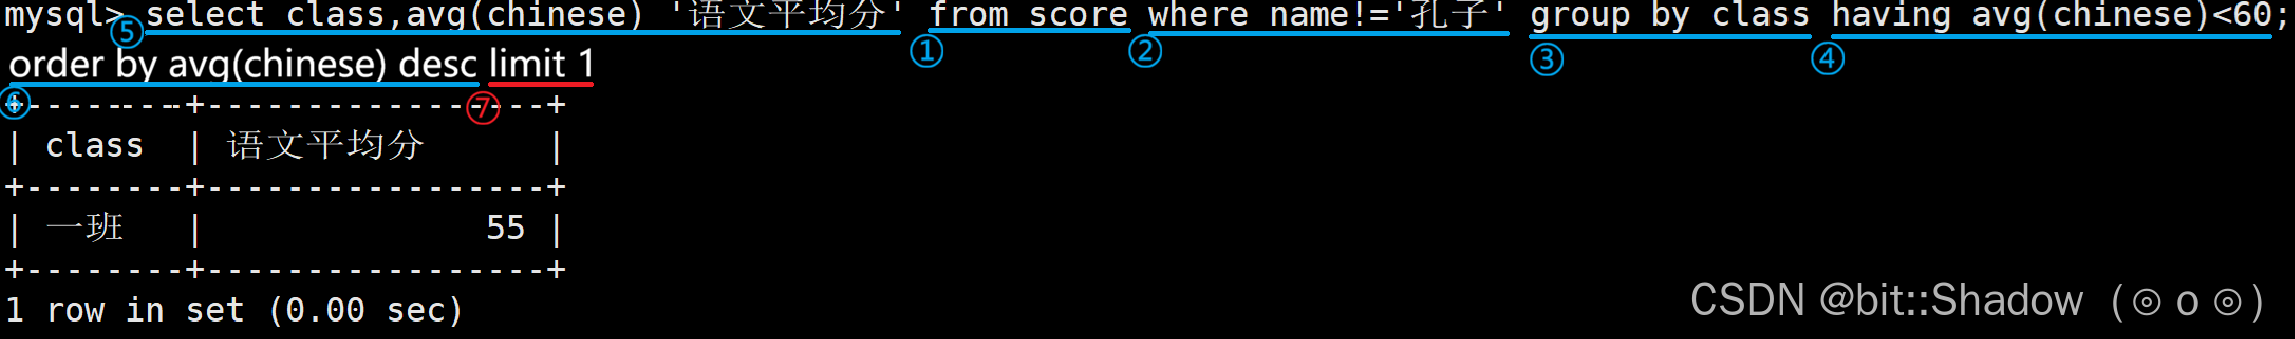
2.MySQL内置函数(较次要)
①用法基础
②特色函数 instr like substr abs isnull format replace
多表查询
知识点基础:
1.from t1, t2 -- 笛卡尔积 复合表查询基础
- t1.col_1 -- 对于多表复合后列名字冲突使用的' . '访问形式
3.子查询------面对复杂需求我们应分解需求先提取中心像:
4.多行子查询中------in all any 与where的配合使用
*5.怎么看待any/all对于min/max替代方案。
多表查询
笛卡尔积
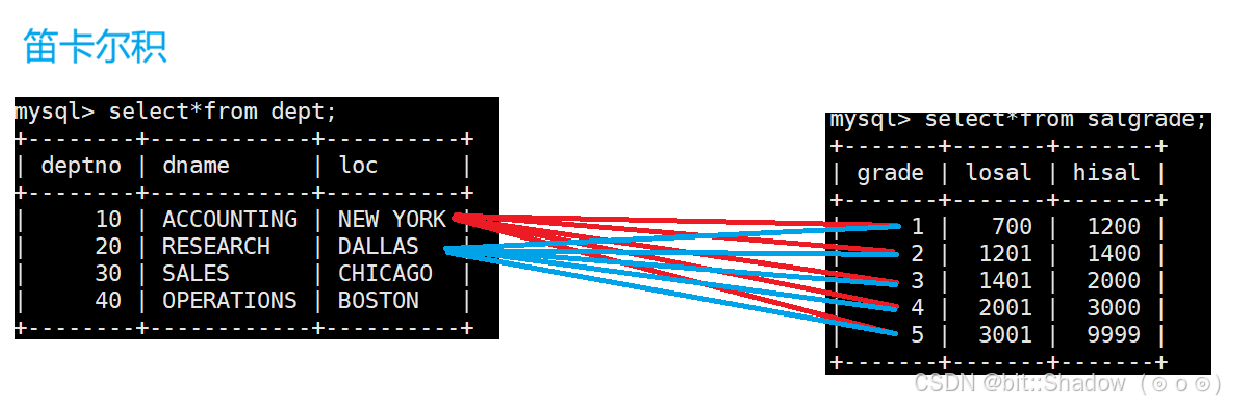
两/多表共同查询的基础是通过"笛卡尔积"形成的一个复合表。
笛卡尔积的本质是两张表的排列组合。
笛卡尔积图示
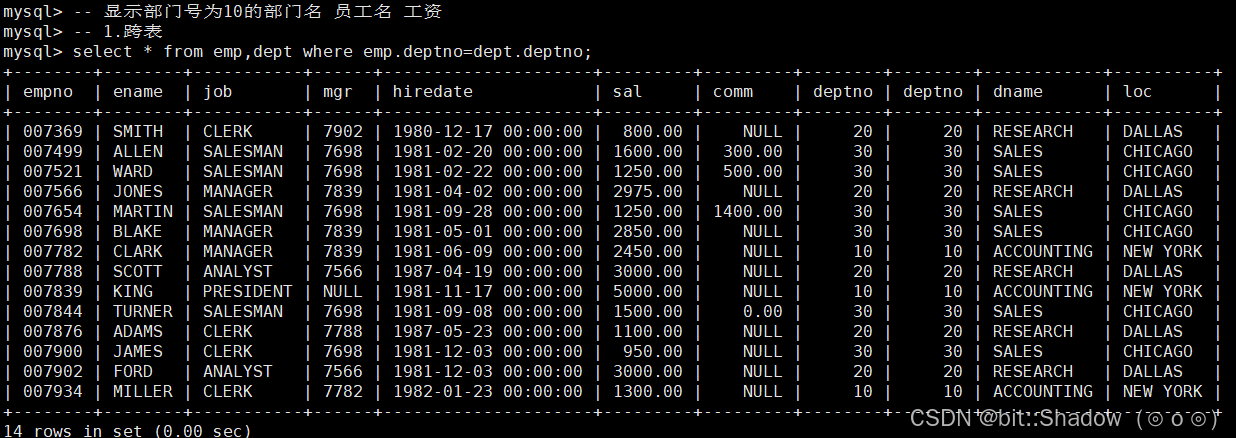
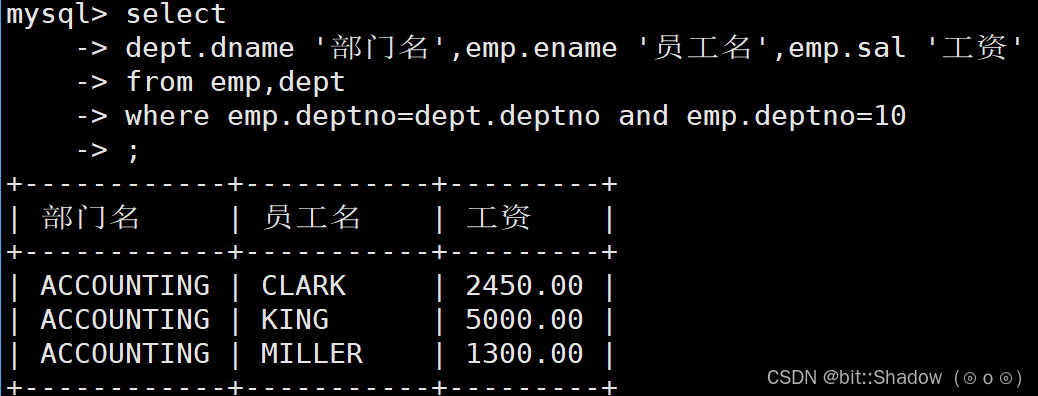
显示部门号为10的部门名,员工名和工资
有效的笛卡尔积
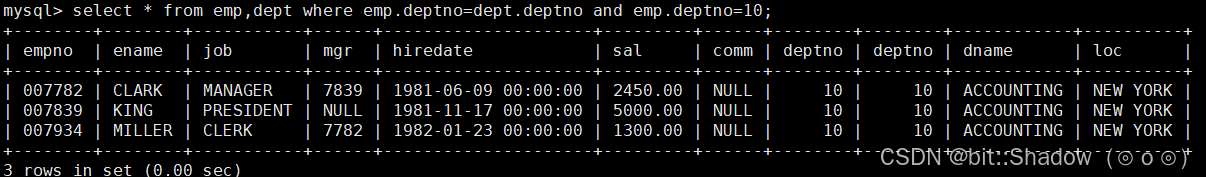
仅10号部门号
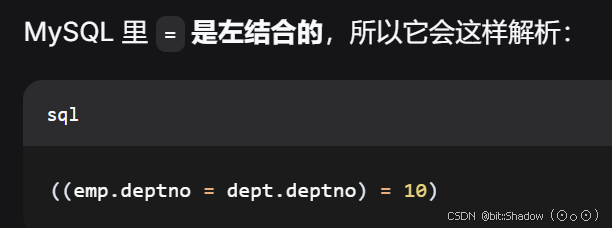
注意:不能连用'='。
sql
select * from emp,dept where emp.deptno=dept.deptno=10;因为MySQL内=是左结合的
最终版
注意:'dept.'的前缀是否加取决于多表复合后是否存在列名字重复
sql
mysql> select
    -> dept.dname '部门名',emp.ename '员工名',emp.sal '工资'
    -> from emp,dept
    -> where emp.deptno=dept.deptno and emp.deptno=10
    -> ;
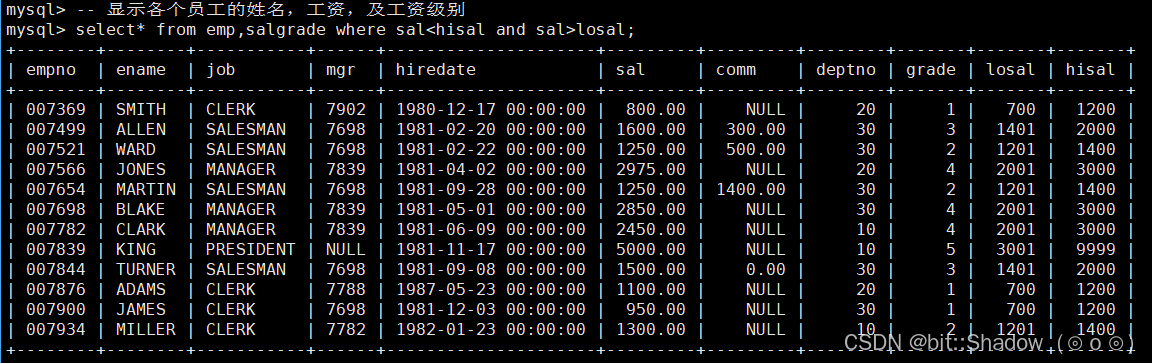
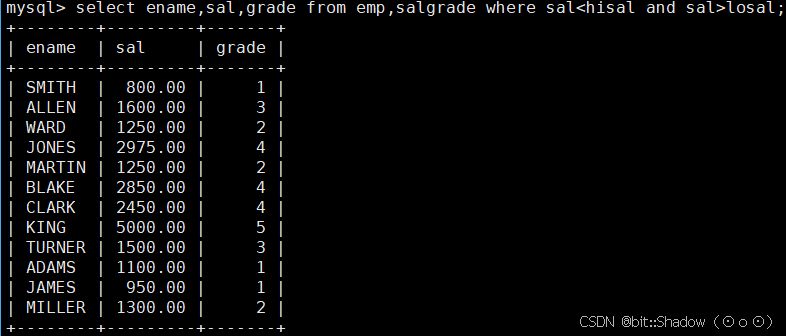
显示各个员工的姓名、工资及工资级别
1.复合员工表与工资表
2.定向查询
总结
多表查询即复合多个表(from t1,t2)以单表的"基本查询"为基础进行查询。
由于需求较为复杂常常采用循序渐进的方法分解主需求后逐渐逼近主需求确保每步查询都是符合预期的
子查询
子查询是指嵌套在一条sql语句中的多个select构成的查询模式。
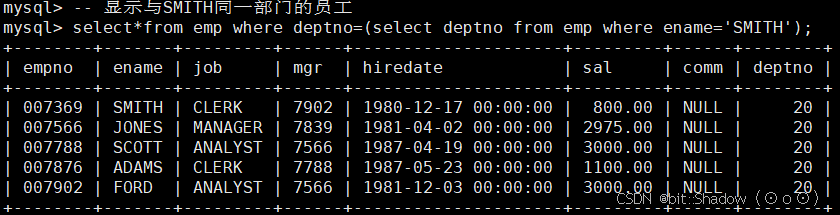
单行子查询
指一个查询内拥有子查询,此子查询返还单行、单列充当查询的依据。
显示 ++与SMITH同一部门++ 的 ++员工++
多行子查询
指一个查询内拥有子查询,此子查询返还单列、多行结果充当查询的依据。
in的使用
针对于"单列、多行"的返回结果
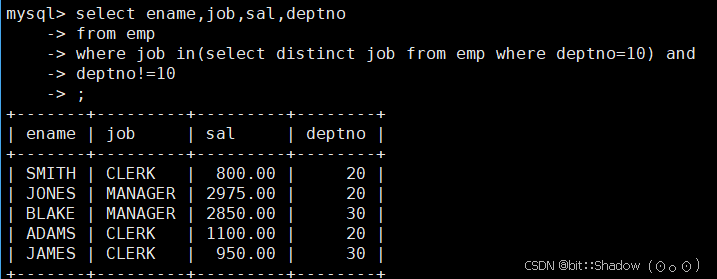
in关键字;查询和++10号部门的工作岗位相同++的雇员的名字,岗位,工资,部门号,但是不包含10部门自己的人 (假设10号部门的所有岗位都有人)
十号部门的所有岗位类型
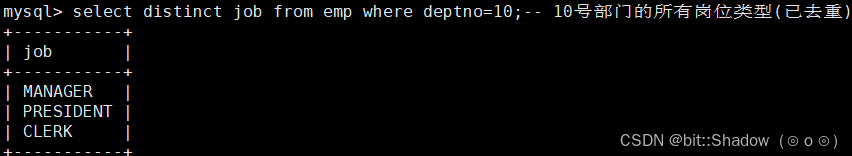
使用where job in (select . . .) -- 多行子查询限定
all的使用
针对的"单列、多行"的子查询结果(表)
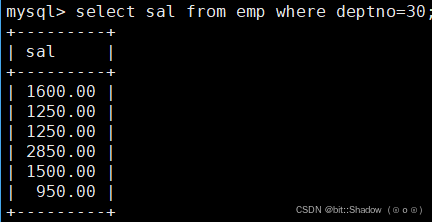
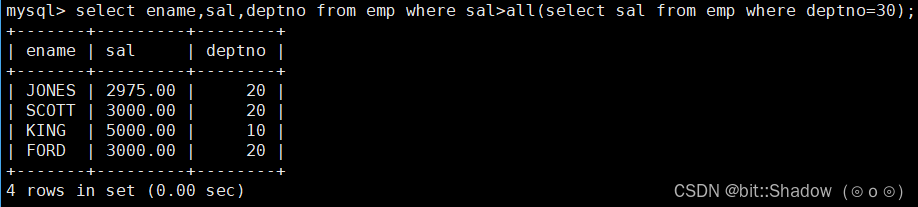
-- all关键字;显示工资比++部门30的所有员工的工资++高的员工的姓名、工资和部门号 (需求其实就是最高) 。
部门30的所有员工的工资
使用where sal>all(select . . .)限定"比所有. . .高"的需求
any的使用
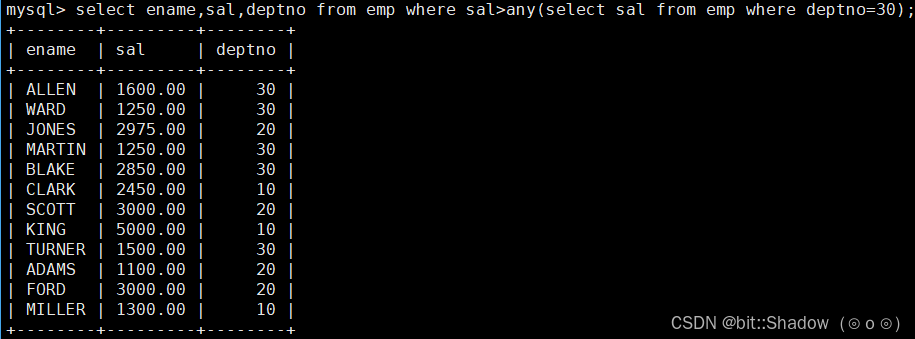
-- any 关键字;显示工资比++部门号30的任意员工的工资++高的员工的姓名、工资和部门号(包含自己部门的员工) 相当于数学中的'∃'
-- 即比最低的高即可
部门号30的人的工资(去重)
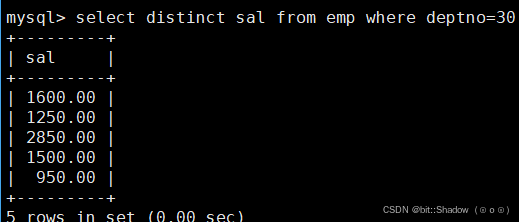
使用where sal>any(select . . .)限定"比任意. . .工资高"的需求
问题
单列多行子查询中all的使用是否完全可以被min max替代?
all
| 原写法 | 等价写法 | 含义 |
|---|---|---|
> ALL (子查询) |
> (SELECT MAX(...) FROM ...) |
大于所有值 = 大于最大值 |
>= ALL (子查询) |
>= (SELECT MAX(...) ...) |
大于等于所有值 = 大于等于最大值 |
< ALL (子查询) |
< (SELECT MIN(...) ...) |
小于所有值 = 小于最小值 |
<= ALL (子查询) |
<= (SELECT MIN(...) ...) |
小于等于所有值 = 小于等于最小值 |
= ALL (子查询) |
子查询结果全相等且等于该值 | 不能简单用 MIN/MAX 替代 |
<> ALL (子查询) |
等价于 NOT IN |
不能用 MIN/MAX 替代 |
如:
> ALL 用 MAX
sql
-- 原写法
select ename, sal
from emp
where sal > all (select sal from emp where deptno = 30);

-- 等价写法
select ename, sal
from emp
where sal > (select max(sal) from emp where deptno = 30);
any
| 写法 | 等价含义 | 可用聚合替代 |
|---|---|---|
> ANY (...) |
大于最小值 | > (SELECT MIN(...)) |
>= ANY (...) |
大于等于最小值 | >= (SELECT MIN(...)) |
< ANY (...) |
小于最大值 | < (SELECT MAX(...)) |
<= ANY (...) |
小于等于最大值 | <= (SELECT MAX(...)) |
= ANY (...) |
等于任意一个 | 等价于 IN |
<> ANY (...) |
不等于任意一个 | 通常恒为真,少用 |
注意:虽然大部分都可以替代,但是在实际中我们要谨慎的选择使用 all/any 与 min/max 。(不能无脑)
多列子查询
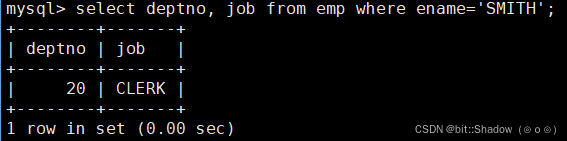
- 查询和SMITH 的部门和岗位完全相同的所有雇员,不含SMITH本人。
SMITH的部门与岗位
使用(deptno,job)=(select deptno,job from . . .)限定部门与岗位一致性并且使用'and'限定ename
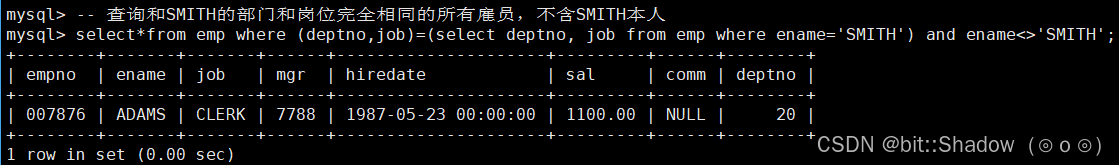
注意:where下以括号进行的整体比较,括号内元素顺序一定要一致。
sql
mysql> select*from emp
    where (job,deptno)=(select deptno, job -- 此处括号内顺序不一致 错误!!
    from emp where ename='SMITH') and
    ename<>'SMITH'
    ;
Empty set, 14 warnings (0.00 sec)
总结:"多列子查询"具有鲜明的特征 --- 几乎直接指定了判断依据,减少了需求分解。
在from子句中使用子查询
- 显示每个高于自己部门平均工资的员工的姓名、部门、工资、平均工资
①各部门平均工资
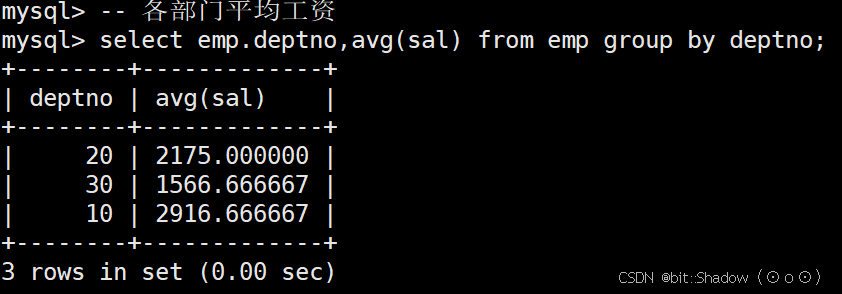
②自己部门

③单位是个人
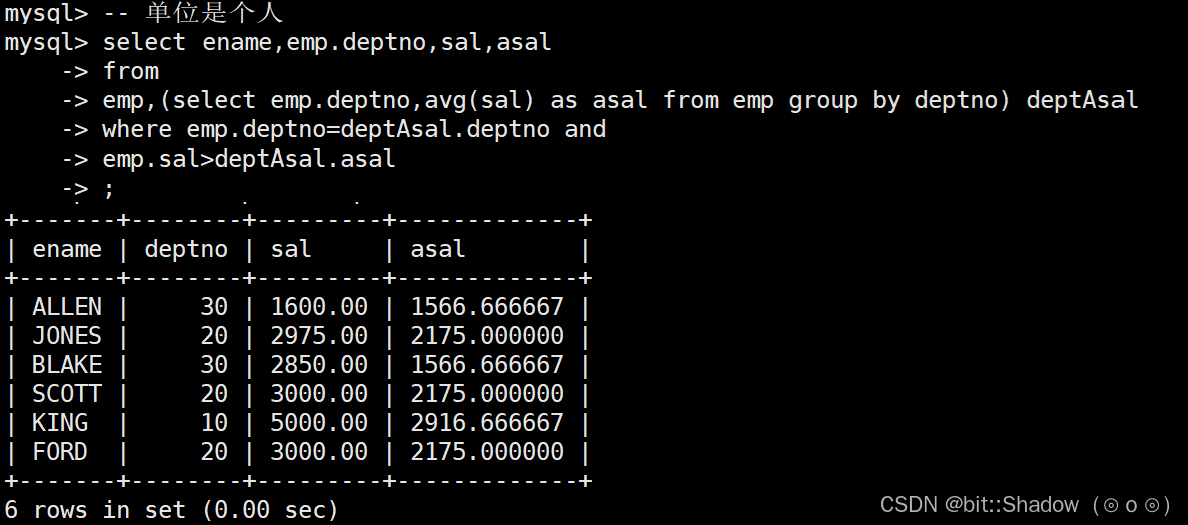
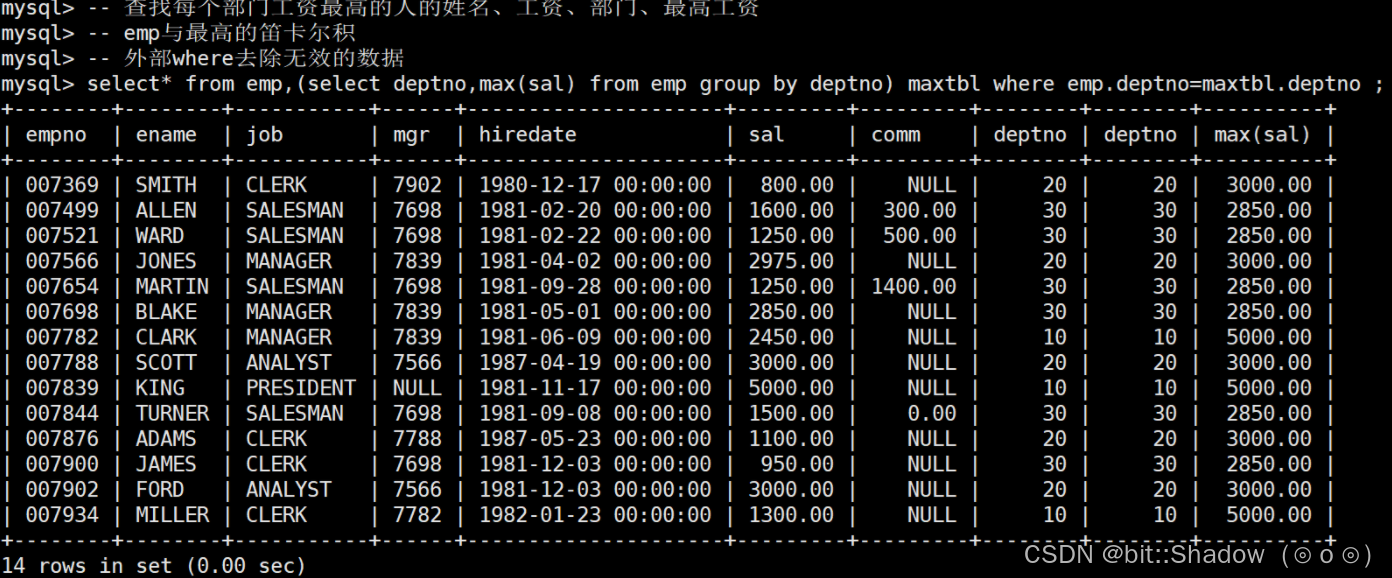
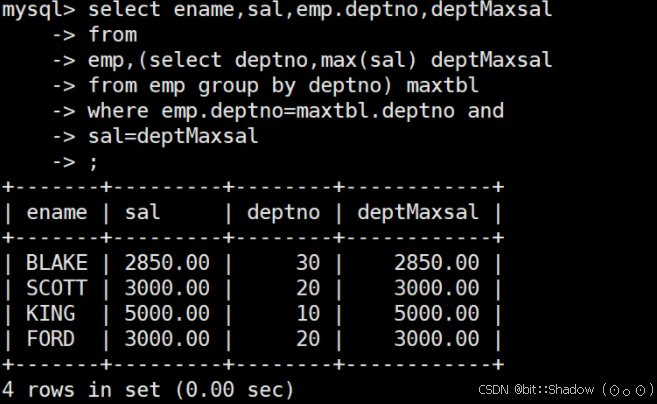
- 查找每个部门工资最高的人的姓名、工资、部门、最高工资
emp与部门最高工资笛卡尔积
注意:要去除无效数据
工资最高的
- 显示每个部门的信息(部门名,编号,地址)和人员数量
笛卡尔积

每个部门的人员数
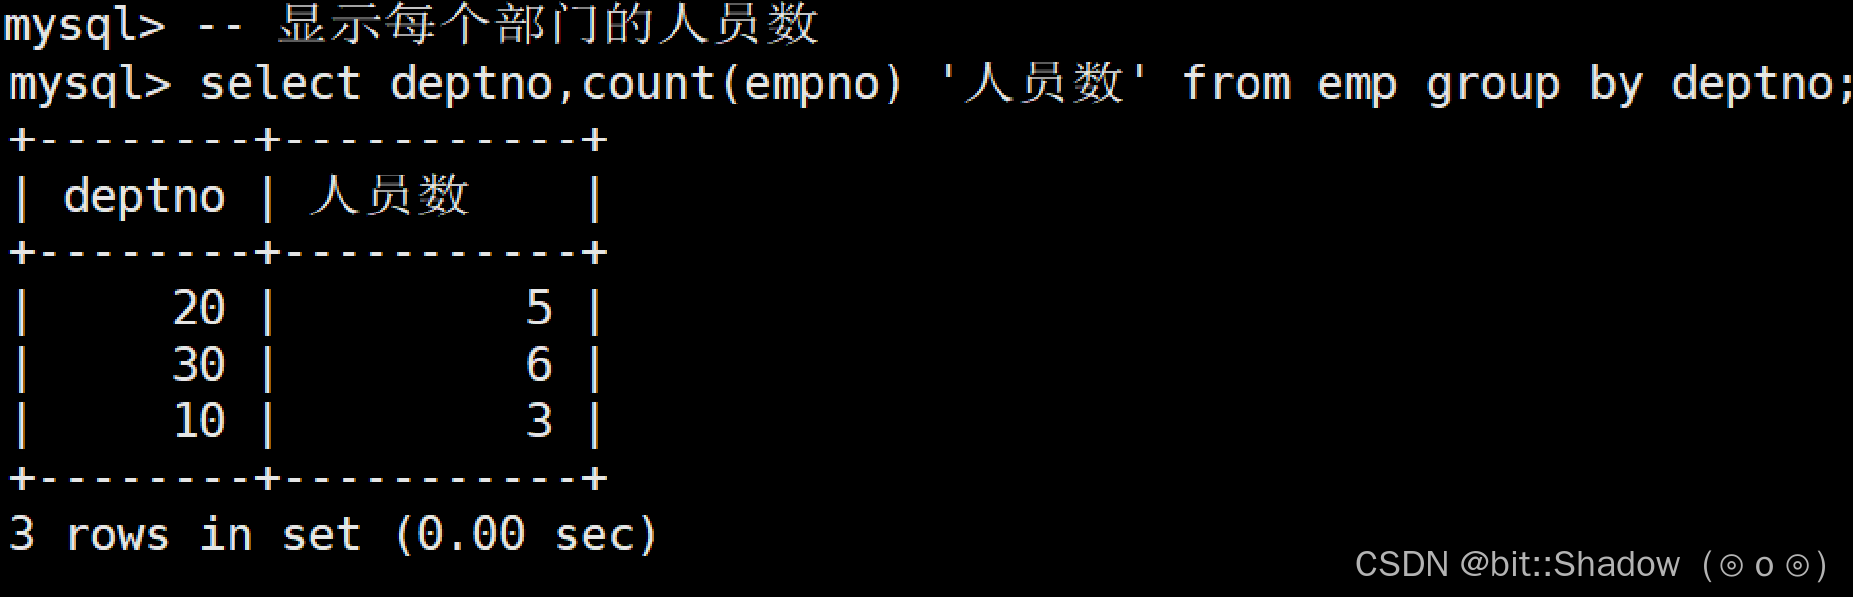
使用where限定(注意:重命名为中文的'人员数'在进行成员访问时不能加引号' ')
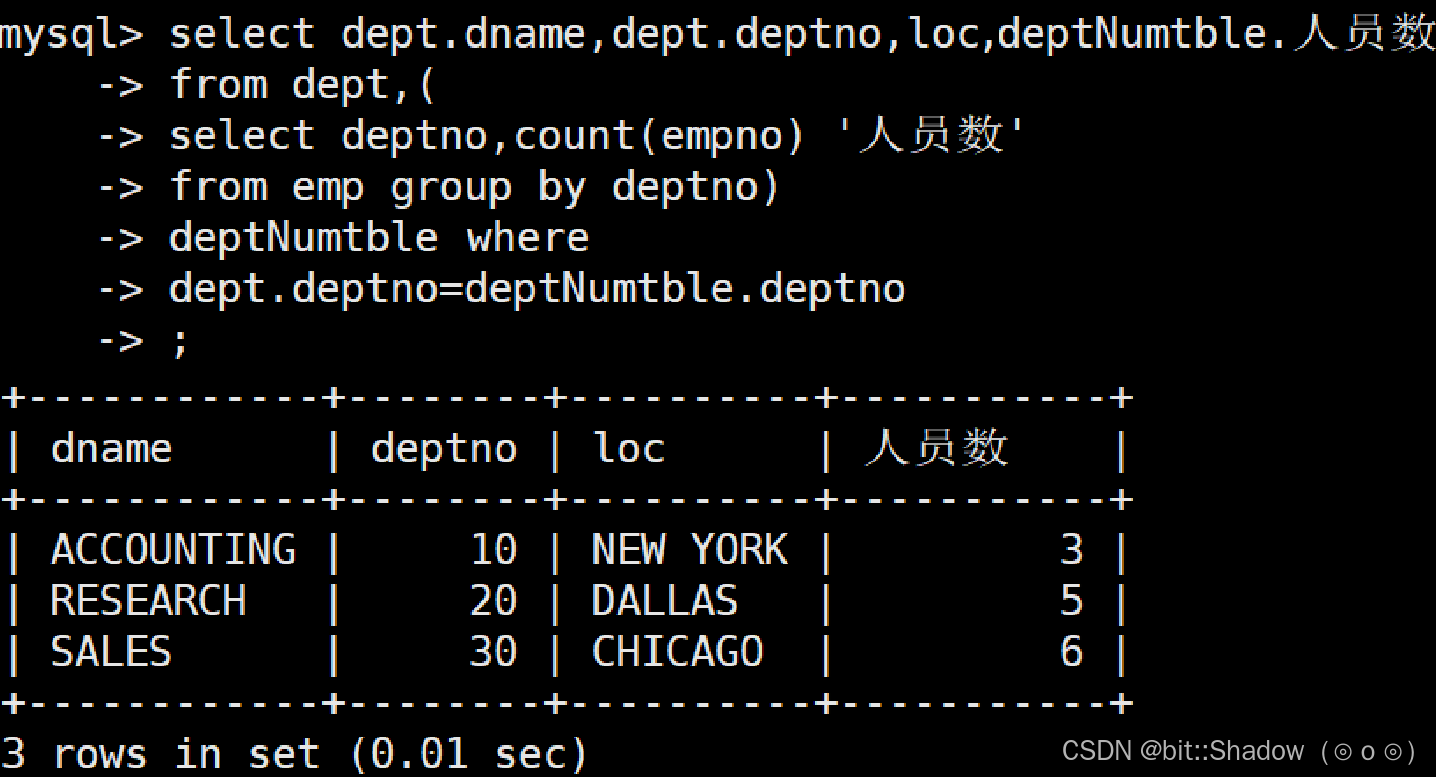
注意:
1.适时重命名解决where内无法聚合的限制
2.分析题意(主要)
此题中"自己部门平均工资" --- 涉及两个单位"部门"与"个人"并且筛选依据是自己工资与部门平均工资比较--->笛卡尔积
3.from后的(多)表必须拥有自己的"别名"
4.笛卡尔积后常常使用where限定去除无效数据(像:emp的部门号与dept的部门号要相等)
*合并查询union all
union 该操作符用于取得两个结果集的并集。当使用该操作符时,会自动去掉结果集中的重复行
-- 将工资大于2500或职位是MANAGER的人找出来
sql
mysql> select ename, sal, job from EMP where sal>2500 union
-> select ename, sal, job from EMP where job='MANAGER';--去掉了重复记录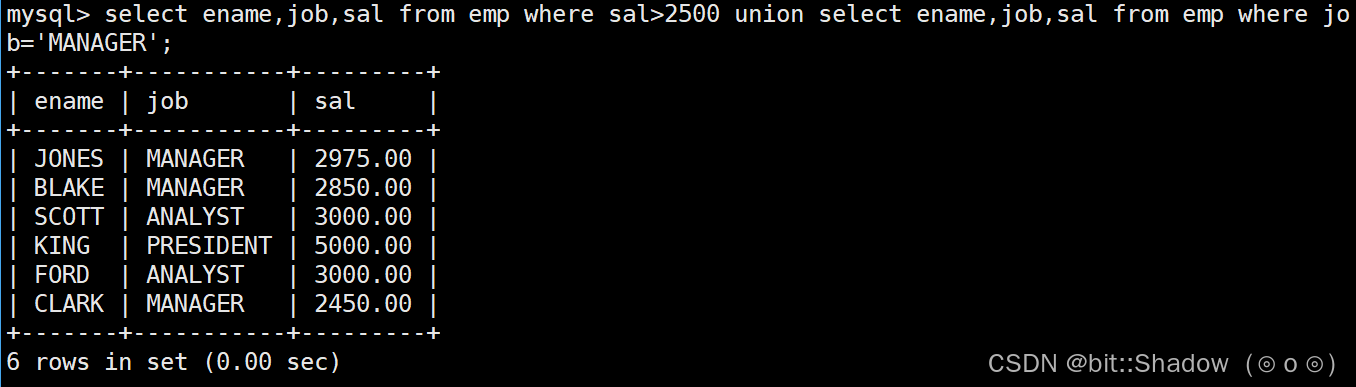
union all
-- 该操作符用于取得两个结果集的并集。当使用该操作符时,不会去掉结果集中的重复行。
感谢支持,长期连载
欢迎关注