本文代码已同步Github
一、序列式容器与关联式容器
前面我们已经接触过 STL 中的不少容器,比如 string、vector、list、deque、array、forward_list 等。
这些容器有一个共同点:逻辑结构是线性的序列 ,元素按存储位置顺序保存和访问,相邻两个位置之间一般没有紧密的联系------比如把 vector 里的两个元素交换一下位置,它依旧是个合法的 vector,结构没被破坏。这类容器统称为序列式容器。
map/set 则不同,它们属于关联式容器:
关联式容器的逻辑结构通常是非线性的,元素之间按「关键字」来保存和访问,位置之间存在紧密的关联关系------交换一下,存储结构就被破坏了。
关联式容器有 map/set 系列,还有 unordered_map/unordered_set 系列,本篇讲的是 map/set 系列。
它们的底层是一棵红黑树,而红黑树是一棵平衡二叉搜索树:
- set 是 key 搜索场景的结构:只存一个关键字,判断它在不在
- map 是 key/value 搜索场景的结构:每个 key 对应一个 value
因为上一篇刚学过二叉搜索树,这里先把红黑树理解成「保证平衡的二叉搜索树」即可------增删查改效率稳定在 O(logN) ,迭代器遍历走中序,所以元素始终按 key 有序。哈希表实现的 unordered 系列(无序、追求 O(1))下一篇再展开。
二、set的使用
1、set的介绍
set 的声明如下:
cpp
template < class T,                 // set::key_type / value_type
           class Compare = less<T>, // set::key_compare
           class Alloc = allocator<T> > // set::allocator_type
class set;
几个要点:
- T 就是 set 底层关键字的类型,它同时既是 key_type 又是 value_type(set 里 key 和 value 是同一个东西)
- Compare 默认是
less<T>,也就是按<升序;默认要求 T 支持小于比较,如果想按自己的需求排序,就自己实现一个仿函数传给第二个模板参数 - Alloc 是空间配置器,一般不用管
一般情况下,我们都不需要传后两个模板参数。
set 的核心特性:
- 底层红黑树,增删查效率 O(logN)
- 迭代器遍历走中序,所以有序(默认升序)
- 去重:不允许重复元素
- 不支持修改:迭代器指向的是 const 元素,改了会破坏底层搜索树的结构
2、set的构造与迭代器
set 支持无参构造、迭代器区间构造、拷贝构造、initializer_list 构造。
迭代器是双向迭代器,支持正向、反向遍历,默认按升序(走中序);支持迭代器就意味着支持范围 for。
来用一段代码实际看看「去重 + 排序」:
cpp
#include <iostream>
#include <set>
#include <string>
using namespace std;

int main()
{
	// 去重 + 升序
	set<int> s = { 9, 3, 5, 3, 9, 1, 7 };
	for (auto e : s) cout << e << " ";
	cout << endl;

	// 去重 + 降序(传 greater)
	set<int, greater<int>> sd = { 9, 3, 5, 3, 9, 1, 7 };
	for (auto e : sd) cout << e << " ";
	cout << endl;

	// string 按字典序
	set<string> ss = { "pear", "apple", "peach", "banana" };
	for (auto& e : ss) cout << e << " ";
	cout << endl;

	return 0;
}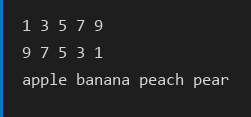
观察输出:
9 3 5 3 9 1 7去重后变成1 3 5 7 9,去重 + 升序- 换成
greater<int>就变成9 7 5 3 1,降序 - string 按 ASCII 码(字典序)排:
apple banana peach pear
注意⚠️:set 的 iterator 和 const_iterator 都不支持修改元素 。如果写 *it = 1;,编译器会报错------因为改了关键字,底层搜索树的结构就被破坏了。
3、set的增删查
set 的增删查接口,我们关注这几个:
| 接口 | 说明 |
|---|---|
insert(val) |
插入,返回 pair<iterator, bool>,已存在则插入失败(second == false) |
find(val) |
查找,返回迭代器,找不到返回 end() |
count(val) |
返回 val 的个数(set 里只有 0 或 1) |
erase(pos) |
删除迭代器位置 |
erase(val) |
删除值,不存在返回 0,存在返回 1 |
lower_bound(val) |
返回 >= val 的位置 |
upper_bound(val) |
返回 > val 的位置 |
来用一段代码实际看看:
cpp
#include <iostream>
#include <set>
using namespace std;

int main()
{
	set<int> s = { 7, 1, 9, 3, 5 };
	for (auto e : s) cout << e << " ";
	cout << endl;

	// erase(迭代器):删最小值
	s.erase(s.begin());
	for (auto e : s) cout << e << " ";
	cout << endl;

	// erase(值):删 5,不存在返回 0,存在返回 1
	size_t n = s.erase(5);
	cout << "删掉 " << n << " 个" << endl;
	for (auto e : s) cout << e << " ";
	cout << endl;

	// find:找到返回迭代器,找不到返回 end()
	auto pos = s.find(9);
	if (pos != s.end()) cout << "找到 " << *pos << endl;
	else cout << "不存在" << endl;

	// count:存在返回 1,不存在返回 0
	cout << "count(3) = " << s.count(3) << endl;
	cout << "count(8) = " << s.count(8) << endl;

	return 0;
}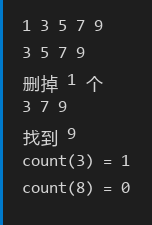
这里有两个容易忽略的点:
- 算法库的
find和 set 自己的find不是一回事 :std::find(s.begin(), s.end(), x)是线性遍历,O(N);而s.find(x)走的是红黑树,O(logN)。数据量大时差别很大。 count可以间接实现「快速判断在不在」:返回 0 就是不在,返回 1 就是在。
再来看 lower_bound / upper_bound 的配合使用------它们可以很方便地定位一段区间:
cpp
#include <iostream>
#include <set>
using namespace std;

int main()
{
	set<int> s;
	for (int i = 1; i < 10; i++) s.insert(i * 10); // 10 20 ... 90

	for (auto e : s) cout << e << " ";
	cout << endl;

	// 删除 [30, 60] 这段区间的值
	auto itlow = s.lower_bound(30); // 返回 >= 30 的位置
	auto itup = s.upper_bound(60);  // 返回 > 60 的位置
	s.erase(itlow, itup);

	for (auto e : s) cout << e << " ";
	cout << endl;

	return 0;
}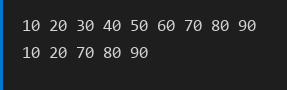
[itlow, itup) 正好覆盖了 [30, 60] 这段区间,erase 一次性删掉 30、40、50、60。
4、multiset与set的差异
multiset 和 set 的用法基本一样,唯一的区别是 multiset 支持值冗余(排序但不去重)。
因此它的几个接口语义跟着变了:
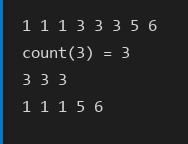
insert总能成功find有多个相同值时,返回中序的第一个count返回实际个数(不是 0/1)erase(值)会删除所有等于该值的元素
来用一段代码实际看看:
cpp
#include <iostream>
#include <set>
using namespace std;

int main()
{
	// multiset:排序但不去重
	multiset<int> ms = { 3, 1, 6, 1, 3, 1, 5, 3 };
	for (auto e : ms) cout << e << " ";
	cout << endl;

	// count 返回实际个数
	cout << "count(3) = " << ms.count(3) << endl;

	// find 返回中序第一个 3,往后循环打出所有 3
	auto pos = ms.find(3);
	while (pos != ms.end() && *pos == 3)
	{
		cout << *pos << " ";
		++pos;
	}
	cout << endl;

	// erase(值):删除所有 3
	ms.erase(3);
	for (auto e : ms) cout << e << " ";
	cout << endl;

	return 0;
}
三、map的使用
1、map的介绍与pair
map 的声明如下:
cpp
template < class Key,                          // map::key_type
           class T,                            // map::mapped_type
           class Compare = less<Key>,          // map::key_compare
           class Alloc = allocator<pair<const Key, T> > > // map::allocator_type
class map;
和 set 相比,map 多了一个模板参数 T,它是 value 的类型:
- Key 是关键字类型
- T 是映射值类型(文档里叫 mapped_type)
- 底层红黑树节点里存的是
pair<const Key, T>键值对
注意区分两个「value」:日常我们说 map 的 value 指的是 T;但文档里的
value_type指的是红黑树节点存的pair<const Key, T>键值对整体。
pair 很简单,就是两个成员 first 和 second:
cpp
template <class T1, class T2>
struct pair
{
	T1 first;
	T2 second;
	pair() : first(T1()), second(T2()) {}
	pair(const T1& a, const T2& b) : first(a), second(b) {}
};
日常构造 pair 最常用的是 make_pair(x, y),或者直接用 { x, y }。
2、map的构造与遍历
map 的构造和 set 类似:无参、迭代器区间、拷贝、initializer_list。
迭代器是双向的,遍历默认按 key 的升序 (走中序)。注意:map 支持修改 value,不支持修改 key------改 key 会破坏底层搜索树的结构。
来看一段构造和遍历:
cpp
#include <iostream>
#include <map>
#include <string>
using namespace std;

int main()
{
	// initializer_list 构造 + 遍历(按 key 字典序)
	map<string, string> dict = { {"apple", "苹果"}, {"book", "书"}, {"cat", "猫"}, {"dog", "狗"} };
	for (const auto& kv : dict) cout << kv.first << ":" << kv.second << " ";
	cout << endl;

	return 0;
}
遍历时 kv.first 是 key,kv.second 是 value;输出按 key 的字典序 apple book cat dog 排列,完全有序。
3、map的增删查
map 的插入是插入一个 pair<key, T> 键值对;查和删的接口只跟 key 有关,和 set 完全类似。
先看 insert 的四种写法:
cpp
// 方式1:先构造 pair 再插入
pair<string, string> kv1("egg", "鸡蛋");
dict.insert(kv1);

// 方式2:匿名 pair 对象
dict.insert(pair<string, string>("fish", "鱼"));

// 方式3:make_pair
dict.insert(make_pair("grape", "葡萄"));

// 方式4:initializer_list 的 { }(最常用)
dict.insert({ "hot", "热" });四种方式等价,对比之下最后一种最方便。
insert 的返回值是 pair<iterator, bool>:
- 插入成功:first 指向新插入的节点,second == true
- 插入失败(key 已存在):first 指向已存在的那个节点,second == false
也就是说,无论成功失败,返回的 first 都指向 key 所在的节点 。这一点很关键,下一节讲 operator[] 时会用到。
来把构造、insert、遍历串起来看一次:
cpp
#include <iostream>
#include <map>
#include <string>
using namespace std;

int main()
{
	map<string, string> dict = { {"apple", "苹果"}, {"book", "书"}, {"cat", "猫"}, {"dog", "狗"} };
	for (const auto& kv : dict) cout << kv.first << ":" << kv.second << " ";
	cout << endl;

	// insert 四种方式
	pair<string, string> kv1("egg", "鸡蛋");
	dict.insert(kv1);
	dict.insert(pair<string, string>("fish", "鱼"));
	dict.insert(make_pair("grape", "葡萄"));
	dict.insert({ "hot", "热" });

	// key 已存在,插入失败
	auto ret = dict.insert({ "apple", "苹果(重复)" });
	if (ret.second == false)
		cout << "apple 已存在,插入失败,原值是 " << ret.first->second << endl;

	for (const auto& kv : dict) cout << kv.first << ":" << kv.second << " ";
	cout << endl;

	return 0;
}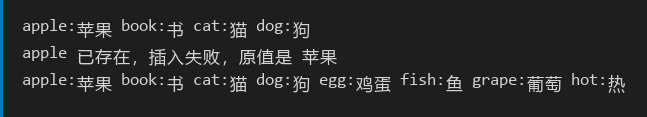
观察输出:
- 初始 4 个词按 key 字典序输出
apple book cat dog - 插入
egg fish grape hot后,整体依旧有序:apple book cat dog egg fish grape hot apple已存在,第二次插入失败,原值「苹果」没被覆盖
4、map的operator\[\]
map 里最重要的复合接口是 operator[],它同时具备插入、查找、修改三种能力:
cpp
mapped_type& operator[] (const key_type& k)
{
	// insert 返回 pair<iterator, bool>
	// 无论 k 在不在,first 都指向 k 所在的节点
	pair<iterator, bool> ret = insert({ k, mapped_type() });
	return ret.first->second;
}
它内部就是调 insert,利用「insert 失败时 first 也指向 key 所在节点」这一点,一个接口干了三件事:
- key 不存在:insert 插入
(k, 默认值),返回 value 的引用 → 可以借此插入 + 修改 - key 存在:insert 失败,但 first 指向 key 所在节点,返回 value 的引用 → 查找 + 修改
来看它的三种行为:
cpp
map<string, string> dict;
dict["left"] = "左边";       // key 不存在 -> 插入 + 赋值
dict["right"] = "右边";
dict["left"] = "左边、剩余";  // key 存在 -> 修改

cout << dict["left"] << endl; // key 存在 -> 查找
接着看一个经典用法------词频统计。同样的事,用 find 和用 [] 都能做,但写法差很多:
cpp
// 方式1:find + 迭代器
map<string, int> count1;
string words[] = { "hello", "world", "hello", "cpp", "world", "hello" };
for (auto& w : words)
{
	auto it = count1.find(w);
	if (it == count1.end()) count1.insert({ w, 1 });
	else it->second++;
}

// 方式2:operator[] 一步到位
map<string, int> count2;
for (auto& w : words) count2[w]++;
count2[w]++ 这一行:第一次遇到 w,[] 插入 (w, 0) 并返回 0 的引用,++ 变成 1;再遇到就返回已有次数的引用直接 ++。一步完成插入 + 计数。
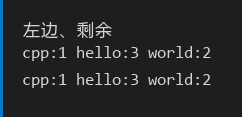
两种方式输出一样,但 [] 简洁得多。
5、multimap与map的差异
multimap 和 map 的差异跟 multiset/set 完全一样------支持 key 冗余,find 返回中序第一个,count 返回实际个数,erase(值) 删除所有。
唯一多出来的一点:multimap 没有 operator[]
因为 key 冗余时,[] 到底返回哪个 value 的引用说不清楚,所以它只支持插入,不支持 [] 修改。
四、set和map的应用
学完接口,来看两个「降维打击」的场景。这两个问题用传统方法都要绕不少弯,换成 set/map 一下就顺了。
1、set:环形链表的入口
题目(LeetCode 142):给定一个链表,可能带环,返回环的入口节点;没有环则返回空。
初阶阶段我们通过「快慢指针 + 证明从头走和从相遇点走会在入口相遇」来解决,光理解证明就很费劲。用 set 的话思路极其直白:一路走,把走过的节点地址都记下来,第一个重复出现的节点就是环入口。
cpp
#include <iostream>
#include <set>
using namespace std;

struct ListNode
{
	int val;
	ListNode* next;
	ListNode(int x) : val(x), next(nullptr) {}
};

int main()
{
	// 构造 1 -> 2 -> 3 -> 4 -> 5,尾节点接到 3 形成环
	ListNode* n1 = new ListNode(1);
	ListNode* n2 = new ListNode(2);
	ListNode* n3 = new ListNode(3);
	ListNode* n4 = new ListNode(4);
	ListNode* n5 = new ListNode(5);
	n1->next = n2;
	n2->next = n3;
	n3->next = n4;
	n4->next = n5;
	n5->next = n3; // 成环

	// 用 set 记录走过的节点,第一个重复的就是环入口
	set<ListNode*> visited;
	ListNode* cur = n1;
	ListNode* entry = nullptr;
	while (cur)
	{
		auto ret = visited.insert(cur);
		if (ret.second == false) // 插入失败 => 这个节点已经走过
		{
			entry = cur;
			break;
		}
		cur = cur->next;
	}

	if (entry) cout << "环入口的值为 " << entry->val << endl;

	return 0;
}
关键点:set 存的是节点地址(指针),不是节点值。值可能重复,但地址是唯一的。
输出 环入口的值为 3,正确。这就是 set 的价值------把「记录是否出现过」这件事交给了红黑树,代码一下就清晰了。
2、map:随机链表的复制
题目(LeetCode 138):链表每个节点多一个 random 指针,随机指向任意节点或空,要求深拷贝这个链表。
难点在 random 指针:复制时如果直接复制 random 的指向,会指到原链表的节点上。初阶阶段的处理非常绕(复制节点插到原节点后面,再拆下来)。
用 map 的思路就简单了:建立「原节点 → 新节点」的映射,两遍遍历:
cpp
#include <iostream>
#include <map>
using namespace std;

struct Node
{
	int val;
	Node* next;
	Node* random;
	Node(int x) : val(x), next(nullptr), random(nullptr) {}
};

int main()
{
	// 构造 1 -> 2 -> 3,random:1->3, 2->1, 3->nullptr
	Node* a = new Node(1);
	Node* b = new Node(2);
	Node* c = new Node(3);
	a->next = b;
	b->next = c;
	a->random = c;
	b->random = a;
	c->random = nullptr;

	// 第一遍:复制节点,建立 原节点 -> 新节点 的映射
	map<Node*, Node*> nodeMap;
	Node* head = a;
	Node* copyHead = nullptr;
	Node* copyTail = nullptr;
	Node* cur = head;
	while (cur)
	{
		Node* n = new Node(cur->val);
		if (copyTail == nullptr) copyHead = copyTail = n;
		else { copyTail->next = n; copyTail = n; }
		nodeMap[cur] = n;
		cur = cur->next;
	}

	// 第二遍:处理 random 指针
	cur = head;
	Node* copyCur = copyHead;
	while (cur)
	{
		copyCur->random = (cur->random == nullptr) ? nullptr : nodeMap[cur->random];
		cur = cur->next;
		copyCur = copyCur->next;
	}

	// 打印副本的 val 和 random
	for (Node* p = copyHead; p != nullptr; p = p->next)
	{
		cout << p->val << " -> ";
		if (p->random) cout << p->random->val;
		else cout << "null";
		cout << endl;
	}

	return 0;
}
第一遍把每个原节点对应的新节点记到 map 里,第二遍就能通过 nodeMap[cur->random] 快速找到「原节点的 random 对应哪个新节点」。
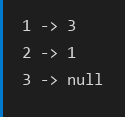
输出 1->3、2->1、3->null,random 指向都正确复制到了新链表上。
如果觉得有帮助,可以关注Github项目持续更新