⭐️在这个怀疑的年代,我们依然需要信仰。
个人主页 :YYYing.
⭐️设计模式系列专栏:设计模式系列
系列上期内容:【设计模式系列 (四) 】建造者模式
系列下期内容:暂无
目录
[1. 概述](#1. 概述)
[2. 结构](#2. 结构)
[3. 核心矛盾:浅克隆 vs 深克隆](#3. 核心矛盾:浅克隆 vs 深克隆)
[4. 实现一:浅克隆(proto/ex1)](#4. 实现一:浅克隆(proto/ex1))
[4.1 抽象原型](#4.1 抽象原型)
[4.2 具体原型](#4.2 具体原型)
[4.3 客户端验证共享](#4.3 客户端验证共享)
[5. 实现二:深克隆(proto/ex2)](#5. 实现二:深克隆(proto/ex2))
[5.1 这段代码里的两个坑](#5.1 这段代码里的两个坑)
[5.2 深克隆的另一种实现:序列化](#5.2 深克隆的另一种实现:序列化)
[6. 为什么 clone() 不直接返回具体类型?](#6. 为什么 clone() 不直接返回具体类型?)
[7. 优缺点与适用环境](#7. 优缺点与适用环境)
[7.1 典型用法:原型管理器](#7.1 典型用法:原型管理器)
[8. 面试专题](#8. 面试专题)
[8.1 开场题:说说原型模式吧](#8.1 开场题:说说原型模式吧)
[8.2 高频追问清单](#8.2 高频追问清单)
[8.3 什么时候不该用原型](#8.3 什么时候不该用原型)
创建型模式里,原型模式是最容易被低估的一个。它的核心只有两个字:克隆。
本文代码取自 design-pattern-cpp 仓库的 design-pattern/proto/,使用 C++11。为阅读方便,片段省略了头文件保护宏。
1. 概述
Wikipedia :The prototype pattern is a creational design pattern in software development. It is used when the type of objects to create is determined by a prototypical instance, which is cloned to produce new objects.
原型模式是软件开发中的一种创造设计模式。当要创建的对象类型由原型实例确定时使用,该实例被克隆以生成新对象。
GoF:Specify the kinds of objects to create using a prototypical instance, and create new objects by copying this prototype.
使用原型实例指定要创建的对象的种类,并通过复制此原型来创建新对象。
翻译过来一句话:用原型实例指定要创建的对象种类,并通过复制这个原型来创建新对象。
两个关键词:
① 原型实例(prototypical instance)
创建对象不再通过 new 类名(),而是从一个已经存在的实例身上复制。
② 克隆(clone)
原型模式解决的问题是"创建代价高":
-
对象的构造需要查数据库、发网络请求、做大量计算 → 造一个就够,剩下的复制;
-
运行时才知道要造哪种子类(手里只有一个基类指针)→ 让它自己 clone 自己,比写一堆
if/else判断类型再 new 优雅; -
需要一个与现有对象状态相同、后续独立演化的副本 → 比如游戏关卡编辑器里的"复制粘贴"、撤销栈里的对象快照。
2. 结构
| 角色 | 职责 |
|---|---|
| Prototype(抽象原型) | 声明 clone() 接口。所有原型必须实现它 |
| ConcretePrototype(具体原型) | 实现 clone(),返回自己的一个副本 |
| Client(客户端) | 调用 clone() 得到新对象,不关心具体类型 |
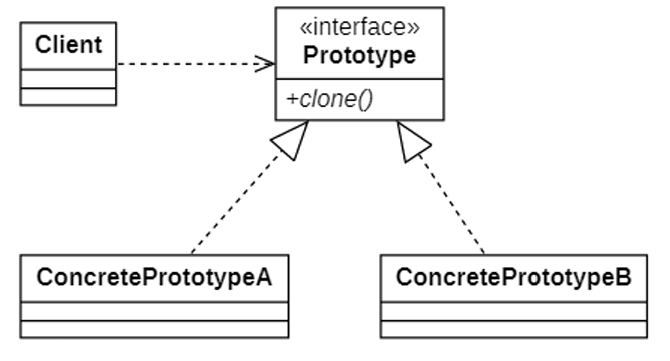
结构很简单:一个虚函数 + 一次拷贝构造。难的是"拷贝"到底拷多深。
3. 核心矛盾:浅克隆 vs 深克隆
这是原型模式真正要考的东西。
C++ 默认的拷贝构造是逐成员拷贝(逐字节复制),对指针成员只复制地址本身:
| 成员类型 | 默认拷贝的行为 | 后果 |
|---|---|---|
| 基本类型 / 值语义成员 | 复制一份值 | ✅ 两个对象互不影响 |
| 指针 / 引用成员 | 只复制地址 | ❌ 两个对象指向同一份资源 |
于是有了两个概念:
-
浅克隆(Shallow Clone) :只复制值成员和指针本身,指针指向的资源仍是共享 的。改副本会影响原型;两个对象析构时还会重复释放同一块内存。
-
深克隆(Deep Clone) :连指针指向的对象也复制一份,副本与原型完全独立。
一句话:浅克隆共享资源,深克隆复制资源。
4. 实现一:浅克隆(proto/ex1)
4.1 抽象原型
cpp
namespace proto
{
    class Prototyppe          // 仓库里的原拼写,多了一个 p
    {
    public:
        virtual Prototyppe* clone() = 0;
    };
}
4.2 具体原型
仓库里用 CC_SYNTHESIZE 系列宏自动生成 getter/setter,先看一眼宏展开才读得懂代码:
cpp
/** 定义受保护的变量,并提供get、set方法 */
#define CC_SYNTHESIZE(varType, varName, funName)\
protected: varType varName;\
public: varType get##funName(void) const { return varName; }\
public: void set##funName(varType var){ varName = var; }
Level 的成员里有 std::vector<Monster*> 和 Rewards* 两个指针成员,这正是浅克隆会出问题的地方:
cpp
class Level : public Prototyppe
{
    CC_SYNTHESIZE(std::string, name, Name);
    CC_SYNTHESIZE(std::string, descrip, Descrip);
    CC_SYNTHESIZE_CR_GET(std::vector<Monster*>, monsters, Monsters);  // 返回引用,才能 push_back
    CC_SYNTHESIZE(Rewards*, rew, Rew);
    CC_SYNTHESIZE_SET(bool, release, Release);                        // 只给 set,不需要 get
public:
    Prototyppe* clone() override
    {
        // 使用默认拷贝构造进行浅克隆
        Level* copy = new Level(*this);
        copy->setRelease(false);
        return copy;
    }
    Level() {
        release = true;
        this->rew = nullptr;
    }
    ~Level() {
        if (!release) return;          // ← 副本不负责释放资源
        if (this->rew) delete rew;
        for (auto one : monsters) delete one;
        monsters.clear();
    }
};
关键在于 release 这个标记:clone() 造出的副本把 release 置为 false,于是它析构时直接 return ,不碰那些共享的 Rewards 和 Monster。
这是"浅克隆避免 double free"的典型权宜写法------资源只有原型自己释放,副本只借用 。代价也很明显:副本一旦自己新增了 Monster / Rewards,就泄漏了。
4.3 客户端验证共享
cpp
Level* proto = new Level();
proto->setName("普通山庄");
proto->setDescrip("这是一个比较危险的山庄,经常有山蜇出没.");
proto->getMonsters().push_back(new Monster(10, 20));
proto->setRew(new Rewards(10));
Level* copy = dynamic_cast<Level*>(proto->clone());
copy->setDescrip("我修改了描述"); // 值成员:互不影响
std::cout << "proto:" << proto->getDescrip() << std::endl; // 原描述
std::cout << "copy:" << copy->getDescrip() << std::endl; // 我修改了描述
copy->getRew()->setGold(30); // 指针成员:改副本 = 改原型
std::cout << "proto:" << proto->getRew()->getGold() << std::endl; // 30 ← 被带跑了
std::cout << "copy:" << copy->getRew()->getGold() << std::endl; // 30copy->getRew()->setGold(30) 这一行就是浅克隆的"罪证":只改了副本的奖励,原型的金币也跟着变成 30。
顺带一提,Prototyppe* 要 dynamic_cast<Level*> 才能拿回具体类型------这个问题下一节会讲怎么优雅解决。
5. 实现二:深克隆(proto/ex2)
思路:绕过默认拷贝构造,自己写一套 copy() / release(),让拷贝构造和赋值运算符共用同一份深拷贝逻辑。
cpp
class Level : public Prototyppe
{
    CC_SYNTHESIZE(std::string, name, Name);
    CC_SYNTHESIZE(std::string, descrip, Descrip);
    CC_SYNTHESIZE_CR_GET(std::vector<Monster*>, monsters, Monsters);
    CC_SYNTHESIZE(Rewards*, rew, Rew);
private:
    void copy(const Level& l) {
        this->name = l.name;
        this->descrip = l.descrip;   // 值成员直接赋
        if (l.rew)
        {
            this->rew = new Rewards(*l.rew);          // ★ 指针成员:重新 new 一份
        }
        for (auto m : l.monsters)
        {
            this->monsters.push_back(new Monster(*m)); // ★ 容器里的指针同样逐个深拷贝
        }
    }
    void release() {
        if (this->rew) { delete rew; this->rew = nullptr; }
        for (auto one : monsters) delete one;
        monsters.clear();
    }
public:
    Prototyppe* clone() override
    {
        // 使用拷贝构造进行克隆
        return new Level(*this);
    }
    Level() { this->rew = nullptr; }
    ~Level() { release(); }
    // 重写拷贝构造
    Level(const Level& l) { copy(l); }
    // 重载赋值运算符
    Level& operator=(const Level& l) {
        release();       // 先释放资源,防止覆盖前泄漏
        copy(l);         // 再复制
        return *this;
    }
};
三个要点:
-
copy()是深拷贝的唯一实现点,拷贝构造和赋值运算符都复用它。这样两份逻辑不会走偏,改一处即可。 -
operator=必须"先 release 再 copy",否则旧资源会被直接覆盖,造成泄漏。 -
clone()里的new Level(*this)走的就是被重写过的拷贝构造,所以自动变成深克隆------clone()本身不需要懂"深"还是"浅"。
此时再跑一遍客户端的验证代码:原型打印 10,副本打印 30,两者彻底独立。
5.1 这段代码里的两个坑
① 自赋值没有防护
cpp
Level& operator=(const Level& l) {
    release();   // 如果 this == &l,这一步已经把资源删了
    copy(l);     // 再去读已释放的内存 → UB
    return *this;
}
标准写法要在 release() 之前判断:
cpp
if (this == &l) return *this;② 异常安全
copy() 进行到一半抛异常(比如 new 失败),对象会停在"已经 release、只拷了一半"的半残状态,析构时还可能二次释放。
工程里更稳的做法是把裸指针换成智能指针 (std::unique_ptr<Rewards>、std::vector<std::unique_ptr<Monster>>),拷贝构造交给 RAII 管,深克隆只需要在 clone() 里显式 std::make_unique 一份。
5.2 深克隆的另一种实现:序列化
先把原型序列化 成字节流,再从字节流反序列化出新对象。
-
优点:不用给每个类手写
copy(),天然深拷贝,对类的新增成员自动生效; -
缺点:引入序列化框架、性能差、遇到不可序列化的成员(文件描述符、句柄、锁)就歇菜。
Java 的 Object.clone() 要求实现 Cloneable 接口,本质上也是同一类思路的产物。C++ 里没有语言级的 clone 支持,只能自己实现。
6. 为什么 clone() 不直接返回具体类型?
4.3 节提到过,仓库里返回 Prototyppe*,客户端要 dynamic_cast 才能拿回 Level*。其实 C++ 支持协变返回类型(covariant return type):
cpp
Level* clone() override { return new Level(*this); } // 合法,派生类可以收窄返回类型派生类把返回类型改写为更具体的类型是允许的(前提是返回指针或引用),这样客户端就不用 dynamic_cast 了。C++ 里这是零成本的。
但更值得注意的是原型模式的根本价值 ------多态地复制:
cpp
Prototyppe* p = getSomePrototype();   // 运行时才知道是 Level 还是 Boss
Prototyppe* copy = p->clone(); // 克隆出来的必然是正确的那一种这件事拷贝构造函数做不到 :拷贝构造是编译期静态绑定的,Prototyppe p = someLevel; 会发生对象切片 (slicing),派生部分被切掉。想在"只有一个基类指针"的前提下复制出正确的派生类对象,只能是虚函数 ------这就是 clone() 存在的意义。
7. 优缺点与适用环境
主要优点
-
创建新对象不必知道具体类型,客户端与具体类解耦;
-
逃避构造函数的约束------不需要为每种原型写一堆工厂类,减少类的数量;
-
可以动态地增删原型(运行期注册原型即可,见下);
-
对"创建代价高"的对象,复制比重新构造便宜得多。
主要缺点
-
每个类都必须实现 clone(),而且深克隆要处理每一层引用关系(引用环、共享成员),实现复杂;
-
深克隆的成本可能接近甚至超过重新构造,需要权衡;
-
必须小心处理浅克隆带来的资源重复释放问题;
-
与所有创建型模式一样,克隆细节对客户端透明,出问题时排查链更长。
适用环境
-
对象之间大同小异,差异只是若干属性的取值;
-
对象的创建代价大(数据准备、网络、复杂计算);
-
需要动态加载/注册原型,运行期才知道要造什么(配合原型管理器)。
7.1 典型用法:原型管理器
仓库里的 ClassFactory(工厂篇讲过的自注册反射机制)就是同一思路的另一个形态。如果要做"原型管理器",通常就是一张表:
cpp
class PrototypeManager {
    std::map<std::string, Prototyppe*> protos;   // 注册表:名字 → 原型
public:
    void add(const std::string& key, Prototyppe* p) { protos[key] = p; }
    Prototyppe* create(const std::string& key) { return protos[key]->clone(); }  // 克隆出副本
};
注意 :注册表里存的是"原型样板",取出来的一定是 clone() 的副本,而不是原型本身。否则所有客户端会共用同一个对象,就退化成全局变量了。
8. 面试专题
8.1 开场题:说说原型模式吧
考察点是概念、角色、应用场景,按这个顺序答:
概念 :原型模式用原型实例指定创建对象的种类,并通过拷贝这些原型来创建新对象。它属于创建型模式。
角色 :抽象原型 Prototype 声明
clone();具体原型 ConcretePrototype 实现clone()返回自己的副本;客户端通过调用clone()得到新对象,不关心具体类型。使用场景:对象创建代价高(要查库、走网络、复杂计算)时;对象之间只有少量属性不同时;运行时才知道要创建哪种子类、手里只有基类指针时。
核心难点:浅克隆与深克隆的取舍。
可扩展:把浅/深克隆的区别、和拷贝构造/工厂模式的区别接上(见下)。
8.2 高频追问清单
| 追问 | 答法 |
|---|---|
| 浅克隆和深克隆的区别?(必问) | 浅克隆只复制值成员和指针本身,指针指向的资源仍是共享的;深克隆连指针指向的对象一起复制,两者完全独立。C++ 默认拷贝构造就是浅克隆 |
| 深克隆怎么实现?(必问) | 一是自己重写拷贝构造 + 重载赋值运算符,集中到 copy() 里处理每一层引用;二是序列化/反序列化,通用但要引入框架且性能差 |
| 原型模式和拷贝构造函数有什么区别? | 拷贝构造是编译期静态绑定 的,用基类对象接派生类对象会发生对象切片 ;clone() 是虚函数,能多态地复制------拿基类指针就能克隆出正确的派生类对象 |
| 原型模式和工厂模式有什么区别? | 工厂关注"造哪个"(用类名/参数决定),原型关注"复制哪一个已有的"(用原型实例决定)。工厂要新增产品时通常要加工厂类,原型只需要多加一个原型对象(甚至运行期动态注册) |
为什么 clone() 返回基类指针? |
为了让客户端通过基类接口调用,实现多态复制。C++ 支持协变返回类型 ,派生类可以把返回类型收窄为具体类型,从而免掉 dynamic_cast |
| 浅克隆时怎么防止 double free? | 引用计数、智能指针(推荐)、或像仓库里那样用一个 release 标记让副本不参与资源释放 |
| 原型对象的析构谁负责? | 原型本身由创建它的人负责;克隆出的副本由客户端负责。所有权关系必须写清楚,否则就是上一问的 double free |
| 深克隆会遇到什么麻烦? | 引用环(A 引用 B、B 又引用 A)会导致无限递归;多个成员共享同一个对象时,深拷贝要保证"共享关系"也被正确复制,而不是各拷一份 |
| 原型模式有什么缺点? | 每个类都要实现 clone();深克隆实现复杂、成本可能不比重新构造低;容易踩浅克隆的资源重复释放 |
| 什么场景不适合用原型? | 对象结构简单、构造开销不大时,直接 new 更直观;对象里有不该被复制的资源(连接、句柄、锁)时,深拷贝语义难以定义 |
8.3 什么时候不该用原型
判断标准就一条:这个对象复制起来,真的比重新造便宜吗?
-
成员只有几个值类型、构造函数就是几个赋值 → 直接
new或拷贝构造,clone()是纯成本; -
对象持有外部资源(数据库连接、文件句柄、互斥锁)→ 深拷贝语义说不清楚,浅拷贝又会共享,别硬套;
-
只想复用一段初始化逻辑 → 那是一个工厂或构造辅助函数的事,不是原型模式。
原型模式的价值在于把"复制一个复杂对象"这件事封装成一次虚函数调用。对象不复杂的时候,它换不来任何东西。
结语
我是YYYing,后面还有更精彩的内容,希望各位能多多关注支持一下主包。
无限进步,我们下次再见!