AI 已经能显著缩短代码生产周期,但软件交付真正变慢的环节,正在从"写代码"转向"缺陷可靠闭环"。一个面向缺陷修复的 AutoDebug Agent,不能只停留在能分析、能解释、能生成报告,而要进入真实缺陷现场,拿到真实证据,修改真实仓库,并用反馈持续证明它是否真的修好了问题。
这类 Agent 的建设重点不是一开始设计宏大的系统,而是从一个真实缺陷开始,验证 AI 能否接手一次 Debug。每一轮失败、偏差和修复,都要沉淀为下一轮可复用的输入。
真实缺陷驱动的调试起点
构建 AutoDebug Agent 的起点,不是追求 Agent 形态有多完整,而是验证它能否在真实缺陷场景中完成一次有效 Debug。
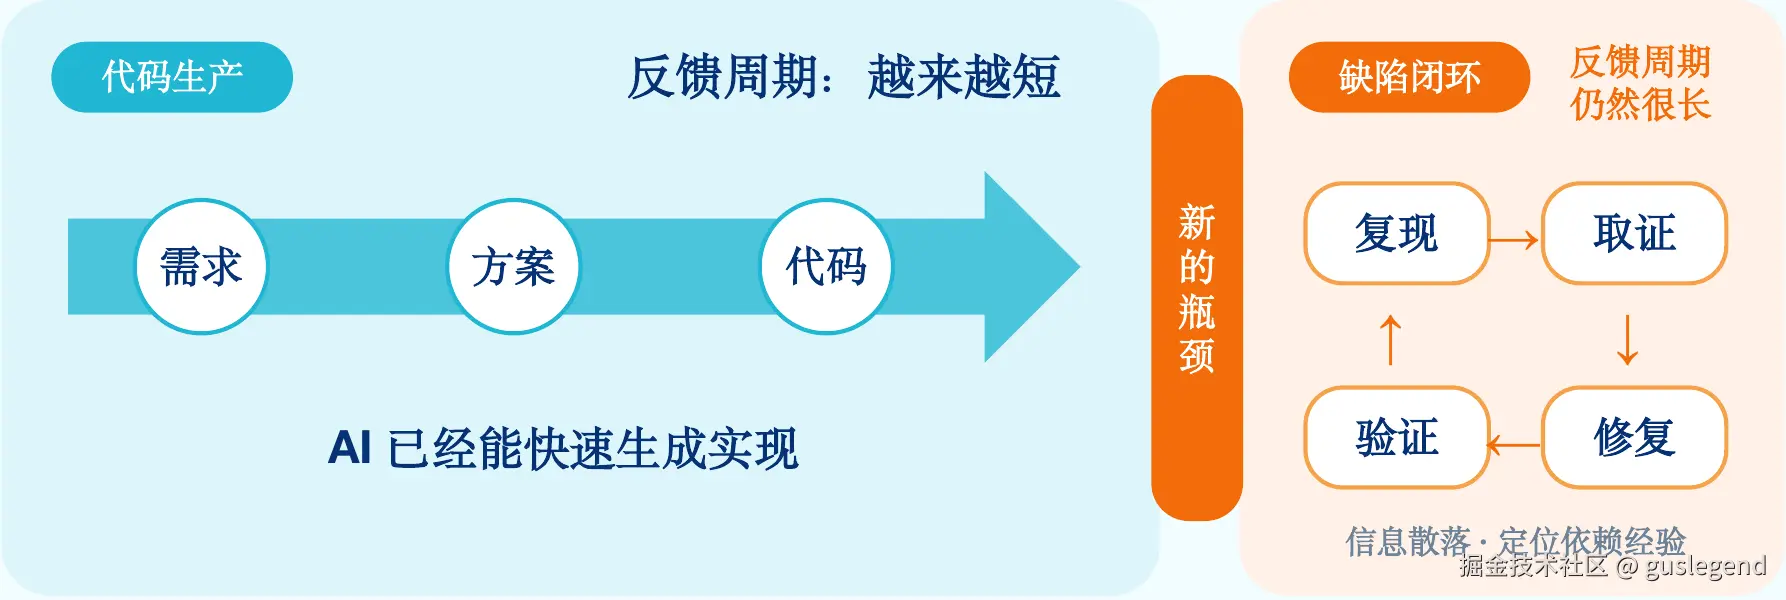
AI 缩短了"需求 → 方案 → 代码"的生产周期,但"复现 → 取证 → 修复 → 验证"的缺陷闭环仍然很慢。两条链路的反馈速度不对称,缺陷闭环成为新的交付瓶颈。
主要原因有两个:
- 信息散落在日志、请求、页面状态、代码变更、历史上下文中
- 定位过程依赖经验,难以完全流程化
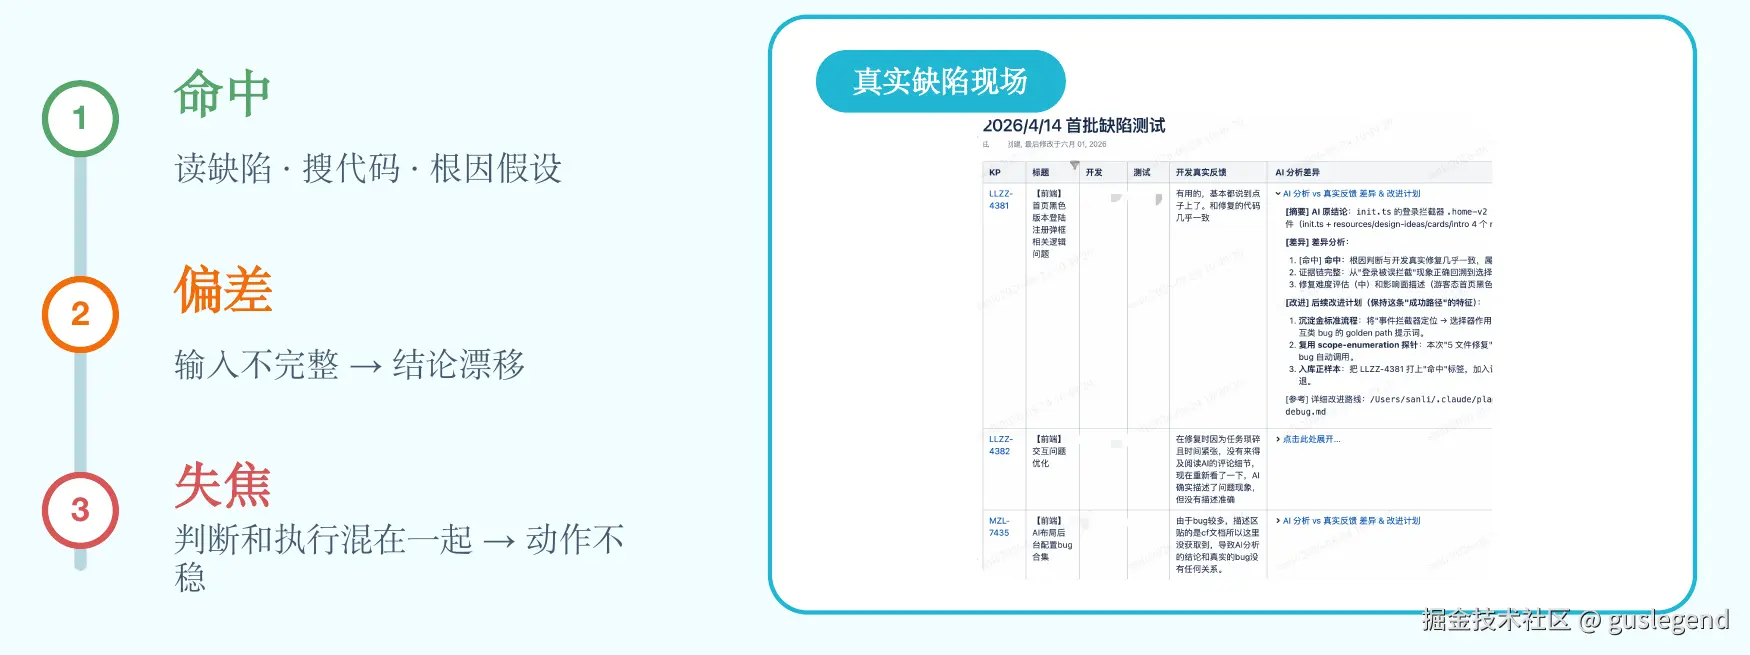
第一次真实缺陷试验的目标,不是证明 AI 很强,而是暴露下一轮应该改哪里。这个试验通常会出现三类现象:
| 阶段 | 动作 | 暴露的问题 |
|---|---|---|
| 命中 | 读缺陷、搜代码、提出根因假设 | AI 可以进入真实现场并尝试分析 |
| 偏差 | 输入信息不完整 | 结论容易漂移 |
| 失焦 | 判断和执行混在一起 | 动作不稳定 |
这说明 AutoDebug 的第一步不是"让 AI 全自动完成所有事",而是明确它在真实缺陷处理中到底能承担哪一段。
判断执行分离与闭环编排
判断与执行解耦:AI 处理不确定性,程序处理可重复性
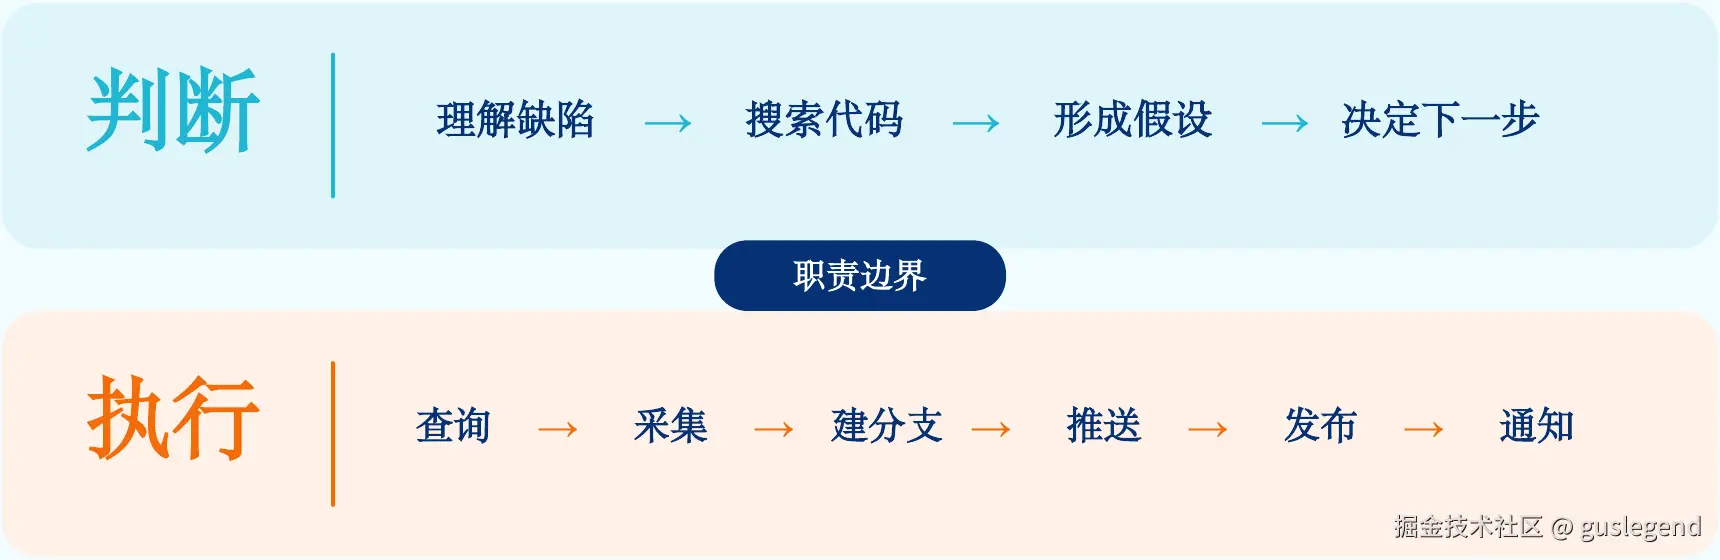
AutoDebug Agent 的关键设计,是把"判断"和"执行"拆开。
AI 更适合处理理解、推理、假设和决策;程序更适合处理查询、采集、建分支、推送、发布和通知。两者之间需要清晰的职责边界。
| 模块 | 负责内容 | 特点 |
|---|---|---|
| 判断 | 理解缺陷、搜索代码、形成假设、决定下一步 | 面向不确定性,需要推理和选择 |
| 执行 | 查询、采集、建分支、推送、发布、通知 | 面向可重复性,适合程序自动化 |
合理边界是:AI 判断方向,程序稳定执行。AI 不应该承担所有执行细节,程序也不应该替代 AI 做开放式判断。
输入质量决定修复上限
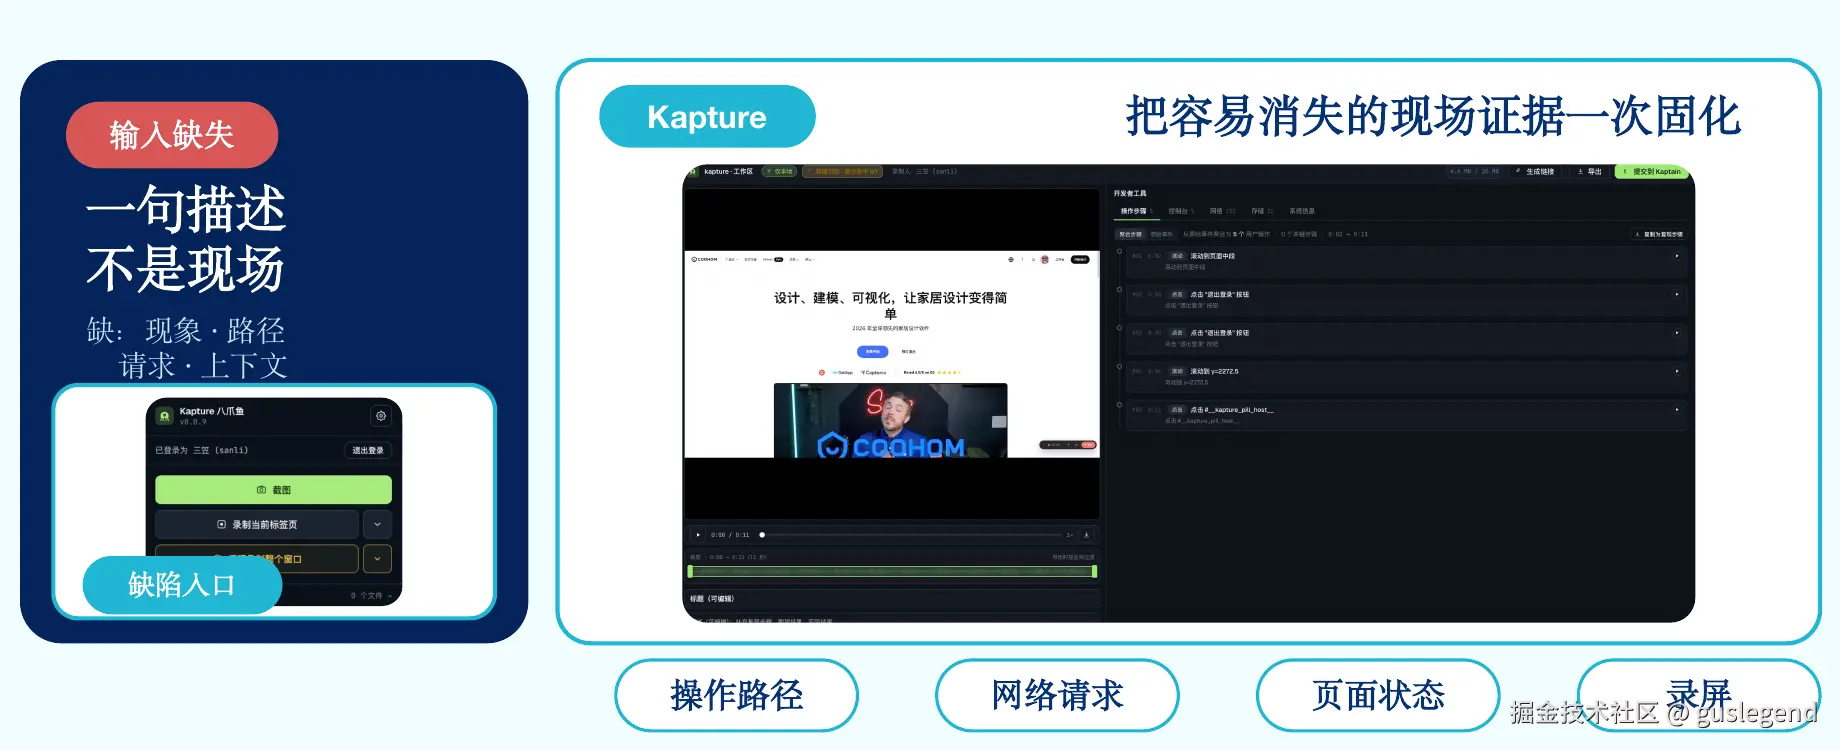
更强的模型无法弥补缺失的事实。一句"有问题"的描述,不能替代真实现场。
缺陷输入如果缺少现象、路径、请求和上下文,模型只能在不完整事实上猜测:
| 缺失项 | 影响 |
|---|---|
| 现象 | 无法确认问题的完整表现 |
| 路径 | 无法稳定复现用户如何触发问题 |
| 请求 | 缺少接口行为、请求响应等线索 |
| 上下文 | 缺少页面状态、环境、前后操作背景 |
缺陷入口应尽量承载现场证据,而不是只保留一句描述。Kapture 的作用,就是把容易消失的现场证据一次固化,把临时状态转成可复用、可分析的输入。
| 证据类型 | 作用 |
|---|---|
| 操作路径 | 记录用户如何触发问题 |
| 网络请求 | 保留接口请求和响应线索 |
| 页面状态 | 保留问题发生时的界面和状态 |
| 录屏 | 保留连续操作和可视化过程 |
输入质量决定最终修复效果的上限。现场事实缺失时,模型输出再完整,也只能是低置信度推断。
从脚本到可编排系统:让判断、执行、反馈形成闭环
AutoDebug 不能长期停留在单一脚本。脚本能跑通局部动作,但真正的工程价值来自可编排系统:稳定地把 AI 判断送进真实环境,并把真实反馈带回来。
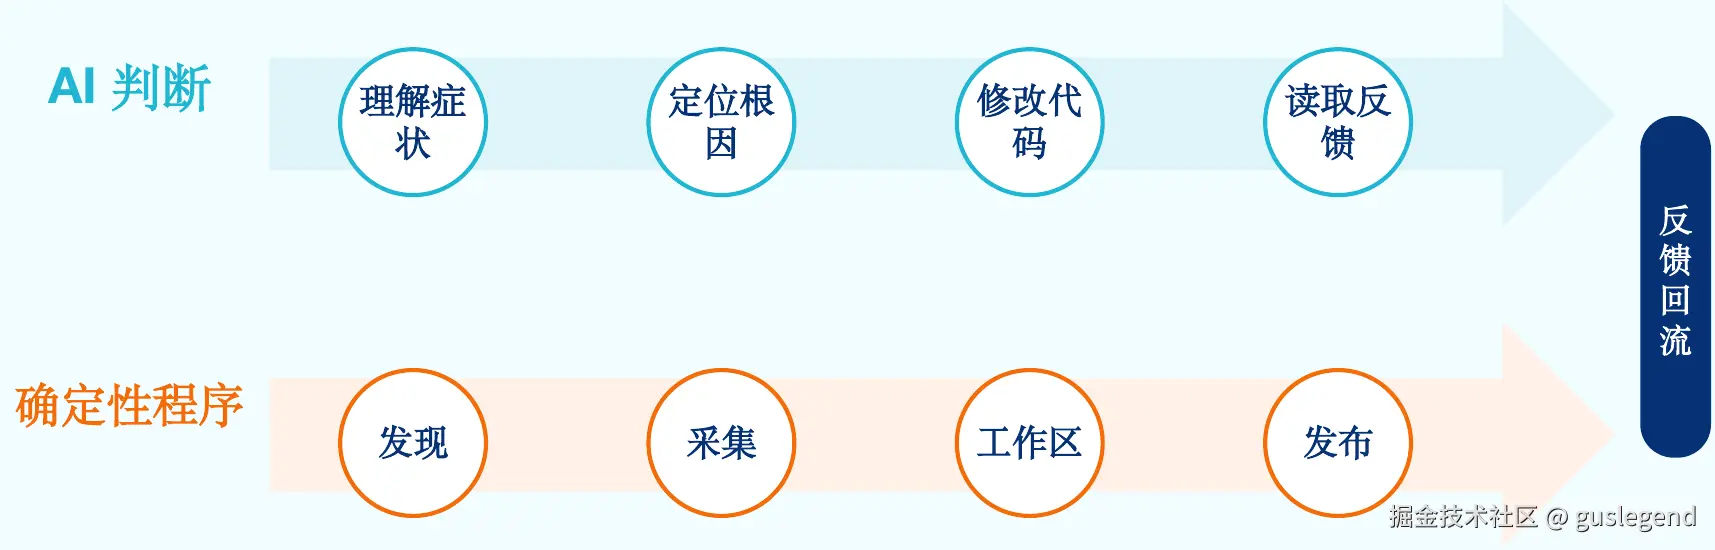
AI 判断链路包括理解症状、定位根因、修改代码和读取反馈;确定性程序链路包括发现、采集、工作区和发布。两条链路都必须进入反馈回流,让真实环境的结果重新影响下一轮判断。
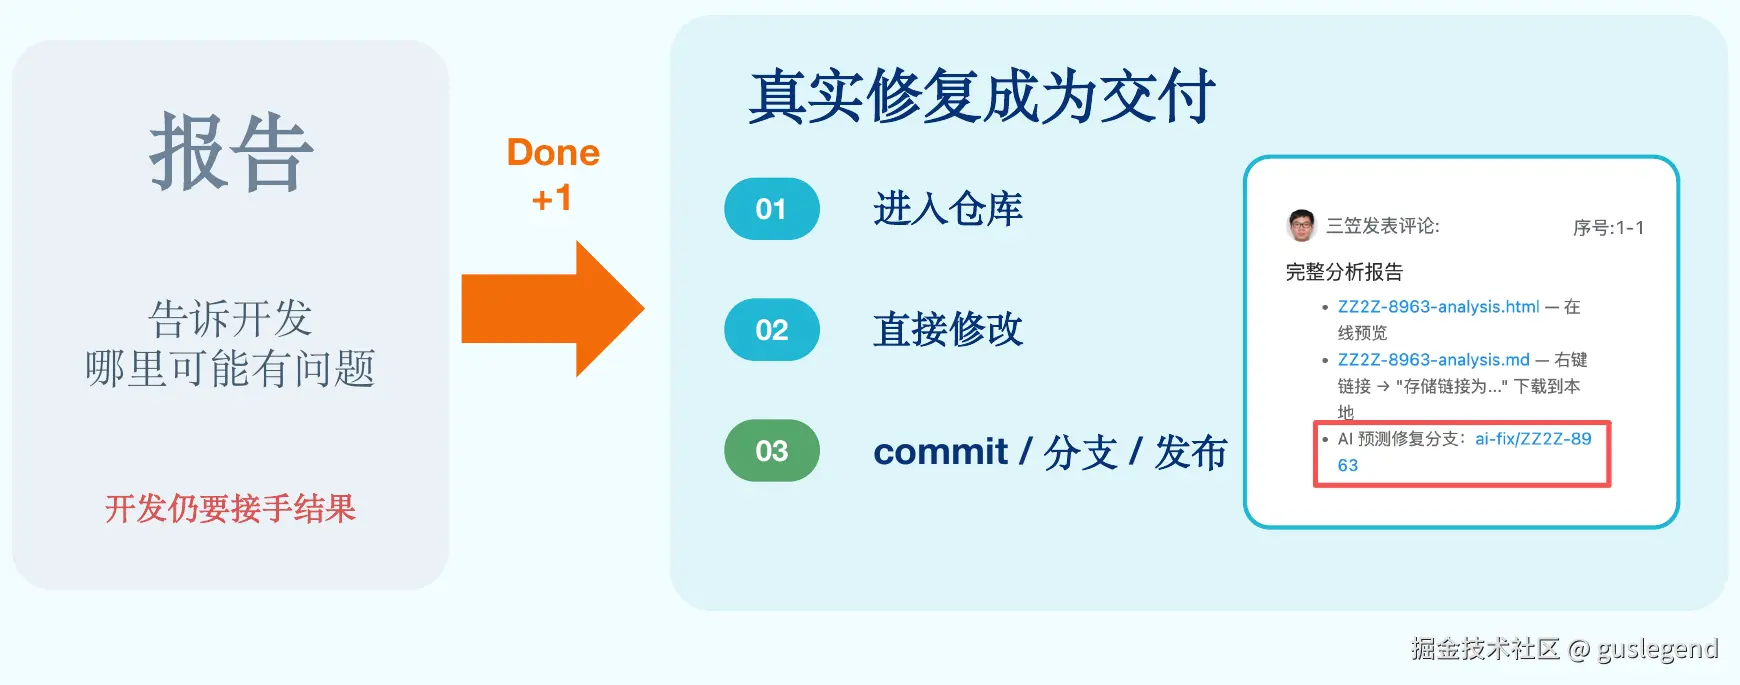
Agent 的价值也要从"说得像"升级为"交得出"。报告只能告诉开发哪里可能有问题,真实修复要求 Agent 能进入仓库、直接修改代码,并形成 commit、分支和发布等可追踪工程结果。
反馈驱动能力进化:结果不是终点,而是下一轮输入
真正的进化,不是单次结果变好,而是把每次结果沉淀为下一轮可复用的输入。
每一轮输出都应该产生可复用信息。这些信息会反过来影响下一轮判断、修复和交付。
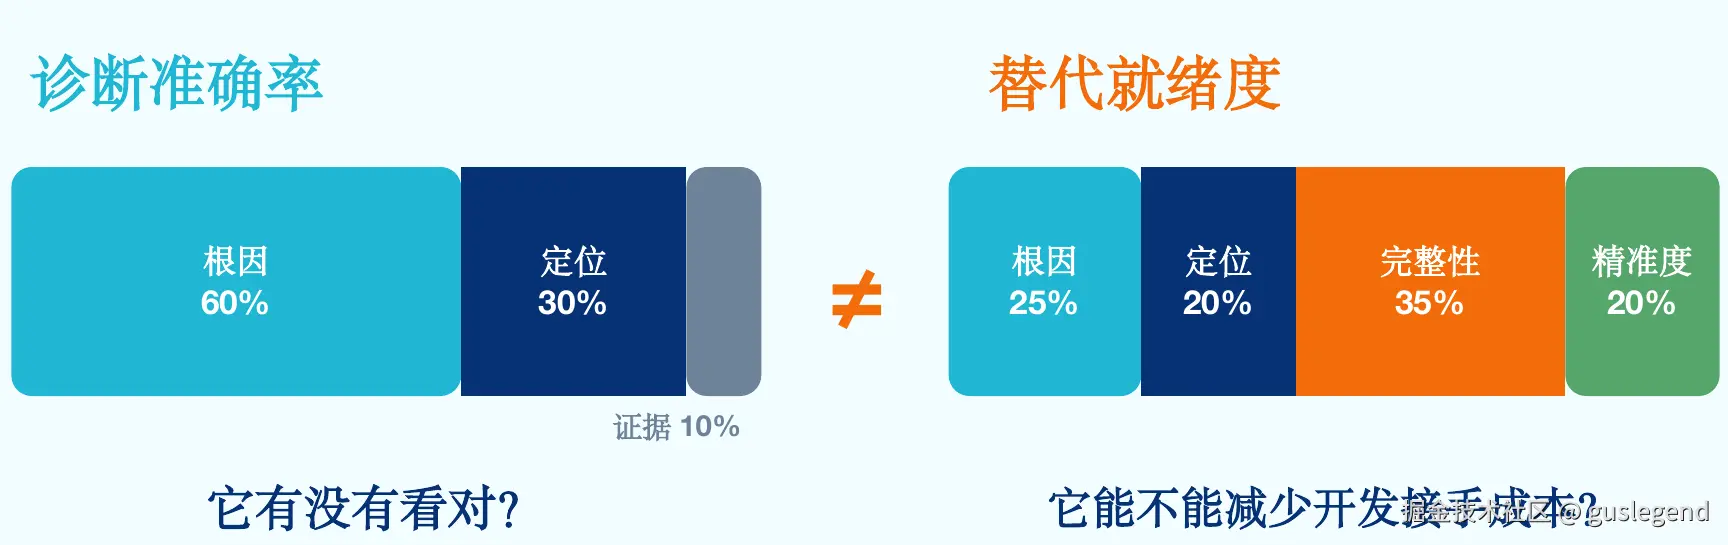
这里需要区分两个指标:诊断准确率和替代就绪度。
| 指标 | 关注问题 | 组成项 |
|---|---|---|
| 诊断准确率 | 它有没有看对 | 根因 60%、定位 30%、证据 10% |
| 替代就绪度 | 它能不能减少开发接手成本 | 根因 25%、定位 20%、完整性 35%、精准度 20% |
诊断准确率不等于替代就绪度。看对问题只是第一步,要减少开发接手成本,还需要结果足够完整、精准,并能进入工程交付链路。
修复验证与证据链
开发修复归因:不能把候选改动直接当成真实修复
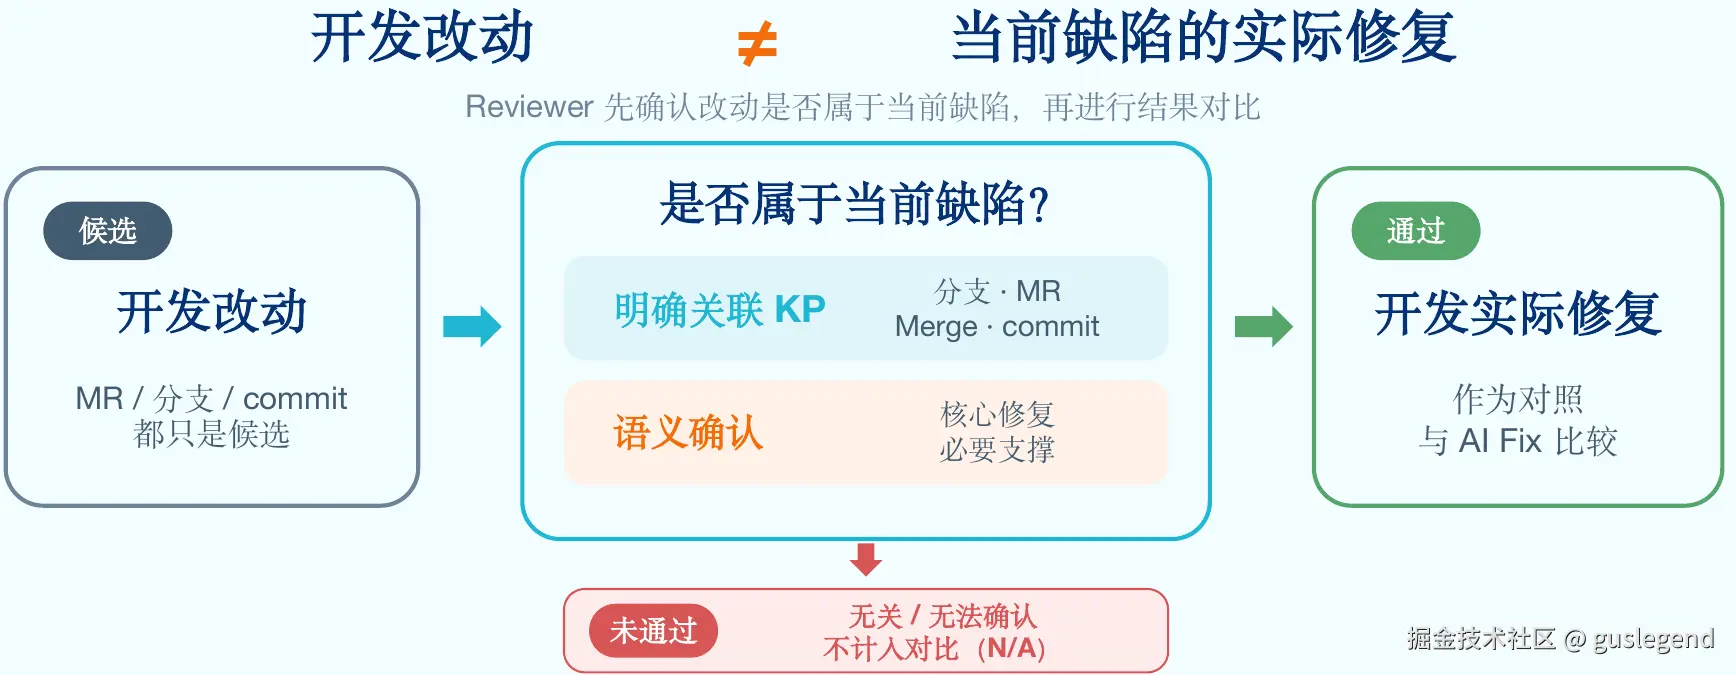
评估 AI Fix 时,必须先确认开发改动是否真的属于当前缺陷。MR、分支、Merge、commit 都只是候选线索,不能直接等同于实际修复。
| 判断项 | 说明 |
|---|---|
明确关联 KP |
改动需要能关联当前缺陷对应的 KP |
分支 / MR / Merge / commit |
只能作为候选线索 |
| 语义确认 | 要确认改动语义上确实修复当前缺陷 |
| 核心修复 | 只有被确认的改动才可作为对照与 AI Fix 比较 |
无法确认属于当前缺陷的开发改动,不应进入结果对比,应标记为 N/A。
未验证假设持续推进:让 Action 每天靠近结论
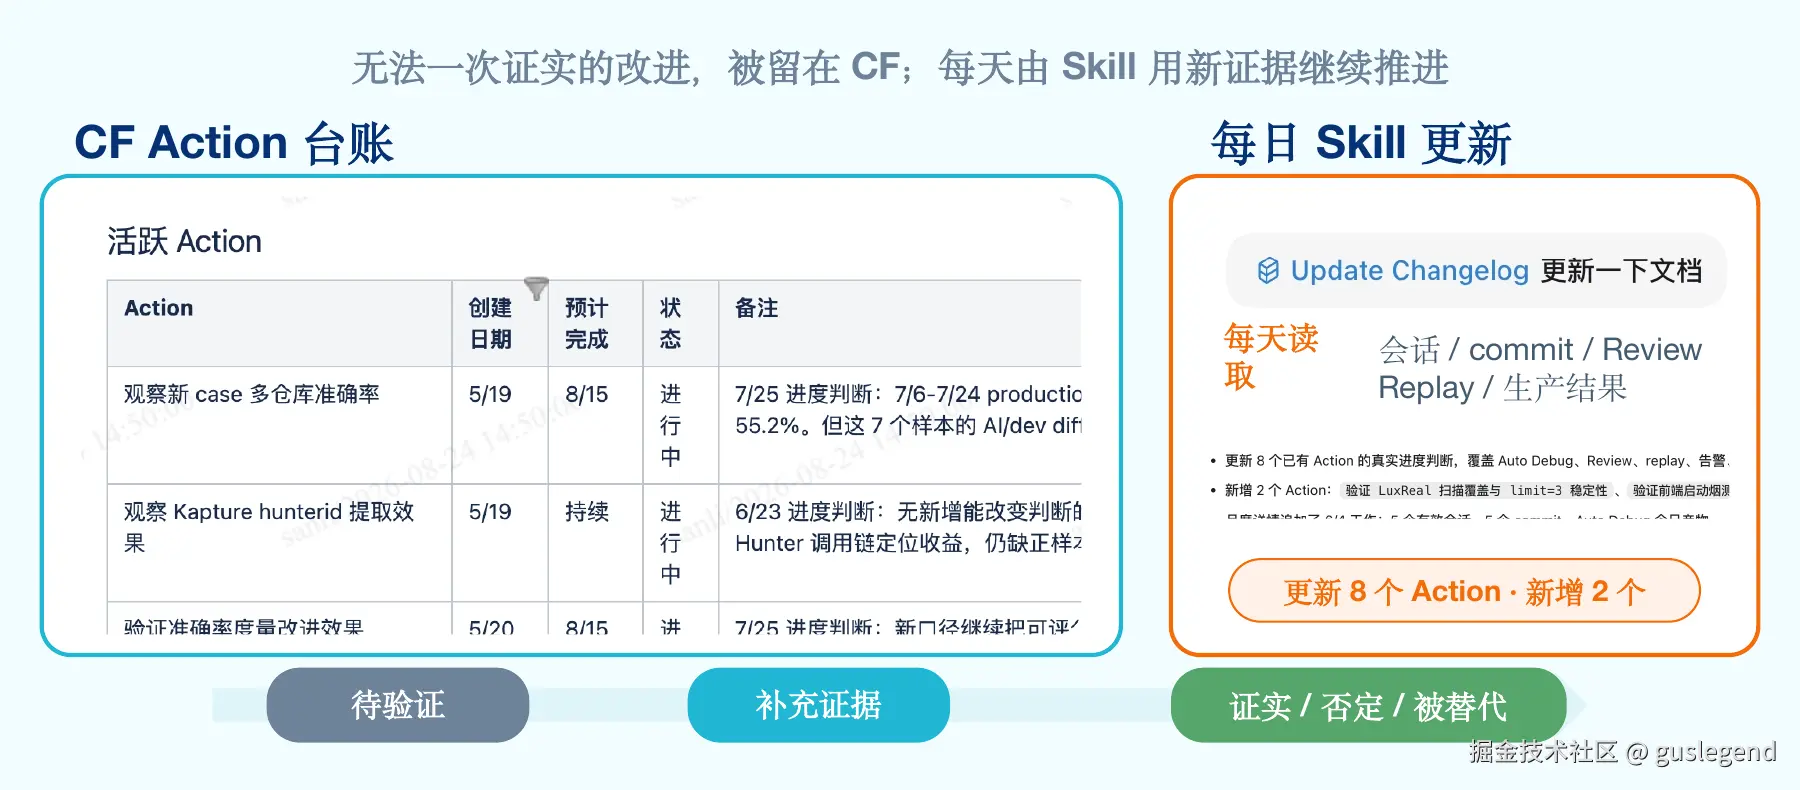
不是每天重来,而是每天让未验证假设向结论移动一步。一次无法证实的改进,可以保留在 CF 中,由 Skill 每天读取新证据继续推进。
CF Action 台账需要记录活跃 Action、创建日期、预计完成时间、状态和备注。每日 Skill 更新会读取会话、commit、Review、Replay 和生产结果等新证据,并根据证据推进假设状态。
每日更新推进了 8 个 Action,新增了 2 个 Action。每个 Action 的目标不是长期停留在"进行中",而是被证实、否定,或被更好的方案替代。
Replay 双轨验证:一条看能不能修好,一条看能不能判准
Replay 的核心机制是 Baseline → Reset → Rerun → Compare。它不是简单重跑,而是保存现场、清理对应记录、重跑主链,再对比新旧证据。
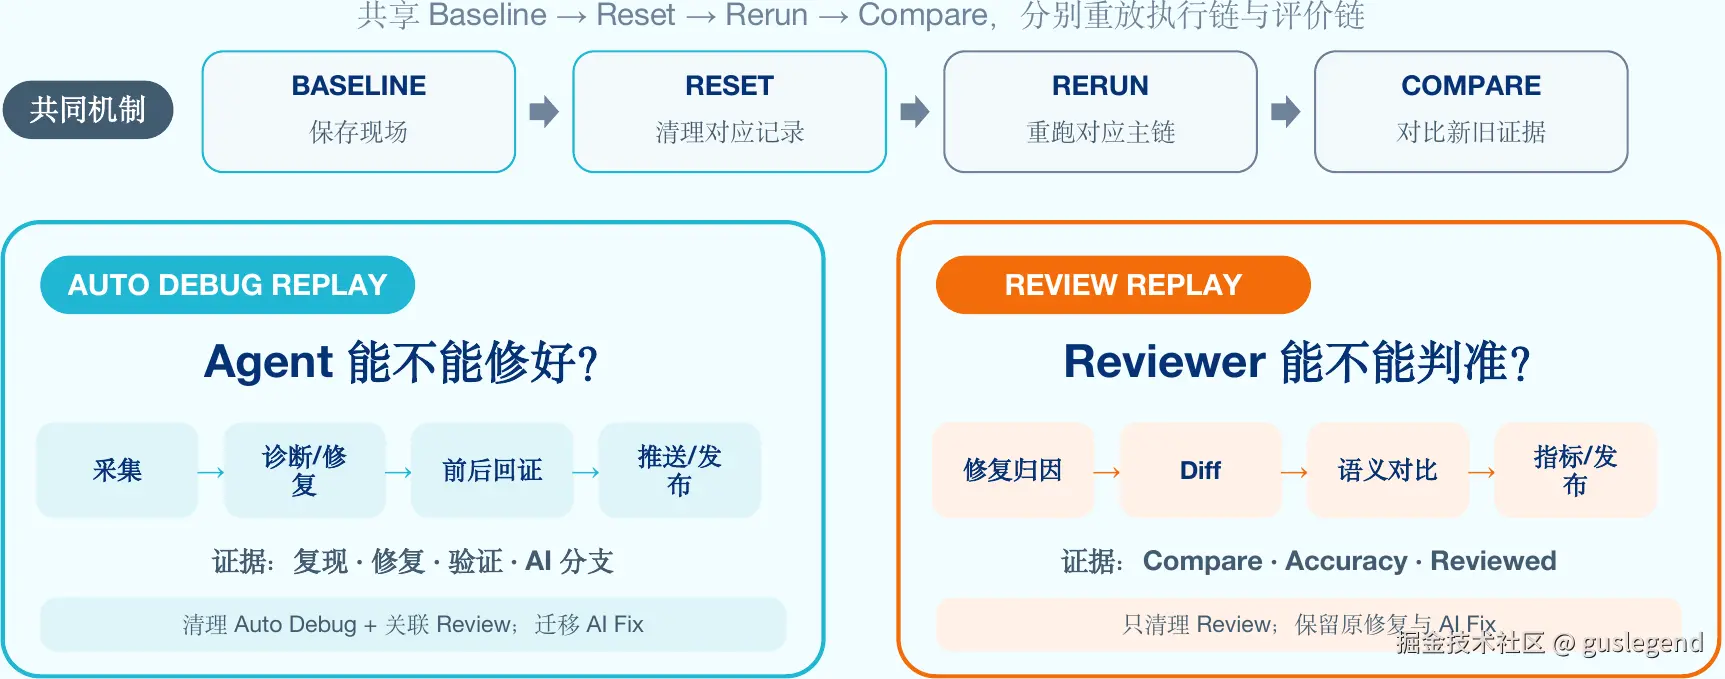
| 轨道 | 核心问题 | 流程 | 证据 | 清理 / 保留规则 |
|---|---|---|---|---|
AUTO DEBUG REPLAY |
Agent 能不能修好 | 采集 → 诊断/修复 → 前后回证 → 推送/发布 | 复现、修复、验证、AI 分支 |
清理 Auto Debug + 关联 Review,迁移 AI Fix |
REVIEW REPLAY |
Reviewer 能不能判准 | 修复归因 → Diff → 语义对比 → 指标/发布 |
Compare、Accuracy、Reviewed |
只清理 Review,保留原修复与 AI Fix |
两条链路清理范围不同,是为了避免把原修复和 AI Fix 误删。
试错环境与生产隔离:给快速试错留出安全空间
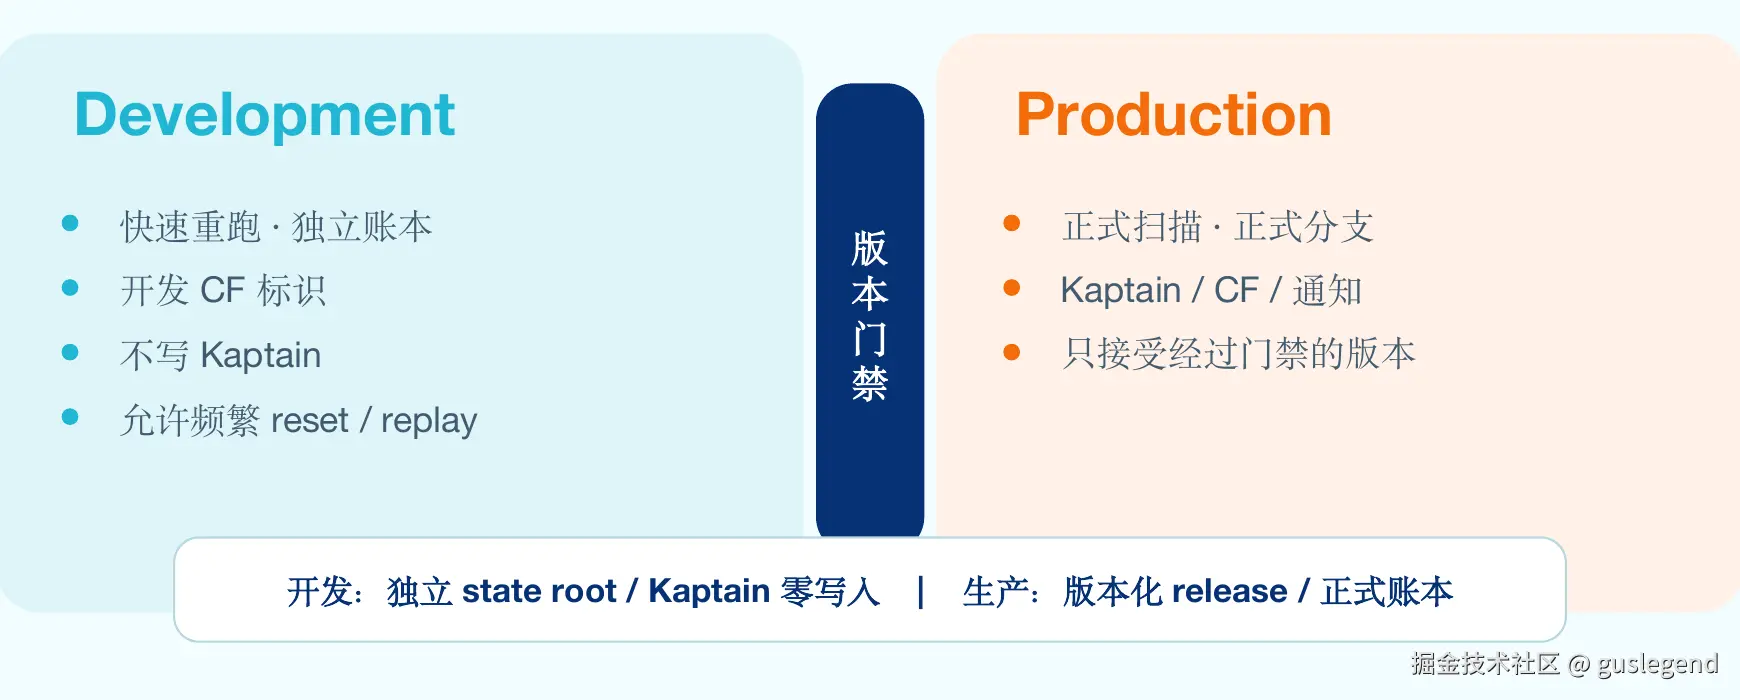
快速试错必须与生产交付隔离。开发环境用于快速重跑和验证假设,生产环境用于正式扫描和正式交付。
| 维度 | Development | Production |
|---|---|---|
| 运行目标 | 快速试错、快速重跑 | 正式扫描、正式交付 |
| 账本关系 | 独立账本 | 正式账本 |
| 标识机制 | 开发 CF 标识 | Kaptain / CF / 通知 |
| Kaptain 写入 | 不写 Kaptain | 只接受经过门禁的版本 |
| 重置与回放 | 允许频繁 reset / replay |
使用版本化 release |
| 版本控制 | 通过版本门禁与生产隔离 | 只接收已过门禁的版本 |
隔离环境不是平台化炫技,而是为高频试错提供安全空间。
修复证据链:原症状前后回证
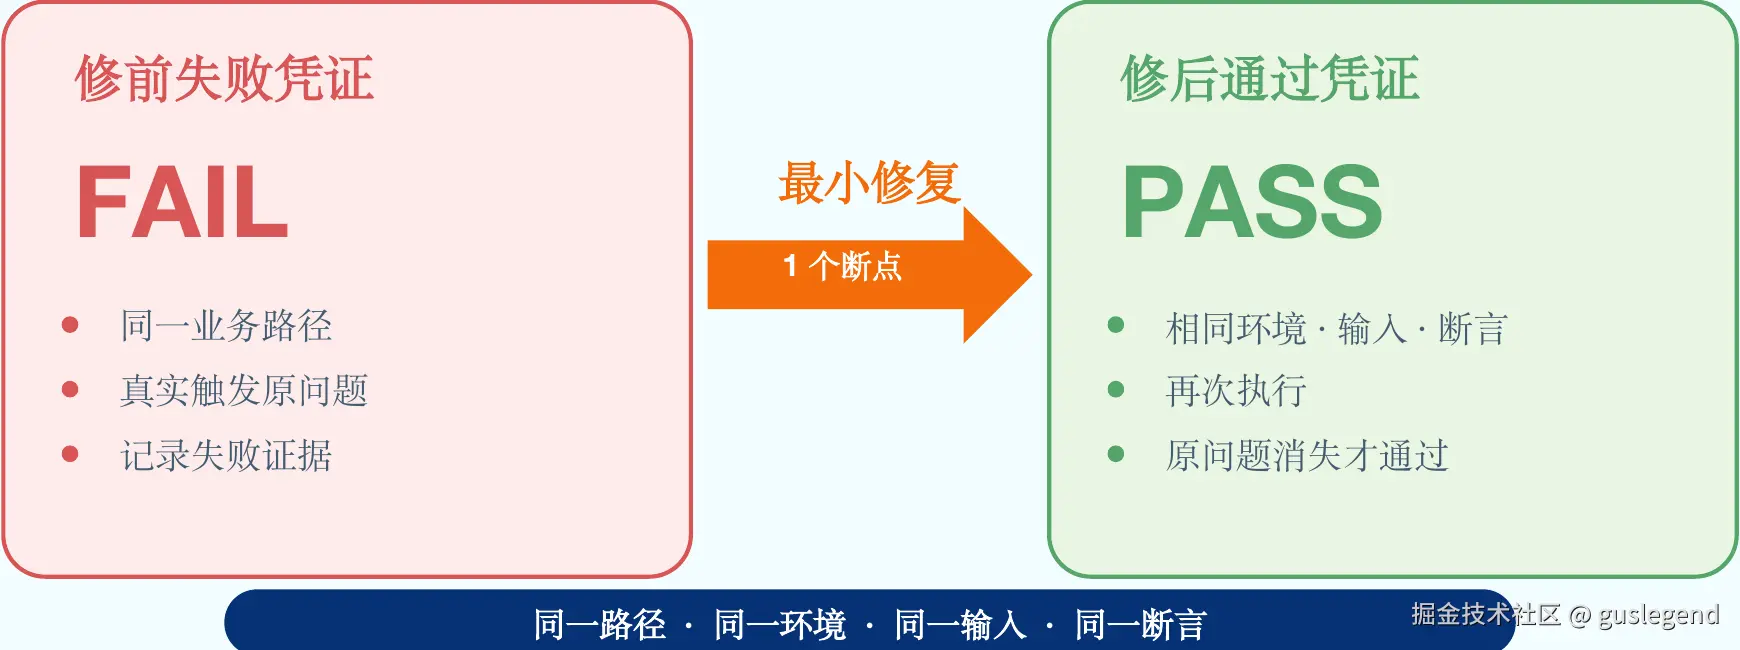
修复是否有效,不能只看测试是否通过,还要看原症状是否从失败变为通过。
| 阶段 | 状态 | 凭证要求 | 关键判断 |
|---|---|---|---|
| 修前失败凭证 | FAIL |
同一业务路径、真实触发原问题、记录失败证据 | 证明问题确实存在 |
| 最小修复 | 1 个断点 | 从失败到通过之间只做最小必要修改 | 用最小变更验证修复有效性 |
| 修后通过凭证 | PASS |
相同环境、输入、断言,再次执行 | 原问题消失才通过 |
修前与修后必须保持同一路径、同一环境、同一输入和同一断言。只有在这些条件不变的情况下,FAIL -> PASS 才能作为有效修复证据。
失败触发下一轮判断:不要用同一个 Prompt 机械重试
固定 Workflow 的问题在于,它把失败当成"继续改代码"的信号,而不是"重新判断"的信号。
改造前的流程通常是:采集、分析、修复、工程验证。验证失败后,继续使用同一修复 Prompt,最多重试 3 次。这种方式不补新证据,也不调整根因假设。
一个典型风险是:即使出现"273 个 Maven 测试通过",也不能直接等于"原始缺陷已修复"。失败后需要进入新一轮判断,而不是重复同一种重试。
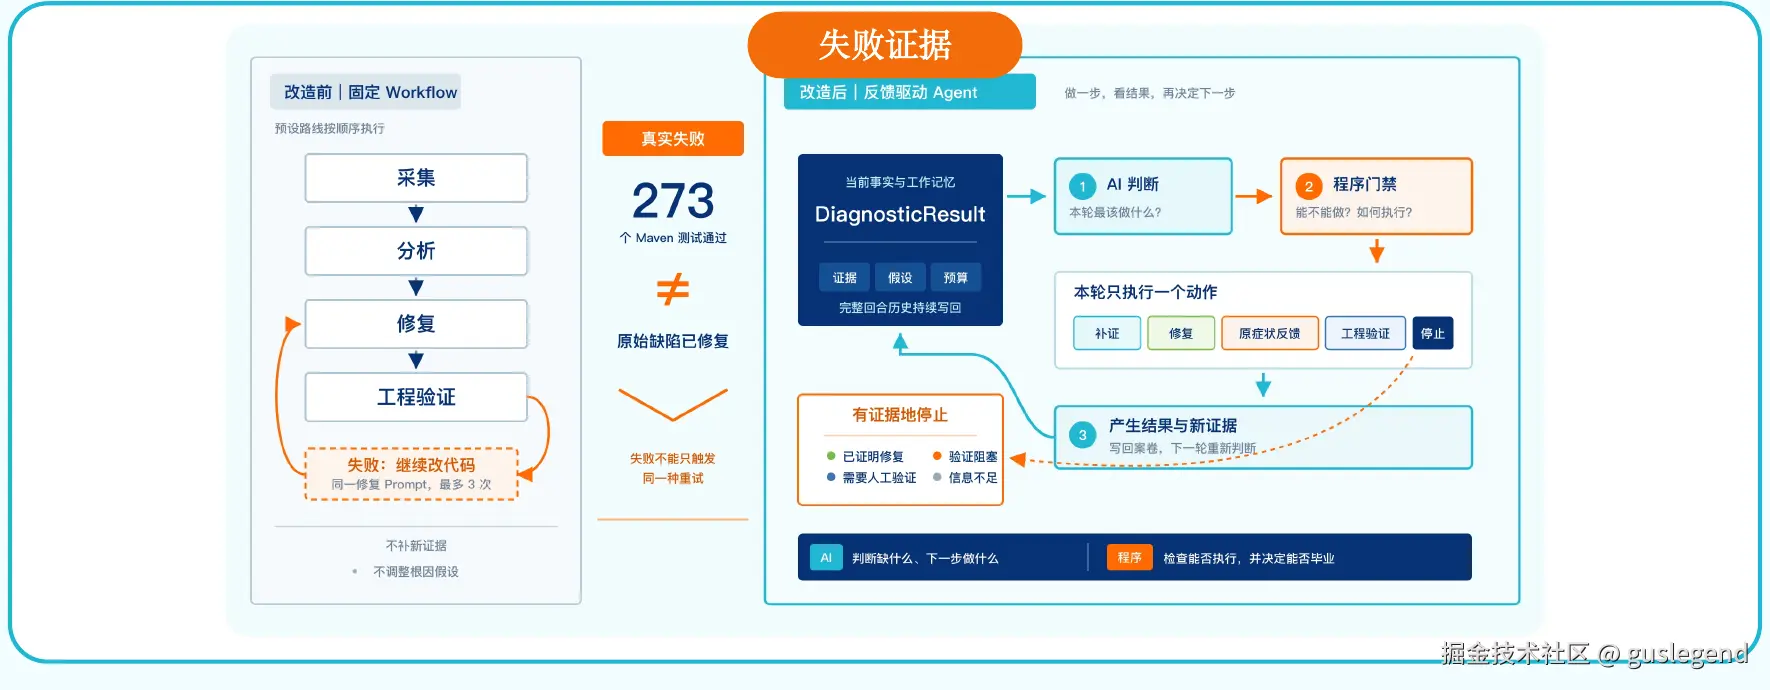
AI 负责判断做什么、下一步做什么;程序负责检查能否执行,并决定是否可以毕业。失败后的下一轮要读取失败证据,更新事实与假设,再决定补证、修复、反馈、工程验证或停止。
闭环体系与阶段度量
Loop:从复盘到自我改进
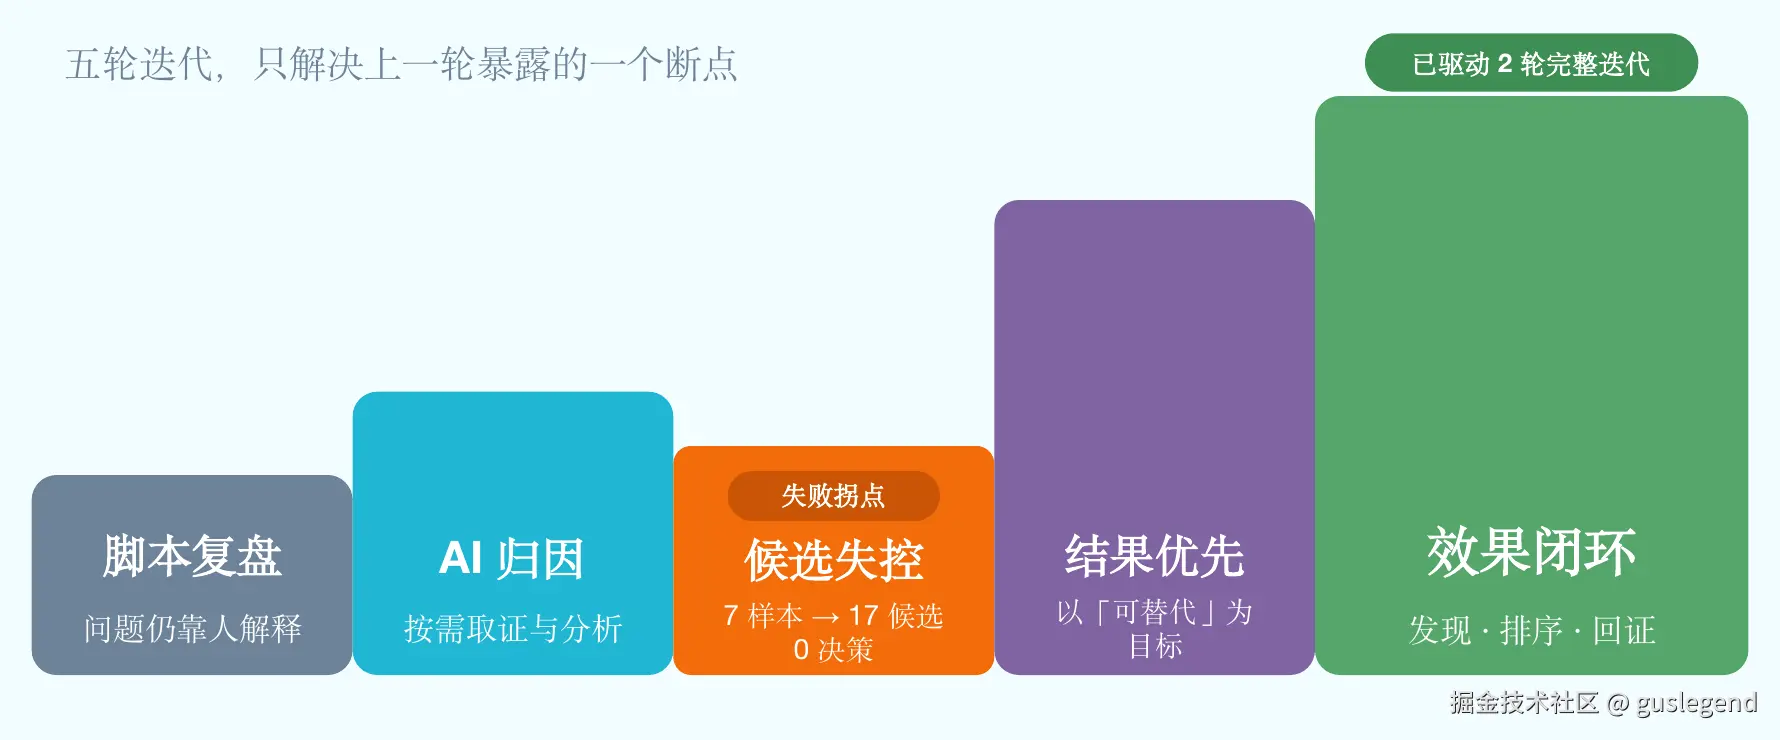
AutoDebug 的进化依赖真实反馈,而不是主观判断。迭代策略是共规划五轮迭代,每轮只解决上一轮暴露的一个断点,当前已驱动 2 轮完整迭代。
| 阶段 | 作用 | 当前问题或目标 |
|---|---|---|
| 脚本复盘 | 复盘执行过程 | 问题仍靠人解释 |
| AI 归因 | 按需取证与分析 | 由 AI 辅助定位原因 |
| 候选失控 | 生成候选方案 | 7 样本 → 17 候选,0 决策 |
| 结果优先 | 以结果筛选方案 | 以"可替代"为目标 |
| 效果闭环 | 形成持续改进闭环 | 发现、排序、回证 |
候选失控是一个关键断点。候选数量从 7 个样本扩展到 17 个候选,但最终决策数为 0,说明候选变多不等于质量变好。如果没有排序、验证和回证机制,AI 分析会停留在"生成很多可能性"。
缺陷闭环全景:发现、修复、评审、回放
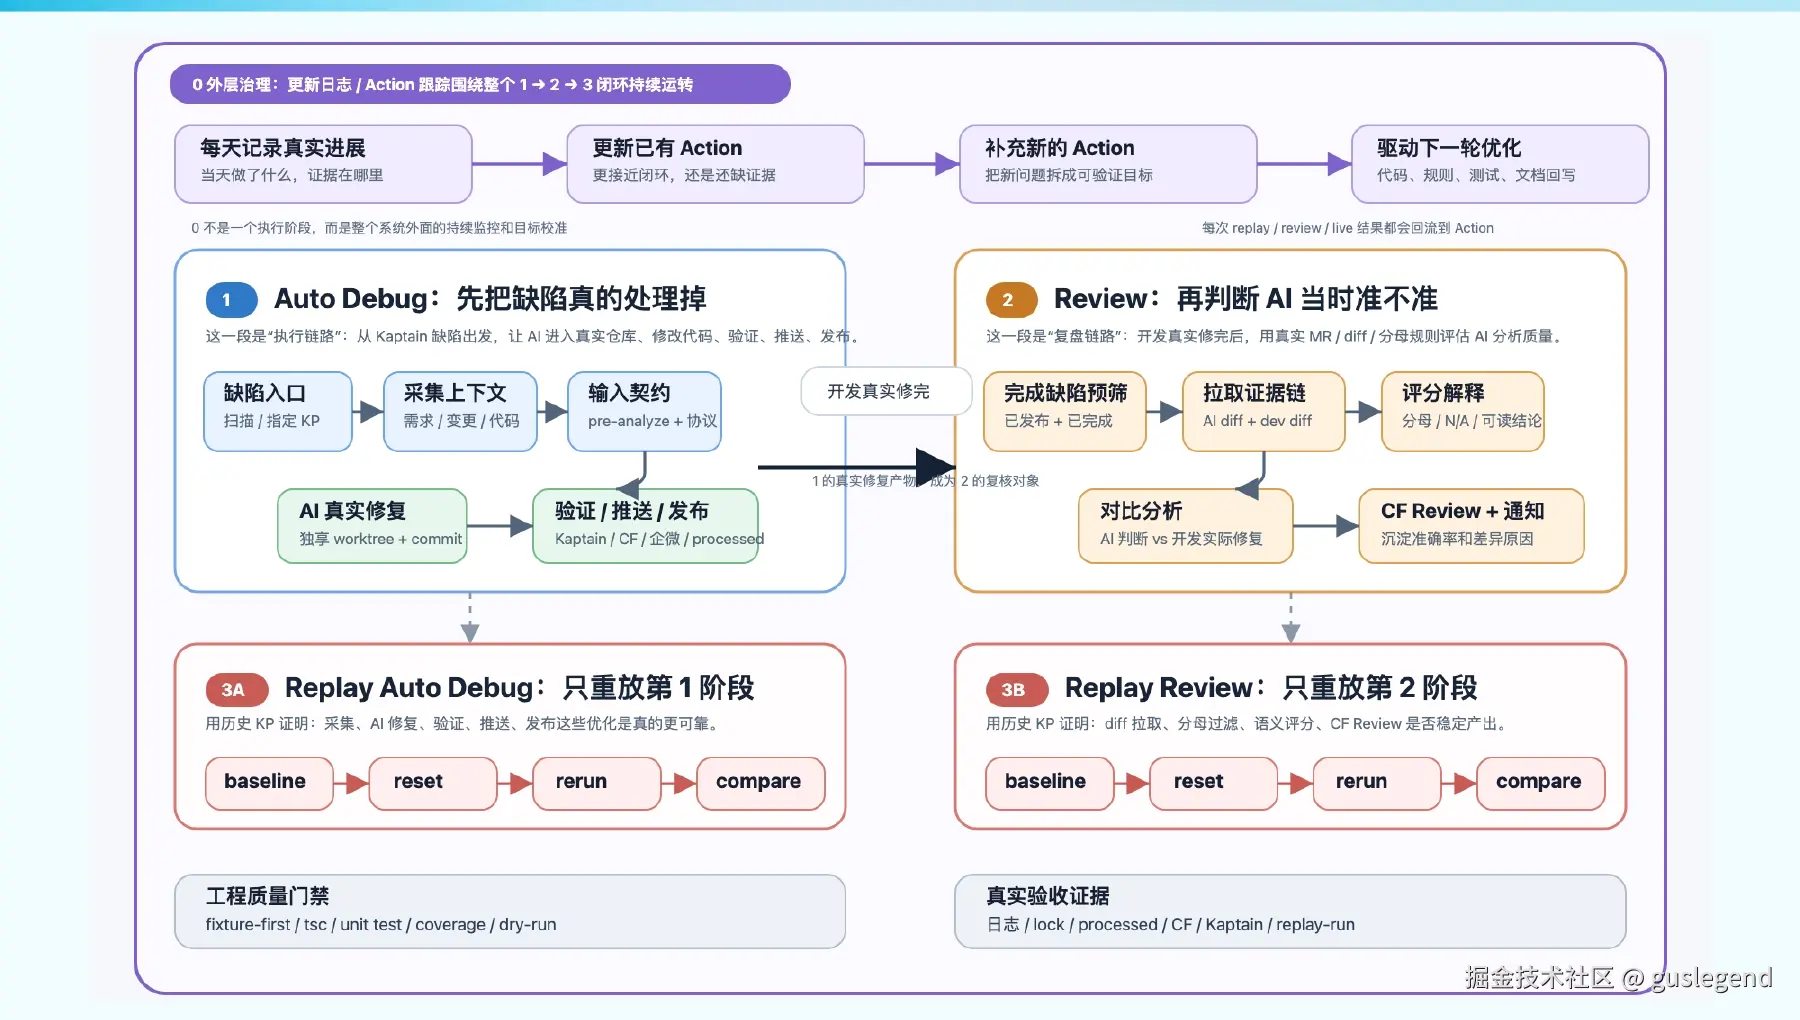
完整的缺陷闭环,不是单次修复,而是持续跟踪 Action 的系统。每次 replay、review、live 结果都要回流到 Action。
外层治理流程是:每天记录真实进展,更新已有 Action,补充新的 Action,再驱动下一轮优化。
AutoDebug、Review、Replay 分别解决不同问题:
| 阶段 | 定位 | 解决的问题 |
|---|---|---|
| Auto Debug | 执行链路 | 缺陷是否真的被处理 |
| Review | 复盘链路 | AI 当时判断是否准确 |
| Replay | 验证链路 | 优化是否可以被数据重复证明 |
Auto Debug 从 Kaptain 缺陷出发,让 AI 进入真实仓库,修改代码、验证、推送、发布。Review 在开发真实修完后,用真实 MR、diff 和分母规则评估 AI 分析质量。Replay 只重放关键阶段,用历史 KP 证明优化是否真的稳定。
| 编号 | Replay 类型 | 重放范围 | 证明内容 |
|---|---|---|---|
3A |
Replay Auto Debug | 只重放第 1 阶段 | 采集、AI 修复、验证、推送、发布是否更可得 |
3B |
Replay Review | 只重放第 2 阶段 | diff 拉取、分母过滤、语义评分、CF Review 是否稳定产出 |
工程质量门禁包括 fixture-first、tsc、unit test、coverage、dry-run。真实验收证据包括日志、lock、processed、CF、Kaptain、replay-run。
用数据证明阶段结果
没有真实样本、真实修复和真实回证,"Agent 很强"只是一句口号。
| 依据 | 含义 | 作用 |
|---|---|---|
| 真实样本 | 来自实际缺陷、真实 KP 或真实任务 |
避免只在演示样例中证明能力 |
| 真实修复 | AI 或开发在真实仓库中完成可验证修改 | 证明问题确实被处理,而不是只给出解释 |
| 真实回证 | 通过日志、对比、评审、Replay 等方式回流证据 | 证明修复有效,并支撑下一轮改进 |
阶段性结果必须能被数据证明,不能只靠主观描述。
规模化验证与交付指标
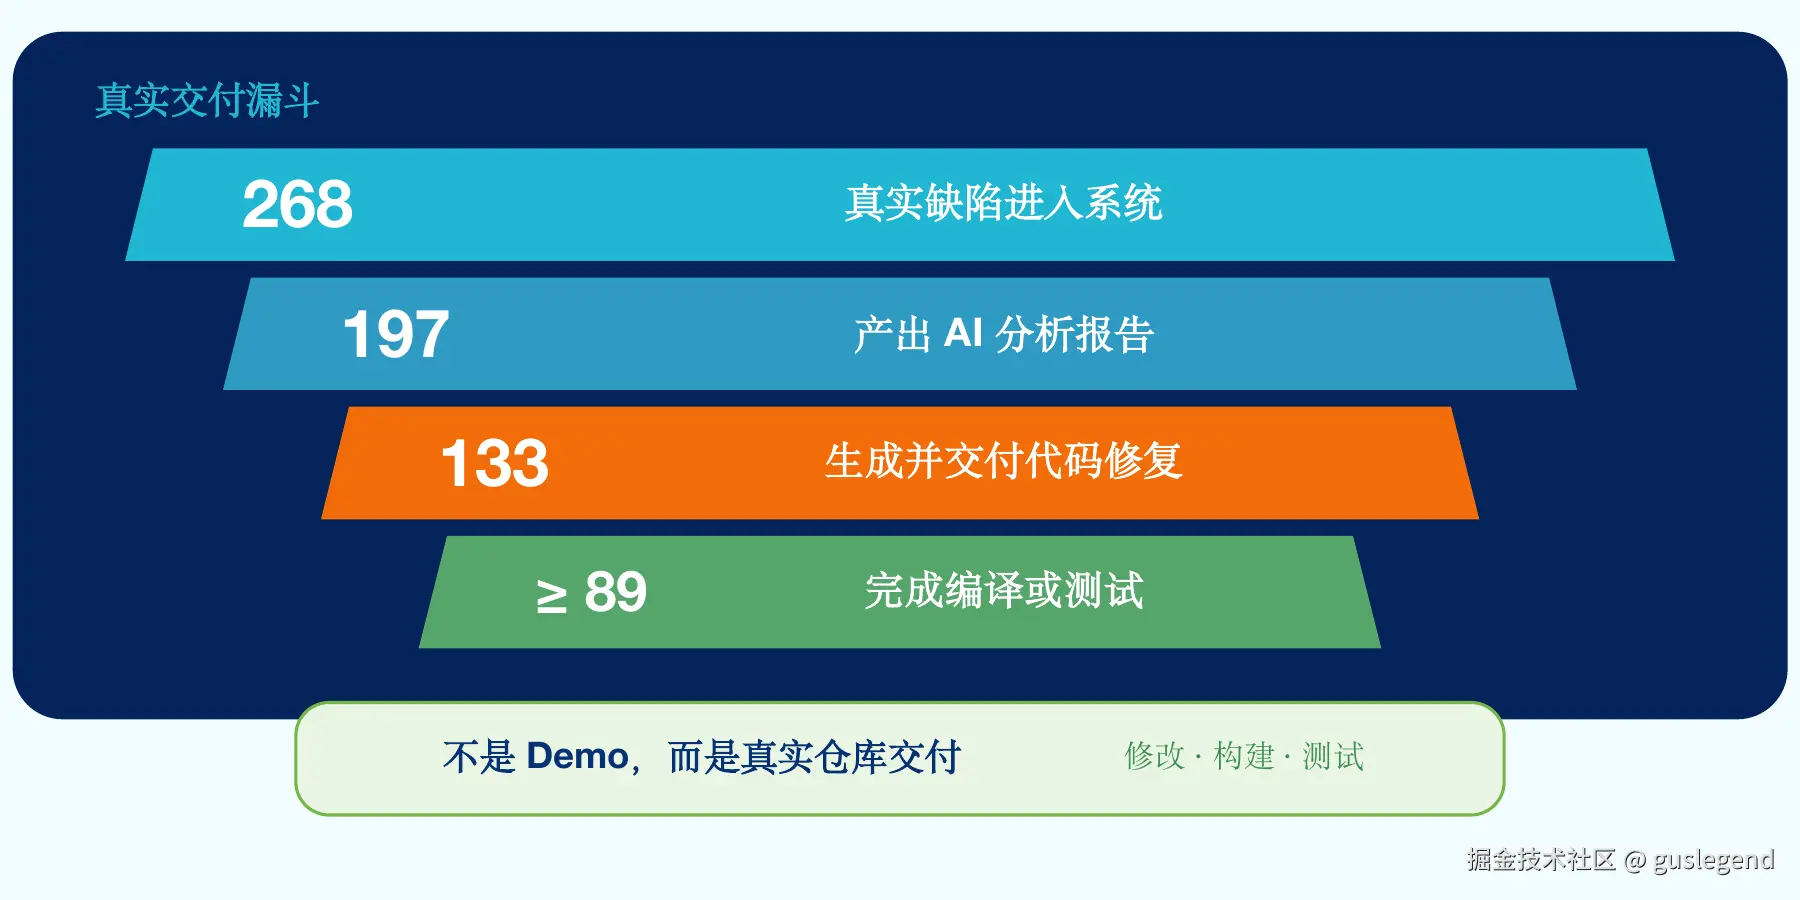
真实缺陷规模化交付:从 268 个缺陷进入系统到 89 个以上完成验证
真实交付漏斗体现了 AutoDebug 从分析到交付的实际落地情况:
| 阶段 | 数量 | 含义 |
|---|---|---|
| 真实缺陷进入系统 | 268 | 真实缺陷被纳入系统处理 |
| 产出 AI 分析报告 | 197 | 系统完成缺陷分析并生成报告 |
| 生成并交付代码修复 | 133 | 形成可交付的代码修复结果 |
| 完成编译或测试 | ≥ 89 | 修复结果至少完成编译或测试验证 |
这不是 Demo,而是真实仓库交付,过程覆盖修改、构建和测试。
准确率与替代就绪度:92.5% 不等于 81.3%
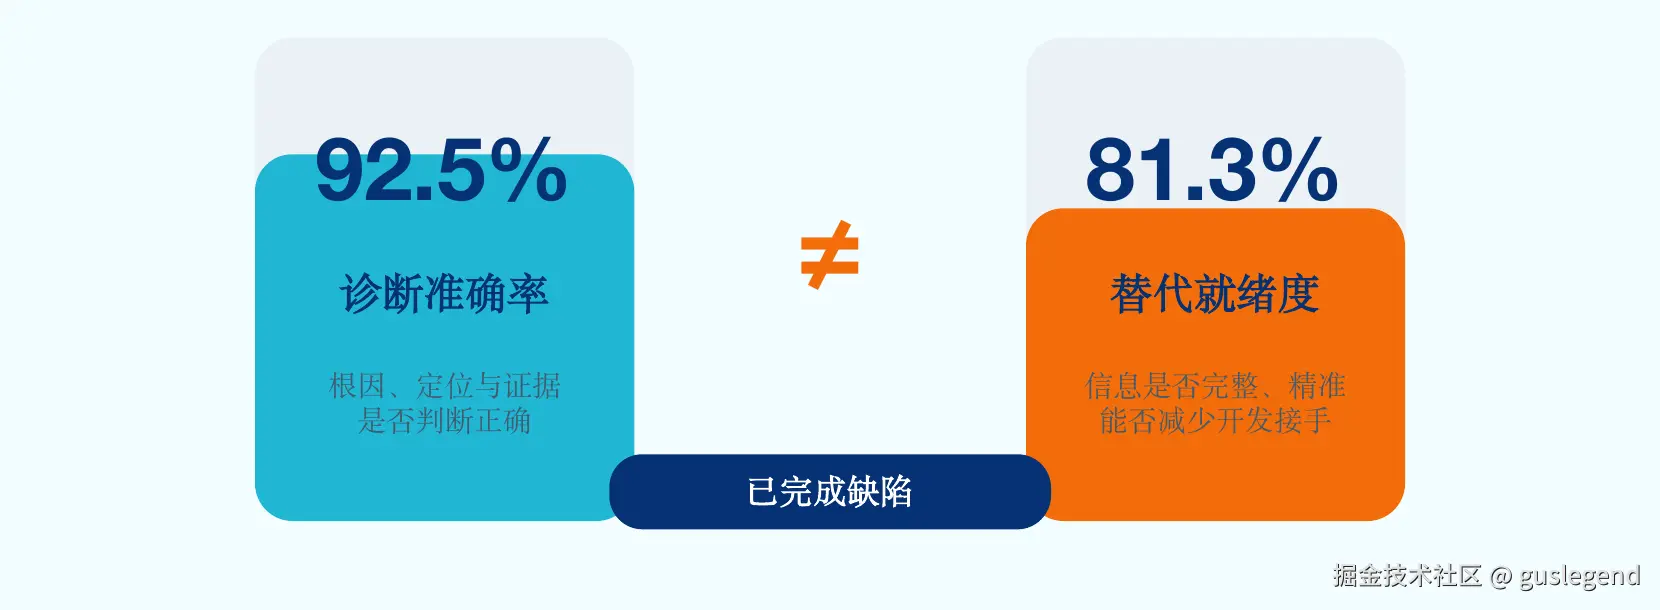
已完成缺陷中,诊断准确率为 92.5%,替代就绪度为 81.3%。
| 指标 | 数值 | 关注点 | 判断含义 |
|---|---|---|---|
| 诊断准确率 | 92.5% | 根因、定位与证据是否判断正确 | 是否看对问题 |
| 替代就绪度 | 81.3% | 信息是否完整、精准 | 能否减少开发接手 |
看对问题,不等于已经准备好替代人工。替代就绪度更接近工程交付视角,因为它关心开发接手成本是否真的下降。
Replay 规模化验证:436 次重放让改进可比较
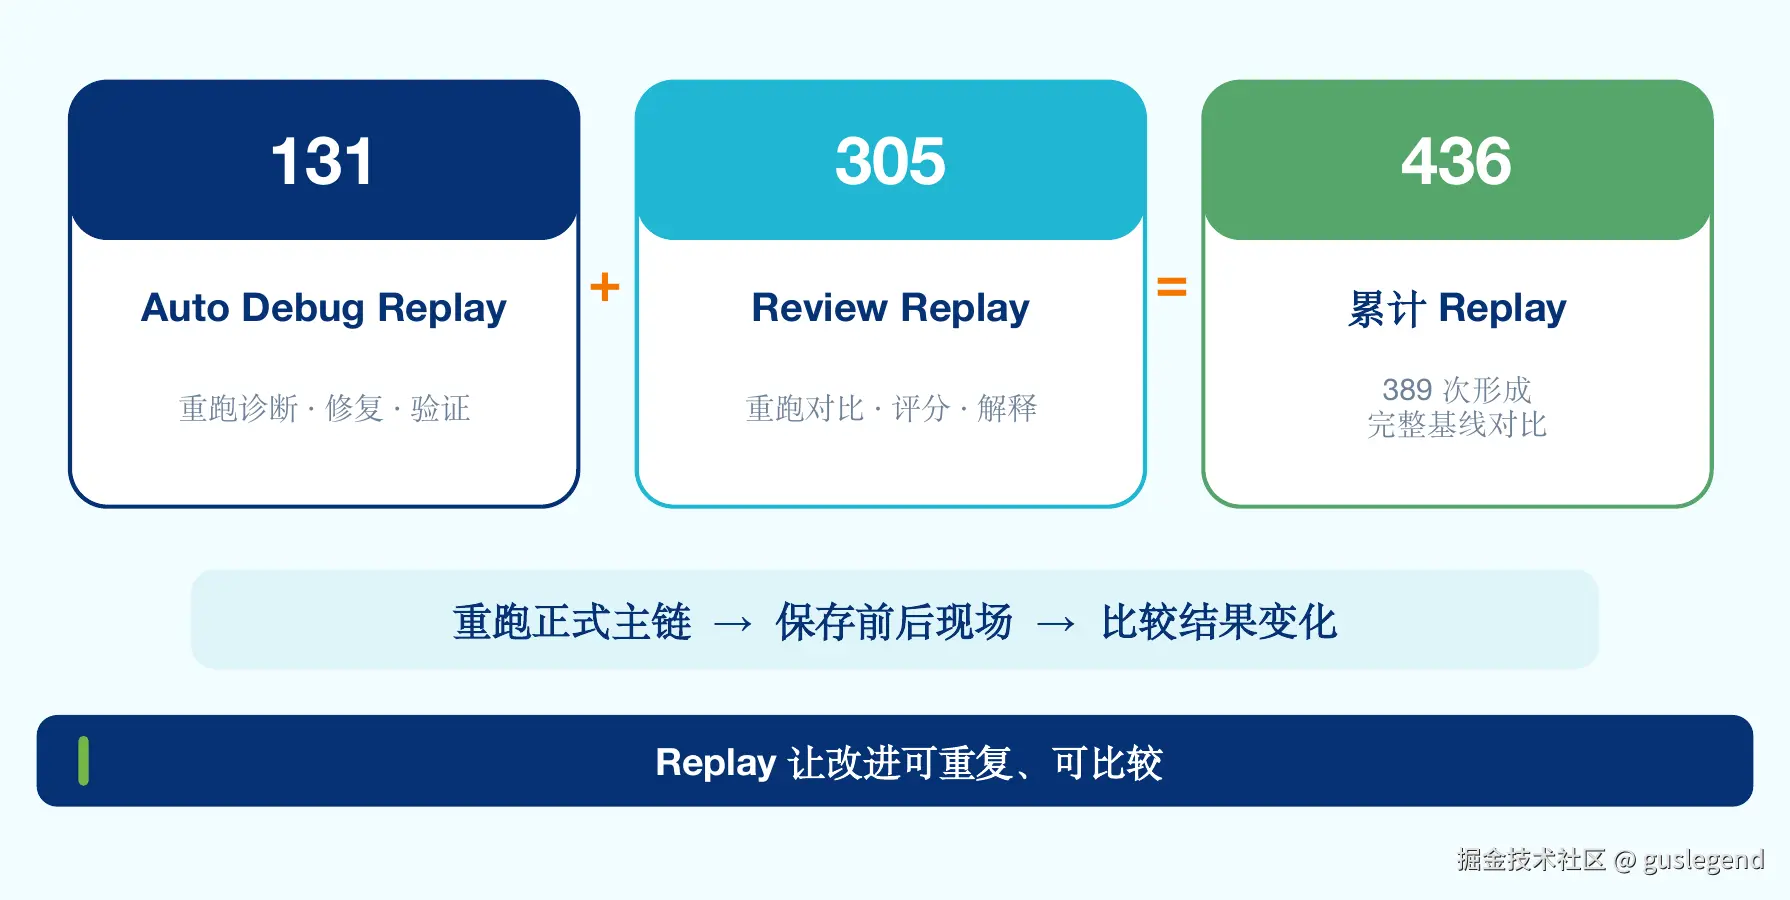
Replay 用于规模化验证,让改进可重复、可比较。
| Replay 类型 | 数量 | 内容 |
|---|---|---|
| Auto Debug Replay | 131 | 重跑诊断、修复、验证 |
| Review Replay | 305 | 重跑对比、评分、解释 |
| 累计 Replay | 436 | 其中 389 次形成完整基线对比 |
验证流程是重跑正式主链,保存前后现场,再比较结果变化。
瓶颈向上游迁移:真实失败会推动边界外移
当系统内部链路逐步稳定后,瓶颈会自然迁移到系统之外。真实失败会推动边界外移,从手工触发逐步迁移到上游输入质量。
| 阶段 | 主要瓶颈 | 解决方向 |
|---|---|---|
Skill → 系统 |
手工触发不可持续 | 动作脚本化 |
报告 → Git |
开发仍承担结果 | 真实分支与 commit |
Workflow → Loop |
跑通不等于改对 | 观察后重规划 |
内部 → 上游 |
输入成为主瓶颈 | 缺陷提交 Skill |
报告不等于真实改动,Workflow 跑通也不代表改对。当内部链路成熟后,输入质量会成为主瓶颈,缺陷提交本身也需要被 Skill 化。
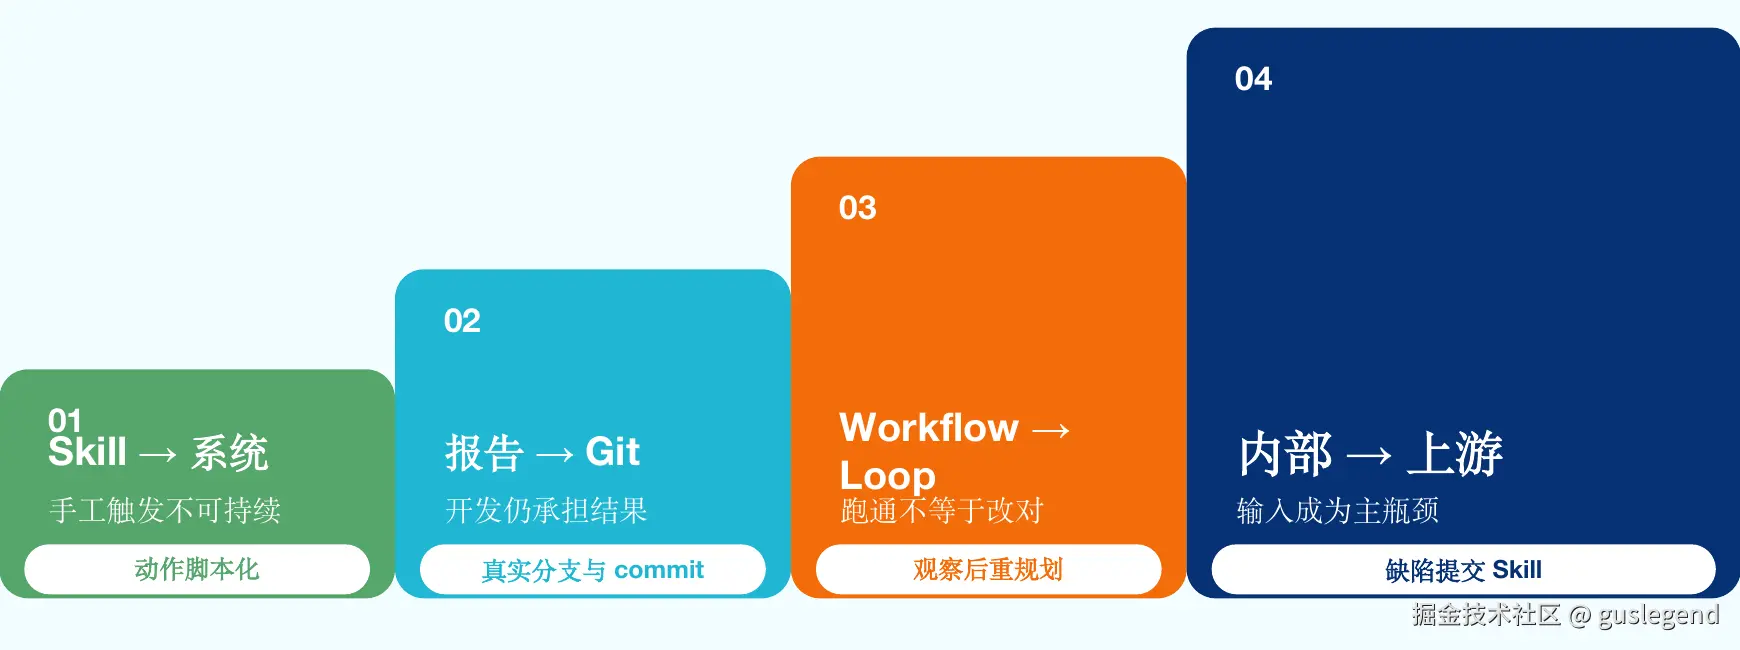
Agent 工程化迭代方法
单兵小步快走:用最短反馈环推动 Agent 成长
单兵推进 AutoDebug 的核心,不是一次把系统想完,而是让每一轮最小改动都尽快遇到真实反馈。这套方法强调本地优先、先定边界、先写验收标准、小步闭环、抓住真实数据窗口,以及用高质量反馈校准 AI 的执行方向。
本地优先是为了让反馈尽快发生。每轮改动在独立 worktree 中进行,修改后立即验证、Replay、Compare。如果结果符合预期,保留本轮结果;如果不符合预期,带失败证据重新修改。链路稳定后,再搬到云端。
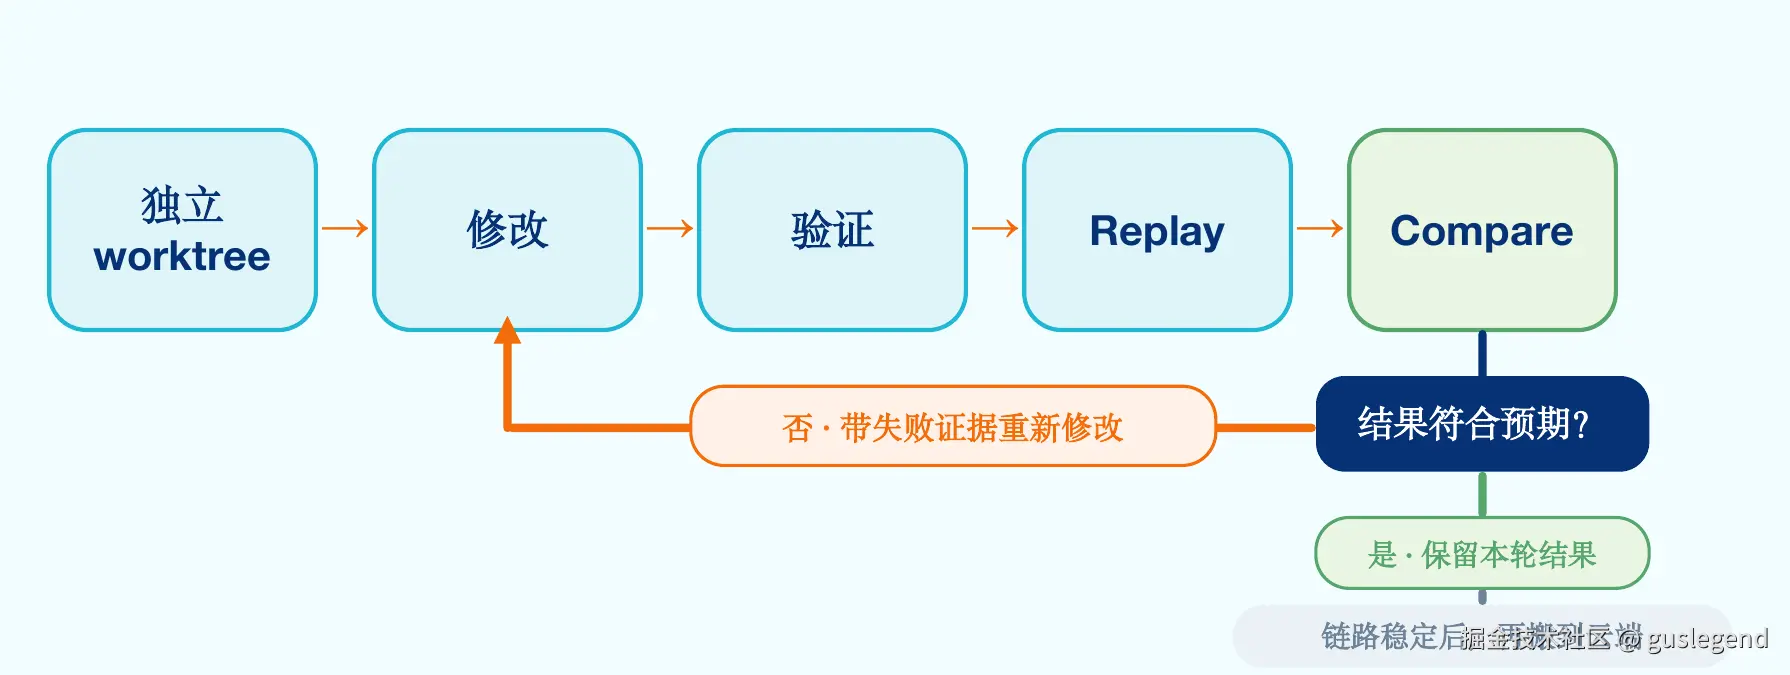
| 维度 | 做法 | 目的 |
|---|---|---|
| 执行位置 | 本地优先 | 快速获得反馈 |
| 工作方式 | 独立 worktree |
隔离每轮改动 |
| 反馈节奏 | 当天进入下一轮 | 缩短迭代周期 |
| 上云时机 | 链路稳定后再搬到云端 | 避免过早放大不稳定问题 |
先定边界,再让 Agent 开工
Agent 开工前要先把任务边界和判真方式写清楚,否则它容易在模糊目标下自行扩散。
| 阶段 | 作用 | 关键内容 |
|---|---|---|
| Trellis | 问题结构化 | 把问题拆清楚,明确要解决什么 |
| 讨论 | 对齐整体方案 | 对齐方案方向,减少理解偏差 |
| Grill | 挑战关键细节 | 提前拷问风险点和模糊点 |
| 验收标准 | 样本、边界、上限 | 明确怎么判真、测试样本、边界条件、重跑限制 |
/goal + /tdd |
带着清晰合同开工 | 用目标和测试驱动 Agent 执行 |
开工前必须回答三个问题:改什么、如何判真、最多重跑几次。
边界不清时,Agent 容易把任务做宽;判真方式不清时,Agent 很难判断自己是否完成;重跑次数不清时,容易陷入无效 Replay。
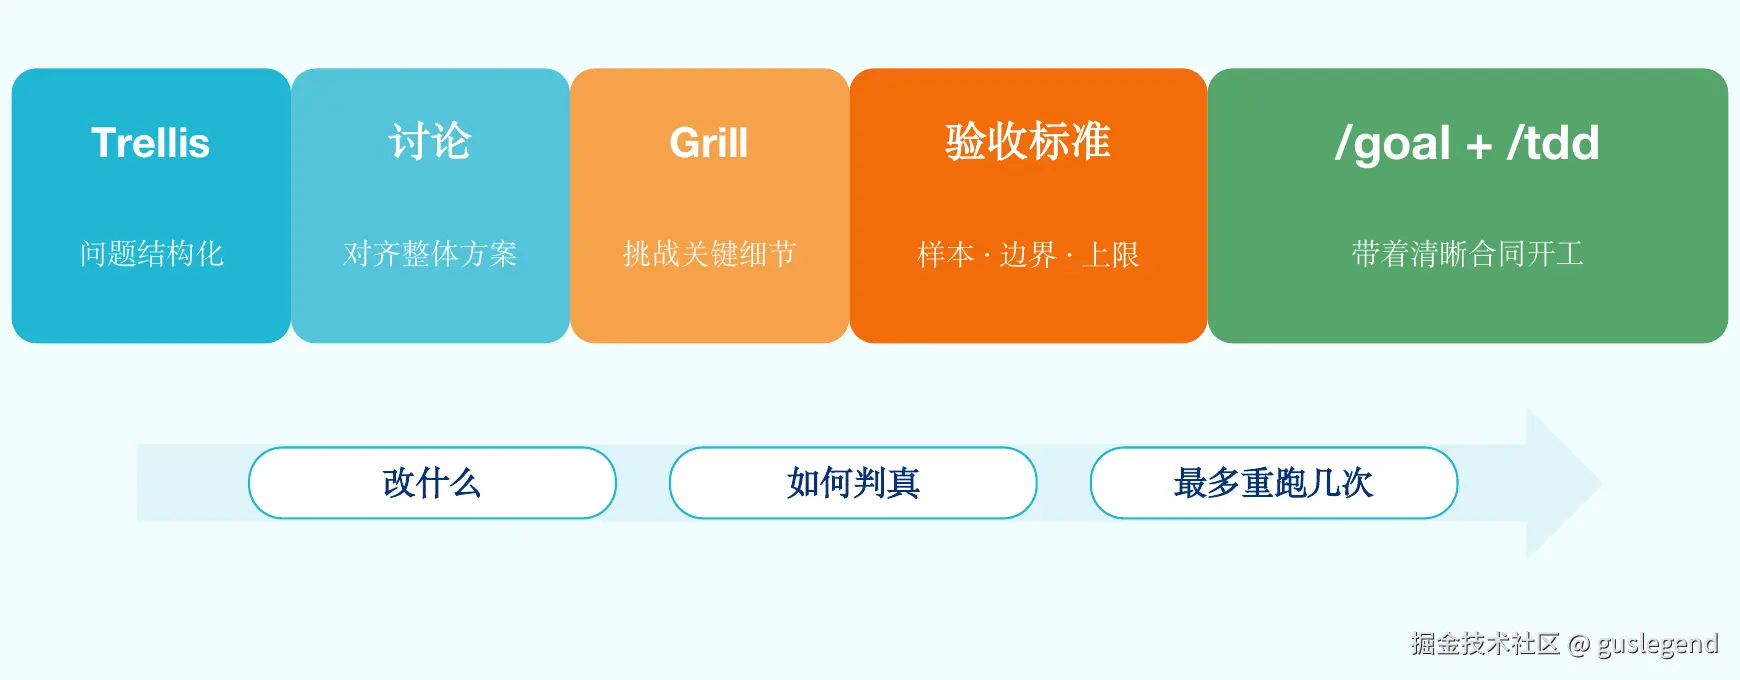
验收标准早于实现:可验证的 Done 才是真完成
先写 Done,再开始实现,可以避免 Agent 把"做过"误当成"完成"。
text
目标结果 + 样本设计 + 停止条件 = 可验证的 Done| 组成部分 | 要回答的问题 | 具体内容 |
|---|---|---|
| 目标结果 | 最终要改善什么 | 明确目标产出,以及哪些证据算完成 |
| 样本设计 | 如何保证可比较 | 设计正向样本、负向样本、边界样本 |
| 停止条件 | 什么情况交给人工 | 设置 Replay 上限,规定停止和人工介入条件 |
Done 必须可验证,不能只靠 Agent 自述"已经做过"。
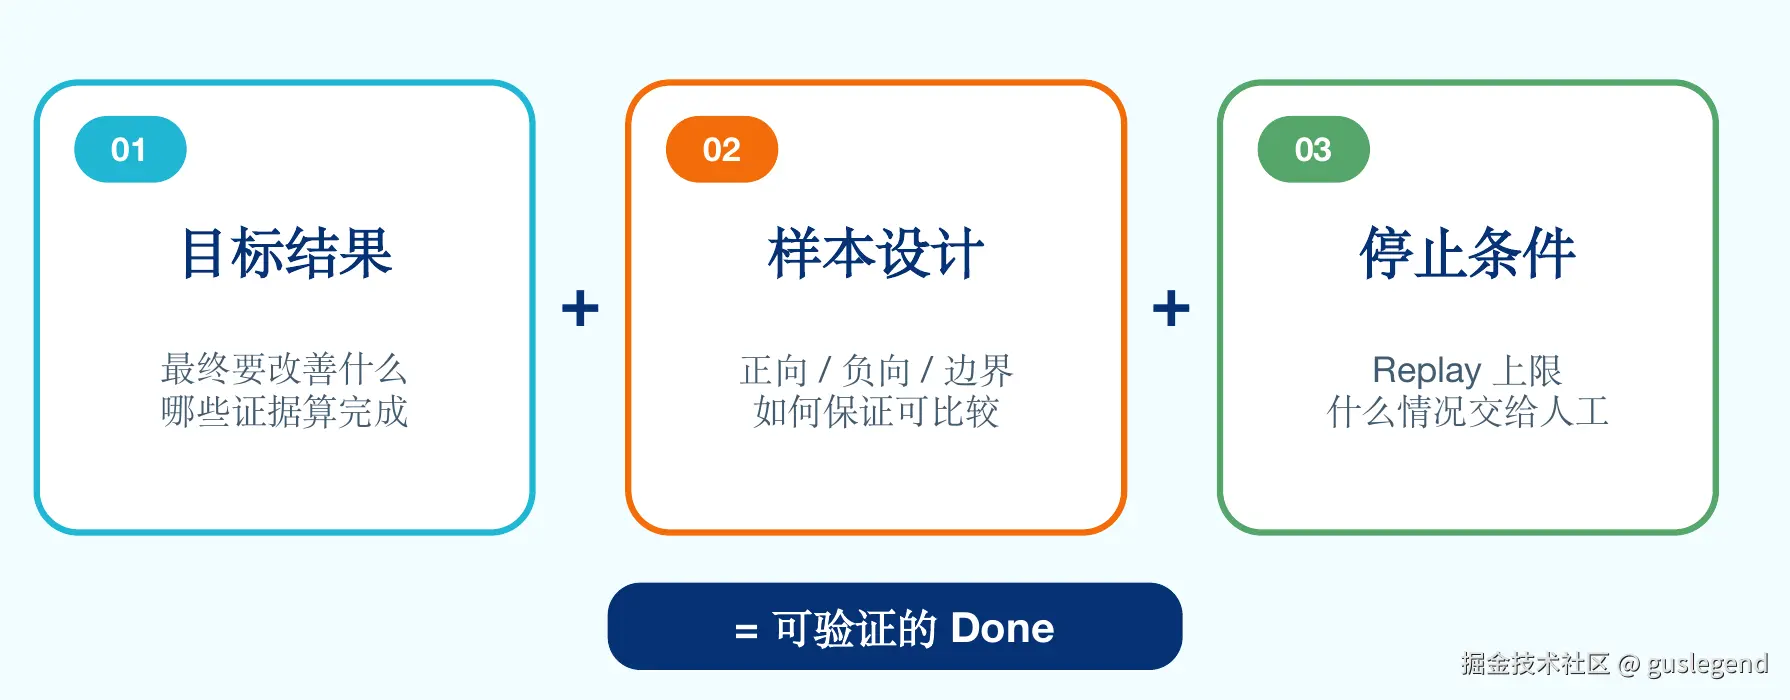
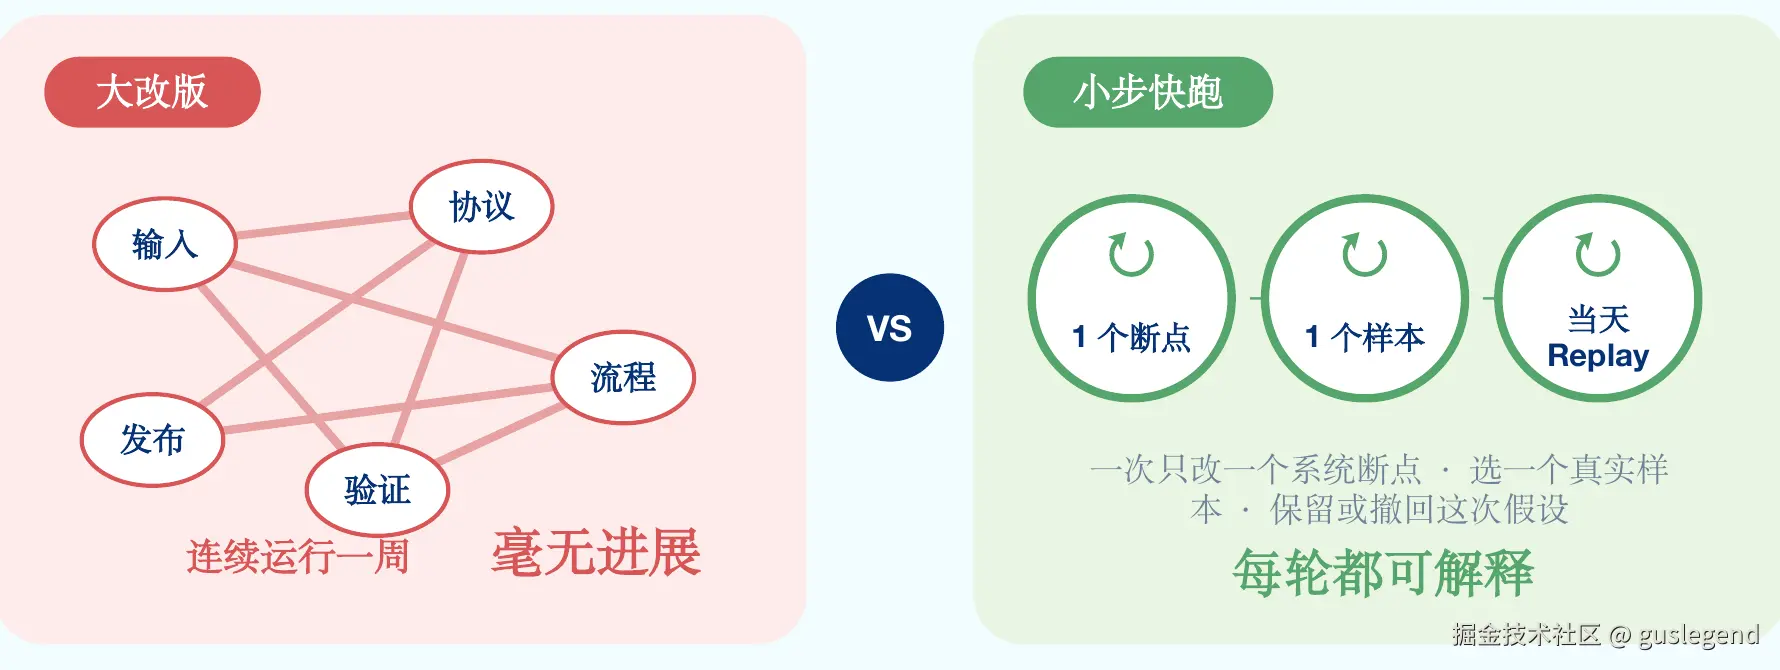
小步闭环胜过大改:一次只改一个系统断点
小步快跑优于一次性大改版。最小改动的价值,是让因果关系仍然可见。
| 维度 | 大改版 | 小步快跑 |
|---|---|---|
| 改动方式 | 多个环节一起改 | 一次只改一个系统断点 |
| 观察难度 | 因果关系混在一起 | 因果关系更清楚 |
| 运行结果 | 连续运行一周仍可能毫无进展 | 每轮都可解释 |
| 处理方式 | 输入、协议、流程、发布、验证互相牵连 | 选一个真实样本,保留或撤回假设 |
| Replay | 没有明确小闭环 | 当天 Replay |
每轮都要能解释:改了什么,为什么有效或无效,是否保留。
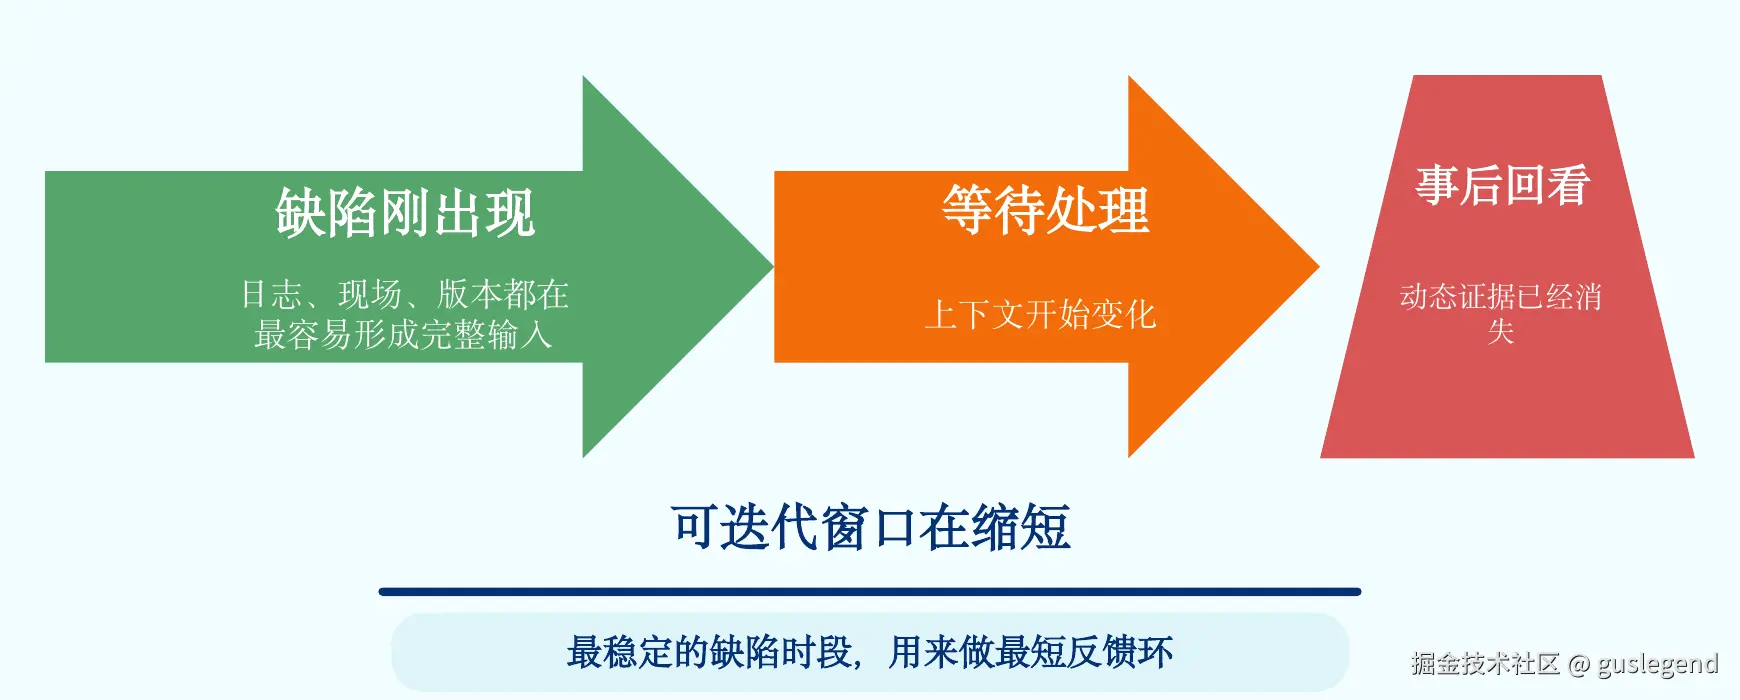
抓住真实数据窗口:动态证据会过期
缺陷刚出现时,日志、现场、版本都在,是最稳定、最容易还原问题的时间段。这个时间段适合建立最短反馈环。
| 阶段 | 状态 | 证据价值 | 风险 |
|---|---|---|---|
| 缺陷刚出现 | 日志、现场、版本都在 | 最容易形成完整输入 | 应立即抓取真实数据 |
| 等待处理 | 上下文开始变化 | 证据开始变弱 | 可迭代窗口在缩短 |
| 事后回看 | 动态证据已经消失 | 难以还原真实现场 | 只能依赖残缺信息判断 |
不要等到问题过去后再回看。越早抓住真实数据,越容易形成完整输入。
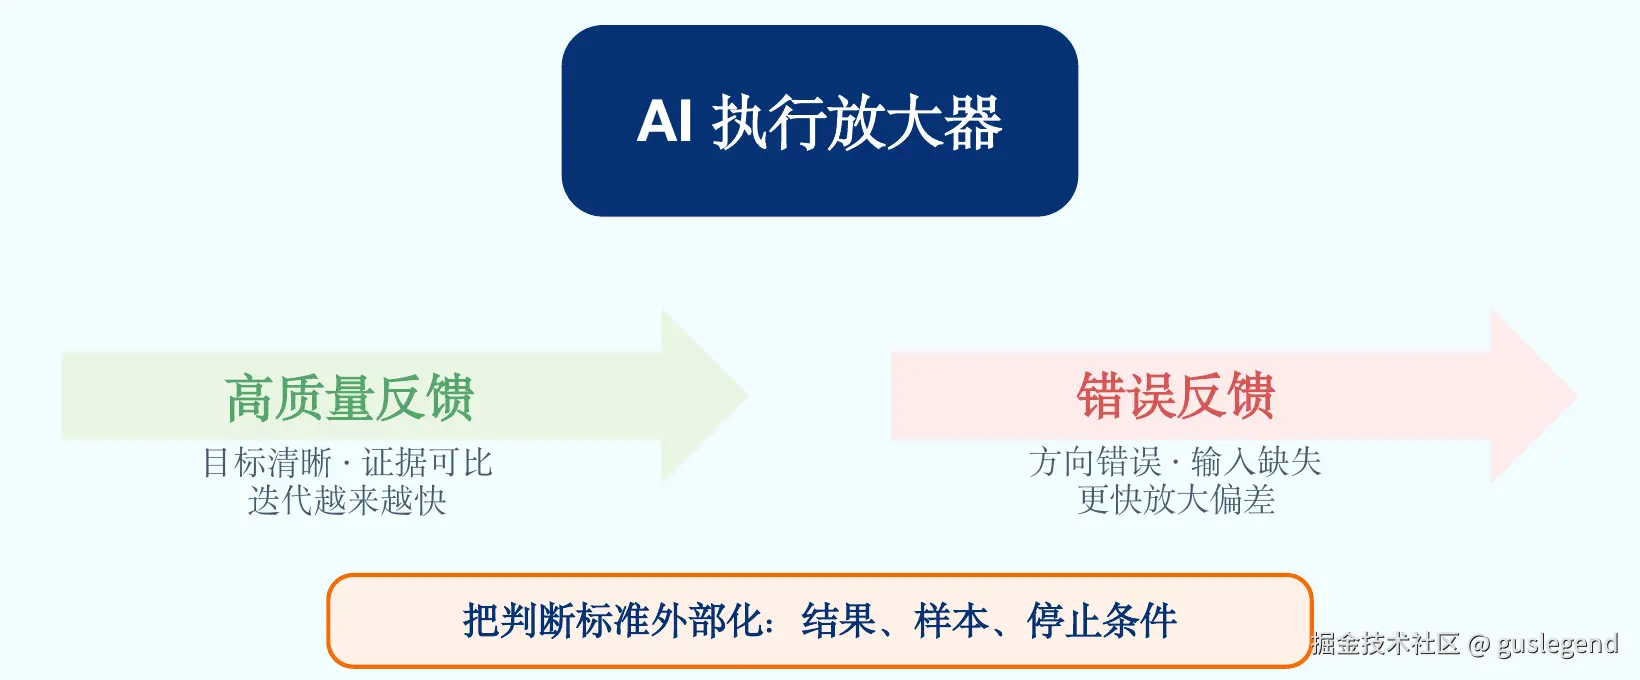
AI 放大执行力,也放大错误方向
AI 是执行放大器。它可以放大执行力,也会放大错误方向。AI 只负责把执行变快,方向必须由真实反馈持续校准。
| 反馈类型 | 前提条件 | 结果 | 影响 |
|---|---|---|---|
| 高质量反馈 | 目标清晰、证据可比 | 迭代越来越快 | 执行效率被正向放大 |
| 错误反馈 | 方向错误、输入缺失 | 更快放大偏差 | 错误方向被加速推进 |
判断标准要外部化,至少包括结果、样本和停止条件。不要只追求 AI 执行速度,先保证反馈方向正确,再让 AI 放大执行。
真实反馈的核心价值
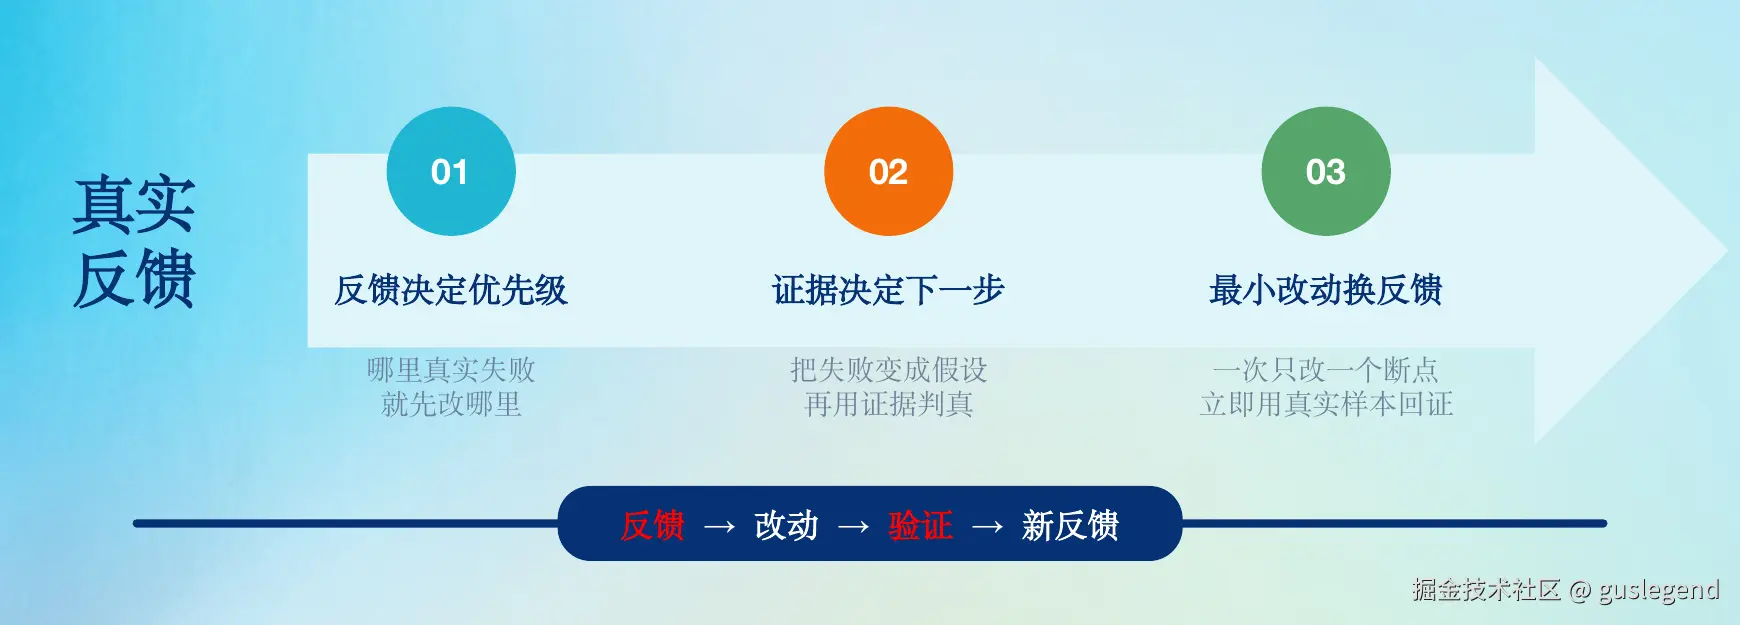
AutoDebug Agent 的核心经验可以浓缩为一句话:真实反馈决定优先级,证据决定下一步,最小改动换取新的反馈。
单兵迭代不是一次性大改,而是每次只围绕一个真实失败点行动。把失败变成假设,再用证据判真;一次只改一个断点,立即用真实样本回证。持续缩短"反馈 → 改动 → 验证 → 新反馈"的周期,才是 AutoDebug Agent 从能分析走向能交付的关键。