这个AI一行代码都不会写,却让14万程序员上头:Jev保姆级实战(附API代码)
你有没有经历过这种绝望------
你只想让大模型判断一封邮件"急不急",回个"是"或"否"就完事了。结果它沉吟片刻,洋洋洒洒输出三百字小作文:"尊敬的用户,经过我深思熟虑,从邮件措辞、语气、时间戳以及情绪倾向等多个维度综合分析,我认为......"
等它说完,黄花菜都凉了,token 账单还挺感人。更要命的是,你还得写正则、写解析,从这三百字里把"是"或"否"抠出来,代码才能继续跑。
9 月中旬,一个"叛逆"模型把这套流程掀了:它不聊天、不写代码、不写文案,主打一个闭嘴干活,上线 36 小时就有 14 万开发者蜂拥而入。
它就是 Jev。这篇文章带你从"它是谁"一路打到"API 怎么调",该泼的冷水也一并泼了。建议先收藏,周末慢慢搓。
一、Jev 是何方神圣?
先上户口本:
-
2026 年 9 月 15 日,旧金山公司 TypeSafe AI 发布 Jev,开放早期内测;
-
创始人 Diogo Almeida 在 OpenAI 待了四年,是 RLHF、InstructGPT、ChatGPT、GPT-4 的核心参与者,GPT-4 贡献者名单里他挂在"基础 RLHF 与 InstructGPT 工作"那一栏;
-
公司隐身研发两年,露面就带着 DCVC 领投的 4000 万美元种子轮(约 2.8 亿人民币),据 Forbes 报道这一轮估值约 2 亿美元(约 14 亿人民币);
-
Jev 被定位为 TypeSafe 的第一个 System One Model,口号相当拽:"Decisions, not strings"------要决策,不要文本;
-
名字 Jev 取自 19 世纪经济学家杰文斯(Jevons),暗合著名的"杰文斯悖论"。
再看战绩,相当离谱:
-
36 小时内 14 万开发者涌入内测,官方接口直接被挤到无法调用;
-
上线 24 小时就拿下 Vercel AI Gateway 近 13% 的付费团队,成为该平台史上采用最快的新模型;
-
Vercel、Cloudflare、LangChain 几天内全部完成集成;
-
9 月 21 日公司干脆撤掉候补名单全面开放,注册即送 5 美元额度,折合约 1.2 亿 token;
-
Almeida 称日调用量已超过万亿 token,连深夜都在持续跑------这说明是程序在后台无人值守地用,而不是人类点两下尝个鲜。
二、为什么它能这么快、这么便宜?
得先搞清楚传统大模型慢在哪。GPT、Claude 都是自回归模型:一个 token 接一个 token 往外蹦,前一个 token 没算完,后一个就没法开始,整条解码链是串行的。哪怕你只要一个"是"字,它也得把完整流程跑完。
Jev 的思路,官方文档、开源复现和社区实验三方口径基本一致,就四步:
-
答案空间在调用前就枚举好------你给的选项、档位或是非题;
-
不生成任何文本,而是把每个候选答案拿去"打分",读取模型对这段候选文本的概率;
-
所有候选在一次前向计算里并行打分,互不等待;
-
归一化后概率最高的就是答案。
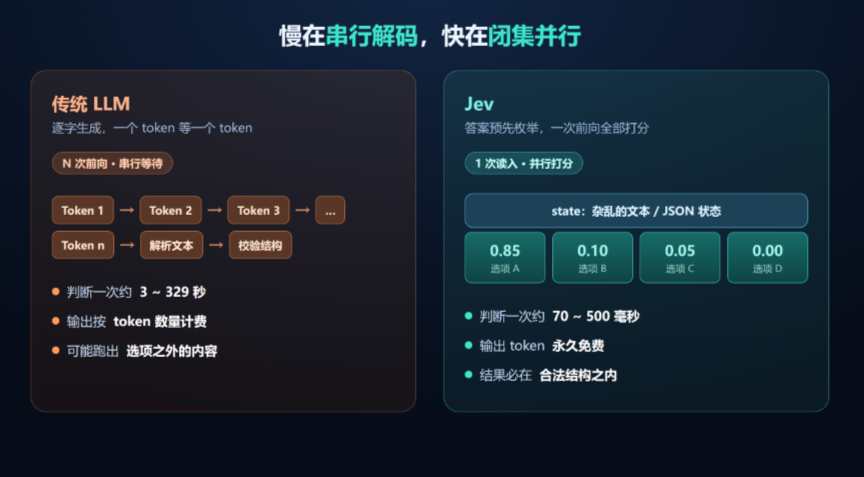
一句话总结:它省掉的不是"模型大小",而是"解码步数"。
训练侧还有个新方法叫 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习):模型说 0.9,现实中就得有约九成命中率,奖励的是"概率和实际命中率咬合"。这和 RLHF(奖励人类看着爽)、RLVR(奖励可验证正确性)是三个不同的靶子。
小提示:2023 年有篇同名缩写 RLCD 的论文(对比蒸馏方向),和这个完全不是一回事,写引用时别撞车。
至于底层架构,官方至今没公开论文和权重。社区逆向更倾向于"双向编码器 + 并行标签头",TypeSafe 的 GitHub 组织还 fork 过扩散语言模型 LLaDA 的仓库,被当成技术谱系线索------但这些都还是推测,不是实锤。
三、它只会做三种题:Choice、Score、Noul
| 类型 | 用来干啥 | 返回内容 |
|---|---|---|
| Choice | 从最多 255 个选项里选一个 | choice、probabilities、confidence |
| Score | 在 2-10 个有序档位上评分 | 连续 score、probabilities、confidence |
| Noul | 是非判断(bernoulli 的缩写) | 0-1 概率值,不带 confidence |
1. Choice:选择题
{
  "type": "choice",
  "instructions": "哪个团队应该处理这张工单?",
  "criteria": {
    "billing": "扣款、发票和退款",
    "technical": "故障、宕机和集成",
    "sales": "价格、升级和新账户",
    "other": "以上均不适用"
  }
}
返回里 probabilities 是完整概率分布,choice 是最高概率项,confidence 描述分布有多集中。如果选项不一定覆盖所有情况,记得主动加一个 "other"。
2. Score:评分题
{
  "type": "score",
  "instructions": "客户有多沮丧?",
  "criteria": [
    "平静,只是在陈述事实",
    "沮丧,但仍然礼貌",
    "非常愤怒,使用强烈措辞"
  ]
}
返回的 score 可能是 1.05 这种小数------它是各档位概率的加权结果,不一定是整数。
3. Noul:判断题
{
  "type": "noul",
  "instructions": "客户是否明确要求退款?"
}
返回一个 0-1 的值,比如 0.72,代表模型对"是"的概率判断。
更爽的是:多个问题共享同一份 state,独立并行评估。官方数据是 13 个问题合成一次调用,比拆成 13 次单独调用便宜 11.5 倍、快 9.6 倍,加问题几乎不增加延迟,只多一点输入 token。
四、API 实战:从注册到跑通
四步上手。
第 1 步:注册账号。 打开官方控制台 console.typesafe.ai 注册。注意:官方服务目前暂未向中国大陆地区开放,网络环境自行解决。
**第 2 步:创建 API Key。**在 console.typesafe.ai/keys 页面创建一个 key,妥善保存。
第 3 步:配置环境变量。
$env:TYPESAFE_API_KEY="你的API_KEY"export TYPESAFE_API_KEY="你的API_KEY"
第 4 步:发请求。 核心接口就一个:POST /v1/systemone。下面是可直接跑的 Python 版本:
import os
import requests

resp = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
    json={
        "model": "jev-latest",
        "state": "用户连续多次登录失败,来源 IP 与历史登录位置不同,并伴随大量失败请求",
        "questions": {
            "security_risk": {
                "type": "noul",
                "instructions": "这个请求是否存在明显的安全风险?"
            }
        }
    }
)
print(resp.json())
返回的是结构化 JSON(示例):
{
  "model": "jev-1.13.0",
  "answers": {
    "security_risk": {
      "type": "noul",
      "noul": 0.96
    }
  },
  "usage": { "input_tokens": 311, "output_tokens": 22 }
}
程序拿到 0.96 后,按阈值决定走向,整个过程不需要任何人读那段描述:
risk = resp.json()["answers"]["security_risk"]["noul"]

if risk >= 0.9:
    trigger_security_flow()   # 高风险,直接拉安全流程
elif risk >= 0.6:
    queue_for_review()        # 拿不准,进复核
else:
    log_and_ignore()          # 低风险,记录后放行
五、价格与规格一览
| 项目 | 数值 |
|---|---|
| 输入价格 | 0.042 美元 / 百万 token(即 42 美元 / 10 亿 token) |
| 输出价格 | 永久免费(官方原话:便宜到根本不值得计费) |
| 端到端延迟 | 70ms - 500ms |
| 上下文 | 单次请求 64K token,其中 state 加最长问题 32K |
| 速率 | 25 万 token/秒,1200 请求/分钟 |
| 输入类型 | 仅文本:字符串、JSON 对象或文本数组 |
有网友实测百万输入 token 只要 0.042 美分,赠送的 1.2 亿 token 根本造不完。这个定价被网友戏称为 AI 界的**"蜜雪冰城"**。
六、大家都在用它干啥?
模型够不够通用,看开发者给它整出的活就知道了:
-
打游戏:官方演示让 Jev 实时玩初代《毁灭战士》,每秒约 10 次决策控制走位、躲避和射击,连跑一小时算力成本约 7 美元;
-
维基寻路:在维基百科几千个超链里锁定目标页面,单次候选上限高达 255 个;
-
审 PR:一次调用约 7 万分之一美元,1000 个 PR 才花 7 美分;同样的活交给 Opus 5 要烧掉 14.5 美元;
-
语音助手:有人给 Mac 糊了个语音助手,"打开备忘录新建一条"话还没落音,App 已经秒开;
-
浏览器自动化:Browser Use 团队的开源项目 jev-ultrafast(MIT,12.1k star)把网页元素编号成选择题,Google 航班苏黎世飞伦敦全程 7.1 秒、花费 0.0039 美元,浏览器协议调用中位数从约 1092 次降到 101 次;
-
密集决策对比:实时通信公司 Ably 实测,几分钟内 Jev 做了 47 次决策,而 GPT、Claude、Gemini 只做了一两次;
-
国内场景:有中文开发者把卡牌游戏的决策换成 Jev,单次只要 0.7 秒,出牌动画还没播完,下一回合已经算完。
这些场景共同点很明确:决策要快、要密集,但每个决策本身都不算难。
七、国产平替与开源复刻
Jev 发布后最戏剧性的一幕,是它被"抄作业"的速度:
-
48 小时内 GitHub 上就冒出至少 6 个复刻项目;
-
Laya:基于 ModernBERT-large(421M)加 PPO,5 天拿下 1.8 万 star;
-
Kev:基于 Qwen3.5,与 TypeSafe 官方 SDK 完全兼容,业务代码不用改,换个请求地址就能切到本地;
-
Bespoke Nimble:Qwen3.5-9B 上做 LoRA,测试准确率 90.1%,接近 Jev 官方自报的 93.2%;
-
中国 APUS:9 月 19 日交出全球最早一批跨平台开源复现,封装成开箱即用的 Agent Skill「fast-browser-use」(MIT 协议)。它用本地 Qwen3.5-9B 复现了单 token logits 快速决策、KV-Cache 广播与并发批量评估;在一台 Apple M2 Pro 笔记本上,维基百科检索中位耗时约 18 秒、表单填报和站内导航约 3 秒,全程零云端调用、零 API 费用,数据不出本机,macOS / Linux / Windows 通吃,没 GPU 也能跑。
有意思的是,阿里通义千问在这波复刻潮里意外当了一回"万能底座"。不过复刻也有短板:面对任意提问加几十个长选项的场景,眼下还得是官方 Jev 更稳。
八、该泼的冷水:这些数字得打折看
先把最唬人的数字放一边。"快 193.6 倍、便宜 444.6 倍"来自官方自家 workflow 测试(Jev 0.114 秒 / 0.000081 美元,对比 LLM 8.566 秒 / 0.01388 美元),没有经过独立实验室验证,官方自己也标注这是偏乐观的上限。
-
第三方独立测试:Jev 的分类一致率和 DeepSeek V4.1 Flash 差不多,中位延迟 0.32 秒;
-
约 3100 名用户实测聚合:中位提速 7 倍、中位成本下降 30 倍、中位延迟 76 毫秒------比官方宣传低一个数量级,但反而更可信;
-
在 TypeSafe 自己的评测页上,Jev 综合得分 67.8% 排第四,前面是 GPT-5.6 Sol 的 74.1% 和 Claude Opus 5 的 73.1%;
-
Redis 作者 antirez 在 9 月 21 日公开开炮:Jev 或许有些狭窄应用场景,但围绕它的炒作,恰好说明 AI 泡沫里大多数人分不清什么重要、什么不重要。
当然也有给它撑腰的硬数据:
-
LangChain 用 5 道天气题、每题 100 次共 500 次判断、以人工打分为真值,Jev 的 500 次判断全部与人工一致(GPT-5.6 Terra 99.8%、GPT-5.6 Luna 96.4%、Claude Sonnet 4.6 80%),单例平均 0.44 秒、0.00035 美元,而 Claude 完成同一任务要 28.17 美元;
-
CMU 的 JEV-as-a-Judge 论文:在普通偏好和事实性任务上,它与最强 LLM 裁判差距不超过 3 个百分点,费用只有对方的 0.36%;RewardBench 92.2% 对 93.5%,HaluEval 87.5% 反超 86.7%。但需要检查推导过程的 JudgeBench 上落后 14.6 个百分点。
九、"零幻觉"的真相,以及那些坑
划重点:Jev 的"零幻觉"是格式保证 ,不是内容保证。
它在结构上不可能输出你选项之外的东西(这是构造性的 0% 类型错误),但照样能在你给的三个选项里选错。同理,confidence 衡量的是概率分布集不集中,不等于"这次回答的正确率被保证"。
坑清单也给你列好了:
-
不能写文本、不能解释理由------金融、医疗、法律这类要求可追溯推理链的场景直接出局;
-
暂不支持图像输入;
-
需要一步步推导的数学推理顶多 GPT-4 水平,步骤一多效果就往下掉;
-
非英语准确率参差不齐,而且对措辞敏感,官方承认它"按字面读指令",问题写得越绕,一致率越低;
-
闭源 API,数据要传到 TypeSafe 的服务器,对部分企业客户是道门槛;
-
还有先发权争议:开发者 Nandha Kishor M 称自己 2025 年 3 月就发过相关论文、模型和数据集。
十、正确姿势:级联,而不是替换
CMU 那篇论文给出了一个很实用的"冻结级联"策略:
-
高置信度的判断:直接采纳、自动执行;
-
不确定的判断:上抛给大模型或人工;
-
论文实测这套打法能保住最强裁判 99% 的准确率,成本却只有零头。
工程上再送四条铁律:
-
一个问题只问一个判断;多因素判断拆成多个原子问题,在代码里加权合成------以后调优先级,改的是系数而不是提示词;
-
阈值按风险分层:同一个系统里低风险动作 0.6 可放行,高风险动作建议 0.85 以上;
-
高风险动作永远不能绕过身份认证、权限检查、业务硬规则、用户确认和审计;
-
上线前用自己的标注集回放,分别测误放行、误拦截和人工队列占比,别直接抄官方示例阈值。
说白了,它和大模型是双核搭档:大模型在前面吭哧吭哧干活,Jev 在旁边花几十毫秒用概率给活打分,合格放行、不合格打回重写,而不是谁取代谁。
写在最后
Jev 最该被抄走的,不是那组"快 200 倍"的数字(水分确实不小),而是一个架构判断:
别再让按字数计费的生成模型,去干那些只需要一个枚举值的活。
当一次判断便宜到可以忽略,以前"算不过来账"的事忽然就划算了:过去系统只抽查 1% 的行为,判断足够便宜后就能 100% 全审;大公司囤积多年、因为调用太贵从没分析过的"暗数据",也终于翻得起了。这正是它名字里"杰文斯悖论"的野心------成本趋近于零,需求反而爆炸。
当然,48 小时被复刻 6 次也说明:模型架构从来不是护城河,校准质量、工具链和分发才是。
它会不会成为下一个时代的拐弯处,我不敢打包票。但作为开发者,现在用送的 5 美元额度(约 1.2 亿 token)亲手搓一搓,绝对不亏。
**互动时间:**你用 Jev 或它的平替跑过什么有意思的场景、踩过什么坑?欢迎评论区交流。觉得有用就点个赞、收个藏,关注我,下一篇安排 Jev 开源平替的本地部署保姆教程。