系列定位 :本文属于「RAG 七层框架」系列的第 3 层(L3 · 文档理解与解析)中篇,聚焦图片 / PPT / PDF 中的图文解析。上篇覆盖通用文本与结构化文本,下篇将覆盖表格与数据库导入。
本文目标读者 :正在搭建 RAG 系统的工程师,尤其是手上有大量扫描件、图片、PPT、PDF,需要把它们转成「可检索、可理解」的结构化内容的落地场景。
一、先说结论:图文与 PDF 是 RAG 导入的「硬骨头」
上篇我们说「导入是 RAG 的第一道分水岭」。但同样是导入,文本和图文是两种难度:
- 文本(txt / JSON / Markdown / 网页):文字就在那里,Loader 只要「读出来」就行。
- 图文 (图片 / PPT / 扫描 PDF):文字被「锁」在像素里,Loader 必须先「认出字」才能「读出字」。
这就是为什么图文解析是整个 L3 层最「重」、最「贵」、也最考验选型功力的部分。本文要讲透三件事:
- 图片和 PPT 怎么解析 ------从
UnstructuredImageLoader到多模态大模型。 - PDF 的九种工具怎么选 ------从
PyPDF到LlamaParser,再到 2026 年的 Docling / MinerU / Marker。 - 解析方法的三条路线------规则、深度学习、多模态大模型,以及它们各自的成本和适用边界。
先给出本文的核心判断,后面逐一展开:
图文解析的本质,是「把像素里的信息搬回文本世界」。搬得越好,后续分块和检索的精度上限越高;但搬得越好,成本也越高。选型的本质,是在「精度」和「成本」之间找平衡点。
二、图片解析:从 OCR 到视觉理解
2.1 最朴素的起点:UnstructuredImageLoader
读图片我一开始用的是 UnstructuredImageLoader,它背后调用的是 Unstructured 的图片分区引擎,能识别出图片里的文字块,并保留一定的结构信息:
python
from langchain_community.document_loaders import UnstructuredImageLoader

image_path = "data/法律/法条扫描件.jpg"
loader = UnstructuredImageLoader(image_path)
data = loader.load()
print(data)
它能做什么 :把一张图片里的文字提取出来,转成 Document 对象,并带上 source 等元数据。
它做不到什么 :它本质上是OCR(光学字符识别) ,只能「认出字」,不理解图片里的内容。如果图片是一张复杂的流程图、一张数据图表、一张手写批注,它只能给你一堆碎片化的文字,丢失了「图」本身的结构和语义。
2.2 传统 OCR 的边界:Tesseract vs PaddleOCR
在深入多模态之前,先厘清传统 OCR 的边界。这是 2026 年依然成立的经典二分:
| 工具 | 定位 | 优势 | 局限 |
|---|---|---|---|
| Tesseract | 老牌开源 OCR(Apache 2.0) | 历史悠久、生态成熟、轻量 | 中文/复杂版式弱,表格和公式基本无能为力 |
| PaddleOCR | 开源 OCR 工具集 | 中文/日文/韩文强,含表格识别、版面分析、公式识别模块 | 相对重,需要装 PaddlePaddle |
关键判断 :如果你的图片以中文为主 ,PaddleOCR 明显优于 Tesseract。但两者都有同一个天花板------它们只能「识别文字」,不能「理解文档」。遇到一张带标题、表格、图表、注释的复杂图片,传统 OCR 会把这些信息全部压平成一坨文字,结构信息丢失殆尽。
2.3 真正的解法:多模态大模型「看懂」图片
这就是为什么 2026 年的图文解析,重心已经从「OCR」转移到了「视觉理解 」。多模态大模型(GPT-4o、Qwen-VL、Claude、Gemini)不仅能 OCR,还能理解图表、表格、流程图、公式,直接输出结构化内容。
我在项目里用 gpt-4o-mini 解析过一张 PPT 幻灯片,核心代码如下:
python
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "请详细描述这张PPT幻灯片的内容,包括标题、正文和图片内容。"},
                {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{base64_image}"}},
            ],
        }
    ],
    max_tokens=300,
)
results.append(response.choices[0].message.content)
这段代码的精髓 :把图片转成 base64 后,以 image_url 的形式塞进多模态对话。模型能「看到」图片,然后输出一段结构化描述。
多模态解析的三种做法对比(这是 2026 年选型的核心):
| 做法 | 原理 | 适用场景 | 成本 |
|---|---|---|---|
| 传统 OCR(Tesseract / PaddleOCR) | 纯文字识别,不理解语义 | 纯文字图片、扫描件 | 低 |
| 布局 + OCR 组合(Docling / MinerU pipeline) | 先布局识别,再分区 OCR | 复杂版式、表格、公式 | 中 |
| 多模态 VLM 直接解析(GPT-4o / Qwen-VL) | 视觉语言模型端到端理解 | 图表、流程图、跨页表格、需语义理解的复杂文档 | 高 |
三、PPT 解析:结构保留是关键
PPT 和图片不同------它本身是「有结构的」。用 partition_ppt 来做,它能识别出 PPT 里的每个元素(标题、正文、图片、表格),而不是把整页压成一段文字:
python
from unstructured.partition.ppt import partition_ppt

ppt_elements = partition_ppt(filename="data/法律/司法解释培训.pptx")

# 逐个打印每个元素
for element in ppt_elements:
    print(element.text)

# 转成 Document 对象
from langchain_core.documents import Document

documents = [
    Document(page_content=element.text, metadata={"source": "data/法律/司法解释培训.pptx"})
    for element in ppt_elements
]
这里有一个非常关键的设计 :partition_ppt 返回的是元素列表 (ppt_elements),每个元素是 PPT 里的一个独立对象。这个粒度对 RAG 特别重要------因为它保留了 PPT 的结构边界,后续分块时可以按元素粒度切,而不是把一整页 PPT 揉成一段。
对比一下两种做法:
- 粗暴做法:把整页 PPT 的文字全部拼接成一段文本 → 丢失了「这是标题」「这是正文」「这是图片说明」的结构。
- 结构做法 :
partition_ppt逐个元素提取 → 每个元素是一个独立Document,保留结构边界。
对企业落地的启发 :PPT 是企业里最常见的「非文档型」知识载体(培训材料、方案汇报、产品介绍)。用 partition_ppt 保留结构,比用 OCR 硬读图片要干净得多。如果 PPT 是原生格式(.pptx),一定要用结构化解析;只有 PPT 被转成图片/PDF 后,才需要求助 OCR 或多模态。
四、PDF 解析:九种工具的完整选型指南
PDF 是 RAG 导入里最复杂、也最常见的格式。它难在两点:
- PDF 是「印刷品」不是「文档」------它保存的是「文字在页面上的位置」,而不是「文字的逻辑结构」。所以同一份 PDF,有的工具能读出标题层级,有的只能读出一坨文字。
- PDF 可能是「扫描件」------如果是扫描的 PDF,里面根本没有文字层,只有图片,必须走 OCR 或多模态。
九种常见 PDF 工具,我把它整理成一张完整的选型表,并补上每种的适用场景 和局限:
4.1 九种 PDF 工具选型总表
| 工具 | 类型 | 核心特点 | 适用场景 | 局限 |
|---|---|---|---|---|
PyPDF (pypdf) |
Package | 高效轻量,纯文本提取 | 简单 PDF(无复杂版式) | 不保留结构,乱序/双栏会读错 |
| PDFMiner | Package | 文本抽取,处理嵌入文字 | 需要精细控制文本抽取 | 速度慢,不处理扫描件 |
| PDFPlumber | Package | 丰富的 PDF 内容控制,擅长表格 | 需要精确提取表格、坐标 | 速度较慢 |
PyMuPDF (fitz) |
Package | 速度最快,支持渲染/转换 | 大批量、需要页面渲染 | 结构理解弱 |
| PyPDFium2 | Package | 高效解析,支持页面渲染转换 | 需要渲染 PDF 页面 | 中文/复杂版式一般 |
| PyPDFDirectory | Package | 批量加载目录中的 PDF | 一次处理多个 PDF | 基于 pypdf,继承其局限 |
| Unstructured | Package/API | 兼容多格式,保留版式和结构 | 复杂版式、需要结构 | 本地版需装依赖,API 版收费 |
| 云厂商 OCR 服务 | API | 云服务,大批量 OCR | 大批量扫描件 | 依赖云服务,成本高 |
| 公式专用 OCR 服务 | API | 专为数学公式设计 | 学术论文、公式密集 | 收费,需 API key |
一个重要的分类 :这九种工具可以按「是否保留结构」分成两类:
- 只提取文字:PyPDF、PDFMiner、PDFPlumber、PyMuPDF、PyPDFium2、PyPDFDirectory------它们给你「文字」,但不理解「结构」。
- 保留结构:Unstructured(版式/结构)、Amazon Textract(OCR)、MathPix(公式)------它们不仅读文字,还告诉你「这是标题」「这是表格」「这是公式」。
4.2 实战:用 PyPDFLoader 做最简单的文本提取
最基础的 PDF 读取可以用 PyPDFLoader:
python
from langchain_community.document_loaders import PyPDFLoader

file_path = "data/法律/法条解读.pdf"
loader = PyPDFLoader(file_path)
pages = loader.load()

print(f"加载了 {len(pages)} 页PDF文档")
for page in pages:
    print(page.page_content)
输出:
text
加载了 1 页PDF文档
本条解读了离婚冷静期的适用要点,并对比了新旧法条的差异。条文自婚姻登记机关收到离婚登记申请之日起三十日内适用。
注意 :PyPDFLoader 按页 切分,每页是一个 Document。这对简单 PDF 够用,但遇到双栏排版 、跨页表格 、复杂标题层级时,它会读乱------因为 pypdf 只是按页面坐标顺序提取文字,不理解「栏」和「段落」的逻辑。
4.3 进阶:用 Unstructured 保留版式和结构
这是从「读文字」到「读结构」的转折点:
python
file_path = "data/山西文旅/云冈石窟-en.pdf"

from langchain_unstructured import UnstructuredLoader

loader = UnstructuredLoader(
    file_path=file_path,
    strategy="hi_res",          # 高精度策略,保留版式
    partition_via_api=True,     # 通过 API 调用 Unstructured
    coordinates=True,           # 返回元素位置坐标
)

docs = []
for doc in loader.lazy_load():
docs.append(doc)这里有几个关键参数:
strategy="hi_res":高精度策略,Unstructured 会用布局模型识别标题、段落、表格、列表等结构,而不是简单按坐标切。这是「保留结构」的核心开关。partition_via_api=True:走 Unstructured 的托管 API,精度更高、不用本地装一堆依赖,但要收费。coordinates=True:返回每个元素的坐标。这对后续版面还原 、跨栏重组 、表格识别特别有用。
为什么 strategy="hi_res" 重要 :默认的 fast 策略只是按坐标切文字,而 hi_res 会用深度学习模型识别语义结构 。同样是读一份 PDF,fast 给你一坨文字,hi_res 给你「标题-段落-表格-列表」的层级结构。这就是 L3 层「结构保留」的关键。
4.4 用 Marker 把 PDF 转成 Markdown
Marker 把 PDF 直接转成 Markdown ------这比「提取文字」高了一个层次,因为它不仅保留结构,还输出标准化的 Markdown 格式 (标题用 #,列表用 -,表格用 |):
python
# Marker 的核心用法(示意)
from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict

converter = PdfConverter(artifact_dict=create_model_dict())
result = converter("data/山西文旅/云冈石窟.pdf")
markdown_text = result.markdown
Marker 的价值 :它不是简单提取文字,而是把 PDF 还原成一份「可编辑的 Markdown 文档」。这意味着:
- 标题层级被还原成
#/##/###。 - 表格被还原成 Markdown 表格。
- 列表被还原成
-/1.。
对企业落地的启发 :如果你需要把 PDF 转成可继续编辑、可重新排版 的内容(而不是只做检索),Marker 这类「PDF→Markdown」工具比「PDF→文字」工具强得多。转成 Markdown 后,还能直接喂给 L4 的 Markdown 分块器,保留结构信息。
4.5 LlamaParser:Normal Parser vs LlamaParser
LlamaParser(LlamaIndex 出品)代表了「普通解析器」之外的另一种思路,两者的区别如下。
核心区别:
| 维度 | Normal Parser | LlamaParser |
|---|---|---|
| 原理 | 基于规则/简单 ML 提取文字 | 基于深度学习 + 多模态,理解版面 |
| 输出 | 一坨文字 | 结构化文档(标题/表格/列表) |
| 表格 | 容易读乱 | 能识别表格结构 |
| 复杂版式 | 双栏/跨页会乱 | 能理解版面逻辑 |
关键判断 :LlamaParser 代表了「从规则到深度学习 」的演进。普通解析器靠「坐标规则」猜结构,LlamaParser 靠「深度学习模型」理解版面。遇到复杂版式(双栏、跨页表格、图文混排),LlamaParser 这类深度学习解析器明显更准。
五、三大类解析方法:规则、深度学习、多模态
PDF 解析方法可以分成三大类,这是理解整个图文解析的总纲。我把它展开成一张完整的对比表:
5.1 三大类方法总览
| 方法 | 原理 | 代表工具 | 精度 | 成本 | 适用场景 |
|---|---|---|---|---|---|
| 基于规则的解析 | 用启发式/坐标规则把文本框聚合成段落、列表、表格 | PyPDF、PDFMiner、pdfplumber | 低 | 低 | 简单排版 PDF |
| 基于深度学习的解析 | 用 ML 模型识别版面,把文本分类为段落/列表/表格,OCR 识别图像文字 | Unstructured (hi_res)、Marker、Docling、MinerU、LlamaParser | 高 | 中 | 复杂版式、表格、公式 |
| 基于多模态大模型的解析 | VLM 端到端「看」页面,理解并输出结构化内容 | GPT-4o、Qwen-VL、Claude、Gemini | 很高 | 高 | 图表、流程图、跨页表格、需语义理解 |
5.2 三大类分别能做什么
基于规则的解析的核心操作:
- 通过启发式方法或机器学习推理,将文本框聚合为行、段落或其他结构。
- 对图像运行 OCR,以检测其中的文本。
- 将文本分类为段落、列表、表格或其他结构。
- 将文本组织成表格的行和列,或以键值对的形式呈现。
基于深度学习的解析 更进一步:它用布局识别模型(如 DocLayout-YOLO)先找出「这一页有哪些区域」,再对每个区域分类(标题/正文/表格/图片/公式),最后分别处理。这是 Docling、Marker、MinerU 的核心思路。
基于多模态大模型的解析 是 2026 年的新趋势:它不再需要「先布局识别、再 OCR、再分类」这条流水线,而是一个 VLM 直接看页面图像,端到端输出结构化内容。这是后面要重点讲的「三巨头」格局的底层逻辑。
六、2026 年新格局:Docling / MinerU / Marker「三巨头」
本节是我在项目之外的独立调研。早期 PDF 解析方案还停留在 PyPDF、Unstructured、Marker、LlamaParser 这个经典组合。但到了 2026 年,文档解析领域已经形成了「三巨头」格局,这是你选型时绕不开的新变量。
6.1 为什么会有「三巨头」?
2026 年文档解析最大的变化,是**「布局识别 + OCR + 公式识别」这三层,正在被一个单一的视觉语言模型(VLM)取代**。
- 过去:你要拼装 DocLayout-YOLO(布局)+ PaddleOCR(文字)+ UniMERNet(公式)三套模型。
- 现在:一个 VLM 就能端到端输出结构化的 Markdown。
这个趋势催生了三个被广泛对比的开源方案:Docling 、MinerU 、Marker。
6.2 三巨头对比
| 引擎 | 出品方 | 协议 | 核心优势 | 局限 |
|---|---|---|---|---|
| Docling | 开源项目 | MIT(最宽松) | 输入覆盖最广(PDF/Word/PPT/HTML/EPUB/邮件),纯 CPU 友好,文档模型专为 RAG 设计,有活跃的 LangChain 集成 | 复杂公式弱于 MinerU,公开榜单较少 |
| MinerU | 开源项目 | 相对宽松 | 中文/日文/韩文复杂版式最强,公式转 LaTeX、合并单元格表格、高精度 OCR,pipeline(CPU)+ VLM(GPU)双路线 | 相对重,GPU 高精度路线成本高 |
| Marker | 开源项目(基于 VLM) | 有商业条款 | 把布局/OCR/公式都路由到单一 VLM(650M 参数),端到端简洁 | 依赖 GPU,中文/复杂版式不如 MinerU |
6.3 关键选型判断
这是本文最重要的独立结论之一,请记住:
-
中文文档 → 我倾向选 MinerU 。法律、政务、科研、中文企业文档这类中文复杂版式 场景,MinerU 在公式转 LaTeX、合并单元格表格、高精度 OCR 上的表现更稳。这对本文的法律条文检索平台场景尤其关键------法律条文里有大量的条款层级、书式、表格(如法条对照表),MinerU 能更好地保留这些结构。
-
类型杂、要 CPU 跑、追求宽松协议 → 我倾向选 Docling。如果你要处理多种格式(不只是 PDF),且要在 CPU 上跑、不想被协议束缚,Docling 的 MIT 协议和面向 RAG 设计的文档模型更省心。
-
有 GPU、追求端到端简洁 → 我倾向选 Marker 或 MinerU 的 VLM 路线。如果你有 GPU 资源,Marker 的单一 VLM 架构最简洁;或者用 MinerU 的 VLM 后端,在 GPU 上获得更高精度。
6.4 一个真实的架构趋势:从「流水线」到「单一 VLM」
这是理解 2026 年文档解析的钥匙:
scss
【传统流水线】
PDF → 布局识别(DocLayout-YOLO) → 分区OCR(PaddleOCR) → 公式识别(UniMERNet) → 组装Markdown
         ↑ 三套模型,需要分别调优,错误会累积

【2026 单一 VLM】
PDF → 页面图像 → 单一VLM(如轻量视觉语言模型) → 结构化Markdown
         ↑ 一个模型端到端,错误不累积
为什么这个趋势重要 :传统流水线里,布局识别错了,OCR 就跟着错;OCR 错了,公式识别也受影响------错误是逐层放大的 。而单一 VLM 是端到端的,一个模型从「看页面」到「输出结构」一气呵成,错误不累积。这就是为什么这三个开源方案都在往「单一 VLM」这个方向走。
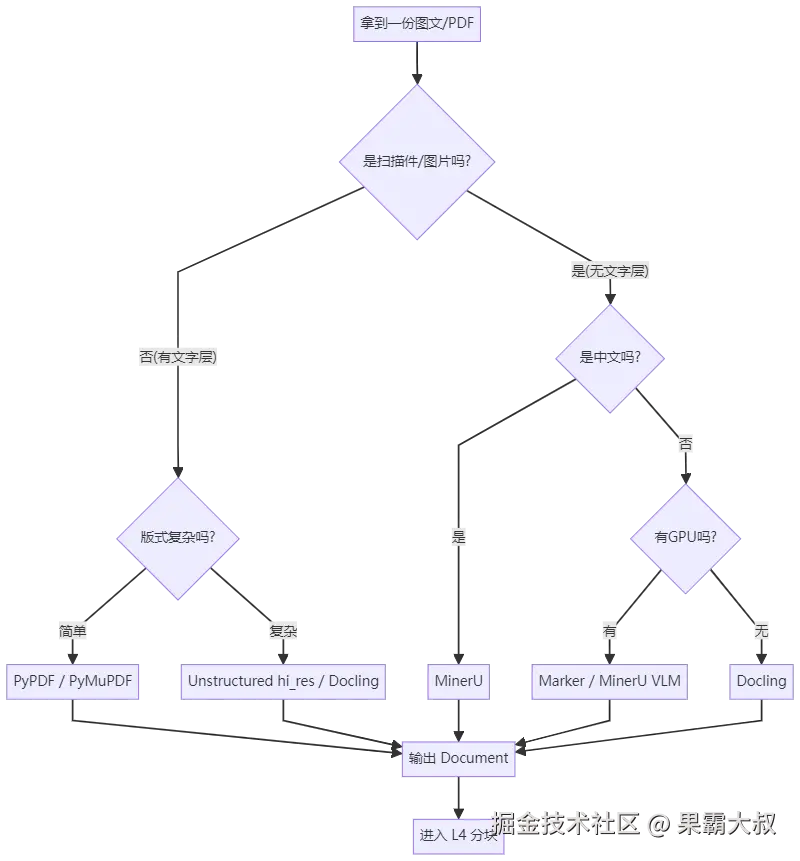
七、选型决策:一张图搞定图文/PDF 解析
7.1 速查选型表
| 你的输入 | 首选方案 | 备选 | 为什么 |
|---|---|---|---|
| 纯文字图片 | PaddleOCR / Tesseract | UnstructuredImageLoader | 便宜,纯文字无需语义理解 |
| 复杂图片(图表/流程图) | 多模态 VLM(GPT-4o / Qwen-VL) | Docling / MinerU | 需要语义理解,不只是 OCR |
| 原生 PPT (.pptx) | partition_ppt |
多模态 VLM | 保留结构,比 OCR 干净 |
| 简单 PDF(文字层) | PyPDFLoader / PyMuPDF | pdfplumber | 轻量,纯文本提取够用 |
| 复杂版式 PDF(双栏/跨页) | Unstructured (hi_res) | Docling / MinerU | 需要保留结构 |
| 扫描 PDF(无文字层) | MinerU / Docling / 多模态 VLM | PaddleOCR | 必须 OCR 或多模态 |
| 公式密集 PDF(论文) | 公式专用 OCR / MinerU | Marker | 公式转 LaTeX 精度 |
| 中文复杂版式 PDF | MinerU | Docling | 中文复杂版式支持更完整 |
| 多种格式混合 | Docling | MinerU | 输入覆盖最广,MIT 协议 |
7.2 三条选型铁律
结合我的实测和 2026 生态,我总结出三条选型铁律:
铁律一:先判断「有没有文字层」,再选工具。
- 有文字层(可复制)→ 走文本提取(PyPDF / Unstructured)。
- 无文字层(扫描件)→ 必须走 OCR 或多模态(MinerU / Docling / VLM)。
- 这一条决定了你是「读文字」还是「认字」,成本差一个数量级。
铁律二:中文优先 MinerU,多格式优先 Docling。
- 中文复杂版式(法律/政务/科研)→ MinerU。
- 多格式、CPU、宽松协议 → Docling。
- 有 GPU、要简洁 → Marker / MinerU VLM。
铁律三:结构保留优先于提取速度。
- 宁可慢一点,也要保留标题层级、表格、段落结构。
- 因为结构是 L4 分块的输入基础------L3 丢了结构,L4 就分不出有意义的 chunk,L7 就检索不准。
7.3 决策流程图
八、企业落地视角:法律条文检索平台的图文/PDF 解析
回到本系列的核心场景------法律条文检索平台。图文/PDF 解析在这个场景里,有几个特别值得注意的点:
8.1 法律文档的 PDF 特点
法律文档(法条、司法解释、判决书、合同)的 PDF,有几个鲜明的特点:
- 大量扫描件:很多历史法律文本是扫描的,没有文字层,必须走 OCR 或多模态。
- 条款层级复杂:法律条文有「编-章-节-条-款-项」的层级,还有「但书」「兜底条款」这些特殊的结构。
- 表格多:法律对照表、司法解释对照表、合同条款清单。
- 中文为主:这是最核心的约束。
结合上面的选型铁律 ,我最终给法律条文检索平台选了 MinerU 作为主力解析器------它在中文复杂版式上的表现最稳,能保留条款层级、表格结构,把扫描件转成高质量的结构化内容。
8.2 通用工具能做到什么、做不到什么
能做到:
- 把扫描件转成可检索的文字。
- 保留基本的标题层级、段落、表格结构。
- 把 PDF 转成干净的 Markdown。
做不到(这是法律场景的核心痛点):
- 识别「但书」「兜底条款」:这些是法律特有的结构,通用解析器不认识。
- 识别「效力层级」:法律有宪法/法律/行政法规/地方性法规/司法解释的层级,通用工具不区分。
- 识别「援引关系」:一条法条可能援引另一条,通用工具不建模这种关系。
- 识别「新旧法时效」:法律会修订,旧法何时失效、新法何时生效,通用工具不处理。
结论 :通用图文/PDF 解析工具(MinerU / Docling / Marker / 多模态 VLM)能帮你解决「把扫描件变成结构化文字 」这个基础问题,但法律场景真正难的部分------效力层级、援引关系、新旧法时效、但书/兜底条款 ------是关系型的,必须在 L3/L4 导入阶段自研建模,通用工具给不了。
8.3 一条实用的落地建议
分层路由是法律图文/PDF 解析的最优工程实践:
- 先判断文档类型:是扫描件还是电子版?是纯文字还是含表格/图表?
- 电子版纯文字 → 走 PyPDF / Unstructured,便宜。
- 扫描件中文 → 走 MinerU,精度优先。
- 含表格/公式 → 走 MinerU 或多模态 VLM,确保表格结构不丢。
- 关键法律文档 (法条、司法解释、判决书)→ 强制走高质量解析,因为条款结构是核心价值载体,不能省。
为什么不能全走一个工具 :因为成本差异巨大。全走多模态 VLM 太贵,全走简单 OCR 又会丢结构。分层路由,把高质量解析用在刀刃上(关键法律文档),把低成本解析用在次要文档(普通公告、通知)。
九、小结与下篇预告
9.1 本文核心要点
- 图文/PDF 是 L3 的硬骨头------文字「锁」在像素里,必须「认出字」才能「读出字」。
- 图片解析 :从
UnstructuredImageLoader(OCR)到多模态 VLM(视觉理解),后者能理解图表/流程图/公式,不只是认字。 - PPT 解析 :原生
.pptx用partition_ppt保留结构,比 OCR 干净得多。 - PDF 九工具:分「只提取文字」和「保留结构」两类,选型看是否需要结构。
- 三大类方法:规则(低精度低成本)、深度学习(高精度中成本)、多模态(很高精度高成本)。
- 2026 三巨头:Docling(多格式/CPU/MIT)、MinerU(中文最强)、Marker(单一 VLM 简洁)。
- 核心趋势:从「布局+OCR+公式」流水线,进化到「单一 VLM 端到端」,错误不累积。
- 选型铁律:先判断有无文字层 → 中文优先 MinerU → 结构保留优先于速度。
9.2 下篇预告
下一篇(第 3 篇)将覆盖 表格与数据库导入 :CSV 的自动切分、source 元数据定制、CSVLoader vs UnstructuredCSVLoader 对比,以及用 LlamaHub 的 DatabaseReader 直接连接数据库。如果你的 RAG 系统需要处理 Excel、CSV、数据库表,下篇就是为你准备的。