本文是「Spring Boot + AI 全栈后端」系列第 02 篇。上一篇定下了"用 Spring Boot 接 AI"的基调,这一篇直接上手:用一个 HR 政策问答机器人的真实场景,把"第一个能上线的 AI 对话接口"从 0 打到能跑。示例基于 Spring AI 2.0 / Boot 4.1。
前阵子帮一家三十来人的公司做内训,HR 同学倒苦水:每天群里都有新人问"入职要带啥材料""报销多久到账""年假怎么算",问题就那十几个,可她得一遍遍复制粘贴答。更麻烦的是,两个人答的口径还偶尔不一致。
这一篇就用这个真实场景,带你在 Spring Boot 里跑通第一个 AI 对话接口,把"重复解答"变成一次接口调用。
一、问题拆解:我们要解决什么
把 HR 的痛点摊开,目标其实很具体:
- 重复劳动:高频政策问题占掉 HR 大量时间;
- 口径不一:多人回答,标准难统一;
- 随时可问:员工希望 7×24 自助,而不是等工作时间。
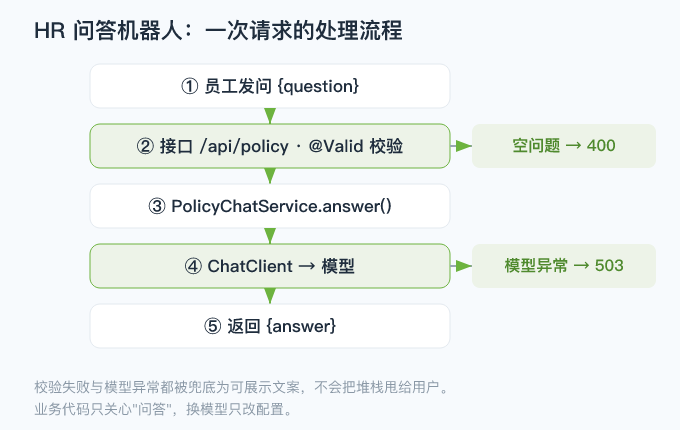
对应的接口要满足三点:能对话、入参要校验、模型挂了不能把堆栈甩给用户。下面一步步来。
先把接口契约定下来
动手写代码前,V哥 建议先把这张表贴在工位上:
| 场景 | 请求体 | 响应体 | HTTP 状态 |
|---|---|---|---|
| 正常提问 | {"question":"年假怎么算"} |
{"answer":"......"} |
200 |
| 空问题 / 纯空格 | {"question":" "} |
{"error":"问题不能为空"} |
400 |
| 模型超时 / 限流 | {"question":"年假怎么算"} |
{"error":"模型暂未返回有效回答,请稍后重试"} |
503 |
别小看这张表。AI 接口最容易失控的地方不是模型,而是边界------问题为空时怎么办、模型没答出来时返回什么。先把状态码和文案定死,前端拿到的是永远能直接展示的东西,联调时才不会因为"你返回了个 500 我怎么渲染"吵半天。
二、最小依赖:复用 01 的结论
项目用 Spring Boot 4.1.1 + Spring AI 2.0.1,靠一个起步依赖把模型接进来:
xml
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-web</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-model-openai</artifactId>
</dependency>
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-validation</artifactId>
</dependency>
ChatModel 和 ChatClient,别搞混
这是新手最容易绕晕的一对概念,一句话说清:
ChatModel是模型本身 :喂一个Prompt进去,还一个ChatResponse出来,一次调用、一进一出,跟厂商 SDK 一一对应;ChatClient是它上面的一层流式 API :把"系统提示词 / 用户消息 / 生成参数 / 拦截器"这些散落的零件串成一条链,写起来是prompt().system().user().call()这种形状。
所以注入的时候拿 ChatModel,用的时候包成 ChatClient。前者由自动配置按厂商给你装配好,后者是你自己的编排层------换厂商动的是前者,动不到后者。
配置:一行密钥是不够的
yaml
spring:
  ai:
    openai:
      api-key: ${OPENAI_API_KEY}
      base-url: https://api.openai.com
      chat:
        options:
          model: gpt-4o-mini
          temperature: 0.2
三个细节值得说:
- 密钥走环境变量,不进代码库。这是底线,一旦把明文 key 提交到 Git,扫描机器人几分钟就能扒走,账单比模型还快。
base-url是留给公司网关和国产模型的。接中转、接私有化部署、接国内大模型,改这一行,Java 代码一行不动------这正是上一篇说的"配置切换不动业务"。model/temperature可以在配置里给默认值 ,业务代码里的ChatOptions再按需覆盖,改档位不用改代码。
三、把对话包成一个接口
先定义请求/响应两个简单的记录类型,再写控制器。注意这里把"业务"和"模型"分开:控制器只管收问题、回答案,真正的对话逻辑交给服务层。
java
public record PolicyChatRequest(@NotBlank(message = "问题不能为空") String question) {}

@RestController
@RequestMapping("/api/policy")
public class PolicyChatController {

    private final PolicyChatService service;

    public PolicyChatController(PolicyChatService service) {
        this.service = service;
    }

    @PostMapping
    public PolicyChatResponse chat(@Valid @RequestBody PolicyChatRequest request) {
        return new PolicyChatResponse(service.answer(request.question()));
    }
}
四、系统提示词:口径统一靠它,不靠模型
这是整篇最容易被跳过、却最值钱的一节。
回到开头那个痛点------两个人答的口径还偶尔不一致 。很多团队的直觉是"换个更强的模型就好了",其实不对:模型再强,你没告诉它"你是谁、能答什么、答不出来怎么办",它就只能按通用常识自由发挥。HR 场景要的是每次都按公司政策答,不是每次都答得漂亮。
系统提示词就是干这个的:它不参与"这一轮问什么",而是长期挂在对话最前面,定角色、定边界、定格式。
java
private static final String SYSTEM_PROMPT = """
        你是公司 HR 政策助手,只回答与人事政策相关的问题。
        回答时必须遵守以下规则:
        1. 只依据公司已发布的政策作答,政策里没有的内容,直接回复"这条我查不到,请联系 HR 同事确认";
        2. 涉及天数、金额、流程的内容,必须给出明确数字和步骤,不用"大概""通常"这类模糊表述;
        3. 用中文回答,控制在 200 字以内,分点列出。
        """;

public String answer(String question) {
    String text = chatClient.prompt()
            .system(SYSTEM_PROMPT)
            .options(generationOptions())
            .user(question)
            .call()
            .content();
    if (text == null || text.isBlank()) {
        throw new AiServiceException("模型暂未返回有效回答,请稍后重试");
    }
    return text;
}
三条规则各有各的用处,V哥 逐个说:
- 第 1 条是"不许编"。HR 问答最怕的就是模型自信地编出一条不存在的政策------员工拿去当依据,责任算谁的?明确告诉它"查不到就说我查不到",比事后审核便宜一百倍。
- 第 2 条是"不许糊"。"通常三个工作日左右"这种话在 HR 场景里等于没说,逼它给数字。
- 第 3 条是"不许长"。既是体验,也是成本------输出按 token 计费,200 字封顶,一次问答的成本就锁死了。
五、生成参数:两个值决定"稳"和"省"
ChatOptions 里参数不少,但政策问答场景真正需要调的就是两个:
java
private static ChatOptions.Builder<?> generationOptions() {
    return ChatOptions.builder()
            .temperature(0.2)
            .maxTokens(500);
}| 参数 | 作用 | 政策问答怎么取值 | 为什么 |
|---|---|---|---|
temperature |
控制发散程度,越高越"有创意" | 0.1 ~ 0.3 | 同一句话答十次要长得一样,口径才叫统一 |
maxTokens |
单次输出上限 | 300 ~ 800 | 既是体验上限,也是单次成本上限 |
这里有个坑要提醒:ChatOptions.builder() 拿到的是个可变的 Builder ,别图省事存成 static final 常量让所有线程共用------ChatClient 在编排过程中会读它、合并它,多线程下容易互相污染。写成方法、每次调用新建一个,是最省心的做法。
至于 topP、frequencyPenalty 这些,政策问答基本用不上,等你做营销文案生成再研究不迟。
六、入参校验:空问题直接拦在门外
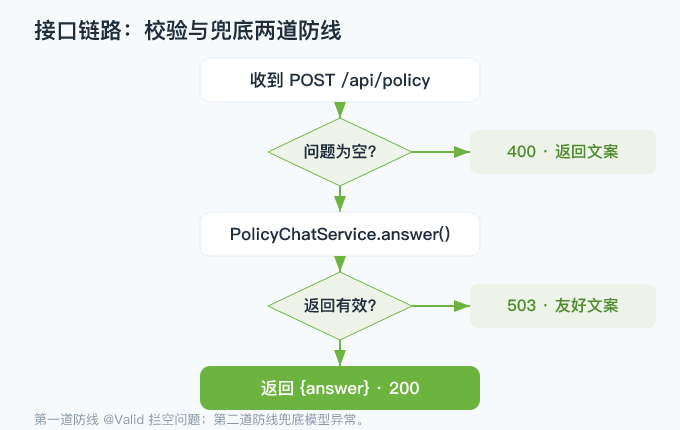
@Valid @RequestBody 配合 @NotBlank,员工发了个空问题,框架直接返回 400,根本不会打到模型。这一步很关键------既省 token,也避免无意义调用。
七、异常兜底:模型挂了也不甩堆栈
模型偶尔超时或限流,不能把一堆异常抛给前端。用 @RestControllerAdvice 统一兜底:
java
@RestControllerAdvice
public class GlobalExceptionHandler {

    @ExceptionHandler(MethodArgumentNotValidException.class)
    public ResponseEntity<Map<String, String>> handleValidation(MethodArgumentNotValidException ex) {
        String msg = ex.getBindingResult().getFieldError() != null
                ? ex.getBindingResult().getFieldError().getDefaultMessage()
                : "参数不合法";
        return ResponseEntity.badRequest().body(Map.of("error", msg));
    }

    @ExceptionHandler(AiServiceException.class)
    public ResponseEntity<Map<String, String>> handleAi(AiServiceException ex) {
        return ResponseEntity.status(HttpStatus.SERVICE_UNAVAILABLE)
                .body(Map.of("error", ex.getMessage()));
    }
}
参数错误 → 400,模型异常 → 503,前端拿到的永远是一段能直接展示的文案。这里 V哥 还有个习惯:给 AI 异常单独定义一个业务异常 (上面的 AiServiceException),不要直接把 Spring AI 抛的原生异常往外传------原生异常里可能带着你的 base-url、请求头信息,等于把内网地址直接透给了调用方。
八、跑起来:一个配置 + 一行启动
启动后用 curl 验证:
bash
curl -X POST localhost:8080/api/policy \
  -H 'Content-Type: application/json' \
  -d '{"question":"入职需要带哪些材料"}'
返回 {"answer":"......"} 就说明第一个 AI 对话接口跑通了。想接通义、Ollama?只改配置,业务代码一行不动。
九、上线前会踩的坑,先列在这
这一节是 V哥 陪学员联调时攒下来的,按出现频率排:
| 现象 | 常见原因 | 怎么查 |
|---|---|---|
启动报 api-key must not be empty |
环境变量没注入(IDE 里最常忘) | 先看 spring.ai.openai.api-key 有没有解析成占位符原样输出 |
| 401 / 403 | key 无效,或 base-url 指向的网关要额外鉴权头 |
用 curl 直接打一次网关,排除 Spring 侧问题 |
| 接口一直转圈 | 模型侧慢,且没设超时 | 给 HTTP 客户端配 connect/read timeout,别让线程池被拖死 |
| 返回空字符串 | 被安全策略拦了,或 maxTokens 给太小 |
先打印原始 ChatResponse,再判断是不是输出被截断 |
| 中文变成问号 | 请求/响应编码不一致(多见于自研网关) | 检查网关是否强制了 ISO-8859-1 |
| 本地好使,服务器上不通 | 服务器出网受限 | 先 curl 通一次目标域名,别急着改代码 |
十、落地要点与下篇
这个最小接口已经具备上线雏形:对话走服务层、口径靠系统提示词、入参有校验、异常有兜底、成本有上限。真要进生产,还差限流和缓存------那是第 11 篇的事。V哥 带学员做项目时立的规矩是:任何一个 AI 接口,没写入参校验和异常兜底,就不许往测试环境发版,否则线上一个空字符串就能让你查半天日志。
还有个问题这一篇故意没解决:现在的接口是一问一答、不记上下文 ,员工追问"那病假呢",模型不知道上一句问的是年假。这就是对话记忆(ChatMemory)的活,等我们把 03 到 06 的能力补齐,再回头收拾它。
下一篇(03)V哥 带你用多模型路由把智能客服的成本压下来:简单问题走小模型,复杂问题才上旗舰。
最后一句 :跑通第一个 AI 对话接口不难------一个 @RestController、一个 ChatClient、再加"系统提示词 + 校验 + 兜底"三道防线,你就能把 HR 的重复解答变成一次干净的接口调用。