导语
每次提交代码,CI/CD 流水线红灯亮起,满屏的报错日志让人头大?本文将带你从 0 到 1 开发一个 DevOps AI Agent。当 GitHub Actions 构建失败时,它能自动捕获日志、定位错误根因、调用大模型生成修复方案,并自动提交 Pull Request,实现真正的 CI 自愈闭环。
Agent 的价值 :将人类从"看日志 → 找文件 → 改代码 → 提交"的机械化循环中解放出来,让 AI 替我们打工。
二、 核心架构设计:AI 是如何修复 CI 的?
整个系统由四个核心模块闭环串联:
-
触发层(Trigger) :通过 GitHub Webhook 监听 Actions 构建失败事件(
workflow_run或workflow_job)。 -
感知层(Log Parser) :拉取失败 Job 的日志,并进行清洗与错误堆栈截取。
-
决策层(LLM Engine) :结合大模型(如 GLM-5.3)与源码上下文,分析错误原因并生成修复 Patch。
-
执行层(Executor) :通过 GitHub API 自动创建分支、提交修改并开启 Pull Request。
三、 核心功能实现
3.1 Webhook 监听与事件接收
这部分负责接收 GitHub 转发的 Webhook 事件。当检测到构建失败 (failure) 时,提取出核心的 Job ID 和仓库信息。整个 main.py 串联起了五个关键步骤,构成了一个闭环的自动化运维管道:
-
Webhook 接收与事件过滤 (
/webhook)- 代码通过 FastAPI 接收 GitHub 发送的 HTTP POST 请求。
- 利用
request.headers.get("X-GitHub-Event")捕获事件类型,并通过payload深入提取workflow_job的状态。 - 精准过滤 :只有当事件为
workflow_job、动作(action)为completed且结论(conclusion)为failure时,才会触发后续逻辑。这避免了对成功或进行中的任务进行无效处理。
-
异步后台任务调度 (
BackgroundTasks)- 关键点 :代码中使用了 FastAPI 的
background_tasks.add_task(run_agent_pipeline, ...)。 - 为什么重要 :GitHub 的 Webhook 要求服务端必须在短时间内(通常几秒内)返回
200 OK响应,否则会被判定为超时并断开连接。而 AI 诊断和 GitHub API 交互需要较长时间,使用BackgroundTasks可以秒级响应 GitHub Webhook,把沉重的 Agent 修复流水线扔到后台异步执行。
- 关键点 :代码中使用了 FastAPI 的
-
五步自动化修复流水线 (
run_agent_pipeline) 当流水线被触发后,它会串行执行以下 5 个严密步骤:- 1/5 抓取日志 :调用
fetch_job_logs(owner, repo, job_id)获取失败 Job 的详细云端日志。 - 2/5 清洗与路径识别 :通过
clean_and_extract_error提取精简的错误片段,并通过extract_file_path_from_logs锁定目标文件(如.github/workflows/release.yml)。 - 3/5 获取源码 :调用
get_file_content将仓库中该文件的原始内容拉取到本地。 - 4/5 大模型推理 :将错误日志、当前代码和文件路径打包,送入
ask_llm_for_fix,利用大模型进行"外科手术式"的代码修补。 - 5/5 自动提 PR :调用
create_repair_pr自动创建修复分支、提交代码并提 Pull Request。
- 1/5 抓取日志 :调用
python
import os
from fastapi import FastAPI, BackgroundTasks, Request, HTTPException
from dotenv import load_dotenv

from agent.github_client import fetch_job_logs, get_file_content, create_repair_pr
from agent.log_parser import clean_and_extract_error, extract_file_path_from_logs
from agent.llm_engine import ask_llm_for_fix

load_dotenv()
app = FastAPI(title="DevOps Agent")

def run_agent_pipeline(owner: str, repo: str, job_id: int, run_id: int):
    """异步执行完整的 Agent 修复流水线"""
    try:
        print(f"[1/5] Fetching logs for job {job_id}...")
        logs = fetch_job_logs(owner, repo, job_id)

        print(f"[2/5] Parsing error snippets...")
        error_snippet = clean_and_extract_error(logs)
        target_file = extract_file_path_from_logs(logs)
        print(f"Detected target file: {target_file}")

        print(f"[3/5] Fetching original file content...")
        file_content = get_file_content(owner, repo, target_file)

        print(f"[4/5] Asking LLM for code patching...")
        fixed_content = ask_llm_for_fix(error_snippet, file_content, target_file)

        print(f"[5/5] Creating repair PR...")
        create_repair_pr(owner, repo, target_file, fixed_content, run_id)
        print("Agent pipeline completed successfully!")

    except Exception as e:
        print(f"Agent pipeline failed with error: {e}")

@app.post("/webhook")
async def github_webhook(request: Request, background_tasks: BackgroundTasks):
    """接收 GitHub 仓库的 Webhook 事件"""
    event = request.headers.get("X-GitHub-Event")
    payload = await request.json()

    # 仅处理 workflow_job 事件,且当状态为完成且结果为 failure 时触发
    if event == "workflow_job":
        action = payload.get("action")
        job = payload.get("workflow_job", {})
        conclusion = job.get("conclusion")

        if action == "completed" and conclusion == "failure":
            repo_info = payload.get("repository", {})
            owner = repo_info.get("owner", {}).get("login")
            repo_name = repo_info.get("name")
            job_id = job.get("id")
            run_id = job.get("run_id")

            print(f"Triggered by failure: {owner}/{repo_name} (Job ID: {job_id}, Run ID: {run_id})")

            # 使用 FastAPI 的 BackgroundTasks 异步执行,避免 GitHub Webhook 超时
            background_tasks.add_task(run_agent_pipeline, owner, repo_name, job_id, run_id)

            return {"status": "accepted", "message": "Agent pipeline triggered in background."}

    return {"status": "ignored", "message": f"Event {event} or status not matched."}

if __name__ == "__main__":
    import uvicorn
    uvicorn.run("main:app", host="0.0.0.0", port=8000, reload=True)
3.2 日志清洗与文件路径提取
这是解决"黑盒"和"大模型输入污染"的关键模块。它负责从成百上千行的构建日志中精准切出错误上下文,并锁定目标文件。它通过滑动窗口截取报错行前后的核心日志,避开了长篇大论的依赖树;同时通过正则匹配,确保提取出类似 .github/workflows/release.yml 的相对路径,防止 GitHub API 报 404 Not Found。
python
import re

def clean_and_extract_error(logs: str) -> str:
    """精准清洗构建日志,只提取真正的错误核心片段,防止长日志污染"""
    lines = logs.splitlines()
    error_lines = []

    # 关键词:过滤掉锁文件详情等干扰项,专注于报错提示
    error_triggers = ["error:", "fail", "exception", "syntax error", "invalid", "err_", "fatal"]

    # 采用滑动窗口或上下文匹配:找到包含错误的行,并提取其前后各 5 行作为上下文
    for i, line in enumerate(lines):
        line_lower = line.lower()
        if any(trigger in line_lower for trigger in error_triggers):
            # 排除干扰:如果包含 pnpm 锁文件的细节行,跳过
            if "resolution:" in line_lower or "integrity:" in line_lower:
                continue

            # 提取错误周围的上下文 (前 3 行,后 5 行)
            start = max(0, i - 3)
            end = min(len(lines), i + 6)

            error_lines.append(f"--- [Context snippet around line {i}] ---")
            for j in range(start, end):
                error_lines.append(lines[j])

    # 如果通过关键字没截取到,退化为取日志最后 50 行(通常错误在最后)
    if not error_lines:
        return "\n".join(lines[-50:])

    # 去重并合并,限制最大长度,避免超长
    return "\n".join(error_lines[:40])

def extract_file_path_from_logs(logs: str) -> str:
    """精准提取出错文件路径"""
    logs_lower = logs.lower()

    if "release.yml" in logs_lower:
        return ".github/workflows/release.yml"
    if "ci.yml" in logs_lower:
        return ".github/workflows/ci.yml"

    match_wf = re.search(r'(\.github/workflows/[a-zA-Z0-9_\-\.]+\.ya?ml)', logs)
    if match_wf:
        return match_wf.group(1)

    # 默认兜底
    return ".github/workflows/release.yml"
3.3 大模型推理引擎
对接阿里云百炼 API(glm-5.3),并内嵌了带有通用工程准则的提示词,确保模型"不乱删代码、只做最小修改"。
-
使用了
glm-5.3,对 YAML 语法和 DevOps 配置文件有极强的理解力。 -
temperature=0.1确保模型输出的高度确定性和严谨性。 -
提示词中明确强调了 "外科手术式最小修改" 与 "保留生命周期步骤" ,彻底治好了大模型"一言不合就删关键步骤"的毛病。
python
import os
import re
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

api_key = os.getenv("ALI_API_KEY")
client = OpenAI(
    api_key=api_key,
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

def ask_llm_for_fix(error_logs: str, file_content: str, file_path: str) -> str:
    """调用百炼大模型,采用通用的 DevOps 修复准则与最小修改原则(中文提示词)"""
    prompt = f"""
    你是一个资深的自主式 DevOps 专家。你的任务是根据提供的错误日志,修复失败的 GitHub Actions 工作流配置或项目文件。

    [上下文]
    文件路径: {file_path}

    [错误日志]
    ```
    {error_logs}
    ```

    [当前文件内容]
    ```yaml
    {file_content}
    ```

    [工程准则]
    1. **外科手术式最小修改 (Surgical & Minimal Fix)**: 仅修改导致构建失败的确切行或配置。切勿重构、大规模修改或删除与错误无关的代码块、步骤或服务。
    2. **保留生命周期步骤 (Preserve Lifecycle Steps)**: 除非有确凿证据表明它们是导致语法或执行错误的根本原因,否则绝不能移除核心工作流步骤(例如 checkout、setup 动作、缓存配置等)。
    3. **回归根本原因 (Root-Cause Alignment)**: 针对日志中明确指出的错误信息(例如版本不匹配、语法错误、参数缺失)进行修复,而不是盲目猜测或添加无关的临时 workaround。
    4. **输出格式要求**: 仅输出修复后的完整、合法的原始代码,或使用干净的 markdown 代码块包裹。不要包含任何解释性说明。
    """

    # 打印发送给大模型的 Prompt 以便调试
    print("\n" + "="*40 + " [LLM_ENGINE] Prompt Sent to Bailian " + "="*40)
    print(prompt)
    print("="*85 + "\n")

    response = client.chat.completions.create(
        model="glm-5.3",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.1
    )

    raw_content = response.choices[0].message.content

    print("\n" + "="*40 + " [LLM_ENGINE] Raw Response from Bailian " + "="*40)
    print(raw_content)
    print("="*85 + "\n")

    fixed_code = re.sub(r"^```[a-zA-Z]*\n", "", raw_content)
    fixed_code = re.sub(r"\n```$", "", fixed_code)

    return fixed_code.strip()
3.4 整体流水线调度与 PR 提交
当大模型返回修改后的代码后,Agent 会自动通过 GitHub Git Data API 提交并创建 Pull Request:
- 基于当前主干切出一个新分支(如
fix/actions-doctor-xxx)。 - 调用
Update Contents API将修复后的 YAML 内容提交上去。 - 调用
Create Pull Request API自动提 PR。
python
import os
import requests
from github import Github
from dotenv import load_dotenv

load_dotenv()

GITHUB_TOKEN = os.getenv("GITHUB_TOKEN")
g = Github(GITHUB_TOKEN)

def fetch_job_logs(owner: str, repo: str, job_id: int) -> str:
    """通过 GitHub API 获取指定 Job 的构建日志"""
    headers = {
        "Authorization": f"Bearer {GITHUB_TOKEN}",
        "Accept": "application/vnd.github+json"
    }
    url = f"https://api.github.com/repos/{owner}/{repo}/actions/jobs/{job_id}/logs"
    response = requests.get(url, headers=headers, allow_redirects=True)

    if response.status_code == 200:
        return response.text
    raise Exception(f"Failed to fetch logs: {response.status_code}, {response.text}")

def get_file_content(owner: str, repo_name: str, file_path: str) -> str:
    """从仓库中获取指定文件的原始内容"""
    repo = g.get_repo(f"{owner}/{repo_name}")
    file_info = repo.get_contents(file_path)
    return file_info.decoded_content.decode("utf-8")

def create_repair_pr(owner: str, repo_name: str, file_path: str, new_content: str, run_id: int):
    """自动创建分支、提交修改并发起 Pull Request"""
    repo = g.get_repo(f"{owner}/{repo_name}")
    default_branch = repo.default_branch

    branch_name = f"ai-fix-run-{run_id}"
    base_ref = repo.get_branch(default_branch)

    # 1. 创建新分支
    try:
        repo.create_git_ref(ref=f"refs/heads/{branch_name}", sha=base_ref.commit.sha)
    except Exception as e:
        print(f"Branch might already exist: {e}")

    # 2. 获取目标文件在分支中的 SHA
    file_info = repo.get_contents(file_path, ref=branch_name)

    # 3. 提交修复后的代码
    repo.update_file(
        path=file_path,
        message=f"fix: auto-repair build failure in run {run_id}",
        content=new_content,
        sha=file_info.sha,
        branch=branch_name
    )

    # 4. 创建 PR
    pr = repo.create_pull(
        title=f"[AI Agent] Auto-fix build failure (Run #{run_id})",
        body=(
            f"### 🤖 Actions Doctor Auto-Repair Report\n\n"
            f"This PR was automatically generated by the AI Auto-Repair Agent after detecting a workflow failure in Run `#{run_id}`.\n"
            f"Please review the changes carefully before merging."
        ),
        head=branch_name,
        base=default_branch
    )

    print(f"Successfully created PR: {pr.html_url}")
    return pr.html_url
四、 本地联调:打通 Webhook 的"最后一公里"
本地开发的 Web Service 无法直接接收公网的 GitHub Webhook。使用 GitHub CLI (gh webhook forward) 可以免去复杂的内网穿透配置,轻松将云端事件转发到本地进行高效调试。
- 简要步骤:
-
下载安装包 点此下载,并进行安装
-
启动agent服务
bash
uvicorn main:app --reload --port 8000- 登录github cli并转发
bash
gh auth login
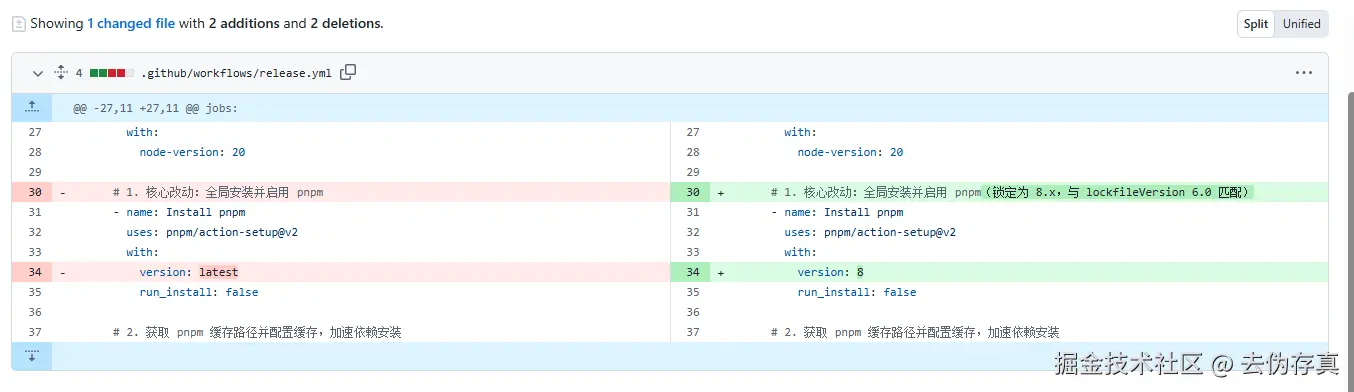
gh webhook forward --repo keep-deep-think/five-in-row --events workflow_job,workflow_run --url http://localhost:8000/webhook- 人为制造错误并打tag触发构建错误 将.github\workflows\release.yml中的
version: 8修改为version: latest
js
     # 1. 核心改动:全局安装并启用 pnpm
      - name: Install pnpm
        uses: pnpm/action-setup@v2
        with:
          version: latest
          run_install: false
打新的tag触发github actions进行构建
bash
git tag v1.0.3 && git push origin v1.0.3在github代码仓库中查看修改结果,精准修复,nice! glm-5.3 模型好强。
五、 生产落地与进阶思考
-
安全边界(Human-in-the-loop) :为什么绝对不能直接 Push 到
main分支? 必须通过 Draft PR 或人工审核保证代码安全性。 -
RAG 增强(检索代码库) :当项目规模变大,单一文件上下文不够时,如何引入向量数据库让 Agent 具备全仓检索能力。
-
Self-Correction(自我修正) :如果 Agent 第一次修不好,如何将第二次的失败日志回传,实现多轮迭代闭环。
要想真的在生产环境中落地,还需要解决问题2和问题3,尤其是问题3,问题2现在的大模型貌似已经具备了这样的能力,针对问题3.我的初步思路是:
1.- 状态追踪与持久化 (State Store) :
-
引入一个简单的状态存储(如 Redis 或本地 SQLite),以
run_id或PR ID为主键,记录当前的修复历史状态(例如:retry_count: 1,history_patches: [...])。 -
闭环触发链 (Feedback Hook) :
- 当 Agent 提交了第一个 PR 并在 CI 中触发了新的运行。如果该 PR 对应的 CI 再次报错(
conclusion: failure),Webhook 再次触发。 - Agent 监听到这是"已修复过的 PR 产生的二次失败",触发 Self-Correction 逻辑。
- 当 Agent 提交了第一个 PR 并在 CI 中触发了新的运行。如果该 PR 对应的 CI 再次报错(
-
多轮对话与历史回传:
-
在调用大模型时,不能只传当前的错误,而是要把"历史对话/历史修改记录"传过去:
- "这是第一次的错误日志......"
- "这是我们第一次尝试的修复代码(但失败了)......"
- "这是由于该修复导致产生的最新错误日志:......"
-
让大模型基于上一次的失败原因进行反思(Reflection)并修正补丁。
-
-
熔断机制 (Circuit Breaker) :
- 必须设置最大重试次数(例如
MAX_RETRIES = 3)。如果连续 3 次迭代修复仍然失败,则自动停止自动化流程,并给 PR 打上needs-human-review标签,转为人工介入,防止大模型陷入无限死循环。
- 必须设置最大重试次数(例如
结语:迈向真正的 AI DevOps 时代
未来的软件工程,不再需要人类在繁琐的 CI/CD 报错、环境版本冲突和 YAML 语法缩进中苦苦挣扎。人类可以退居幕后担任架构师与终审官(Human-in-the-loop),将高频、枯燥、底层的故障诊断与修复交给像 DevOps Agent 这样的自主式 Agent。这不仅是开发效率的跨越式跃迁,更是 AI 深度赋能软件研发全生命周期的生动实践!