很多 AI 应用做到最后,都会遇到同一个工程问题:模型能理解用户想做什么,却无法真正读取订单、创建日程、查询库存或调用企业内部系统。
工具调用解决了"模型如何表达执行意图",但当系统里有几十甚至上百个 REST API 时,逐个手写工具定义同样难以维护。接口一旦修改,还要同步修改模型侧的参数 Schema,很容易产生文档、代码和模型工具定义不一致的问题。
一个更具扩展性的方案是:直接读取现有 OpenAPI 规范,把每个 API 操作自动转换成大模型可以理解的工具定义。
本文会完整拆解这条链路,并给出已经通过真实 DeepSeek API 验证的 Python 实现:
- 如何从 OpenAPI 中提取
operationId、描述和参数; - 如何转换为 Chat Completions API 的
tools; - DeepSeek 如何根据自然语言自动选择一个或多个工具;
- 如何把工具执行结果送回模型并生成最终总结;
- 生产环境如何控制权限、参数、循环次数和破坏性操作。
一、技术背景:为什么不应该手写几十个工具定义
假设一个事件管理服务提供以下接口:
- 查询全部事件;
- 创建事件;
- 根据 ID 查询事件;
- 删除事件;
- 更新事件名称。
传统函数调用需要为每个接口编写一份 JSON Schema:
python
{
    "type": "function",
    "function": {
        "name": "deleteEvent",
        "description": "Delete an event by id",
        "parameters": {
            "type": "object",
            "properties": {"id": {"type": "string"}},
            "required": ["id"],
        },
    },
}
五个接口还可以手工维护,五十个接口就会出现明显问题:
- OpenAPI 文档和工具定义重复维护;
- 参数变更后容易遗漏模型侧 Schema;
- 不同开发者对工具名称和描述的写法不一致;
$ref、请求体、路径参数和查询参数处理容易出错;- 模型接口迁移时,需要再次修改大量业务代码。
OpenAPI 本身已经包含路径、方法、参数、请求体和响应结构。与其重新描述一次,不如把它作为模型工具定义的唯一事实来源。
二、核心原理:OpenAPI 负责描述,模型负责规划,程序负责执行
这套架构最重要的原则是职责分离。
OpenAPI 规范层
负责声明系统"允许做什么",包括接口路径、HTTP 方法、operationId、参数和请求体 Schema。
模型规划层
模型接收用户指令和工具列表,只负责回答:
- 应该调用哪个工具;
- 工具参数是什么;
- 是否还需要继续调用其他工具。
模型不会自动发送 HTTP 请求,也不应该直接持有业务系统凭据。
受控执行层
程序校验函数名和参数后,才使用服务端保存的认证信息调用真实 API。执行结果被包装为 tool 消息,再发送给模型。
结果总结层
模型读取全部工具结果,向用户生成自然语言总结。多步骤任务会形成"规划、执行、反馈、继续规划"的循环。
三、整体架构
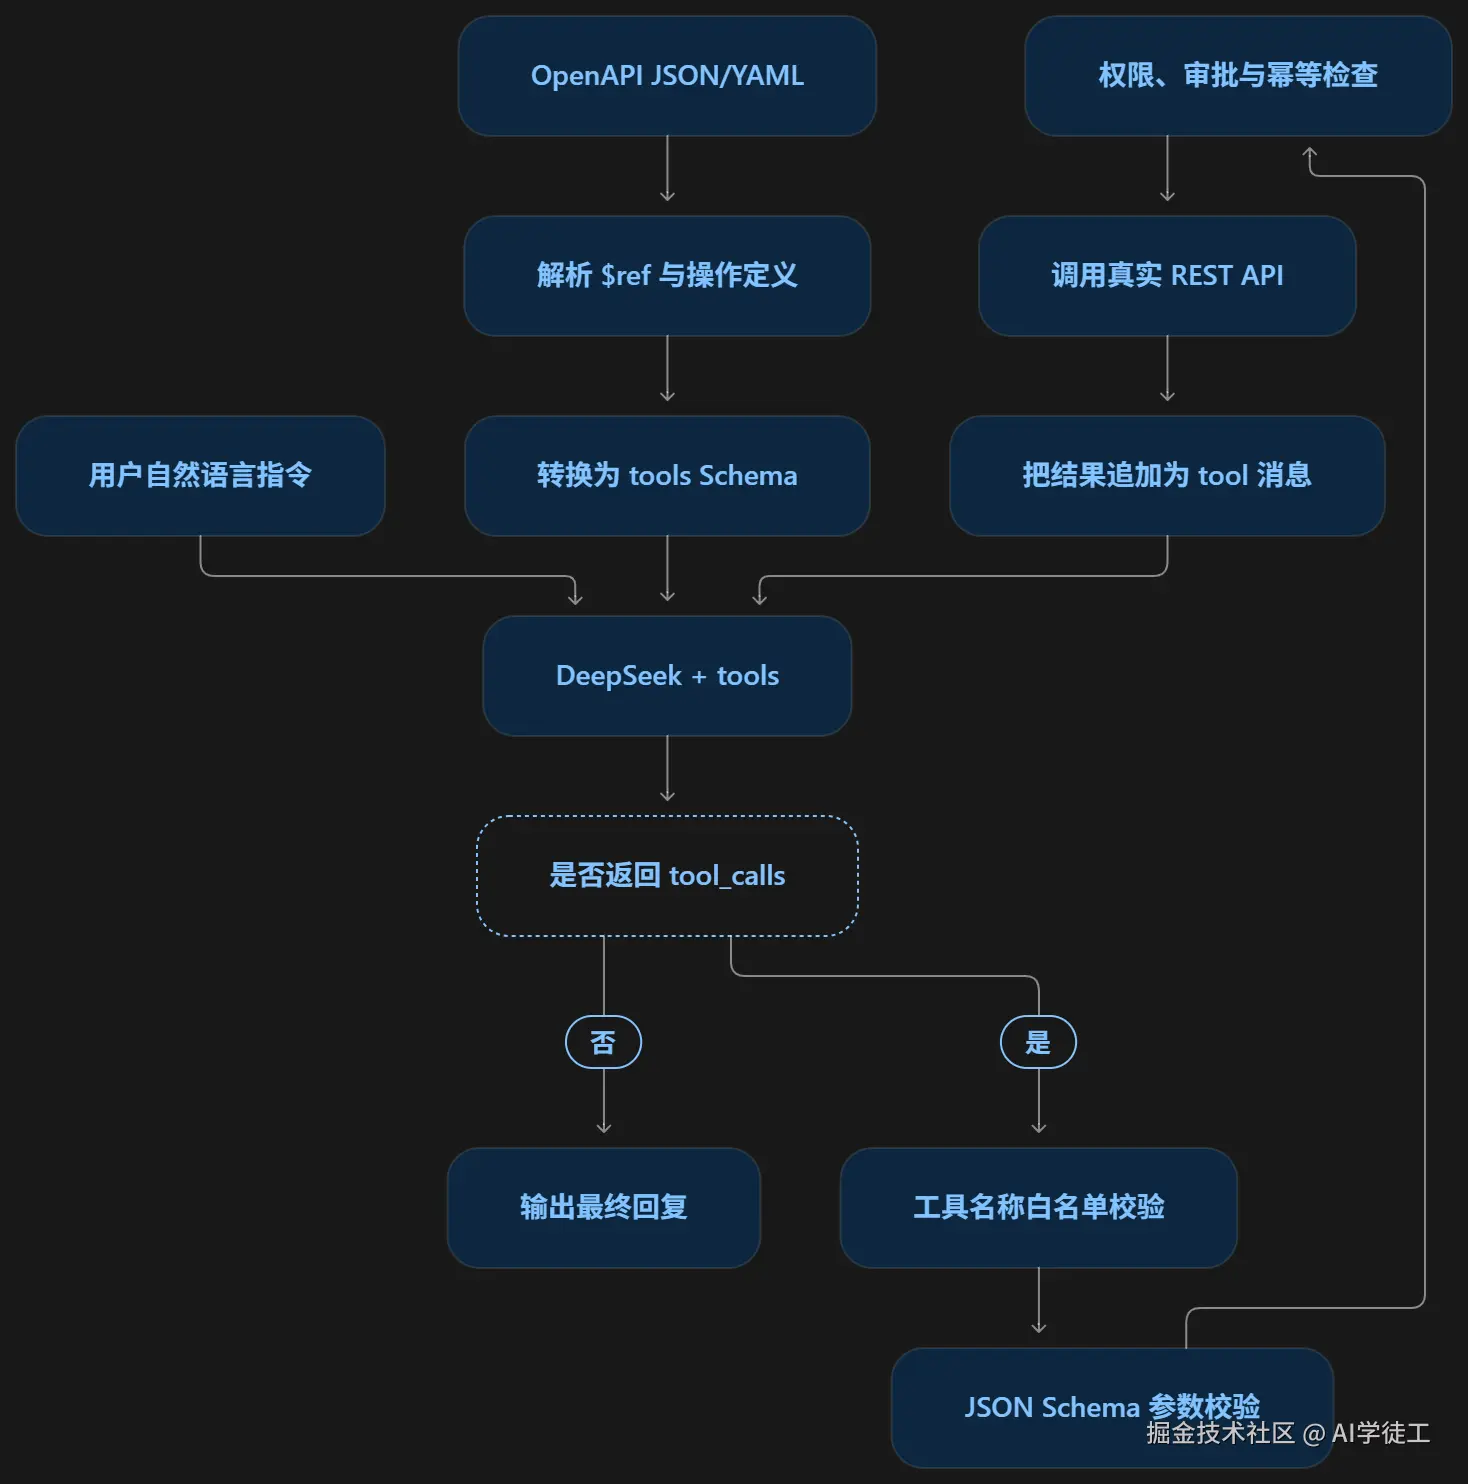
这里存在一条必须守住的安全边界:OpenAPI 可以生成工具描述,但不能自动获得执行权限。 模型输出只是候选调用计划,是否执行仍由服务端代码决定。
四、适用场景
企业内部助手
把工单、知识库、CRM、库存和审批系统的 OpenAPI 接入统一助手,让模型根据意图选择正确接口。
自动化工作流
把"查询全部事件、创建新事件、删除旧事件"这样的自然语言任务拆成多个连续工具调用。
客服系统
根据用户问题调用订单查询、物流跟踪、退款资格判断等接口,并把结构化结果解释给用户。
API 探索与运维
让模型读取经过筛选的内部 API 规范,辅助生成查询参数或组合只读诊断流程。
不适合直接使用的场景包括高风险资金操作、不可逆删除、权限边界不清晰的接口,以及没有稳定 operationId 和 Schema 的老旧 API。
五、实战流程:把 OpenAPI 转换为 DeepSeek 工具
本文使用 OpenAI Python SDK 连接 DeepSeek 兼容接口。实际验证环境为 Python 3.11,模型为 deepseek-flash。
1. 安装依赖
bash
pip install openai jsonref requests设置 API Key:
powershell
$env:DEEPSEEK_API_KEY="你的 API Key"Linux 或 macOS 使用:
bash
export DEEPSEEK_API_KEY="你的 API Key"2. 准备 OpenAPI 规范
下面是一份最小天气接口规范:
yaml
openapi: 3.0.0
info:
  title: 天气 API
  version: 1.0.0
paths:
  /weather:
    get:
      operationId: get_weather
      summary: 获取指定城市的天气
      parameters:
        - name: city
          in: query
          required: true
          schema:
            type: string
      responses:
        "200":
          description: 成功
operationId 非常重要。它会成为模型看到的工具名,因此必须唯一、稳定并且具有可读性。
3. 解析 $ref 并生成 tools
OpenAPI 经常通过 $ref 复用对象定义,直接读取原始 JSON 可能得到不完整的参数结构。可以使用 jsonref 先解析引用:
python
import jsonref

def openapi_to_tools(openapi_spec: dict) -> list[dict]:
    tools = []
    for path, methods in openapi_spec["paths"].items():
        for method, operation_with_ref in methods.items():
            operation = jsonref.replace_refs(operation_with_ref)
            function_name = operation.get("operationId")
            if not function_name:
                raise ValueError(f"{method.upper()} {path} 缺少 operationId")

            description = operation.get("description") or operation.get("summary", "")
            schema = {"type": "object", "properties": {}}

            request_body = (
                operation.get("requestBody", {})
                .get("content", {})
                .get("application/json", {})
                .get("schema")
            )
            if request_body:
                schema["properties"]["requestBody"] = request_body

            parameters = operation.get("parameters", [])
            if parameters:
                schema["properties"]["parameters"] = {
                    "type": "object",
                    "properties": {
                        item["name"]: item["schema"]
                        for item in parameters
                        if "schema" in item
                    },
                    "required": [
                        item["name"] for item in parameters if item.get("required")
                    ],
                }

            tools.append({
                "type": "function",
                "function": {
                    "name": function_name,
                    "description": description,
                    "parameters": schema,
                },
            })
    return tools
这段转换逻辑与模型厂商无关。未来改用其他支持 OpenAI 风格工具调用的模型时,OpenAPI 解析层可以继续复用。
4. 初始化 DeepSeek 客户端
python
import json
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)
MODEL = "deepseek-flash"
迁移的关键是把模型调用封装在适配层。上层代码只依赖 client.chat.completions.create(),不直接散落厂商配置。
5. 验证单次天气工具调用
python
tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "获取指定城市的天气",
        "parameters": {
            "type": "object",
            "properties": {"city": {"type": "string"}},
            "required": ["city"],
            "additionalProperties": False,
        },
    },
}]

response = client.chat.completions.create(
    model=MODEL,
    messages=[
        {"role": "system", "content": "需要实时天气时必须调用 get_weather 工具。"},
        {"role": "user", "content": "北京今天天气怎么样?"},
    ],
    tools=tools,
    tool_choice="auto",
    temperature=0,
)

message = response.choices[0].message
if not message.tool_calls:
    raise RuntimeError("模型没有返回天气工具调用")

function_call = message.tool_calls[0].function
arguments = json.loads(function_call.arguments)
assert function_call.name == "get_weather"
assert arguments["city"] == "北京"
真实测试中,DeepSeek 返回了:
text
工具:get_weather
参数:{"city": "北京"}
这里验证的是模型真实生成的工具名称和参数,不是本地伪造的响应。
六、链式调用:一次用户指令触发多个 API
用户可能会提出:
text
查询全部事件,然后创建一个名为 AGI Party 的事件,最后删除 ID 为 2456 的事件。模型需要先后或并行规划多个工具,并在收到执行结果后继续完成剩余步骤。
python
MAX_CALLS = 5

def get_model_response(tools: list[dict], messages: list) -> object:
    return client.chat.completions.create(
        model=MODEL,
        tools=tools,
        tool_choice="auto",
        temperature=0,
        messages=messages,
    )

def process_instruction(tools: list[dict], instruction: str, execute_tool) -> dict:
    call_count = 0
    called_tools = []
    messages = [
        {
            "role": "system",
            "content": "使用可用工具完成任务,然后总结所有执行结果。",
        },
        {"role": "user", "content": instruction},
    ]

    while call_count < MAX_CALLS:
        message = get_model_response(tools, messages).choices[0].message
        messages.append(message)

        if not message.tool_calls:
            return {
                "called_tools": called_tools,
                "message": message.content or "",
            }

        for tool_call in message.tool_calls:
            if call_count >= MAX_CALLS:
                break

            name = tool_call.function.name
            arguments = json.loads(tool_call.function.arguments)
            result = execute_tool(name, arguments)

            called_tools.append(name)
            call_count += 1
            messages.append({
                "role": "tool",
                "tool_call_id": tool_call.id,
                "content": json.dumps(result, ensure_ascii=False),
            })

    raise RuntimeError(f"工具调用达到上限:{MAX_CALLS}")
在真实 DeepSeek 验证中,模型首先并行生成:
text
listEvents()
createEvent({"requestBody": {"name": "AGI Party"}})
收到两条工具结果后,它继续生成:
text
deleteEvent({"parameters": {"id": "2456"}})三个结果全部回传后,模型停止调用工具并输出最终总结。
需要准确说明的是:上述模型请求、参数生成、调用顺序和工具结果回传均由真实 DeepSeek API 完成;测试中的事件业务结果使用了与原始 Cookbook 相同的确定性成功数据,没有连接或修改真实事件系统。生产环境必须把 execute_tool 替换为经过权限控制的真实 HTTP 执行器。
七、生产环境不能省略的安全层
1. 不要让模型决定请求地址
模型只能返回 operationId 和参数。请求方法、路径、目标主机和认证方式应由服务端注册表映射,避免 SSRF 和任意 URL 访问。
python
OPERATION_REGISTRY = {
    "listEvents": {"method": "GET", "path": "/events", "scope": "events:read"},
    "createEvent": {"method": "POST", "path": "/events", "scope": "events:write"},
    "deleteEvent": {"method": "DELETE", "path": "/events/{id}", "scope": "events:delete"},
}
2. 参数必须重新校验
模型返回的 JSON 不能直接传给业务 API。应使用 OpenAPI Schema 或 Pydantic 校验类型、必填项、枚举值、长度和额外字段。
3. 破坏性操作必须增加确认
查询可以自动执行,删除、退款、转账和权限修改则需要人工确认或业务审批。不能因为模型正确生成了 deleteEvent,就默认用户已经授权删除。
4. 写操作必须具备幂等性
网络重试或模型重复调用可能导致重复创建。写接口应携带幂等键,并在执行层记录 tool_call_id 与业务操作结果。
5. 限制工具数量和循环次数
一次性把数百个接口全部交给模型,会增加 Token、降低选择准确率。可以先按业务域筛选工具,再设置 MAX_CALLS、总耗时和费用预算。
6. 正确处理一次返回多个 tool_calls
模型可能在一条消息中并行返回多个独立工具调用。必须为每个 tool_call_id 都追加对应结果,遗漏任何一个都可能导致下一次模型请求失败。
7. 把认证留在执行层
API Key、OAuth Token 和 Cookie 不应出现在 Prompt、OpenAPI 工具描述或模型返回内容中。模型只看业务参数,执行层负责注入凭据。
8. 建立完整审计日志
至少记录:
- 用户与会话标识;
- 原始指令;
- 模型选择的
operationId; - 校验后的参数摘要;
- 权限和审批结果;
- HTTP 状态、耗时与重试次数;
- 最终回复和失败原因。
涉及个人信息或支付数据时,日志必须脱敏。
八、迁移到国内模型时的兼容性注意事项
本次迁移保留了 OpenAPI 解析、operationId 映射、参数 Schema 和消息循环,只替换模型接入层。这样可以最大限度降低迁移范围。
实测中需要特别注意:
deepseek-flash在tool_choice="auto"下能够正确生成单次和链式工具调用;- 当前思考模式不接受
tool_choice="required",接口会返回明确的 400 错误; - 因此不能机械复制其他平台参数,需要使用
auto并通过系统提示和结果校验约束行为; - 模型 ID 应以当前账号实际返回的模型列表为准;
- "兼容 OpenAI SDK"只表示接口形态接近,不代表每个参数和能力完全一致。
后续改用通义、智谱或豆包时,OpenAPI 转换层仍可保留,只需为模型客户端和能力差异增加新的适配配置。
九、总结
把 OpenAPI 规范转换成模型工具,真正解决的是工具规模化管理问题:
- OpenAPI 成为接口能力的事实来源;
- 转换层把 REST 操作映射成
tools; - 模型根据用户意图生成结构化调用计划;
- 执行层完成权限、参数和安全校验;
- 工具结果回传给模型,形成可追踪的执行闭环。
这套方案可以显著减少手写工具定义,但不能把执行权直接交给模型。真正可上线的系统,必须具备工具白名单、Schema 校验、权限控制、破坏性操作确认、幂等机制和审计日志。
我把原始 OpenAI 示例、DeepSeek 迁移代码、逐代码块差异高亮、无需修改说明及真实 API 验证过程整理成了完整教程:
使用 OpenAPI 规范进行函数调用:原版与 DeepSeek 国产迁移实战
原始思路参考 OpenAI Cookbook 的 Function Calling with an OpenAPI Spec 示例;国内迁移版本使用 DeepSeek 兼容接口完成真实模型调用验证。