GoWind Admin|风行 --- 开箱即用的企业级全栈中后台框架:AI 模块
当"接个大模型"成为每个管理系统的标配需求,多数团队的选择是在业务代码里散落一堆 SDK 调用:密钥写死在配置文件、用量没人记账、租户之间无隔离、换一家模型供应商就要发版。风行(GoWind Admin)把 AI 当作平台的一等公民模块来做:提供商是数据不是配置、对话走流式推送、用量进配额体系、知识库 RAG 开箱即用,甚至自然语言问数也带四重安全护栏。本文带你完整过一遍这套 AI 能力的设计与实践。
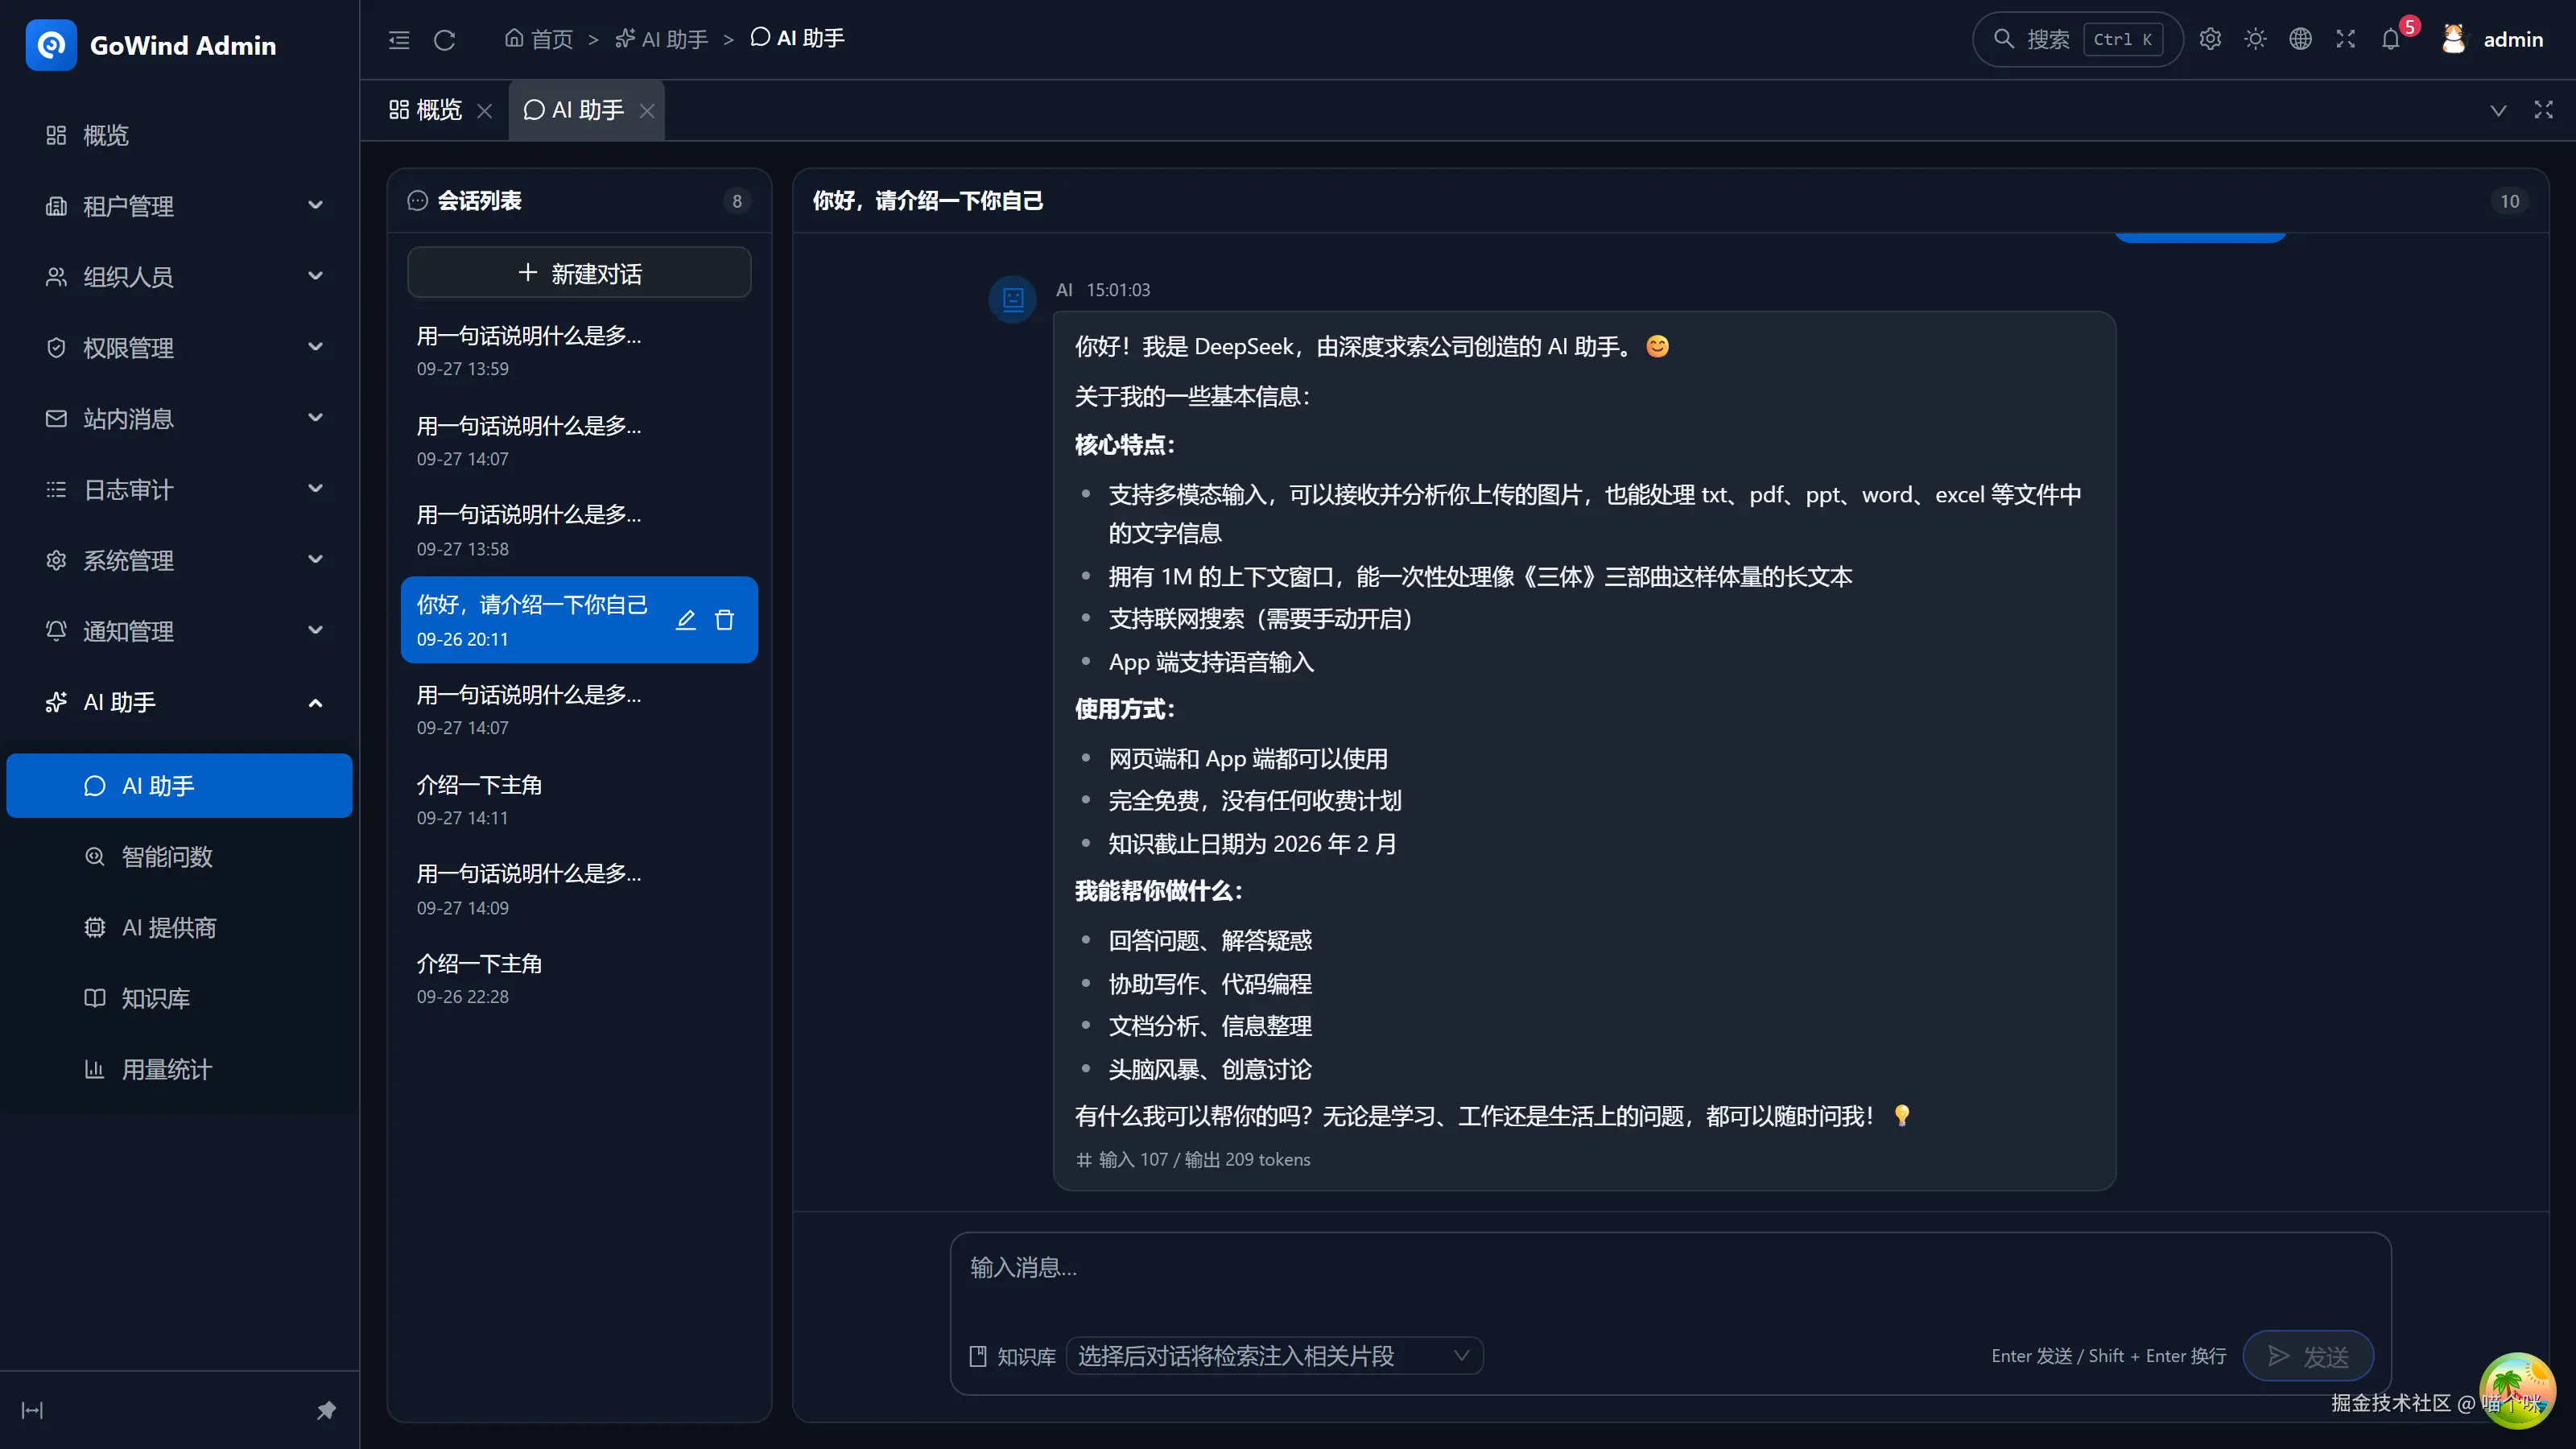
一、能力全景:五个子域,一张图看懂
| 能力 | 入口 | 一句话说明 |
|---|---|---|
| 模型提供商 | 管理页「AI 提供商」 | 一行 = 一个 OpenAI 兼容端点(云端 API 或本地 Ollama);api_key 加密落库 |
| 流式对话 | 分析页 → AI 助手 | SSE 实时推送增量 token;同步响应携带完整回复 |
| 知识库 RAG | 管理页「知识库」 | 文档切片 → 向量化(pgvector)→ 检索注入对话上下文 |
| 智能问数 | AI 助手 → 智能问数 | 自然语言 → 只读 SQL → 结果表格 + 自然语言结论 |
| 用量配额 | 套餐配额 AI_TOKENS |
每次调用记账,月度配额超限拒绝 |
| 安全与异常洞察 | 分析页卡片 | 规则预筛审计明细,LLM 只写总评 |
两张核心设计思路贯穿始终:
- 模型接入与业务解耦 ------提供商是数据库里的一行记录,不是
application.yaml里的一段配置。接 DeepSeek、通义还是本地 Ollama,管理页新建一条即可,业务零改动。 - 告警/分析只产出结构化事实------文案归前端 i18n,模型只生成指定部分,多语言界面永远一致。
二、模型提供商:一次配置,处处可用
管理页「AI 提供商」新建一条记录,就是接入一个模型:
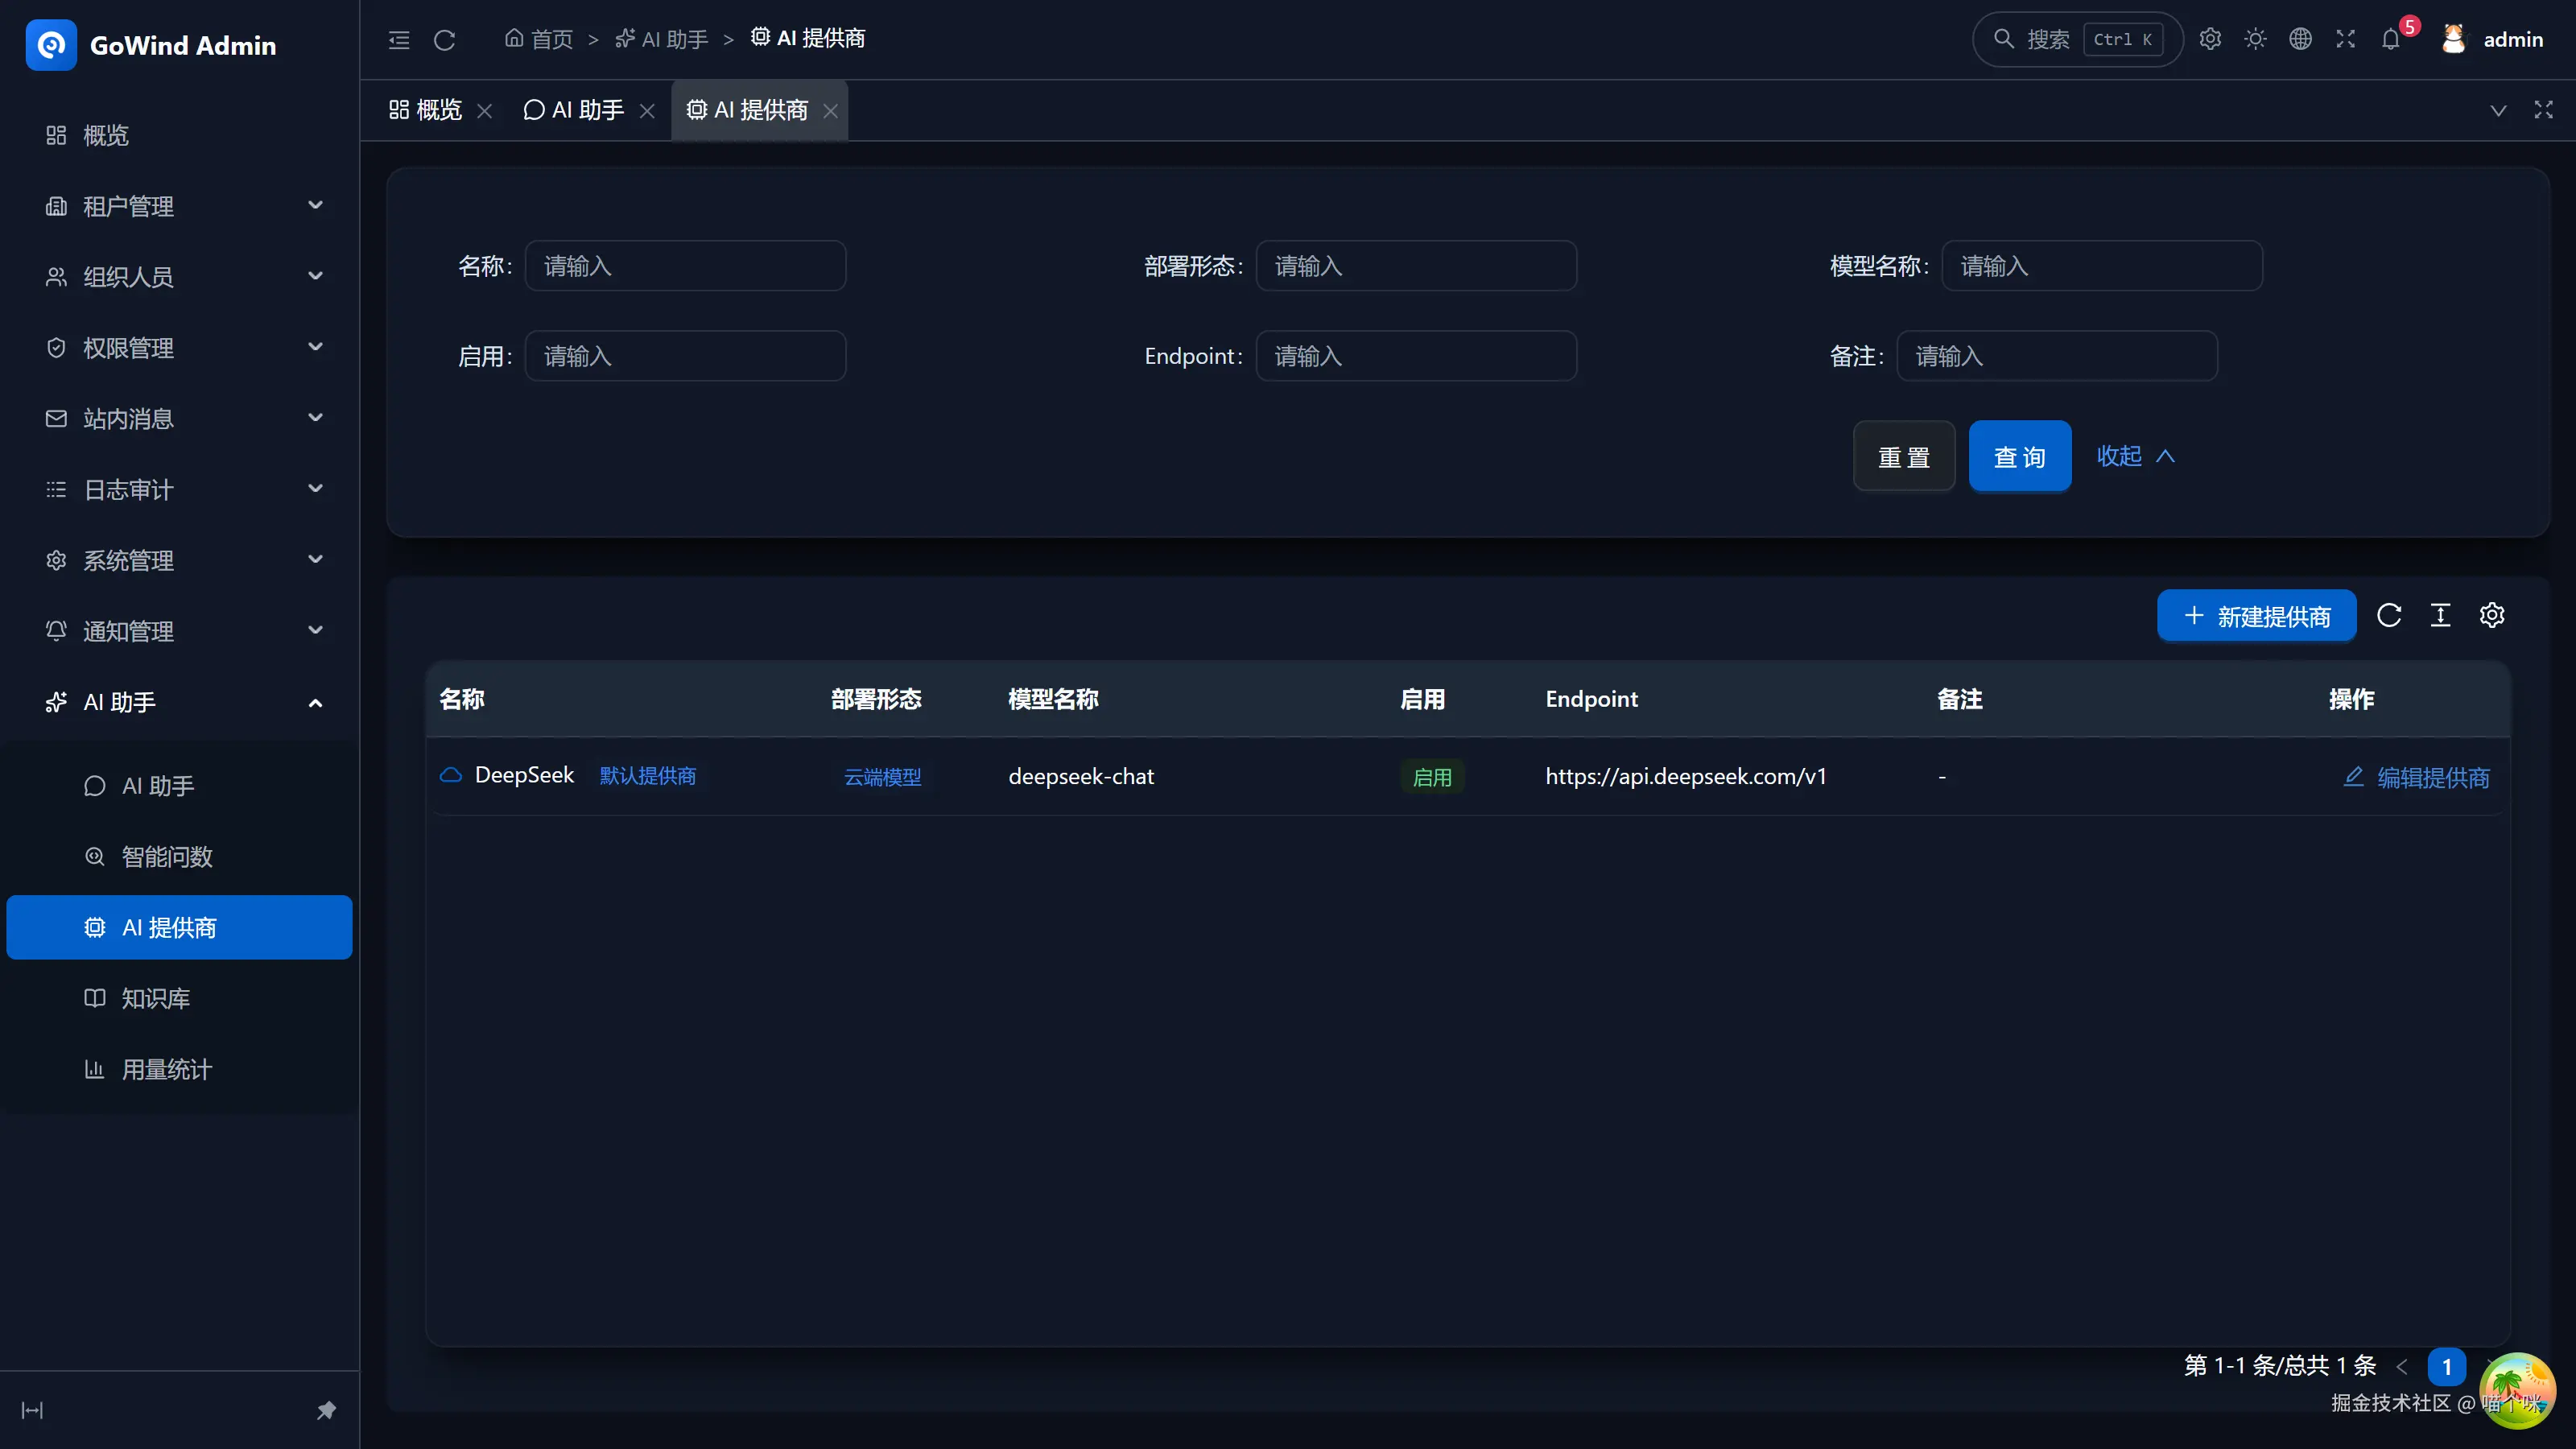
- 云端模型 :填 OpenAI 兼容
baseUrl+apiKey(DeepSeek、通义等主流厂商均兼容); - 本地模型:填 Ollama 主机端口即可,key 留空------政企/等保场景数据不出内网的关键;
- api_key AES-GCM 加密落库 ,读视图只有脱敏后的
apiKeyHint;更新时留空 = 不修改已存 Key; - 勾选「默认提供商」后,聊天与定时任务在未指定时都用它。
go
// 后端内部链路:脚本 ai 模块、定时任务、洞察共用同一条
// provider 解析 → 密钥解密 → 客户端工厂链路,不存在第二套接入逻辑
三、流式对话:SSE 推送的工程细节
POST /admin/v1/ai/chat/completions 是一个普通 POST,同步返回完整回复;生成过程中的增量 token 则通过 SSE 网关(独立 :7789 端口)以 ai_chat_chunk 事件实时推给发起用户,前端逐帧渲染 markdown。
几个值得抄走的工程决策:
- chunk 是尽力而为 :SSE 缓冲满即丢帧(
TryPublish),以 POST 同步响应为最终事实------推送从不阻塞主链路; - 流式时长由 context deadline 控制 (5 分钟),而不是
http.Client.Timeout------后者会把长回复腰斩在 30 秒; - 对话归属用户,删除会话级联删除消息;ASSISTANT 消息行带 tokens/耗时快照,与用量流水互相印证。
四、知识库 RAG:pgvector 全链路
链路:上传纯文本或文件(txt/md/docx/pdf,后端抽取文本,上限 10MB)→ 切片(500 字符/片,50 重叠)→ 调 provider 端点的 OpenAI 兼容 /v1/embeddings 批量向量化 → 落库 → 检索(pgvector 余弦距离 topK)→ chat 携带 knowledgeBaseId 时把命中片段注入 system 消息。
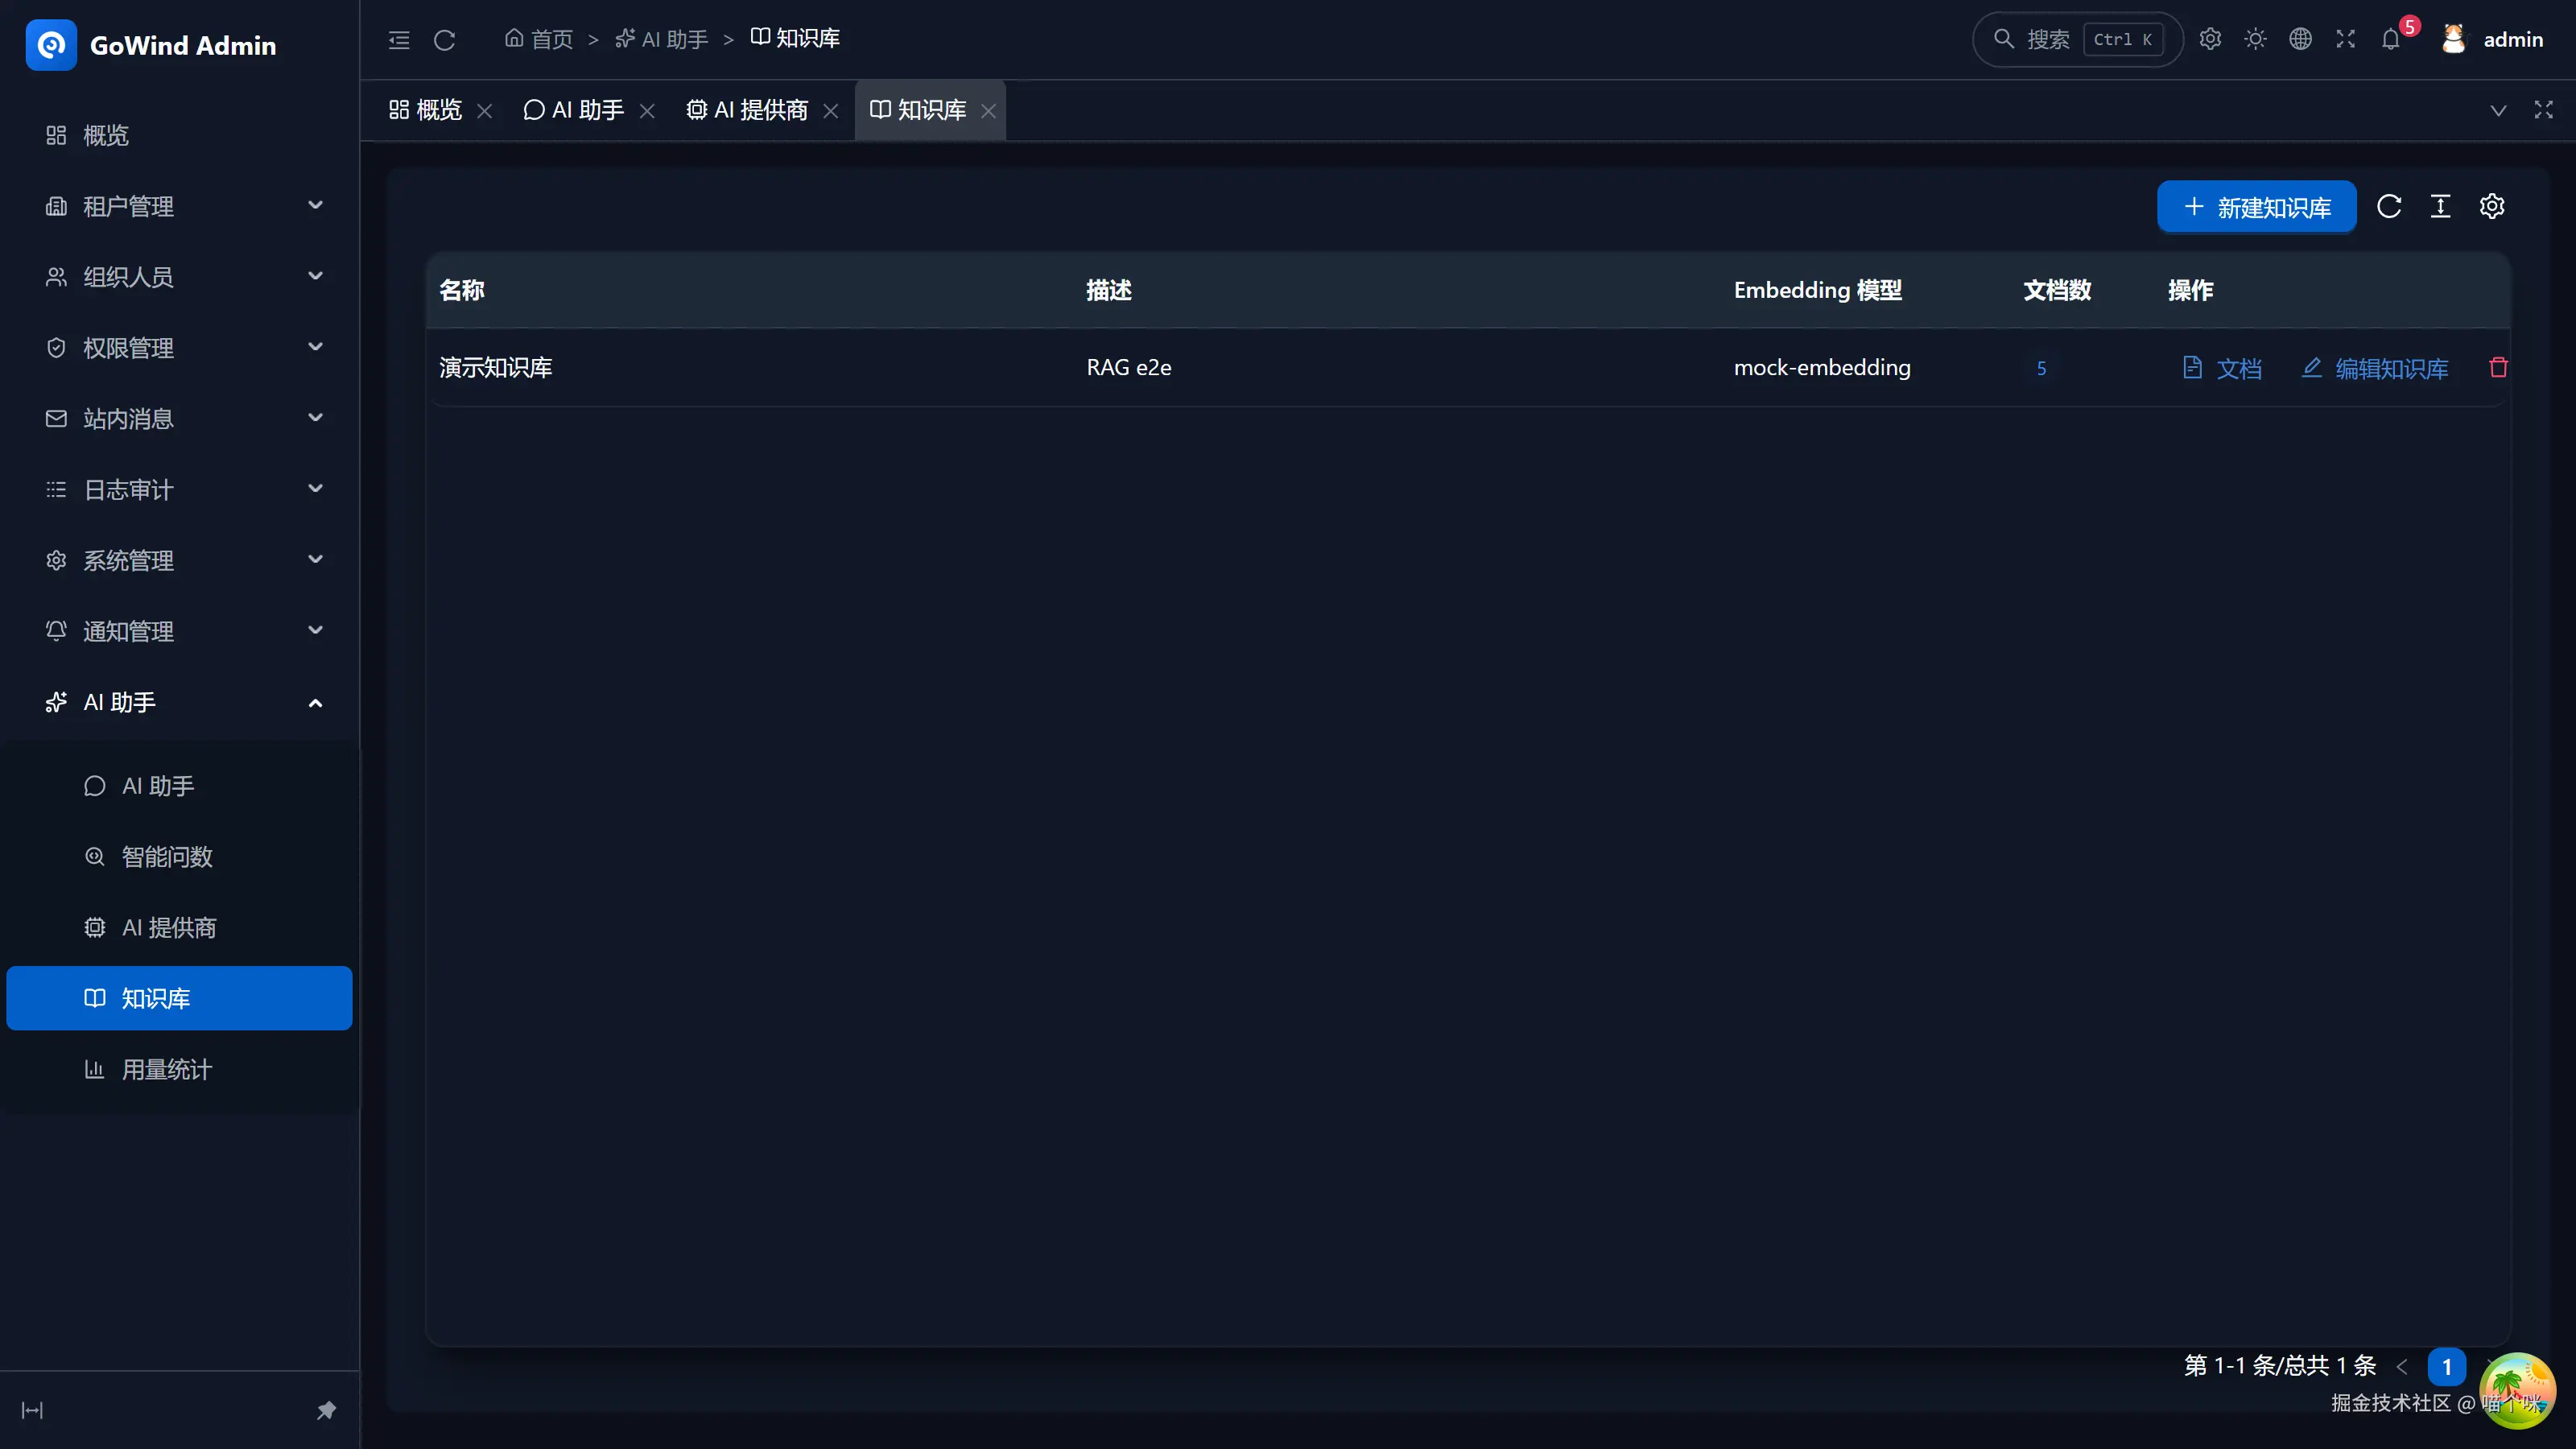
部署侧只有一件事要做:Postgres 换成 pgvector/pgvector:pg16 镜像 。服务启动时自动 CREATE EXTENSION IF NOT EXISTS vector 并补列,失败仅降级 RAG,其余功能不受影响。
规模化的后手也已备好:切片表过 1 万行后,启动迁移自动建 HNSW 索引并放开迭代扫描;到十万级再建议把向量负载迁出主 OLTP 库------DSN 级部署改动,无需改代码。
换 embedding 模型 ?「任务管理」创建 ai_doc_reindex 任务全量重算切片向量,业务无感。
五、智能问数:自然语言查库,四重护栏兜底
「智能问数」是风行的特色能力:自然语言提问 → LLM 生成只读 SQL → 只读事务执行 → 结果表格 +(可选)自然语言结论。支持多轮追问("那只看 admin 的"、"换成按天分组"),每轮 SQL 仍全量过检:
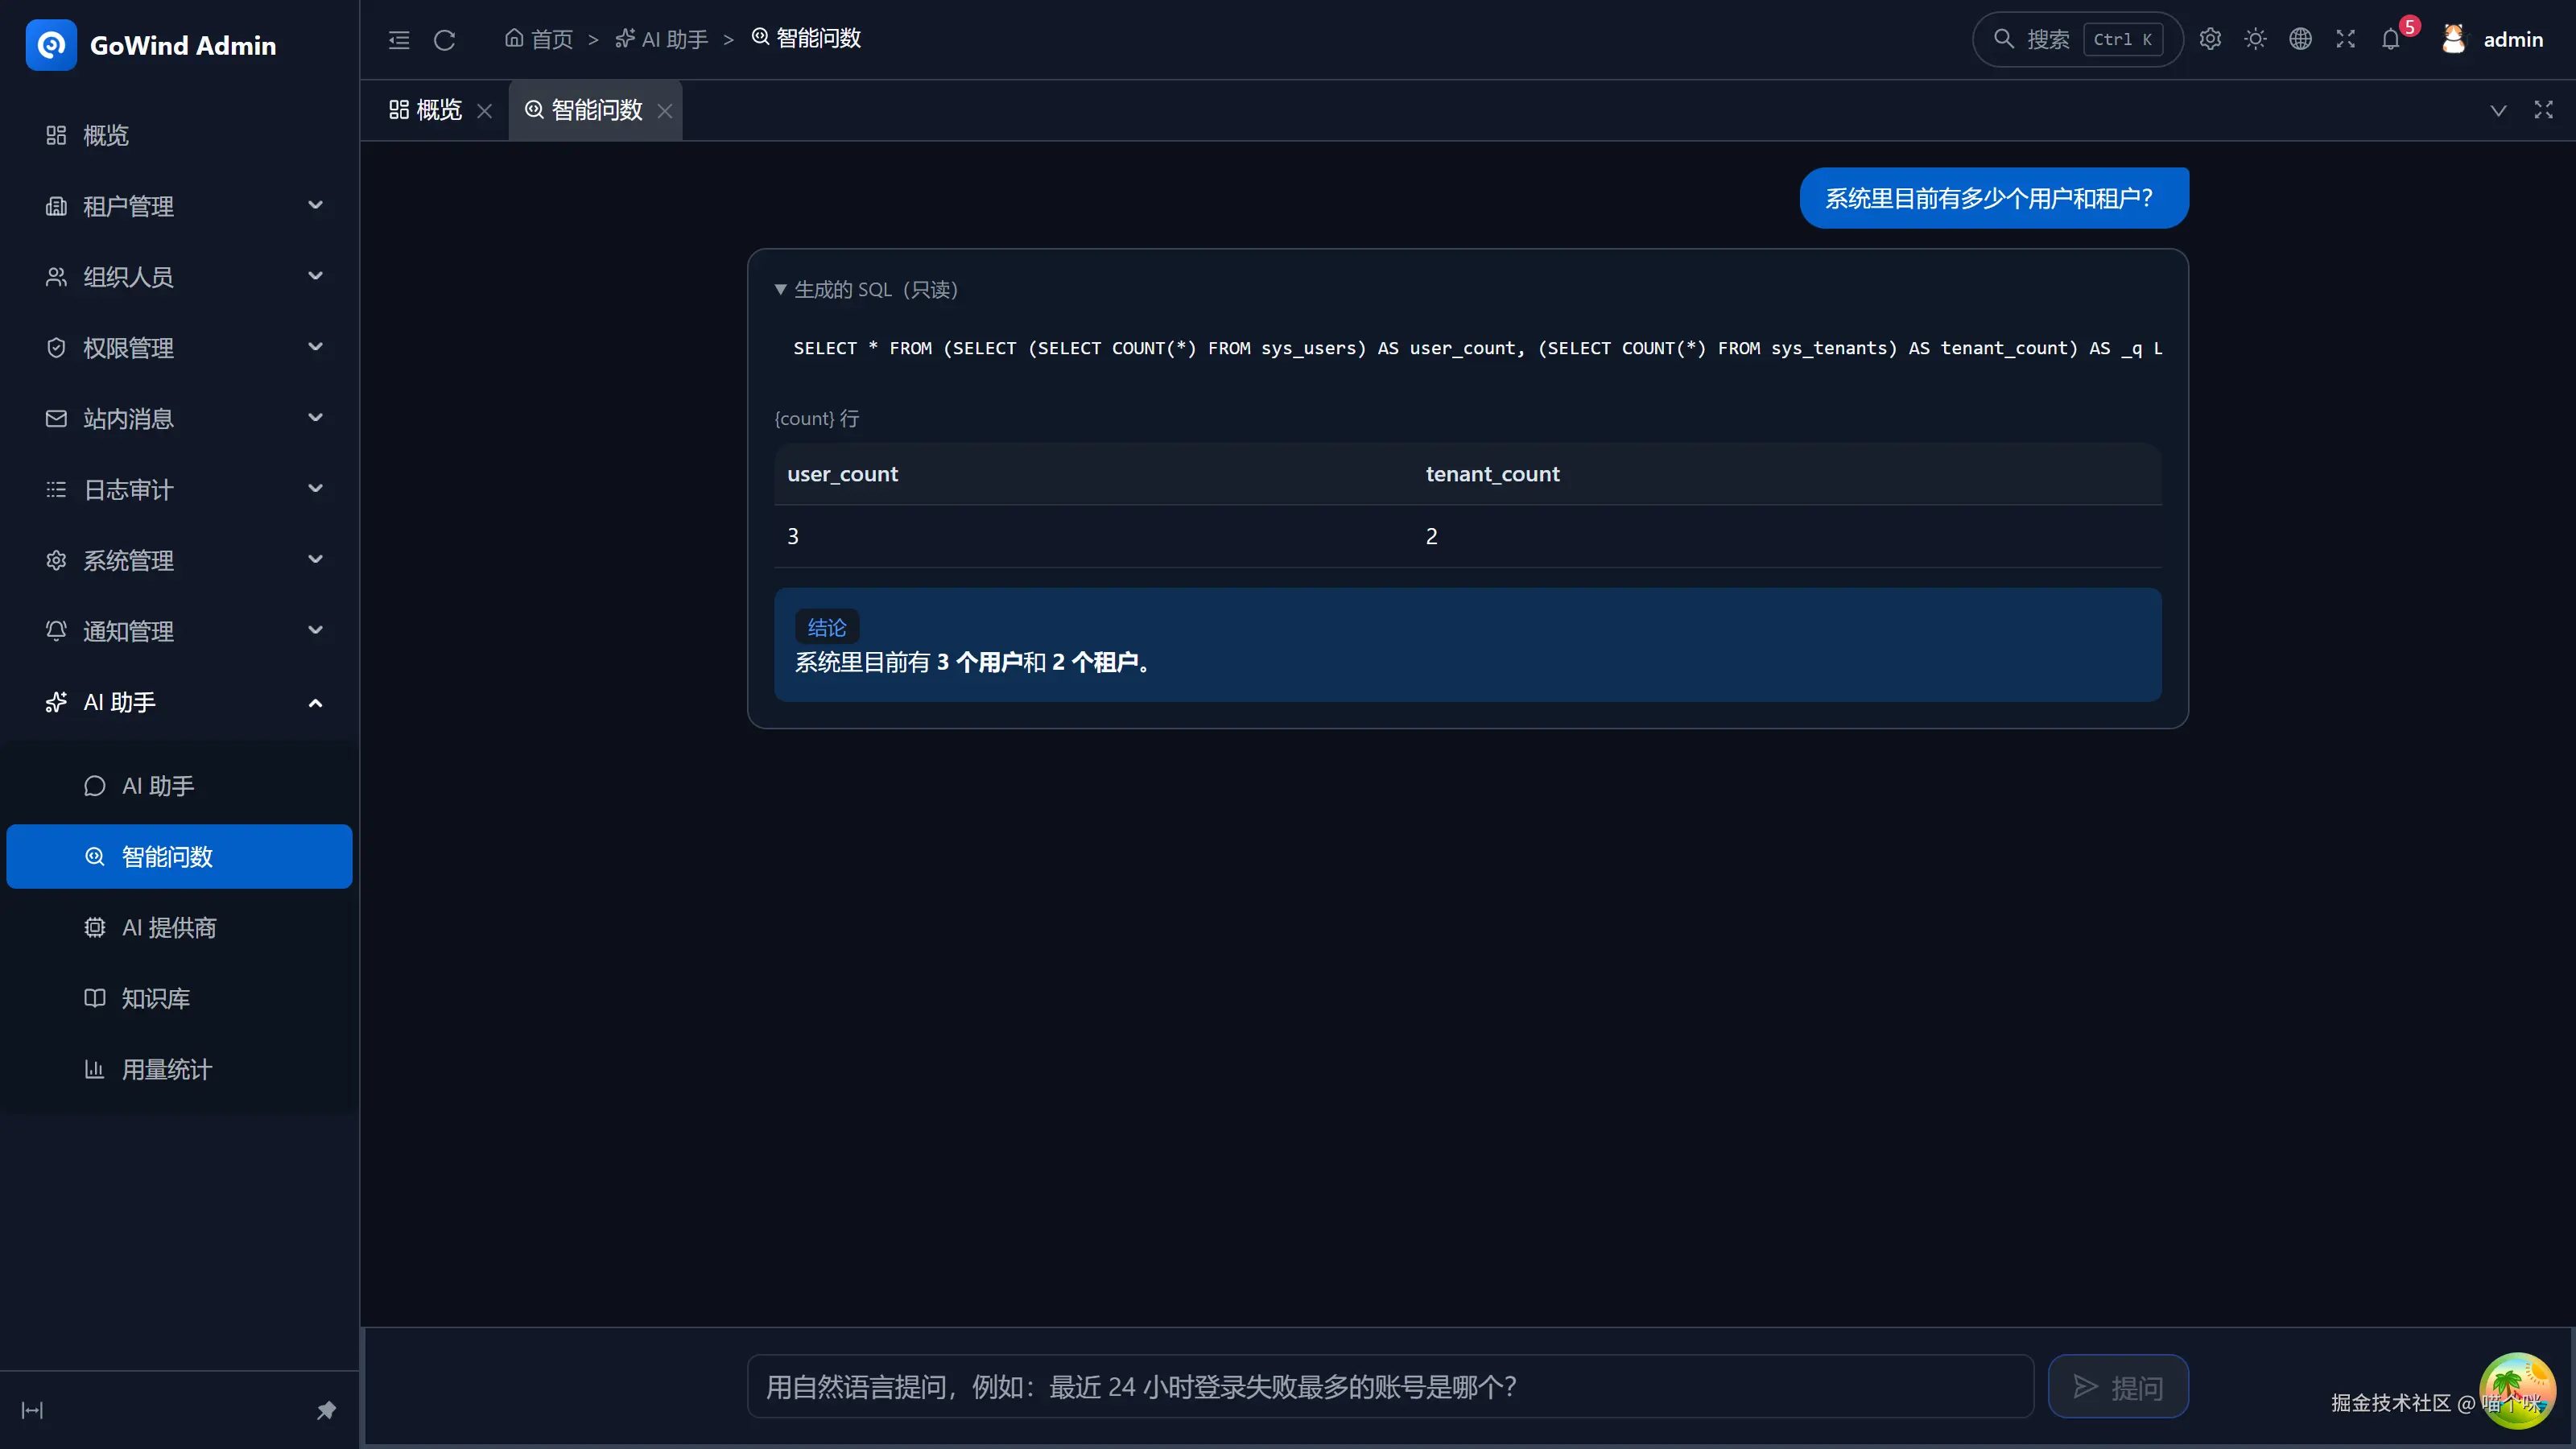
- 只读语句 :仅
SELECT/WITH开头;INSERT/UPDATE/DELETE/DROP、危险函数、多语句、SQL 注释一律拒绝; - 表白名单 :
FROM/JOIN涉及的每张表逐一对照白名单------租户用户只能查 6 张本租户数据表,平台级表(租户表、套餐表)不可见; - 租户谓词强制 :租户生成的 SQL 必须自带
tenant_id = 自身ID,缺失即拒绝(fail-closed); - LIMIT 钳制 + 只读事务 :缺失补 100、超限改写,数据库层
READ ONLY事务兜底。
六、用量配额:AI 消耗进 SaaS 计费体系
每次成功调用(对话、embedding、问数,全部口径)写入 sys_ai_usage_logs 用量流水,按月聚合对照套餐配额 AI_TOKENS:
- 超限返回 400,未配置该维度 = 不限量;
- 平台管理员(tenant_id=0)跳过检查;
- 租户能否用 AI,由套餐模块白名单 统一控制------套餐管理里勾选
AI模块即可开通/停用一个租户的 AI 能力,这就是 SaaS 化运营的商业开关。
配合「用量统计」页(摘要卡 + 流水列表同口径),租户管理员对自己这个月的 token 消耗一目了然。
七、安全与异常洞察:规则筛事实,模型只写总评
分析页的「AI 安全与异常洞察」卡片,思路是告警必须是确定性事实:
| 信号(24h 窗口) | 严重度 | 规则 |
|---|---|---|
| 疑似口令尝试 | HIGH | 单账号登录失败 ≥3 次 |
| 非常规时段操作 | MEDIUM | 本地 0-6 点的操作 |
| 操作失败集中 | MEDIUM | 单用户失败操作 ≥3 次 |
| 敏感操作 | LOW | DELETE/EXPORT/ASSIGN 明细 |
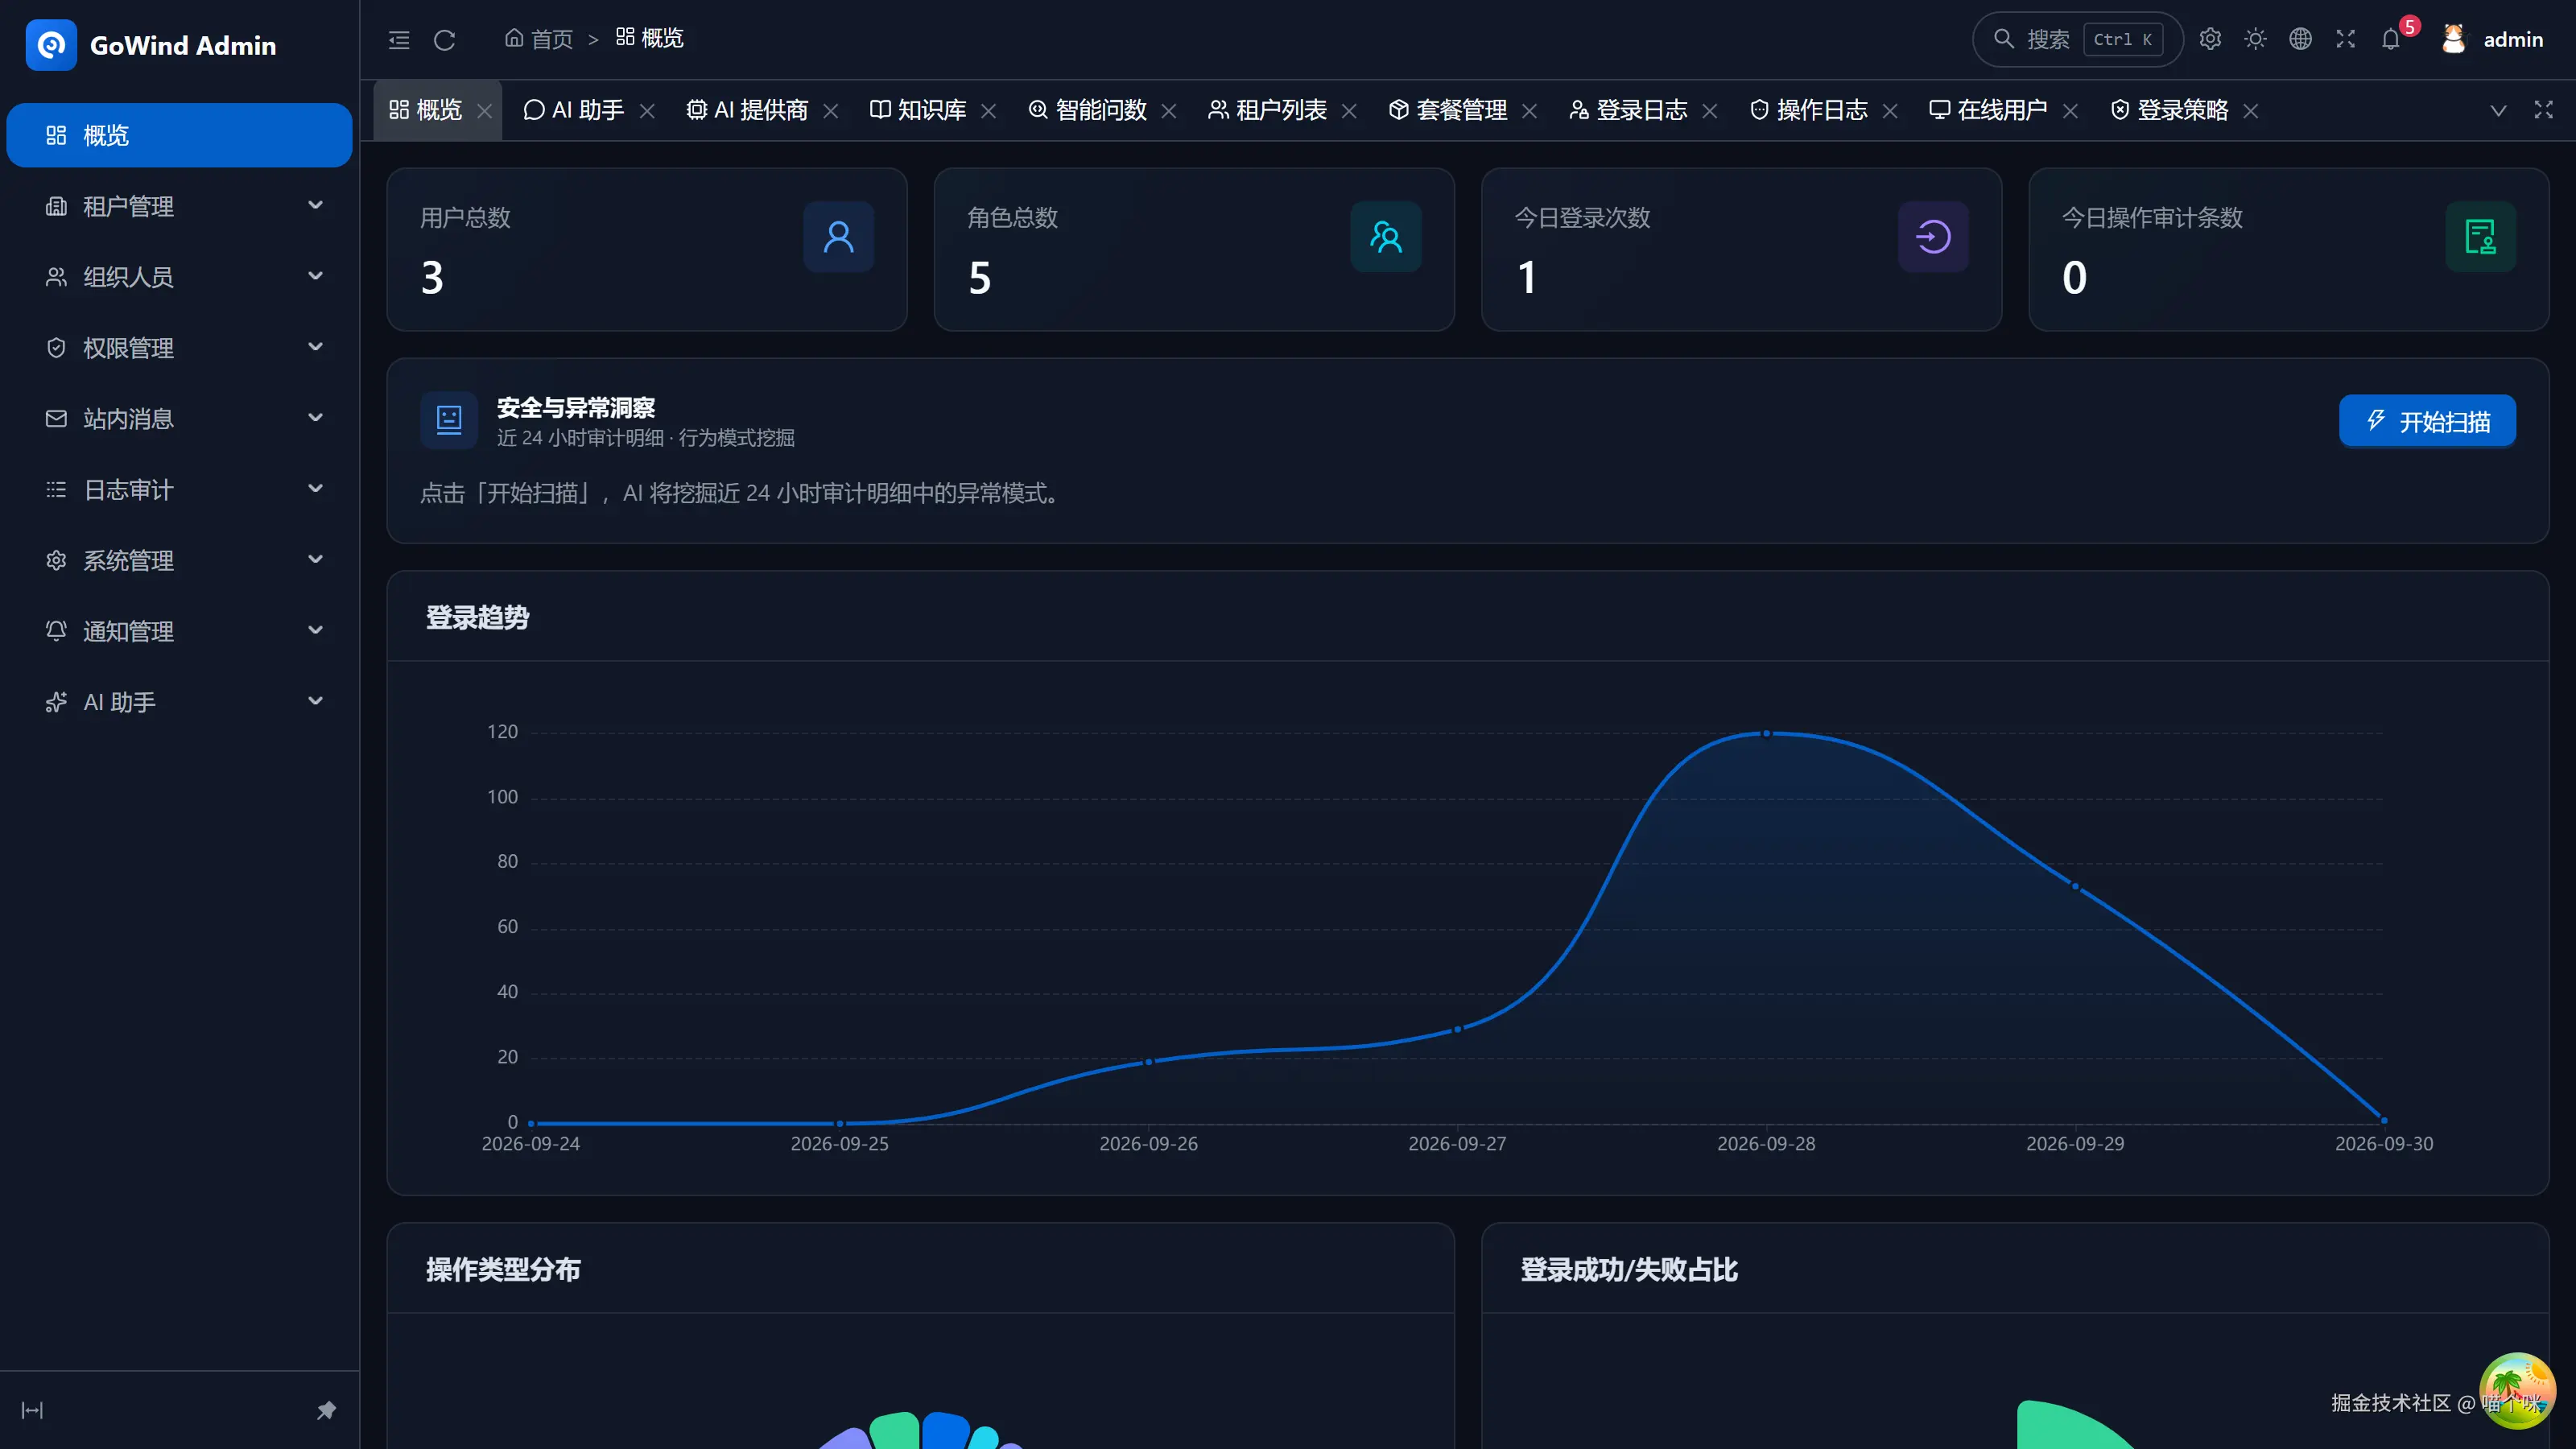
规则预筛审计明细、输出结构化告警,LLM 只生成总体评估措辞;无告警时不调模型------既不浪费 token,也不给模型编造异常的机会。后端只回结构化事实(severity/type/facts),告警标题与明细由前端 i18n 模板按界面语言渲染。
八、集成到业务:脚本与定时任务
AI 能力不止于页面,两条集成路径让它长进业务里:
- 脚本里调模型 :脚本(JS/Lua)内置
ai模块------ai.chat(content)/ai.chatWith(providerId, content)。实体钩子、定时脚本里都能用(例如user.after_create自动生成欢迎语),每次调用自动记用量; - 定时 AI 任务 :内置
ai_audit_digest系统常驻任务(每日 08:00),聚合昨日操作审计生成中文日报并站内信投递;自定义 AI 批处理任务可照此模式注册新的任务类型。
九、本地开发与演示
无真实 key 也能全链路开发:仓库自带的 mock LLM 服务(OpenAI 兼容,echo 对话 + 可断言 embeddings)可替代真实模型打通全部链路;生产环境在管理页配置真实 provider 即可切换。
结语
把 AI 做成平台模块而不是业务代码里的胶水调用,意味着:换模型不发版、用量可审计、租户可管控、数据可出域也可不出域(本地 Ollama)。这套路由密钥管理 → 流式对话 → RAG → 配额计费的完整链路,全部开箱即用。
项目地址 :github.com/tx7do/go-wi... / gitee.com/tx7do/go-wi...
在线演示 :demo.admin.gowind.cloud(前端)/ api.demo.admin.gowind.cloud/docs/(后端 Swagger)