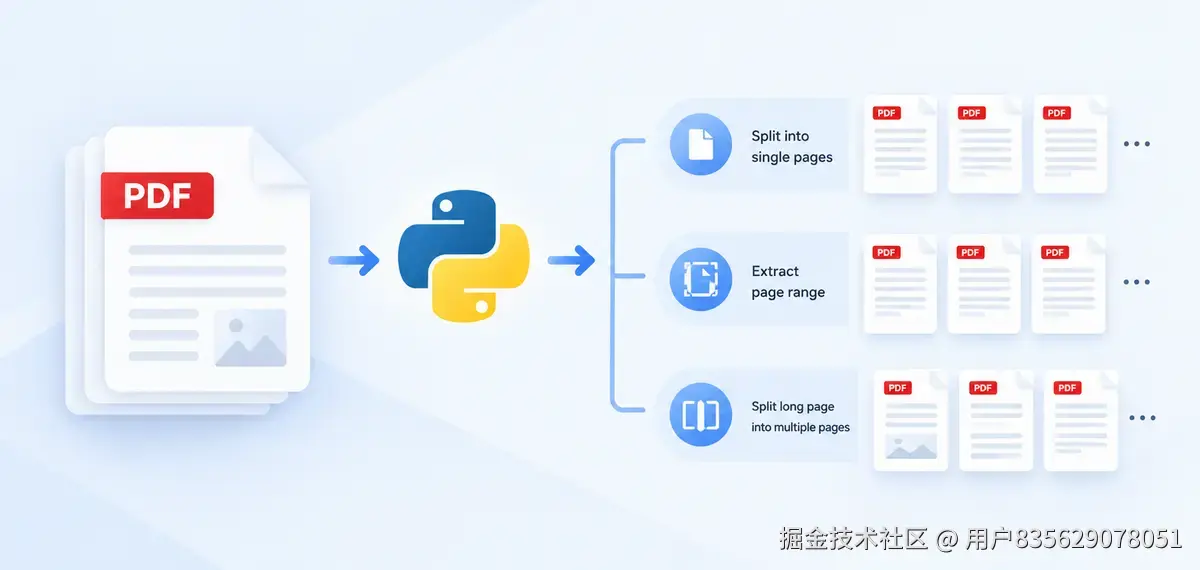
实际工作中经常拿到几十页甚至上百页的 PDF------合并的季度报告、扫描的合同、批量导出的发票。接收方往往只需要其中几页:把单页拆成独立文件分发,或者抽取某个页码区间交给不同的人处理。手动用 PDF 编辑器拆分既低效又难以批量。用 Python 可以按页拆分整个文档、提取指定页码、甚至把一个超长页面切成多页,方便接入自动化流程。本文以 Spire.PDF for Python 为例,演示这三种常见的拆分方式。
为什么用 Python 拆分 PDF
通过脚本拆分 PDF 有几个实际好处:
- 批量处理:一次脚本处理成百上千个文件,无需人工逐个操作。
- 拆分粒度灵活:既可以整档逐页拆,也可以只提取指定页,或对单个超长页面再切分。
- 易于集成:拆分只是流水线中的一步,可以和下载、归档、邮件发送等操作衔接。
环境准备
安装 Spire.PDF 库:
bash
pip install Spire.PDF在脚本中引入模块:
python
from spire.pdf import *
from spire.pdf.common import *
将 PDF 拆分为单页文档
最直接的拆分方式是让每一页都变成一个独立的 PDF 文件。PdfDocument.Split() 用一个文件名模板即可完成,无需逐页操作:
python
from spire.pdf import *
from spire.pdf.common import *

# 加载 PDF 文档
doc = PdfDocument()
doc.LoadFromFile("Sample.pdf")

# 按文件名模板拆分,每一页生成一个独立 PDF
doc.Split("SplitDocument-{0}.pdf")

doc.Close()
Split() 接收一个包含 {0} 占位符的文件名模板,占位符会被替换成页码索引(从 0 开始)。一个 10 页的文档执行后会生成 SplitDocument-0.pdf 到 SplitDocument-9.pdf 共 10 个单页文件。拆分完成后调用 Close() 释放文档占用的资源。
提取指定页面生成新 PDF
更多场景是不需要全部页面,只挑出某几页组成新文档。思路是:新建一个 PdfDocument,为每个要提取的源页面添加一个同尺寸的新页面,再把源页内容绘制进去:
python
from spire.pdf import *
from spire.pdf.common import *

# 加载源文档
oldPdf = PdfDocument()
oldPdf.LoadFromFile("Sample.pdf")

# 新建目标文档
newPdf = PdfDocument()
page = None

# 提取索引 1、2 两页(页码从 0 开始)
for i in range(1, 3):
    # 添加与源页面同尺寸的页面
    page = newPdf.Pages.Add(oldPdf.Pages[i].Size, PdfMargins(0.0))
    # 把源页面内容绘制到新页面
    oldPdf.Pages[i].CreateTemplate().Draw(page, PointF(0.0, 0.0))

newPdf.SaveToFile("ExtractPages.pdf")
newPdf.Close()
oldPdf.Close()
Pages.Add() 的第一个参数传入源页面的 Size,保证新页面与源页面尺寸一致;PdfMargins(0.0) 把新页面边距设为 0,避免内容错位。CreateTemplate() 为源页面生成一个绘制模板,Draw() 把它原样画到新页面上,内容和排版都不会丢失。循环范围 range(1, 3) 表示提取第 2、3 页------改这个范围就能提取任意页码组合。
将一个长页面拆分为多页
还有一类特殊需求:源 PDF 里有一张很长的页面(比如长截图、连续表格),希望按标准页高切成多页。做法是新建一个高度只取源页一半的文档,再利用自动分页布局绘制源页内容:
python
from spire.pdf import *
from spire.pdf.common import *

# 加载源文档并获取第一页
doc = PdfDocument()
doc.LoadFromFile("LongPage.pdf")
page = doc.Pages[0]

# 新建文档:边距为 0,宽度不变,高度取源页的一半
newPdf = PdfDocument()
newPdf.PageSettings.Margins.All = 0.0
newPdf.PageSettings.Width = page.Size.Width
newPdf.PageSettings.Height = page.Size.Height / float(2)

# 添加新页面并设置自动分页布局
newPage = newPdf.Pages.Add()
format = PdfTextLayout()
format.Break = PdfLayoutBreakType.FitPage
format.Layout = PdfLayoutType.Paginate

# 绘制源页内容,内容超出页高时自动换页
page.CreateTemplate().Draw(newPage, PointF(0.0, 0.0), format)

newPdf.SaveToFile("SplitOnePage.pdf")
newPdf.Close()
doc.Close()
关键在 PdfTextLayout 的两个属性:Layout = PdfLayoutType.Paginate 表示绘制内容超出页面时自动分页,Break = PdfLayoutBreakType.FitPage 表示按页面高度截断。由于新页面高度是源页的一半,一页长内容会被平铺到两个标准页上;把高度除数改小,还能切成更多份。
实用提示
- 输出位置 :
Split()的文件名模板里可以带上路径前缀(如"output/SplitDocument-{0}.pdf"),让拆分结果直接输出到指定目录。 - 页码从 0 开始 :提取页面时先用
doc.Pages.Count确认总页数,再决定循环范围,避免索引越界。 - 拆分粒度 :长页切分时,
Height除以的数字越小,切出的页数越多,可按实际内容高度调整。 - 资源释放 :源文档和目标文档用完都调用
Close(),批量处理时尤其重要。 - 免费版限制:Spire.PDF 的免费版对处理的页数有限制,大批量或大文档场景需注意这一约束。
总结
本文介绍了用 Python 拆分 PDF 文档的三种常见方式:用 Split() 把整个文档逐页拆成单页文件,用 CreateTemplate().Draw() 把指定页码提取成新文档,以及借助 PdfLayoutType.Paginate 自动分页把一个长页面切成多页。结合文件遍历和页码计算,这些操作可以轻松嵌入批量拆分、按人分发文档等自动化流程中。