苦猿的大模型日记 · Day65 · 从0学习Claude Code(十五)Harness集成-帮普通人把AI学进简历系列
前言:零件全有了,车还跑不起来
本篇干一件事:不引入任何一个新机制 ,把前面攒下的所有零件------工具分发、权限、Hooks、todo、子 agent、技能、记忆、上下文压缩、后台任务、定时调度、团队、worktree、MCP------全部装回同一个 while True。
先说实话,这是整个系列最难的一篇。难的不是新知识,是集成。
那些零件单独都会跑:权限示例能拦命令,记忆示例能存偏好,定时示例能到点触发。可真把它们倒进同一个工程,问题立刻排队上门:
- cron 到点的提醒,怎么送进正在跑的对话?
- 后台任务完成了,谁来告诉 Agent?
- 队友发来的 plan,排在用户问题前面还是后面?
- 上下文压缩和记忆注入,谁先谁后?
- 用户正在敲键盘,定时任务到点了,两轮对话撞车怎么办?
每一个单拎出来都不难,难的是它们共享同一段对话、同一个工具池、同一份上下文预算------动任何一个,其他全部跟着晃。
读完这篇,你会拿到三样东西:
- 一张全景图:十几种机制,各自挂在循环的哪个位置
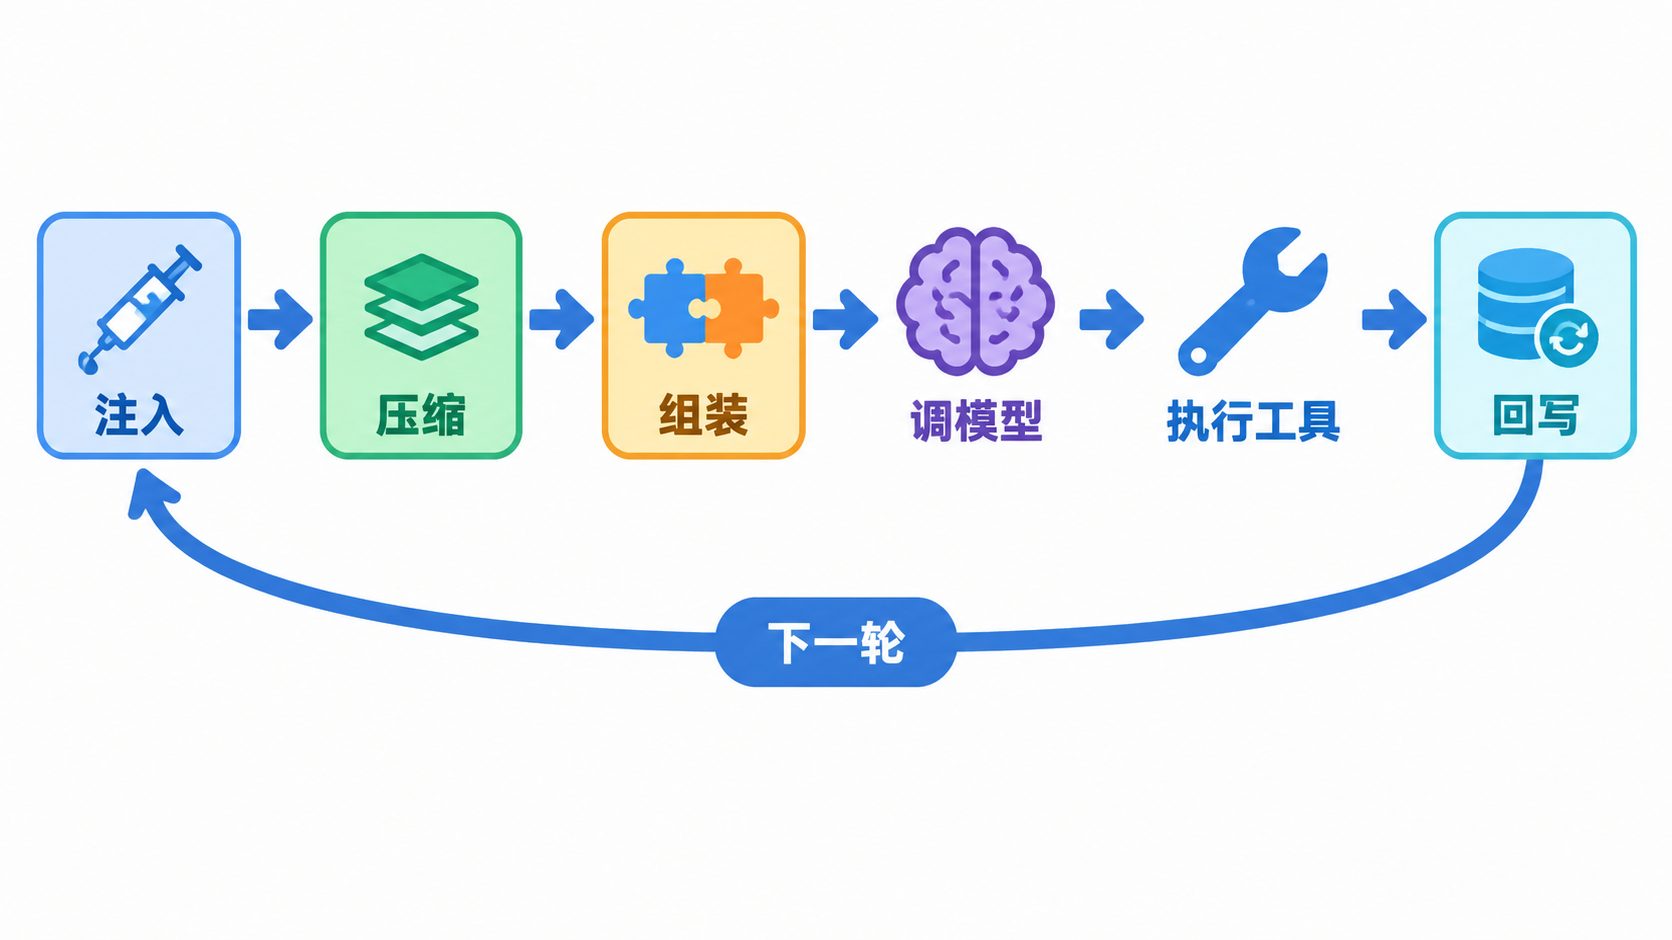
- 逐段读懂主循环的能力:一轮从进门到出门,到底发生了什么
- 事件驱动机制:Agent 跑完一轮就睡了,是谁把它叫醒的
门槛不变:一路跟到现在的读者直接开跑;新来的朋友只需要记住一句话------Agent 循环 = 调模型 → 看响应里有没有工具调用 → 有就执行、结果回消息。
PART 01:集成第一决策------循环一个都不多
先看最反直觉的地方。这个集成版的 Agent,工具从最早的 5 个涨到了 26 个 ,机制从 0 涨到了 13 种,但主循环的结构一行没变:
调用模型
  → 响应里有 tool_use block?
      没有 → 本轮结束
有 → 执行工具 → 结果追加回 messages → 下一轮还是那三步。这不是偷懒,是整个集成方案里最重要的一条纪律:循环结构不许动。
为什么?因为循环是全系统的主干道。每加一个机制就改一次循环,改到第十次,循环会变成一坨谁也不敢碰的面条------每个机制都认识其他所有机制,牵一发动全身。正确的做法反过来:循环不认识任何机制,机制自己找地方挂。
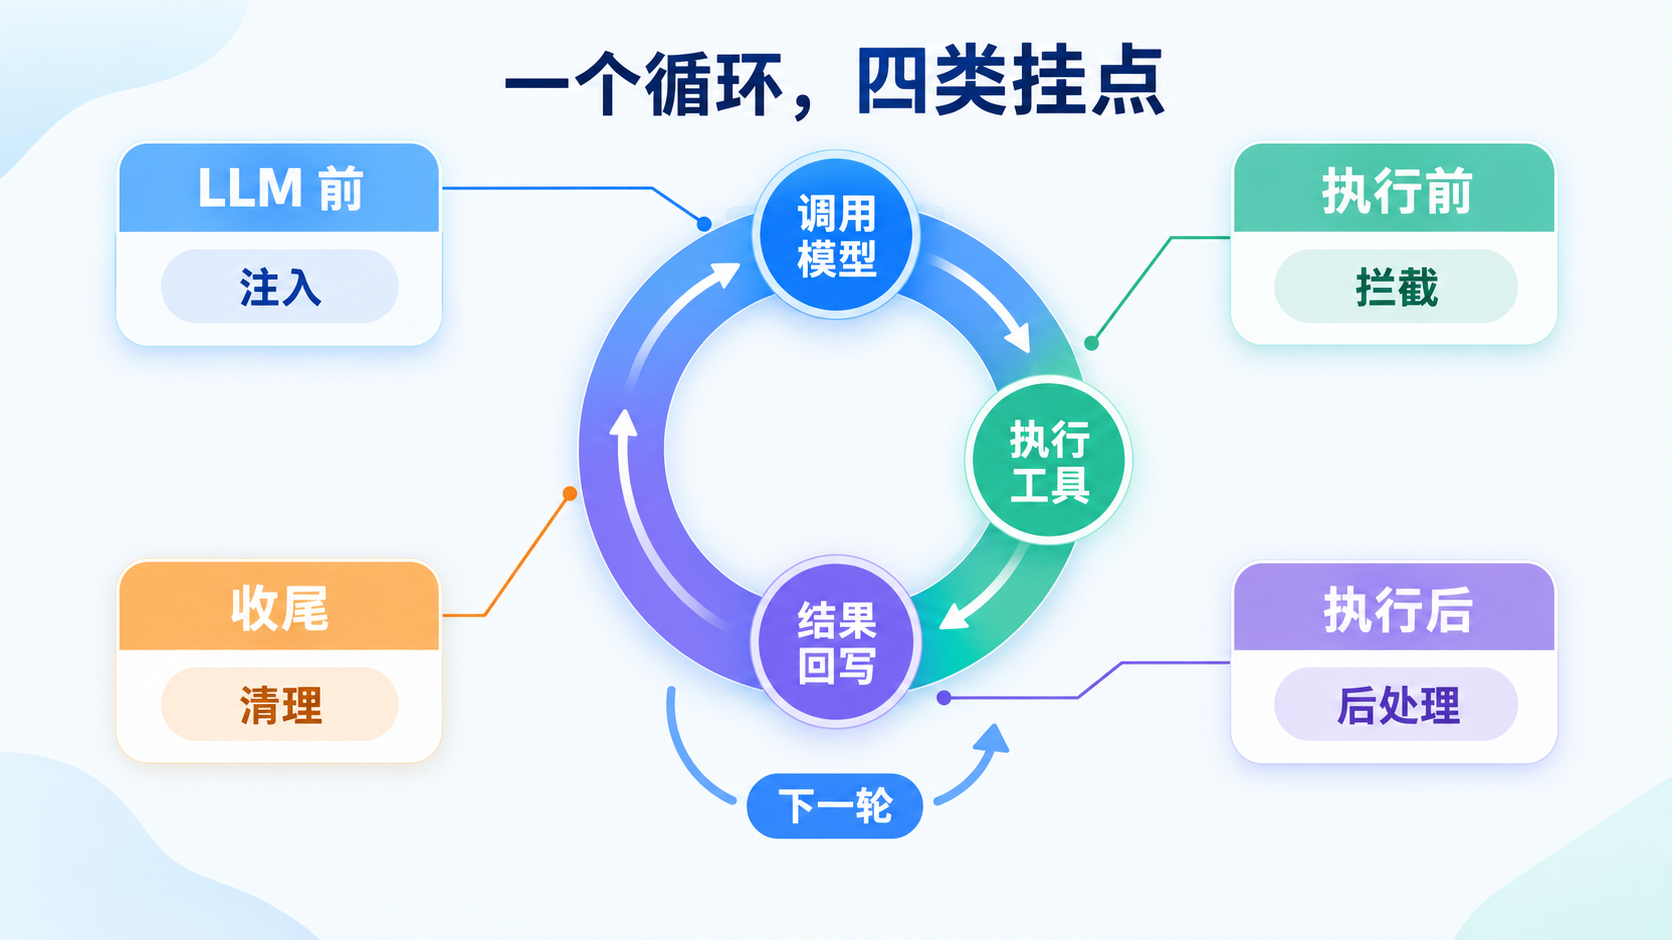
于是整个系统只有四类挂点:
- LLM 前:定时任务、后台通知、压缩管线、记忆和技能组装------把"该带的行李"塞进上下文
- 工具执行前:PreToolUse Hooks + 权限------把"不该执行的动作"拦下来
- 工具执行后:PostToolUse Hooks------大输出告警、日志这些后处理
- 本轮收尾:没有 tool_use、循环要退出时,Stop Hooks 做统计和清理
十几种机制,四类挂点。就像装修房子不用砸承重墙------水管走水管的位置,电线走电线的位置,房子还是那个房子。
机制可以无限加,循环永远是那一个。 这是集成全部设计的前提。
PART 02:主循环逐段拆解------一轮到底发生了什么
把主循环的代码简化后摆出来,这是全篇的主角:
def agent_loop(messages, context, active_request):
    tools, handlers = assemble_tool_pool()
    while True:
        # ① 到点的定时任务,作为 user 消息注入对话
        for job in consume_cron_queue():
            messages.append({"role": "user",
                             "content": f"[Scheduled] {job.prompt}"})

        # ② 后台任务完成的通知,同样注入对话
        inject_background_notifications(messages)

        # ③ 连续三轮没碰 todo,提醒它更新计划
        if rounds_since_todo >= 3:
            messages.append({"role": "user",
                             "content": "<reminder>Update your todos.</reminder>"})

        # ④ 压缩管线 + 组装 system prompt 和工具池
        prepare_context(messages, active_request)
        context = update_context(context, messages)
        tools, handlers = assemble_tool_pool()

        # ⑤ 调模型(外面包着错误恢复)
        response = call_llm(messages, context, tools, state, max_tokens)
        messages.append({"role": "assistant", "content": response.content})

        if not has_tool_use(response.content):
            trigger_hooks("Stop", messages)      # 没有 tool_use,本轮结束
            remember_after_turn(messages)        # 提取记忆
            return

        # ⑥ 逐个执行工具,结果回 messages
        results = []
        for block in response.content:
            if block.type != "tool_use":
                continue
            blocked = trigger_hooks("PreToolUse", block)   # 权限在这拦
            if blocked:
                results.append(tool_result(block.id, blocked))
                continue
            output = call_tool_handler(handlers[block.name], block.input)
            trigger_hooks("PostToolUse", block, output)
            results.append(tool_result(block.id, output))
        messages.append({"role": "user", "content": results})
逐段看。
①② 是全篇最值钱的一个设计 :cron 到点的提醒、后台任务的完成通知、队友发来的消息------统统变成 messages 里一条 role: "user" 的内容。
不管事件从哪来(定时器、后台线程、队友收件箱),进入对话的姿势只有一种:变成一条用户侧消息。对模型来说,它看到的永远只是一段对话,根本不知道也不需要知道这条消息背后是哪个机制产生的。
我把这叫统一货币:所有事件先兑换成 messages,再进循环。没有"cron 专用通道",没有"后台任务专用格式"。谁想给模型递话,谁就学会说 messages 这一种语言。
③ 是防漂移的细节 。Agent 干活一上头,三四个工具轮过去,早把最初的任务清单忘干净了,越干越歪。这里连续三轮没碰 todo_write,就插一条提醒。成本几乎为零,效果是把跑偏的 Agent 拽回来。
④ 是上下文的账房先生。调模型前先过四级压缩管线:
tool_result_budget → snip_compact → micro_compact → compact_history先给大块工具输出套预算,再裁中段,超限了才动摘要------能裁就不删,能删才总结 ,每一步都比下一步便宜。而且裁剪手下有分寸:micro_compact 只在真超限时才动手,动手也只替换"较早且已经读过"的结果,最近 3 条消息永远保持完整,逼近阈值的 80% 就停手------宁可这轮少省一点,也不让模型突然失忆,忘了自己刚干了什么。
同一时刻,记忆、技能目录、已连接的 MCP server 也组装进 system prompt,工具池现场重新拼一次------上一轮刚连上的 MCP server,这一轮的工具就位。
⑤ 外面那层错误恢复 上一批就位了:429 退避重试、529 切备用模型、max_tokens 先升档再要续写、prompt 太长触发应急压缩。集成版没加新东西,只是确认它们在总装车上还灵。
⑥ 是三岔路口 。每个 tool_use block 走到这,面临三种命运:被 PreToolUse 拦下(返回拒绝理由,也算一种 tool_result);标记了后台执行的 bash(拿占位符走人,真结果以后以通知形式回来);正常前台执行。三条路殊途同归------都变成 tool_result,都回 messages。
你看,又是统一货币。事件进来是货币,结果出去还是货币。整个系统里只有一种数据在流动。
PART 03:权限不是一层 if,是一个挂点
总装车上最容易被低估的,是权限的位置。
直觉写法是把权限写成工具执行旁边的一层 if:if 危险: 拦下。单文件示例这么写没问题,集成版这么写会漏------你自己写的工具拦住了,那队友调用的工具呢?一次性 subagent 调用的呢?MCP 插进来的外部工具呢?
而且集成版的工具池本身就不固定。每轮调模型前,assemble_tool_pool() 现场把两路工具合进一个池子:
def assemble_tool_pool():
    tools = list(BUILTIN_TOOLS)          # 26 个内置工具
    handlers = dict(BUILTIN_HANDLERS)
    for server_name, client in mcp_clients.items():
        for tool_def in client.tools:
            prefixed = f"mcp__{server_name}__{tool_def['name']}"
            if prefixed in origins:      # 规范化后撞名,当场炸
                raise ValueError(
                    f"MCP tool name collision: {prefixed!r}")
            tools.append(to_mcp_schema(tool_def))
            handlers[prefixed] = client.call_tool
    return tools, handlers
内置 26 个打底,MCP server 连几个就动态插几个,connect_mcp("docs") 之后下一轮池子里就多出 mcp__docs__search。注意那个撞名检查:两个 server 的工具规范化之后名字撞了,当场抛异常,绝不悄悄合并------两个同名工具悄悄变成一个,调用路由到错误的 server,这种 bug 出了根本查不到。
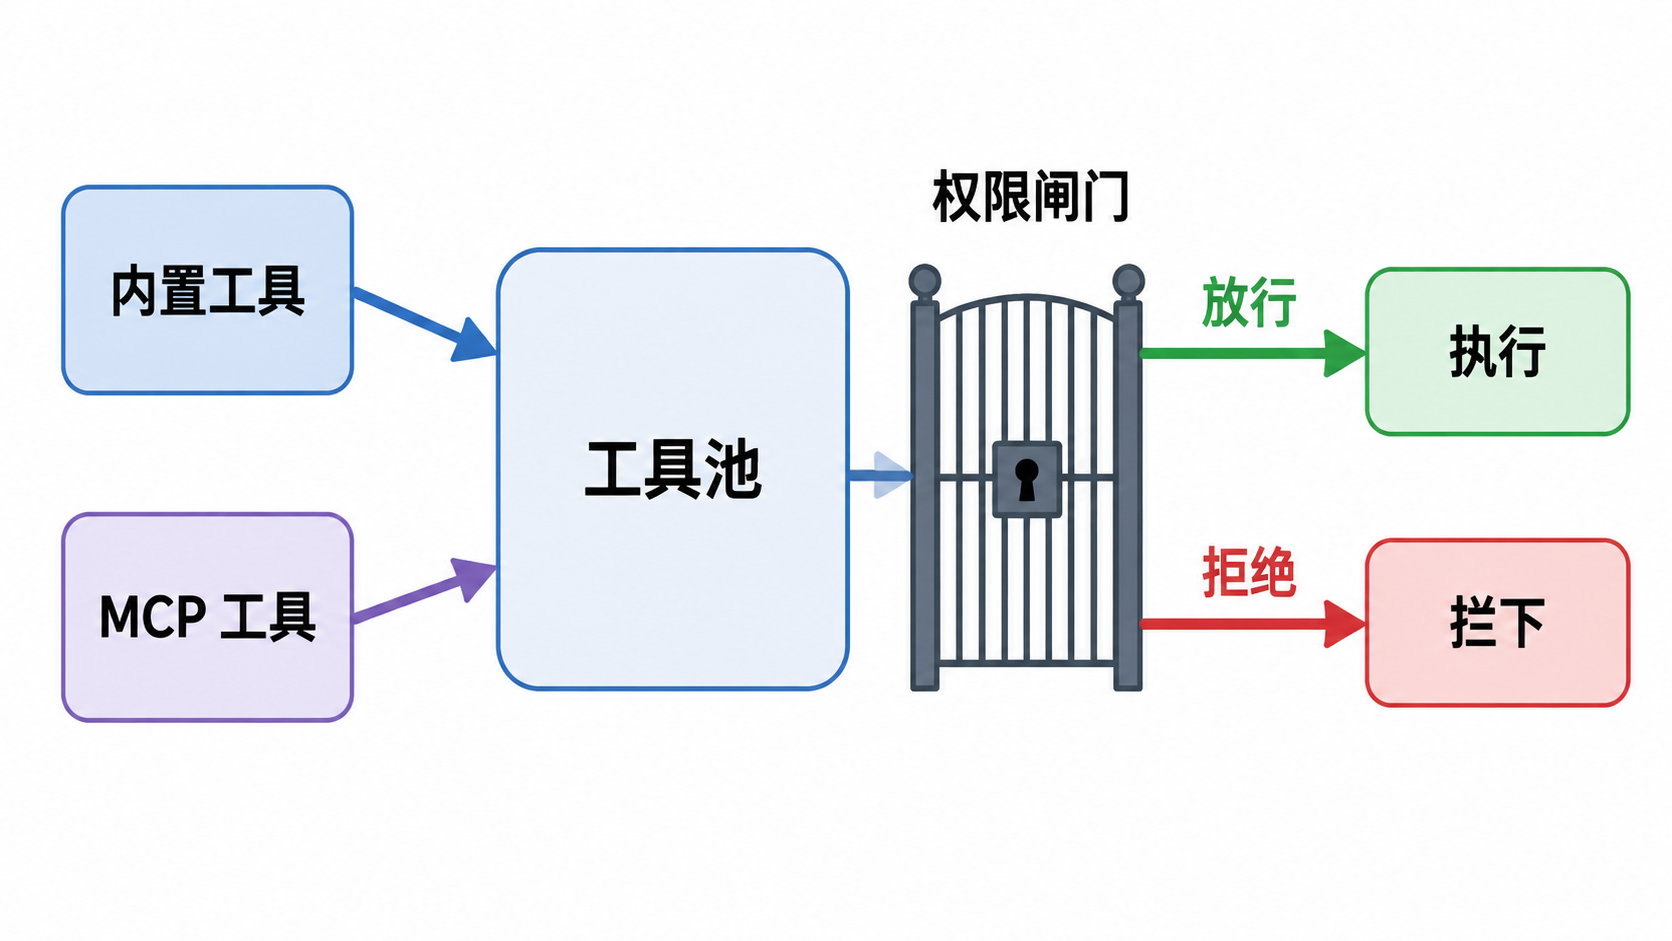
池子是动态的,权限更不能绑死在某个工具的实现里。集成版的答案:权限不写在执行处,写成 PreToolUse Hook。看简化后的代码:
def permission_hook(block):
    if block.name == "bash":
        command = block.input.get("command", "")
        for pattern in DENY_LIST:              # rm -rf /、sudo、mkfs 这些
            if pattern in command:
                return f"Permission denied: '{pattern}' is on the deny list"
        if threading.current_thread() is not threading.main_thread():
            return ("Permission denied: interactive shell approval is "
                    "unavailable during an asynchronous turn")
        if CONSOLE.ask("  Allow? [y/N] ") not in ("y", "yes"):
            return "Permission denied by user"

    if block.name in ("read_file", "write_file", "edit_file"):
        path = block.input.get("path", "")
        if not (WORKDIR / path).resolve().is_relative_to(WORKDIR):
            return "Permission denied: path is outside the workspace"

    if block.name.startswith("mcp__") and \
            mcp_tool_policies.get(block.name, "confirm") != "allow":
        if CONSOLE.ask("  Allow? [y/N] ") not in ("y", "yes"):
            return "Permission denied by user"

    return None       # None = 放行
这么挂之后,主循环里只剩一句 trigger_hooks("PreToolUse", block)。Lead 的工具、subagent 的工具、队友线程的工具,全部从这道门过------因为门挂在主干道上,没有旁路可绕。
而且 Hook 是可以排队的:permission 挂一个,日志再挂一个,审计再挂一个,互不认识,各司其职。权限从"工具执行的一部分"升级成了"主干道上的独立检查站"。
这段代码里还藏着两处容易被忽略的工程品味。
第一处,MCP 工具的默认值是 confirm 。宿主自己维护一份精确的已知只读工具名单(比如 mcp__docs__search),名单之外的 MCP 工具一律问用户。为什么不让 server 的 description 说了算?因为 description 是 server 自己写的------自我介绍不能当授权书。一个标着"只读查询"的工具,谁知道它背后干了什么。
第二处,那句线程检查 。threading.current_thread() is not threading.main_thread()------非主线程直接拒绝需要交互确认的操作。为什么?因为异步轮次(下面马上讲)可能发生在用户正在终端里敲字的时候,这时候弹一个"Allow? y/N"出来,会跟用户正在输入的内容抢终端,两边都是灾难。所以宁可拒绝,不抢输入。
对危险动作,宁可错过,不可错放;对用户终端,宁可拒绝,不可打扰。
PART 04:睡着的 Agent,谁来叫醒
前面留了个坑:主循环跑完一轮就 return 了,Agent 就此睡着。那第二天早上九点的定时任务谁来执行?后台装依赖装完了谁来接着干活?
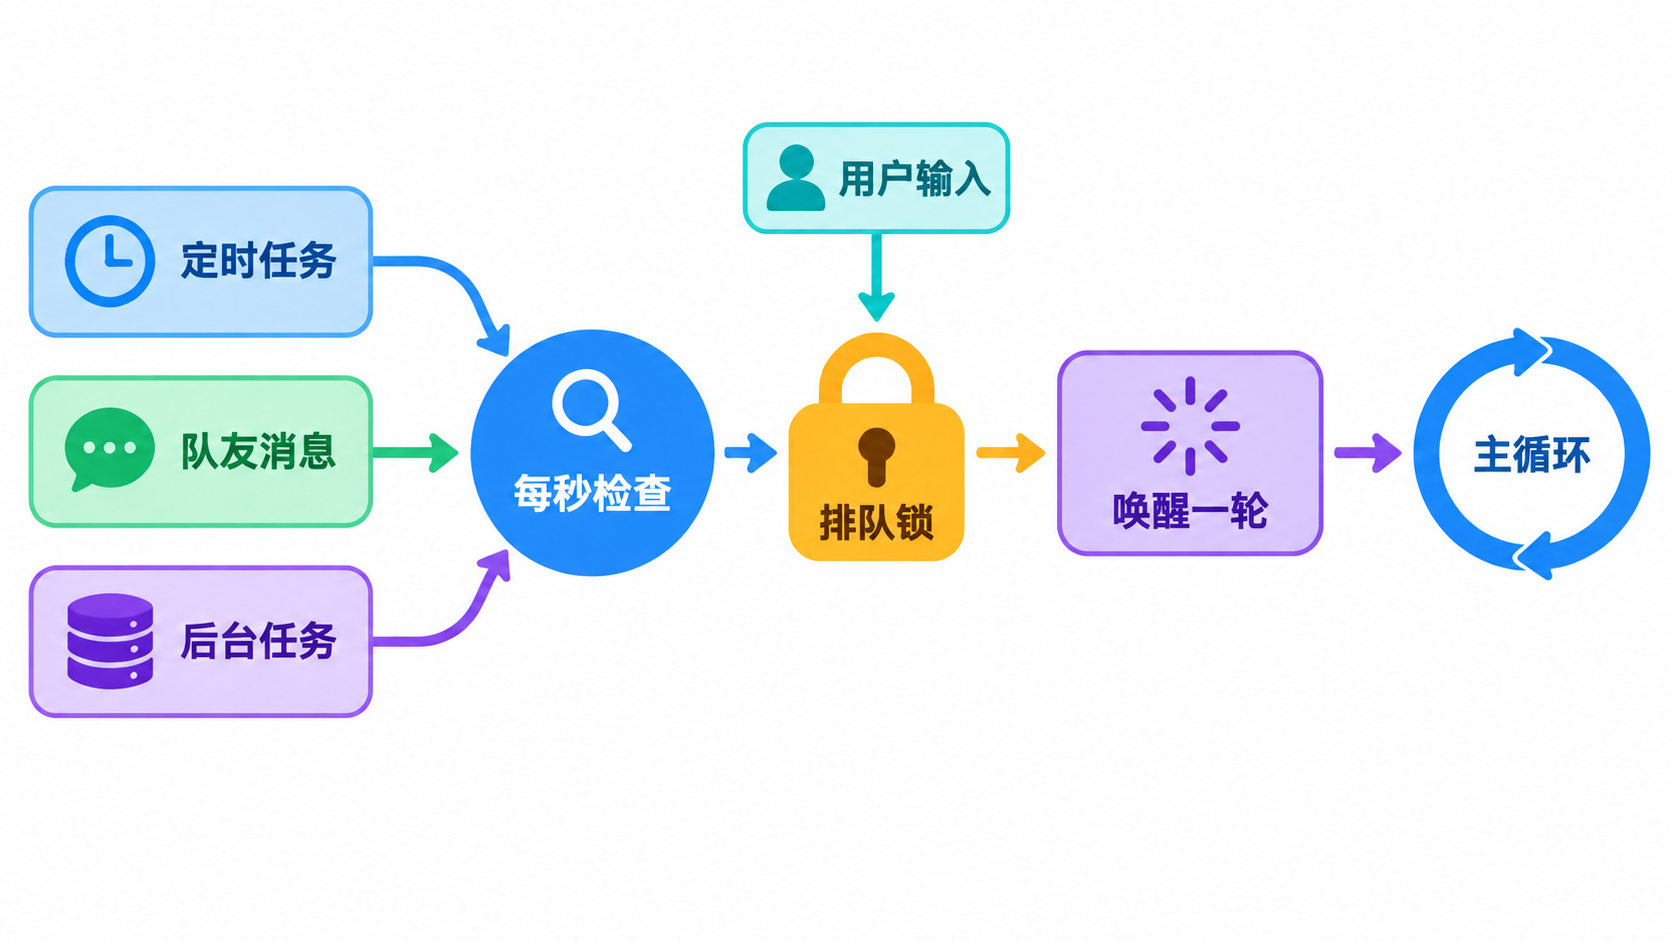
答案是集成版真正的第二个循环------事件循环:
def async_event_loop(history, context, session_state):
    while True:
        time.sleep(1)
        with agent_lock:                        # 和用户输入抢同一把锁
            fired = list(cron_queue)            # 事件源①:到点的定时任务
            inbox = consume_lead_inbox()        # 事件源②:队友消息/plan/关机
            if not fired and not inbox \
                    and not has_pending_background():
                continue                        # 事件源③:后台任务。全空,接着睡
            ...
agent_loop(history, context, active_request)这个后台线程每秒醒一次,检查三个事件源:cron 队列、Lead 收件箱、已完成的后台任务 。三个全空,接着睡;任何一个有货,就叫醒一轮 agent_loop。
注意那把 agent_lock。用户在前台敲一个问题会触发一轮循环,事件循环也可能同时想触发一轮------两轮对话操作的是同一份 history ,并发跑必然写花。所以两边抢同一把锁:用户在用,事件循环排队等;事件循环在跑,用户输入等它跑完。两个循环,一份历史,一把锁。
我拿两个实验跑过它,建议你也试试。
实验一:3 分钟后提醒我开会,然后什么都别干,去泡杯茶。到点你会看到一条 [cron auto] 日志,Agent 自己醒来给自己安排了提醒------全程没人碰键盘。
实验二:在后台安装依赖,同时继续阅读 README.md。bash 被标记成后台执行,主循环立刻拿到占位结果继续读文件;依赖装完,完成通知以事件形式唤醒下一轮。两件事在时间上重叠,在对话里串行------模型看到的永远是一段有条不紊的历史。
最后是 cron 的交付语义,这里有个容易漏想的细节:到点的任务是先攒在 unacknowledged_cron_jobs 里,等包含这条 prompt 的模型调用成功,才确认消费;失败就塞回队列,重启后也会重新入队。
翻译成人话:定时任务的通知是"至少送达一次"。宁可重复提醒你一次开会,绝不悄悄吞掉一次提醒。对一个没人值守的调度系统,吞任务是最恶劣的故障------重复只是烦,丢失是事故。
结尾:从裸循环,到一台完整的 Harness
回顾这一篇的三块核心:循环不动 (结构一行不改,机制自己找挂点,主干道不认识任何一个机制)、统一货币 (cron、后台、队友、工具结果,统统兑换成 messages 再进对话)、事件驱动(主循环睡了,事件循环每秒查三个源,拿同一把锁唤醒它)。
再退远看一眼这辆车:26 个工具、长期记忆、自动压缩、任务图、队友线程、定时调度、可插拔的外部服务。它的第一个形态,是几十行代码、5 个工具、跑两轮就把上下文塞爆的裸循环。
十四篇,每篇只加一个机制;这一篇,把它们装回同一台车------循环本身,还是第一天那三步。
循环只是心跳,挂点才是器官------Agent 的强大,从来不在于跳了多少轮,而在于每一轮前后,长出了什么。
互动时间:如果让你往这个循环上再挂一个机制,你会挂什么?(我先来:一个"预算 Hook",每次调模型前算一遍这轮的 token 成本,超线就拦。)评论区说说你的答案。
下一篇预告:「从0学习 Claude Code」第十六篇------Workflow Runtime。车装好了,下一站解决新问题:有些活儿的步骤是固定的,凭什么每次都让模型现场发挥?把编排路径写进代码、记录运行进度、中断了还能接着跑------工作流运行时,给这台 Harness 装上"自动挡"。
--- END ---
苦猿 · 帮普通人把 AI 学进简历