上一篇我们搞定了 Ceph 集群配置(第3章),集群已经能跑起来了。但是------数据到底存在哪?怎么分类?怎么备份?怎么找回来? 这就是本章《池管理》要回答的灵魂三问 🎯
本章是 Ceph 的核心概念章:Pool(存储池)、PG(放置组)、Object(对象)、CRUSH 算法,全是面试高频考点!学会本章,你就真正理解了 Ceph "数据是怎么躺到磁盘上的"。
📌 你将学到
| 序号 | 知识点 | 难度 |
|---|---|---|
| 1 | Ceph 数据组织:Pool → PG → Object → OSD 四层结构 | ⭐⭐⭐ |
| 2 | PG(放置组)数量怎么算?为什么不能随便设? | ⭐⭐⭐ |
| 3 | 对象映射到 OSD 的完整流程(CRUSH 算法) | ⭐⭐⭐⭐ |
| 4 | Ceph 读数据/写数据的完整链路(含两次确认优化) | ⭐⭐⭐⭐ |
| 5 | 复本池 vs 纠删码池:怎么选?k+m 是什么? | ⭐⭐⭐⭐ |
| 6 | 创建池、查池状态、改复本数、调 PG 数 | ⭐⭐⭐⭐ |
| 7 | rados 命令玩对象:put/get/append/rm/stat/map | ⭐⭐⭐ |
| 8 | 池快照(mksnap/rollback)与命名空间(namespace) | ⭐⭐⭐ |
🎯 为什么要做这个实验(现实运维工作中的作用)
| 场景 | 不懂池管理的后果 | 掌握后的价值 |
|---|---|---|
| 客户说"给我建个 100TB 的池" | PG 数瞎设,集群一上线就卡 | 按 OSD 数科学算 PG 数,一次到位 |
| 存储扩容 | 不知道池里有啥、哪些是热数据 | ceph df 一目了然,容量规划心中有数 |
| 数据误删 | 没快照,数据找不回 | 池快照 + rollback 秒级恢复 |
| 成本敏感项目 | 全用 3 副本,磁盘成本爆炸 | 纠删码 k=4 m=2,省 50% 空间 |
| 排障"对象到底存在哪块盘" | 抓瞎 | ceph osd map 一步定位 |
| 面试 | 只会说"Ceph 是分布式存储" | 张口就是 PG=128/512/4096、强一致性两次写 |
🚨 警钟 :池一旦创建,类型(复本/纠删)就不能改!所以建池前一定要想清楚------本章带你把这个决策逻辑彻底搞明白!
第 4 章 Ceph 分布式存储 池管理
⏪ 先把第3章的防火墙配置收尾
第3章末尾讲到"用防火墙保护 MON 节点",原文给了完整命令,我们一条一条来:
bash
# firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp
# ↑ firewall-cmd: firewalld 防火墙管理命令
#   --zone=Public: 指定 Public 区域(公共区域,即对外的网卡)
#   --add-port=6789/tcp: 放行 6789/tcp 端口(MON 的 v1 协议端口)
#   --add-port=3300/tcp: 再放行 3300/tcp(MON 的 v2 协议端口)
#   作用:让客户端能访问 MON 服务(运行时生效,重启防火墙失效)

# firewall-cmd --zone=Public --add-port=6789/tcp --add-port=3300/tcp --permanent
# ↑ 同上,但多了 --permanent 参数
#   --permanent: 永久生效(写入防火墙配置文件,重启不丢)
#   🎯 小白口诀:不带 permanent 是"试一下",带 permanent 才是"永久保存"!
还可通过添加 ceph-mon 服务至防火墙规则来保护 MON 节点。
bash
# firewall-cmd --zone=Public --add-service=ceph-mon
# ↑ --add-service=ceph-mon: 直接放行"ceph-mon 这个预定义服务"
#   比逐个加端口更省事------firewalld 知道 ceph-mon 服务该开哪些端口

# firewall-cmd --zone=Public --add-service=ceph-mon --permanent
# ↑ 永久放行 ceph-mon 服务
若要配置 cluster 网络,防火墙需要配置 Public 和 cluster 网络规则。客户端通过使用公共网络连接到 OSD,OSD 通过集群网络互相通信。
若要使用防火墙规则保护 OSD 节点,执行以下命令:
bash
# firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp
# ↑ --add-port=6800-7300/tcp: 放行 6800~7300 整个端口范围(OSD/MDS 端口)
#   <public-or-cluster>: 占位符,替换成实际的 zone 名(public 或 cluster)
#   作用:放行 OSD 之间的通信端口

# firewall-cmd --zone=<public-or-cluster> --add-port=6800-7300/tcp --permanent
# ↑ 永久放行 6800-7300 端口段
还可通过添加 ceph 服务至防火墙规则来保护 OSD 节点。
bash
# firewall-cmd --zone=<public-or-cluster> --add-service=ceph
# ↑ 放行预定义服务 ceph(ceph 服务 = OSD 相关端口集合)

# firewall-cmd --zone=<public-or-cluster> --add-service=ceph --permanent
# ↑ 永久放行 ceph 服务
4.1 Ceph 数据组织结构
先建立全局认知:Ceph 里的数据是怎么"分层存放"的?
4.1.1 Pool(存储池)
池是 Ceph 存储集群的逻辑分区,用于在通用名称标签下存储对象。 Ceph 为每个池分配特定数量放置组 (PG),用于对对象进行分组以进行存储。
每个池具有以下可调整属性:
| 属性 | 说明 |
|---|---|
| 池 ID | 系统自动分配的数字编号(如 pool_web 的 ID 是 2) |
| 池名称 | 自定义的名字(如 pool_web、pool_era) |
| PG 数量 | 池里分多少个放置组 |
| CRUSH 规则 | 用于确定此池的 PG 映射(数据往哪落) |
| 保护类型 | 复本(replicated)或纠删码(erasure) |
| 与保护类型相关的参数 | 如复本数 size、纠删码 k/m |
| 影响集群行为的各种标志 | nodelete、noscrub 等 |
4.1.2 Place Group(放置组)
PG 全称为 Placement Group ,是构成 pool 的子集,也是一系列对象的集合。一个 PG 仅能属于一个 Pool。
Ceph 将每个 PG 映射到一组 OSD。属于同一个 PG 的所有对象都返回相同的哈希结果。
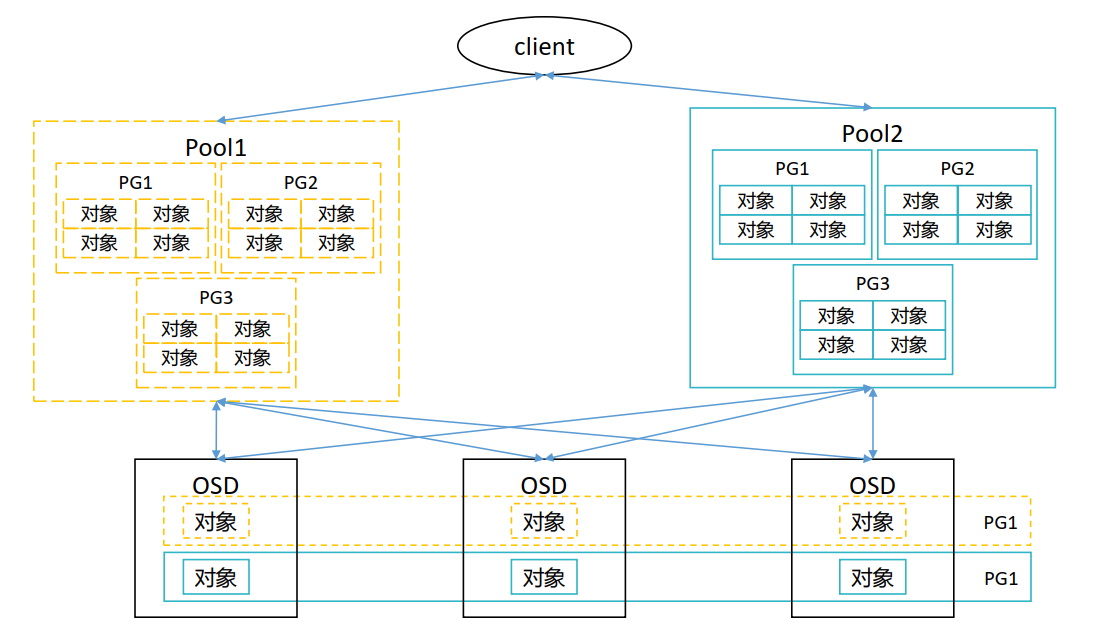
📌 看图说话(四层结构一目了然):
client(客户端) └── Pool1(池1) ├── PG1(放置组1)→ 对象 ×4 ├── PG2(放置组2)→ 对象 ×4 └── PG3(放置组3)→ 对象 ×4 └── Pool2(池2) ├── PG1 / PG2 / PG3 → 各自装对象 └── PG 映射到 3 台 OSD → 每台 OSD 磁盘上存一份对象副本一句话:池里分 PG,PG 里装对象,PG 再映射到多台 OSD 存副本。
PG 数量会影响 ceph 的性能:
| PG 数量 | 后果 |
|---|---|
| 过多 | 每个 PG 维护的数据量过少,ceph 占用大量 CPU 和内存计算,影响集群正常客户端使用 |
| 过少 | 单个 PG 存储的数据就越多,移动 PG 会占用大量带宽,影响集群客户端使用 |
在以前版本中,PG 的计算公式为:
公式 计算方式 Ceph 集群 PG 总数 = (OSD 数 × 100) / 最大副本数 单个资源池 PG 总数 = (OSD 数 × 100) / 最大副本数 / 池数 以上公式中计算出的结果必须舍入到最接近 2 的 N 次幂的值(128、256、512、1024...)。
一般情况下,PG 数量设置遵循以下原则:
| OSD 数量 | PG 数量 |
|---|---|
| OSD 少于 5 个 | 128 |
| OSD 数量大于 5 小于 10 | 512 |
| OSD 数量大于 10 小于 50 | 4096 |
| OSD 数量大于 50 | 需要借助工具计算,官方工具:https://old.ceph.com/pgcalc/ |
4.1.3 映射对象到 OSD
客户端在进行数据读写时,仅需向 ceph 提供资源池(pool)的名称和对象 ID。一个完整的对象由三部分组成:对象 ID、二进制数据、对象元数据。
| 步骤 | 做什么 |
|---|---|
| 1 | Ceph 客户端从 MON 获取最新的集群映射复本。集群映射向客户端提供有关集群中所有 MON、OSD 和 MDS 的信息,但不向客户提供对象的位置 |
| 2 | 计算 PG ID 。公式:PG ID = hash(Object ID) % (PG number)。为了计算 PG ID,Ceph 需要知道对象存储池的名称和对象 ID:根据池的名称获取池的 PG 数量,然后对 Ceph 对象 ID 做 hash 运算,最终计算出 PG ID |
| 3 | Ceph 使用 CRUSH 算法 确定 PG 负责哪些 OSDs(Acting Set)。Acting Set 中的 OSD 在 Up Set 中。Up Set 中的第一个 OSD 是对象归置组的当前主 OSD ,Up Set 中的其他 OSD 是辅助 OSD |
| 4 | Ceph 客户端直接跟主 OSD 通信以读写对象 |
客户端访问 ceph 流程:
| 步骤 | 做什么 |
|---|---|
| 1 | 客户端向 MON 集群发起连接请求 |
| 2 | 客户端和 MON 建立连接后,它将索引最新版本的 cluster map,从而获取到 MON、OSD 和 MDS 的信息,但不包括对象的存储位置 |
| 3 | client 根据 CRUSH 算法计算出对象对应的 PG 和 OSD |
| 4 | client 根据上步中计算得出主 OSD 的位置,然后和其进行通信,完成对象的读写 |
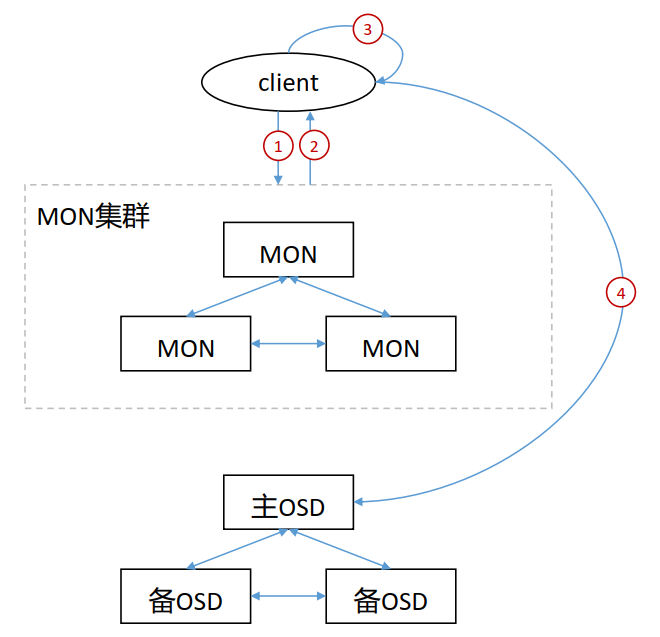
💡 为什么客户端自己算位置? 在 ceph 中,客户端自行计算对象存储位置的速度要比通过和 ceph 组件交互来查询对象存储位置快很多,因此,在数据读写时,都是客户端根据 CRUSH 完成对象的位置计算。(这就是 Ceph 高性能的秘诀------服务端不用记"对象在哪",客户端自己算!)
4.1.4 Ceph 数据读取流程
| 步骤 | 做什么 |
|---|---|
| 1 | 客户端通过 MON 获取到 cluster map |
| 2 | client 通过 cluster map 获取到主 OSD 节点信息,并向其发送读取请求 |
| 3 | 主 OSD 将 client 请求的数据返回给 client |
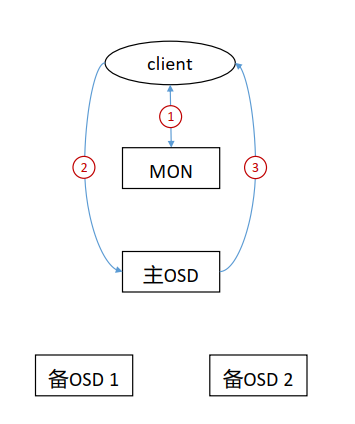
🎯 读数据超简单:问一次 MON 拿地图,之后所有读都直接找主 OSD,只读主副本就行!
4.1.5 Ceph 数据写入流程
| 步骤 | 做什么 |
|---|---|
| 1 | 客户端通过 MON 获取到 cluster map |
| 2 | 客户端通过 cluster map 获取到主 OSD 节点信息,并向其发送写入请求 |
| 3 | 主 OSD 收到写入请求后,将数据写入,并向两个备 OSD 发起数据写入指令 |
| 4 | 两个备 OSD 将数据写入后返回确认到主 OSD |
| 5 | 主 OSD 收到所有备 OSD 写入完成后的确认后,向客户端返回写入完成的确认 |
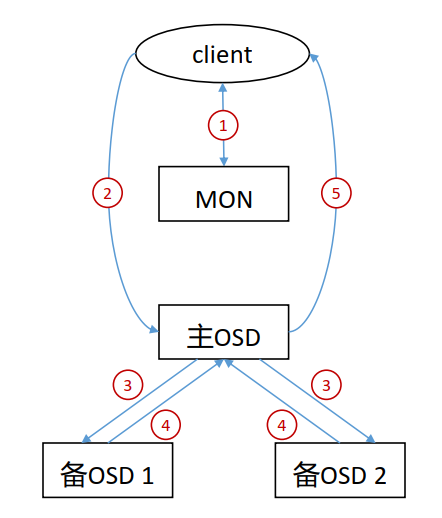
Ceph 采用数据强一致性 来保证数据的同步。强一致性会导致数据写入有较大的延迟,因此 ceph 进行了优化,将数据的写入分两次进行:
| 确认时机 | 客户端感知 |
|---|---|
| 第一次:所有数据都写入 OSD 节点的缓存后 | 向 client 发送一次确认,client 就会认为数据写入完成,继续进行后面操作 |
| 第二次:所有数据都从缓存写入到磁盘后 | 再向 client 发送一次确认,client 就会认为数据彻底写入,从而根据需要删除对应的本地数据 |
🎯 大白话:数据先写内存缓存(快!),先告诉你"写好了";等真落到磁盘了,再告诉你"彻底妥了"。既保证了不丢数据,又兼顾了写入速度!
4.2 数据保护
Ceph 存储支持:复本池 和纠删码池。
| 池类型 | 工作原理 | 优点 | 缺点 |
|---|---|---|---|
| replicated pool(复本池) | 通过将各个对象复本到多个 OSD 来发挥作用。此池类型会创建多个对象复本 | 通过冗余提高了读取操作的可用性 | 需要较多存储空间(3 副本 = 3 倍空间) |
| Erasure code pool(纠删代码池) | 对象切分后计算编码块,分散存到不同 OSD | 需要较少的存储空间和网络带宽 | 因为要进行奇偶校验计算,会占用较多的 CPU 处理时间 |
🚨 注意:池一旦创建完成,池的类型便无法更改。(所以建池前想清楚!)
池类型选择:
| 数据特点 | 推荐池类型 |
|---|---|
| 不需要频繁访问且不需要低延迟的数据(如归档、备份) | 纠删码池 |
| 需要频繁访问并且要具备快速读取性能的数据(如虚拟机镜像、数据库) | 复本池 |
4.3 创建池
4.3.1 创建复本池
Ceph 为每个对象创建多个复本来保护复本池中的数据。Ceph 使用 CRUSH 故障域来确定存储数据的操作集的主要 OSD。然后,主要 OSD 会查找池的当前复本数量,并计算要写入对象的次要 OSD。在主要 OSD 收到写入确认并完成数据写入后,主要 OSD 会向 Ceph 客户端确认写入操作已成功。如果一个或多个 OSD 出现故障,这一过程可保护对象中的数据。
创建复本池语法:
bash
ceph osd pool create pool-name pg-num pgp-num replicated crush-rule-name
# ↑ ceph osd pool create: 创建池的总命令
#   pool-name: 池名(自己取)
#   pg-num: PG 总数
#   pgp-num: 有效 PG 数(设成和 pg-num 一样,可省略)
#   replicated: 池类型=复本池(默认就是它,可省略)
#   crush-rule-name: CRUSH 规则集名称
其中:
| 参数 | 说明 |
|---|---|
| pool_name | 指定新池的名称 |
| pg_num | 指定池的放置组 (PG) 总数 |
| pgp_num | 指定池的有效放置组数量。将它设置为与 pg_num 相等。该值可省略 |
| replicated | 指定池的类型为复本池;如果命令中未包含此参数,这是默认值 |
| crush-rule-name | 指定池的 CRUSH 规则集的名称。由 osd_pool_default_crush_replicated_ruleset 配置参数设置其默认值 |
示例:
bash
[root@ceph1 ~]# ceph osd pool create pool_web 32 32 replicated
# ↑ ceph osd pool create: 创建池
#   pool_web: 池名(web 业务用)
#   32: pg_num = 32 个放置组
#   32: pgp_num = 32(和 pg_num 相等)
#   replicated: 复本池

pool 'pool_web' created
# ↑ 输出:池 pool_web 创建成功!
bash
[root@ceph1 ~]# ceph osd pool ls
# ↑ ceph osd pool ls: 列出所有池,验证创建结果

device_health_metrics
# ↑ 系统自带的设备健康监控池(别删,Ceph 内部用)

pool_web
# ↑ 我们刚创建的 pool_web 池(出现了!🎉)
4.3.2 创建纠删代码池
纠删代码池使用纠删代码保护对象数据。在纠删代码池中存储的对象分割为多个数据区块 ,这些数据区块存储在不同的 OSD 中。编码块的数量是根据数据块计算的,并存储在不同的 OSD 中。当 OSD 出现故障时,可利用编码块重构对象数据。主要 OSD 接收写入操作,然后将载荷编码为 K+M 块,并将它们发给纠删代码池中的次要 OSD。
以下概括了纠删代码池的工作方式:
| 规则 | 说明 |
|---|---|
| 切分 | 每个对象的数据分割为 k 个数据区块 ,计算出 m 个编码区块 |
| 落点 | 对象存储在总共 k + m 个 OSD 中 |
| 大小 | 编码区块大小与数据区块大小相同 |
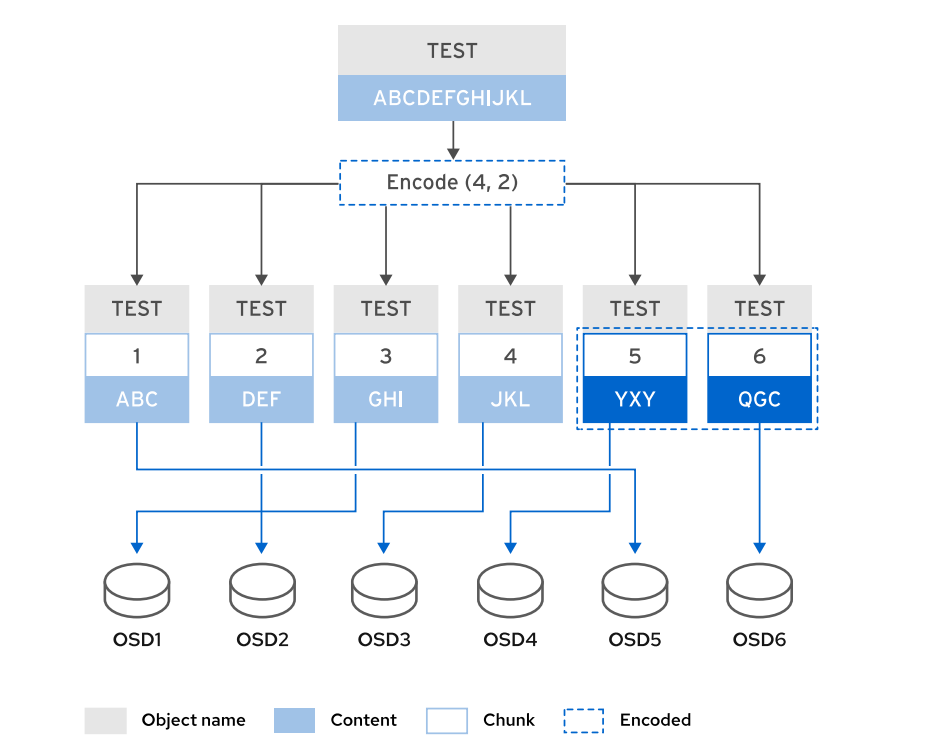
📌 看图算账:k=4(4 个数据块)+ m=2(2 个编码块)= 6 个块,存到 6 台 OSD。坏任意 2 台都能靠编码块拼回原数据!
与复本相比,纠删代码使用存储容量的效率更高。复本池维护对象的 n 个复本,而纠删代码仅维护 k + m 个区块。
| 方案 | 空间占用 | 效率 |
|---|---|---|
| 3 副本复本池 | 3 倍存储空间 | 1:3 |
| k=4 m=2 纠删码池 | 1.5 倍存储空间 | 1:1.5(省一半!) |
支持以下 k+m 值,其对应的可用与原始比为:
| k+m | 比率 |
|---|---|
| 4+2 | 1:1.5 |
| 8+3 | 1:1.375 |
| 8+4 | 1:1.5 |
纠删代码池有效容量百分比:
k / (k+m)。例如,如果用户有 64 个 OSD(每个 4 TB,总计 256 TB)并且 k=8 和 m=4,那么公式为8 / (8+4) × 64 × 4 = 170.67。然后,将原始存储容量除以开销就能得出该比率。256 TB / 170.67 TB = 1.5比率。
创建纠删代码池语法:
bash
ceph osd pool create pool-name pg-num pgp-num erasure erasure-code-profile crush-rule-name
# ↑ ceph osd pool create: 创建池
#   erasure: 池类型=纠删码池
#   erasure-code-profile: 纠删码配置文件名(默认 default)
# crush-rule-name: CRUSH 规则集名(不指定就用 profile 里定义的)| 参数 | 说明 |
|---|---|
| pool-name | 指定新池的名称 |
| pg-num | 指定池的放置组 (PG) 总数 |
| pgp-num | 指定池的有效放置组数量。通常而言,这应当与 PG 总数相等 |
| erasure | 指定池的类型是纠删代码池 |
| erasure-code-profile | 指定池使用的纠删代码配置文件的名称。默认情况下,Ceph 使用 default 配置文件 |
| crush-rule-name | 要用于这个池的 CRUSH 规则集的名称。如果不设置,Ceph 将使用纠删代码池配置文件中定义的规则集 |
⚠️ 纠删代码池无法使用对象映射功能。对象映射是对象的一个索引,用于跟踪 rbd 对象的块会被分配到哪里,可用于提高大小调整、导出、扁平化和其他操作的性能。(所以 RBD 块存储一般用复本池!)
示例:
bash
[root@ceph1 ~]# ceph osd pool create pool_era 32 32 erasure
# ↑ 创建纠删码池
#   pool_era: 池名(era = erasure 纠删码)
#   32 32: pg_num 和 pgp_num 都是 32
#   erasure: 纠删码类型

pool 'pool_era' created
# ↑ 创建成功!
bash
[root@ceph1 ~]# ceph osd pool ls
# ↑ 列池验证

device_health_metrics
pool_web
pool_era
# ↑ 三个池都在了:系统池 + 复本池 + 纠删码池
4.3.3 查看默认纠删代码配置
bash
[root@ceph1 ~]# ceph osd erasure-code-profile ls
# ↑ ceph osd erasure-code-profile ls: 列出所有纠删码配置文件

default
# ↑ 只有一个默认配置文件 default
bash
[root@ceph1 ~]# ceph osd erasure-code-profile get default
# ↑ ceph osd erasure-code-profile get: 查看某配置文件详情
#   default: 默认配置文件

k=2
# ↑ k=2: 数据块数=2

m=2
# ↑ m=2: 编码块数=2(坏 2 块也能恢复)

plugin=jerasure
# ↑ plugin=jerasure: 使用 jerasure 插件(最常用的纠删码库)

technique=reed_sol_van
# ↑ technique=reed_sol_van: 算法=reed-solomon(范德蒙德版)
4.3.4 管理纠删代码配置文件
纠删代码配置文件可配置纠删代码池用于存储对象的数据区块和编码区块的数量,以及要使用的纠删代码插件和算法。
创建纠删代码配置文件语法:
bash
ceph osd erasure-code-profile set profile-name arguments
# ↑ set: 新建一个纠删码配置文件
可用的参数如下:
| 参数 | 说明 |
|---|---|
| k | 在不同 OSD 之间拆分的数据区块数量。默认值为 2 |
| m | 数据变得不可用之前可以出现故障的 OSD 数量。默认值为 1 |
| directory | 此可选参数是插件库的位置。默认值为 /usr/lib64/ceph/erasure-code |
| plugin | 此可选参数定义要使用的纠删代码算法 |
| crush-failure-domain | 此可选参数定义 CRUSH 故障域,它控制区块放置。默认设置为 host,这样可确保对象的区块放置到不同主机的 OSD 上。如果设置为 osd,则对象的区块可以放置到同一主机的 OSD 上。如果主机出现故障,则该主机上的所有 OSD 都会出现故障。故障域可用于确保将区块放置到不同数据中心机架或其他定制的主机上的 OSD 上 |
| crush-device-class | 此可选参数选择仅将这一类别设备支持的 OSD 用于池。典型的类别可能包括 hdd、ssd 或 nvme |
| crush-root | 此可选参数设置 CRUSH 规则集的根节点 |
| key=value | 插件可以具有对该插件唯一的键值参数 |
| technique | 每个插件提供一组不同的技术来实施不同的算法 |
示例:
bash
[root@ceph1 ~]# ceph osd erasure-code-profile set ceph k=4 m=2
# ↑ 新建配置文件
#   set ceph: 配置文件名 = ceph
#   k=4: 数据块 4 个
#   m=2: 编码块 2 个(4+2 = 1.5 倍空间)
列出现有的纠删代码配置文件:
bash
[root@ceph1 ~]# ceph osd erasure-code-profile ls
# ↑ 列出所有配置文件

ceph
# ↑ 我们刚建的 ceph

default
# ↑ 系统默认的 default
Ceph 会在安装期间创建 default 配置文件。这个配置文件已配置为将对象分割为 2 个数据区块和 2 个编码区块。
查看现有配置文件的详细信息:
bash
[root@ceph1 ~]# ceph osd erasure-code-profile get ceph
# ↑ 查看我们自建的 ceph 配置文件详情

crush-device-class=
# ↑ crush-device-class 未指定(不限定设备类型)

crush-failure-domain=host
# ↑ 故障域=host(块必须分散到不同主机)

crush-root=default
# ↑ CRUSH 规则根节点=default

jerasure-per-chunk-alignment=false
# ↑ jerasure 每块对齐=false

k=4
# ↑ 数据块 4

m=2
# ↑ 编码块 2

plugin=jerasure
# ↑ 插件 jerasure

technique=reed_sol_van
# ↑ 算法 reed_sol_van

w=8
# ↑ w=8: 字长 8 位
删除现有的配置文件:
bash
[root@ceph1 ~]# ceph osd erasure-code-profile rm ceph
# ↑ ceph osd erasure-code-profile rm: 删除配置文件
#   ceph: 要删的文件名

[root@ceph1 ~]# ceph osd erasure-code-profile ls
# ↑ 再列一下验证

default
# ↑ 只剩 default 了,ceph 已删除
🚨 重要:现有纠删代码配置文件是无法修改或更改,只能创建新的配置文件。(要改 k/m?只能新建一个 profile!)
4.4 查看池状态
使用 ceph osd pool ls 命令,可以列出池清单。
bash
[root@ceph1 ~]# ceph osd pool ls
# ↑ 列出所有池名

device_health_metrics
pool_web
pool_era
使用 ceph osd pool ls detail 命令,可以列出池清单和池的详细配置。
bash
[root@ceph1 ~]# ceph osd pool ls detail
# ↑ detail: 详细模式(每个池一行详细信息)

pool 1 'device_health_metrics' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins pg_num 1 pgp_num 1 autoscale_mode on last_change 31 flags hashpspool stripe_width 0 pg_num_max 32 pg_num_min 1 application mgr_devicehealth
# ↑ 池 1(device_health_metrics):
#   replicated=复本池 size=3(3副本) min_size=2(最少2副本可读写)
#   crush_rule 0 / object_hash rjenkins(哈希算法)
#   pg_num 1 / pgp_num 1 / autoscale_mode on(自动扩PG开)
#   application mgr_devicehealth(用途:MGR 设备健康监控)

pool 2 'pool_web' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins pg_num 32 pgp_num 32 autoscale_mode on last_change 34 flags hashpspool stripe_width 0
# ↑ 池 2(pool_web):复本池 size=3 pg_num=32

pool 3 'pool_era' erasure profile default size 4 min_size 3 crush_rule 1 object_hash rjenkins pg_num 32 pgp_num 32 autoscale_mode on last_change 41 flags hashpspool stripe_width 8192
# ↑ 池 3(pool_era):
#   erasure=纠删码池 profile default
#   size 4 min_size 3(k=2 m=2,总共 4 块,坏 1 块还能读 = min_size 3)
#   stripe_width 8192(条带宽度,纠删码特征)
使用 ceph osd lspools 命令,也可以列出池清单。
bash
[root@ceph1 ~]# ceph osd lspools
# ↑ 老式列池命令(带数字 ID)

1 device_health_metrics
2 pool_web
3 pool_era
# ↑ 格式:池ID 池名
使用 ceph osd pool stats 命令,可以列出池状态信息,池被哪些客户端使用。
bash
[root@ceph1 ~]# ceph osd pool stats
# ↑ 池的实时使用状态

pool device_health_metrics id 1
  nothing is going on
# ↑ 这个池当前没活动(nothing is going on = 没人用)

pool pool_web id 2
  nothing is going on

pool pool_era id 3
  nothing is going on
# ↑ 三个池都空闲(刚建好,还没传数据)
使用 ceph df 命令,可以查看池容量使用信息。
bash
[root@ceph1 ~]# ceph df
# ↑ ceph df: 看集群容量(类似 Linux 的 df 命令)

--- RAW STORAGE ---
# ↑ 裸存储层:整个集群磁盘总量

CLASS     SIZE    AVAIL     USED  RAW USED  %RAW USED
# ↑ CLASS 设备类型 / SIZE 总容量 / AVAIL 可用 / USED 已用 / RAW USED 裸用 / %RAW USED 百分比

hdd    180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
# ↑ hdd 盘:总 180G,可用 177G,已用 2.6G,用了 1.42%

TOTAL  180 GiB  177 GiB  2.6 GiB   2.6 GiB       1.42
# ↑ 合计:180G(3 节点 × 3 块 × 20G ≈ 180G,对上了!)

--- POOLS ---
# ↑ 池层:每个池的用量

POOL                   ID  PGS  STORED  OBJECTS  USED  %USED  MAX AVAIL
# ↑ POOL 池名 / ID 编号 / PGS PG 数 / STORED 已存 / OBJECTS 对象数 / USED 占用 / %USED 百分比 / MAX AVAIL 最大可用

device_health_metrics   1    1     0 B        0   0 B      0     56 GiB
pool_web                2   32     0 B        0   0 B      0     56 GiB
pool_era                3   32     0 B        0   0 B      0     84 GiB
# ↑ 三个池都是 0 对象(空池)
#   pool_web/pool_era 的 MAX AVAIL 不同:纠删码池可用空间更大(84G > 56G)!
4.5 管理池
4.5.1 管理池应用类型
使用
ceph osd pool application命令,管理池 Ceph 应用类型。应用类型有 cephfs (用于 Ceph 文件系统)、rbd (Ceph 块设备)和 rgw(RADOS 网关)。
bash
[root@ceph1 ~]# ceph osd pool application <tab><tab>
# ↑ 输入两次 Tab 键,自动补全提示可用子命令

disable  enable   get      rm       set
# ↑ 5 个子命令:
#   disable=禁用应用 / enable=启用 / get=查看 / rm=删配置 / set=写配置
bash
# 启用池的类型为 rbd
[root@ceph1 ~]# ceph osd pool application enable pool_web rbd
# ↑ enable pool_web rbd: 把 pool_web 池标记为"给 rbd(块设备)用"
#   作用:告诉 Ceph 这个池将来跑块存储业务

enabled application 'rbd' on pool 'pool_web'
# ↑ 输出:已在 pool_web 上启用 rbd 应用
bash
[root@ceph1 ~]# ceph osd pool ls detail | grep pool_web
# ↑ 查看池详情,只看 pool_web 这行(grep 过滤)

pool 2 'pool_web' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins pg_num 32 pgp_num 32 autoscale_mode on last_change 44 flags hashpspool stripe_width 0 `application rbd`  <------ #看这的变化
# ↑ 注意最后多了 "application rbd"!
#   🎯 现象解释:启用应用类型后,ls detail 输出里会标注这个池被哪个应用使用
bash
# 使用 set 子命令,设置池的应用类型详细配置
[root@ceph1 ~]# ceph osd pool application set pool_web rbd app1 apache
# ↑ set pool_web rbd app1 apache:
#   pool_web: 池名
#   rbd: 应用类型
#   app1: 自定义键
#   apache: 自定义值
#   作用:给池打个自定义标签(app1=apache)

set application 'rbd' key 'app1' to 'apache' on pool 'pool_web'
# ↑ 输出:已设置

# 这里添加的设置,app1=apache 仅供参考,没有实际意义。
bash
# 使用 get 子命令,查看池的应用类型详细配置
[root@ceph1 ~]# ceph osd pool application get pool_web
# ↑ get pool_web: 查 pool_web 的应用配置

{
    "rbd": {
        "app1": "apache"
    }
}
# ↑ JSON 输出:rbd 应用下有个 app1=apache(刚才 set 的内容)
bash
# 使用 rm 子命令,删除池的应用类型详细配置
[root@ceph1 ~]# ceph osd pool application rm pool_web rbd app1
# ↑ rm pool_web rbd app1: 删掉 app1 这个键

removed application 'rbd' key 'app1' on pool 'pool_web'
# ↑ 输出:已删除
bash
[root@ceph1 ~]# ceph osd pool application get pool_web
# ↑ 再查验证

{
    "rbd": {}
}
# ↑ app1 没了,rbd 变成空 {}(删除成功)
bash
# 禁用池的类型
[root@ceph1 ~]# ceph osd pool application disable pool_web rbd --yes-i-really-mean-it
# ↑ disable pool_web rbd: 禁用 rbd 应用标记
#   --yes-i-really-mean-it: 强制确认(危险操作必须加这句话,Ceph 的安全设计!)

disable application 'rbd' on pool 'pool_web'
# ↑ 已禁用
bash
[root@ceph1 ~]# ceph osd pool ls detail | grep pool_web
# ↑ 再看详情,application rbd 已消失

pool 2 'pool_web' replicated size 3 min_size 2 crush_rule 0 object_hash rjenkins pg_num 32 pgp_num 32 autoscale_mode on last_change 47 flags hashpspool stripe_width 0
# ↑ 末尾没有 application rbd 了(禁用成功)
4.5.2 管理池配额
使用
ceph osd pool get-quota命令,获取池配额信息:池中能够存储的最大字节数或最大对象数量。
bash
[root@ceph1 ~]# ceph osd pool get-quota pool_web
# ↑ get-quota: 查池配额

quotas for pool 'pool_web':
  max objects: N/A
# ↑ max objects: 最大对象数限制(N/A = 不限)

  max bytes  : N/A
# ↑ max bytes: 最大容量限制(N/A = 不限)
使用
ceph osd pool set-quota命令,可以设置池配额来限制池中能够存储的最大字节数或最大对象数量。当存储对象达到限额时,整个池会无法使用。
bash
[root@ceph1 ~]# ceph osd pool set-quota pool_web max_objects 100000
# ↑ set-quota pool_web max_objects 100000:
#   限制 pool_web 最多存 100000 个对象

set-quota max_objects = 100000 for pool pool_web
# ↑ 输出:设置成功

[root@ceph1 ~]# ceph osd pool set-quota pool_web max_bytes 10G
# ↑ 限制 pool_web 最多存 10G 数据

set-quota max_bytes = 10737418240 for pool pool_web
# ↑ 输出:10737418240 字节 = 10×1024×1024×1024 = 10 GiB(Ceph 内部用字节算)
bash
[root@ceph1 ~]# ceph osd pool get-quota pool_web
# ↑ 查看配额是否生效

quotas for pool 'pool_web':
  max objects: 100k objects  (current num objects: 0 objects)
# ↑ 上限 100k 个对象,当前 0 个

  max bytes  : 10 GiB  (current num bytes: 0 bytes)
# ↑ 上限 10 GiB,当前 0 字节
当池使用量达到池配额时,操作将被阻止。用户可通过将该值设置为 0 来删除配额。
bash
[root@ceph1 ~]# ceph osd pool set-quota pool_web max_objects 0
# ↑ max_objects 0: 对象数限制设为 0 = 取消限制

set-quota max_objects = 0 for pool pool_web

[root@ceph1 ~]# ceph osd pool set-quota pool_web max_bytes 0
# ↑ max_bytes 0: 容量限制设为 0 = 取消限制

set-quota max_bytes = 0 for pool pool_web

[root@ceph1 ~]# ceph osd pool get-quota pool_web
# ↑ 验证

quotas for pool 'pool_web':
  max objects: N/A
  max bytes  : N/A
# ↑ 又变回 N/A 了(配额取消成功)
4.5.3 管理池配置
查看池配置:使用 ceph osd pool get 命令。
bash
# 查看池所有配置
[root@ceph1 ~]# ceph osd pool get pool_web all
# ↑ get pool_web all: all = 显示这个池的全部配置

size: 3                     #副本数3
# ↑ size=3: 副本数 3(3 份数据)

min_size: 2
# ↑ min_size=2: 最少 2 副本存活才能读写

pg_num: 32
# ↑ pg_num=32: 32 个 PG

pgp_num: 32
# ↑ pgp_num=32: 有效 PG 数

crush_rule: replicated_rule
# ↑ CRUSH 规则名=replicated_rule(复本规则)

hashpspool: true
# ↑ hashpspool=true: 使用 PSP 哈希

nodelete: false
# ↑ nodelete=false: 允许删除池(true 则禁止删)

nopgchange: false
# ↑ nopgchange=false: 允许改 PG 数

nosizechange: false
# ↑ nosizechange=false: 允许改副本数

write_fadvise_dontneed: false
# ↑ write_fadvise_dontneed=false

noscrub: false
# ↑ noscrub=false: 允许数据清洗(scrub=校验副本一致性)

nodeep-scrub: false
# ↑ nodeep-scrub=false: 允许深度清洗

use_gmt_hitset: 1
# ↑ use_gmt_hitset=1

fast_read: 0
# ↑ fast_read=0

pg_autoscale_mode: on
# ↑ pg 自动扩展模式=on

bulk: false
# ↑ bulk=false
bash
# 查看池特定配置
[root@ceph1 ~]# ceph osd pool get pool_web nodelete
# ↑ 只查 nodelete 这一项

nodelete: false
# ↑ 输出:当前不禁止删除
bash
# 备用命令
[root@ceph1 ~]# ceph osd pool get pool_web all | grep nodelete
# ↑ 用 grep 从 all 输出里筛出 nodelete 行

nodelete: false
设置池配置:使用 ceph osd pool set 命令。
bash
# 设置池不可删除
[root@ceph1 ~]# ceph osd pool set pool_web nodelete true
# ↑ set pool_web nodelete true: 把 pool_web 设为"不可删除"(保护重要池!)

set pool 2 nodelete to true
# ↑ 输出:pool 2(pool_web 的 ID 是 2)nodelete 设为 true

[root@ceph1 ~]# ceph osd pool get pool_web nodelete
# ↑ 验证

nodelete: true
# ↑ 已生效:现在这个池删不掉了(防误删神器)
bash
# 将 nodelete 重新设置为 FALSE,即可允许删除池
root@ceph1 ~]# ceph osd pool set pool_web nodelete false
# ↑ 改回 false(恢复可删除)
#   🤔 注意原文这行提示符少了个 [,照原样保留!

set pool 2 nodelete to false
# ↑ pool 2 的 nodelete 改回 false

[root@ceph1 ~]# ceph osd pool get pool_web nodelete
# ↑ 验证

nodelete: false
# ↑ 恢复可删除
4.5.4 管理池复本数
使用以下命令,更改池的复本数量。
bash
[root@ceph1 ~]# ceph osd pool set pool_web size 2
# ↑ set pool_web size 2: 把 pool_web 的副本数从 3 改成 2

set pool 2 size to 2           #2 size to 2???没变,别闹这里说的是pool2 的 size 变成2,pool2是谁??
# ↑ 输出:pool 2(pool_web 的 ID)的 size 变成 2
#   🤔 原文小白批注:"pool2 是谁??" ------ 其实就是 pool_web!因为 pool_web 的池 ID 是 2,Ceph 内部按 ID 称呼它。
bash
[root@ceph1 ~]# ceph osd pool get pool_web all
# ↑ 查全部配置,确认 size 变了

size: 2             #这里确实从之前的3变成了2
# ↑ size 确实从 3 变成 2 了!

min_size: 1
# ↑ min_size 也跟着自动从 2 变成 1(size/2 取整:2/2=1)

pg_num: 32
pgp_num: 32
crush_rule: replicated_rule
hashpspool: true
nodelete: false
nopgchange: false
nosizechange: false
write_fadvise_dontneed: false
noscrub: false
nodeep-scrub: false
use_gmt_hitset: 1
fast_read: 0
pg_autoscale_mode: on
bulk: false
池的默认复本数量由
osd_pool_default_size配置参数定义,默认值为 3。
bash
[root@ceph1 ~]# ceph config get mon osd_pool_default_size
# ↑ 查"新建池默认副本数"这个全局参数

3
# ↑ 默认 3 副本
使用以下命令定义创建新池的默认复本数量。
bash
[root@ceph1 ~]# ceph config set mon osd_pool_default_size 2
# ↑ 把以后新建池的默认副本数改成 2(省空间!)

[root@ceph1 ~]# ceph config get mon osd_pool_default_size
# ↑ 验证

2
# ↑ 以后新建的池默认就是 2 副本了
osd_pool_default_min_size参数定义集群必须提供多少个对象复本才能接受 I/O 请求。复本数为 3 的池,该值为 2;复本数为 2 的池,该值为 1。
bash
[root@ceph1 ~]# ceph config get mon osd_pool_default_min_size
0                         #参数值为0是特殊设置,意味着集群将自动使用存储池的size值作为最小副本数计算,举例说明:如果某存储池size=3,那么min_size会自动设为2(即size/2+1取整)
# ↑ 输出 0
#   0 = 特殊值:Ceph 自动按 size/2+1 算 min_size(size=3→min_size=2;size=2→min_size=1)
bash
[root@ceph1 ~]# ceph config set mon osd_pool_default_min_size 1
# ↑ 手动指定默认 min_size = 1

[root@ceph1 ~]# ceph config get mon osd_pool_default_min_size
# ↑ 验证

1
# ↑ 已生效
4.5.5 管理池 PG 数
使用以下命令,更改池 PG 数量。
bash
[root@ceph1 ~]# ceph osd pool set pool_web pg_num 64      #思考PG设置多少合适???
# ↑ set pool_web pg_num 64: 把 pool_web 的 PG 数从 32 改成 64

set pool 2 pg_num to 64
# ↑ pool 2 的 pg_num 改为 64
bash
[root@ceph1 ~]# ceph osd pool get pool_web all
# ↑ 验证

size: 2
min_size: 1
pg_num: 64                                 #确实PG变为了64
# ↑ pg_num 确实变成 64 了

pgp_num: 64
# ↑ pgp_num 自动跟着变成 64(因为它要和 pg_num 一致)

crush_rule: replicated_rule
hashpspool: true
nodelete: false
nopgchange: false
nosizechange: false
write_fadvise_dontneed: false
noscrub: false
nodeep-scrub: false
use_gmt_hitset: 1
fast_read: 0
pg_autoscale_mode: on
bulk: false
Ceph 存储默认在池上配置放置组自动扩展。自动扩展允许集群计算放置组的数量,并且自动选择适当的 pg_num 值。
集群中的每个池都有一个
pg_autoscale_mode选项,其值可以是 on、off 或 warn:
| 模式 | 含义 |
|---|---|
| on | 启用自动调整池的 PG 数 |
| off | 禁用池的 PG 自动扩展 |
| warn | 在 PG 数需要调整时引发运行状况警报并将集群运行状况更改为 HEALTH_WARN |
集群配置放置组自动扩展,需要在 Ceph MGR 节点上启用 pg_autoscaler 模块,并将池的自动扩展模式设置为 on:
bash
[root@ceph1 ~]# ceph mgr module enable pg_autoscaler
# ↑ ceph mgr module enable: 启用 MGR 插件
#   pg_autoscaler: PG 自动扩缩插件
#   作用:让 MGR 自动帮你算合适的 PG 数

module 'pg_autoscaler' is already enabled (always-on)
# ↑ 输出:这个模块已经启用了(always-on = 默认自带开启)
bash
[root@ceph1 ~]# ceph osd pool set pool_web pg_autoscale_mode off
#pool_web池pg_autoscale_mode设置为off
# ↑ 手动把 pool_web 的自动扩缩关掉(改回手动管理 PG 数)

set pool 2 pg_autoscale_mode to off
bash
[root@ceph1 ~]# ceph osd pool autoscale-status
# ↑ autoscale-status: 查看各池的自动扩缩状态

POOL                     SIZE  TARGET SIZE  RATE  RAW CAPACITY   RATIO TARGET RATIO  EFFECTIVE RATIO  BIAS  PG_NUM  NEW PG_NUM  AUTOSCALE  BULK
# ↑ 表头:池名 / 已用大小 / 目标大小 / 速率 / 裸容量 / 比例 / 目标比例 / 有效比例 / 偏差 / 当前PG数 / 建议新PG数 / 自动扩缩状态 / 是否bulk

device_health_metrics      0                 3.0        179.9G  0.0000 1.0       1              on         False
# ↑ device_health_metrics:AUTOSCALE=on

pool_web                   0                 2.0        179.9G  0.0000 1.0      64              off        False
# ↑ pool_web:PG_NUM=64,AUTOSCALE=off(刚关掉的)

pool_era                   0                 2.0        179.9G  0.0000 1.0      32              on         False
# ↑ pool_era:AUTOSCALE=on
bash
[root@ceph1 ~]# ceph osd pool set pool_web pg_autoscale_mode on
# ↑ 再把 pool_web 的自动扩缩开回来

set pool 2 pg_autoscale_mode to on

[root@ceph1 ~]# ceph osd pool autoscale-status
# ↑ 再看状态

POOL                     SIZE  TARGET SIZE  RATE  RAW CAPACITY   RATIO TARGET RATIO  EFFECTIVE RATIO  BIAS  PG_NUM  NEW PG_NUM  AUTOSCALE  BULK
device_health_metrics      0                 3.0        179.9G  0.0000 1.0       1              on         False
pool_web                   0                 2.0        179.9G  0.0000 1.0      64              on         False
# ↑ pool_web 的 AUTOSCALE 从 off 变回 on 了!

pool_era                   0                 2.0        179.9G  0.0000 1.0      32              on         False
可以在集群级别为新创建的池设置一些默认值:
| 参数 | 作用 |
|---|---|
| osd_pool_default_flag_nodelete | 为池设置 nodelete 标志的默认值。将值设置为 TRUE 可以防止删除池 |
| osd_pool_default_flag_nopgchange | 为池设置 nopgchange 标志的默认值。将值设置为 TRUE 可以防止更改 pg_num 和 pgp_num |
| osd_pool_default_flag_nosizechange | 为池设置 nosizechange 标志的默认值。将值设置为 TRUE 可以防止更改池大小 |
以上这些参数需要配置在 ceph 集群配置 ceph.conf 的 global 块中。
4.6 管理池中对象
Ceph 使用 rados 命令管理池的对象。先看看 rados 都能干啥:
bash
[root@ceph1 ~]# rados -h
# ↑ rados -h: 查看 rados 命令的完整帮助
#   rados = RADOS(Ceph 原生对象存储接口)的命令行工具
#   下面输出原文全部保留,共分 8 大组命令:

usage: rados [options] [commands]
# ↑ 用法:rados [选项] [命令]

POOL COMMANDS
# ↑ 【第一组】池级命令:
   lspools                          list pools
#     ↑ lspools: 列出所有池
   cppool <pool-name> <dest-pool>   copy content of a pool
#     ↑ cppool: 复制整个池内容到目标池
   purge <pool-name> --yes-i-really-really-mean-it
                                    remove all objects from pool <pool-name> without removing it
#     ↑ purge: 清空池里所有对象(但不删池本身),必须加超长确认语
   df                               show per-pool and total usage
#     ↑ df: 显示池容量用量
   ls                               list objects in pool
#     ↑ ls: 列出池里的对象

POOL SNAP COMMANDS
# ↑ 【第二组】池快照命令:
   lssnap                           list snaps
#     ↑ lssnap: 列出池快照
   mksnap <snap-name>               create snap <snap-name>
#     ↑ mksnap: 创建快照
   rmsnap <snap-name>               remove snap <snap-name>
#     ↑ rmsnap: 删除快照

OBJECT COMMANDS
# ↑ 【第三组】对象级命令(本章重点用这些!):
   get <obj-name> <outfile>         fetch object
#     ↑ get: 把对象下载到本地文件
   put <obj-name> <infile> [--offset offset]
                                    write object with start offset (default:0)
#     ↑ put: 把本地文件上传成对象
   append <obj-name> <infile>       append object
#     ↑ append: 往对象尾部追加内容
   truncate <obj-name> length       truncate object
#     ↑ truncate: 截断对象到指定长度
   create <obj-name>                create object
#     ↑ create: 创建空对象
   rm <obj-name> ... [--force-full] remove object(s), --force-full forces remove when cluster is full
#     ↑ rm: 删除对象
   cp <obj-name> [target-obj]       copy object
#     ↑ cp: 复制对象
   listxattr <obj-name>
#     ↑ listxattr: 列对象扩展属性
   getxattr <obj-name> attr
   setxattr <obj-name> attr val
   rmxattr <obj-name> attr
   stat <obj-name>                  stat the named object
#     ↑ stat: 查看对象状态(大小、修改时间)
   stat2 <obj-name>                 stat2 the named object (with high precision time)
   touch <obj-name> [timestamp]     change the named object modification time
#     ↑ touch: 改对象修改时间
   mapext <obj-name>
   rollback <obj-name> <snap-name>  roll back object to snap <snap-name>
#     ↑ rollback: 把对象回滚到快照状态
   listsnaps <obj-name>             list the snapshots of this object
#     ↑ listsnaps: 列对象的快照
   bench <seconds> write|seq|rand [-t concurrent_operations] [--no-cleanup] [--run-name run_name] [--no-hints] [--reuse-bench]
                                    default is 16 concurrent IOs and 4 MB ops
                                    default is to clean up after write benchmark
                                    default run-name is 'benchmark_last_metadata'
#     ↑ bench: 性能压测(写/顺序/随机)
   cleanup [--run-name run_name] [--prefix prefix]
#     ↑ cleanup: 清理压测数据
   load-gen [options]               generate load on the cluster
#     ↑ load-gen: 生成随机负载
   listomapkeys <obj-name>          list the keys in the object map
   listomapvals <obj-name>          list the keys and vals in the object map
   getomapval <obj-name> <key> [file] show the value for the specified key in the object's object map
   setomapval <obj-name> <key> <val | --input-file file>
   rmomapkey <obj-name> <key>
   clearomap <obj-name> [obj-name2 obj-name3...] clear all the omap keys for the specified objects
   getomapheader <obj-name> [file]
   setomapheader <obj-name> <val>
   watch <obj-name>                 add watcher on this object
   notify <obj-name> <message>      notify watcher of this object with message
   listwatchers <obj-name>          list the watchers of this object
   set-alloc-hint <obj-name> <expected-object-size> <expected-write-size>
                                    set allocation hint for an object
   set-redirect <object A> --target-pool <caspool> <target object A> [--with-reference]
                                    set redirect target
   set-chunk <object A> <offset> <length> --target-pool <caspool> <target object A> <taget-offset> [--with-reference]
                                    convert an object to chunked object
   tier-promote <obj-name>          promote the object to the base tier
   unset-manifest <obj-name>        unset redirect or chunked object
   tier-flush <obj-name>            flush the chunked object
   tier-evict <obj-name>            evict the chunked object

IMPORT AND EXPORT
# ↑ 【第四组】导入导出:
   export [filename]
        Serialize pool contents to a file or standard out.
#     ↑ export: 导出池内容到文件
   import [--dry-run] [--no-overwrite] < filename | - >
        Load pool contents from a file or standard in
#     ↑ import: 从文件导入池内容

ADVISORY LOCKS
# ↑ 【第五组】乐观锁:
   lock list <obj-name>
        List all advisory locks on an object
   lock get <obj-name> <lock-name> [--lock-cookie locker-cookie] [--lock-tag locker-tag] [--lock-description locker-desc] [--lock-duration locker-dur] [--lock-type locker-type]
        Try to acquire a lock
   lock break <obj-name> <lock-name> <locker-name> [--lock-cookie locker-cookie]
        Try to break a lock acquired by another client
   lock info <obj-name> <lock-name>
        Show lock information
   options:
        --lock-tag                   Lock tag, all locks operation should use the same tag
        --lock-cookie                Locker cookie
        --lock-description           Description of lock
        --lock-duration              Lock duration (in seconds)
        --lock-type                  Lock type (shared, exclusive)

SCRUB AND REPAIR:
# ↑ 【第六组】校验修复:
   list-inconsistent-pg <pool>      list inconsistent PGs in given pool
   list-inconsistent-obj <pgid>     list inconsistent objects in given PG
   list-inconsistent-snapset <pgid> list inconsistent snapsets in the given PG

CACHE POOLS: (for testing/development only)
# ↑ 【第七组】缓存池(仅测试用):
   cache-flush <obj-name>           flush cache pool object (blocking)
   cache-try-flush <obj-name>       flush cache pool object (non-blocking)
   cache-evict <obj-name>           evict cache pool object
   cache-flush-evict-all            flush+evict all objects
   cache-try-flush-evict-all        try-flush+evict all objects

GLOBAL OPTIONS:
# ↑ 【第八组】全局选项:
   --object-locator object_locator
        set object_locator for operation
   -p pool
   --pool=pool
        select given pool by name
#     ↑ -p pool: 指定操作哪个池(本章最常用!)
   --target-pool=pool
        select target pool by name
   --pgid PG id
        select given pg id
   -f [--format plain|json|json-pretty]
   --format=[--format plain|json|json-pretty]
#     ↑ -f: 输出格式(plain/json/json-pretty)
   -b op_size
        set the block size for put/get ops and for write benchmarking
   -O object_size
        set the object size for put/get ops and for write benchmarking
   --max-objects
        set the max number of objects for write benchmarking
   --obj-name-file file
        use the content of the specified file in place of <obj-name>
   -s name
   --snap name
        select given snap name for (read) IO
#     ↑ -s name: 指定快照名(读快照用)
   --input-file file
        use the content of the specified file in place of <val>
   --create
        create the pool or directory that was specified
   -N namespace
   --namespace=namespace
        specify the namespace to use for the object
#     ↑ -N namespace: 指定命名空间
   --all
        Use with ls to list objects in all namespaces
        Put in CEPH_ARGS environment variable to make this the default
   --default
        Use with ls to list objects in default namespace
        Takes precedence over --all in case --all is in environment
   --target-locator
        Use with cp to specify the locator of the new object
   --target-nspace
        Use with cp to specify the namespace of the new object
   --striper
        Use radostriper interface rather than pure rados
        Available for stat, get, put, truncate, rm, ls and all xattr related operations

BENCH OPTIONS:
# ↑ 压测选项:
   -t N
   --concurrent-ios=N
        Set number of concurrent I/O operations
   --show-time
        prefix output with date/time
   --no-verify
        do not verify contents of read objects
   --write-object
        write contents to the objects
   --write-omap
        write contents to the omap
   --write-xattr
        write contents to the extended attributes

LOAD GEN OPTIONS:
# ↑ 负载生成选项:
   --num-objects                    total number of objects
   --min-object-size                min object size
   --max-object-size                 max object size
   --min-op-len                     min io size of operations
   --max-op-len                     max io size of operations
   --max-ops                        max number of operations
   --max-backlog                    max backlog size
   --read-percent                   percent of operations that are read
   --target-throughput              target throughput (in bytes)
   --run-length                     total time (in seconds)
   --offset-align                   at what boundary to align random op offsets

CACHE POOLS OPTIONS:
   --with-clones                    include clones when doing flush or evict

OMAP OPTIONS:
   --omap-key-file file            read the omap key from a file

GENERIC OPTIONS:
# ↑ 通用选项:
   --conf/-c FILE    read configuration from the given configuration file
   --id ID           set ID portion of my name
   --name/-n TYPE.ID set name
   --cluster NAME    set cluster name (default: ceph)
   --setuser USER    set uid to user or uid (and gid to user's gid)
   --setgroup GROUP  set gid to group or gid
   --version         show version and quit
这里我们主要讲解池中对象操作。下面开始实战!
4.6.1 上传对象到池中
bash
[root@ceph1 ~]# echo laogao1 > hosts1
# ↑ echo laogao1: 往 hosts1 文件里写一行 "laogao1"(> 覆盖写入)
#   作用:准备一个测试文件

[root@ceph1 ~]# rados -p pool_web put hosts hosts1  #将host1文件上传到webapp池,取名为hosts
# ↑ rados: 对象操作命令
#   -p pool_web: 指定池名(-p = --pool)
#   put: 上传对象子命令
#   hosts: 上传后对象叫"hosts"
#   hosts1: 本地源文件
#   作用:把本地 hosts1 文件上传到 pool_web 池,对象名 = hosts

[root@ceph1 ~]# rados -p pool_web ls
# ↑ ls: 列出池里的对象

hosts
# ↑ 池里现在有个对象叫 hosts(上传成功!)
4.6.2 查看池中对象状态
bash
[root@ceph1 ~]# rados -p pool_web stat hosts
# ↑ stat: 查看对象状态

pool_web/hosts mtime 2025-08-21T09:52:43.000000+0800, size 8
# ↑ pool_web/hosts: 池/对象名
#   mtime: 最后修改时间 2025-08-21 09:52:43
#   size 8: 对象大小 8 字节("laogao1" 7 个字母 + 1 个换行 = 8 字节,对上了!)
4.6.3 查看池中对象存储在哪里(面试高频!)
bash
[root@ceph1 ~]# ceph osd map pool_web hosts
# ↑ ceph osd map: 查"对象 → PG → OSD"的映射关系
#   pool_web: 池名
#   hosts: 对象名
#   作用:这个对象到底存在哪块盘上?

osdmap e85 pool 'pool_web' (2) object 'hosts' -> pg 2.ea1b298e (2.e) -> up ([8,2], p8) acting ([8,2], p8)
# ↑ 映射结果(下面逐段翻译!)
bash
[root@ceph1 ~]# ceph osd metadata 8 | grep devices
# ↑ ceph osd metadata 8: 查 osd.8 的元数据
#   | grep devices: 只筛选含 devices 的行
#   作用:看看 osd.8 到底是哪块盘

    "bluestore_bdev_devices": "sdd",
# ↑ bluestore 后端设备 = sdd

    "devices": "sdd",
# ↑ devices: sdd

    "objectstore_numa_unknown_devices": "sdd",
# ↑ 对象存储未知 NUMA 设备: sdd

    "osdspec_affinity": "all-available-devices",
# ↑ OSD 规范亲和性: 所有可用设备
bash
[root@ceph1 ~]# ceph pg dump pgs_brief
# ↑ ceph pg dump pgs_brief: 导出 PG 简表(看 PG 分布,原文此处有输出截图/表格)
逐段翻译上面的 map 输出(小白救命解读):
1. osdmap e85
osdmap:Ceph 集群当前的 OSD 映射表(集群拓扑)
e85:epoch 85 → 这是第 85 版集群映射
每次加盘、删盘、故障、重启,版本号都会涨。

2. pool 'pool_web' (2)
存储池名字:pool_web
存储池 ID:2

3. object 'hosts'
你要查询的对象名:hosts

4. -> pg 2.ea1b298e (2.e)
PG = Placement Group(放置组)
Ceph 先把对象映射到 PG,再由 PG 映射到 OSD。
2:pool ID
ea1b298e:对象 hosts 经过 HASH 计算 得到的十六进制值
(2.e):简化写法 = pool 2 + PG 编号 e
PG 编号 e 是十六进制 → 等于十进制 14
也就是说:
对象 hosts → 被 Ceph 放进 PG 2.14(2.e)

5. -> up ([8,2], p8)
up:表示当前活着、可用的 OSD 列表
[8,2]:对象的两个副本分别在 osd.8 和 osd.2
p8:primary osd = 主 OSD 是 8
读写优先走主 OSD。

6. acting ([8,2], p8)
acting:表示实际负责这个 PG 的 OSD
正常情况下 up 和 acting 完全一样
如果在恢复、迁移、故障时,两者会不一样

最终结论(最关键)

你这个对象 hosts 在 Ceph 里的位置是:

pool_web (pool-2)
  → 对象 hosts
    → 哈希到 PG 2.e (PG 14)
      → 主 OSD:osd.8
      → 副本 OSD:osd.2
数据存在 osd.8 和 osd.2 两块盘上
4.6.4 检索对象到本地(下载)
bash
[root@ceph1 ~]# rados -p pool_web get hosts newhosts
# ↑ get hosts newhosts: 把池里的 hosts 对象下载下来,存成本地 newhosts 文件

[root@ceph1 ~]# cat newhosts
# ↑ cat: 查看下载下来的文件内容

laogao1
# ↑ 内容就是当初上传的 laogao1(下载成功!)
4.6.5 追加池中对象
bash
[root@ceph1 ~]# echo laogao2 >> hosts2
# ↑ echo laogao2 >> hosts2: 把 laogao2 追加写入 hosts2 文件(>> 追加)

[root@ceph1 ~]# rados append -p pool_web hosts hosts2
# ↑ append: 往对象尾部追加内容
#   hosts: 目标对象
#   hosts2: 要追加的本地文件

[root@ceph1 ~]# rados get hosts newhosts -p pool_web
# ↑ 再下载看看(注意这里 get 写法:对象名 输出文件,-p 放最后)

[root@ceph1 ~]# cat newhosts
# ↑ 查看结果

laogao1
# ↑ 原来的内容还在

laogao2
# ↑ 追加的内容也来了(append 成功!对象现在有两行)
4.6.6 删除池中对象
bash
[root@ceph1 ~]# rados put passwd /etc/passwd -p pool_web
# ↑ 先传个 passwd 对象上去(把 /etc/passwd 文件上传成对象 passwd)

[root@ceph1 ~]# rados ls -p pool_web
# ↑ 列对象

passwd
hosts
# ↑ 池里有两个对象了

[root@ceph1 ~]# rados rm passwd -p pool_web
# ↑ rm passwd: 删除 passwd 对象

[root@ceph1 ~]# rados ls -p pool_web
# ↑ 再列

hosts
# ↑ 只剩 hosts 了,passwd 已删
4.7 管理池快照
使用
ceph osd pool mksnap命令,创建池快照。(快照 = 给整个池拍张"时间机器照片",误操作可以回退!)
bash
[root@ceph1 ~]# ceph osd pool mksnap pool_web snap1     #给池pool_web创建快照snap1
# ↑ ceph osd pool mksnap: 创建池快照
#   pool_web: 目标池
#   snap1: 快照名

created pool pool_web snap snap1
# ↑ 输出:快照 snap1 创建成功
bash
[root@ceph1 ~]# ceph osd pool ls detail
# ↑ 看池详情,验证快照挂上了

pool 2 'pool_web' replicated size 2 min_size 1 crush_rule 0 object_hash rjenkins pg_num 64 pgp_num 64 autoscale_mode off last_change 68 lfor 0/0/60
flags hashpspool,pool_snaps stripe_width 0
        snap 1 'snap1' 2025-08-21T02:05:02.662386+0000            #多了snap1
# ↑ 注意 flags 里多了 pool_snaps,下面多了一行快照:
#   snap 1 'snap1' 创建时间 2025-08-21(快照挂上了!)
bash
[root@ceph1 ~]# rados -p pool_web lssnap
# ↑ rados lssnap: 列出池的所有快照

1       snap1   2025.09.29 14:38:50
# ↑ 快照编号 1,名 snap1,时间 2025.09.29 14:38:50

1 snaps
# ↑ 一共 1 个快照
使用
ceph osd pool rmsnap命令,删除池快照。
bash
[root@ceph1 ~]# ceph osd pool rmsnap pool_web snap1
# ↑ rmsnap pool_web snap1: 删除 snap1 快照

removed pool pool_web snap snap1
# ↑ 输出:已删除

[root@ceph1 ~]# ceph osd pool ls detail
# ↑ 验证

pool 2 'pool_web' replicated size 2 min_size 1 crush_rule 0 object_hash rjenkins pg_num 64 pgp_num 64 autoscale_mode off last_change 69 lfor 0/0/60
flags hashpspool,pool_snaps stripe_width 0
# ↑ 下面没有 snap 行了(快照删了,但 flags 还显示 pool_snaps,正常)
bash
[root@ceph1 ~]# rados -p pool_web lssnap
# ↑ 再列快照

0 snaps
# ↑ 0 个快照(删干净了)
4.8 管理池快照中对象
对池某个快照中对象操作需要使用 -s 选项指定快照名称。
bash
[root@ceph1 ~]# ceph osd pool mksnap pool_web snap1     #给池pool_web拍摄快照snap1
# ↑ 重新拍个快照(回到实验状态)

created pool pool_web snap snap1
bash
[root@ceph1 ~]# rados -p pool_web listsnaps hosts
# ↑ listsnaps hosts: 看 hosts 对象关联了哪些快照

hosts:
# ↑ 对象 hosts:

cloneid snaps   size    overlap
# ↑ 表头:克隆ID / 快照 / 大小 / 重叠

head    -       16
# ↑ head=当前活动版本(没有快照关联它),大小 16 字节
bash
#拍摄快照后,上传新的内容到hosts中
[root@ceph1 ~]# echo laogao3 > hosts3
# ↑ 准备新内容 laogao3

[root@ceph1 ~]# rados -p pool_web put hosts hosts3
# ↑ 把 hosts 对象覆盖成 hosts3 的内容(laogao3)

[root@ceph1 ~]# rados -p pool_web get hosts newhosts
# ↑ 下载当前 hosts

[root@ceph1 ~]# cat newhosts
# ↑ 看内容

laogao3
# ↑ 现在 hosts 对象已经变成 laogao3 了(快照前是 laogao1+laogao2)
bash
# 查看快照中对象
[root@ceph1 ~]# rados ls -p pool_web -s snap1
# ↑ ls -s snap1: 看"snap1 那个时间点"池里有哪些对象
#   -s snap1: 指定快照(-s = --snap)

selected snap 3 'snap1'
# ↑ 选中了快照 snap1(编号 3)

hosts
# ↑ 快照时池里有 hosts
bash
# 获取快照中对象
[root@ceph1 ~]# rados -p pool_web -s snap1 get hosts hosts-from-snap1
# ↑ 从快照里把 hosts 对象下载成 hosts-from-snap1

selected snap 3 'snap1'
# ↑ 选中快照

[root@ceph1 ~]# cat hosts-from-snap1     #发现即使hosts文件拍摄快照后变了,从快照获取的依然没变
# ↑ 看快照里的内容

laogao1
# ↑ 快照里还是旧内容!

laogao2
# ↑ (当前 hosts 已经是 laogao3,但快照里保留了 laogao1+laogao2------这就是快照的意义!)
bash
# 恢复对象内容为指定快照时内容
[root@ceph1 ~]# rados -p pool_web rollback hosts snap1
# ↑ rollback hosts snap1: 把 hosts 对象回滚到 snap1 快照时刻的内容

rolled back pool pool_web to snapshot snap1
# ↑ 输出:已回滚到 snap1

[root@ceph1 ~]# rados -p pool_web get hosts newhosts
# ↑ 再下载当前 hosts

[root@ceph1 ~]# cat newhosts
# ↑ 看内容

laogao1
# ↑ 回滚成功!又变回 laogao1

laogao2
# ↑ (laogao3 被"撤销"了,数据恢复到快照时刻)
🚨 快照是只读文件系统,无法上传和删除快照中对象。
bash
[root@ceph1 ~]# rados put -p pool_web -s snap1 passwd /etc/passwd
# ↑ 试图往快照里传对象

selected snap 3 'snap1'
# ↑ 选中快照

error putting pool_web/passwd: (30) Read-only file system
# ↑ 报错:(30) Read-only file system(快照是只读文件系统!)
bash
[root@ceph1 ~]# rados ls -p pool_web -s snap1
# ↑ 列快照内容

selected snap 3 'snap1'
hosts
# ↑ 快照里只有 hosts
bash
[root@ceph1 ~]# rados rm -p pool_web -s snap1 hosts
# ↑ 试图删快照里的对象

selected snap 3 'snap1'
# ↑ 选中快照

error removing pool_web>hosts: (30) Read-only file system
# ↑ 报错:还是 Read-only file system(快照里删东西?门都没有!)
4.9 管理池命名空间
Ceph 可以将整个池提供给特定应用。随着应用增加,池的数量也增加。
建议每个 OSD 关联的 PG 数量为 100-200。由于集群中 OSD 数量是有限的,所以 PG 的数量也是有限的。创建的池越多,导致池能够分配的 PG 数量越少,每个 PG 将会为更多的对象映射到 OSD 磁盘,进而导致每个 PG 的计算开销更高(负载更高),从而降低 OSD 性能。
使用命名空间 ,可以对池中对象进行逻辑分组,还可以限制用户只能存储或检索池中特定命名空间内的对象。借助命名空间,可以让多个应用使用同一个池,而且不必将整个池专用于各个应用,从而确保池的数量不会太多。
📌 小白理解:命名空间 = 池里的"文件夹"!一个池可以切多个"虚拟子目录",不同应用各用各的,不用建那么多池。
⚠️ 命名空间目前仅支持直接使用 librados 的应用。RBD 和 Ceph 对象网关客户端目前不支持此功能。若要在命名空间内存储对象,客户端应用必须提供池和命名空间的名称。默认情况下,每个池包含一个具有空名称的命名空间,称为默认命名空间。
示例:
bash
[root@ceph1 ~]# rados put -p pool_web -N myns1 hostname1 /etc/hostname
# ↑ put: 上传对象
#   -p pool_web: 池
#   -N myns1: 指定命名空间 myns1(-N = --namespace)
#   hostname1: 对象名
#   /etc/hostname: 本地源文件
#   作用:把 hostname1 传到 pool_web 的 myns1 命名空间里

[root@ceph1 ~]# rados ls -p pool_web
# ↑ 列对象(默认命名空间)

hosts
# ↑ 只看到 hosts(hostname1 在 myns1 里,默认视图看不到!)
bash
[root@ceph1 ~]# rados ls -p pool_web -N myns1    #上传的hostname1在namespace myns1中
# ↑ 指定 myns1 命名空间列对象

hostname1
# ↑ 看到了!hostname1 躺在 myns1 里
bash
[root@ceph1 ~]# rados put -p pool_web -N myns2 hostname2 /etc/hostname
# ↑ 再建一个命名空间 myns2,传 hostname2

[root@ceph1 ~]# rados ls -p pool_web -N myns2
# ↑ 看 myns2 里

hostname2
# ↑ hostname2 在 myns2 里
bash
[root@ceph1 ~]# rados ls -p pool_web --all
# ↑ --all: 列出所有命名空间里的对象

myns1   hostname1
# ↑ myns1 命名空间下:hostname1

        hosts
# ↑ 空命名空间(默认)下:hosts

myns2   hostname2
# ↑ myns2 命名空间下:hostname2
#   🎯 一个池里三个"小格子",互不干扰!
bash
[root@ceph1 ~]# rados ls -p pool_web --all --format=json-pretty
# ↑ --format=json-pretty: JSON 美化输出(含命名空间字段,看得更清楚)

[
    {
        "namespace": "myns1",
# ↑ 命名空间 = myns1

        "name": "hostname1"
# ↑ 对象名 = hostname1
    },
    {
        "namespace": "",
# ↑ 命名空间 = 空(默认命名空间)

        "name": "hosts"
# ↑ 对象名 = hosts
    },
    {
        "namespace": "myns2",
# ↑ 命名空间 = myns2

        "name": "hostname2"
# ↑ 对象名 = hostname2
    }
]
4.10 重命名池
使用
ceph osd pool rename命令,重命名池。(语法:
ceph osd pool rename 旧名 新名,改完业务无感知,池 ID 不变。)
🏁 本章总结(速查表,收藏不亏!)
数据结构四层模型
client → Pool(池)→ PG(放置组)→ Object(对象)→ OSD(磁盘)
         逻辑分区      2 的 N 次幂      对象/数据      实际存储
池管理命令全家桶
| 命令 | 作用 | 示例 |
|---|---|---|
ceph osd pool create <名> <pg> <pgp> replicated |
建复本池 | create pool_web 32 32 replicated |
ceph osd pool create <名> <pg> <pgp> erasure |
建纠删码池 | create pool_era 32 32 erasure |
ceph osd pool ls [detail] |
列池(详细) | ls detail |
ceph osd lspools |
列池(带 ID) | lspools |
ceph osd pool stats |
池实时状态 | pool stats |
ceph df |
容量用量 | df |
ceph osd pool set <池> size <n> |
改副本数 | size 2 |
ceph osd pool set <池> pg_num <n> |
改 PG 数 | pg_num 64 |
ceph osd pool get <池> all |
看全部配置 | get pool_web all |
ceph osd pool set-quota |
设配额 | max_objects 100000 |
ceph osd pool mksnap/rmsnap |
建/删快照 | mksnap pool_web snap1 |
ceph osd erasure-code-profile |
纠删码配置 | ls/get/set/rm |
rados 对象操作全家桶
| 命令 | 作用 |
|---|---|
rados -p <池> put <对象> <本地文件> |
上传对象 |
rados -p <池> ls |
列对象 |
rados -p <池> stat <对象> |
看对象状态 |
rados -p <池> get <对象> <本地文件> |
下载对象 |
rados -p <池> append <对象> <文件> |
追加对象 |
rados -p <池> rm <对象> |
删除对象 |
rados -p <池> -s <快照> ... |
操作快照里的对象 |
rados -p <池> rollback <对象> <快照> |
回滚对象 |
ceph osd map <池> <对象> |
查对象落在哪块盘(高频面试!) |
复本池 vs 纠删码池
| 对比项 | 复本池 | 纠删码池 |
|---|---|---|
| 空间效率 | 1:3(3 副本) | 1:1.5(4+2) |
| CPU 开销 | 小 | 大(要算校验) |
| 读性能 | 快 | 一般 |
| 适用数据 | 热数据/虚拟机/DB | 冷数据/归档备份 |
| 对象映射 | 支持 | 不支持 |
| 类型可改吗 | 🚨 创建后不可改 | 同左 |
🎯 一句话总结 :池是逻辑分区,PG 是数据搬运的"快递格子",CRUSH 算法帮客户端自己算"包裹送哪个仓";副本多了占空间但快,纠删码省空间但吃 CPU;快照是后悔药、命名空间是池里的文件夹。下章《认证和授权管理》见!🚀