把对象存储搬进 K8s 的动机通常是"顺便",反正集群已经在跑,再加一套存储也不差一个 StatefulSet。但存储和 Web 应用在 K8s 里的相处方式完全不同:Web 应用挂了重启没事,存储的 StatefulSet 挂了要考虑 PVC 会不会丢、分布式集群能不能凑够法定人数、重启循环会不会把可用性拖穿。这三件事想不清楚就上,后面每一步都在还债。
RustFS 在 K8s 上官方支持两条路径(Helm Chart 和 Operator),加上"别放 K8s 里"这个选项,构成三个方向。这篇按决策顺序讲:先看 Helm 的默认值里藏着什么,再看 Operator 适合谁,最后说清楚什么情况下放弃 K8s 部署。
Helm Chart 的默认值你得逐个看
RustFS 官方 Helm Chart 的仓库在 github.com/rustfs/rustfs 的 helm/rustfs 目录,或者从 charts.rustfs.com 拉:
bash
helm repo add rustfs https://charts.rustfs.com
helm repo update
export RUSTFS_CHART=rustfs/rustfs

helm upgrade --install rustfs "$RUSTFS_CHART" \
  --namespace rustfs --create-namespace \
  -f distributed-values.yaml

helm upgrade --install rustfs "$RUSTFS_CHART" \
  --namespace rustfs --create-namespace \
  -f standalone-values.yaml
Helm 里还有一类配置值得看一眼:PDB(Pod Disruption Budget)默认关闭,开 pdb.create=true 后默认 maxUnavailable=1。这个设置的含义是节点滚动维护时最多允许一个 Pod 不可用,对存储这种有法定人数要求的组件来说,这条约束决定了"维护期间集群是否还能写入"。4 副本的集群 1 个 Pod 不可用通常还能写,2 个同时不可用就得看纠删配置扛不扛得住。做节点维护窗口规划时把这条算进去。
但要准确理解这条约束的作用范围。PDB 是一个调度约束,不是可用性保证 :它只在自愿驱逐路径上生效,节点 drain、升级节点内核这类操作才受它约束。kubectl delete pod、节点直接宕掉、OOM 杀进程这些情况根本不走驱逐路径,PDB 拦不住。所以 PDB 能防御的是"维护时别一次抽走太多",防御不了"故障本身"。要让维护期间集群仍然可写,还得看纠删配置能容忍几块盘。
官方文档里有一句关于默认值的话值得抄在 values.yaml 旁边:默认 PVC 大小 256Mi,仅用于基础评估,生产要显式设置存储容量。这意味着拿默认 values 直接 install 出来的集群,PVC 只有 256 MiB,跑真业务立刻写满。
默认的关键值:
| 项 | 默认值 | 说明 |
|---|---|---|
mode.distributed.enabled |
true |
默认走分布式 |
replicaCount |
4 |
分布式下是 Pod 数量 |
drivesPerNode |
按 replicaCount 推断 | 4 → 每节点 4 块盘;其他 → 每节点 1 块 |
storageclass.name |
local-path |
集群里必须有对应 StorageClass |
storageclass.dataStorageSize |
256Mi |
生产必须改 |
service.endpoint.port |
9000 |
S3 API |
service.console.port |
9001 |
Console |
一个容易踩的点是 drivesPerNode 的推断规则:replicaCount 为 4 时默认每节点 4 块盘(共 16 块),其他 replicaCount 默认每节点 1 块。想要 8 节点 × 2 盘的布局,必须显式设 drivesPerNode: 2,否则会得到 8 节点 × 1 盘,可用容量差一倍。
Chart 里只有 OTel 导出的开关,没有 Prometheus、Grafana、Jaeger 等附属组件,这意味着可观测栈要自己搭。这和 Docker compose 那套(compose 文件里带 grafana/prometheus/otel/jaeger 四个服务)不一样,迁移时要重新规划监控。
Operator 是什么、什么时候用
RustFS 官方有一个独立的 Operator 仓库 github.com/rustfs/operator,用 Rust 写的,当前版本 v0.1.0 pre-release。官方文档对它的描述是"applies the Kubernetes Operator pattern to RustFS clusters",装上去会创建两个 CRD:Tenant(rustfs.com/v1alpha1)和 PolicyBinding(sts.rustfs.com/v1alpha1)。
一个 Tenant 的 yaml 长这样:
yaml
apiVersion: rustfs.com/v1alpha1
kind: Tenant
metadata:
  name: tenant-a
  namespace: storage-a
spec:
  image: rustfs/rustfs:1.0.0
  credsSecret:
    name: rustfs-tenant-creds
  pools:
    - name: pool-0
      servers: 1
      persistence:
        volumesPerServer: 1
        volumeClaimTemplate:
          storageClassName: standard
          accessModes:
            - ReadWriteOnce
          resources:
            requests:
              storage: 10Gi
部署方式之间还有一个容易混用的细节:Helm Chart 里 Console 端口是 9001,Operator 带出来的 Console 是 9090。写访问文档或脚本时如果两套环境并存,别把端口抄串了。
Operator 适合的场景是多租户 :每个 Tenant 是一个独立的 RustFS 集群,有独立的凭据和存储池,适合平台团队给不同业务线各发一套存储。它还带了 Grafana 仪表盘 ConfigMap(通过 label grafana_dashboard: "1" 暴露)、Console(端口 9090)、tenantMonitor(默认 300 秒间隔)。
用之前先补一样上面这段 yaml 里没写的东西:Pod 的 CPU 与内存 requests / limits。示例 Tenant 只给了 PVC 的 storage,Pod 侧没有任何资源声明,这种 Pod 在 Kubernetes 里被归为 BestEffort QoS,节点资源紧张时是第一批被驱逐的对象,存储进程被驱逐走的代价比 Web 应用高得多。生产环境必须显式配置,同时给 requests 和 limits,让 Pod 落在 Burst 或 Guarantee QoS 上。
另一个 CRD PolicyBinding 在 sts.rustfs.com 组下,从命名看是给 STS 相关的策略绑定用的,官方文档目前对它的描述篇幅不多,用之前最好先读一遍仓库里的 CRD 定义和示例,别照着 Tenant 的用法套。
Operator 安装本身是走 Helm:
bash
git clone https://github.com/rustfs/operator.git
cd operator
helm upgrade --install rustfs-operator deploy/rustfs-operator/ \
  --namespace rustfs-system --create-namespace
Operator 的 Chart 默认带 dashboard、metrics(端口 8080)、tenantMonitor、Console,serviceMonitor.enabled 和 prometheusRule.enabled 默认关着,接 Prometheus Operator 时再打开。扩 pool 的动作是在 Tenant yaml 里追加一个 pool 条目,Operator 会为每个 pool 创建独立的 StatefulSet,官方文档里明确一句:Existing pools are immutable,已有 pool 的 servers 和 volumesPerServer 不能改。
代价是版本和成熟度:Operator 当前是 pre-release,文档里明确写了 under active development,生产用要自己评估。如果只是想给一套业务跑一个 RustFS 集群,Helm Chart 更直接;需要管理多个 Tenant 时 Operator 才划算。
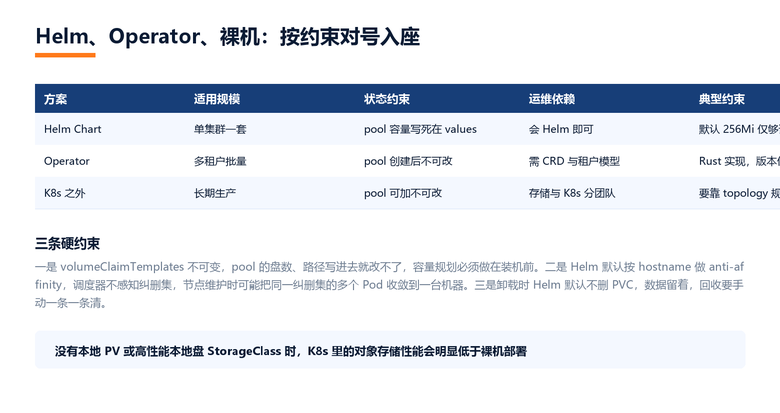
StatefulSet 的 volumeClaimTemplates 不能改
这条约束是 K8s 层面的,不是 RustFS 特有的,但对存储部署影响很大,官方文档专门用一句话强调了它:
Kubernetes does not allow updates to StatefulSet volumeClaimTemplates. Changing drivesPerNode later requires StatefulSet recreation or a new installation.
想改 drivesPerNode 就得删 StatefulSet 重建(--cascade=orphan 保留 Pod 和 PVC),或者干脆重装。这个约束决定了容量规划必须在装机前做完,跑起来之后发现盘不够,走的是加 pool(多池扩容)而不是改现有 pool。另外注意扩容会把数据搬动,IO 与延迟的代价见下一节。官方给出的扩容路径就是多池加 rebalance:新 pool 加进来之后,数据在池之间重新分布,旧 pool 的 PVC 不用动。所以第一次部署时把单池规模定得保守一点、留出加池的余地,比一开始就把盘塞满要稳。
rebalance 这件事要单独排窗口。把一卷数据从旧池挪到新池,代价是持续的磁盘读写和网络传输,集群读写延迟在这段时间里会明显上抬,IO 打满时还会牵连同一节点上的其他 Pod。官方文档给的节奏是先确认 Tenant Ready、再应用完整 manifest、再等 Ready(扩容期间反复观察 get tenant -w 与 get pods,pvc -l rustfs.pool=pool-1),中间不停下来做下一次拓扑变更。生产上把它排在业务低峰窗口,扩容窗口内别同时安排其他节点维护。
官方文档还给了两个运行时细节值得知道:
- anti-affinity 默认开启,topologyKey 是
kubernetes.io/hostname,Pod 会被打散到不同节点;要按可用区打散得开topologySpreadConstraints - 启动时 Pod 崩溃循环是正常的,官方原话:pods restart until every pod of every pool is resolvable,server 拒绝在有不可达 peer 的情况下启动,所以预期会看到几次 crash loop,这是无害的
第二条如果不提前知道,第一次装的时候很容易以为装坏了。
把 Helm 和 Operator 两条路径放在一起看,分工其实比较清楚:Helm 管的是"一套 RustFS 集群的部署",Operator 管的是"多个 Tenant 的生命周期"。如果只有一套集群,Helm 加手写 yaml 足够;如果集群数量会增长、或者要把存储当作平台能力提供给多个团队,Operator 的 CRD 模型把重复劳动抽象掉了。从 Operator 现在的版本号看,它更像在能力建设的早期,功能覆盖还没到可以完全替代 Helm 的程度,实际部署里两条路径并存也正常。
数据怎么持久化,PVC 别删
Helm Chart 的持久化走 PVC,分布式模式下每个 Pod 挂 drivesPerNode 个数据 PVC 加一个日志 PVC。官方升级文档里有一句加粗的话:Do not delete PersistentVolumeClaims (PVCs) during an upgrade or rollback。PVC 是数据的家,删了就真没了。
多 pool 部署时,Chart 会为每个 pool 生成一个独立的 StatefulSet(命名形如 <fullname>-pool<N>),所有 pool 共享同一个 headless service、主 service、配置和凭据。这意味着扩 pool 时的动作是改 values 里的 pools.list,Chart 会渲染出新的 StatefulSet,原有 pool 不受影响。RUSTFS_VOLUMES 表达式由 Chart 自动生成,集群 DNS 域名默认 cluster.local,改了 K8s 的 DNS 域要跟着改 Chart 里的 clusterDomain。
还有一个和 StorageClass 绑定的陷阱:Chart 默认的 local-path 把卷落在具体某个节点的本地目录上,Pod 漂到别的节点就读不到原来的数据。节点故障后重建 Pod 时,要先确认调度回原节点,或者从一开始就用能跟着 Pod 迁移的 StorageClass。测试环境无所谓,生产环境这个点会直接决定一次节点故障是不是变成数据丢失。
local-path 这个类 StorageClass 还有一层限制值得知道:它一般不提供拓扑约束(topology)能力,调度器无法感知某个卷到底在哪个节点上。生产要用本地盘,更稳妥的做法是手工创建 local 类型的 PV 并在 Pod 上写 nodeAffinity 钉住节点,而不是依赖简易 provisioner 自动创建的本地卷。这两条加起来决定了本地盘方案是"可控但麻烦",不是"简单直接"。
卸载时 Helm 不会删除 StatefulSet 创建的 PVC。这一点是 K8s 里 StatefulSet 的既有行为:StatefulSet 管理出来的 PVC 有独立生命周期,helm uninstall 只删 Helm 自己管理的资源,不会去动它。换句话说,卸载之后想恢复数据,下面这条命令千万别跑:
bash
kubectl -n rustfs delete pvc -l app.kubernetes.io/name=rustfs升级时的滚动状态检查:
bash
kubectl -n rustfs rollout status statefulset/rustfs --timeout=10m
kubectl -n rustfs rollout status deployment/rustfs --timeout=10m
滚动升级是另一个容易踩法定人数的动作,开了 PDB 也不等于安全。升级过程中 Pod 是逐个被驱逐再拉起的,同时不可用的数量一旦超过纠删码能容忍的坏盘数,写请求就会失败。所以开升级窗口前先看一眼自己的纠删配置(几块盘、几个奇偶校验)对应能容忍几个 Pod 同时不在,把同时下线的数量卡在容忍线以内,再按 pool 逐个滚动。单节点模式没有纠删这层,Pod 不可写就是整体不可写,窗口要挑在业务完全空的时候。
三条路线并列看是这样:
什么情况下别用 K8s 跑
三个信号出现任何一个,就该考虑把存储放在 K8s 外面:
第一,本地盘资源是瓶颈。 K8s 的 StorageClass 通常走网络存储(Ceph、云盘),而对象存储恰恰是吃本地盘吞吐的,网络存储一层转发会显著拖累 S3 请求延迟。如果集群里没有 local PV 或高性能本地盘 StorageClass,跑出来的对象存储性能会远低于裸机部署。更麻烦的是冗余会叠加:对象存储自己用纠删码做了一份冗余,底层的网络存储通常又做一份副本或纠删,等于同一份数据付两次保护成本,可用容量被压缩到裸机部署的一半甚至更低。
第二,节点调度可能拆散纠删集。 对象存储的可靠性建立在"同一个纠删集的盘分散在不同故障域"上,K8s 调度器的 anti-affinity 默认只按 hostname 打散,不感知纠删集结构,节点维护或自动伸缩时可能把同一个纠删集的多个 Pod 调到同一台机器,可靠性会退化。这层保护要靠 topologySpreadConstraints 加亲和规则自己搭。
第三,运维能力不在一个团队手里。 K8s 上跑存储意味着存储团队要懂 K8s,或者 K8s 团队要懂存储。两边都懂的组合不多见,出问题时容易互相推诿。直接在裸机或虚机上部署,边界更清楚。
三条之外补一个决策参考:如果 K8s 集群本身就是临时性的(比如CI 环境的测试集群),存储放进去跟着一起创建销毁反而是合理的,这种场景下数据本来就不需要长期保留,K8s 的生命周期管理正好覆盖。真正麻烦的是"数据要长期保留、但集群形态会变"的场景,那是把两个生命周期绑在一起,出问题的概率最大。
RustFS 在 Apache 2.0 许可下开源,Helm Chart 与 Operator 的官方文档分别在 cloud-native/helm-chart 与 cloud-native/operator。三条路径没有绝对对错,关键是想清楚自己要解决的问题是什么,再把对应的默认值逐条过一遍------Helm 的 256Mi 默认值只够评估,operator 的版本状态也值得在选型阶段确认清楚。