《山海经》里有一种能自行生长、永不耗减的神土,名叫"息壤"。对具身智能和世界模型而言,数据就是这片土壤。机器人要操作物理世界、世界模型要预测时空演变,靠的都不是几百条精修样本,而是海量、多源、贴近真实、且经严格质检与标注的操作数据。只是这片土壤想真正"长"起来,同样面临着挑战。
息壤开物:物理智能时代的底座型公司
息壤开物不做机器人本体,也不做单点应用,而是自研物理基础模型(Large Physics Model, LPM)------让模型从物理交互数据里自己习得物理规律,理解状态演化、规划长程动作、支撑闭环执行。它没走"在现成 VLM 上外挂动作头"的增训路线,而选择更重的原生物理预训练。这是一条更难、天花板也更高的路。
走通这条路,靠一支把大模型从底层训到产业交付的团队。核心班底出自头部大模型工程体系,经历过万卡级稳定训练、视频大模型与复杂行业交付;理论侧有因果与多模态方向的顶尖学者提供第一性原理支撑。在清华等团队推动的国际具身世界模型基准 WorldArena 2.0 全球总决赛(2026-09-16)中,息壤开物于视频质量赛道拿下轨迹精度全球第一、物理合规性全球前三。
而要把这样的物理底座持续训出来,背后必须有一座能稳定供给海量高质量数据的工厂------这正是息壤的另一份使命。
一座面向全行业的数据工厂
息壤开物自研的 AI 数据工作台 XIRRA 上已沉淀数十万小时操作视频、数千万量级 Episode,覆盖真机、第一视角(Ego)、手持采集(UMI)、遥操等形态,单个数据集最大超过百TB。与"采一批数据、训一个模型"的本体厂商不同,息壤更像一座面向全行业的数据工厂:多源原始数据统一入库、统一 schema、统一质检与标注,导出为训练包,作为标准化数据资产供给下游各类 VLA 与世界模型团队。
数据增长很快把工厂推到新关口。采集带有明显波次特征------一批数据涌进来就要尽快加工、质检、标注、交付;而任何固定规模的自建集群,面对数千万条 Episode 的全库质检一轮理论上需要数万小时,难随峰谷伸缩,瓶颈不在算法而在算力弹性。难的不只是快:多源异构数据分散在各类容器里,相机角色、控制频率、状态与动作维度各不相同;标注规范在整个行业都还欠定义。这是具身数据加工共同面对的硬骨头。
所以息壤要解决的,不是处理完某一批数据,而是让整座工厂能弹性扩容、自动流转、全程可追溯地长期运转。
把数据工厂搬上云
阿里云大数据 AI 平台"具身数据管线解决方案",以一条端到端的数据链路,贯通采集、处理、训练与推理全流程。加速问题闭环、缩短迭代周期,在降低管理与生产成本的同时,将海量多模态原料淬炼为高价值资产,为具身智能注入持续进化的数据闭环能力。
息壤开物基于此方案联合阿里云,依托MaxCompute(MaxFrame)+ DataWorks + OSS + PAI + 百炼,把原本受限于固定自建资源的加工链路,重构成一座跑在云上的数据工厂:算力弹性伸缩、任务自动调度、血缘全程可追溯。 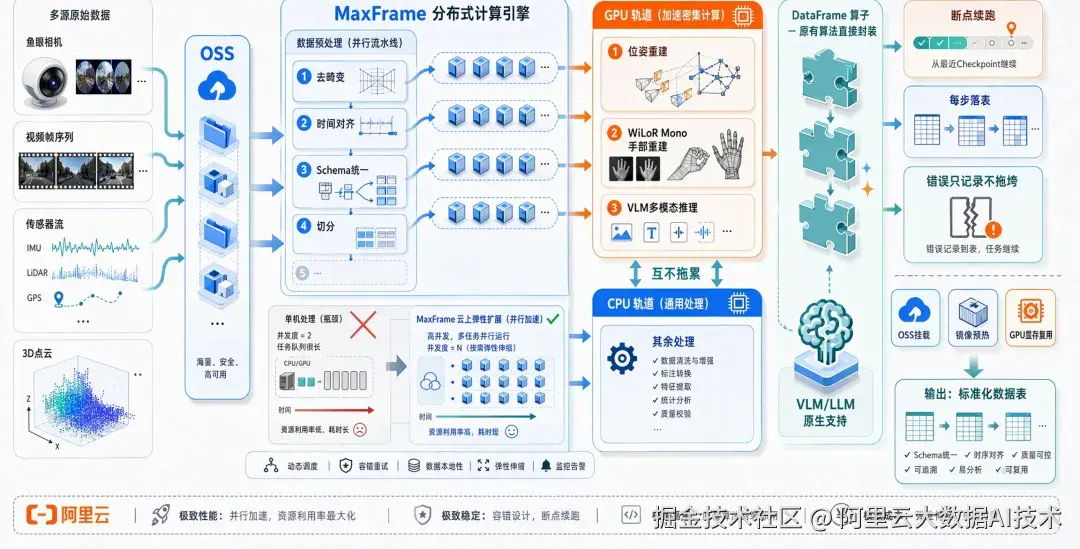
数据在工厂里的四道工序
从一段原始视频,到一份能被模型直接加载的训练集,数据要在这座云上工厂里走过四道工序。
工序一 · 入湖与标准化:把异构原料炼成标准件
多模态具身原始采集数据先汇入 OSS 数据湖,再交给 MaxCompute 上的Python分布式引擎 MaxFrame。MaxFrame 把整段视频加工拆成可并行的子任务,调度到按需伸缩的资源池上:计算密集的环节交给 GPU,其余由 CPU 承担,不断创新的模型和算法,也能够封装成 DataFrame 算子,即可随数据分布式运行;各阶段独立落表、支持断点续跑,单个片段失败不阻塞全局,大批量长任务也能稳定跑完。
这条云上产线,是息壤 XR 数据平台前两环------多模态接入与清洗------在MaxCompute 上的落地;平台把"接入 → 清洗 → 标注 → 质量检查 → 版本管理 → 发布"整条流程打通。平台的价值,是把多源经验统一编译成可训练、可追溯、可迭代的数据资产,保持跨本体、跨模型的中立,连真实失败案例也一并沉淀。
工序二 · 质检:把不可用的数据拦在产线上
质检分两层,对应 XR 数据平台的"质量检查"环节。第一层是将质检算子封装成 MaxFrame 算子分布式并行,逐个卡住丢帧损坏、长时间静止等等客观缺陷,数千万量级的 Episode 也能逐条过筛。第二层交给模型的三阶段语义质检,末端强制挂一道质量门禁。这样,综合分不达标的 Episode 直接挡在发布之外。在质检能力的保障下,不合格数据在产线上就被拦下、并留有证据,不会污染下游训练集。
工序三 · 标注:边界精度决定数据价值
标注的门槛不在"标没标",而在"切得准不准":边界差上零点几秒,在越严的匹配口径下(要求预测段与标准段近乎重合、一段只配一段)差距越被成倍放大,而下游模仿学习真正需要的,恰是边界干净、粒度贴近人工的原子动作。
为此,标注被拆成四个递进阶段,对应 XR 数据平台的"标注"环节:先由模型通盘理解视频、给出粗分段,再逐段把动作边界抠到帧级,随后用确定性规则做碎片吸收、边界吸附与连续性修复------不靠模型的"感觉",而靠可复现的规则兜底,同一段数据无论跑多少次边界都一致、可审计,最后按规范句式重写指令。走完 AI 自动完成约八到九成,人工只复核高风险片段,把"从零标"变成"只改错"。
工序四 · 治理与交付:管得住,也供得出
数据工厂最怕两件事:任务没人调度、出了问题没人知道,DataWorks 支撑的正是这一块。整条产线能够统一调度:周期灵活配置、历史数据一键补数回溯,多种触发方式,任务异常自动重试并有 AI 诊断与基线预警兜底;其触发式调度引擎单集群每天可调度千万级任务、分钟级自愈,正好接得住具身数据波次式的突发负载。调度之外,DataWorks 还替工厂看住质量与血缘,让XR平台实现"版本管理"的落地:一份训练集从哪来、经过哪些加工、停在哪个版本,一键倒查。
贯穿全程 · 训推闭环:数据与模型互为输入
数据出厂只是起点,让它真正产生价值的,是"喂给模型、模型再反过来挑数据"的那一圈闭环。这一圈跑在阿里云 PAI 上------它把调试、训练、评测、服务串在同一条平台上,数据与环境不必在多套工具间反复搬运。这是一场训练工程能力与弹性平台底座的强强联合。一边是息壤核心班底:经历过万亿参数长稳训练与极致推理优化,曾依托百万小时级视频、用两个月完成一个视频大模型的训练与发布,深谙怎么把大集群"训稳、训快"。另一边是 PAI的深度优化能力:分布式断点续训、故障节点自动隔离替换、通信与显存优化层层叠加。
两者相乘,弹性算力才不止于"能扩",而是"扩上去仍能稳定跑出高有效训练时长"------息壤的操盘经验把利用率守在高位,PAI 的弹性与故障自愈让千卡长稳训练不必再靠人海盯守。
数据不再是瓶颈之后
对息壤开物这样的数据与模型底座型公司来说,云带来的不只是"算得更快",而是让"持续、规模化、可追溯地供给高质量数据"第一次真正可行。数据不再是瓶颈,世界模型与具身大脑的迭代才能跑起来。
在真实采集之外,双方也正基于视频生成大模型等前沿基模,共同探索生成式数据合成与闭环仿真,为具身智能的长尾场景补充训练数据,并将在世界模型、数据飞轮等方向持续联合创新。对息壤而言,云上数据工厂同样只是起点------同一套数据资产与物理底座,将沿着"通用底座---领域模型---垂域应用"的分层复用,持续沉淀到更多机器人本体、更多操作任务、更多工业与生活场景的具身落地中。数据的土壤一旦培起来,上面能长出什么,值得期待。