前面我们学习了 PyTorch 的张量操作和训练循环,但模型本身只用了一个 nn.Linear 线性层------严格来说那还不算"神经网络",只是一层线性变换。真正的神经网络,是由多层神经元组成、通过激活函数引入非线性的复杂结构。
今天这篇文章,我们正式走进全连接神经网络(ANN)的世界。从神经元的基本结构出发,理解前向传播的计算过程,深入五大激活函数的原理与选择,掌握参数初始化的方法与讲究,最后用 PyTorch 搭建一个真正的多层神经网络。这是从"会用 PyTorch"到"理解神经网络"的关键一步。
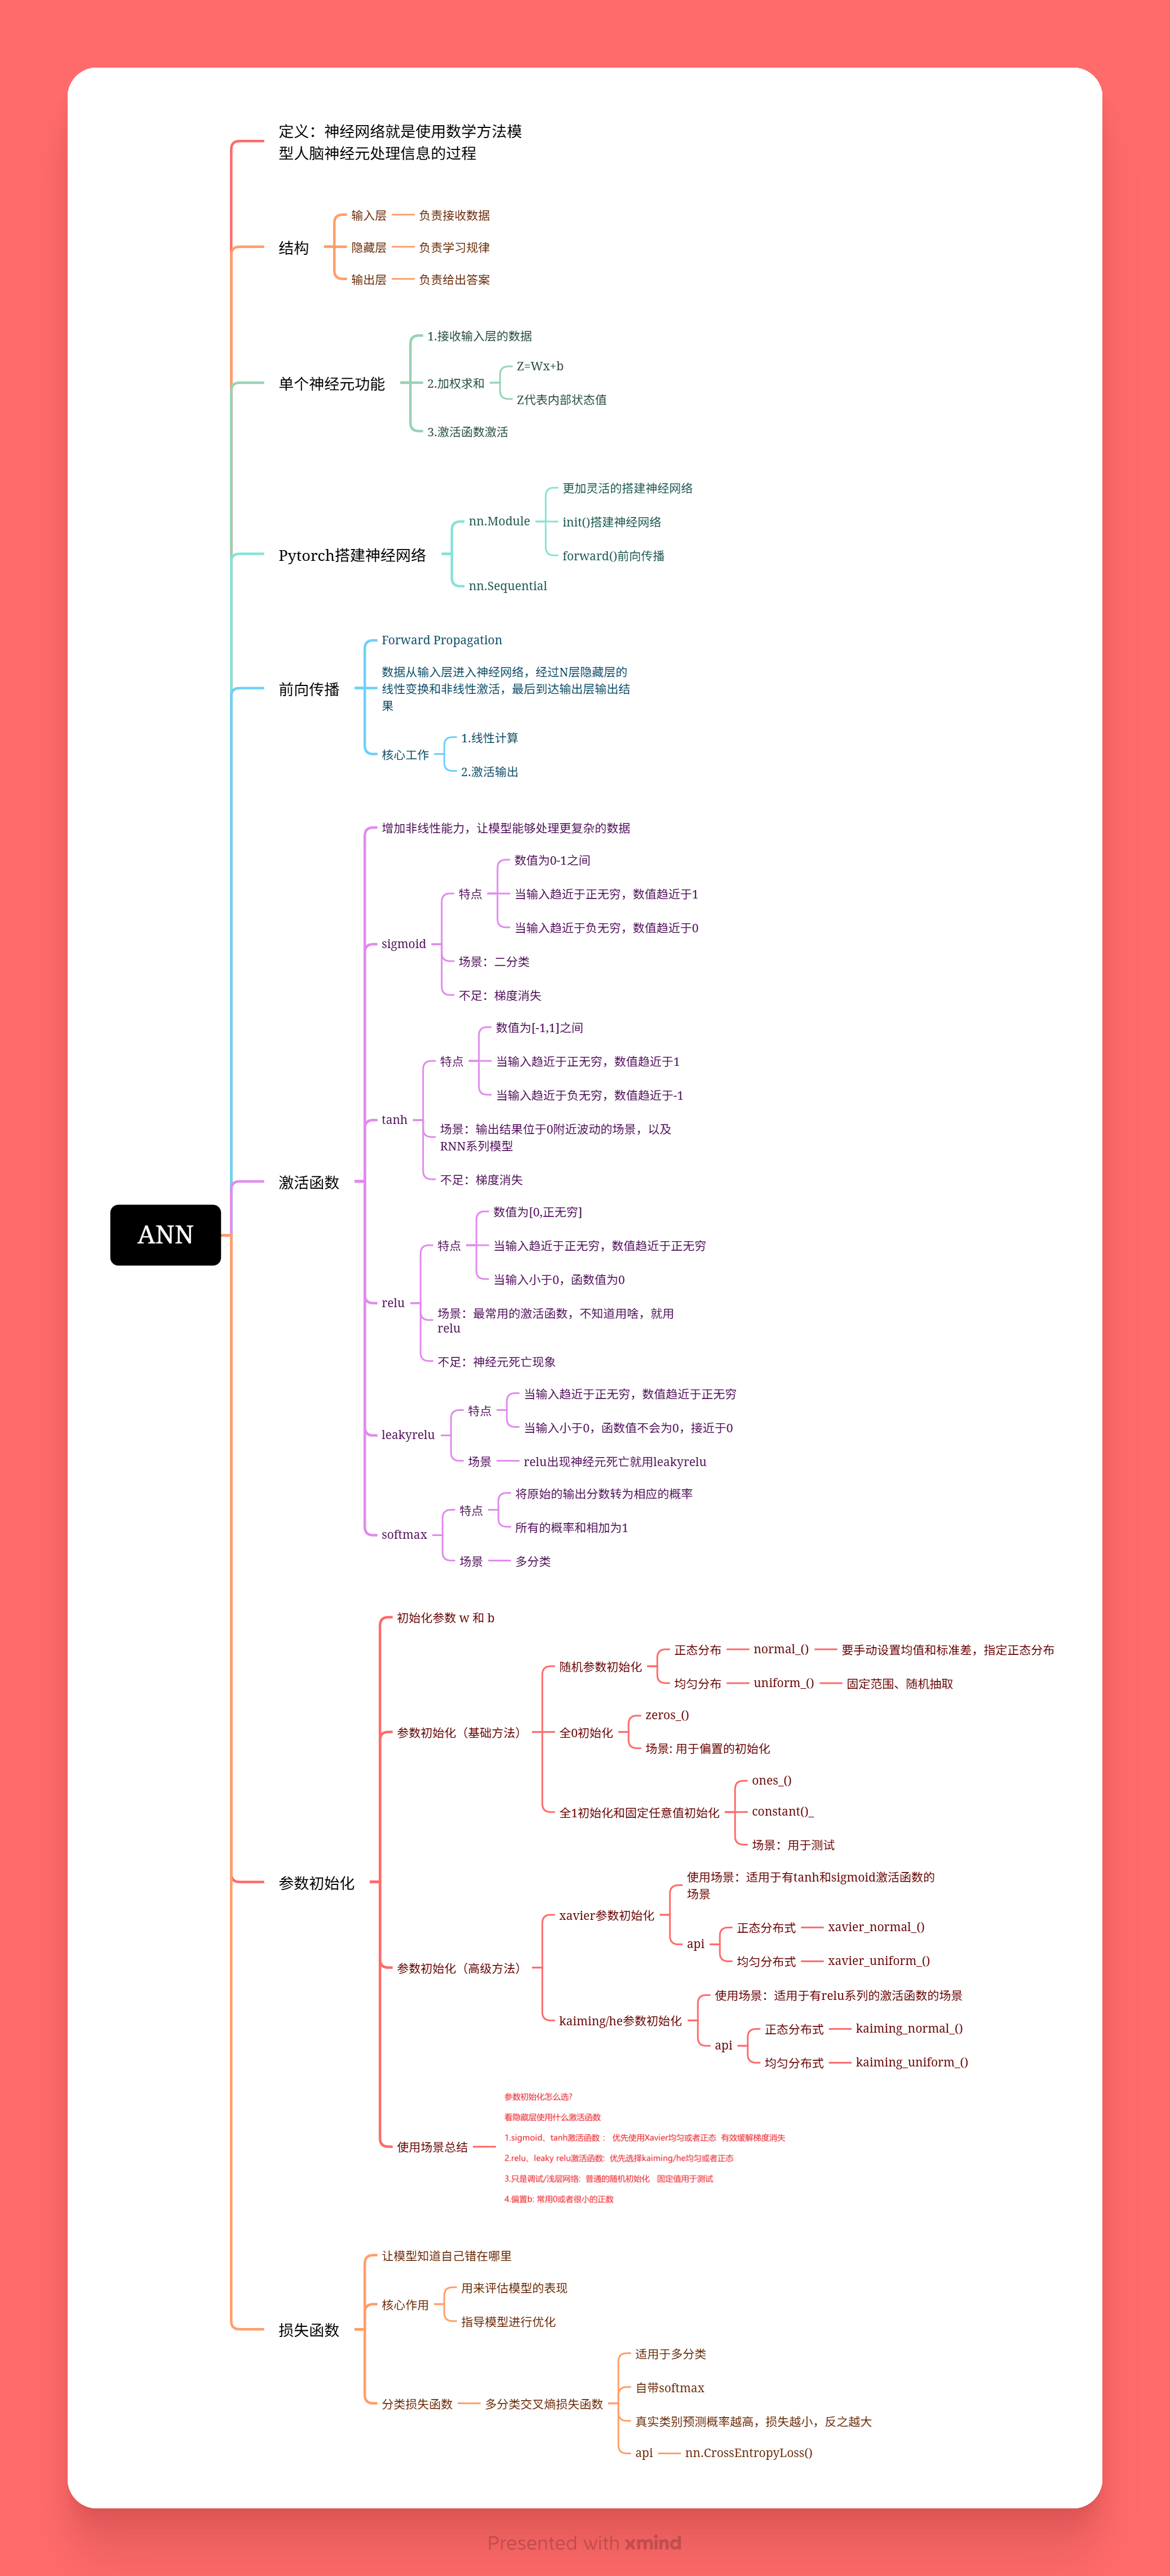
一、什么是神经网络
定义:神经网络就是使用数学方法模拟人脑神经元处理信息的过程。
这句话听起来玄乎,但拆开来看其实很简单。人脑中有大约 860 亿个神经元,它们通过突触相互连接,电信号在神经元之间传递、加工、整合,最终产生思维和行为。人工神经网络就是借鉴这个思路------用数学化的"神经元"组成网络,让数据在其中流动和变换,从而学习复杂的模式。
和人脑相比,人工神经网络的结构要简单得多,但核心思想是一致的:大量简单的单元相互连接,通过调整连接的强度(权重)来学习。
二、神经网络的结构
一个典型的全连接神经网络由三层组成:
输入层        隐藏层        输出层
  ○            ○            ○
  ○    →      ○     →      ○
  ○            ○            ○
○输入层:负责接收数据。有多少个特征,就有多少个输入神经元。比如用 5 个特征预测房价,输入层就有 5 个神经元。
隐藏层:负责学习规律。这是神经网络的"大脑",数据在这里经过层层变换,从低级特征逐步提取出高级特征。隐藏层可以有很多层------一层、两层、几十层、上百层。层越多,网络越"深",能学习的模式越复杂。所谓"深度学习",就是隐藏层很多的神经网络。
输出层:负责输出答案。分类问题的输出神经元数量等于类别数(比如 10 分类就有 10 个输出,每个代表一类的概率);回归问题通常只有 1 个输出神经元。
全连接(Fully Connected)的意思是:每一层的每个神经元,都和上一层的所有神经元相连。没有遗漏,没有跳过,层层紧密相连------这也是"全连接"名字的由来。每一条连接都有一个权重 w,这些 w 就是神经网络要学习的参数。
三、单个神经元在做什么
神经网络的基本单元是神经元。一个神经元的工作过程可以分为三步:
  x₁───w₁───┐
  x₂───w₂───┤
  x₃───w₃───┼→ 加权求和 → Z = Wx + b → 激活函数 → output
           ┌┘
           b(偏置)
第一步:接收输入层的数据。 神经元接收来自上一层的所有输入信号 x₁、x₂、x₃......
第二步:加权求和。 每个输入乘以对应的权重 w,再加起来,最后加上偏置 b。公式是:
Z = Wx + b其中 Z 代表神经元的内部状态值,W 是权重向量,x 是输入向量,b 是偏置。加权求和的本质是:给不同的输入不同的重要性权重,综合起来得到一个总评分。
第三步:激活函数激活。 把 Z 送入激活函数,得到神经元的输出。激活函数的作用是引入非线性------如果没有激活函数,不管多少层神经网络,最终都等价于一层线性变换,和线性回归没什么区别。
四、PyTorch 搭建神经网络
PyTorch 提供了两种搭建神经网络的方式,各有适用场景。
方式一:nn.Sequential(快速搭建)
import torch.nn as nn

model = nn.Sequential(
    nn.Linear(784, 256),   # 输入层 → 隐藏层1
    nn.ReLU(),
    nn.Linear(256, 128),   # 隐藏层1 → 隐藏层2
    nn.ReLU(),
    nn.Linear(128, 10),    # 隐藏层2 → 输出层
    nn.Softmax(dim=1)
)
nn.Sequential 把层按顺序叠起来,数据从第一层流入,从最后一层流出。它的优点是写起来快、结构清晰,适合简单的前馈网络。缺点是不够灵活------如果你的前向传播有分支、有跳跃连接,Sequential 就搞不定了。
方式二:nn.Module(灵活搭建)
import torch
import torch.nn as nn

class MyNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(784, 256)
        self.fc2 = nn.Linear(256, 128)
        self.fc3 = nn.Linear(128, 10)
        self.relu = nn.ReLU()

    def forward(self, x):
        x = self.relu(self.fc1(x))
        x = self.relu(self.fc2(x))
        x = self.fc3(x)
        return x

model = MyNet()
继承 nn.Module 是 PyTorch 搭建模型的标准方式。你在 __init__ 中定义层,在 forward 方法中定义前向传播的逻辑。forward 方法极其灵活------你可以写分支、加循环、做条件判断,只要最后返回输出就行。
nn.Module 还自动提供了很多便利功能:model.parameters() 获取所有参数、model.state_dict() 获取参数字典、model.train() / model.eval() 切换模式等等。实际项目中,推荐统一使用 nn.Module 的方式,它更规范、更可扩展。
五、前向传播:数据如何流过网络
前向传播(Forward Propagation)是神经网络最基本的计算过程:数据从输入层进入神经网络,经过隐藏层的线性变换和非线性激活,最后到达输出层输出结果。
它的核心工作只有两件事:
-
线性计算 :每层的加权求和
Z = Wx + b -
激活输出 :通过激活函数引入非线性
a = f(Z)
以一个两层隐藏层的网络为例,前向传播的完整过程:
输入 x
  → Z₁ = W₁x + b₁    (第一层线性变换)
  → a₁ = ReLU(Z₁)     (第一层激活)
  → Z₂ = W₂a₁ + b₂    (第二层线性变换)
  → a₂ = ReLU(Z₂)     (第二层激活)
  → Z₃ = W₃a₂ + b₃    (输出层线性变换)
  → ŷ = Softmax(Z₃)   (输出层激活,得到概率)
每一层都是"线性变换 + 激活函数"的重复。这个模式看似简单,但堆叠多层之后,网络就能表达极其复杂的函数关系------理论上,只要隐藏层足够宽,一层隐藏层的神经网络就能逼近任意连续函数(万能近似定理)。
六、激活函数:神经网络的"灵魂"
激活函数的核心作用是增加非线性能力,让模型能够处理更复杂的数据。如果没有激活函数,多层网络的效果等于一层------因为多次线性变换的组合仍然是线性变换。激活函数让神经网络从"高级线性回归"变成了"万能函数拟合器"。
下面逐一介绍五大常用激活函数。
Sigmoid
f(x) = 1 / (1 + e^(-x))特点:
-
输出范围在 0 到 1 之间
-
当输入趋近于正无穷,输出趋近于 1
-
当输入趋近于负无穷,输出趋近于 0
场景 :二分类的输出层。因为输出在 0-1 之间,可以直接解释为概率。
不足 :梯度消失。当输入很大或很小时,sigmoid 曲线变得非常平缓,梯度几乎为 0。反向传播时,梯度乘上一个接近 0 的数,传到前面的层就几乎没了------前面的层根本学不到东西。这就是"梯度消失"问题,也是 sigmoid 在深层网络中不适合做隐藏层激活的原因。
Tanh(双曲正切)
f(x) = (e^x - e^(-x)) / (e^x + e^(-x))特点:
-
输出范围在 -1 到 1 之间
-
当输入趋近于正无穷,输出趋近于 1
-
当输入趋近于负无穷,输出趋近于 -1
场景 :输出结果位于 0 附近波动的场景,以及 RNN 系列模型。相比 sigmoid,tanh 的输出以 0 为中心,优化起来更容易。
不足 :梯度消失。和 sigmoid 一样,两端的梯度趋近于 0,深层网络中容易出现梯度消失。
ReLU(线性整流函数)
f(x) = max(0, x)特点:
-
取值范围为 [0, +∞)
-
当输入大于 0,输出等于输入,梯度为 1
-
当输入小于 0,输出恒为 0,梯度为 0
场景 :最常用的激活函数,不知道用啥,就用 ReLU。它的优点很突出:计算简单(就是个取最大值)、正区间没有梯度消失问题、收敛速度比 sigmoid/tanh 快很多。
不足 :神经元死亡现象。当输入一直小于 0 时,ReLU 的梯度始终为 0,这个神经元的权重永远不会更新------神经元"死了"。如果学习率太大,可能会有大量神经元死掉。
LeakyReLU
f(x) = max(αx, x) # 通常 α=0.01特点:
-
当输入大于 0,输出等于输入
-
当输入小于 0,函数值不为 0,而是接近 0(乘以一个小系数 α)
场景 :ReLU 出现神经元死亡时就用 LeakyReLU。它给负区间一个很小的斜率,保证了负区间也有梯度,神经元不会彻底死掉。虽然只是一个小小的改动,但在某些场景下效果提升明显。
Softmax
特点:
-
将原始的输出分数转为相应的概率
-
所有的概率相加为 1
场景 :多分类的输出层。比如 10 分类问题,输出 10 个 logits(原始分数),经过 Softmax 后变成 10 个概率值,加起来等于 1。这样你就知道模型"认为"每个类别的可能性有多大。
Softmax 和 sigmoid 的关系:二分类时,sigmoid 等价于两分类的 Softmax。两者都是把输出变成概率,只是适用的类别数不同。
激活函数对比表
| 激活函数 | 输出范围 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|---|
| Sigmoid | (0, 1) | 输出可解释为概率 | 梯度消失、不以0为中心 | 二分类输出层 |
| Tanh | (-1, 1) | 以0为中心,优化容易 | 梯度消失 | RNN、0附近波动 |
| ReLU | [0, +∞) | 计算快、无梯度消失(正区间) | 神经元死亡 | 隐藏层首选 |
| LeakyReLU | (-∞, +∞) | 解决神经元死亡 | 多了一个超参数 | ReLU死亡时替代 |
| Softmax | (0, 1)且和为1 | 输出概率分布 | 仅用于输出层 | 多分类输出层 |
七、参数初始化:好的开始是成功的一半
神经网络的参数(权重 w 和偏置 b)在训练开始前需要初始化------不能全是 0,也不能随便乱设。初始化得好不好,直接影响训练能不能收敛、收敛快不快。
基础方法
随机参数初始化:
-
正态分布 (
normal_()):手动设置均值和标准差,按正态分布随机生成。这是最常用的初始化方式。 -
均匀分布 (
uniform_()):在指定范围内均匀随机取值。
全 0 初始化 (zeros_()):所有权重都设为 0。这是错误的! 如果所有权重相同,每个神经元的输出都一样,反向传播时梯度也一样,所有神经元始终保持同步------相当于只有一个神经元在工作,网络的表达能力大打折扣。偏置 b 可以初始化为 0,但权重 w 绝对不能全 0。
全 1 和恒定值初始化 (ones_() / constant_()):和全 0 类似,所有权重相同会导致对称性问题,不推荐用于权重初始化。偏置有时可以初始化为小的常数。
高级方法
基础的随机初始化虽然能用,但对于深层网络效果不稳定------初始化得太大,激活函数输出进入饱和区,梯度消失;初始化得太小,信号逐层衰减,到后面层就没了。高级初始化方法就是为了解决这个问题。
Xavier 参数初始化:
-
使用场景:适用于有 tanh 和 sigmoid 等激活函数的场景
-
核心思想:让输入和输出的方差保持一致,信号在传播过程中不会放大也不会衰减
-
两种分布形式:
-
正态分布形式:
xavier_normal_() -
均匀分布形式:
xavier_uniform_()
-
Kaiming(He)参数初始化:
-
使用场景:适用于有 ReLU 系列激活函数的场景
-
核心思想:针对 ReLU 的负区间被置零的特性,调整初始化策略,保证方差稳定
-
两种分布形式:
-
正态分布形式:
kaiming_normal_() -
均匀分布形式:
kaiming_uniform_()
-
PyTorch 中各层的默认初始化其实已经考虑了这些策略,但在自定义初始化或调参时,了解这些方法能帮你做出更合理的选择。
使用场景总结
-
sigmoid、tanh 激活函数:因为梯度对输入的均值和方差敏感,用 Xavier 初始化更合适
-
ReLU、Leaky ReLU 激活函数:负区间被截断,用 Kaiming 初始化更合适
-
只能确定初始值的大致区间:用均匀分布初始化
-
最常用 :正态分布 + 小的方差是最常见的组合
八、损失函数:告诉模型错在哪里
核心作用
损失函数有三个核心作用:
-
让模型知道自己错在哪里:量化预测和真实值之间的差距
-
用来评估模型的表现:loss 越小,模型越好
-
指导模型进行优化:反向传播根据 loss 计算梯度,更新参数
没有损失函数,模型就不知道该往哪个方向优化。损失函数是训练的"指南针"。
分类损失函数:多分类交叉熵损失
分类问题最常用的损失函数是交叉熵损失 (Cross-Entropy Loss)。它的思想是:真实类别预测概率越高,损失越小;反之越大。
比如一个 3 分类问题,真实类别是第 2 类(one-hot 为 0, 1, 0):
-
如果模型预测概率为 0.1, 0.8, 0.1,预测正确且置信度高,loss 很小
-
如果模型预测概率为 0.5, 0.3, 0.2,预测错误,loss 很大
交叉熵和 Softmax 是好搭档------Softmax 把输出变成概率,交叉熵衡量概率分布和真实分布的差距。
PyTorch 中的 API 是 nn.CrossEntropyLoss()。注意:nn.CrossEntropyLoss() 内部已经包含了 Softmax,所以模型的最后一层不需要再加 Softmax,直接输出原始 logits 就行。这是初学者常踩的一个坑------加了 Softmax 再用 CrossEntropyLoss,相当于做了两次 Softmax,效果反而更差。
criterion = nn.CrossEntropyLoss()
loss = criterion(output, target)
# output 形状:[batch_size, num_classes],是原始logits,不是概率
# target 形状:[batch_size],是类别索引(如 [0, 2, 1, ...])
九、学习心得与建议
第一,神经网络的本质是"组合函数"。 每一层做一次线性变换加一次非线性激活,多层堆叠就是多个函数的复合。函数复合的威力在于------简单函数叠足够多层,就能逼近任意复杂的函数。理解了这一点,你就理解了为什么神经网络"什么都能学"。
第二,激活函数是神经网络的灵魂。 没有激活函数,再深的网络也只是线性回归。激活函数让非线性成为可能,让神经网络有了拟合复杂模式的能力。选什么激活函数、为什么选,这是设计网络结构时的第一个决策。
第三,参数初始化比你想的重要。 初学者可能觉得"反正训练会调参,初始值随便设设就行"。但对于深层网络,初始化不当会导致梯度消失或爆炸,模型根本训练不动。好的初始化让模型"赢在起跑线"------训练更稳定、收敛更快、效果更好。
第四,损失函数决定了优化方向。 选对损失函数和选对模型结构一样重要。分类用交叉熵、回归用 MSE,这是常识;但在样本不平衡时要不要换 focal loss、在多任务时怎么加权多个 loss,这些才是体现功力的地方。
写在最后
从单个神经元到多层网络,从激活函数到参数初始化,从损失函数到前向传播------今天我们搭建了一个完整的 ANN 知识框架。这些概念看起来多,但它们环环相扣:神经元是基本单元,激活函数引入非线性,参数初始化决定起点,损失函数提供优化方向,前向传播计算预测,反向传播更新参数。
这篇文章聚焦在前向传播和网络结构上,下篇文章我们会把反向传播也串进来,走通一个完整的 ANN 训练流程。到那时,你会发现------所谓深度学习,就是今天这些概念的放大和深化。
神经网络的大门已经打开,里面的世界很深,但入口很清晰:一个神经元、一层网络、一个激活函数。从简单开始,逐步深入,你也能掌握深度学习的奥秘。
如果这篇文章对你有帮助,欢迎点赞收藏。下一篇我们将用 PyTorch 完整训练一个全连接神经网络,敬请关注。