一、说明
LTX-2.5是2026年8月发布的220亿参数开放权重升级版,相比2.3版本在画质、性能、功能上有全面升级。
🎬 画质与生成能力升级
- 规格大幅提升 :从2.3的最高1024x1024分辨率、5秒时长,升级到支持4K分辨率、最长20秒视频,帧率从24fps提升至50fps 。
- 细节伪影改善:新增扩散视频解码器,替换传统VAE重建阶段,大幅减少人脸崩坏、纹理抖动、画面文字模糊等伪影问题,动态场景稳定性显著提升 。
- 原生多镜头一致性:一次生成即可产出多段衔接镜头,全程保持角色长相、场景环境、光线氛围、配音音色完全统一,省去大量后期拼接工作 。
- 动态算力分配:采用可变令牌率(VTR)和像素扩散技术,根据画面复杂度动态分配算力,简单场景少算、复杂场景多算,实现"影院级帧间平衡" 。
⚡ 速度与显存优化变化
- 生成速度翻倍 :官方双GB200环境下,10秒视频仅需6.8秒渲染完成,速度约为2.3的2倍;消费级RTX5090实测10秒片段约1.5分钟,仍远快于同类竞品 。
- 显存优化升级 :通过NVIDIA官方优化省40%显存,支持FP4量化,最低显存门槛从2.3的8GB提升至16GB,8GB显卡已无法正常运行 。
- 你的V100 16G适配提示:刚好踩中最低显存门槛,需使用FP4量化版本,关闭4K模式,最高可稳定运行768P分辨率任务,无法开启原生4K渲染。
🔧 架构与核心功能更新
- 文本编码器升级:从2.3的T5替换为定制版Gemma 4,对多主体、长提示词的语义理解能力大幅增强,提示词遵循度明显提升 。
- 音视频深度融合:基于22B参数双流扩散Transformer架构,音视频在同一模型内同步预测生成,对白、环境音、背景音乐与画面完全同步,无需后期二次配音 。
- 专业工作流支持:原生支持4K HDR与EXR RAW专业调色工作流,ComfyUI发布首日就完成原生集成,零配置即可直接使用,无需额外适配 。
- 世界模型特性增强:强化对物理世界规律的理解,大幅减少"穿墙"等生成幻觉,生成内容更符合真实世界逻辑,还可支持数字环境模拟、机器人导航辅助等延伸场景 。
二、取模板
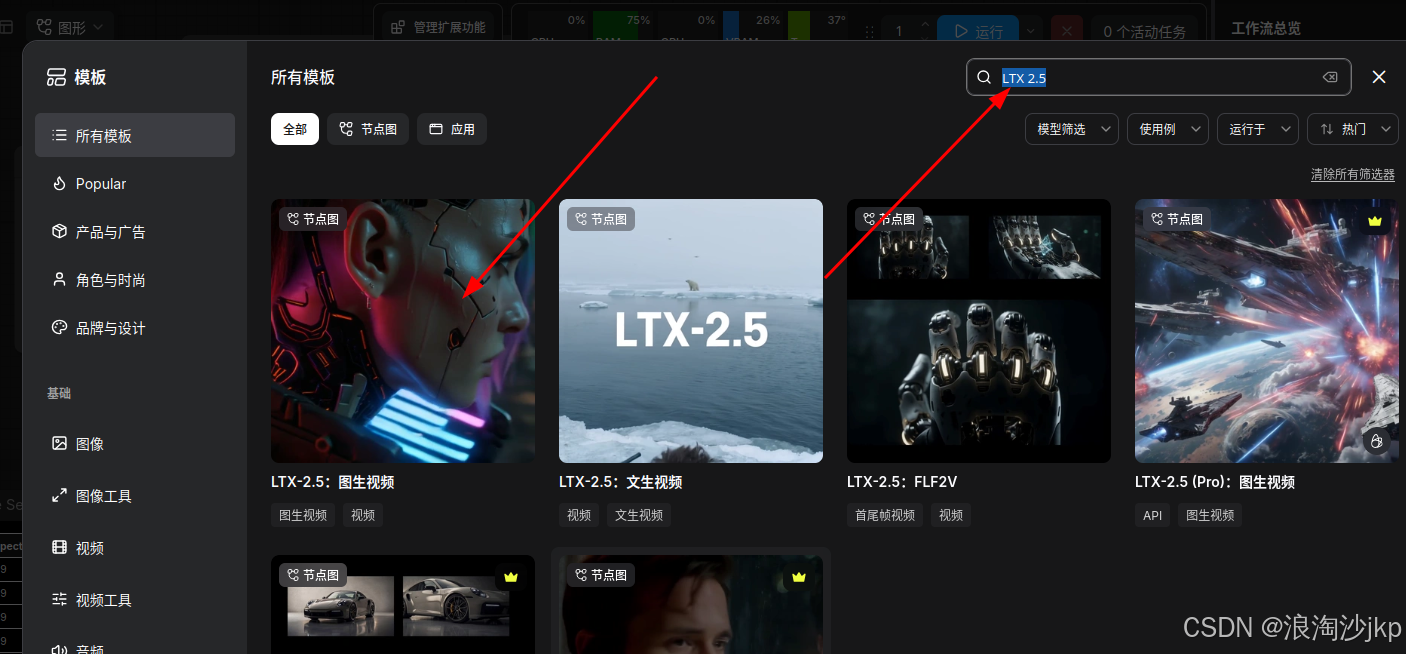
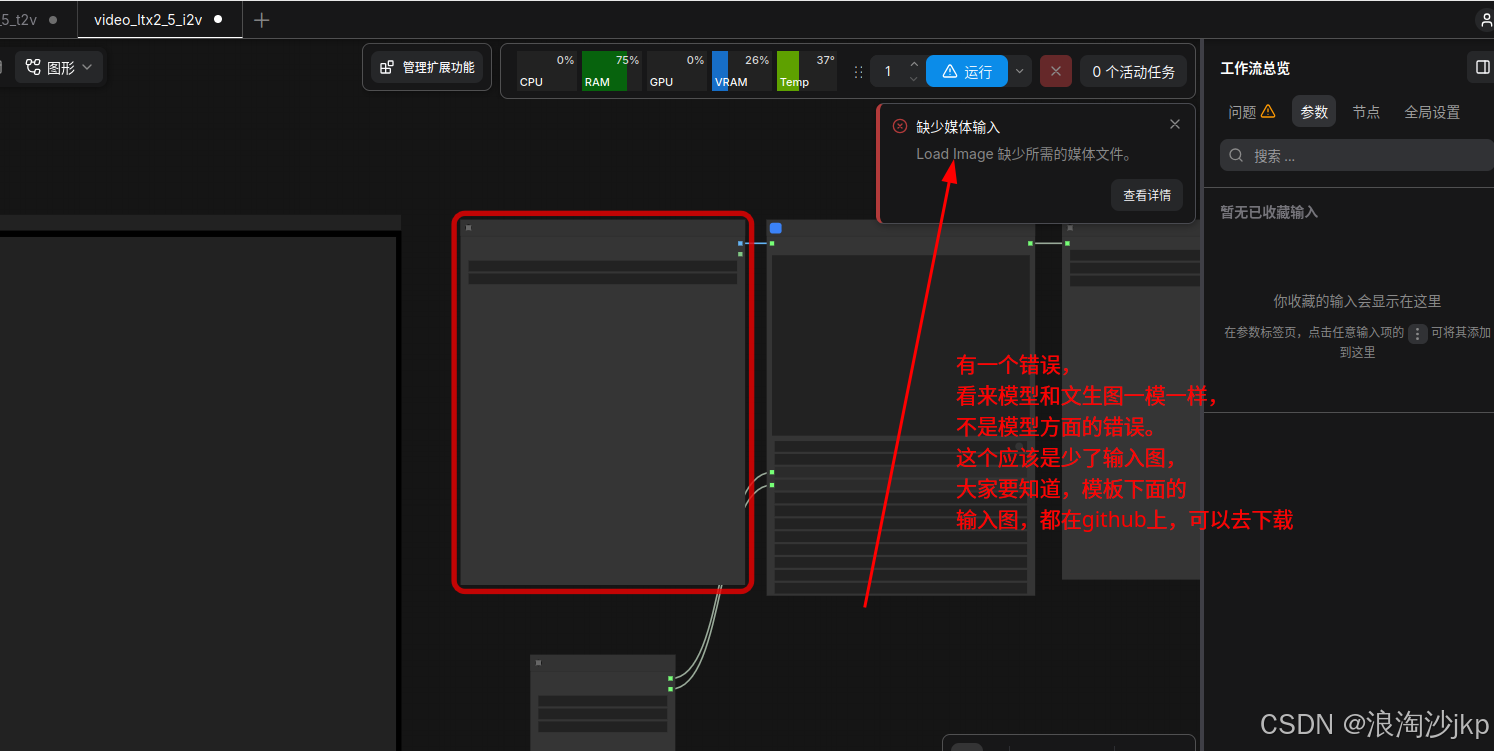
模板下面的输入图都在https://github.com/Comfy-Org/workflow_templates/
下载下来可以用作参考,也免于到处去找图,学习速度会快点
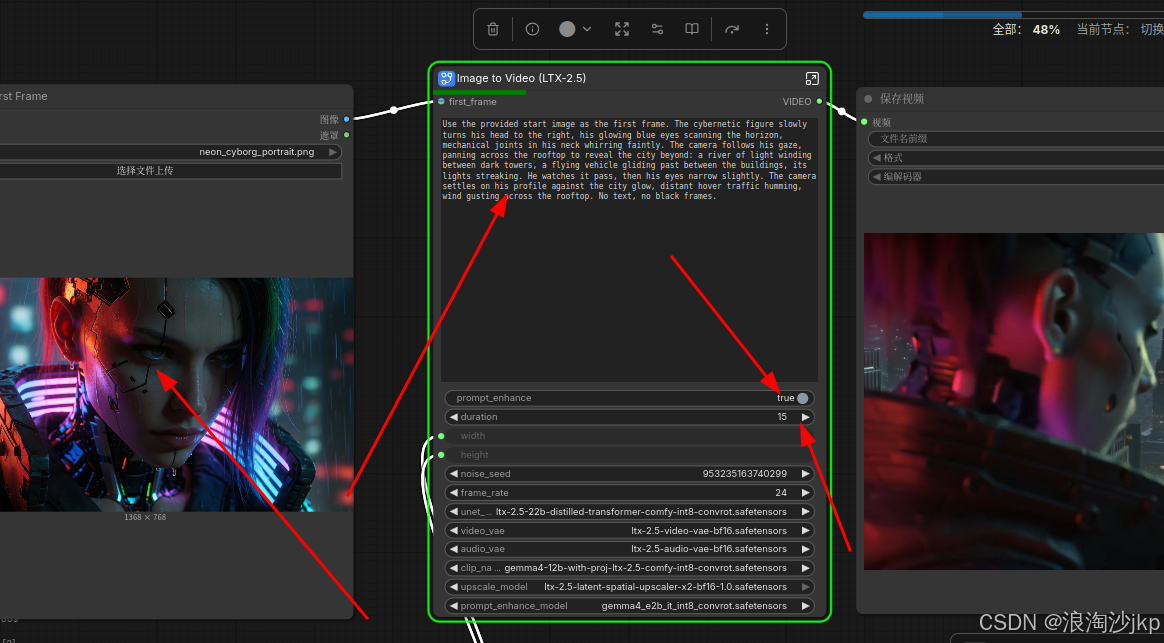
时间变为15秒,
三、运行
按上面设置运行,OOM了
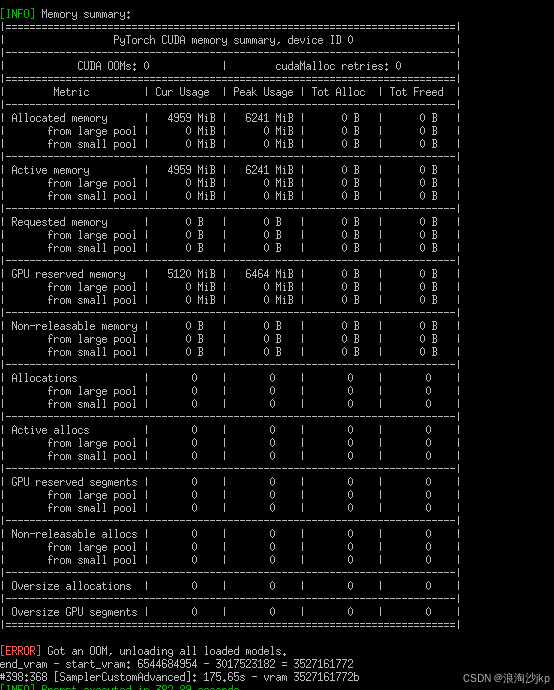
我们把像素调小点,这时候要么减少时间,要么降低显示像素,也许还可以优化,但是我还不知道
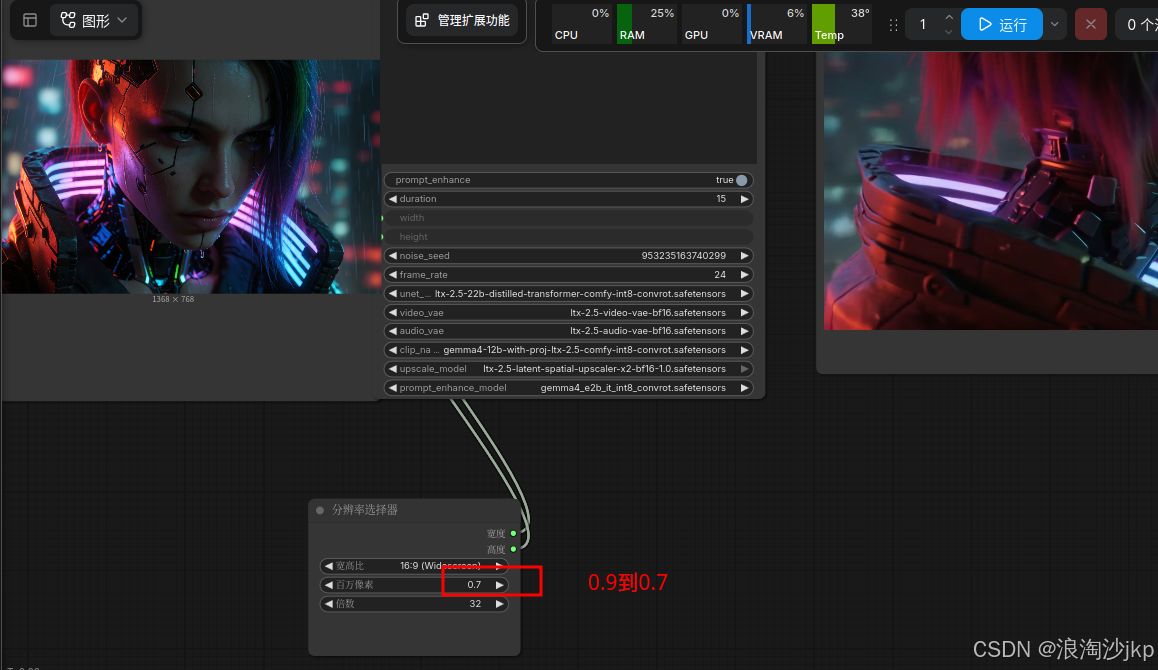
INFO Prompt executed in 00:13:33,能接受不?
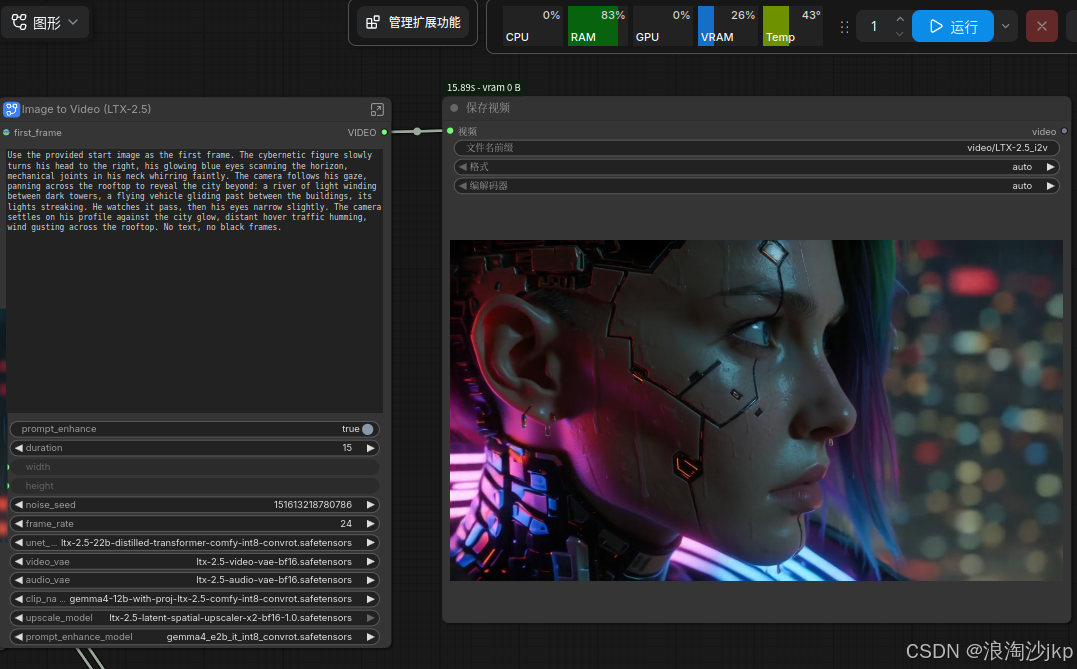
四、提示词
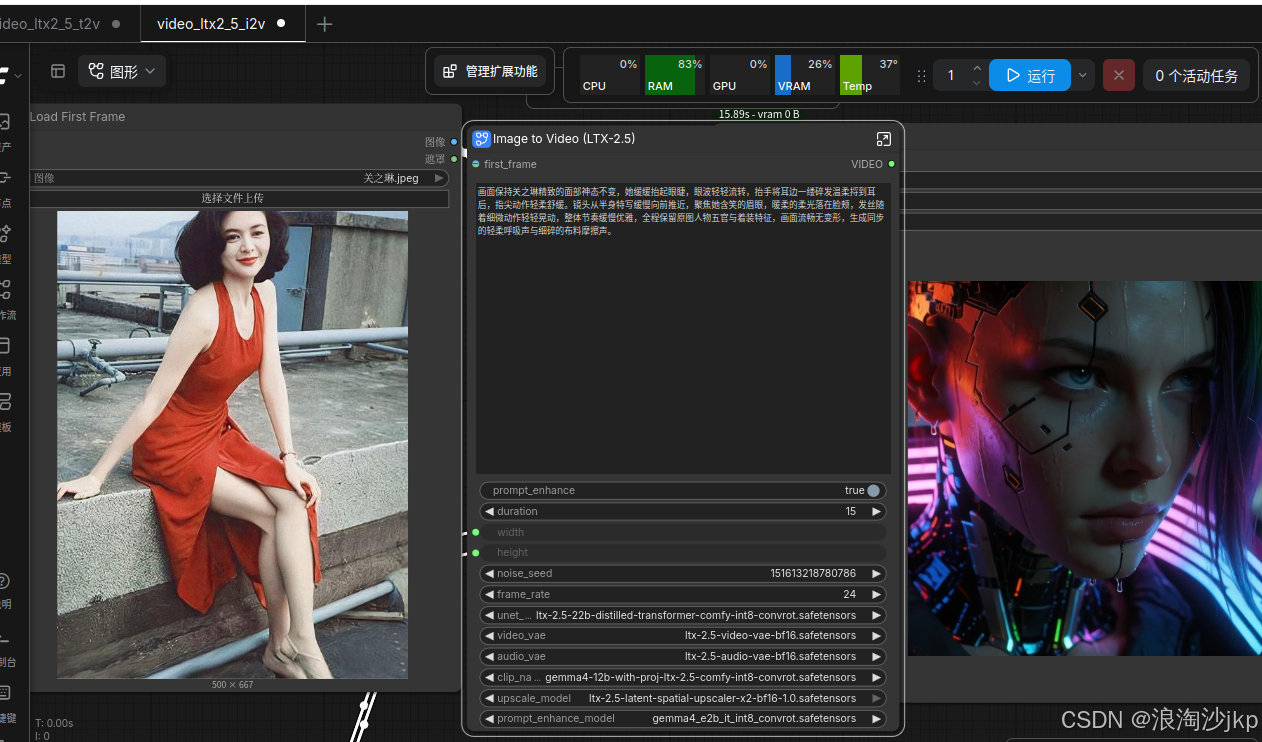
还是找AI吧,肯定比我写的好,input图,
提示词为:画面保持关之琳精致的面部神态不变,她缓缓抬起眼睫,眼波轻轻流转,抬手将耳边一缕碎发温柔捋到耳后,指尖动作轻柔舒缓。镜头从半身特写缓慢向前推近,聚焦她含笑的眉眼,暖柔的柔光落在脸颊,发丝随着细微动作轻轻晃动,整体节奏缓慢优雅,全程保留原图人物五官与着装特征,画面流畅无变形,生成同步的轻柔呼吸声与细碎的布料摩擦声。
这次用中文试试,听说是可以的
生成视频,变得这么丑了,还是我的关关吗?正准备条参数
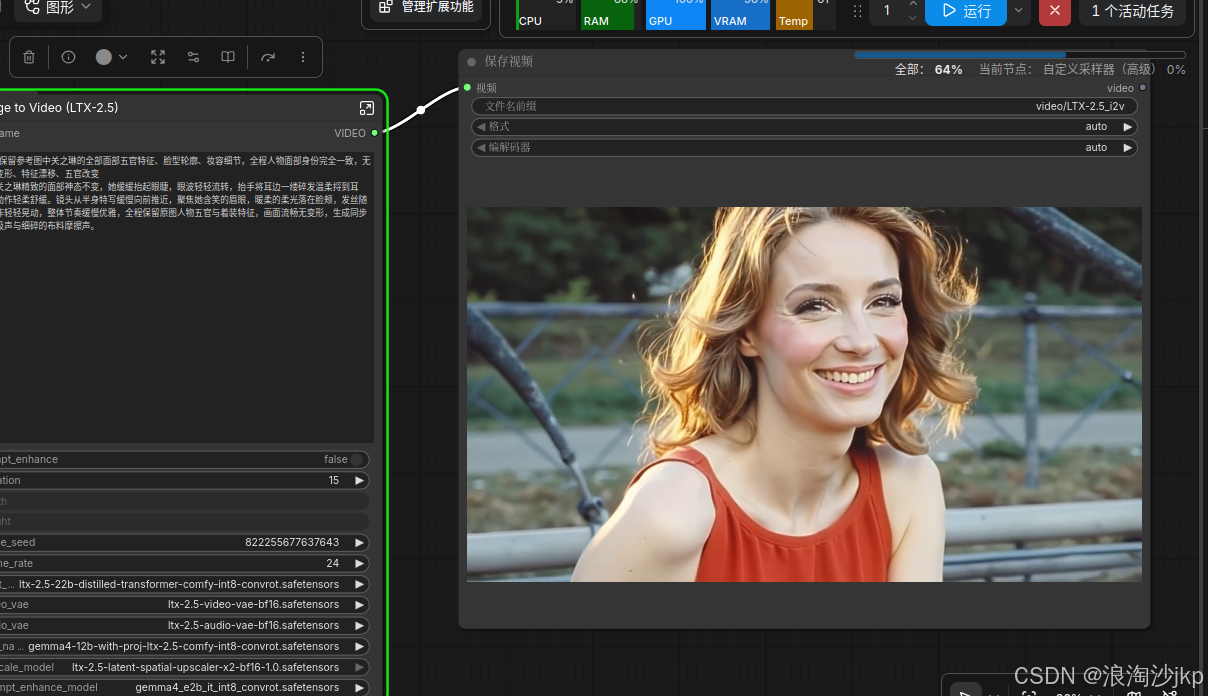
LTX-2.5_i2v_00003_
要想保持人脸不变,首先关闭prompt_enhance开关,固定noise_seed,我是固定的
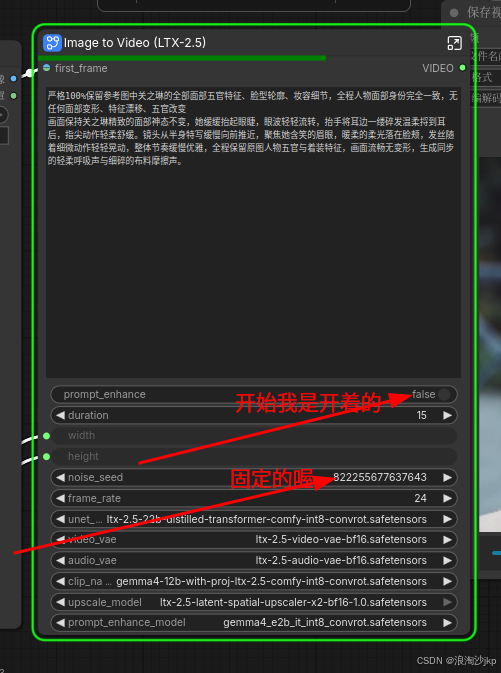
在提示词最开头加入的强约束语句
严格100%保留参考图中关之琳的全部面部五官特征、脸型轮廓、妆容细节,全程人物面部身份完全一致,无任何面部变形、特征漂移、五官改变
画面保持关之琳精致的面部神态不变,她缓缓抬起眼睫,眼波轻轻流转,抬手将耳边一缕碎发温柔捋到耳后,指尖动作轻柔舒缓。镜头从半身特写缓慢向前推近,聚焦她含笑的眉眼,暖柔的柔光落在脸颊,发丝随着细微动作轻轻晃动,整体节奏缓慢优雅,全程保留原图人物五官与着装特征,画面流畅无变形,生成同步的轻柔呼吸声与细碎的布料摩擦声。
把Stage1的去噪强度调整到0.25-0.35区间,进一步降低模型修改原图面部细节的自由度,从生成起点就锁死初始人脸特征。
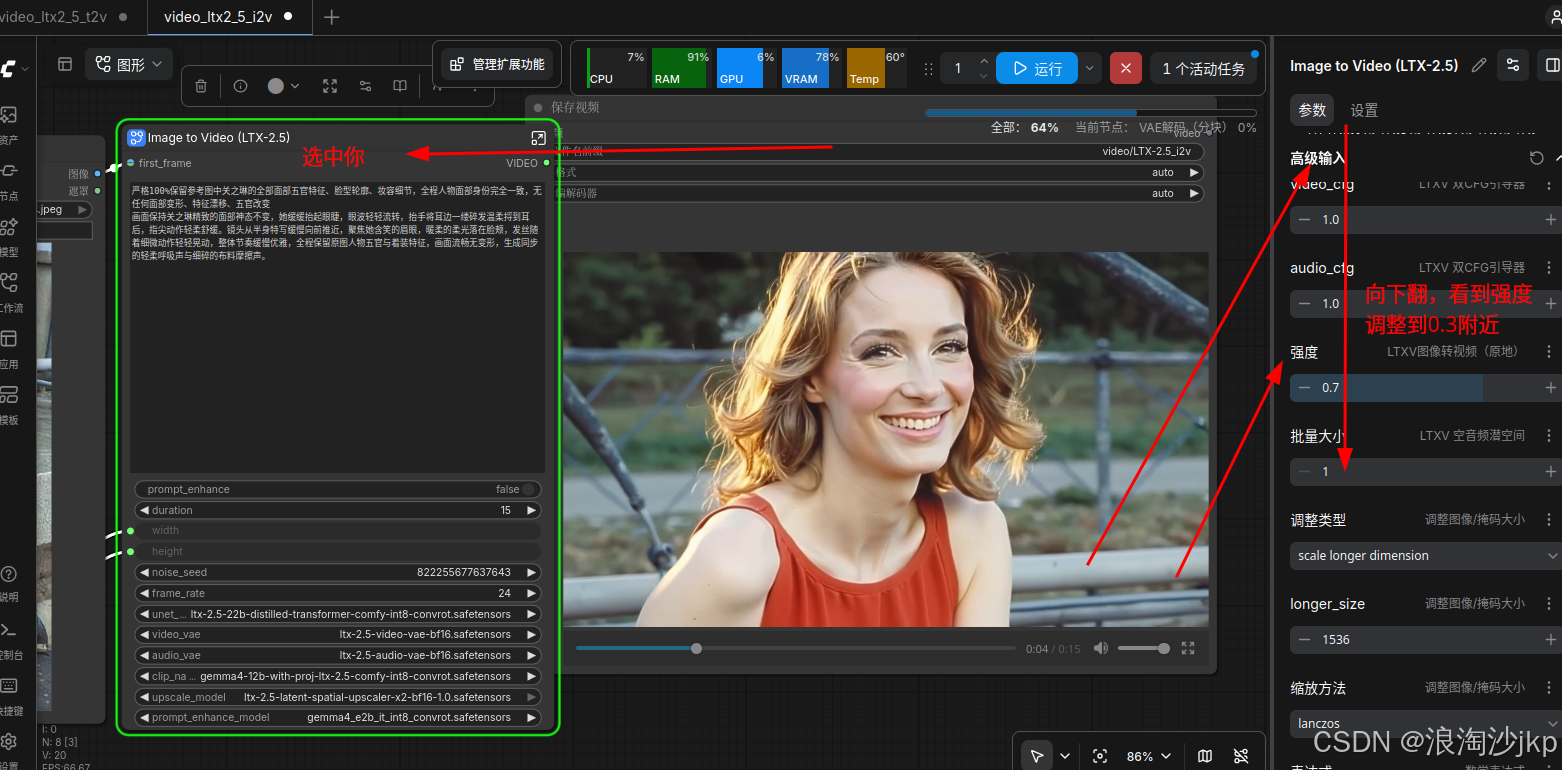
改了参数后
INFO Prompt executed in 00:13:45
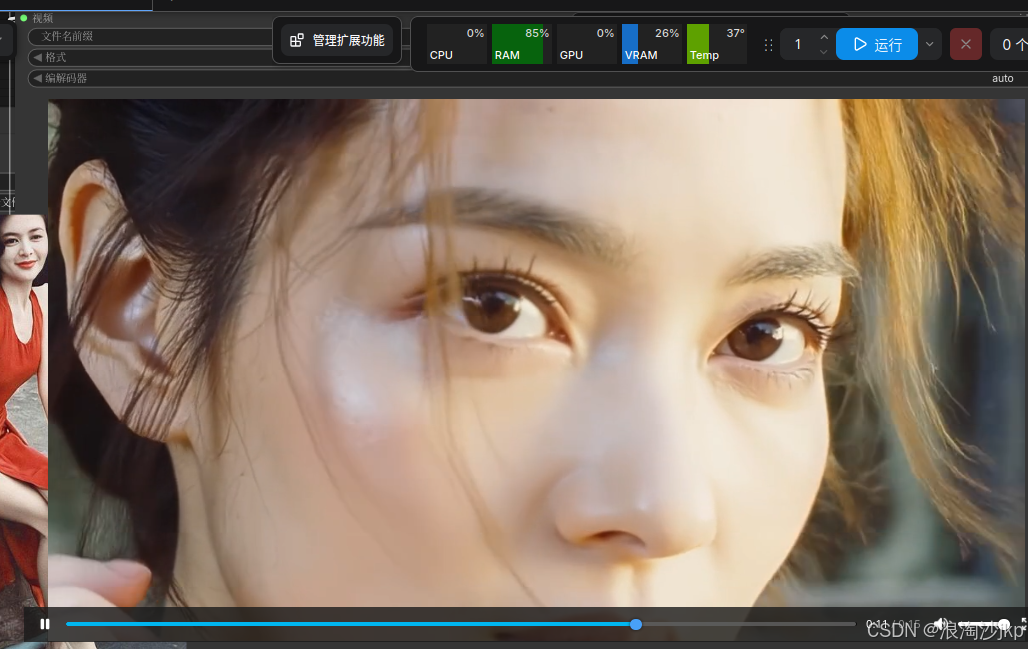
视频到时候发给大家看,我曾经的女神,搞成这样
LTX-2.5_i2v_00005_