智能体(AI Agent)研究进展与发展现状文献综述
------从经典智能体、强化学习智能体到大模型智能体与 Agentic AI
摘要
智能体(Agent)并不是伴随 ChatGPT 才出现的新概念,而是人工智能领域延续数十年的核心研究方向。早期智能体研究主要关注"感知---决策---行动"闭环、符号规划、BDI(Belief-Desire-Intention)认知架构以及多智能体协作;2010 年以后,深度强化学习使智能体能够通过与环境交互自主学习策略;2022 年以后,大语言模型(Large Language Model,LLM)提供了强大的语言理解、知识调用和推理能力,使智能体研究发生重要转折:LLM 开始从传统意义上的"信息生成模型"转变为可以进行目标理解、任务分解、规划、工具调用、环境交互、记忆和反思的"认知控制器"。
截至 2026 年,LLM Agent 已形成较清晰的技术体系,其核心研究内容包括推理与规划、工具使用、记忆、环境交互、自我反思、多智能体协作、强化学习、自进化、计算机操作以及科研智能体等。与此同时,AgentBench、WebArena、GAIA、SWE-bench、OSWorld、τ-bench 等动态评测环境逐渐替代传统静态问答测试,Agent 研究正在从"模型回答是否正确"转向"一个智能系统是否能够长期、稳定、可靠地完成真实任务"。2026 年的综述研究也已经将 LLM Agent 的基本组成概括为感知、认知/推理、规划、行动、工具和协作等模块。:chatgpt-content-reference{index="0"}
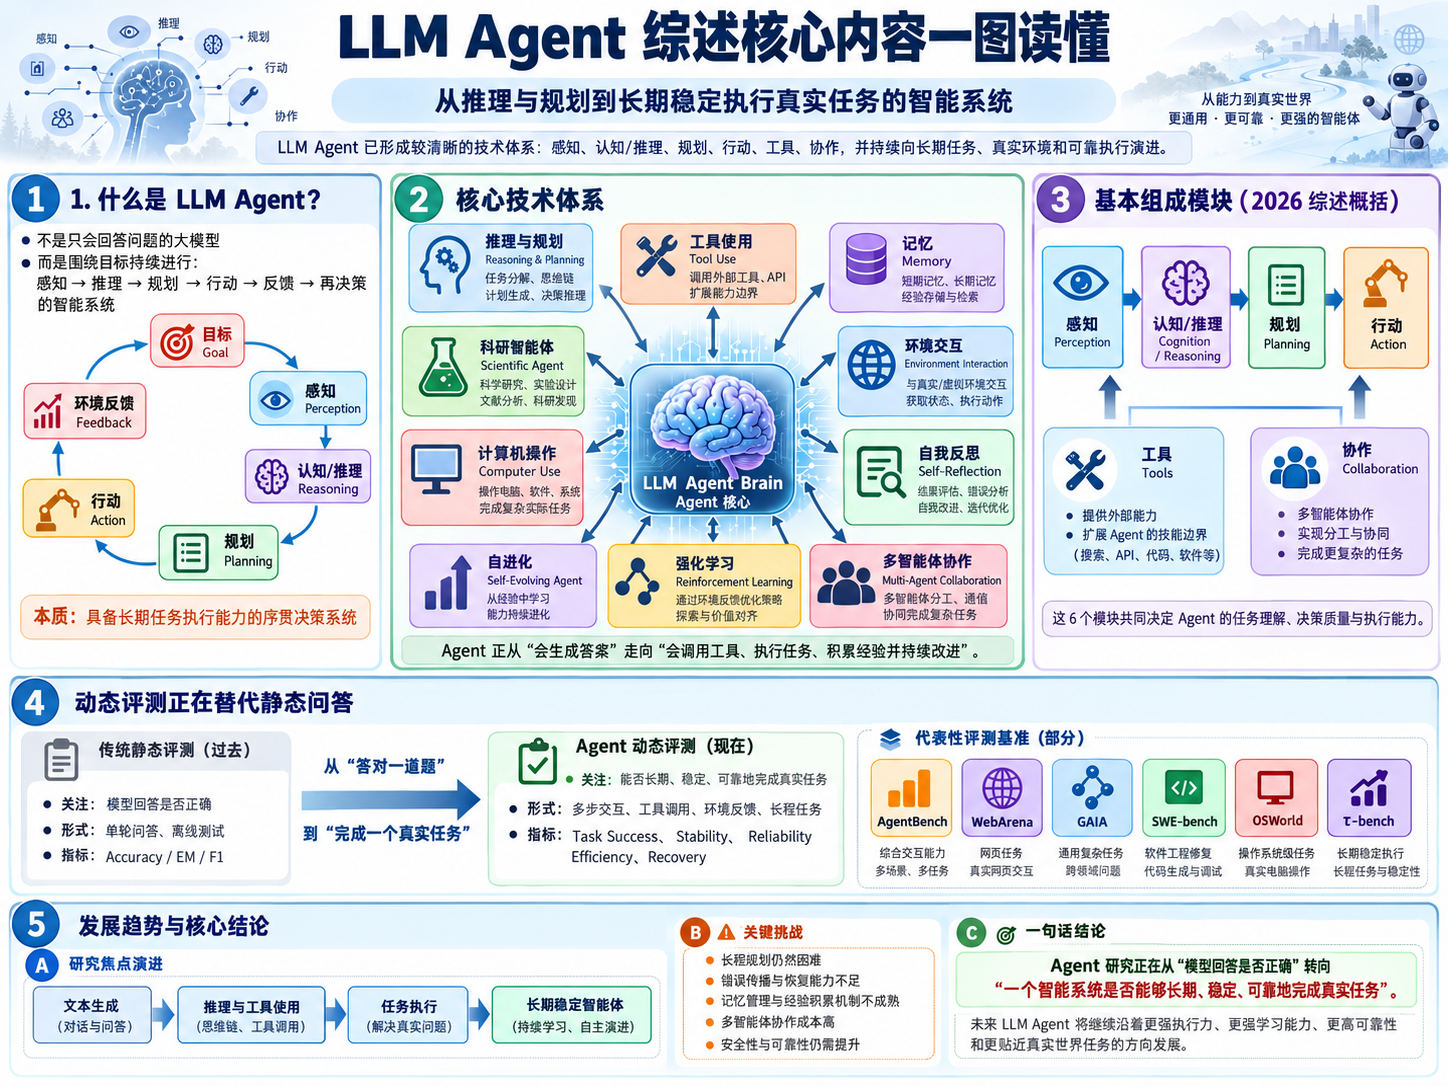
1. 什么是智能体
理解 Agent 最重要的一句话是:
Agent 不是"会回答问题的模型",而是"能够围绕目标持续感知环境、做决策、采取行动,并根据行动结果继续调整行为的系统"。
经典智能体研究中,Wooldridge 和 Jennings 在 1995 年就系统讨论了智能体的自主性、反应性、主动性和社会能力,这些思想直到今天依然是 Agent 研究的理论基础。:chatgpt-content-reference{index="1"}
一个最基本的智能体可以描述为:
Observation→Reasoning→Decision→Action→Environment→New Observation \boxed{ Observation \rightarrow Reasoning \rightarrow Decision \rightarrow Action \rightarrow Environment \rightarrow New\ Observation } Observation→Reasoning→Decision→Action→Environment→New Observation
也就是:
ot→at→ot+1 o_t \rightarrow a_t \rightarrow o_{t+1} ot→at→ot+1
如果加入目标、记忆和工具,可以进一步表示为
$$
a_t
\pi_\theta
(
g,o_t,m_t,\mathcal T
)
其中: | 符号 | 含义 | |------------------|-----------------| | ggg | 当前目标 Goal | | oto_tot | 时刻 ttt 感知到的环境信息 | | mtm_tmt | 当前记忆 | | T\\mathcal TT | 可使用的工具集合 | | πθ\\pi_\\thetaπθ | 智能体决策策略 | | ata_tat | 智能体选择的行动 | 执行行动后: ot+1=E(ot,at) o_{t+1}=E(o_t,a_t) ot+1=E(ot,at) 同时更新记忆: ##
m_{t+1}
U(m_t,o_t,a_t,o_{t+1})
所以 Agent 本质上是一种**序贯决策系统**。 这也是 Agent 和普通 ChatGPT、RAG 系统最大的区别。 | 系统 | 核心行为 | 是否真正形成闭环 | |----------------|---------------------|----------| | LLM | 输入 → 生成文本 | 否 | | RAG | 查询 → 检索 → 生成 | 通常否 | | 固定 Workflow | 按预设步骤执行 | 部分 | | Agent | 观察 → 判断 → 行动 → 再观察 | 是 | | Learning Agent | 行动 → 反馈 → 学习 → 改进策略 | 是 | 因此: LLM≠Agent \\boxed{\\text{LLM}\\neq\\text{Agent}} LLM=Agent 更准确地说: ##
\boxed{
Agent
LLM
Memory
Planning
Tools
Environment
Feedback
}
*** ** * ** *** ## 2. 智能体发展的第一阶段:经典智能体 经典 Agent 研究远早于大模型。 20 世纪 80---90 年代,人工智能研究者已经开始研究: * Intelligent Agent * Autonomous Agent * Rational Agent * Reactive Agent * Cognitive Agent * Multi-Agent System 1995 年 Rao 与 Georgeff 提出的 BDI Agent 是经典智能体研究最重要的理论体系之一。BDI 将智能体内部状态划分为: Belief+Desire+Intention \\boxed{ Belief + Desire + Intention } Belief+Desire+Intention 即: **Belief(信念)** 智能体认为当前世界是什么状态。 **Desire(愿望)** 智能体希望实现哪些目标。 **Intention(意图)** 智能体当前真正决定执行哪个目标。 Rao 和 Georgeff 将 BDI 从理论模型进一步连接到实际 Agent 系统实现,是认知智能体发展的代表性工作。:chatgpt-content-reference{index="2"} 这一阶段研究的核心不是语言模型,而是: 感知→状态表示→规划→决策→行为 感知 \\rightarrow 状态表示 \\rightarrow 规划 \\rightarrow 决策 \\rightarrow 行为 感知→状态表示→规划→决策→行为 这一思想实际上已经奠定了今天 LLM Agent 的基本骨架。 *** ** * ** *** ## 3. 第二阶段:强化学习智能体 大约从 2013---2021 年开始,Agent 研究出现第二次重要跃迁: Rule Agent→Learning Agent \\boxed{ Rule\\ Agent \\rightarrow Learning\\ Agent } Rule Agent→Learning Agent 过去需要人工写规则: State→Rule→Action State\\rightarrow Rule\\rightarrow Action State→Rule→Action 强化学习则学习策略: π(a∣s) \\pi(a\|s) π(a∣s) 目标是最大化长期累计回报: maxπE\[∑t=0Tγtrt\] \\max_\\pi E \\left\[ \\sum_{t=0}\^{T}\\gamma\^t r_t \\right\] πmaxE\[t=0∑Tγtrt\] 2015 年 DeepMind 的 DQN 将深度神经网络与强化学习结合,使 Agent 可以直接从 Atari 游戏图像中学习决策策略,是现代学习型 Agent 的重要里程碑。:chatgpt-content-reference{index="3"} 随后 AlphaGo 将: 策略网络+价值网络+蒙特卡洛树搜索+强化学习 策略网络 + 价值网络 + 蒙特卡洛树搜索 + 强化学习 策略网络+价值网络+蒙特卡洛树搜索+强化学习 结合,在围棋问题上实现重大突破。:chatgpt-content-reference{index="4"} 2019 年 AlphaStar 又进一步展示了复杂环境中的多智能体强化学习能力,通过不同策略智能体之间持续竞争和适应达到 StarCraft II Grandmaster 水平。:chatgpt-content-reference{index="5"} 但是这一时期的 Agent 存在明显限制: > **很会"行动",但不太会"理解"。** 例如 AlphaGo 可以下围棋,却无法理解: > "请分析这盘棋我失败的主要原因,然后查阅资料并给我制定训练计划。" 因此强化学习 Agent 很强,但通常局限于特定环境和固定状态空间。 *** ** * ** *** ## 4. 第三阶段:大语言模型成为 Agent 的"大脑" 真正改变 Agent 研究格局的是 Transformer 和大语言模型。 尤其是 2022 年以后。 LLM 突然提供了 Agent 以前缺少的一系列能力: 语言理解+世界知识+推理+任务分解+代码生成 \\boxed{ 语言理解 + 世界知识 + 推理 + 任务分解 + 代码生成 } 语言理解+世界知识+推理+任务分解+代码生成 这使研究者开始思考: > 能否让 LLM 不只是"回答问题",而是直接作为 Agent 的决策中枢? 答案逐渐变成了"可以"。 *** ** * ** *** ## 5. 2022:从"会生成"到"会推理" 一个关键转折是 Chain-of-Thought。 Wei 等人的经典工作表明,让大型语言模型生成中间推理步骤可以显著改善复杂推理能力。:chatgpt-content-reference{index="6"} 传统模式: Question→Answer Question \\rightarrow Answer Question→Answer CoT: Question→Reasoning1→Reasoning2→...→Answer Question \\rightarrow Reasoning_1 \\rightarrow Reasoning_2 \\rightarrow ... \\rightarrow Answer Question→Reasoning1→Reasoning2→...→Answer 于是 LLM 开始表现出类似"内部思考"的能力。 同一时期,Huang 等人进一步研究了: **Language Models as Zero-Shot Planners** 即: High Level Goal→Action Plan High\\ Level\\ Goal \\rightarrow Action\\ Plan High Level Goal→Action Plan 证明预训练语言模型中蕴含的世界知识可以用于任务规划。:chatgpt-content-reference{index="7"} 这两个方向实际上为 LLM Agent 奠定了两个核心组件: Reasoning+Planning \\boxed{ Reasoning + Planning } Reasoning+Planning *** ** * ** *** ## 6. 2022---2023:工具使用成为关键能力 单独依靠 LLM 有一个根本问题: LLM 本身只能输出 Token。 它不能真正: * 查询数据库; * 浏览网页; * 执行 Python; * 调用专业模型; * 操作软件; * 读取传感器; * 控制设备。 于是产生了: LLM+Tool \\boxed{LLM + Tool} LLM+Tool MRKL Systems 是这一思想的重要早期工作之一,它提出用 LLM 连接外部知识模块和离散推理模块,形成模块化神经符号系统。:chatgpt-content-reference{index="8"} Toolformer 更进一步,让模型学习: * 是否调用工具; * 调哪个工具; * 什么时候调用; * 输入什么参数; * 如何使用工具结果。 :chatgpt-content-reference{index="9"} 这其实完成了一次重要转变: LLM:语言生成器→工具调度器 \\boxed{ LLM: 语言生成器 \\rightarrow 工具调度器 } LLM:语言生成器→工具调度器 *** ** * ** *** ## 7. ReAct:现代 LLM Agent 最关键的范式之一 如果初学 Agent,我认为必须真正看懂 ReAct。 Yao 等人在 ICLR 2023 提出了: **ReAct: Synergizing Reasoning and Acting in Language Models** 其核心思想极其简单: Thought→Action→Observation→Thought→Action \\boxed{ Thought \\rightarrow Action \\rightarrow Observation \\rightarrow Thought \\rightarrow Action } Thought→Action→Observation→Thought→Action 例如: 用户问: > 四川盆地页岩气主要分布在哪里? Agent: Thought:我需要查询可靠资料 Thought: 我需要查询可靠资料 Thought:我需要查询可靠资料 ↓ Action:Search(...) Action: Search(...) Action:Search(...) ↓ Observation:返回搜索结果 Observation: 返回搜索结果 Observation:返回搜索结果 ↓ Thought:信息不够,需要进一步查地质资料 Thought: 信息不够,需要进一步查地质资料 Thought:信息不够,需要进一步查地质资料 ↓ Action:Search(...) Action: Search(...) Action:Search(...) ↓ 最终回答。 ReAct 的意义在于首次非常清楚地把: Reasoning+Acting \\boxed{ Reasoning + Acting } Reasoning+Acting 连接起来。 研究结果显示,在知识问答和交互决策环境中,将推理和行动交替进行可以改善任务完成效果,并降低单纯 CoT 中出现的幻觉和错误传播问题。:chatgpt-content-reference{index="10"} 今天很多 Agent 框架,本质上仍然是 ReAct 的工程化扩展。 *** ** * ** *** ## 8. Agent 为什么需要"记忆" 单纯 ReAct 很快会遇到问题: > Agent 做了几十步以后,前面发生的事情怎么办? 于是产生了 Memory Agent。 通常可以将 Agent Memory 分成: ##
Memory
Working\ Memory
Episodic\ Memory
Semantic\ Memory
Procedural\ Memory
其中: | 记忆 | 类似人的什么能力 | |-------------------|--------------| | Working Memory | 当前上下文 | | Episodic Memory | "我以前遇到过什么" | | Semantic Memory | "我知道什么知识" | | Procedural Memory | "我会怎样完成某种任务" | Generative Agents 是这一方向很有代表性的论文。 作者让 25 个 LLM Agent 生活在一个虚拟小镇里,每个 Agent 会: Observation→Memory→Reflection→Planning Observation \\rightarrow Memory \\rightarrow Reflection \\rightarrow Planning Observation→Memory→Reflection→Planning 从而产生较长期的行为和社会互动。:chatgpt-content-reference{index="11"} 这篇论文真正重要的并不是"小镇模拟",而是提出了: Memory+Reflection+Planning \\boxed{ Memory + Reflection + Planning } Memory+Reflection+Planning 这种认知架构。 *** ** * ** *** ## 9. Reflexion:Agent 开始"从失败中学习" 传统 Agent 做错以后: 失败→重新执行 失败\\rightarrow重新执行 失败→重新执行 Reflexion 提出的思路是: 失败→分析为什么失败→形成语言经验→保存→下一次执行时调用 失败 \\rightarrow 分析为什么失败 \\rightarrow 形成语言经验 \\rightarrow 保存 \\rightarrow 下一次执行时调用 失败→分析为什么失败→形成语言经验→保存→下一次执行时调用 而不一定更新神经网络参数。 Reflexion 将这种机制称为: **Verbal Reinforcement Learning** 即通过语言反馈和反思改善后续行为。:chatgpt-content-reference{index="12"} 可以写为: ##
e_t
Reflect(
trajectory_t,
feedback_t
)
然后: M←M∪et M \\leftarrow M\\cup e_t M←M∪et 下一次决策: ##
a_t
\pi(o_t,M)
这奠定了后来大量: * self-reflection; * self-correction; * experience learning; * agent memory; 研究。 *** ** * ** *** ## 10. Tree of Thoughts:从一条推理链变成搜索空间 CoT 是: A→B→C A\\rightarrow B\\rightarrow C A→B→C 但是复杂问题可能应该同时考虑多个方案: A→{B1B2B3 A \\rightarrow \\begin{cases} B_1\\\\ B_2\\\\ B_3 \\end{cases} A→⎩ ⎨ ⎧B1B2B3 然后评价哪个方向更好。 Tree of Thoughts 因此把推理过程转化为树搜索: Generate→Evaluate→Search \\boxed{ Generate \\rightarrow Evaluate \\rightarrow Search } Generate→Evaluate→Search 允许模型探索、回溯并比较多个 reasoning path。:chatgpt-content-reference{index="13"} 这使 Agent Planning 与传统 AI Search 再次发生连接。 *** ** * ** *** ## 11. Voyager:Agent 开始积累"技能" Voyager 是 Embodied Agent 中很经典的一项工作。 它在 Minecraft 中让 Agent: 探索→学习技能→形成代码→保存Skill→组合旧技能解决新问题 探索 \\rightarrow 学习技能 \\rightarrow 形成代码 \\rightarrow 保存Skill \\rightarrow 组合旧技能解决新问题 探索→学习技能→形成代码→保存Skill→组合旧技能解决新问题 它包含三个关键机制: Automatic Curriculum Automatic\\ Curriculum Automatic Curriculum Skill Library Skill\\ Library Skill Library Iterative Prompting Iterative\\ Prompting Iterative Prompting 并展示了基于代码技能库进行长期能力积累的可能性。:chatgpt-content-reference{index="14"} 于是 Agent 从: > 每次重新想办法 开始走向: > 把成功经验固化成可复用能力。 这也是当前 Agent 自进化研究的重要来源之一。 *** ** * ** *** ## 12. 从单智能体走向多智能体 很快研究者发现: 一个 Agent 同时负责: * 规划; * 搜索; * 编程; * 检查; * 写作; 未必是最佳方案。 于是产生: Multi−AgentSystem \\boxed{ Multi-Agent System } Multi−AgentSystem 基本思想类似组织分工: Manager→Researcher→Engineer→Reviewer Manager \\rightarrow Researcher \\rightarrow Engineer \\rightarrow Reviewer Manager→Researcher→Engineer→Reviewer CAMEL 是 LLM 多智能体研究的早期代表之一,通过角色扮演研究多个语言 Agent 之间的自主合作。:chatgpt-content-reference{index="15"} MetaGPT 则进一步把软件企业中的 SOP 引入多智能体系统,例如: 产品经理→架构师→程序员→测试人员 产品经理 \\rightarrow 架构师 \\rightarrow 程序员 \\rightarrow 测试人员 产品经理→架构师→程序员→测试人员 并强调标准化中间产物和角色分工。:chatgpt-content-reference{index="16"} ChatDev 则把多 Agent 自然语言通信应用于软件设计、编码和测试。:chatgpt-content-reference{index="17"} AutoGen 则提供了更加通用的多智能体会话和协作基础设施,支持 LLM、工具以及人类组成不同 Agent。:chatgpt-content-reference{index="18"} Magentic-One 又进一步采用 Orchestrator: Orchestrator→BrowserAgent Orchestrator \\rightarrow BrowserAgent Orchestrator→BrowserAgent →FileAgent \\rightarrow FileAgent →FileAgent →CoderAgent \\rightarrow CoderAgent →CoderAgent 由总控智能体负责计划、监督和重新规划。:chatgpt-content-reference{index="19"} 因此多 Agent 已逐渐从: Agent1↔Agent2 Agent_1 \\leftrightarrow Agent_2 Agent1↔Agent2 发展成: Hierarchical Agent Organization \\boxed{ Hierarchical\\ Agent\\ Organization } Hierarchical Agent Organization *** ** * ** *** ## 13. 但"多智能体"并不等于科学创新 这是现在研究 Agent 最容易踩的坑。 例如: Planner+DataAgent+ModelAgent+ReportAgent Planner + DataAgent + ModelAgent + ReportAgent Planner+DataAgent+ModelAgent+ReportAgent 然后四个 Agent 互相聊天。 从工程角度完全合理。 但从学术研究角度: > **"把任务拆成几个角色"本身已经很难构成高水平创新。** 同样,下列工作现在通常也不够作为论文的核心创新: LLM+RAG LLM+RAG LLM+RAG LLM+KnowledgeGraph LLM+KnowledgeGraph LLM+KnowledgeGraph LLM+Tools LLM+Tools LLM+Tools LLM+Memory LLM+Memory LLM+Memory LLM+MultiAgent LLM+MultiAgent LLM+MultiAgent 如果只是模块拼接,本质属于: System Integration \\boxed{System\\ Integration} System Integration 而不是新的 Agent 学习或推理机制。 *** ** * ** *** ## 14. Agent 评测发生了什么变化 早期 LLM 评价: Question→Answer→Accuracy Question \\rightarrow Answer \\rightarrow Accuracy Question→Answer→Accuracy Agent 评价则必须研究整个 trajectory: s0→a1→s1→a2→...→sT s_0 \\rightarrow a_1 \\rightarrow s_1 \\rightarrow a_2 \\rightarrow ... \\rightarrow s_T s0→a1→s1→a2→...→sT 因此真正需要评价的是: Task Success+Efficiency+Reliability+Planning+Tool Use+Recovery \\boxed{ Task\\ Success + Efficiency + Reliability + Planning + Tool\\ Use + Recovery } Task Success+Efficiency+Reliability+Planning+Tool Use+Recovery AgentBench 建立了包含多个交互环境的综合 Agent benchmark,并指出长程推理、决策与指令遵循仍然是重要瓶颈。:chatgpt-content-reference{index="20"} WebArena 将 Agent 放入真实风格的网站环境中执行购物、论坛、代码协作等长程任务;其早期实验中 GPT-4 Agent 的端到端成功率仍远低于人类,显示真实交互远比静态 QA 困难。:chatgpt-content-reference{index="21"} GAIA 则测试: Reasoning+Web+Multimodal+Tool Reasoning + Web + Multimodal + Tool Reasoning+Web+Multimodal+Tool 所组成的一般 AI assistant 能力。:chatgpt-content-reference{index="22"} SWE-bench 将问题推进到真实软件工程: GitHub Issue+Repository→Agent→Code Patch GitHub\\ Issue + Repository \\rightarrow Agent \\rightarrow Code\\ Patch GitHub Issue+Repository→Agent→Code Patch 测试智能体是否真正可以修改大型代码库。:chatgpt-content-reference{index="23"} VisualWebArena 开始加入网页视觉信息。:chatgpt-content-reference{index="24"} OSWorld 更进一步,让多模态 Agent 操作: * Ubuntu; * Windows; * macOS; * 不同真实软件。 :chatgpt-content-reference{index="25"} τ-bench 又开始研究: Agent+User+Tools+Policy Agent + User + Tools + Policy Agent+User+Tools+Policy 重点测试 Agent 是否能够在与用户动态交互时仍然正确遵守业务规则。研究发现,即使当时较强的 function-calling agents,在重复运行时仍有明显的不稳定性。:chatgpt-content-reference{index="26"} 这说明 Agent 研究的核心问题正在从: > **一次能不能做对?** 变成: > **连续做 100 次能不能稳定做对?** *** ** * ** *** ## 15. Agent 的研究主线已经形成 综合目前文献,可以把现代 Agent 看成下面八个能力层。 | 能力 | 核心问题 | 代表研究 | |----------------|------------------|---------------------------------| | Reasoning | 怎么思考 | CoT、ToT | | Planning | 怎么分解长期任务 | Zero-shot Planner、ReAct | | Tool Use | 怎么使用外部能力 | MRKL、Toolformer | | Memory | 怎么记住过去 | Generative Agents | | Reflection | 怎么从错误中学习 | Reflexion | | Skill Learning | 怎么积累可复用能力 | Voyager | | Collaboration | 多 Agent 如何合作 | CAMEL、MetaGPT、AutoGen | | Learning | Agent 如何通过交互持续进化 | Agentic RL、Self-Evolving Agents | 这八个问题比"用什么框架开发 Agent"重要得多。 *** ** * ** *** ## 16. 2024---2026:计算机使用智能体快速发展 目前 Agent 的一个明显趋势是: 过去: LLM→API LLM \\rightarrow API LLM→API 现在: Multimodal Agent→Screen→Mouse→Keyboard Multimodal\\ Agent \\rightarrow Screen \\rightarrow Mouse \\rightarrow Keyboard Multimodal Agent→Screen→Mouse→Keyboard 即 Agent 像人一样直接操作计算机。 因此问题从: > "调用哪个 API?" 变成: > "看懂当前界面之后下一步点哪里?" 对应研究问题包括: Visual Grounding Visual\\ Grounding Visual Grounding GUI Understanding GUI\\ Understanding GUI Understanding Long−Horizon Planning Long-Horizon\\ Planning Long−Horizon Planning Cross−App Operation Cross-App\\ Operation Cross−App Operation Error Recovery Error\\ Recovery Error Recovery OSWorld 和 VisualWebArena 正是这一研究趋势的重要 benchmark。:chatgpt-content-reference{index="27"} *** ** * ** *** ## 17. 科研智能体成为非常重要的应用方向 Agent 在科学研究上的价值非常突出,因为科研天然就是一个 Agent workflow: 提出问题→查文献→提出假设→设计实验→运行实验→分析结果→修改假设 提出问题 \\rightarrow 查文献 \\rightarrow 提出假设 \\rightarrow 设计实验 \\rightarrow 运行实验 \\rightarrow 分析结果 \\rightarrow 修改假设 提出问题→查文献→提出假设→设计实验→运行实验→分析结果→修改假设 这与 Agent 的结构高度一致。 *** ** * ** *** ### ChemCrow ChemCrow 将 GPT-4 与 18 个化学专业工具结合,使 Agent 可以处理有机合成、药物发现和材料问题,并展示了工具增强 Agent 在真实化学任务上的价值。:chatgpt-content-reference{index="28"} *** ** * ** *** ### Coscientist Nature 2023 的 Coscientist 更进一步。 系统可以: 搜索资料→实验规划→调用实验设备→执行实验→分析结果 搜索资料 \\rightarrow 实验规划 \\rightarrow 调用实验设备 \\rightarrow 执行实验 \\rightarrow 分析结果 搜索资料→实验规划→调用实验设备→执行实验→分析结果 甚至通过 API 控制自动化实验设备。:chatgpt-content-reference{index="29"} 因此出现: Agent+Scientific Instruments \\boxed{ Agent + Scientific\\ Instruments } Agent+Scientific Instruments *** ** * ** *** ### AI Scientist 2024 年 The AI Scientist 尝试覆盖完整机器学习科研过程: Idea→Code→Experiment→Figure→Paper→Review Idea \\rightarrow Code \\rightarrow Experiment \\rightarrow Figure \\rightarrow Paper \\rightarrow Review Idea→Code→Experiment→Figure→Paper→Review 这是"科研智能体"发展的代表性尝试。:chatgpt-content-reference{index="30"} 但后续研究也不断提醒: > 自动完成科研流程,并不等同于真正拥有科学发现能力。 科学品味、实验设计、因果判断、长期上下文保持和失败诊断依然是难题。 *** ** * ** *** ## 18. 2025---2026:Deep Research Agent 传统 RAG: Question→Retrieve→Answer Question \\rightarrow Retrieve \\rightarrow Answer Question→Retrieve→Answer Deep Research Agent 则更加接近: Question→Task Decomposition Question \\rightarrow Task\\ Decomposition Question→Task Decomposition →Search→Read→Evaluate→Search Again \\rightarrow Search \\rightarrow Read \\rightarrow Evaluate \\rightarrow Search\\ Again →Search→Read→Evaluate→Search Again →Cross Validation→Synthesis→Report \\rightarrow Cross\\ Validation \\rightarrow Synthesis \\rightarrow Report →Cross Validation→Synthesis→Report 2025 年针对 Deep Research Agent 的综述将其核心技术概括为动态推理、长程规划、多跳检索、迭代工具使用和结构化报告生成,并开始讨论 MCP 等工具生态。:chatgpt-content-reference{index="31"} 所以: RAG→Agentic Retrieval→Deep Research \\boxed{ RAG \\rightarrow Agentic\\ Retrieval \\rightarrow Deep\\ Research } RAG→Agentic Retrieval→Deep Research 是一个非常明显的发展趋势。 *** ** * ** *** ## 19. Agentic Reinforcement Learning 正在重新变得重要 早期很多 LLM Agent 的决策来自 Prompt: Prompt→Action Prompt \\rightarrow Action Prompt→Action 问题是: 这些 Agent 往往没有真正"学会"。 于是研究重新走向: LLM+Reinforcement Learning LLM + Reinforcement\\ Learning LLM+Reinforcement Learning 只是这次 RL 学习的不再只是: Token Generation Token\\ Generation Token Generation 而是: Long−Horizon Agent Policy \\boxed{ Long-Horizon\\ Agent\\ Policy } Long−Horizon Agent Policy 例如: ##
s_t
(
environment,
memory,
tool\ state,
history
)
$$
Agent 学习:
πθ(at∣st) \pi_\theta(a_t|s_t) πθ(at∣st)
2025 年关于 Agentic RL 的综述已经明确区分传统 LLM-RL 和面向长期环境交互的 Agentic RL,并将 planning、tool use、memory、reasoning、self-improvement 和 perception 统一到序贯决策框架下。相关研究正在把 Agent 再次拉回 POMDP、强化学习和策略优化的理论体系。
这可能是未来几年 Agent 学术研究最重要的方向之一。
20. Self-Evolving Agent:Agent 从"执行任务"走向"改造自己"
2025 年以后另一个快速增长的方向是:
Self−EvolvingAgent \boxed{ Self-Evolving Agent } Self−EvolvingAgent
研究问题开始从:
Agent 如何完成任务?
变为:
Agent 完成任务以后,怎样让自己永久变得更强?
Self-Evolving Agent 的综述通常把"进化对象"分成:
Model Model Model
Memory Memory Memory
Tool Tool Tool
Prompt/Policy Prompt/Policy Prompt/Policy
Architecture Architecture Architecture
例如:
Agent 第一次:
Task→失败 Task \rightarrow 失败 Task→失败
↓
分析失败:
Experience Experience Experience
↓
生成新的工具或技能:
Toolnew Tool_{new} Toolnew
↓
修改自己的策略:
πt+1 \pi_{t+1} πt+1
↓
下一次:
Task→成功 Task \rightarrow 成功 Task→成功
2025 年关于 Self-Evolving Agents 的系统综述已经把这一方向概括为:
What to evolve What\ to\ evolve What to evolve
When to evolve When\ to\ evolve When to evolve
How to evolve How\ to\ evolve How to evolve
并将模型、记忆、工具以及 Agent architecture 的适应都纳入统一框架。:chatgpt-content-reference{index="32"}
21. 当前真正没有解决的问题
阅读大量 Agent 文献以后,可以发现现在并不是"Agent 已经完成",恰恰相反,核心理论问题才刚刚开始。
21.1 长程规划
任务:
a1→a2→...→a100 a_1 \rightarrow a_2 \rightarrow ... \rightarrow a_{100} a1→a2→...→a100
只要每一步正确率是 ppp,粗略看长期正确率就会快速下降:
Psuccess≈pT P_{success} \approx p^T Psuccess≈pT
例如:
0.98100≈0.133 0.98^{100}\approx0.133 0.98100≈0.133
所以:
单步 98% 正确并不意味着长程 Agent 可靠。
22. 错误传播
Agent 一个早期错误可能产生:
Error1→Wrong Observation→Wrong Planning→Wrong Tool→Error2 Error_1 \rightarrow Wrong\ Observation \rightarrow Wrong\ Planning \rightarrow Wrong\ Tool \rightarrow Error_2 Error1→Wrong Observation→Wrong Planning→Wrong Tool→Error2
最后形成:
Error Cascade \boxed{Error\ Cascade} Error Cascade
这也是为什么"会反思"还远远不够。
真正困难的是:
Error Detection+Localization+Recovery Error\ Detection + Localization + Recovery Error Detection+Localization+Recovery
23. Memory 还远未解决
现在大量 Agent memory 本质上仍是:
Vector Database+Similarity Search Vector\ Database + Similarity\ Search Vector Database+Similarity Search
但真正的智能记忆应该解决:
What to remember? What\ to\ remember? What to remember?
What to forget? What\ to\ forget? What to forget?
When to recall? When\ to\ recall? When to recall?
How to consolidate? How\ to\ consolidate? How to consolidate?
How to distinguish experience from fact? How\ to\ distinguish\ experience\ from\ fact? How to distinguish experience from fact?
因此 Agent Memory 仍然具有很大的研究空间。
24. 多智能体存在"越多越聪明"的误区
多 Agent 并不天然优于单 Agent。
随着 Agent 数量增加:
Communication Cost↑ Communication\ Cost\uparrow Communication Cost↑
Coordination Error↑ Coordination\ Error\uparrow Coordination Error↑
Hallucination Propagation↑ Hallucination\ Propagation\uparrow Hallucination Propagation↑
甚至可能:
Performance↓ Performance\downarrow Performance↓
所以真正的研究问题不是:
应该设计几个 Agent?
而是:
什么时候应该协作? \boxed{ 什么时候应该协作? } 什么时候应该协作?
谁应该和谁通信? \boxed{ 谁应该和谁通信? } 谁应该和谁通信?
信息应该传多少? \boxed{ 信息应该传多少? } 信息应该传多少?
什么时候单Agent更好? \boxed{ 什么时候单 Agent 更好? } 什么时候单Agent更好?
这比简单角色扮演更有研究价值。
25. Agent 的可靠性仍然是最大问题之一
真实应用最重要的不一定是平均准确率:
Accuracy=90% Accuracy=90\% Accuracy=90%
而是:
P(failure in critical situation) P( failure\ in\ critical\ situation ) P(failure in critical situation)
特别是:
- 医疗;
- 石油工程;
- 化工;
- 电力;
- 自动驾驶;
- 工业安全;
这些领域不能接受:
Agent 平均表现很好,但偶尔完全乱来。
τ-bench 等工作的意义就在于开始研究重复执行的一致性而不是单次成功。:chatgpt-content-reference{index="33"}
26. Agent Security 成为新问题
普通 LLM 的攻击主要影响输出文本。
Agent 被攻击以后可能:
LLM→Tool→Real Action LLM \rightarrow Tool \rightarrow Real\ Action LLM→Tool→Real Action
因此风险急剧增加。
特别重要的问题包括:
Prompt Injection Prompt\ Injection Prompt Injection
Indirect Prompt Injection Indirect\ Prompt\ Injection Indirect Prompt Injection
Tool Misuse Tool\ Misuse Tool Misuse
Privilege Escalation Privilege\ Escalation Privilege Escalation
Data Exfiltration Data\ Exfiltration Data Exfiltration
Malicious Memory Malicious\ Memory Malicious Memory
因此未来 Agent 必须有:
Planner+Executor+Verifier+Policy Guard Planner + Executor + Verifier + Policy\ Guard Planner+Executor+Verifier+Policy Guard
而不能简单让同一个 LLM:
自己规划、自己执行、自己检查自己。
2026 年的 Agentic AI 综述已经把 prompt injection、action hallucination 和无限循环等列为重要开放问题。:chatgpt-content-reference{index="34"}
27. 当前 Agent 的完整技术体系
如果把目前几十条研究路线压缩成一张图,可以得到:
text
                     ┌──────────────┐
                     │     Goal     │
                     └──────┬───────┘
                            ↓
                  ┌─────────────────┐
                  │   Perception    │
                  └────────┬────────┘
                           ↓
             ┌──────────────────────────┐
             │         Agent Brain      │
             │                          │
             │ Reasoning                │
             │ Planning                 │
             │ Decision                 │
             └────────────┬─────────────┘
                          │
        ┌─────────────────┼─────────────────┐
        ↓                 ↓                 ↓
     Memory             Tools          Other Agents
        │                 │                 │
        └─────────────────┼─────────────────┘
                          ↓
                     Action
                          ↓
                    Environment
                          ↓
                      Feedback
                          ↓
               Reflection / Learning
                          ↓
                 Memory / Policy Update
这张图基本可以作为理解现代 Agent 的"总地图"。
28. Agent 研究的发展脉络
| 时期 | 主要范式 | 解决的问题 |
|---|---|---|
| 1980s--2000s | Symbolic / BDI Agent | Agent 应该如何表示目标和行为 |
| 2000s--2015 | Multi-Agent / Planning | 多智能体协作与规划 |
| 2015--2021 | Deep RL Agent | 如何从环境反馈学习 |
| 2022 | LLM Planning / CoT | LLM 如何推理和规划 |
| 2023 | ReAct / Tool / Memory | 如何形成真正行动闭环 |
| 2023--2024 | Multi-Agent | 如何进行角色协作 |
| 2024--2025 | Web / Code / Computer Agent | 如何解决真实复杂任务 |
| 2024--2026 | Scientific Agent | 如何自主进行科研活动 |
| 2025--2026 | Agentic RL | 如何学习长期 Agent policy |
| 2025--2026 | Self-Evolving Agent | 如何从经验持续进化 |
因此当前 Agent 研究的核心转变可以概括成:
Generation→Reasoning→Action→Learning \boxed{ Generation \rightarrow Reasoning \rightarrow Action \rightarrow Learning } Generation→Reasoning→Action→Learning
29. 初学者最应该阅读的核心文献
不建议一开始读 200 篇。
先把下面这条文献链读透。
| 顺序 | 论文 | 解决的问题 |
|---|---|---|
| 1 | Wooldridge & Jennings, 1995 | Agent 到底是什么 |
| 2 | Rao & Georgeff, 1995 | BDI 认知架构 |
| 3 | Mnih et al., 2015 | Deep RL Agent |
| 4 | Wei et al., 2022, CoT | LLM 推理 |
| 5 | Huang et al., 2022 | LLM Planning |
| 6 | MRKL, 2022 | LLM + 外部模块 |
| 7 | ReAct, 2023 | Reasoning + Acting |
| 8 | Toolformer, 2023 | Tool Learning |
| 9 | Reflexion, 2023 | Reflection |
| 10 | Tree of Thoughts, 2023 | Search-based Reasoning |
| 11 | Generative Agents, 2023 | Memory + Reflection |
| 12 | Voyager, 2023 | Skill Learning |
| 13 | CAMEL, 2023 | Multi-Agent |
| 14 | MetaGPT, 2024 | SOP-based Multi-Agent |
| 15 | AutoGen, 2024 | 通用多 Agent 编排 |
| 16 | AgentBench | Agent 综合评价 |
| 17 | WebArena | Web Agent |
| 18 | SWE-bench | Coding Agent |
| 19 | OSWorld | Computer Agent |
| 20 | τ-bench | 真实业务可靠性 |
| 21 | ChemCrow / Coscientist | Scientific Agent |
| 22 | The AI Scientist | Autonomous Research |
| 23 | Self-Evolving Agents Survey | Agent 自进化 |
| 24 | Agentic RL Survey | Agent 学习 |
读完以后,再看 2023 年 Wang 等人的综述以及 2026 年 Chowa 等人的系统综述,就基本能够建立完整知识体系。前者提出了较早的 LLM autonomous agent 统一框架,后者对 2023---2025 年高水平 Agent 文献进行了较系统的整理。:chatgpt-content-reference{index="35"}
30. 初学者学习路线
我建议按照下面的顺序,而不是先学习某个 Agent 框架。
| 阶段 | 学什么 | 最终应该理解什么 |
|---|---|---|
| 第1阶段 | MDP、POMDP、Agent、BDI | Agent 的理论定义 |
| 第2阶段 | RL、DQN、Policy | Agent 怎么学决策 |
| 第3阶段 | Transformer、LLM、CoT | LLM 为什么能推理 |
| 第4阶段 | ReAct | Agent 基本闭环 |
| 第5阶段 | Tool Use | Agent 怎么调用外部能力 |
| 第6阶段 | Memory/Reflection | Agent 怎样积累经验 |
| 第7阶段 | Multi-Agent | Agent 如何协作 |
| 第8阶段 | WebArena/OSWorld/SWE-bench | Agent 如何评价 |
| 第9阶段 | Agentic RL | Agent 怎么真正学习 |
| 第10阶段 | Self-Evolving Agent | Agent 怎么持续进化 |
最后再学习:
LangChain、LangGraph、AutoGen、CrewAI 等工程框架。
这样你学到的是:
Agent Science \boxed{Agent\ Science} Agent Science
而不是:
Agent API \boxed{Agent\ API} Agent API
31. 如果要做硕士/博士论文,研究什么更值得
截至 2026 年,单纯研究:
"RAG + Agent"
已经比较拥挤。
单纯:
"知识图谱 + Agent"
通常也不够。
单纯:
"多个 Agent 分工协作"
也越来越难形成理论创新。
更值得做的是下面这些基础问题:
Long−Horizon Planning Long-Horizon\ Planning Long−Horizon Planning
Agent Memory Agent\ Memory Agent Memory
Error Recovery Error\ Recovery Error Recovery
Tool Learning Tool\ Learning Tool Learning
Agentic Reinforcement Learning Agentic\ Reinforcement\ Learning Agentic Reinforcement Learning
Self−Evolving Agent Self-Evolving\ Agent Self−Evolving Agent
Uncertainty−Aware Agent Uncertainty-Aware\ Agent Uncertainty−Aware Agent
Causal Agent Causal\ Agent Causal Agent
Dynamic Multi−Agent Collaboration Dynamic\ Multi-Agent\ Collaboration Dynamic Multi−Agent Collaboration
Scientific Agent Scientific\ Agent Scientific Agent
特别值得注意的是:
Domain Agent≠LLM+Domain Knowledge \boxed{ Domain\ Agent \neq LLM+Domain\ Knowledge } Domain Agent=LLM+Domain Knowledge
真正有研究价值的专业智能体应该进一步研究:
Domain State+Domain Tools+Domain Constraints+Domain Reasoning+Domain Feedback Domain\ State + Domain\ Tools + Domain\ Constraints + Domain\ Reasoning + Domain\ Feedback Domain State+Domain Tools+Domain Constraints+Domain Reasoning+Domain Feedback
例如一个真正的钻井工程智能体,不是:
GPT + 钻井知识库。
而应该是:
钻井实时数据→工况识别→异常判断→调用水力学/井控模型 钻井实时数据 \rightarrow 工况识别 \rightarrow 异常判断 \rightarrow 调用水力学/井控模型 钻井实时数据→工况识别→异常判断→调用水力学/井控模型
→比较候选原因→形成证据链→给出处置方案→观察后续数据 \rightarrow 比较候选原因 \rightarrow 形成证据链 \rightarrow 给出处置方案 \rightarrow 观察后续数据 →比较候选原因→形成证据链→给出处置方案→观察后续数据
这才真正符合 Agent 的定义。
32. 一个非常重要的研究判断
过去人工智能研究重点是:
学习一个更好的模型 \boxed{ 学习一个更好的模型 } 学习一个更好的模型
例如:
CNN、Transformer、GNN。
而 Agent 研究正在改变问题:
如何构造一个能够长期完成任务的智能系统? \boxed{ 如何构造一个能够长期完成任务的智能系统? } 如何构造一个能够长期完成任务的智能系统?
因此研究对象正在由:
Model Model Model
转向:
Model+Memory+Tools+Environment+Learning \boxed{ Model + Memory + Tools + Environment + Learning } Model+Memory+Tools+Environment+Learning
也就是说:
Agent 不是一种新的神经网络,而是一种新的人工智能系统组织范式。
这是理解 Agent 领域最重要的一点。
33. 当前发展现状的最终判断
截至 2026 年,可以把 Agent 的发展状态概括为三个层次。
第一层已经较成熟:Agent Engineering
包括:
LLM+RAG LLM+RAG LLM+RAG
LLM+Tools LLM+Tools LLM+Tools
ReAct ReAct ReAct
Workflow Workflow Workflow
Role−based Multi−Agent Role-based\ Multi-Agent Role−based Multi−Agent
已经有大量工程框架和应用。
第二层正在快速发展:Agent Intelligence
重点研究:
Planning Planning Planning
Memory Memory Memory
Reflection Reflection Reflection
Computer Use Computer\ Use Computer Use
Multi−Agent Coordination Multi-Agent\ Coordination Multi−Agent Coordination
Long−Horizon Reasoning Long-Horizon\ Reasoning Long−Horizon Reasoning
这一层仍存在大量学术问题。
第三层刚刚开始:Learning & Evolving Agent
真正值得长期研究的是:
Experience→Learning→Policy Improvement Experience \rightarrow Learning \rightarrow Policy\ Improvement Experience→Learning→Policy Improvement
进一步:
Agentt→Experience→Agentt+1 Agent_t \rightarrow Experience \rightarrow Agent_{t+1} Agentt→Experience→Agentt+1
即:
Static Agent→Learning Agent→Self−Evolving Agent \boxed{ Static\ Agent \rightarrow Learning\ Agent \rightarrow Self-Evolving\ Agent } Static Agent→Learning Agent→Self−Evolving Agent
这也是 2025---2026 年综述文献中非常明显的发展趋势。:chatgpt-content-reference{index="36"}
34. 一句话掌握整个 Agent 领域
如果只记住一张演化图,我建议记:
规则智能体→学习智能体→LLM智能体→工具智能体→记忆智能体→多智能体→通用任务智能体→科研智能体→自学习智能体→自进化智能体 \boxed{ 规则智能体 \rightarrow 学习智能体 \rightarrow LLM智能体 \rightarrow 工具智能体 \rightarrow 记忆智能体 \rightarrow 多智能体 \rightarrow 通用任务智能体 \rightarrow 科研智能体 \rightarrow 自学习智能体 \rightarrow 自进化智能体 } 规则智能体→学习智能体→LLM智能体→工具智能体→记忆智能体→多智能体→通用任务智能体→科研智能体→自学习智能体→自进化智能体
真正的终点并不是:
"让 GPT 调几个工具。"
而是:
让智能体在环境中感知---推理---规划---行动---验证---学习---进化 \boxed{ 让智能体在环境中 感知---推理---规划---行动---验证---学习---进化 } 让智能体在环境中感知---推理---规划---行动---验证---学习---进化
这才是现代 Agentic AI 研究真正正在解决的问题。
如果从"准备做科研"的角度继续推进,下一步最有价值的不是再泛读文献,而是把上面这张地图进一步拆成 "哪些方向已经做烂了、哪些属于模块组合、哪些还有 SCI 顶刊级理论创新空间" 。我可以直接基于这次调研继续给你整理成一张 Agent 研究空白地图 + 20 个可做的科研问题 + 适合计算机硕士的 3 篇递进式 SCI 论文路线。