我在本地留了不少仓库的镜像(都停在 main 上),也有正在开发的 working copy,未提交的改动一并算在内。
经常遇到的问题是这个 API 还有哪些服务在用。grep -rn 在一个仓库里够用;铺到几十个仓库,每次搜索都要把所有文件重新读一遍,就快不起来了。
云端方案也不合适。公司代码不能上传,grep.app 和 Sourcegraph 直接排除;GitHub code search 只索引默认分支,我未推送的改动、以及托管在别处的仓库,它都看不到。
后来我把这件事做成了一个工具:dowse ,基于微软今年开源的 tgrep,跨仓库的本地代码搜索,桌面应用加 CLI,MIT 协议,Windows / macOS / Linux 都能跑。
为什么是 tgrep:trigram 索引
ripgrep 和 git grep 这类工具没有索引,每次搜索都从零开始:把每个文件打开、读出来、跑正则。tgrep 走的是另一条路,trigram 索引。
建索引时,它记录每个三字符序列出现在哪些文件里。搜索时把查询拆成若干个 trigram,取出各自的倒排表求交集,得到一份「可能命中」的文件列表,然后只对这些文件跑真正的正则引擎做校验。
这个思路不新。Sourcegraph 背后的 Zoekt 是同一套,Google 早年的 Code Search 也是。
tgrep 是微软今年开源的那一个,同时也是 GitHub Copilot CLI 里 grep 搜索的引擎。在 tgrep 项目自己发布的基准里,它在 17/18 个「仓库 × 平台」组合上快于 ripgrep,最高 51.9 倍。
实测
我拉了 12 个公开仓库做测试:tgrep、ripgrep、Zoekt、Google codesearch、Hound、tokio、serde、regex、VS Code、Django、FastAPI、Go,合计 45,629 个文件。
查询 trigram index -path:test,命中 6 个仓库里的 72 个文件。为了找到它们,dowse 一共读了 73 个文件 ,耗时 10 ms。
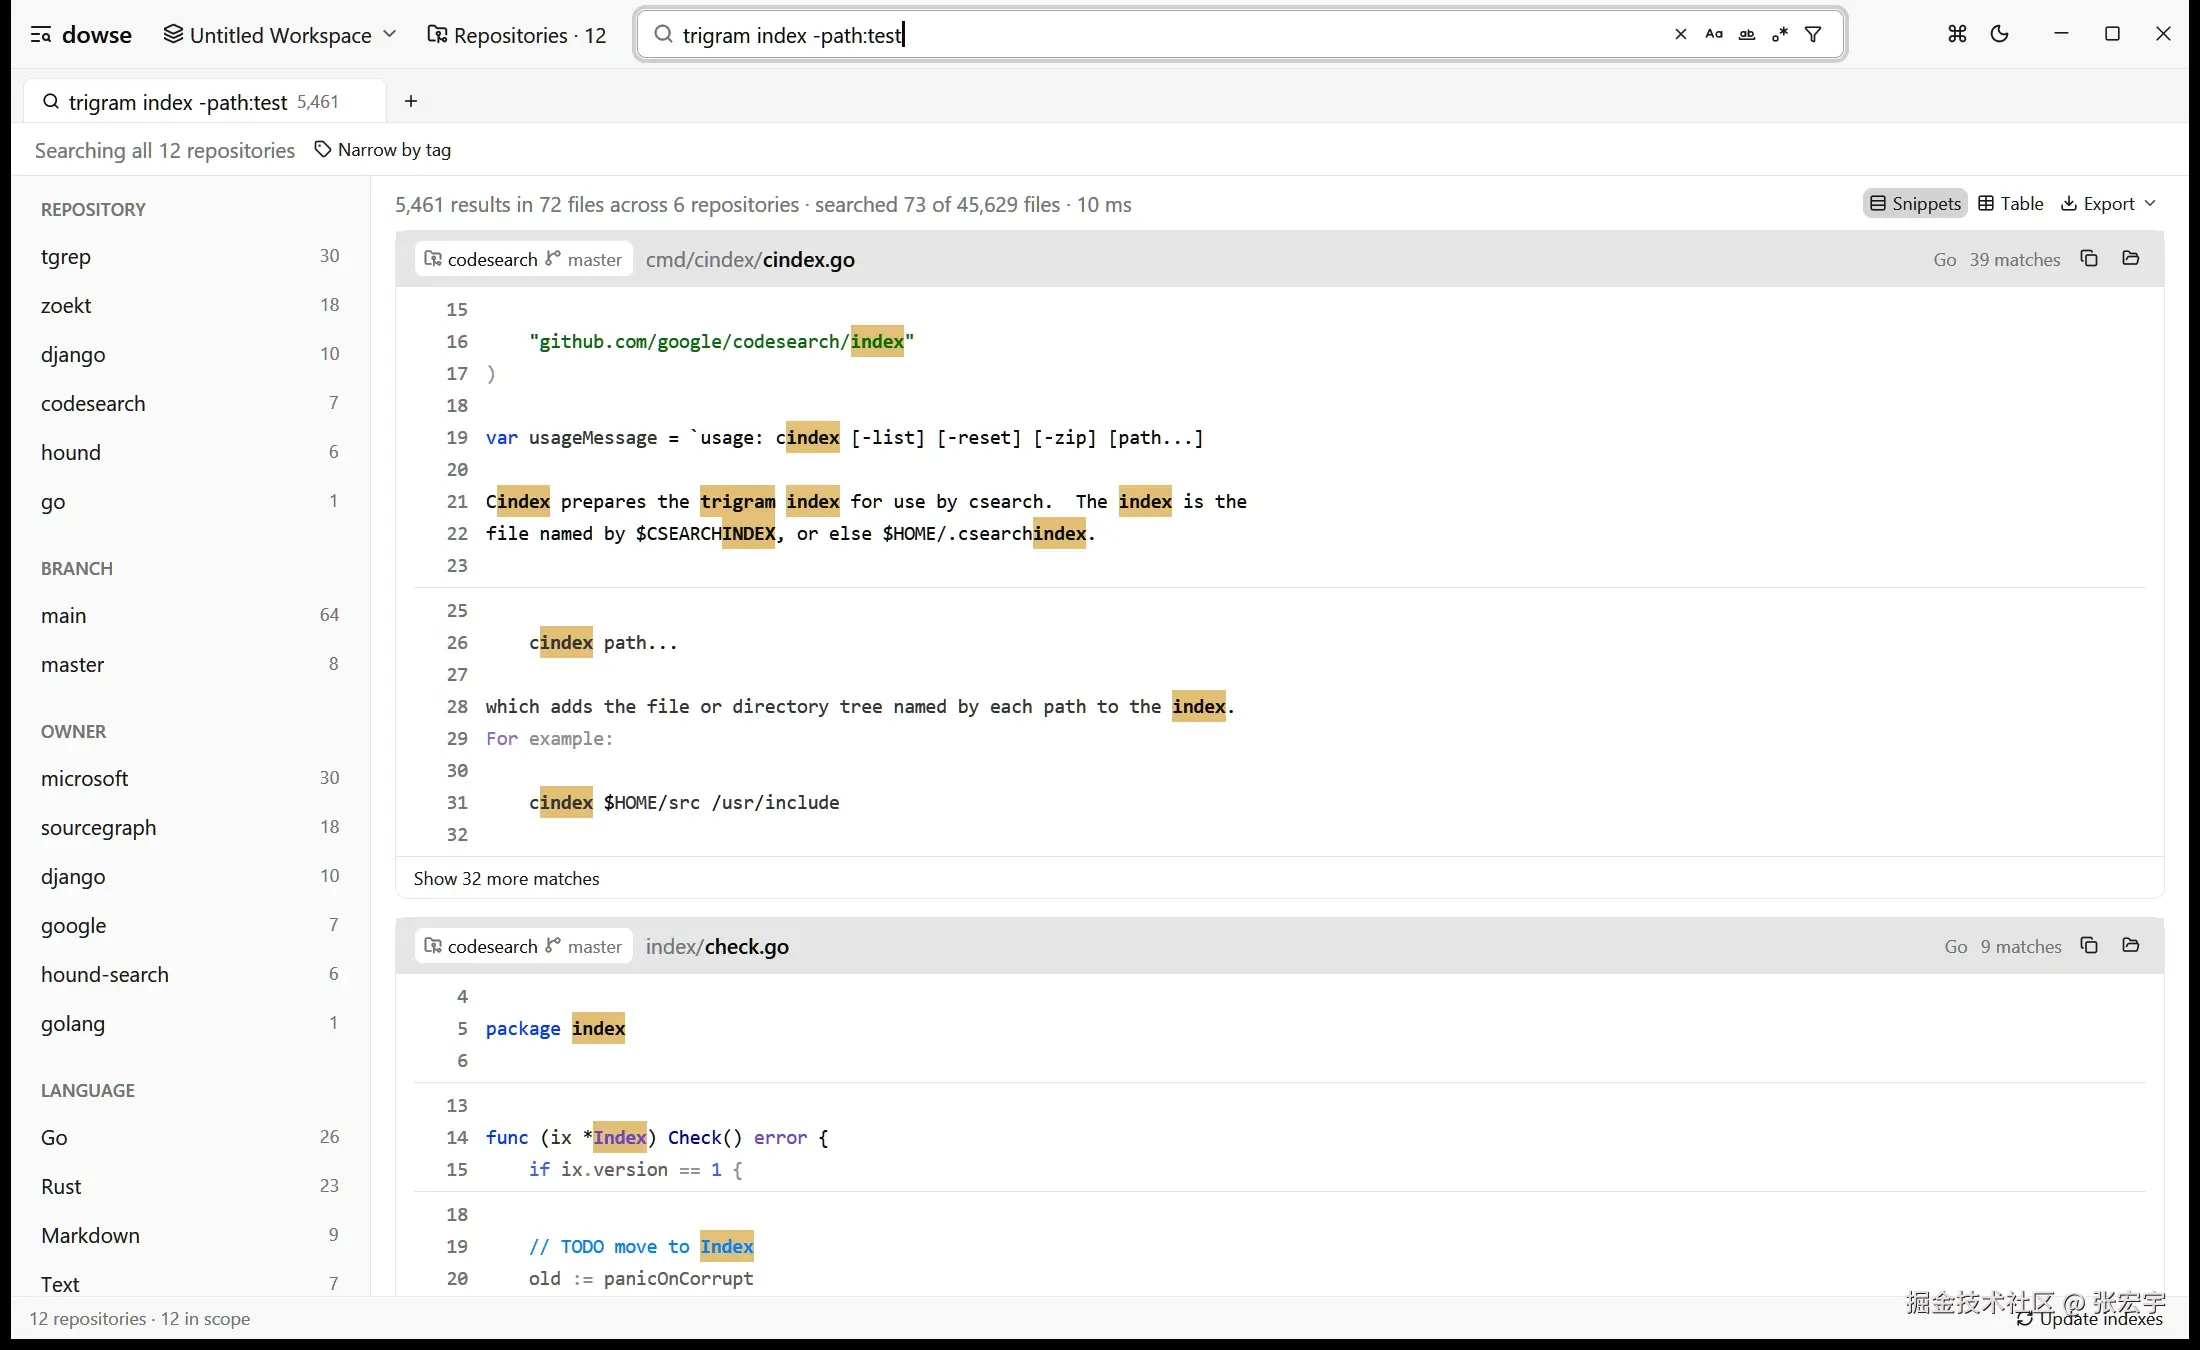
另一个查询在同样这批仓库上耗时 3.2 ms(下面讲是什么查询)。在更大的树上------42,000 个文件、1.3 GB 的 Rust crate 源码------索引构建大约 6 秒,典型查询 20 到 60 ms。
真正说明问题的是选择性:45,629 个文件里只读了 73 个。
dowse 在 tgrep 之上做了什么
tgrep 索引一个目录树,从命令行里搜它,或者为这个树起一个 server。dowse 把很多棵树放到一个搜索框后面,并补上那些需要的东西。
GitHub Code Search 的查询语法
直接用 GitHub 的语法,不用再学一套:
text
parse config                      # 同时包含两个词的文件
parse OR config                   # 任一
parse NOT test                    # 有 parse 没有 test
"fn main()"                       # 精确匹配
/fn \w+_test/                     # 正则
path:src/*.rs  language:rust      # 路径通配、语言
repo:api  branch:main             # 指定仓库、分支
-path:tests  -lang:md             # 取反
有一点和 GitHub 一样需要注意:词项是按文件组合的,不是按行 。parse config 找的是「文件里同时出现这两个词」,然后把包含任一个的行显示出来。
只有限定词的查询(比如 path:*.proto)会直接列出文件,不读内容。
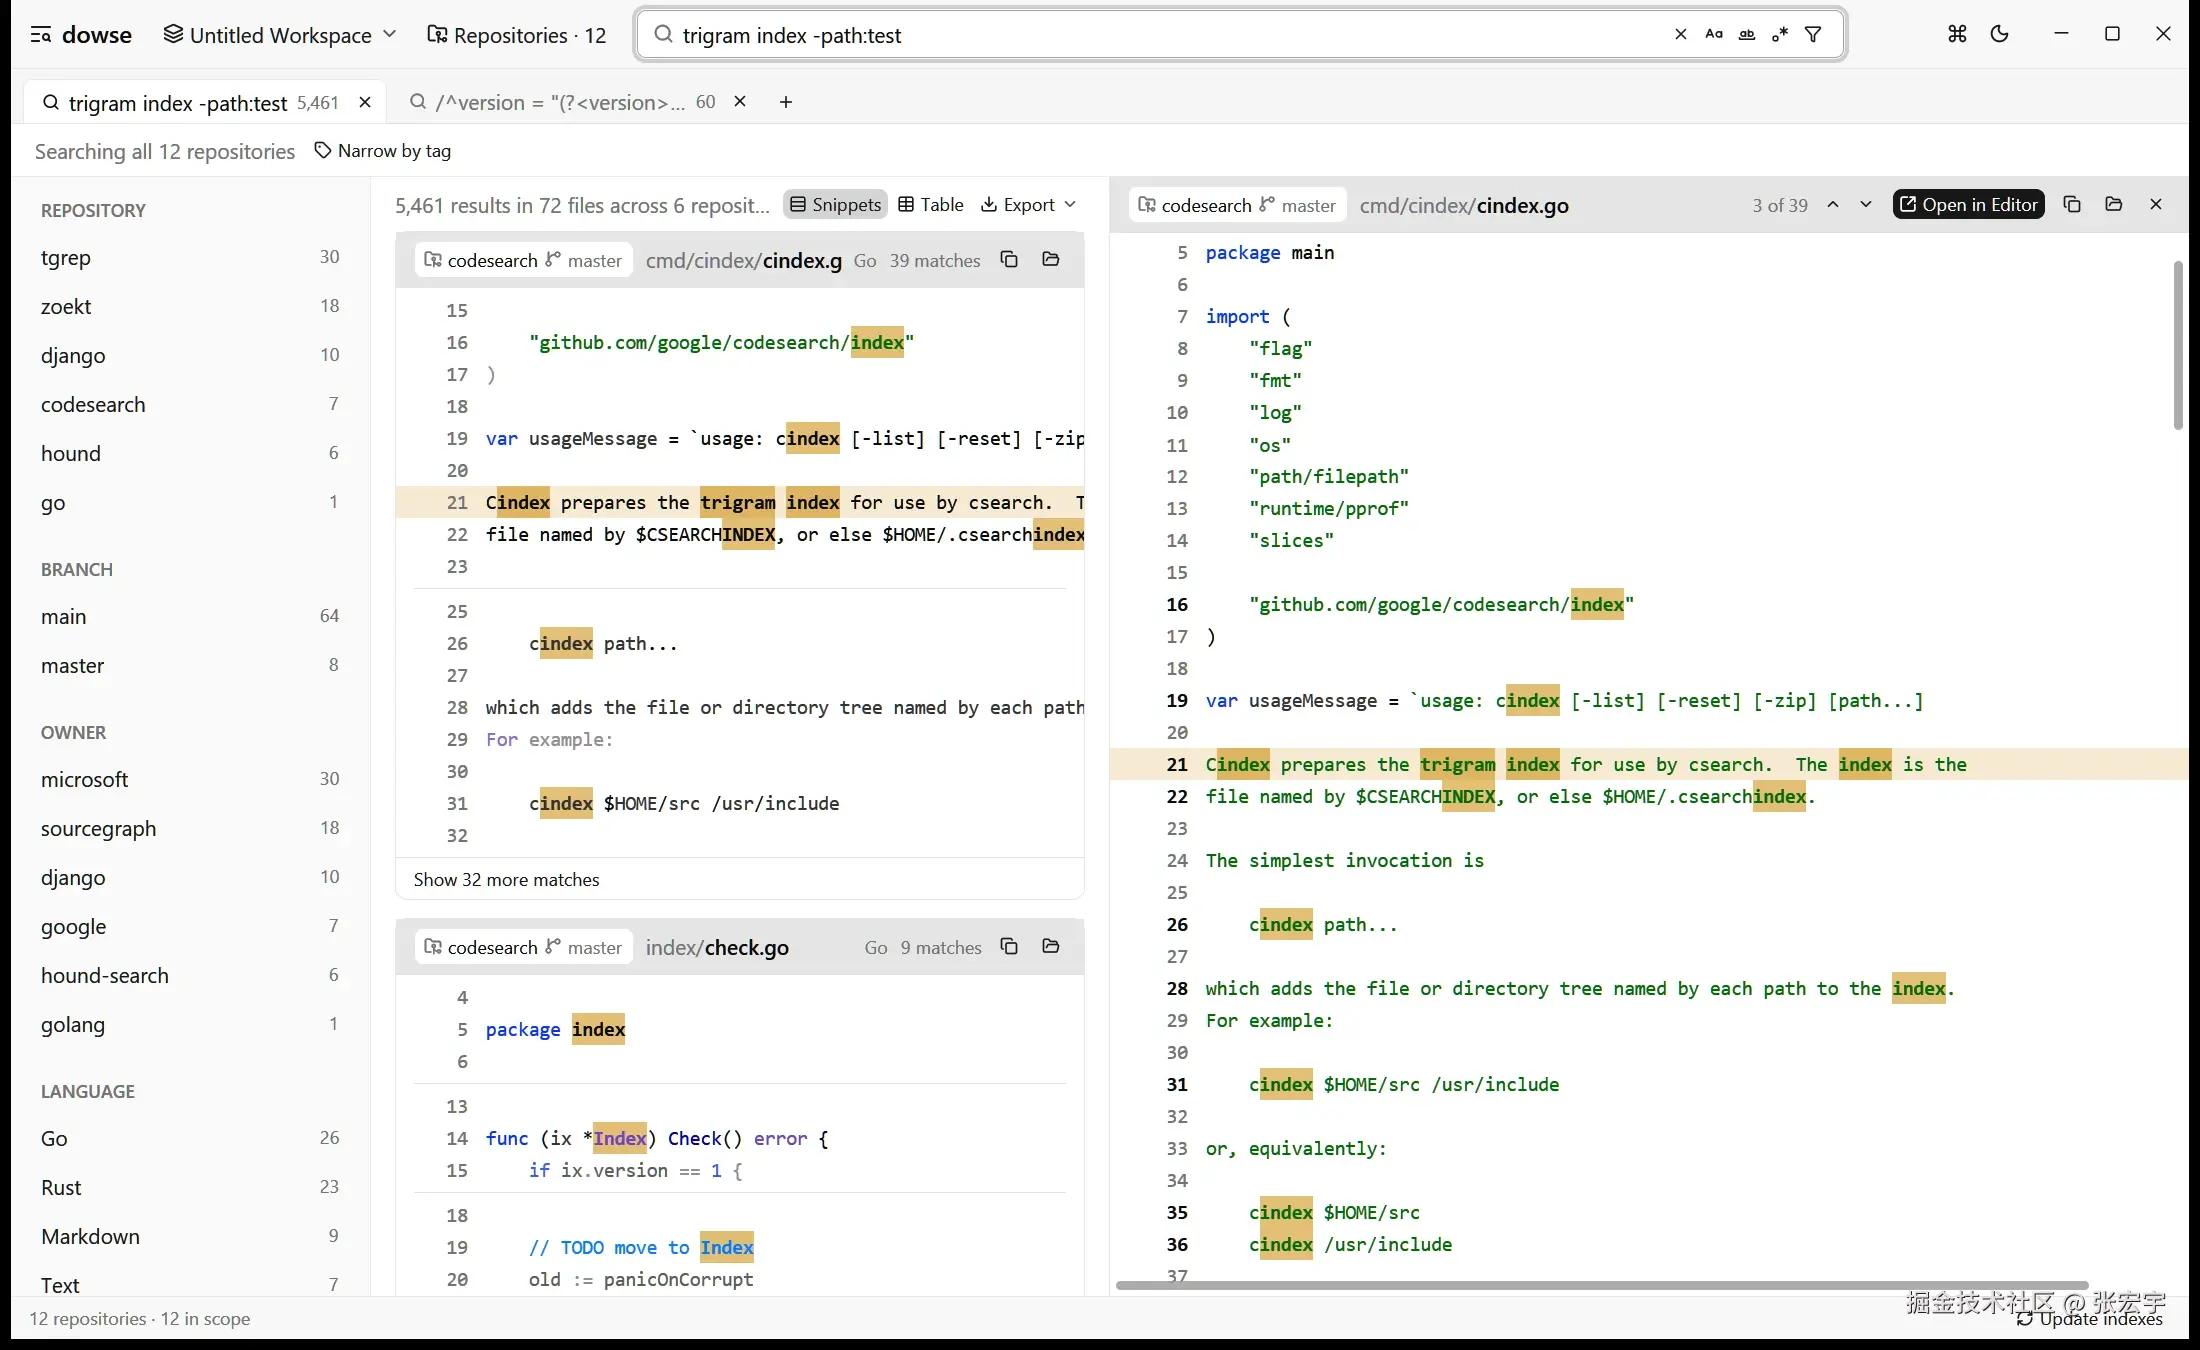
大小写、全词、正则分别绑在 Alt+C、Alt+W、Alt+R。结果用 tree-sitter 语法高亮,点某一行可以在旁边预览整个文件,F4 逐个跳匹配,Ctrl+Click 用 VS Code、Cursor、Zed 或 Sublime Text 打开到对应行。
tags 选范围,facets 收窄结果
每个仓库可以打标签:普通标签如 mirror、dev,或者 key:value 形式的 owner:alice、project:billing。仓库还会自动带上 branch:<当前分支>,切分支时跟着更新。
scope bar 用来选标签。同一组内的标签是「或」(owner:alice 或 owner:bob),组与组之间是「与」(dev 且 owner:alice)。
结果出来之后,facets 会按仓库、分支、标签、语言、顶层目录统计数量,而且每个计数都是在其他筛选条件生效的前提下算出来的。
表格视图:正则捕获组变成列
Alt+T 打开表格视图,每行是一条匹配行,列包括仓库、分支、路径、行号、列号、语言、匹配内容、整行内容。
如果正则里有捕获组,每个组会变成一列,列名就是组名。这个查询可以把所有仓库里的 crate 版本列成一张表:
text
/^version = "(?<version>[^"]+)"/ path:Cargo.toml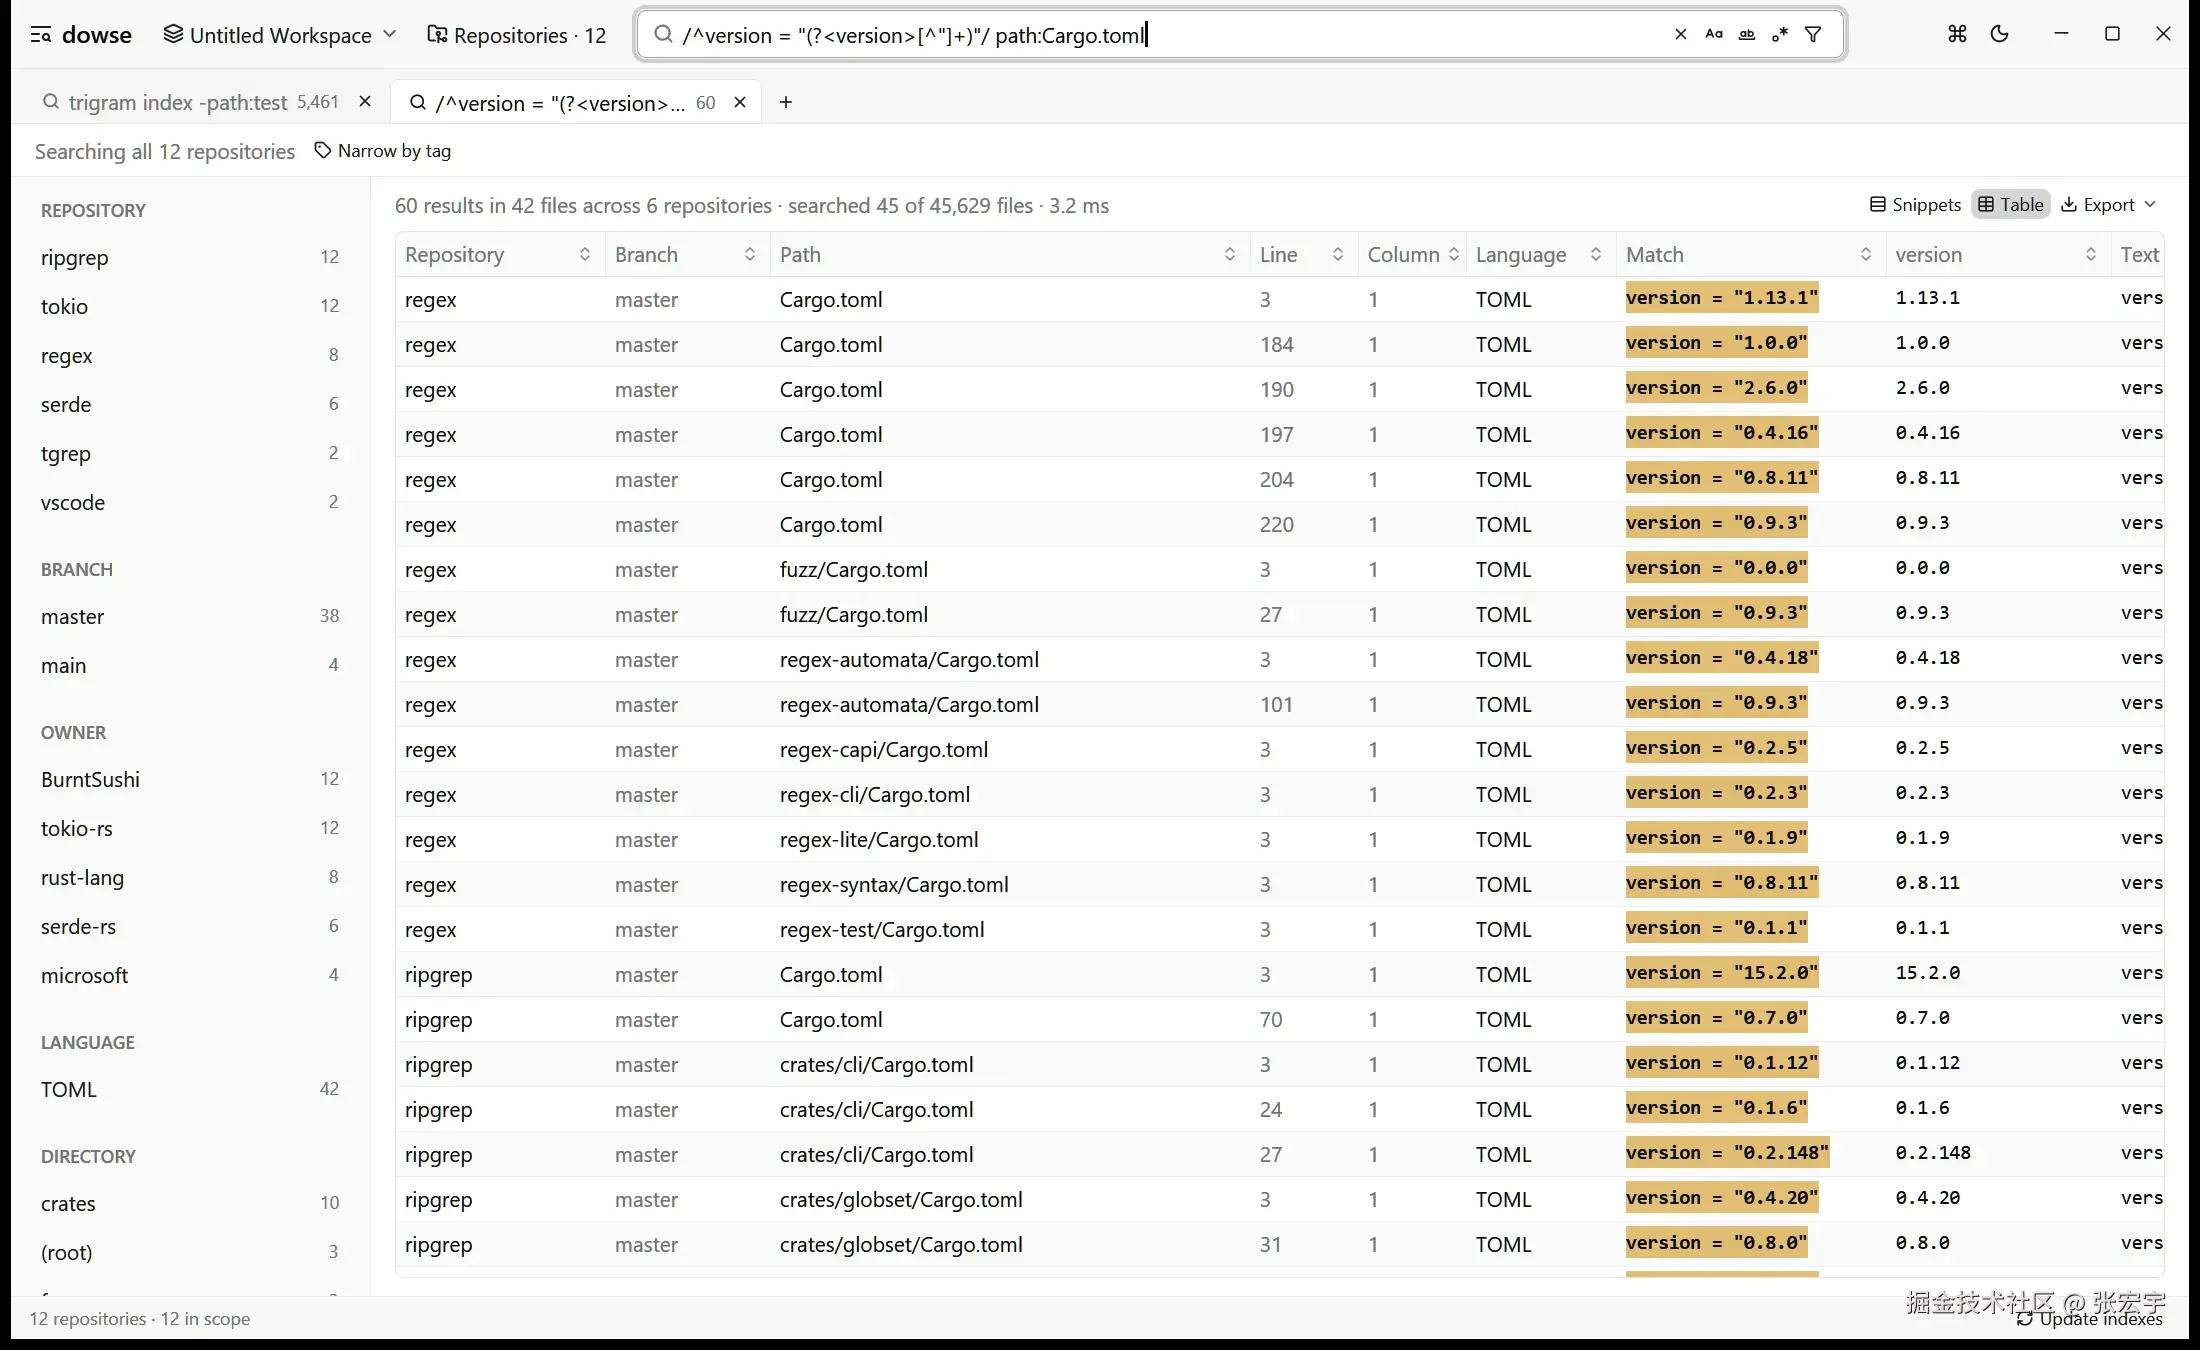
上限大约 20,000 行。作为对比,GitHub code search 单次最多返回 100 条结果。任意列都能排序,然后导出成 CSV、TSV、Markdown 或 JSON,也可以直接粘进表格软件。
「哪些服务还在用这个 API」「日志级别都配成了什么」,这类问题就变成了一张表,而不是一路往下滚。
克隆整个组织,并让它保持最新
仓库页面通过 GitHub CLI 列出某个 owner 的仓库,所以 dowse 不接触你的凭据,先 gh auth login 一次就行。列表分页并行拉取,2,000 个仓库几秒列完。选几个或全选,dowse 在后台把它们克隆到 <folder>/<owner>/<name>,自动打上 owner:<owner> 标签并建索引。
默认是 blobless clone:拿到所有提交,但只取签出状态的文件内容。所以大仓库克隆很快,历史依然可用。
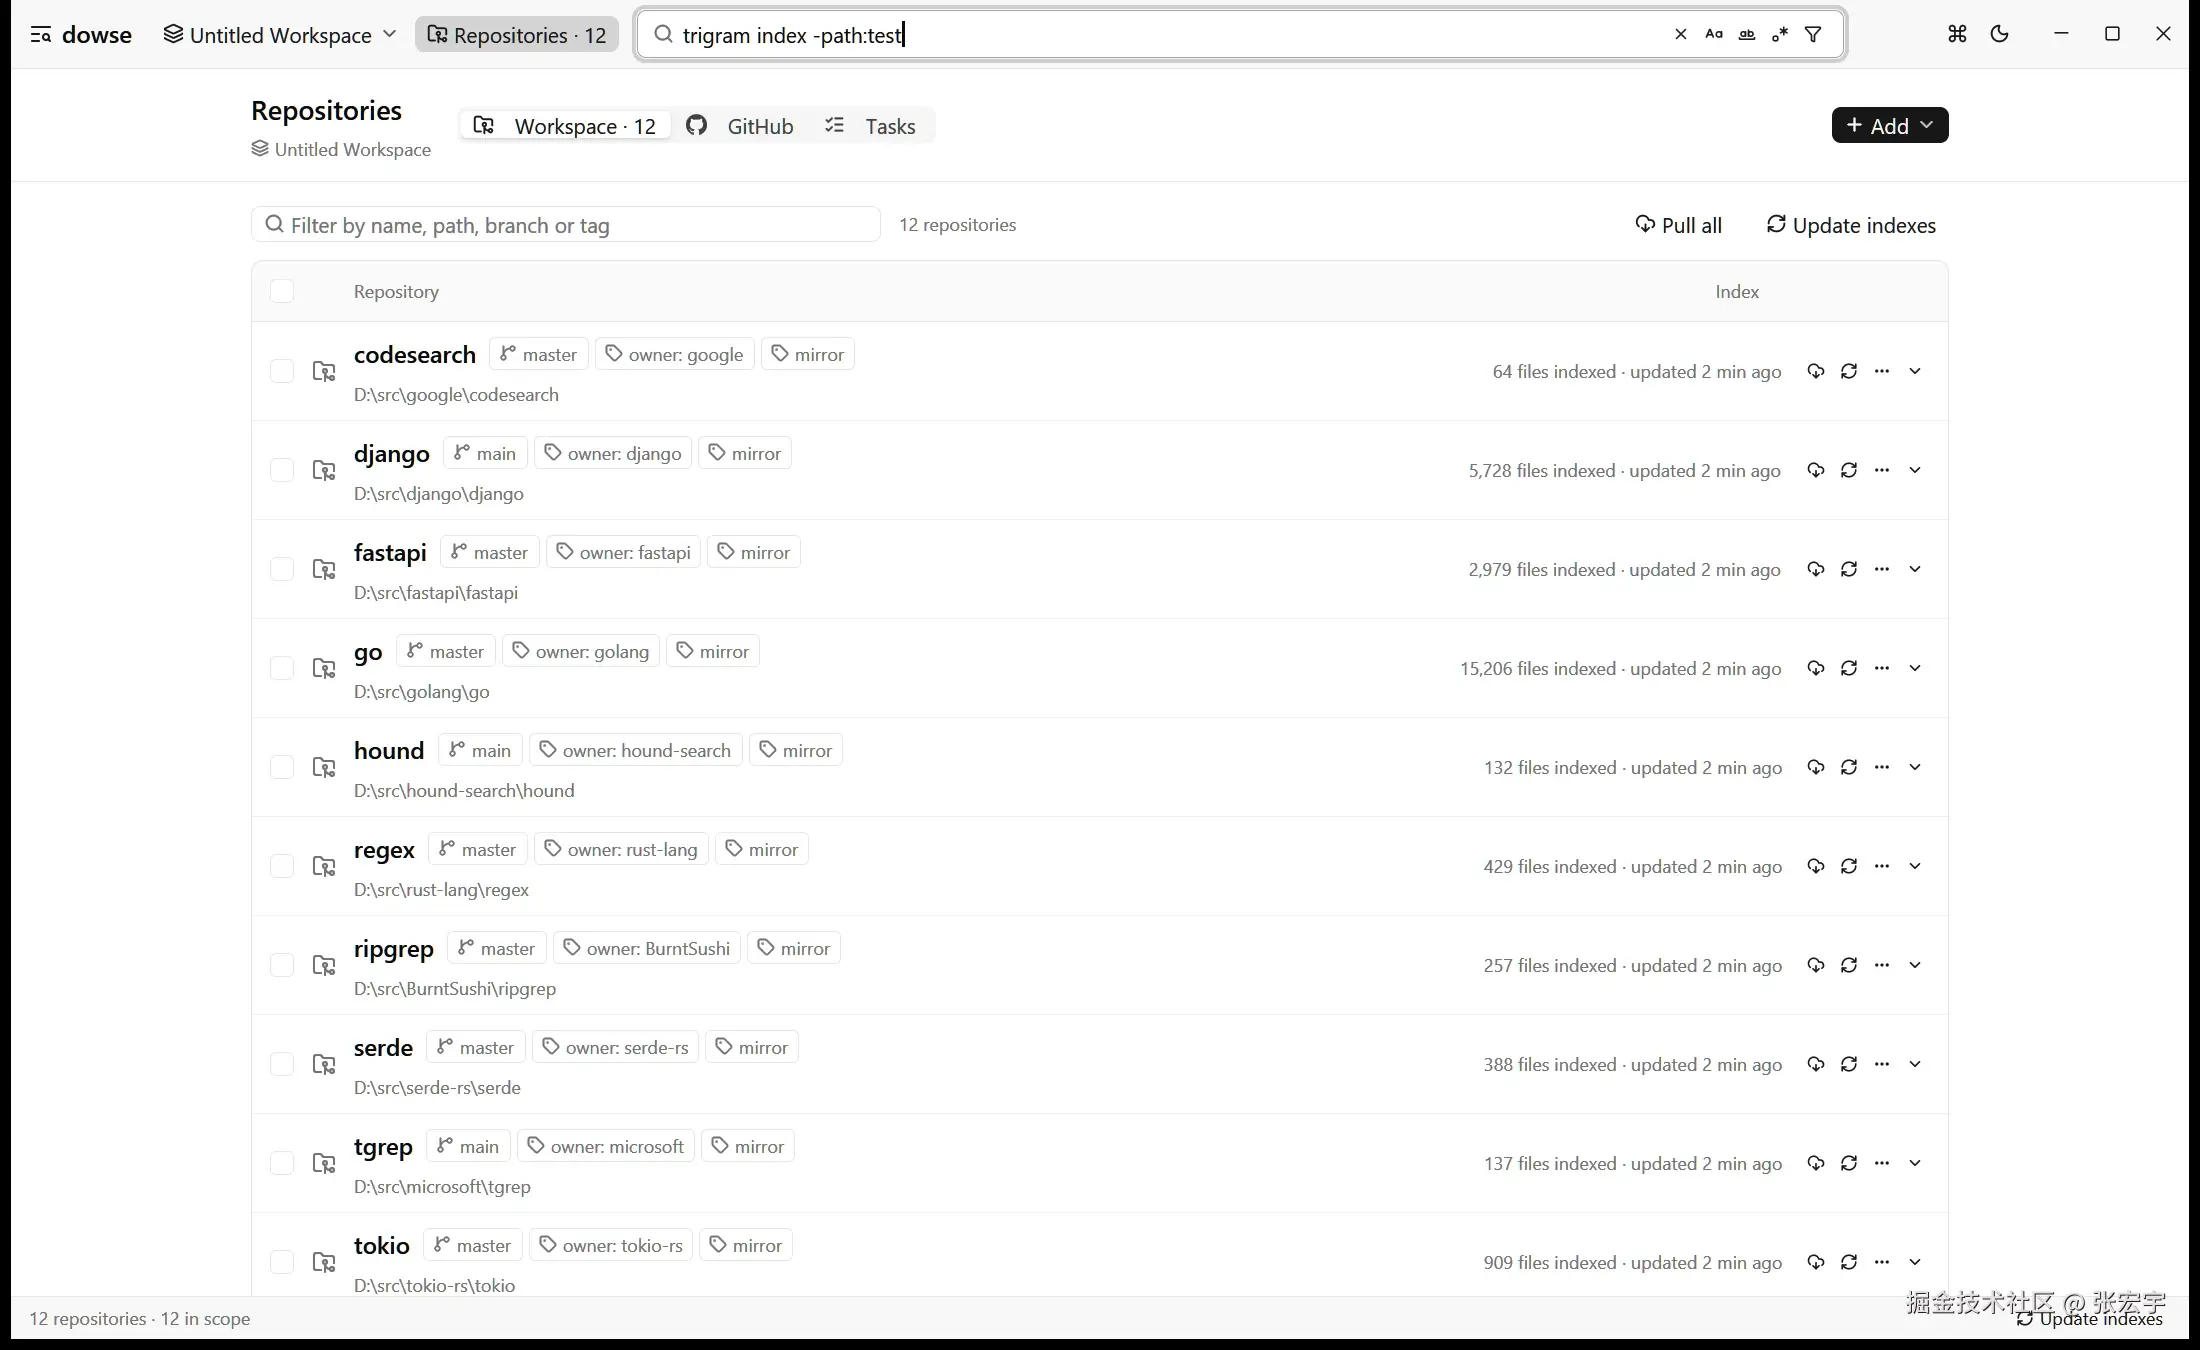
给仓库设一个 pull 间隔(15m、1h、3d),dowse 会按计划拉取。只有满足「默认分支已签出、tracked 文件没有改动、没有本地提交」时它才会 fast-forward,否则只 fetch,并告诉你原因(on feature/x, not main、uncommitted changes)。
它从不 merge、rebase 或 stash。所以你可以把它指向正在开发的 working copy,而不只是给镜像用。
索引怎么保持新鲜
索引只有在和文件一致时才有用,dowse 不等重建:
- 每个仓库一个 file watcher,跟踪上次构建后被改动的文件,搜索时直接读它们。你在镜像里
git pull,或者一秒钟前保存的编辑,下一次搜索就能看到。 - 打开仓库时会找出 dowse 没运行时改动的文件,包括被删除和移动的。
- 更新索引只读改动的文件,然后流式写入索引的一个副本。在一个 245,000 文件、索引 1.7 GB 的仓库上,更新大约 10 秒,而全量构建大约 9 分钟。更新期间搜索照常可用。
索引就放在每个仓库的 .tgrep 目录里,和 tgrep index、tgrep serve 用的是同一个位置,所以 dowse 和 tgrep 命令行可以共用一份索引。
UI 是原生的,用 GPUI 写,也就是 Zed 编辑器背后那套 GPU 渲染框架。中间没有浏览器,也没有 Electron。
给 coding agent 用
dowse search、dowse repos 这些子命令驱动的是正在运行的应用,所以它们共用同一份热索引和 file watcher。如果应用没在运行,第一条命令会在后台无窗口地把它启动起来。
bash
dowse search 'parse_config lang:rust'          # dowse 知道的所有仓库
dowse search --here 'parse_config'             # 只搜你当前所在的那个仓库
dowse search -t owner:my-org -l 'LegacyClient' # 只要路径,限定某个 owner
dowse repos clone --from my-org --pull-every 1h
输出是同时给人和 agent 设计的。一个用 grep 在大树上搜索的 agent,时间花在读文件上,context window 花在读输出上。tgrep 已经解决了前半段(在 Copilot CLI 内部),dowse 让任何 agent 都能拿到跨所有仓库的同一份索引,并且给输出加了预算:
- 结果走 stdout,计数、耗时、说明走 stderr。有匹配退出码 0,没有匹配退出码 1。
- 输出上限 100 行匹配、每文件 20 行,总数在 footer 里。结果被截断时,footer 会建议用哪些限定词收窄,并给出各自保留多少文件:
text
narrow with: repo:api (120) language:Rust (80) path:src/** (64)--json每个匹配文件输出一个对象,外加一个 summary;--table csv输出表格视图的那些行。dowse guide会打印一份给 agent 的简短指南。把它放进AGENTS.md或CLAUDE.md,agent 就能搜索你所有的仓库,而不只是它启动时所在的那一个。
安装
当前版本是 v1.2.0。每个 release 都有可直接运行的构建,SHA256SUMS 里是校验和:
| 平台 | 下载 |
|---|---|
| Windows (x64) | dowse-v1.2.0-windows-x86_64.zip |
| macOS 11+(Apple silicon 和 Intel) | dowse-v1.2.0-macos-universal.zip |
| Linux (x64、arm64) | dowse-v1.2.0-linux-x86_64.tar.gz、dowse-v1.2.0-linux-aarch64.tar.gz |
然后把放仓库的目录加进去:
bash
dowse ~/src ~/mirrors一个装着多个 Git 仓库的目录会把它们逐个加进来。Windows 上仓库页面还能把「Add to dowse」加到资源管理器的文件夹菜单里。
构建没有买付费证书签名,所以 Windows SmartScreen 和 macOS Gatekeeper 会在第一次启动时拦一次,README 里写了怎么放行。想从源码构建,用较新的 stable Rust 跑 cargo run --release 就行。
和其他工具比
| dowse | tgrep | GitHub code search | Sourcegraph | Zoekt | Entrian Source Search | |
|---|---|---|---|---|---|---|
| 运行位置 | 你的机器 | 你的机器 | github.com | 你部署的服务器 | 你部署的服务器 | Visual Studio 内 |
| 搜索范围 | 多个本地 clone,任意分支,含未提交改动 | 一个目录树 | GitHub 仓库,默认分支 | 接入的代码托管 | 你索引的仓库 | 解决方案内的文件 |
| 查询语法 | GitHub code search | 正则、grep 风格 | GitHub code search | Sourcegraph | Zoekt | Entrian |
| 索引 | trigram(tgrep),watcher 保持新鲜 | trigram | GitHub 的 | Zoekt | trigram | 全文 |
| 界面 | 桌面应用和 CLI | CLI 和 server | web | web | web 和 API | IDE 面板 |
| 价格 | 免费,MIT | 免费,MIT | 随 GitHub 提供 | 商业 | 免费,Apache-2.0 | 按开发者授权 |
如果只是想要一个终端里最快的单仓库 grep,用 tgrep。如果团队需要浏览器里共享的、组织级代码搜索,上 Sourcegraph 或者自己跑 Zoekt。如果你的代码都在 GitHub 上、默认分支也够用,GitHub code search 已经在那里了。如果你想搜自己机器上的每一个仓库、不管它在哪个分支、从一个应用和 agent 的终端里搜,还不想跑服务器,那就是 dowse。
几个常见问题
这算 Sourcegraph 的替代品吗? 对一个人搜自己的 clone 来说算,dowse 覆盖了它的核心用法:跨多个仓库的快速正则和字面量搜索,不需要服务器。它不替代 Sourcegraph 的代码智能、batch changes,也没有给团队用的共享 web UI。
它算 tgrep 的 GUI 吗? 算一部分。dowse 用 tgrep 的索引,读写同一个 .tgrep 目录,所以它是一个 tgrep 的桌面前端。但它同时支持一次查询多个仓库、解析 GitHub code search 语法,还加了标签、facets、表格视图、文件预览,以及从 GitHub 克隆和拉取,这些都不是 tgrep 打算做的事。
会搜未提交的改动和其他分支吗? 会。它搜的是磁盘上的文件,所以仓库当前签出的是哪个分支、你还没提交的编辑,都能搜到。每个仓库会带上当前分支的标签,所以 branch:main 能挑出在 main 上的那些。
代码会被传到哪里吗? 不会。索引在各仓库的 .tgrep 目录里,搜索在本机跑。唯一的网络访问是你主动要的 Git 和 GitHub CLI 命令:列出、克隆、拉取。
最后
dowse 在 GitHub 上:HenryZhang-ZHY/dowse。免费,MIT 协议。
如果它帮你省了时间,一个 star 能让更多人看到它;有缺的或者坏的地方,欢迎开 issue。
英文的发布说明(写在 1.0 发布时)在这里:dowse 1.0: A Local Alternative to Sourcegraph and GitHub Code Search。