把边界放进时序图:RSC 请求链路的交接设计
React Server Components(RSC)讨论到最后,常常又回到一句过于静态的话:"这个组件该放服务端,还是客户端?"
这当然是一个必要问题,但在真实项目里,更容易造成性能、缓存和一致性问题的,往往不是某个组件的"归属",而是一次用户操作在不同运行时之间交接时,责任没有被说清楚。
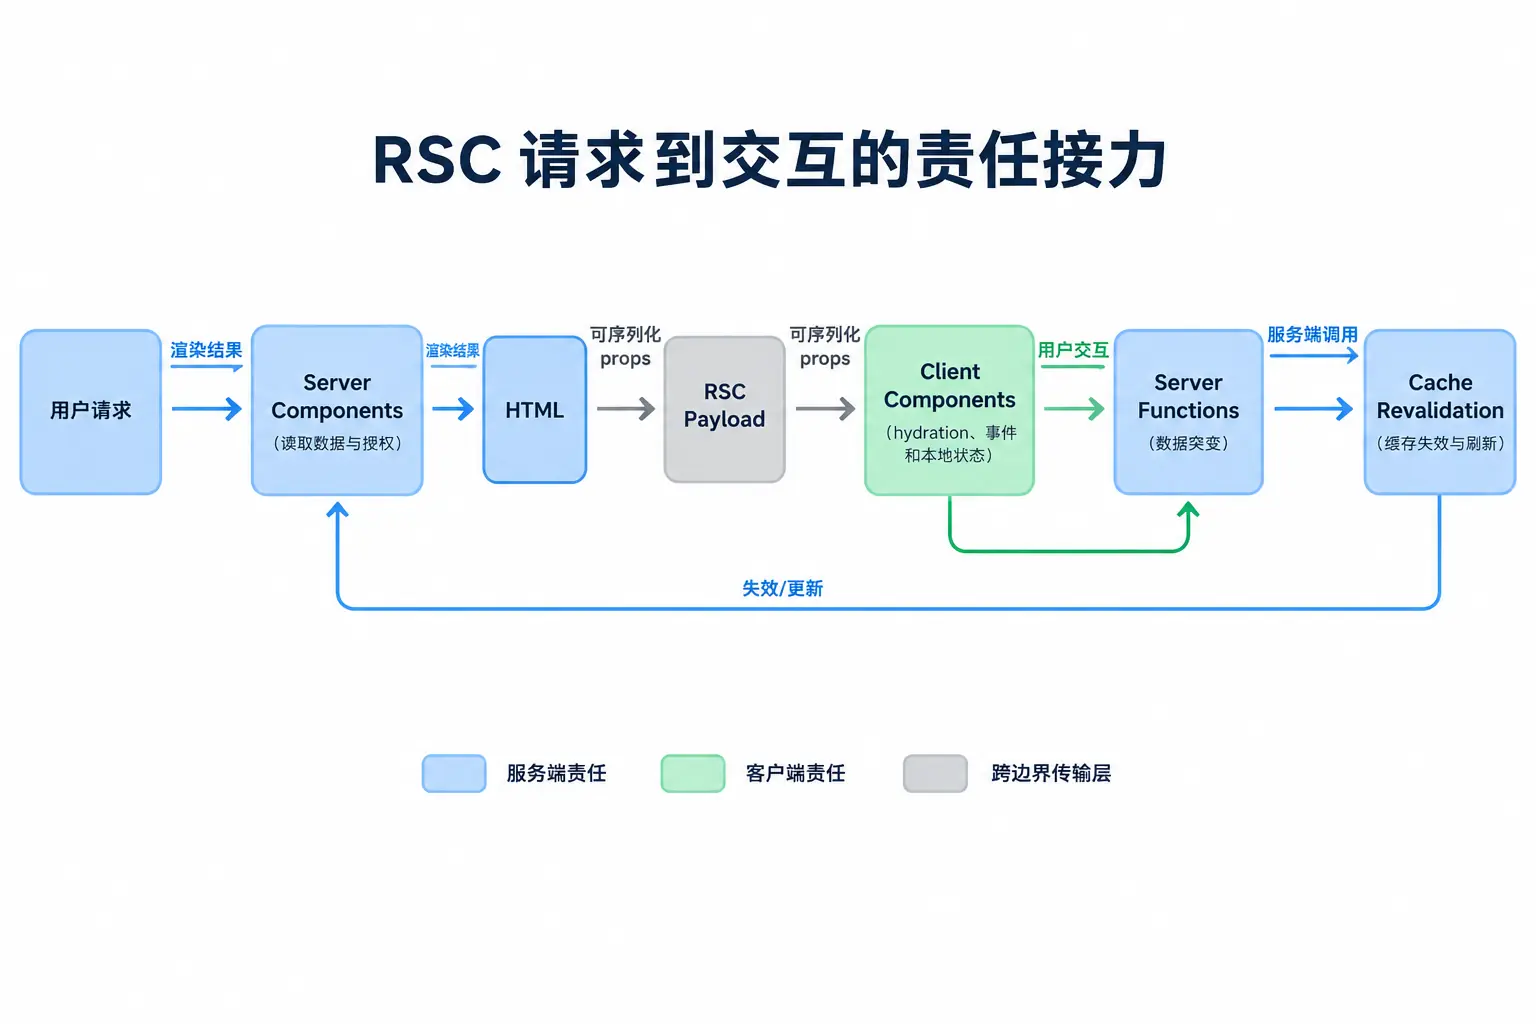
以 Next.js App Router 为例,一个订单页的生命周期通常包括:服务端读取会话与数据、生成 RSC 结果和 HTML、浏览器 hydration、用户输入筛选条件、客户端路由跳转、服务端重新查询、提交突变、缓存失效与界面同步。RSC 边界应服务于这条链路,而不是服务于"提高服务端组件比例"这个指标。
本文采用一个更适合评审方案的原则:
把浏览器中必须连续存在的过程留给客户端;把可在一次服务端计算中完成、且能安全复用的结果留给服务端;把数据下传、缓存和突变后的同步视为独立的交接契约。
RSC 不是 SSR 的别名
Server Components 是 React 的组件执行模型。它们运行在服务端环境中,可以在静态生成阶段或请求处理阶段执行;其代码及仅供服务端使用的依赖不需要被发送到浏览器。(React:Server Components)
在 Next.js App Router 的首次访问中,服务端会协同产出:
- HTML:尽早提供可见内容;
- RSC Payload:描述服务端组件结果、客户端组件引用及跨边界数据;
- 客户端 JavaScript :让 Client Components 在浏览器中 hydration 并响应交互。(Next.js:Server and Client Components)
因此,RSC 的核心收益不只是"先返回 HTML",而是避免将服务端组件及其服务端依赖一并下载、解析和执行于浏览器。
后续导航也不应简单理解为"重新加载整页 HTML"。App Router 可以获取、复用或预取路由所需的 RSC 结果;实际行为仍会受到路由动态性、缓存配置和预取策略影响。不要把某一次观察到的网络请求形态当成 RSC 的固定语义。(Next.js:Prefetching)
第一条边界:use client 划分的是模块图
'use client' 不是给一段 JSX 涂上"客户端颜色",而是声明该文件是客户端入口。该模块及其可被客户端打包的传递依赖,会进入客户端模块图。(React:use client)
这意味着,下面两种改动的影响完全不同:
- 给一个小型日期选择器加
'use client'; - 给页面根组件加
'use client',使查询、格式化、图表库和状态管理依赖都可能进入浏览器端依赖链。
因此,评审时应先查看 import 图,而不是只看组件在视觉树中的大小。一个"只有一个按钮"的组件,如果直接导入富文本编辑器、图表运行时或大型工具库,也可能成为客户端包膨胀的入口。
但模块图边界不等于 JSX 父子关系边界。服务端组件可以先构造 JSX,再作为 children 或 slot 传入客户端交互容器:
tsx
// app/ui/filter-panel.tsx
'use client'

import { useState, type ReactNode } from 'react'

export function FilterPanel({ children }: { children: ReactNode }) {
  const [open, setOpen] = useState(false)

  return (
    <section>
      <button onClick={() => setOpen((value) => !value)}>筛选</button>
      {open ? children : null}
    </section>
  )
}

// app/orders/page.tsx
import { FilterPanel } from '@/app/ui/filter-panel'
import { OrderSummary } from '@/app/ui/order-summary'

export default async function OrdersPage() {
  return (
    <FilterPanel>
      <OrderSummary />
    </FilterPanel>
  )
}
这里的 FilterPanel 负责浏览器中的开关状态;OrderSummary 仍可在服务端执行,因为它由服务端页面组件创建,再作为内容传入客户端容器。这个组合模式能避免"交互容器包住什么,什么就必须客户端化"的误判。(React:use client)
第二条边界:区分一次性结果与连续过程
判断组件位置时,与其先给组件贴标签,不如先画出它参与的时间线。
| 运行时问题 | 典型责任 | 优先位置 |
|---|---|---|
| 页面刚进入时,谁读取会话、租户和权限? | 鉴权、数据裁剪、初始查询 | 服务端 |
| 用户正在输入、拖拽或编辑时,谁保存未提交过程? | 草稿、焦点、选区、动画、撤销栈 | 客户端 |
| 筛选条件变更后,谁负责得到新的列表? | URL 参数解析、查询、排序、分页 | 服务端为主 |
| 用户点击保存时,谁证明请求仍有权限? | 再鉴权、幂等、写入、审计 | 服务端 |
| 写入完成后,谁让旧结果退出视图? | 失效、刷新、乐观更新或回滚 | 两端协作 |
一个实用判断法是:如果下一次用户操作必须依赖浏览器内尚未提交的状态,这段责任通常必须在客户端连续存在。
例如,复杂表单中的输入值、字段联动、撤销、拖拽位置和编辑器选区,不适合因"服务端优先"而在每次变更时都往返服务端。相反,订单列表的权限过滤、分页查询和聚合统计,通常不应先把完整数据集下载到客户端再自行筛选。
RSC 并不要求"所有数据都服务端化",它要求团队明确:哪些状态是短暂交互过程,哪些结果可以被服务端重新计算。
第三条边界:传递结果不等于传递访问权
服务端读取数据库、内部服务、文件系统或使用密钥,是 RSC 的重要价值;但服务端能读取某份数据,不代表这份数据可以完整穿过 RSC 边界。
例如,订单详情页可以在服务端完成查询和权限判断,但传给客户端编辑器的应是面向编辑场景的 DTO,而不是原始数据库实体:
tsx
// 错误:客户端不应接收仓储对象或领域实体实例
return <OrderEditor repository={orderRepository} order={new Order(row)} />

// 更清晰:服务端完成映射和字段裁剪
return (
  <OrderEditor
    initialOrder={{
      id: row.id,
      status: row.status,
      deliveryAddress: row.deliveryAddress,
    }}
  />
)
跨边界 props 必须满足 React 的序列化约束。普通数据结构,以及 React 支持的部分内建类型和服务端引用可以跨越边界;普通函数、类实例、数据库连接、请求对象等不能作为普通 props 直接交给客户端。具体支持范围应以所用 React 版本文档为准。(React:use client)
更重要的是建立三份不同的清单:
- 数据访问清单:服务端为了完成决策可以读取什么;
- 数据下传清单:客户端为渲染和交互实际需要什么;
- 缓存复用清单:哪些结果可以被哪些请求复用。
将这三者混为一谈,容易导致敏感字段下传、租户串数据或缓存命中旧权限结果。
第四条边界:等待策略决定体验,不是组件名称决定体验
服务端组件适合等待首屏关键事实,例如商品标题、订单状态、权限结论和主内容数据。对评论、相关推荐、次级统计等非关键内容,则应通过 Suspense 将等待范围明确表达出来,让关键内容优先显示。
这里需要避免两个误区:
- 不要把所有请求都
await在页面顶层,导致一个慢的次要接口阻塞整个首屏; - 也不要为了流式渲染拆出大量细碎边界,使加载状态跳动、请求瀑布化且难以监控。
一个好的 Suspense 边界应对应用户可理解的内容单元,并能回答:它慢时,用户仍能做什么;它失败时,错误应落在哪个区域;它刷新时,哪些内容必须保持稳定。
第五条边界:突变后,缓存才是真正的交接现场
'use server' 用于声明可从客户端触发的 Server Function;客户端获得的是服务端引用,而不是函数实现本身。它适合表单提交、状态修改和删除等突变操作。(React:Server Functions)
但 Server Function 不是"每个事件都远程调用一次"的万能 RPC。一次突变至少应明确以下契约:
- 重新鉴权:不能只信任页面初次渲染时的权限结论;
- 幂等与并发语义:双击、超时重试、重复提交如何处理;
- 最小返回值:仅返回继续更新 UI 必需的信息;
- 失败策略:保留草稿、回滚乐观更新,还是要求用户刷新;
- 失效范围:详情、列表、统计、导航徽标中哪些结果需要同步。
缓存策略尤其不能只写成"这个页面要缓存"。缓存键必须包含所有影响结果的维度,例如商品 ID、租户、语言、实验分组;当前用户权限和强个人化数据则不能误用为公共缓存。
Next.js 的缓存能力与默认行为会随版本、路由配置和所采用的缓存模型变化。项目文档应固定 Next.js 版本,并写明采用的缓存 API、失效方式和验证用例;不要把某个版本的默认策略描述为 RSC 的通用规律。(Next.js:use cache)
运行时也属于边界的一部分
"运行在服务端"不等于"拥有完整 Node.js 能力"。在 Next.js 中,路由可运行于 Node.js 或 Edge runtime;Edge 环境以 Web API 为主,对文件系统、原生 Node.js API 和部分依赖的兼容性不同。(Next.js:Route Segment Config)
因此,涉及数据库驱动、文件处理、原生二进制模块或企业 SDK 时,不能只因"Edge 离用户更近"就迁移运行时。应先验证依赖兼容性、连接模型、冷启动成本、区域数据合规和缓存能力。
组件边界、缓存边界与 runtime 选择是三项关联但独立的设计决策。
合并前的评审清单
一次 RSC 改造至少应回答:
'use client'新增后,哪些传递依赖进入了客户端包?- 哪些状态必须在浏览器中跨多次操作连续保存?
- 服务端读取的数据中,哪些字段真正需要下传?
- 跨边界 props 是否符合当前 React 版本的序列化规则?
- 关键内容与可延迟内容是否有清晰的等待和错误边界?
- 突变是否在服务端重新鉴权,并定义幂等、失败与并发行为?
- 缓存键和失效范围是否覆盖租户、用户、语言等影响结果的维度?
- 路由运行于 Node.js 还是 Edge,依赖是否兼容?
- 是否测量了客户端 JavaScript、RSC Payload、TTFB、服务端查询耗时和交互延迟?
- 指标恶化时,能否按路由或功能开关回退?
RSC 的成熟用法,不是把更多组件迁回服务端,而是让每一次交接都有明确责任:谁读取事实,谁保存过程,谁等待结果,谁能看到数据,谁负责让旧结果失效。
当边界被放进一条可观测的请求时序图中,RSC 才会从"组件放置技巧"变成可持续演进的运行时架构。