在 Anthropic 和 OpenAI 猛烈的炮火下,国产模型好像集体哑火了。
"国产大佬"都不说话了,我猜测是在"避锋芒"。
不过也有几个头铁的,完全就是光脚的不怕穿鞋的!
比如之前说的 LongCat2.5,还有"低调"更新的 MiniMax3.1 和神秘的"太空兔"(Space Bunny)。
这个事情就有点像以前热门电影档期,好莱坞大片云集,国产大片会避一避,但是有些小制作就会搏一搏。
虽然我大概知道结果,但是还是有一点点好奇。
坊间有传闻说它们是同一个模型,既然如此,我就一锅炖了吧。把两个模型都放在一起测试吧。
关于 MiniMax 我还是要稍微讲一点点背景信息。
一年前的 M 可以说是非常嚣张的!
年初的时候 MiniMax 的宣传攻势非常猛,号称能打赢 Claude,编程和智能体世界第一 No.1。(这个梗我要说很久很久)
当时 MM 和 GLM 一起上市,加上资本的推波助澜,非常热闹。
但是,我一测就发现是非常"拉胯"。然后我也是头铁,直接戳破了这个泡泡!当时的环境,要跳出来说真话是挺难的。然后它们 PR 也联系我进行了友好的交流。
M从此被我誉为"凤雏"。
后来的事情大家也知道了,慢慢地大家都发现它的真实水平了,股价也一泻千里了,完美演绎了倒 V 走势。
然后语言模型也基本停更了!
很久很久之后,也就这两天,终于更新了这个 3.1(+0.1)版本!
这次学低调了,很好!
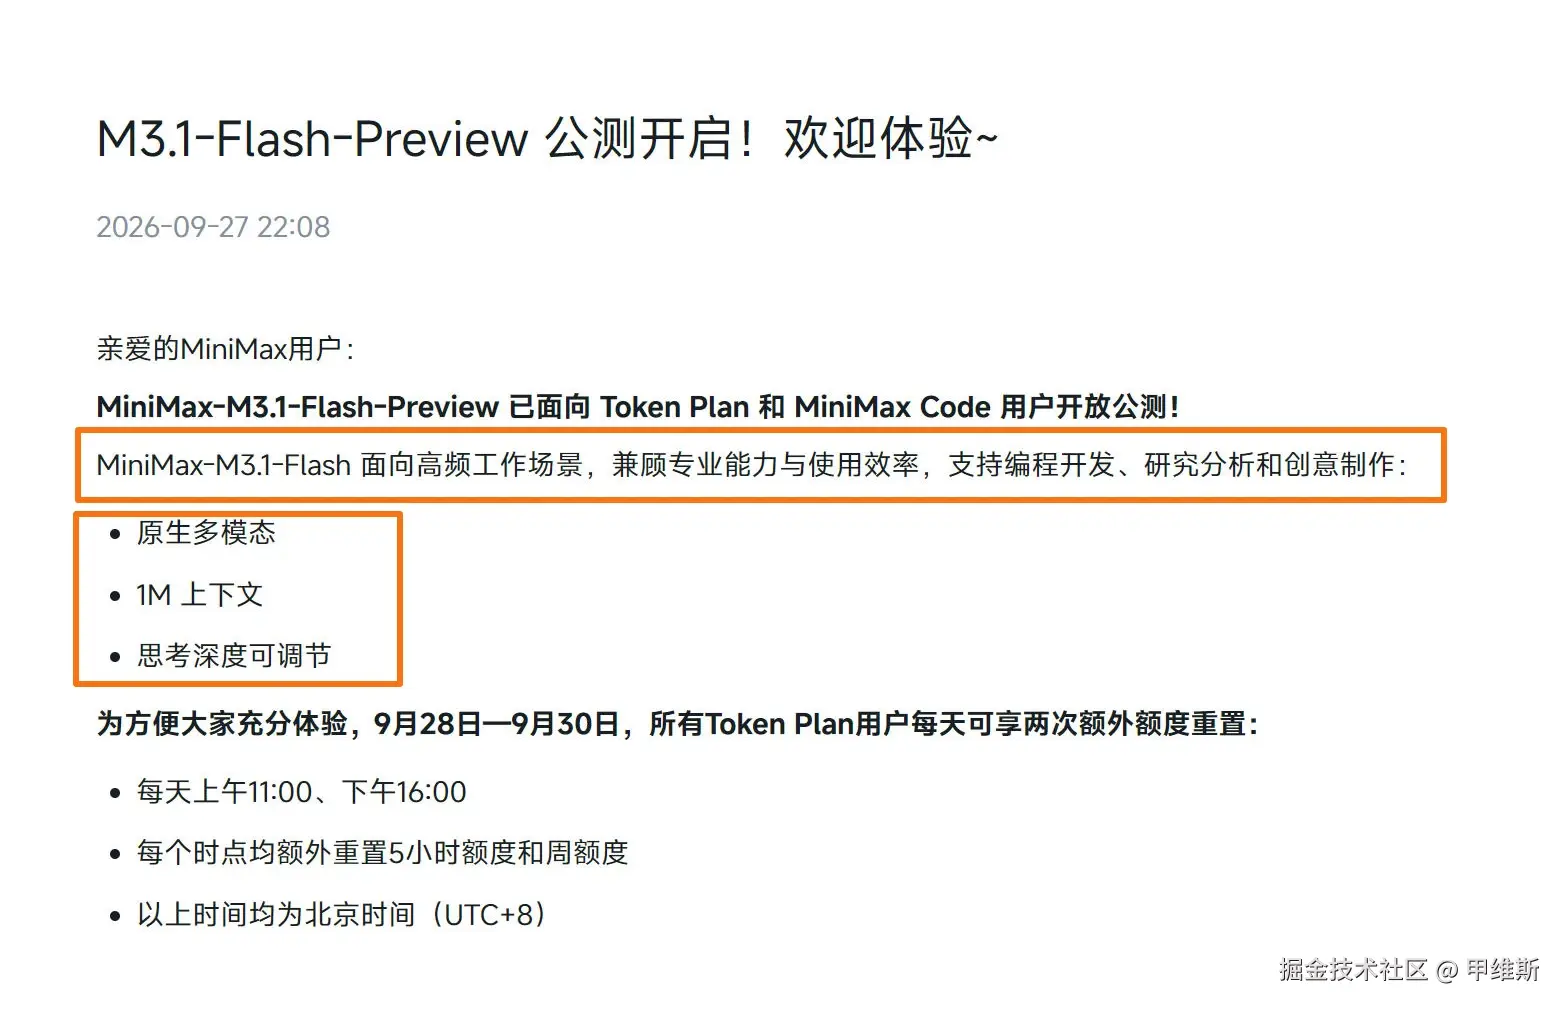
这次的信息非常少,就是登录官网之后会有一个弹窗!(我终于想起我有个年会员了,被忽悠的)
除此之外没太多信息!
OpenCode 上有一个对比图,可以作为参考:
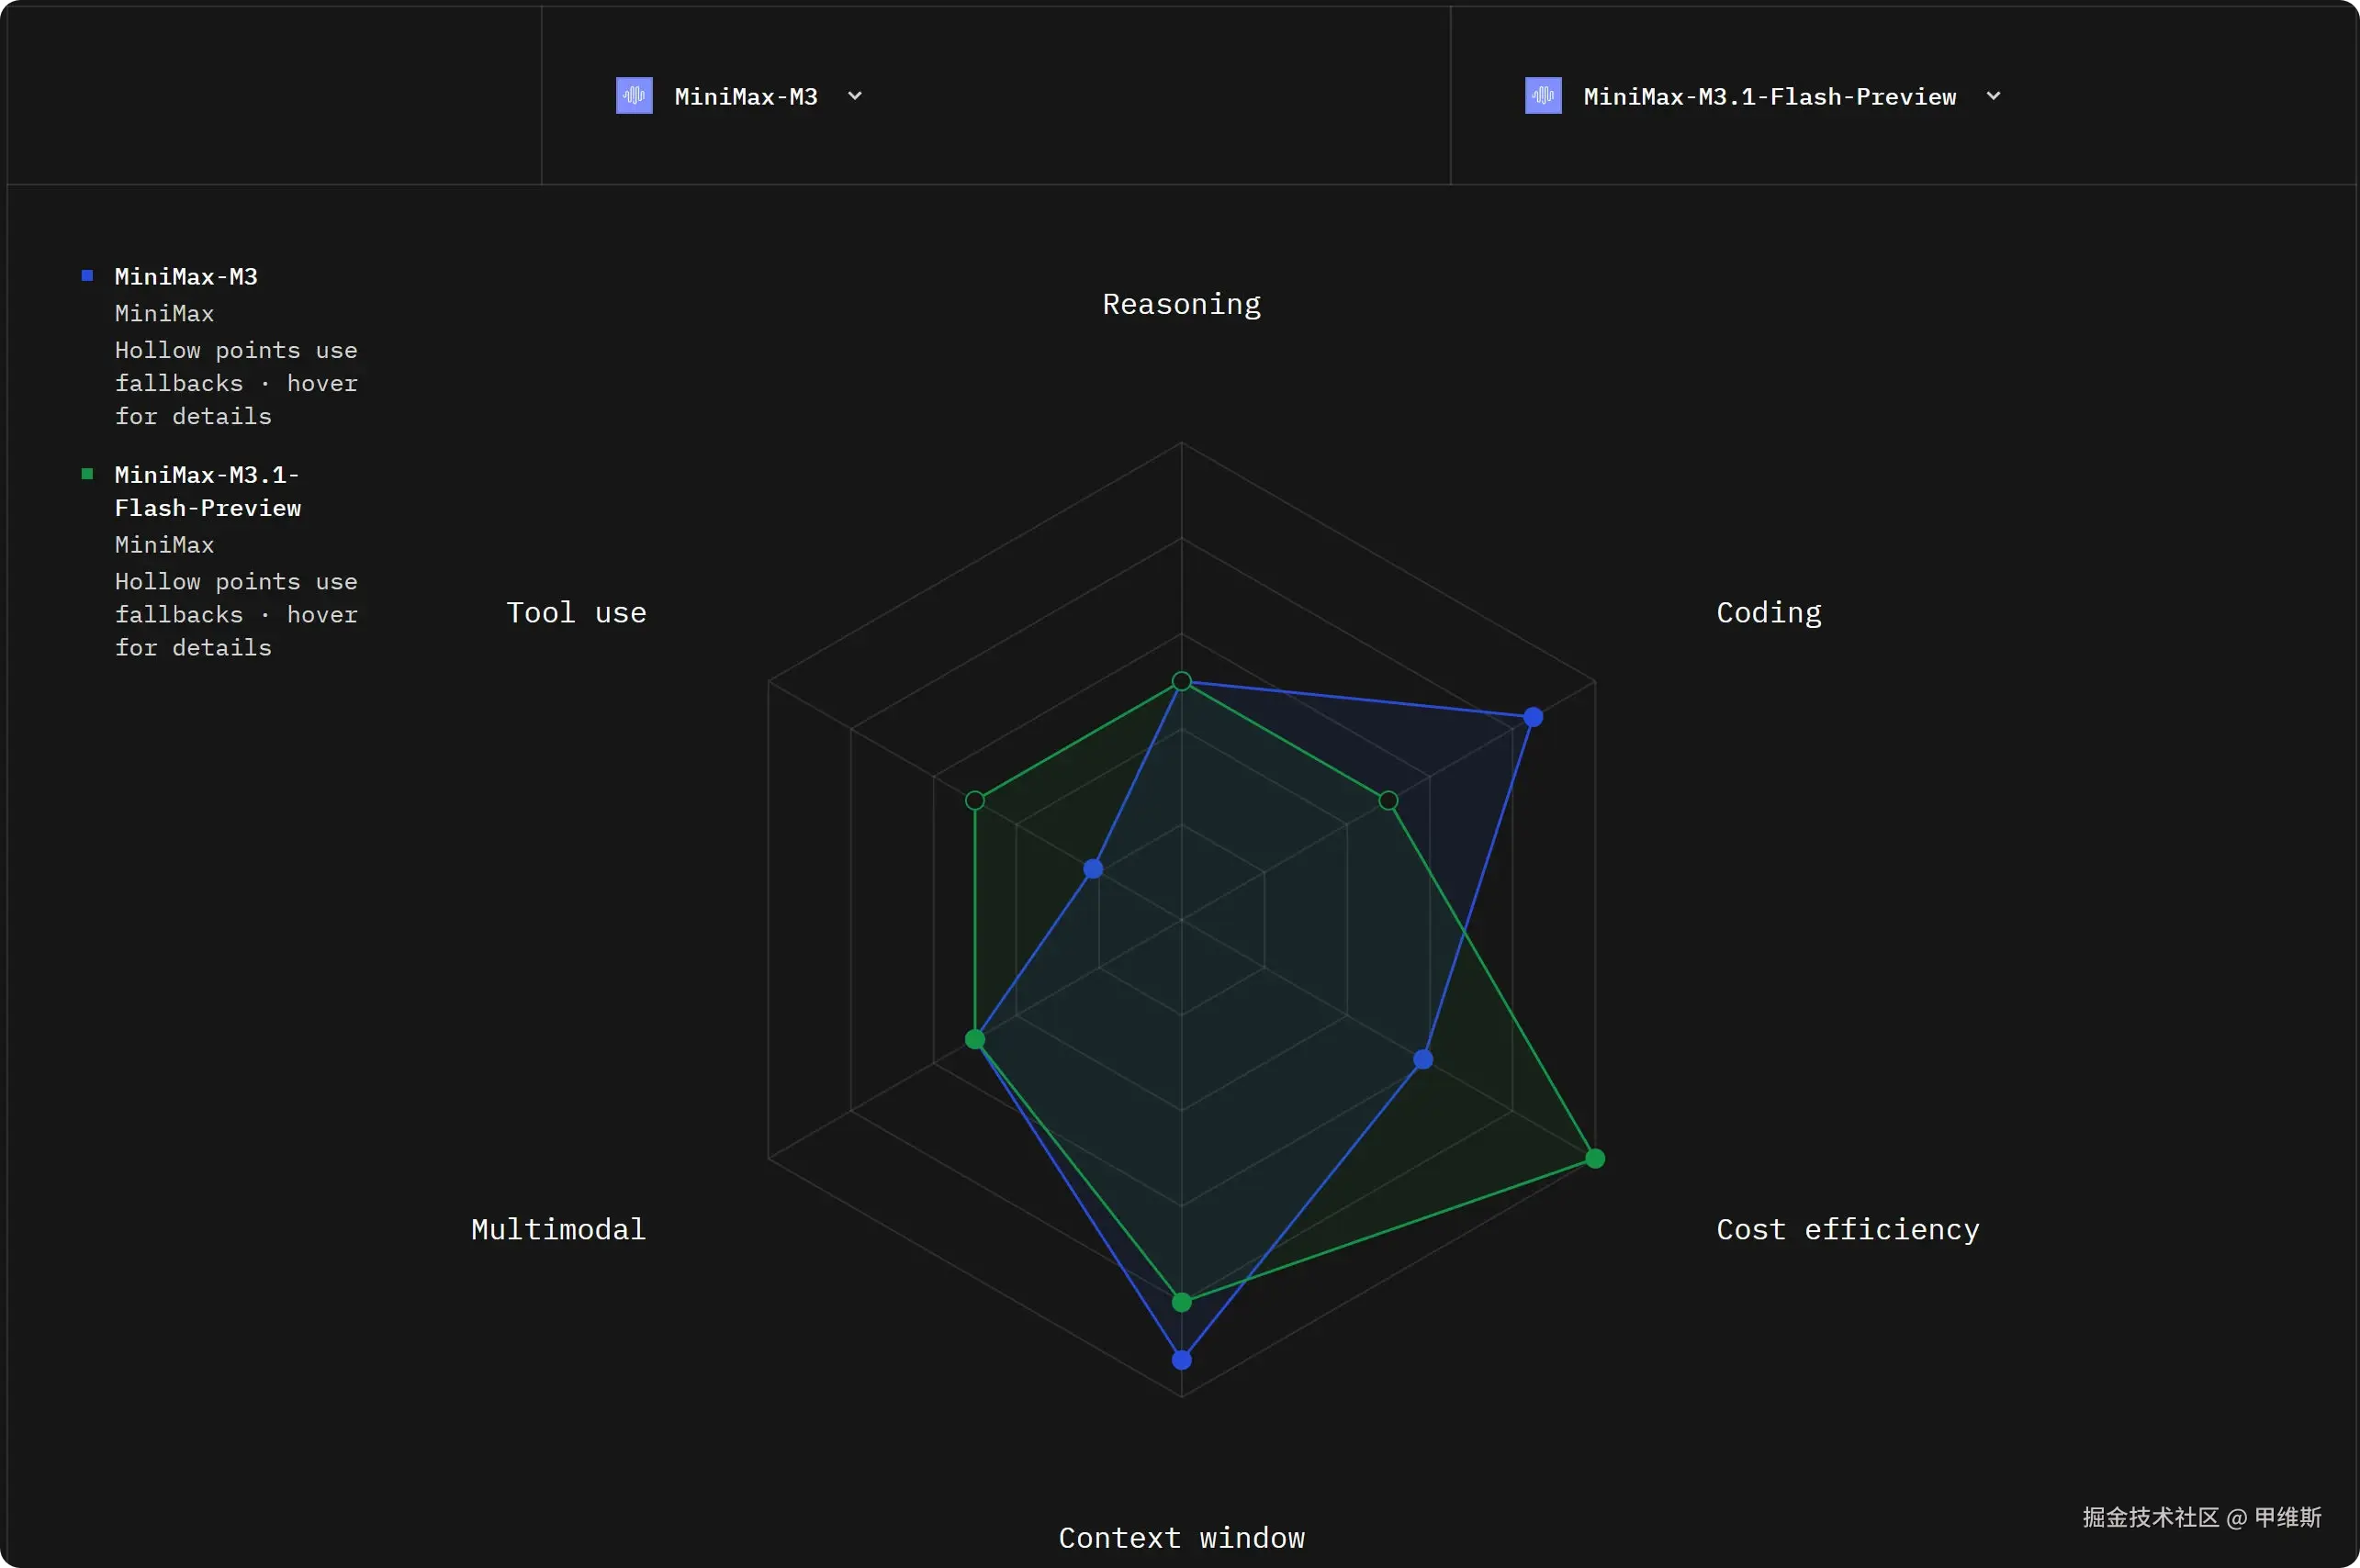
既然名字是 3.1,那么整体结构估计和 3.0 差不多。
从这个对比图来看,主要是 coding 方面变强了,然后成本变低了。
Space Bunny 这个模型基本上也没啥信息,大概可以知道 1M 上下文、多模态!
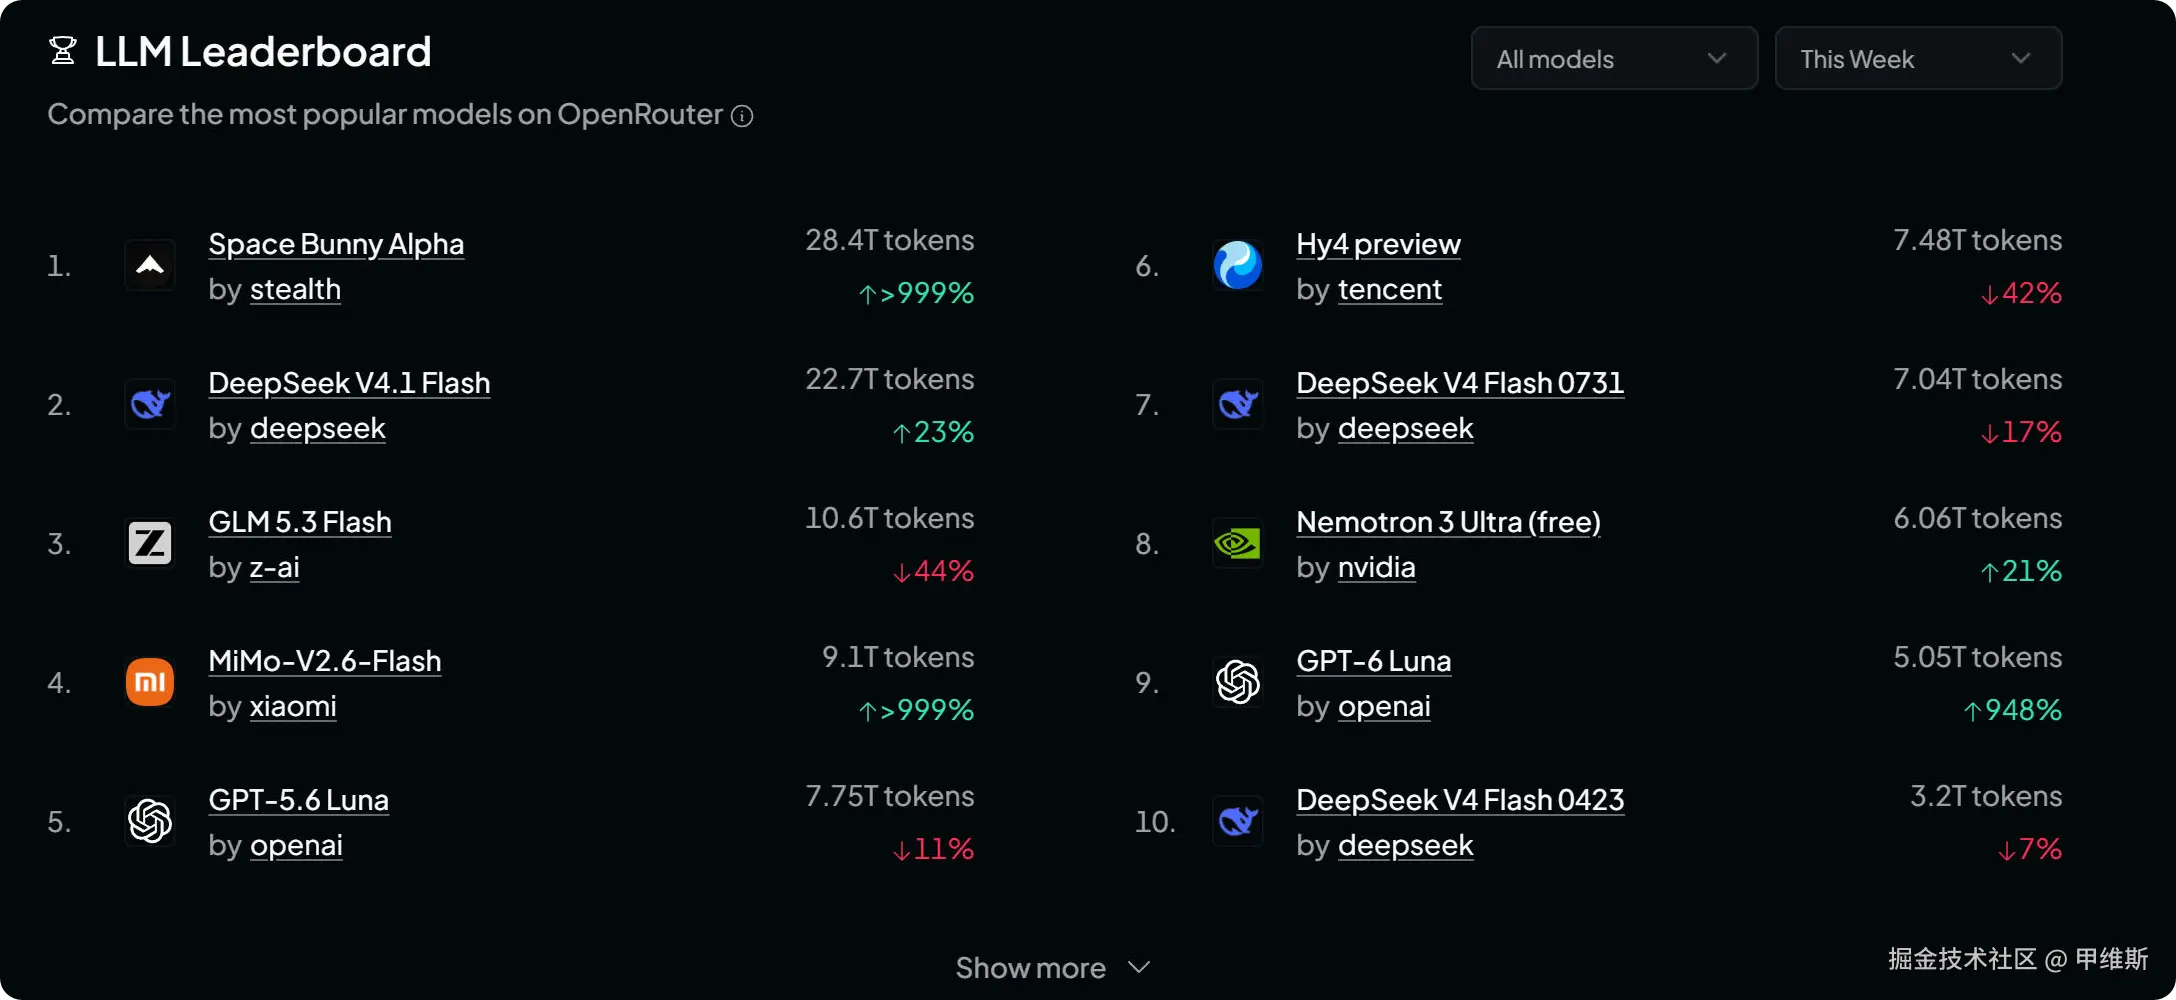
它在 OpenRouter 上的使用量刷到了 No.1(28.4T)
直接把一众 Flash 都压下去了!DS、GLM、MiMo、Luna 全部排它后面了。
当然,它能排第一的关键是:能白嫖!
能免费被刷这么多 T,感觉背后的公司也有点实力啊,主要是财力。
基础信息大概就是这些了。
下面来看看实测结果吧,这些例子的提示词和考点我就不单独强调了。如果感兴趣的,见文末网站,全部放在一起了。
这两个模型名字也挺长的,下面我就简称 Space Bunny 为 SB,MiniMax 为 MM。
赛博上河图!
MM 结果如下:
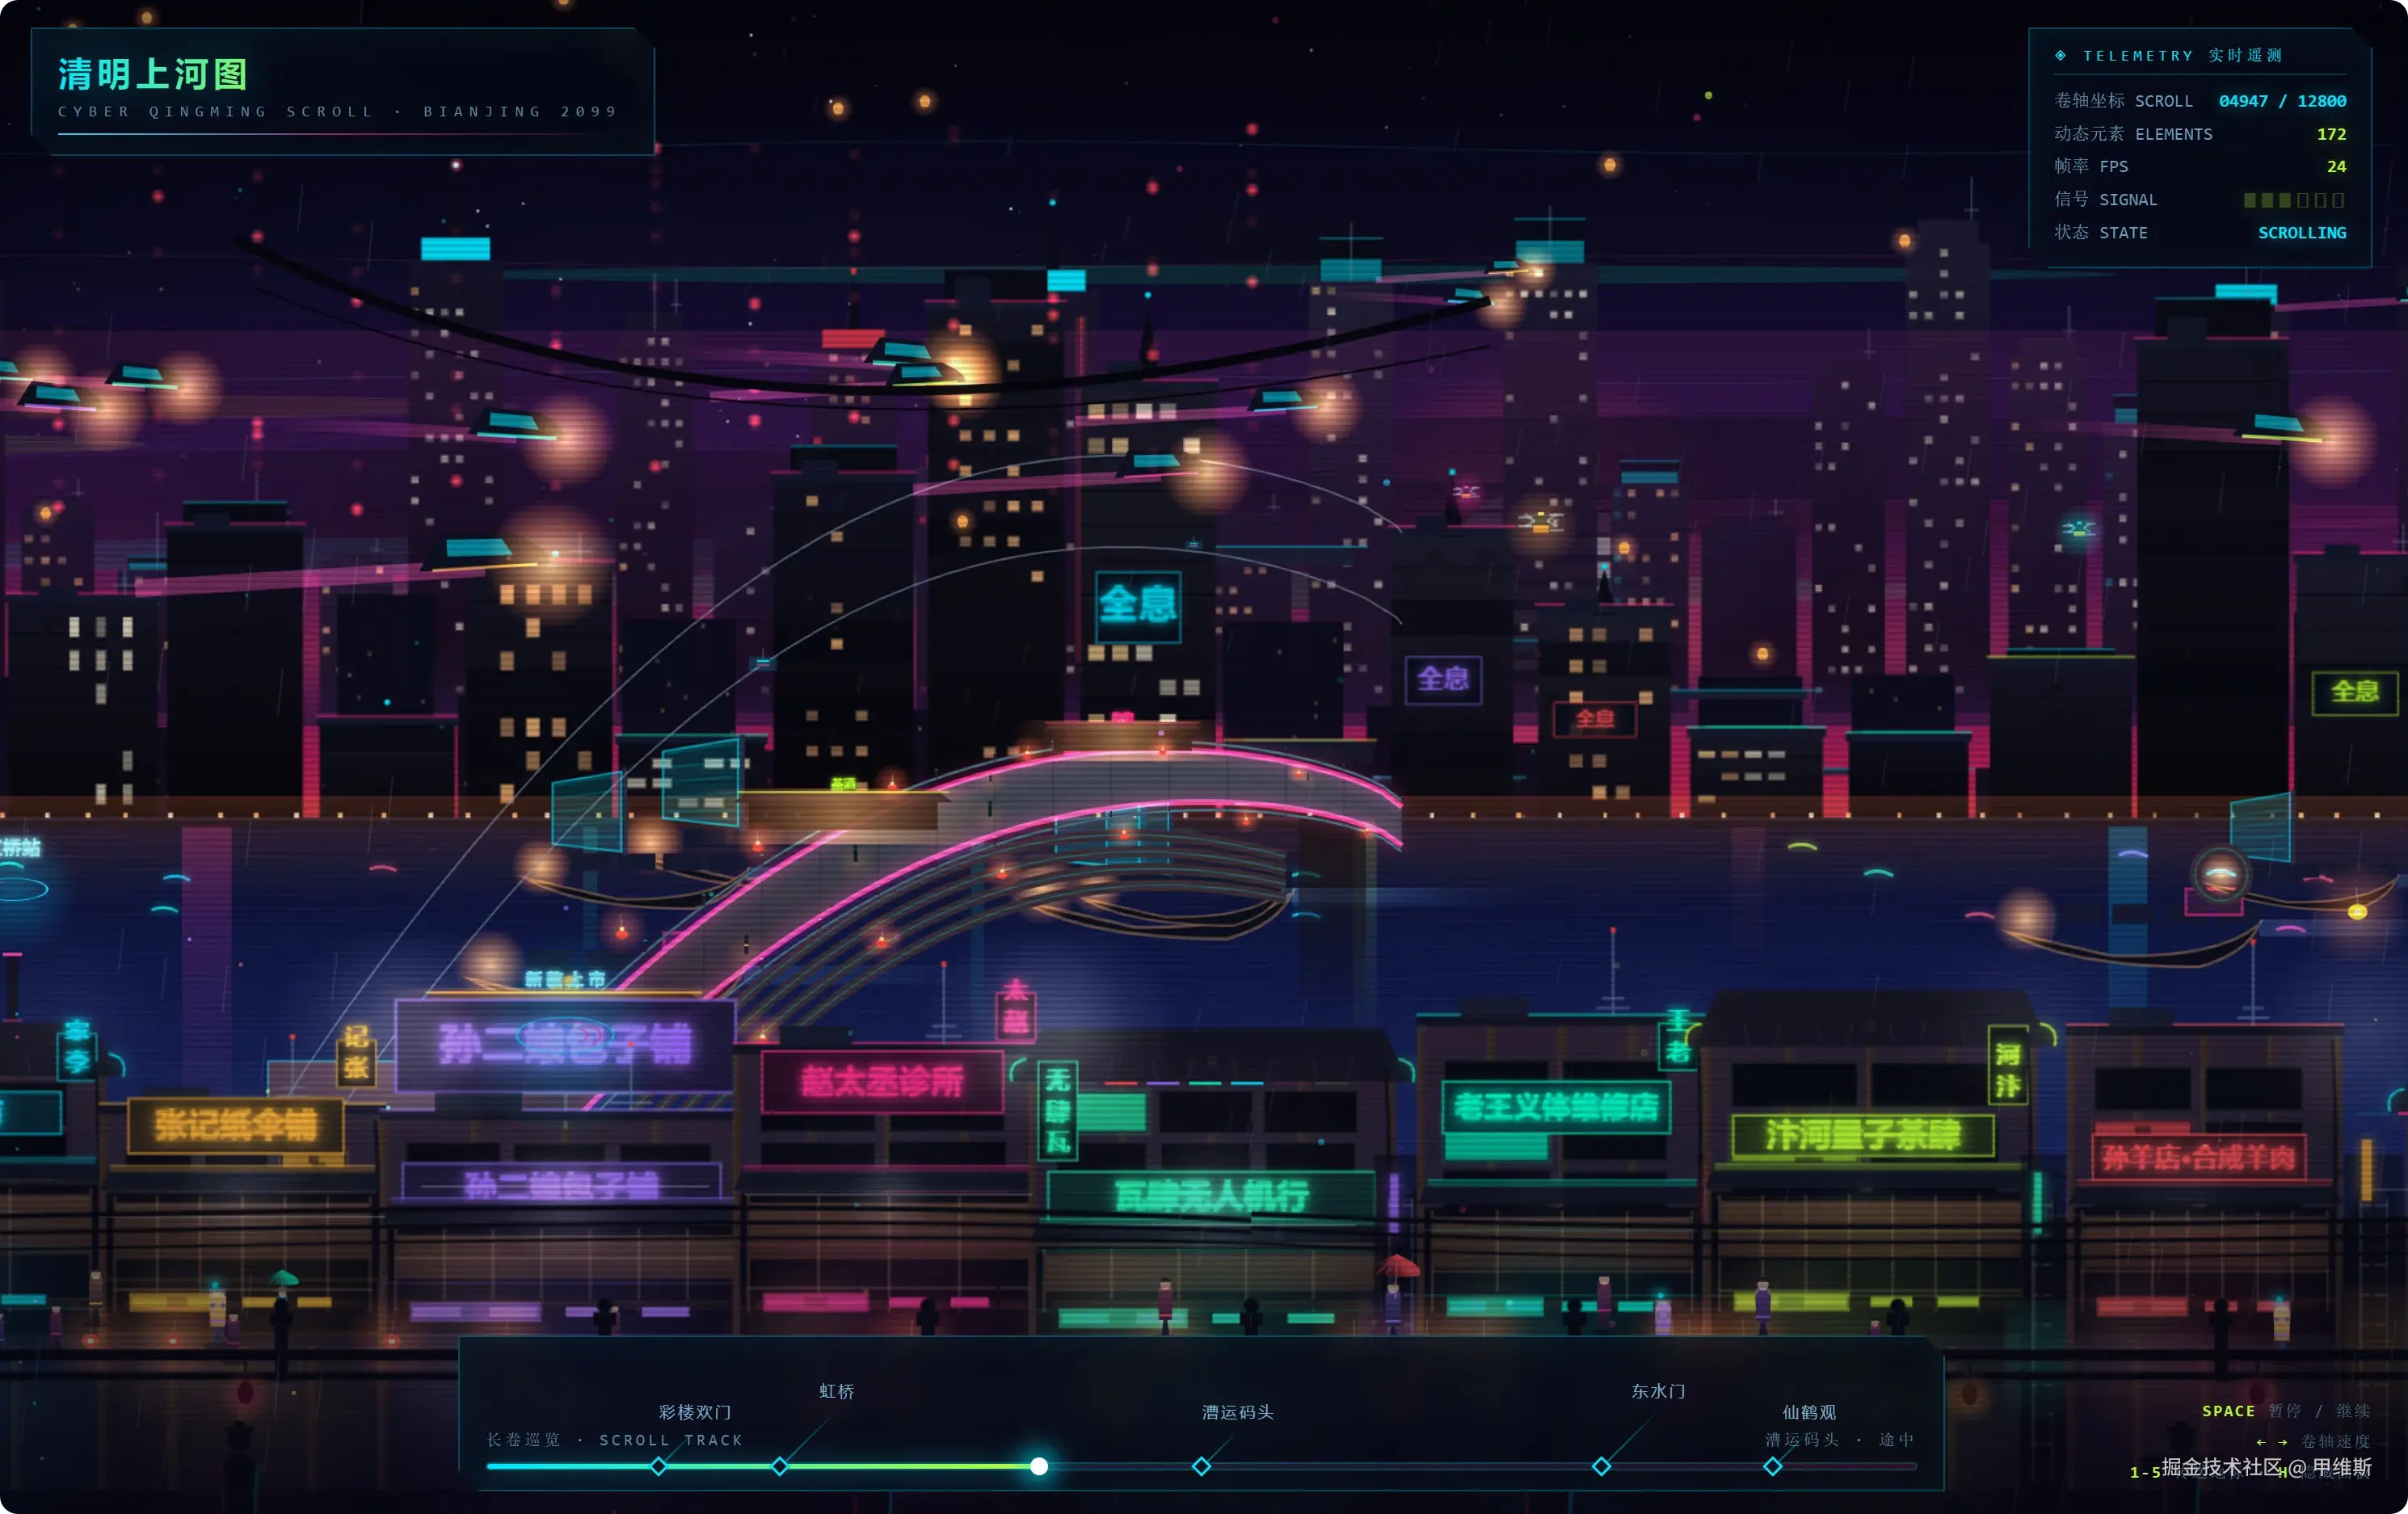
用时 56 分钟!
SB 结果如下:
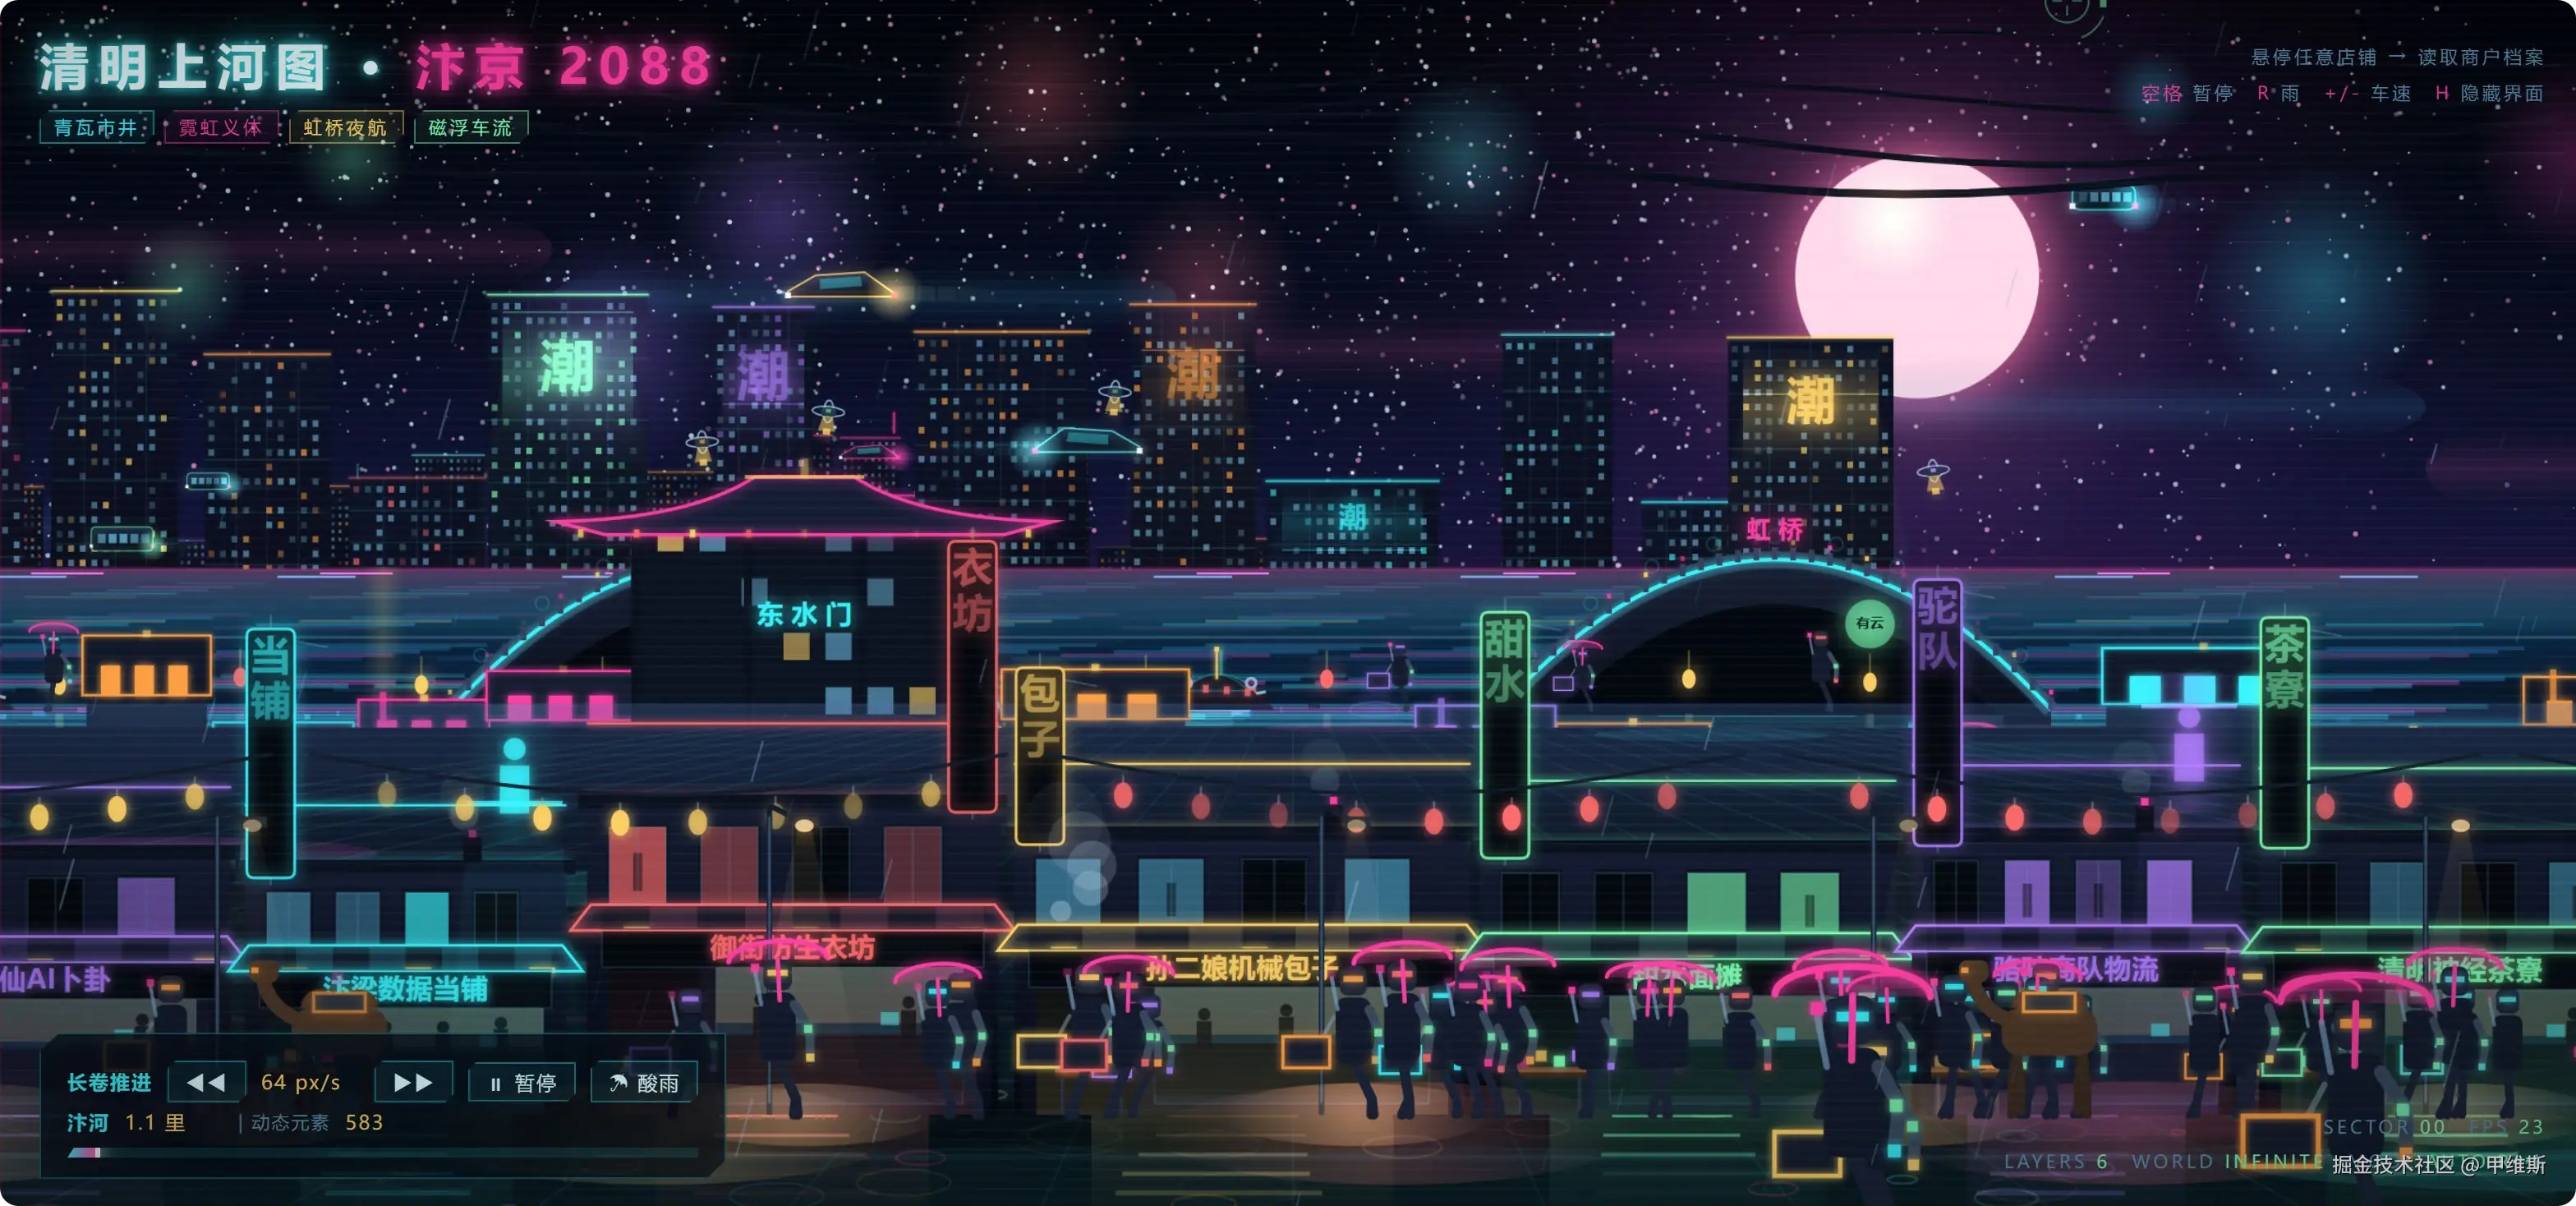
用时 44 分钟!
哟,这个结果好像还行,没有很差!
都在努力表达空间感了。
MM 细节不是很好,SB 的更精致一些,细节更好一些! 但是 SB 也有一个问题,就是桥的位置关系不对!
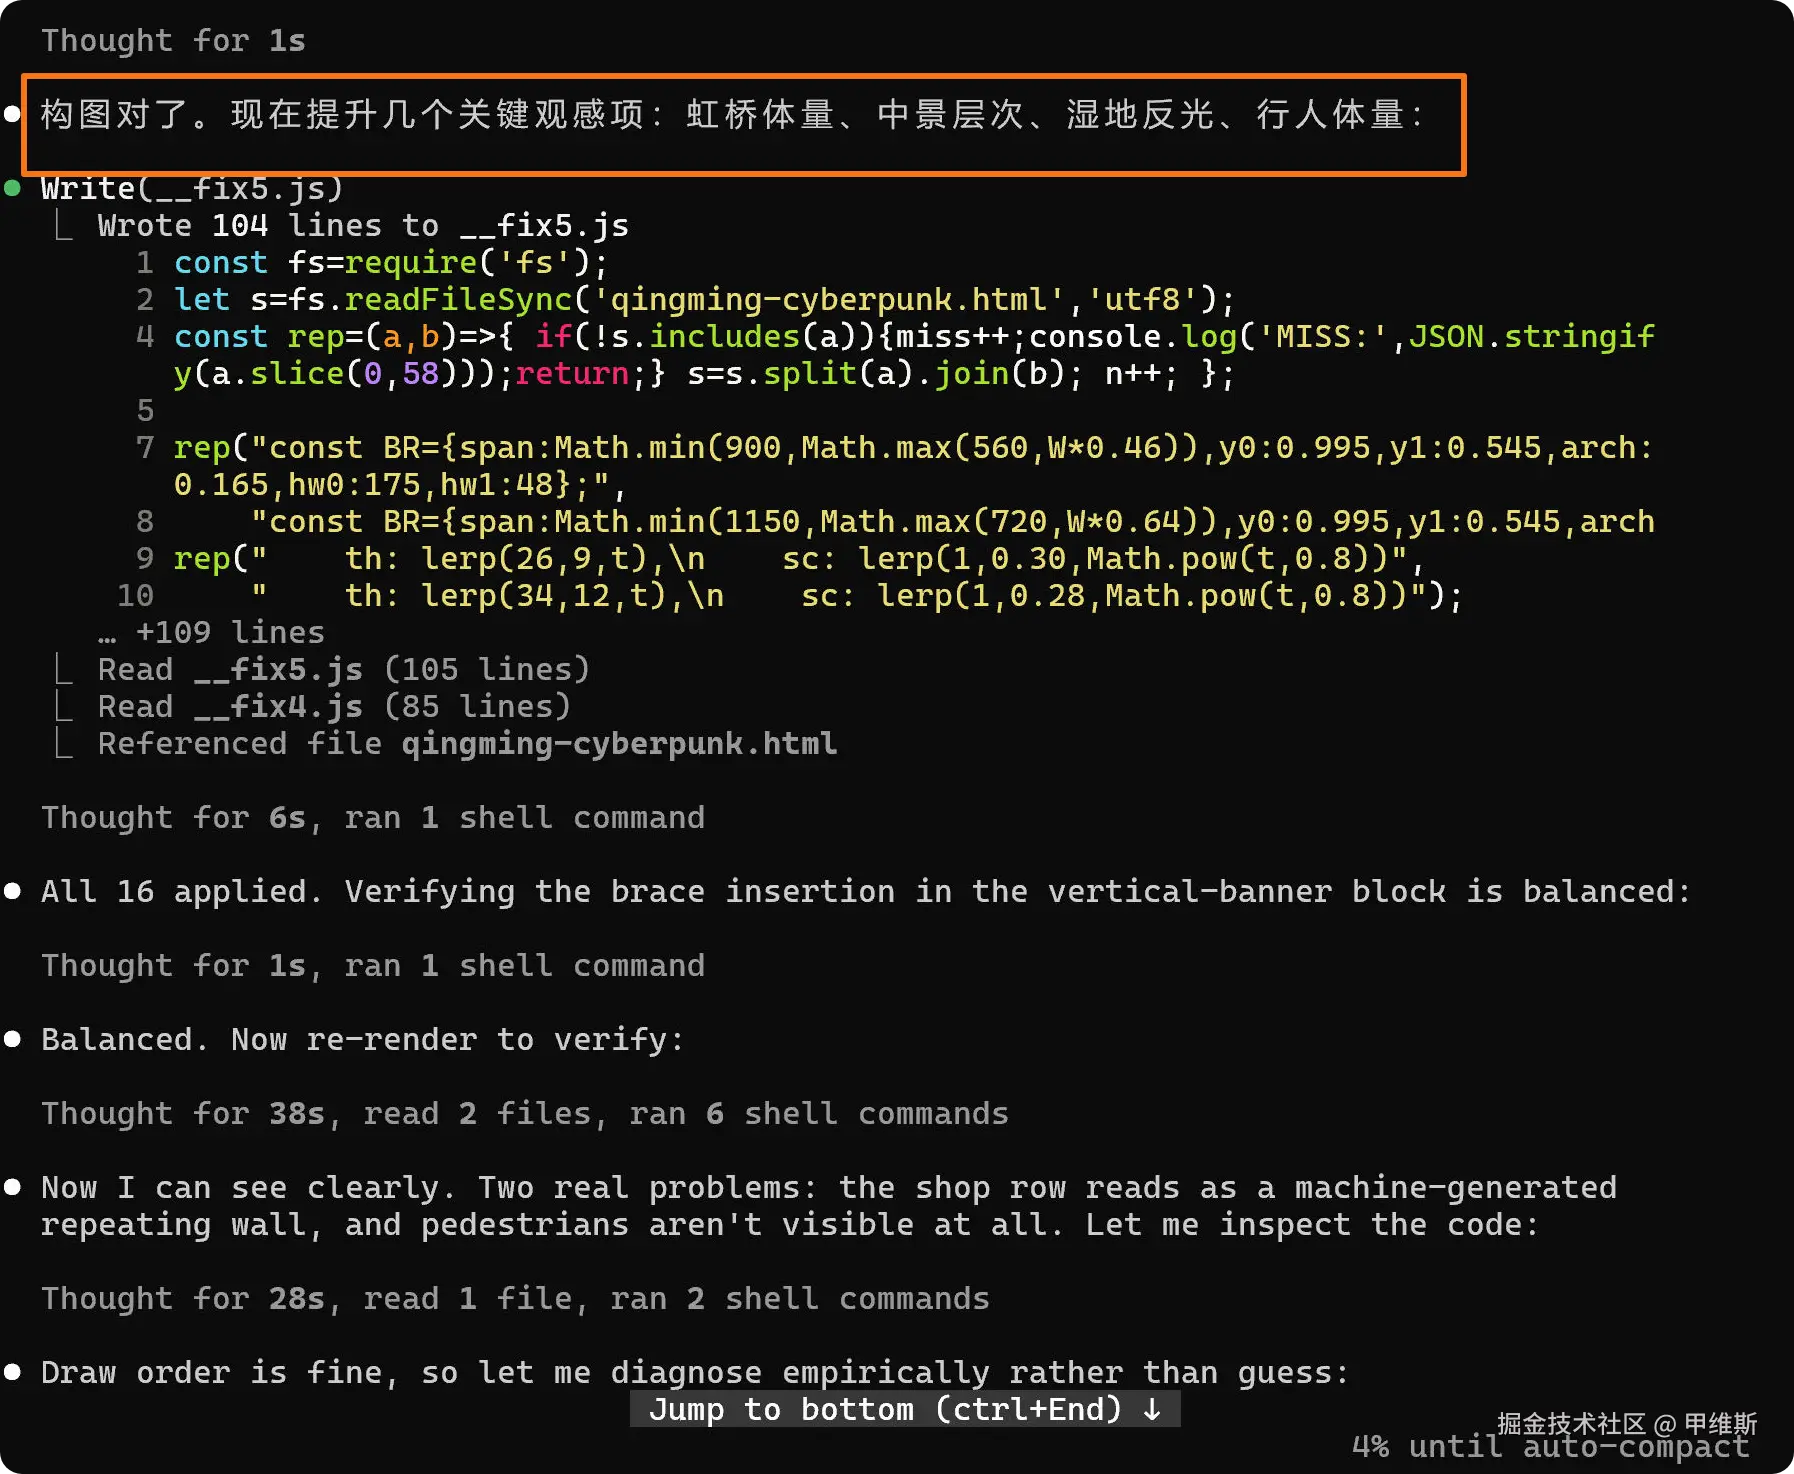
然后我们稍微看一下过程!
这两位选手,居然都用了大量的时间来完成这个例子。看来是能意识到问题的复杂性了。
MM 的过程:
SB 的过程:
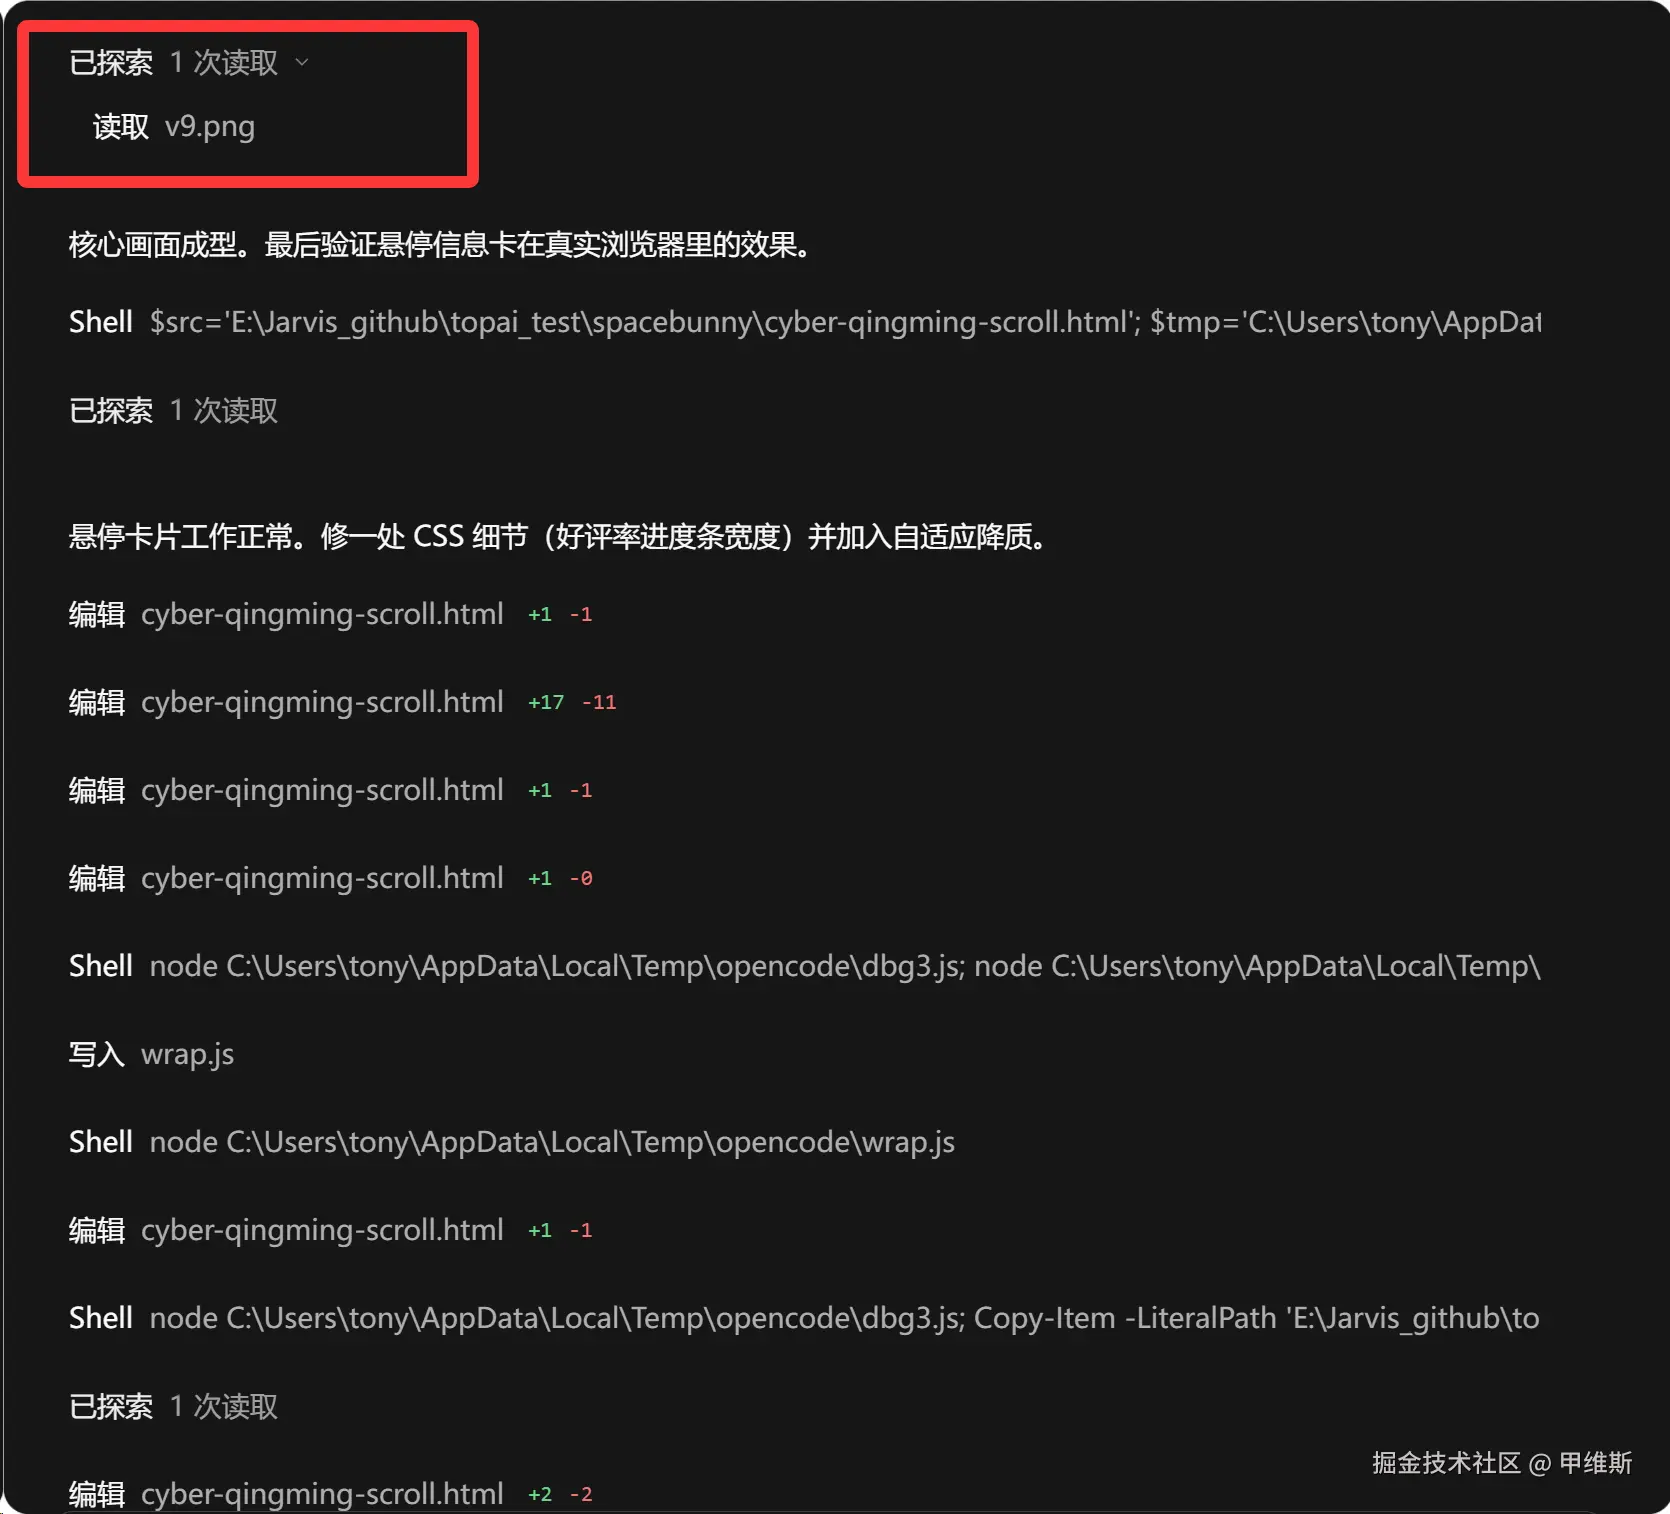
它们都做了很多轮修改。先从代码改起,然后校验,然后截图查看,继续修复。 智力和审美先不说,流程基本上对了,是当前比较主流的处理流程。
其中 MM 由于不太聪明,浪费大量时间:
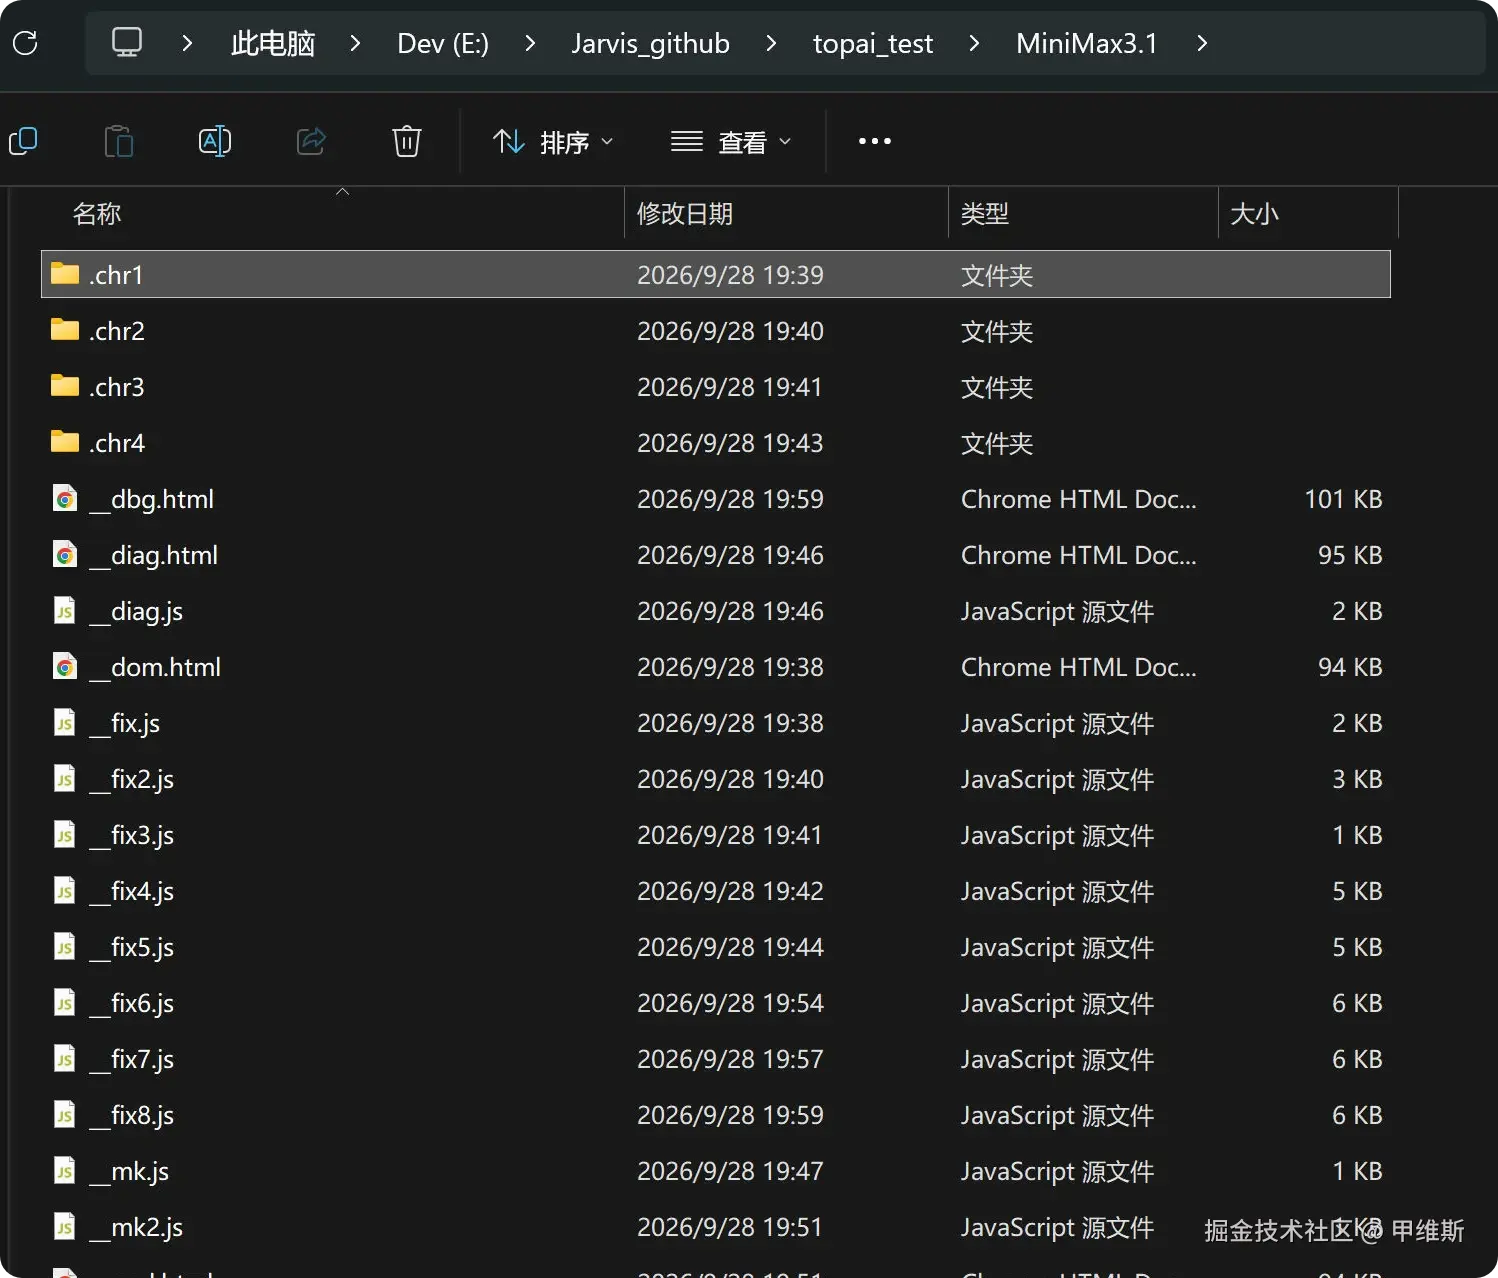
我发现它的执行过程出现了大量的缓存文件,而且拷贝了 4 份 Chrome,这就是不聪明的表现。 之前在 DSH 上测试 DS 的时候,我也发现过一次,然后也是搞了很久很久。
它搞这个的目的是想要截图和验证,但是要截图和验证并不需要这么麻烦,一行命令就可以了。 用它这种方式,浪费 token 浪费时间。
它比较好的一点是,搞完之后知道给我清理咯。
这一轮 SB 无论是在时间还是效果上都是略胜一筹!
天文机械表
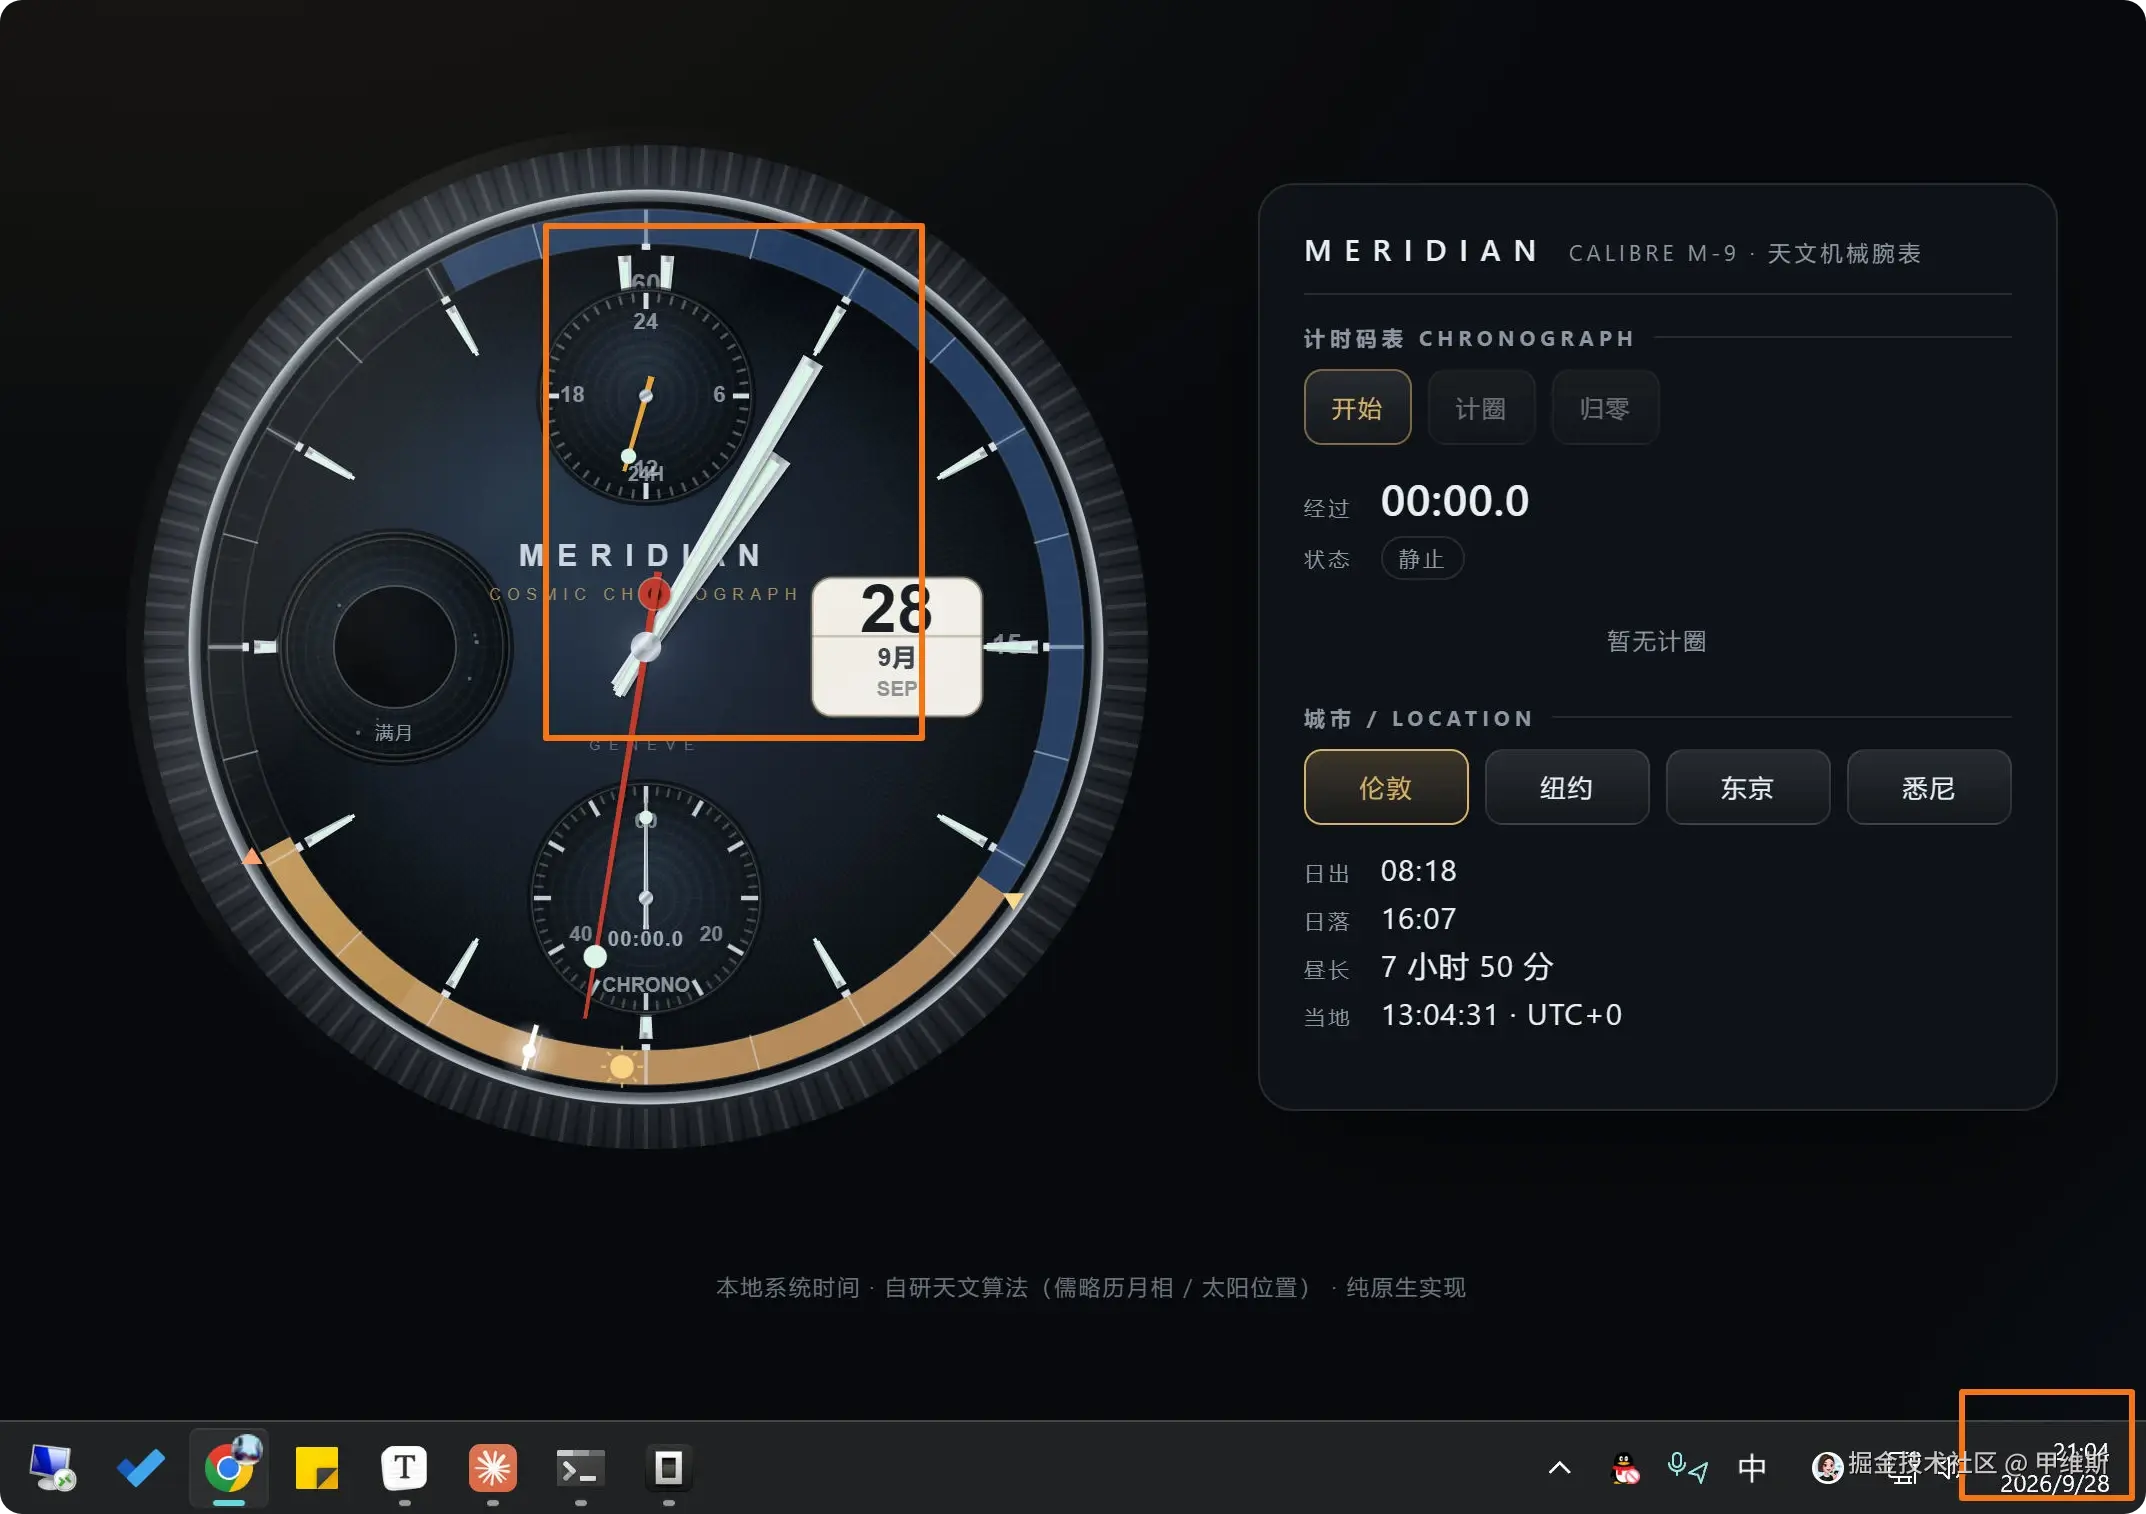
MM 的结果:
SB 的结果:
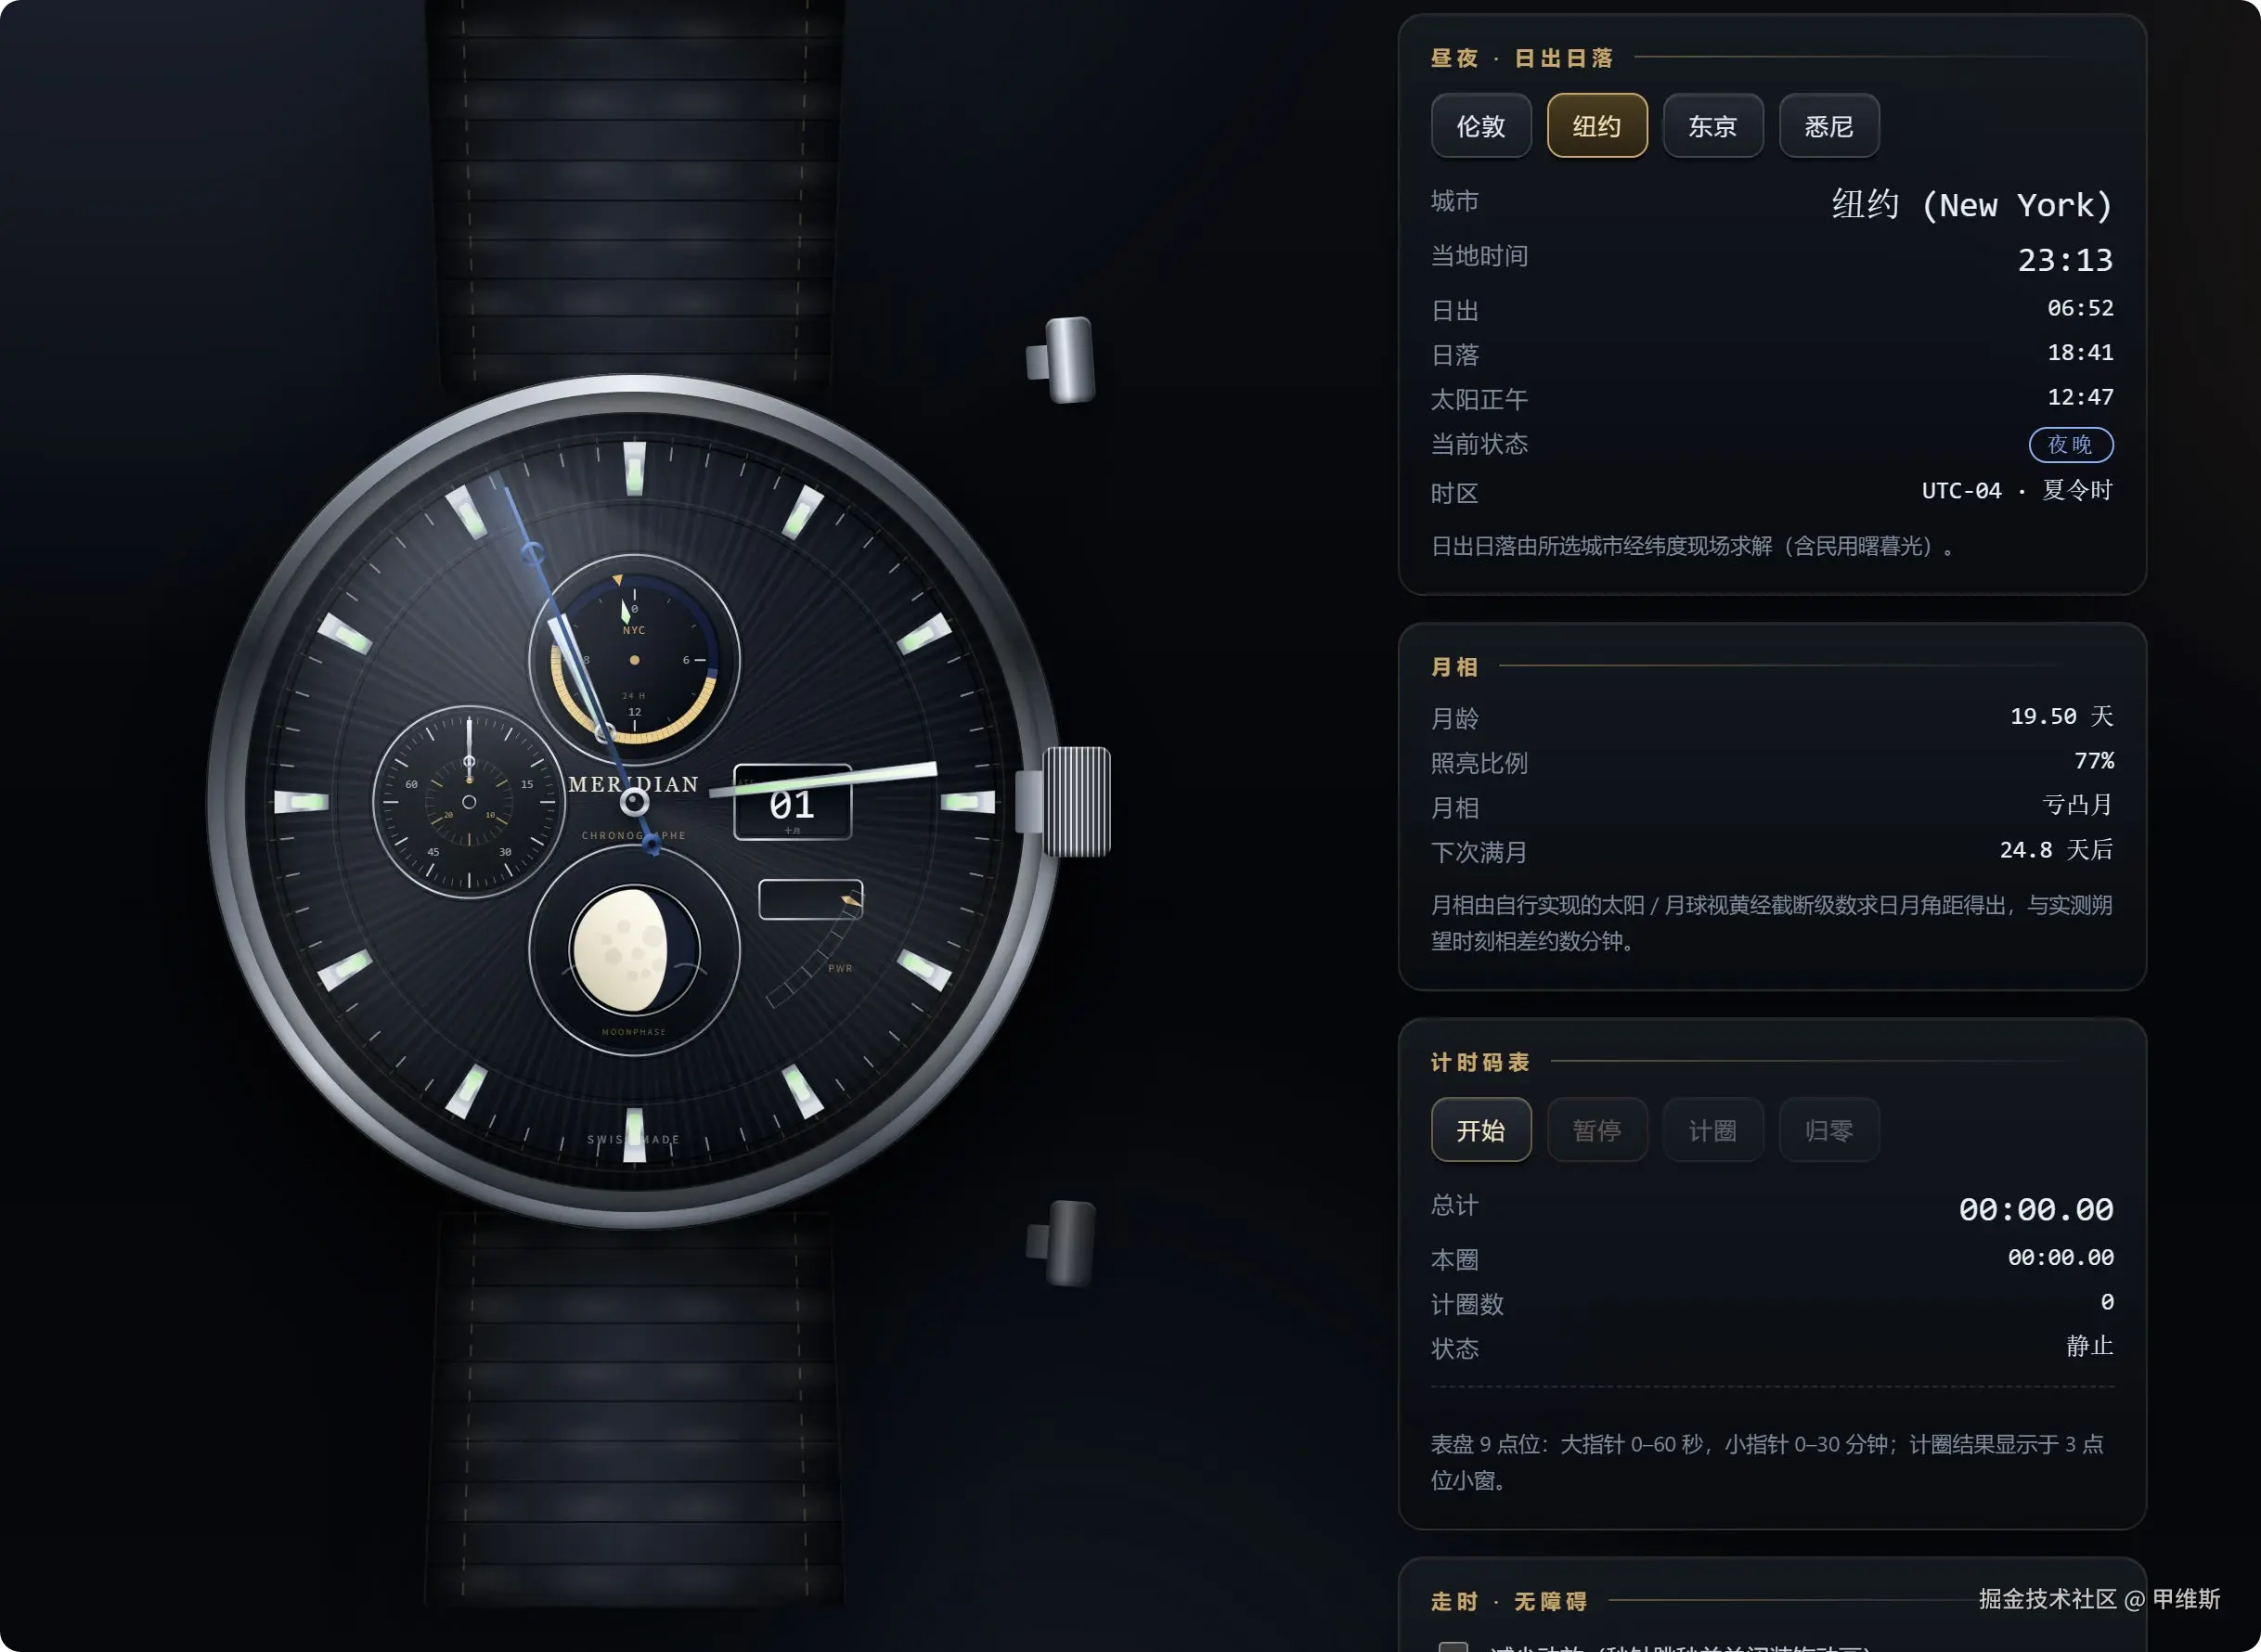
这个结果就非常典型了,非常符合这个题目的设计意图。 两个模型都没有很好地完成所有需求,或多或少都有些问题。
MM 的问题,基础的时间就不对,月相也不对,28 号的时候显示满月,现在 10 月 1 日了也显示满月...... 除了这两个核心功能有问题之外,其他问题不大啊!
SB 的问题主要是显示的问题,两个表盘按钮都飞起来了,指针也有些问题!
除此之外时间和月相是对的,然后它 3 个按钮全是有功能的,这个好评。
这一轮从功能上讲 SB 要比 MM 好不少,但是 SB 的表盘样式有些问题!
游戏复刻
游戏复刻环节,主要是复刻经典老游戏,坦克大战和超级玛丽!
MM 的超级玛丽:
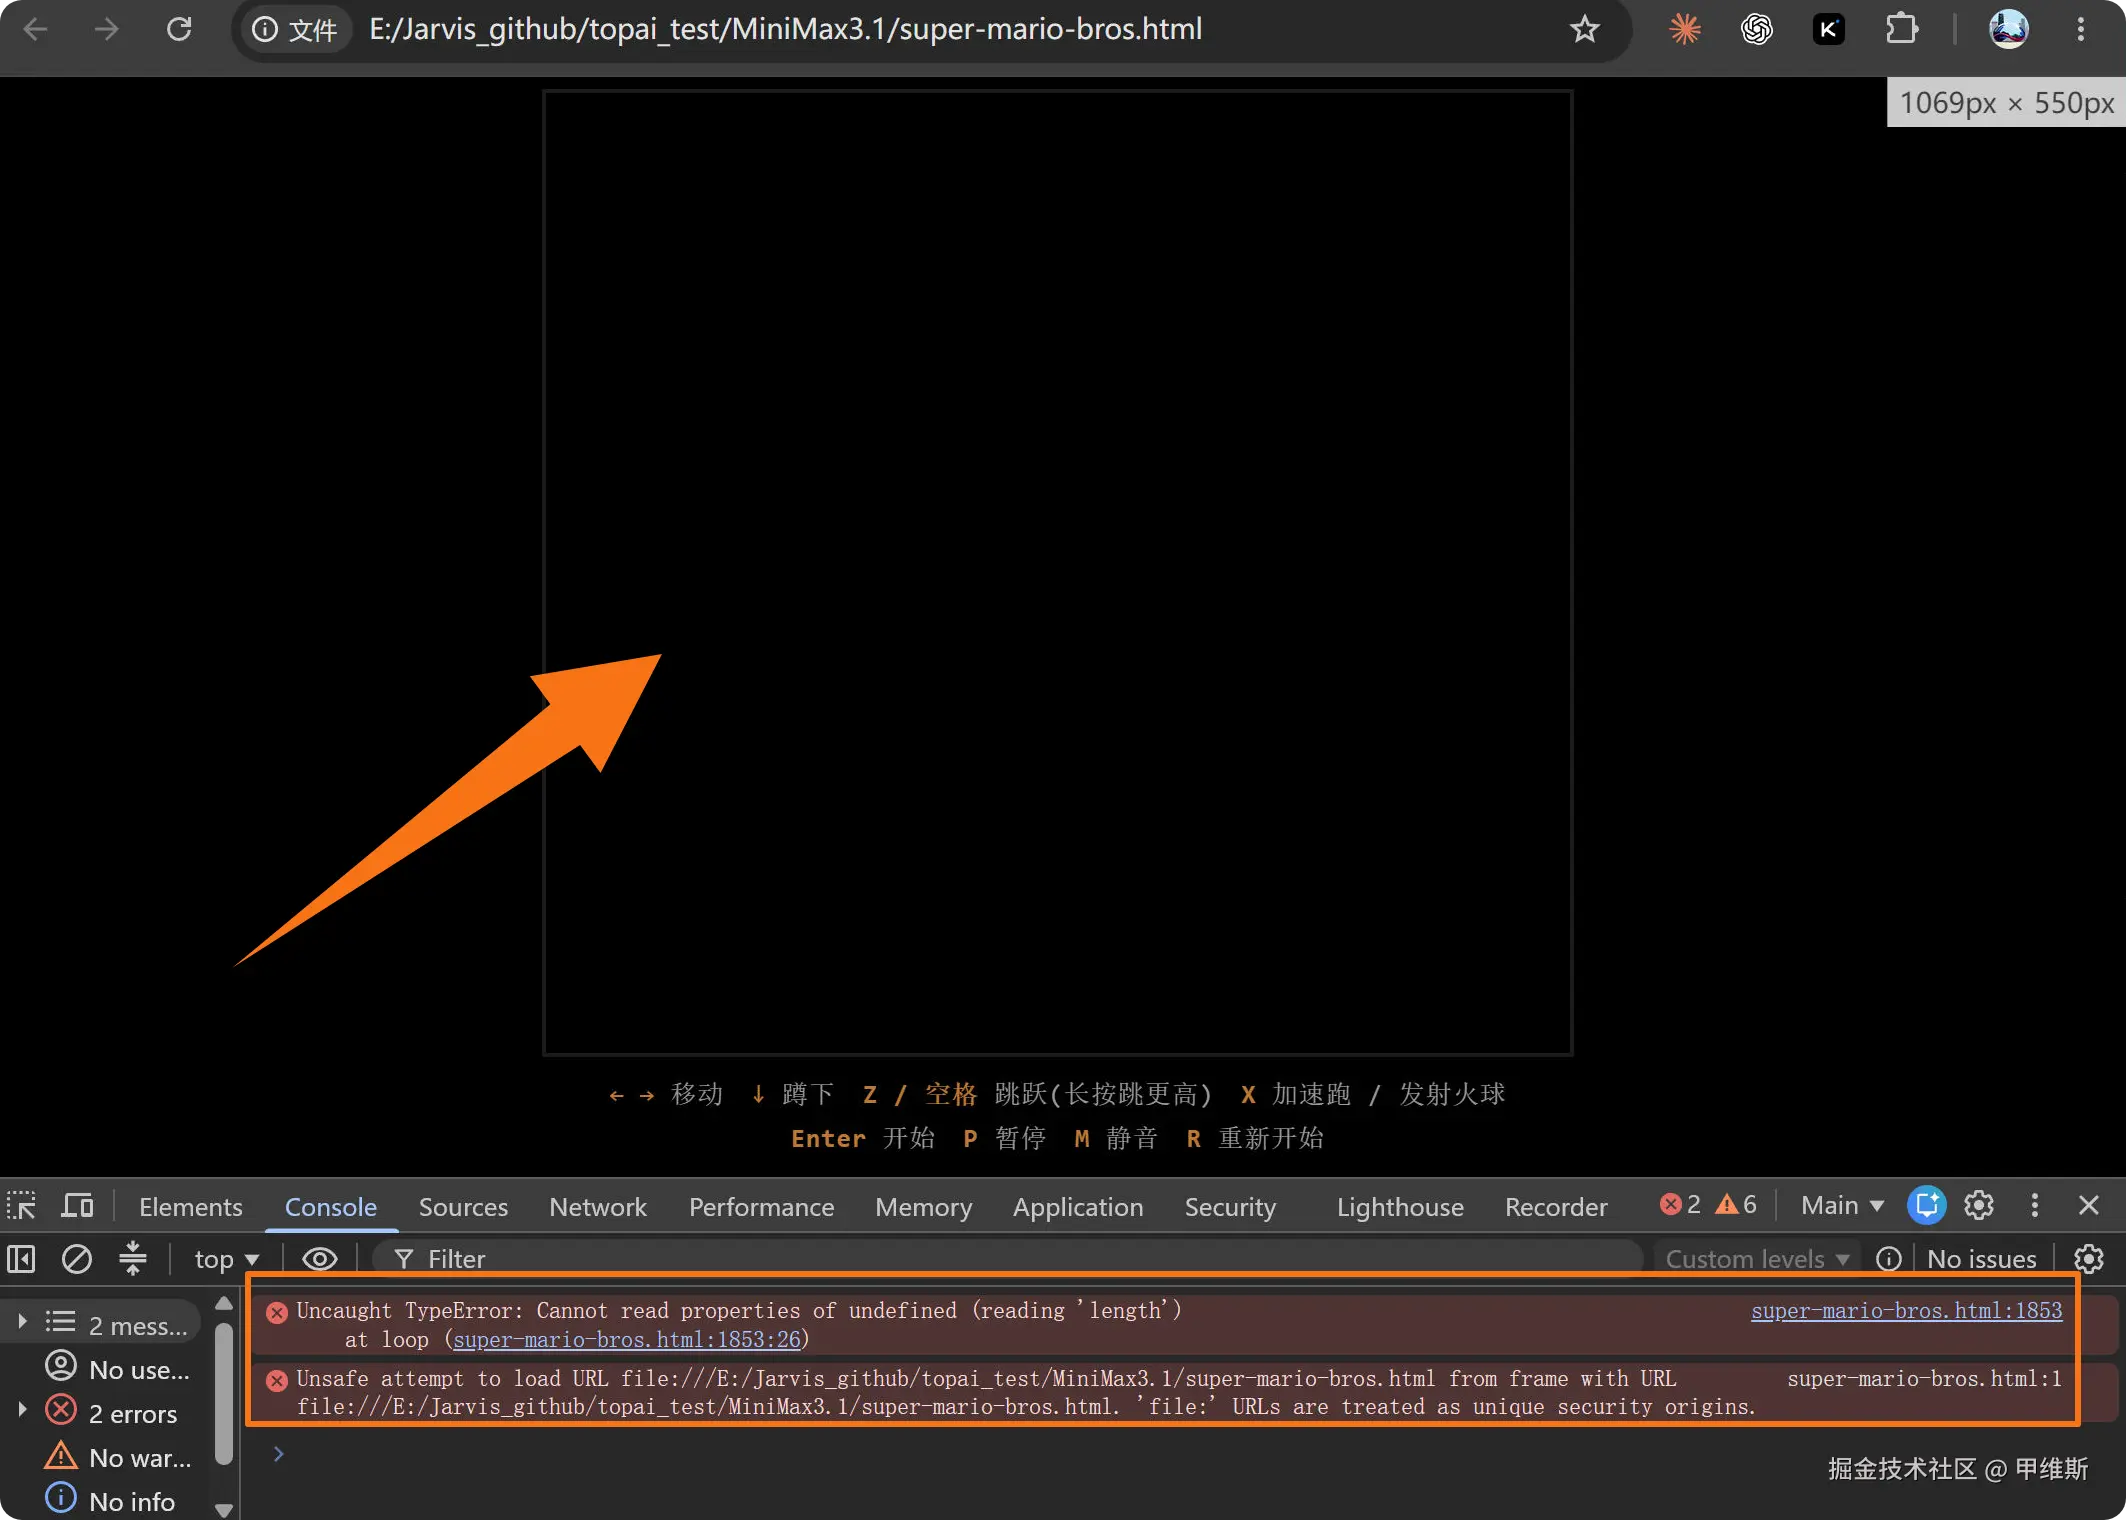
用了 37 分钟!
SB 的超级玛丽:
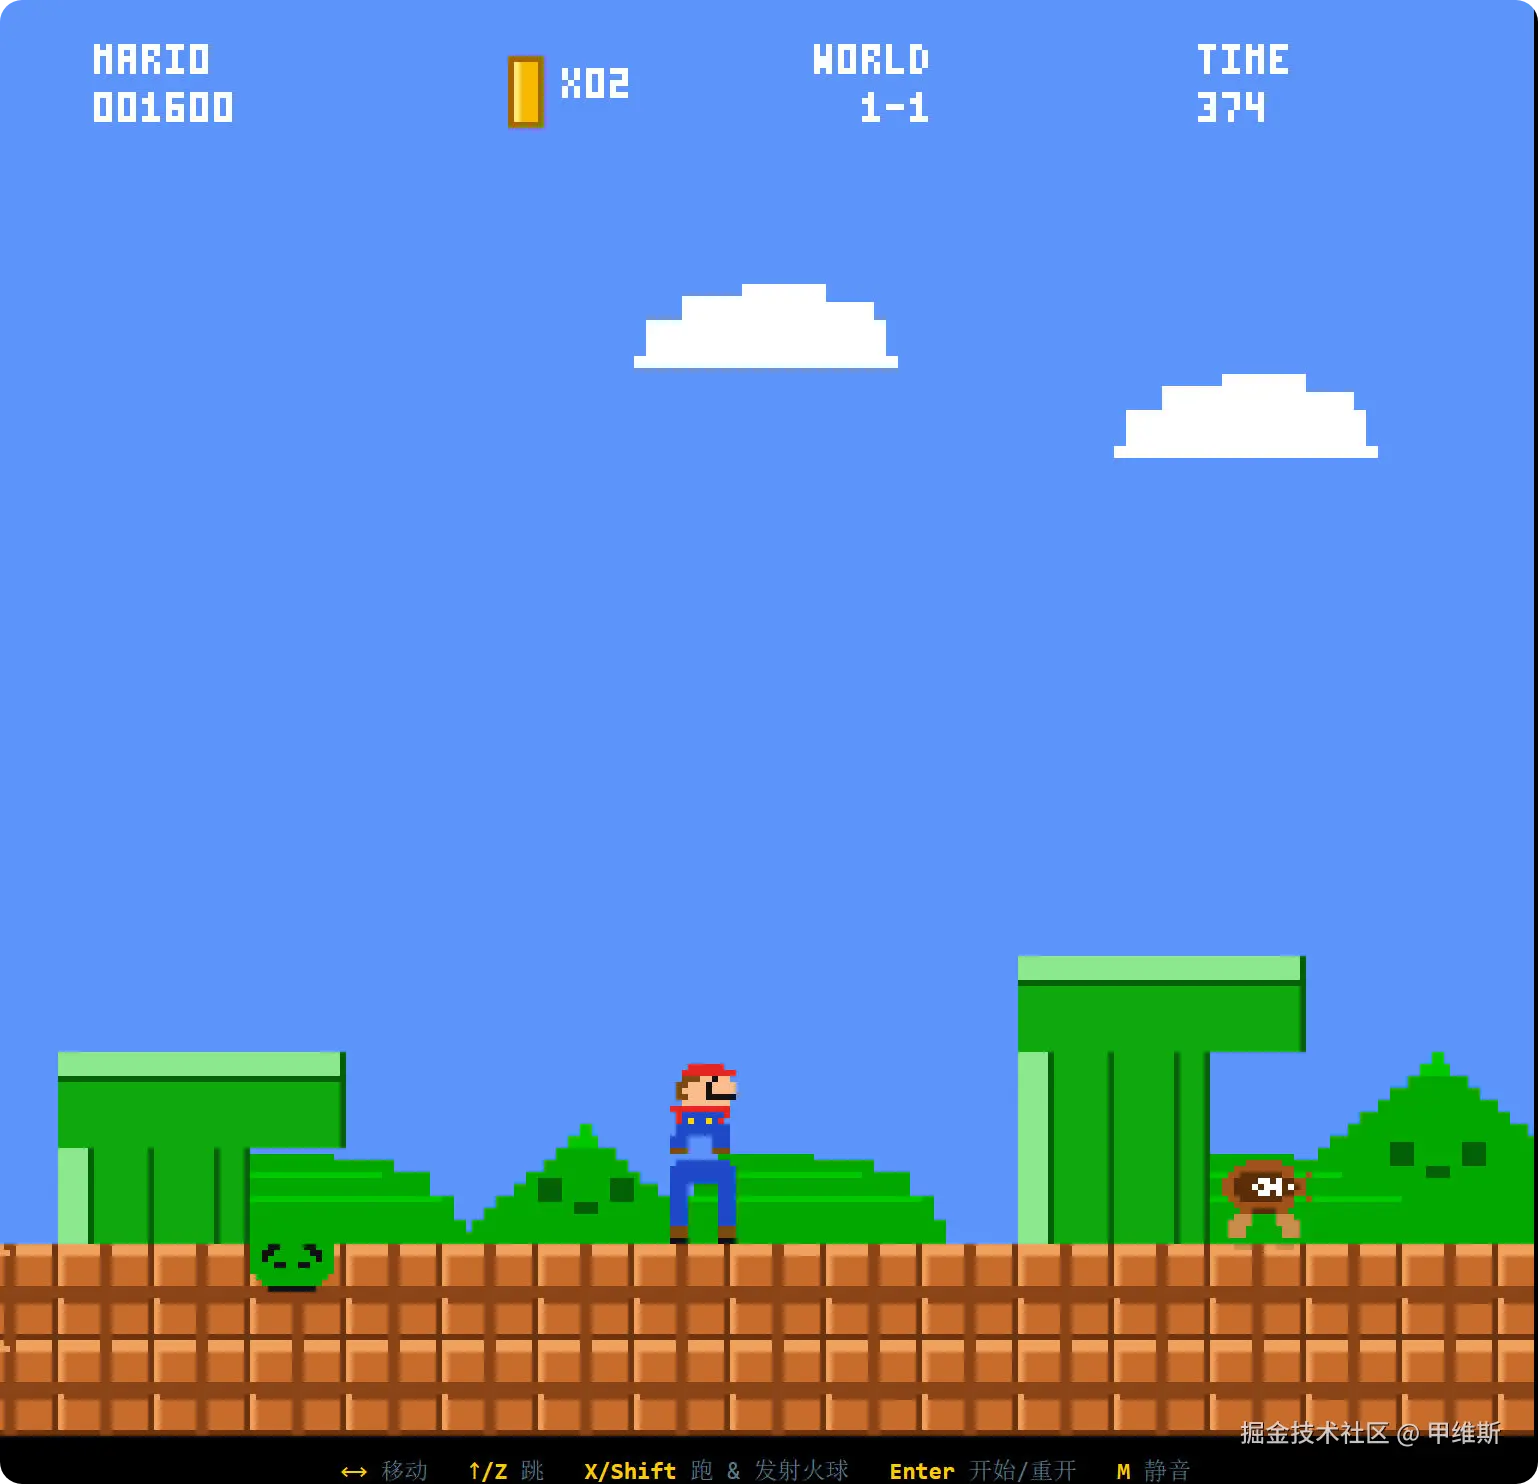
用了 30 分钟!
两位选手都是"抽象派"!
MM 开始的时候信誓旦旦说,它非常熟悉这个游戏。
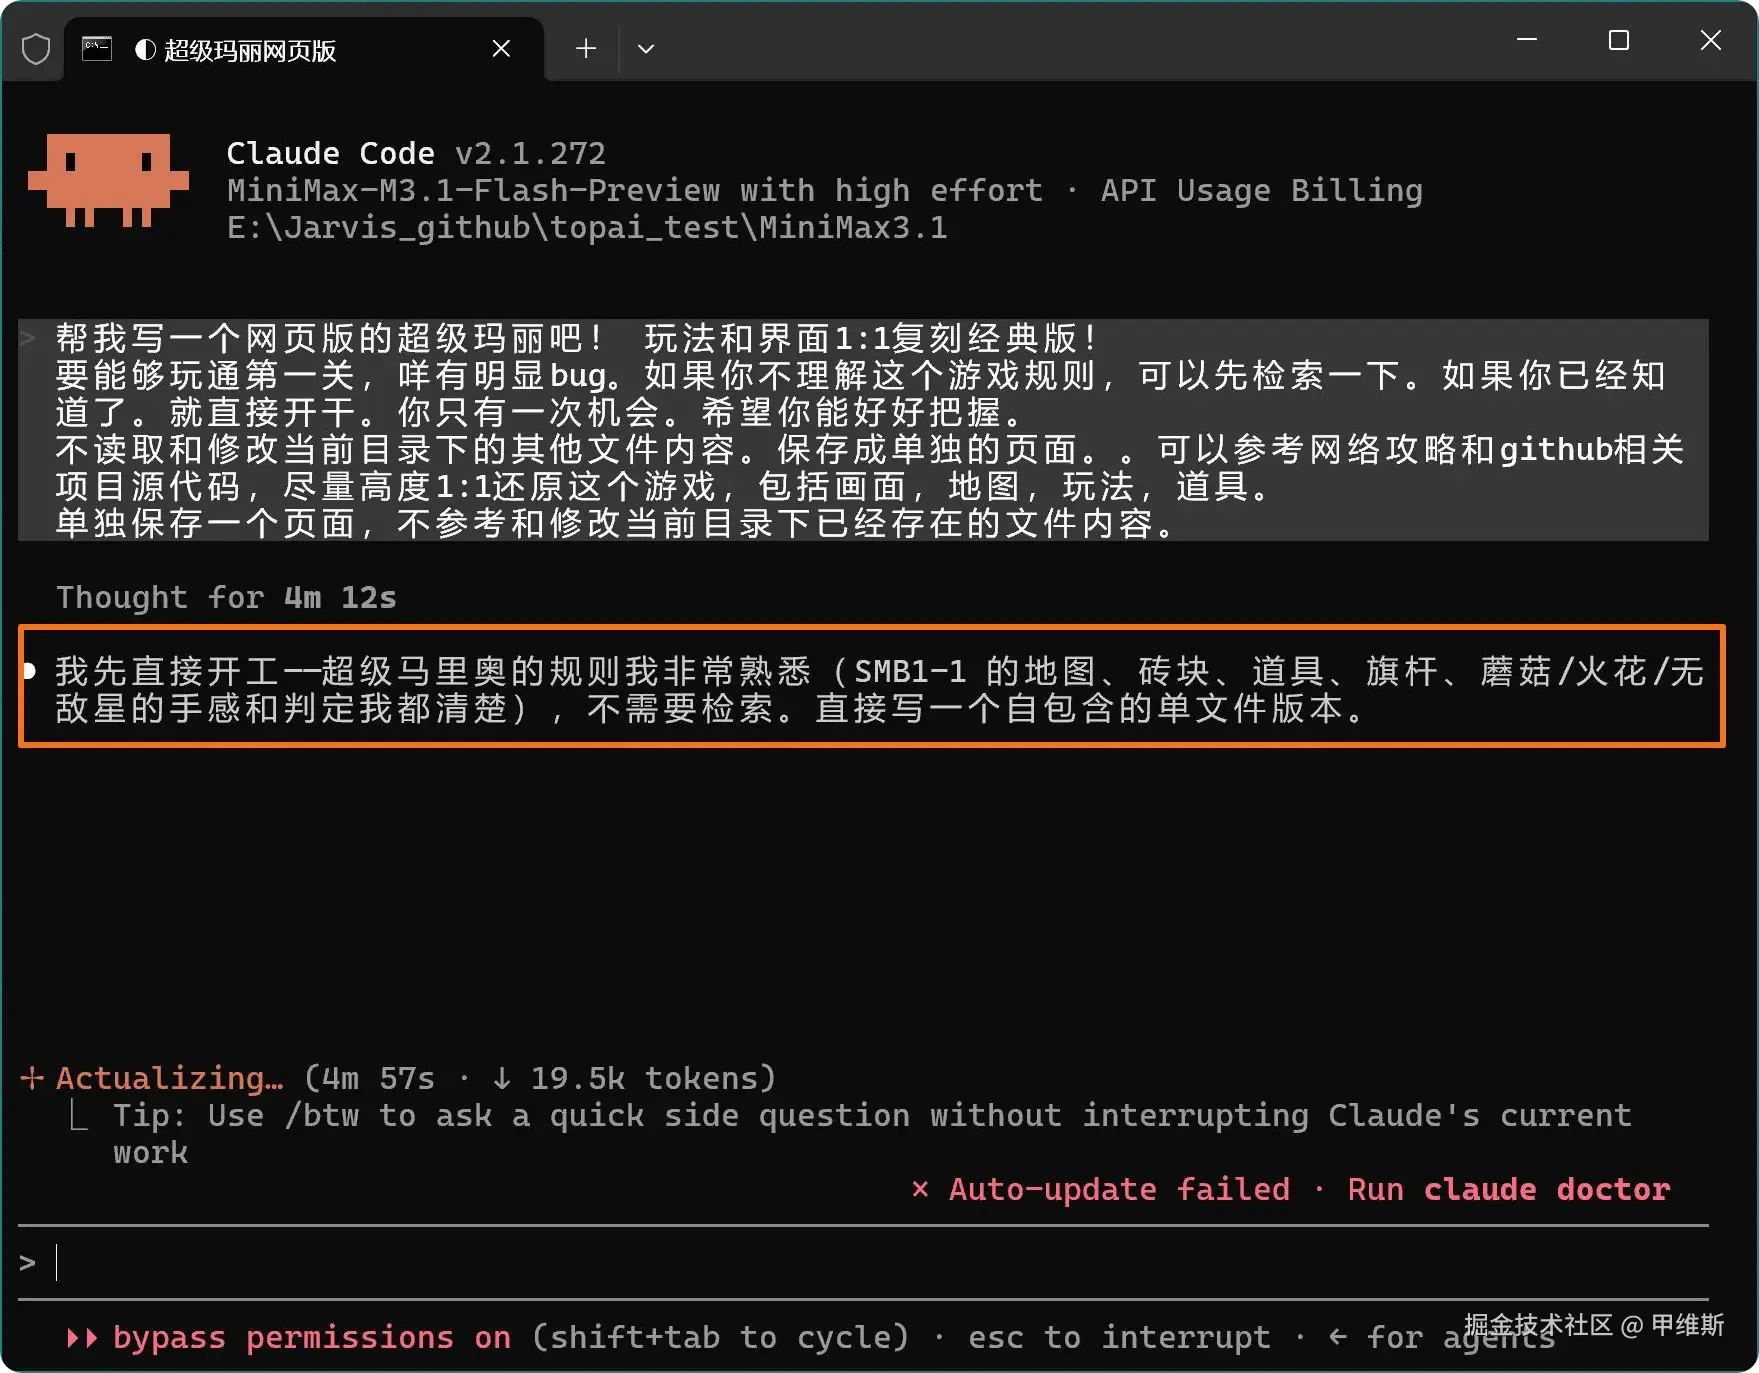
听它这么一说,我感觉十拿九稳了。
然后花了 37 分钟,给我一个空白页,还有比这更抽象的么?
从页面的控制台可以看到,它就是出现基础语法错误了,然后搞了那么久也没有验证和修复!
SB 是能玩通关的,但是它角色、场景、地图、玩法的还原度都很低!
哎~~ 人家 GPT-6 Sol 和 Sonnet5.5 都轻轻松松还原 90%+ 了。这两位抄代码都抄不好!
我已经努力克制我的吐槽欲望了,但是这一趴我还是有点忍不住了!
MM 的坦克大战:
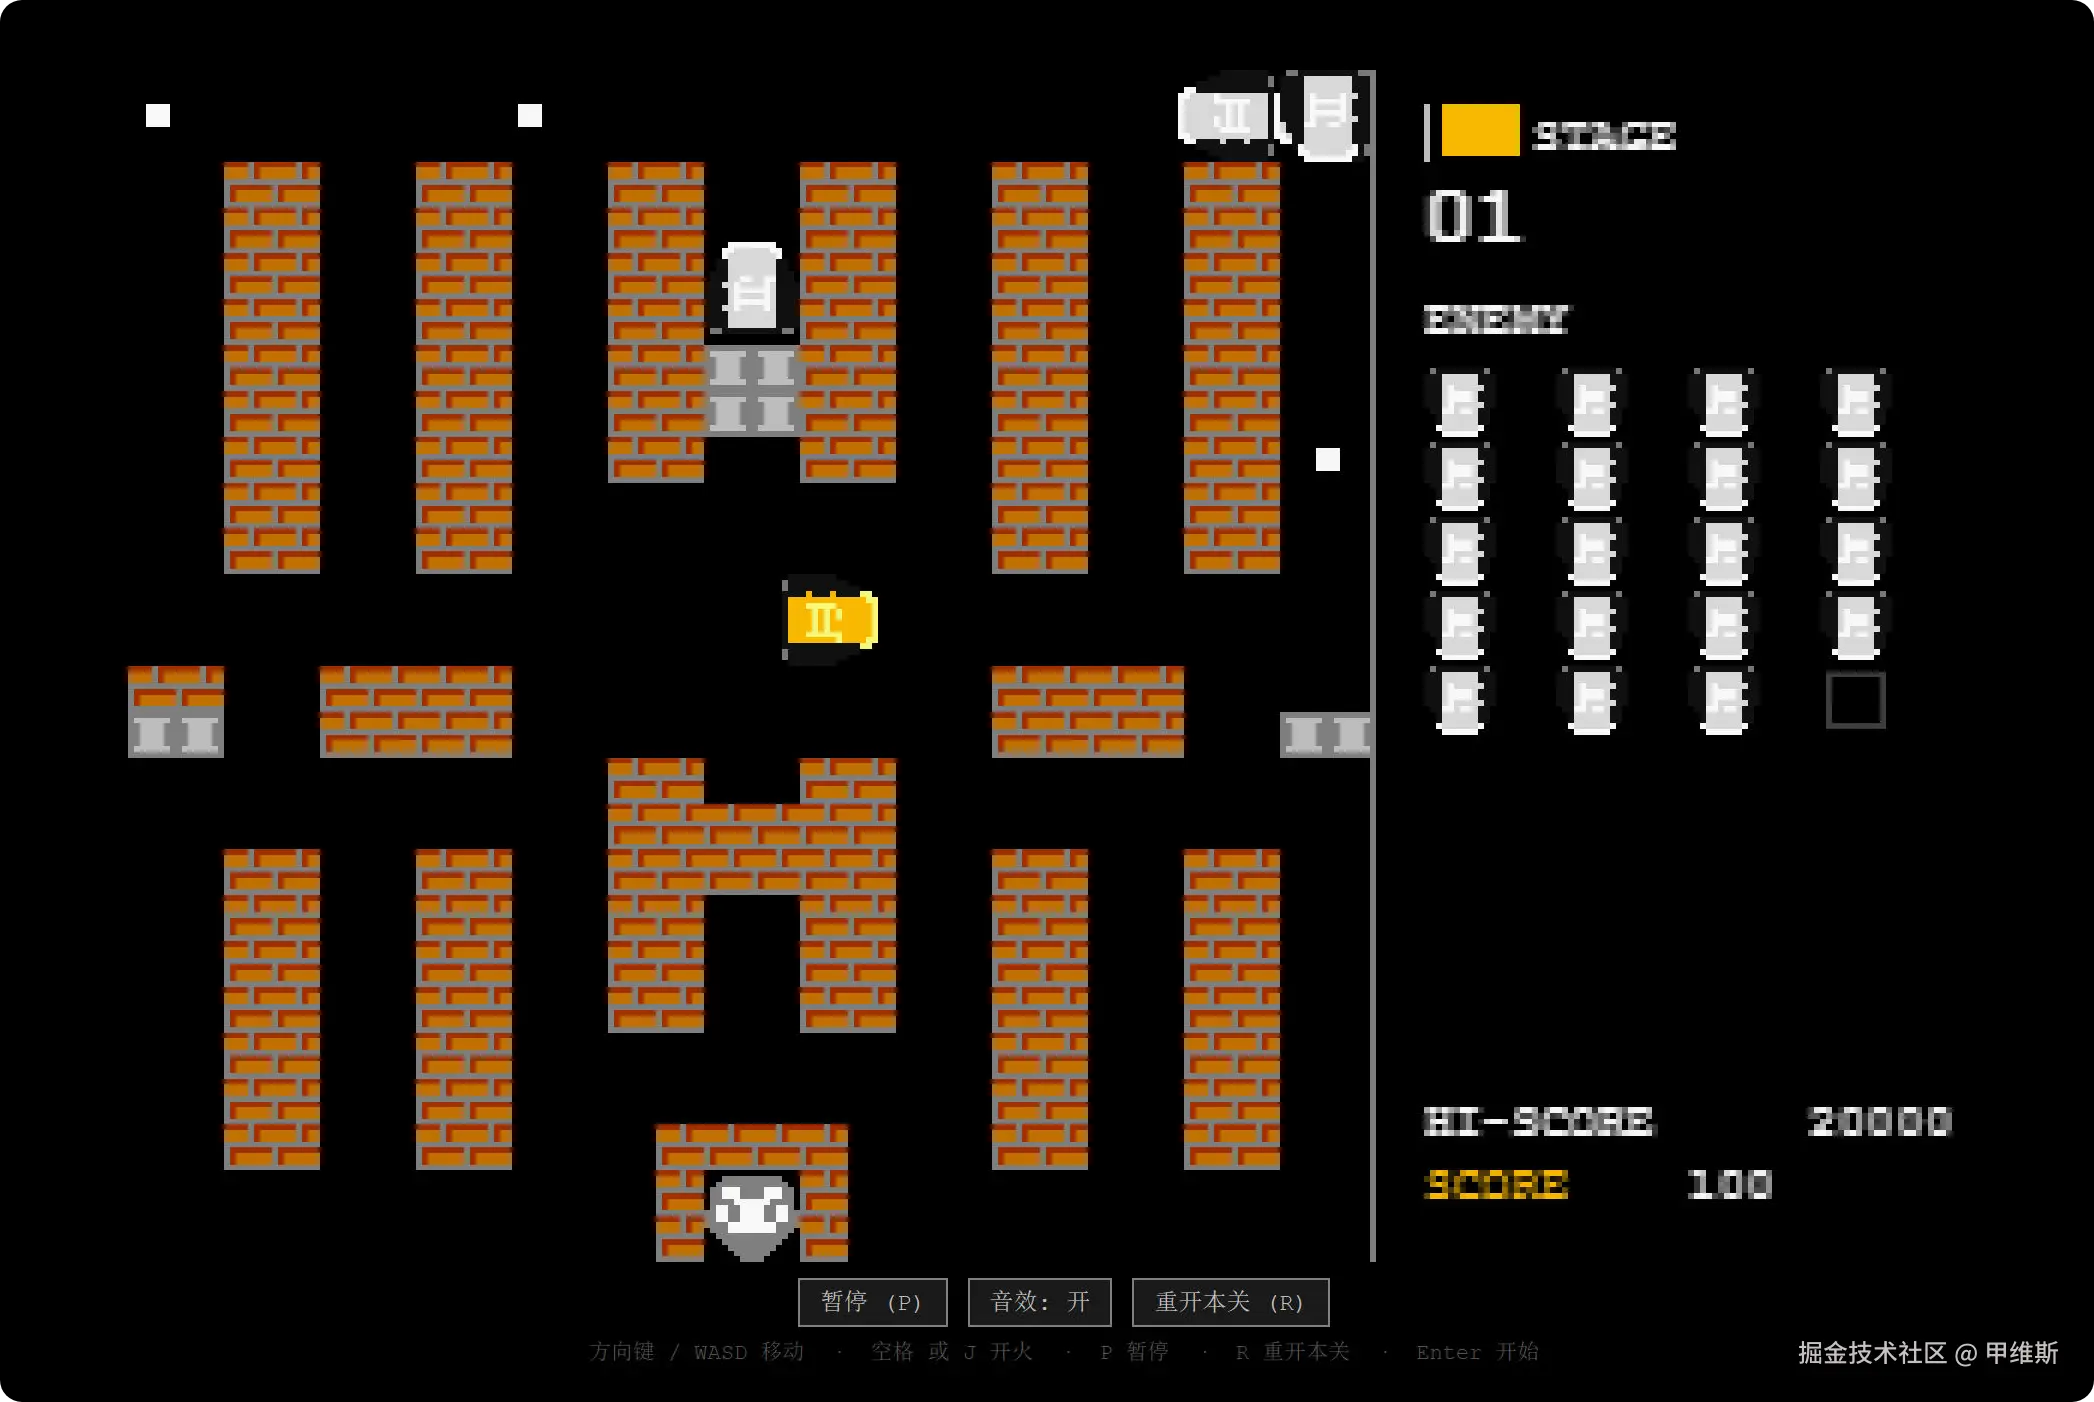
用时 27 分钟!
SB 的坦克大战:
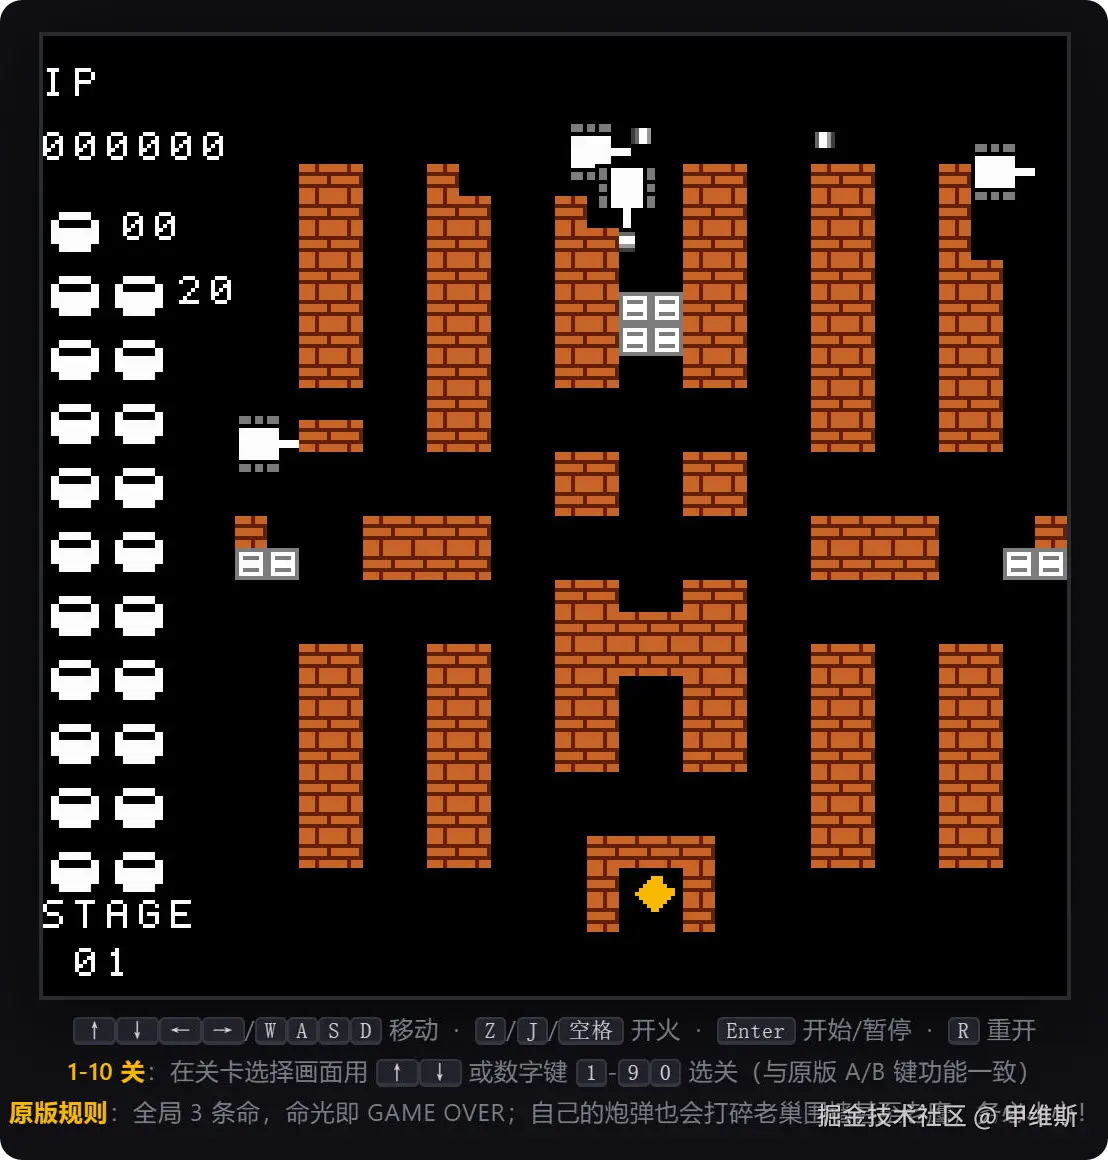
用时 47 分钟!
坦克大战部分两位选手都没有语法错误,都能跑起来!
但是这个复刻结果并不理想,问题太多了,完全没有体验可言!
其实我本身对这两个模型并没有高期待的。
但是你们能理解那种心情么:
花一个小时两个小时拆开一个包装精美的盒子发现里面放了一坨东西。
再对比一下,隔壁一个盒子,一下子就拆开了,里面真的有精致的礼物!
这种落差,大概就是我当前的心情。
我就不多描述了,假期要开开心心。
以后我也尽量少吐槽,多鼓励,多分享有用的东西(除非我实在压抑不住吐槽的冲动了)。
写完这篇,应该就不测任何新模型了,这几天总该没有更新了吧!!!
可能会跟大家分享一些很棒的例子!
我有点想直播一下 Opus 搓的那些游戏,真的能玩!
昨天GPT6.1Sol和Sonnet5.5的测试结果都已经发布了,今天的例子也会上传很快上传!
网址: