现在,doubao-seed-2-1 系列模型已经上架算桥 API,欢迎前来体验。
做 API 的人,大概都见过这种场面。模型把一句需求答得挺漂亮,接下来让它读几份材料、拆成待办、调用工具、拿结果回来核一遍,它就开始掉链子。回复能看,活却没往前走。项目里最费时间的,往往就是这段。
现在,doubao-seed-2-1 系列模型已经上架算桥 API。我们把 doubao-seed-2-1-pro 和 doubao-seed-2-1-turbo 都放进了模型广场。想试的开发者,不用为接入再开一套账号和代码,拿现有的 OpenAI 兼容写法改两处,就能把模型放进自己的应用里。
这次豆包想解决的事
字节跳动 Seed 团队在 2026 年 6 月发布 Seed 2.1 时,把重点放在真实生产力任务上。官方给出的方向很实在,模型要能围绕一个目标持续推进,处理项目规划、文件内容和工具调用,再交回可用结果。
这句话放到日常开发里,就是很多让人头大的小事。客户丢来一堆材料,产品同学问能不能先整理出问题清单,研发要把一个自然语言需求拆成可实现的模块。单次问答当然能参与,任务一变长,就开始考验模型能不能记住上下文、把步骤排顺、在需要时把工具用起来。
Seed 2.1 也把代码工程放到了很靠前的位置。官方介绍中,它面向真实开发过程强化了需求理解、代码实现、问题修复和结果验证。多模态理解也在这一代继续加强,复杂文档、图表、图片和视频里的信息,能成为后续任务的一部分。对做产品的人来说,这些能力最终都落在一个地方,少来回搬材料,少让人手工补上一段模型漏掉的步骤。
Pro 和 Turbo 怎么选
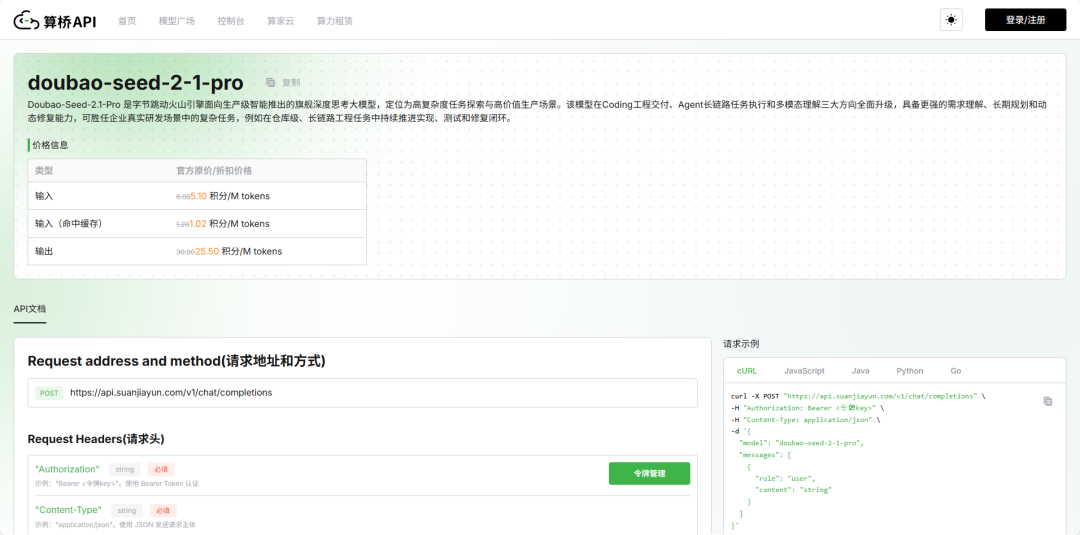
两个版本都叫 Seed 2.1,分工挺清楚。遇到复杂 Coding、长任务执行、多步骤工程交付这类难题,可以先用 Pro。它面向高复杂度探索和高价值生产任务,适合把时间花在方案、代码和结果验证上。
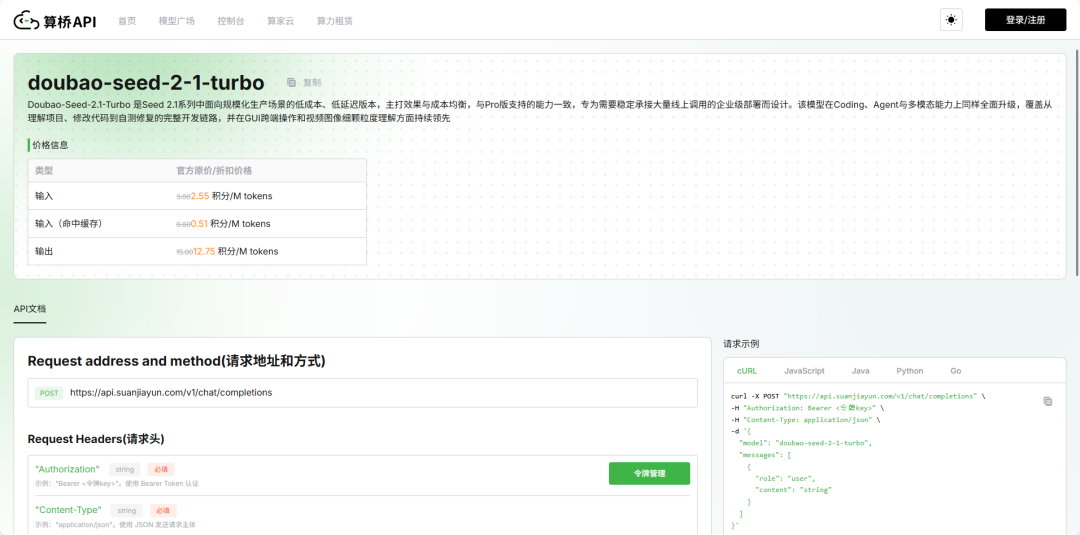
线上请求多起来以后,Turbo 会更合适。官方把它定位为面向规模化生产的低成本、低时延版本,功能保持齐备,适合大量线上 Coding、智能体和多模态理解请求。比如产品里的批量内容整理、客服质检、固定格式的资料处理,这类任务需要稳定地一条条往下跑,Turbo 的定位更贴近。
选型不必一开始就想得太重。把最复杂的一批任务先给 Pro,观察它会在哪一步卡住。把规则清楚、调用量大的任务交给 Turbo,看看质量、速度和成本是不是能接受。跑过一轮,模型怎么分工就清楚了。
在算桥 API 跑通第一次对话
在算桥 API,我们把多模型接入做成一个统一入口。创建账号后,在控制台新建 API Key,再到模型广场确认要用的版本。已有 OpenAI SDK 的项目,通常只需要换 base_url、api_key 和 model 三处。
下面用 Pro 做一个产品需求拆解的小例子。这个例子没有替你写完产品,只把一段模糊需求先变成研发能继续讨论的清单。
代码示例
from openai import OpenAI
client = OpenAI(
api_key="你的算桥 API Key",
base_url="https://api.suanjiayun.com/v1"
)
reply = client.chat.completions.create(
model="doubao-seed-2-1-pro",
messages=[
{"role": "system", "content": "你是产品研发助理。输出要能直接进入评审。"},
{"role": "user", "content": "把下面的需求拆成目标、页面改动、接口改动、风险和验收项。需求是为会员增加续费提醒。"}
]
)
print(reply.choices0.message.content)
代码里最关键的是模型名。需要更快处理大量同类请求时,把 model 换成 doubao-seed-2-1-turbo 就行。模型擅长什么,还得靠你的数据和任务来验。先拿一批真实但脱敏的样本试,别用一句泛泛的问题给模型下结论。
提示词也别只写一句帮我优化。把交付物说清楚,模型的输出会好用得多。比如明确告诉它,结果要分成待办清单、需要确认的问题和验收标准。团队里谁接这份结果,谁就知道下一步该干什么。
工具调用也建议从一件小事开始。可以先让模型从需求里提取检索词,程序拿到资料后,再让模型按固定格式整理。两次请求各自负责一件事,日志里也更容易看出问题出在哪。等这套做法跑稳了,再把更多步骤接进去。
把模型接进项目 也把选择权留在手里
很多团队接入新模型最怕两件事。一个是代码改动太多,另一个是业务跑起来以后想换模型还得重做。算桥 API 的 OpenAI 兼容接口,给这件事留了一个更轻的入口。我们提供 https://api.suanjiayun.com/v1 作为统一地址,模型选择留在请求参数里。你可以在模型广场里看 Pro 和 Turbo 的详情,再按自己的任务做取舍。
我们更希望大家把它当成一次小范围试用。挑一个已有数据、结果好判断的任务,先跑几十条。看它在复杂需求上有没有漏步骤,也看它在批量调用时能不能稳定交付。等这两件事有答案,再往生产环境里放。
豆包 Seed 2.1 系列已经在算桥 API 等你调用。复杂任务想多给模型一点时间,就从 Pro 开始。高频任务想把请求跑得更顺,就去试试 Turbo。一个 Key,模型怎么选,决定权一直在你手里。