Linux层:硬件错误接收、解析、隔离与恢复
1. 总体概述
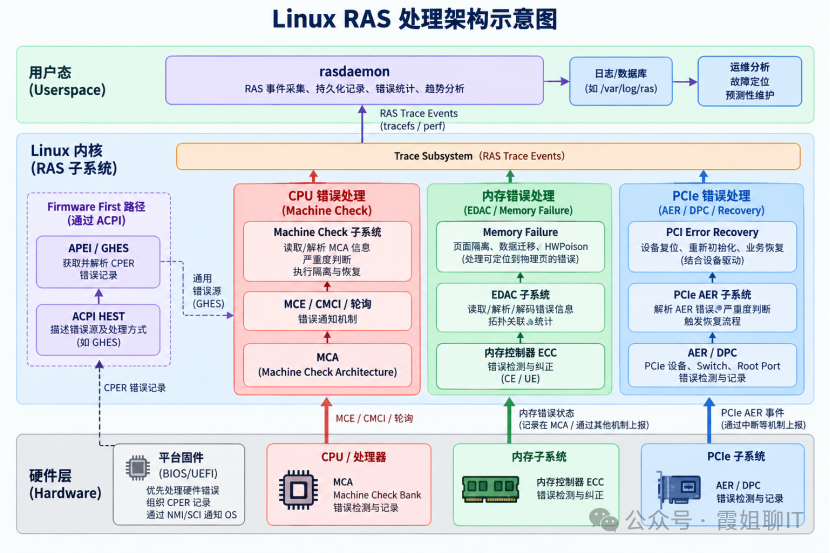
Linux RAS层负责系统运行期间硬件错误的接收、解析、记录、隔离与恢复。它并不是一个单独的软件模块,而是建立在CPU、内存和PCIe设备等硬件RAS能力之上,由多个内核子系统和用户态工具共同构成。
(1) CPU 错误 处理
处理器通过 MCA完成硬件错误的检测和记录,并通过MCE、CMCI等机制通知Linux;
Linux的 Machine Check子系统负责读取和解析MCA错误信息,并进行错误严重度判断及后续处理。
(2) 内存错误 处理
内存控制器中的ECC逻辑负责错误检测,并在能力范围内完成纠正;
相关错误状态可由处理器的MCA记录在内存控制器对应的Machine Check Bank中。Linux的Machine Check及 EDAC等子系统负责读取、解析和记录这些错误信息。
如果内存错误信息中能够获得有效物理地址并定位到具体物理页面,Linux可通过Memory Failure机制进行处理,并利用Hardware Poison标记和隔离故障页面,根据页面类型及错误影响范围采取页面隔离、进程SIGBUS或必要的系统级处理措施。
(3) PCIe错误 处理
Root Port 、PCIe Switch、PCIe设备等可通过AER机制检测和记录错误,并将其上报给Linux PCIe AE子系统解析和处理。
严重错误还可结合 DPC限制故障向上游或其他设备扩散,并通过 PCI Error Recovery和设备驱动提供的错误恢复接口执行设备复位、重新初始化和业务恢复。
(4) Firmware First模式
该模式下,平台固件优先处理硬件错误,然后Linux可通过ACPI APEI/GHES 获取并解析平台固件提供的错误状态和CPER错误记录,再根据错误类型进入相应的RAS处理流程。
(5) 用户态rasdaemon 工具
rasdaemon可持续采集Linux内核产生的RAS事件,并进行持久化记录、错误统计和趋势分析,为故障定位和预测性维护提供数据支持。
2. OS Native与Firmware First两种错误处理模式
OS Native 是较早采用的硬件错误处理方式。
在这种模式下,硬件完成错误检测和状态记录后,直接通过相应的硬件通知机制将错误通知OS,由OS读取和解析硬件错误状态,并根据错误类型执行记录、隔离和恢复等处理。
例如,处理器可以通过 MCA 记录 Machine Check 错误,并通过MCE、CMCI 等机制通知 Linux直接处理;
PCIe设备产生AER错误后,也可以由Linux AER驱动直接处理。
而随着服务器硬件架构日益复杂,不同处理器和平台之间的硬件拓扑、错误寄存器以及厂商扩展 RAS 能力存在较大差异。
如果完全由OS直接访问和解析这些硬件错误信息,会增加操作系统对不同硬件平台的适配复杂度。
与此同时,一些错误还需要结合平台拓扑、FRU 信息以及厂商特定的硬件状态进行判断和处理。
针对这类需求,服务器平台逐渐形成了 Firmware First错误处理模式。
在 Firmware First 模式下,硬件错误发生后,平台固件首先获得相应错误的处理控制权。
固件根据具体平台实现读取硬件错误状态,完成必要的平台级处理,并将错误信息按照 CPER 等标准格式进行组织。
ACPI HEST 用于向操作系统描述平台中的硬件错误源及其处理方式,其中可以定义 GHES(Generic Hardware Error Source)等通用错误源。
固件将错误信息写入相应的错误状态区域后,通过 NMI、SCI 等通知机制通知Linux;
Linux 再通过 APEI/GHES获取并解析这些错误记录,并根据错误类型继续执行页面隔离、进程通知、设备恢复或其他处理。
Firmware First 的主要优势在于能够充分利用平台固件对底层硬件拓扑、厂商私有寄存器以及 FRU 信息的了解,在固件层完成硬件相关错误信息的采集和整理,并以相对统一的标准格式交给操作系统处理,从而降低操作系统直接适配不同硬件错误接口的复杂度。
同时,对于需要平台参与的错误,固件还可以在向操作系统报告之前完成必要的平台级错误处理和错误状态管理。
实际服务器通常不会在OS Native与Firmware First之间进行整机级的二选一,而是根据不同的错误源和平台设计分别选择相应的处理方式。
例如,部分内存错误可以由平台固件优先处理,并通过 CPER/GHES 路径上报给 Linux;而部分CPU Machine Check错误则可以通过 MCA 和 Linux Machine Check 机制直接处理。
对于 PCIe AER,Linux是否采用Native AER还与Firmware是否通过 ACPI _OSC 将AER控制权授予操作系统有关。
因此,现代服务器通常采用OS Native 与 Firmware First 并存的混合式 RAS错误处理架构。
3. Linux处理CPU错误:MCA与Machine Check机制
(1)CPU MCA基本原理
MCA(Machine Check Architecture)是处理器提供的一种硬件 RAS 能力,用于检测、记录和报告处理器及其相关硬件单元发生的错误。
Linux在 MCA 提供的硬件能力基础上,进一步完成 Machine Check 错误的读取、解析、严重程度判断以及后续恢复处理。
处理器内部设置有多个 Machine Check Bank,用于记录不同硬件单元产生的错误信息。
这些Bank可以与CPU Core、Cache、Memory Controller、Interconnect等硬件单元相关联,但具体Bank与硬件单元之间的对应关系取决于处理器架构和型号,并不是固定不变的。
当处理器内部某个硬件单元检测到错误后,相应的 Machine Check Bank 会保存错误状态。典型的 MCA 寄存器包括:
MCi_STATUS:记录该 Bank 的主要错误状态,包括错误记录是否有效、错误是否已经纠正、处理器上下文是否可能已经损坏以及具体错误代码等信息。
Linux在后续进行错误严重程度判断时,会结合这些状态位以及错误发生时的执行上下文进行综合判断。
MCi_ADDR:在错误地址有效时保存与该错误相关的地址信息。
例如,对于能够提供有效物理地址的内存类 Machine Check,Linux可以进一步利用该地址定位相应的物理内存资源,并交由 Memory Failure 等机制进行后续处理。
MCi_MISC:保存与错误相关的辅助信息,其具体内容和含义取决于错误类型以及处理器的具体实现。
需要注意的是,MCA记录错误后,并不意味着所有错误都会触发 Machine Check Exception。
对于需要通过异常方式通知操作系统的 Machine Check,处理器可以触发 Machine Check Exception;
对于部分已经由硬件纠正的错误,则可以通过 CMCI或周期性轮询等方式由操作系统发现和处理。
(2)Linux Machine Check处理流程
当处理器通过MCE、CMCI 或其他Machine Check路径向Linux报告错误后,Linux Machine Check子系统读取相应 MCA Bank 中保存的错误状态、错误地址以及辅助信息,并结合处理器类型和错误发生时的执行上下文,对错误进行解析和严重程度判断。
Linux首先采集Machine Check Bank中保存的硬件错误信息,并形成相应的 Machine Check错误记录。
随后,根据MCA状态位、错误类型、处理器执行状态以及故障资源是否能够被准确定位和隔离等因素,决定后续处理方式。
从Linux后续处理结果的角度,可将Machine Check错误概括为以下几类典型情况:
① Corrected Error
Corrected Error 是指硬件已经完成纠正、没有立即破坏系统正常执行的错误,例如部分 Cache ECC 或内存 ECC Corrected Error。
对于这类错误,Linux通常不需要进行系统级恢复,而是记录错误来源、类型、CPU、Bank以及相关状态信息,并继续运行。
****既然硬件已经纠正,为何还要记录呢?****单次纠正错误通常不会造成系统故障,但如果某个硬件单元持续产生大量Corrected Error,则可能反映其正在发生退化,需要结合错误频率、阈值以及平台维护策略进行进一步分析。
② Recoverable / Containable Error
对于某些处理器报告为具备软件恢复条件的Machine Check,如果Linux判断错误影响能够限制在当前执行上下文,并且内核状态仍然可信,则可以尝试终止受影响的任务或执行相应的软件恢复,而不是立即触发Kernel Panic。
③ Fatal Error
如果 Machine Check 表明处理器执行上下文已经损坏,例如出现Processor Context Corrupted等状态,或者错误已经影响到无法安全隔离和恢复的关键系统资源,则继续运行可能造成进一步的数据损坏。
此时Linux会记录相关Machine Check信息,并根据错误严重程度进入Kernel Panic,以避免系统在状态已经不可信的情况下继续运行。
(3)Linux Machine Check相关源码
Linux x86 Machine Check 的主要源码位于arch/x86/kernel/cpu/mce/。
其中主要包括以下文件:
① arch/x86/kernel/cpu/mce/core.c
Machine Check 子系统的核心实现文件,主要负责 Machine Check功能初始化、MCA Bank信息读取、Machine Check事件采集和记录,以及相关错误处理流程。
② arch/x86/kernel/cpu/mce/severity.c
主要负责 Machine Check 错误的严重程度判断。
Linux会结合MCA状态位、错误类型、处理器执行上下文以及错误是否具有软件恢复条件等信息,对Machine Check进行严重程度分类,为后续继续运行、恢复处理或 Kernel Panic 提供判断依据。
③ drivers/edac/mce_amd.c
主要负责 AMD MCA/SMCA Machine Check 错误的进一步解码。
对于支持SMCA的AMD 处理器,该文件可以结合Bank类型、扩展错误码以及相关SMCA信息,进一步识别和解析 Core、Cache、UMC以及其他处理器内部硬件单元产生的Machine Check错误。
4. Linux处理 内存错误:EDAC和Memory Failure机制
硬件方面,内存控制器负责检测内存访问过程中出现的数据错误,并在能力允许的情况下完成纠正。
而Linux在此基础上,进一步负责错误信息的解析和记录、内存错误统计、故障地址定位以及严重错误情况下的物理页面隔离。
从 Linux 软件角度来看,内存错误处理主要涉及 EDAC、Memory Failure。
EDAC主要承担内存错误信息的采集、解码、拓扑关联和统计;
Memory Failure则面向能够定位到具体物理页的内存硬件错误实施页面级隔离与恢复。
(1)EDAC(Error Detection And Correction)
EDAC是 Linux 内核中用于管理硬件错误信息的框架,其中 Memory Controller EDAC主要用于处理内存控制器报告的内存错误。
不同处理器和内存控制器的硬件寄存器、内存拓扑以及错误信息格式存在差异,因此 Linux中有不同硬件对应的具体EDAC驱动。
具体EDAC驱动负责获取底层硬件错误信息,并转换成 EDAC Core能够统一处理的错误记录。
Linux EDAC使用 Memory Controller、Channel、DIMM等层级描述系统中的内存拓扑。例如,一个内存错误可能最终被描述为:
Memory Controller : MC0
Channel : Channel 2
DIMM : DIMM A2
Error Type : Corrected Error
Error Count : 1
如果硬件能够提供有效地址、Syndrome等信息,EDAC还可以记录:Physical Address(错误发生的物理地址)、PFN(Page Frame Number 错误位于哪个物理页)、Offset(错误在这个物理页中的位置)、Syndrome(ECC错误特征信息)、Error Message(人可读的错误描述)。
因此,EDAC的一个重要作用就是把不同处理器和内存控制器产生的硬件错误信息转换成 Linux能够统一管理和统计的内存RAS信息。
edac的源码位于drivers/edac目录,其中edac_mc.c是Memory Controller Core的主要实现文件,负责内存错误的统一管理、CE/UE统计以及错误事件处理。可以关注edac_mc_handle_error()查看处理的详细步骤。
(2)Corrected Error处理
Corrected Error(CE)是指硬件检测到数据错误后,能够利用 ECC机制恢复出正确数据的错误。
由于错误已经由硬件完成纠正,EDAC获得 CE后,会记录错误发生在哪个 Memory Controller、Channel或 DIMM,并更新相应的错误计数,用于长期趋势分析。
(3)Uncorrected Error处理
Uncorrected Error(UE)表示硬件已经检测到数据错误,但无法通过 ECC直接恢复出正确数据。
与 CE相比,UE可能直接影响操作系统或应用程序正在使用的数据,因此Linux需要进一步判断错误影响范围以及是否能够进行软件层面的隔离和恢复。
如果错误信息能够提供有效的物理地址,Linux可以将硬件错误进一步定位到具体物理页面,并通过 Memory Failure机制尝试隔离故障资源。
如果错误无法定位,或者错误已经影响到无法安全恢复的系统关键资源,则 Linux可能无法通过页面级隔离完成恢复,需要采取更加严格的错误处理措施。
(4)Memory Failure与Hardware Poison
对于无法由 ECC 硬件直接纠正的严重内存错误,如果 Linux 能够根据错误信息获得有效的物理地址,就可以进一步将该地址转换为对应的物理页,并通过 Memory Failure 机制进行处理。
Memory Failure 是 Linux 针对物理内存硬件错误提供的软件处理机制,其核心目标是:在能够确定故障物理页的情况下,将错误影响尽可能限制在该物理页及其使用者范围内,避免局部内存故障进一步影响整个系统。
其主要实现位于:mm/memory-failure.c,其中 memory_failure() 是处理故障物理页的重要入口之一。整体处理过程可以概括为:
Memory Error
↓
获得Physical Address
↓
转换为PFN
↓
定位故障物理页
↓
memory_failure()
↓
标记Hardware Poison
↓
判断页面类型及使用状态
↓
处理页面映射及使用者
↓
隔离故障页面
↓
Recovery / SIGBUS / Failed
其中,Hardware Poison(HWPoison)是Memory Failure处理过程中的重要机制。它用于标识某个物理页已经由于硬件错误而不再可信,使 Linux 不再将该页面作为正常物理内存继续使用。
Linux 在将故障页面标记为 HWPoison 后,还要进一步判断该页面当前由谁使用、是否存在用户空间映射、数据是否能够重新获得,以及该页面能否被安全隔离,并根据具体情况采取不同的处理措施。
① 用户进程使用的页面
如果故障物理页已经映射到用户进程地址空间,Linux 会尝试处理相应的页面映射,并确定受到该错误影响的进程。
对于无法继续安全访问故障页面的进程,Linux 可以发送 SIGBUS,通知应用程序发生了硬件内存访问错误。
通过这种方式,可以将一个物理内存错误的影响尽可能限制在具体页面和相关进程范围内,而不会因为单个物理页发生故障就立即导致整个操作系统停止运行。
② 具有可靠后备数据的页面
对于部分文件映射或 Page Cache 页面,如果页面中的数据可以从文件等可靠后备存储中重新获得,Linux可以将损坏页面从正常使用路径中隔离,使后续访问重新获取有效数据。
但如果故障页面中包含尚未写回的修改数据,或者数据已经不存在其他可靠副本,则恢复会更加困难。
③ 无法安全恢复的页面
并不是所有物理内存错误都能够通过Hardware Poison完成恢复。
如果 Linux 无法准确定位故障页面,或者故障页面正在保存无法安全丢弃或恢复的关键系统数据,使得页面隔离后仍无法保证系统继续正确运行,则Memory Failure可能无法完成有效恢复。
此时,Linux需要根据错误上下文及系统配置采取更严格的处理措施;在无法保证系统继续可靠运行且相应策略要求终止系统运行时,可能进入Kernel Panic。
(5)Soft Offline机制
Linux提供Soft Offline机制,用于在物理页面尚未发生不可纠正错误的情况下,主动将存在潜在硬件风险的页面退出正常使用。
例如,某个物理页面反复出现Corrected Error(CE),虽然ECC仍能够完成数据纠正,页面中的数据暂未发生不可恢复的损坏,但持续出现的纠正错误可能表明对应内存区域存在潜在的硬件退化风险。此时,系统管理或平台RAS策略可以根据错误监测结果,主动对相关物理页面执行Soft Offline。
是否根据CE频率或其他健康指标触发Soft Offline,取决于具体的平台RAS策略、用户态管理机制及系统配置。
同时,并非所有类型的物理页面都能够成功完成Soft Offline,其最终处理结果还受到页面类型、使用状态以及能否安全迁移等条件影响。
Soft Offline相关实现主要位于mm/memory-failure.c。
5. Linux处理PCIe错误:AER、DPC与Recovery
PCIe设备广泛应用于服务器中的网卡、存储控制器、GPU、加速卡以及其他高速外设,在运行过程中,PCIe链路和设备也可能发生硬件错误。
AER(Advanced Error Reporting)和DPC(Downstream Port Containment)就是PCIe规范性定义的,由硬件实现的PCIe错误处理能力****,****而Linux在此基础上,通过DPC驱动、AER驱动以及PCI Error Recovery框架读取错误信息、判断错误严重程度,并协调设备驱动完成后续恢复。
(1)PCIe AER错误处理机制
支持AER的PCIe组件可以通过AER Extended Capability中的相关寄存器记录详细的PCIe错误信息,Linux AER驱动可读取这些信息,对错误进行解析和报告。
Linux获得AER错误后,可以获取包括错误严重程度、错误类型、Requester ID以及部分错误对应的TLP Header等信息,从而辅助判断错误来自哪个PCIe设备以及发生在哪个协议层次。
例如Linux日志中可能出现类似:
0000:41:00.0: PCIe Bus Error:severity=Uncorrectable (Non-Fatal) type=Transaction Layer
其中:0000:41:00.0表示PCI设备的BDF地址,可以用于定位相应PCIe设备。
PCIe AER将错误分为Correctable Error和Uncorrectable Error,其中Uncorrectable Error又进一步分为Non-Fatal和Fatal。Linux根据错误严重程度采取不同处理方式。
① Correctable Error
Correctable Error表示PCIe协议层能够完成恢复,错误不会导致功能失效,也不会造成数据丢失,因此通常不需要Linux执行设备Reset等恢复操作。
常见的Correctable Error包括Receiver Error、Bad TLP、Bad DLLP等。
对应此类错误,Linux处理重点通常是记录和统计,而不是立即复位设备。
对于同一设备或链路连续出现多个Correctable Error,Linux不会仅根据CE累计次数自动复位或隔离设备,而是继续记录相应错误并更新AER统计信息。
对于高频重复错误,AER驱动提供了错误日志限速机制,以避免大量错误信息持续输出影响系统运行。
需要注意的是,日志限速并不意味着停止错误统计,也不代表Linux已经对故障设备执行恢复。
大量重复CE可以作为设备或链路异常的重要监控指标,但是否进一步采取降速、复位、隔离或更换设备等措施,需要结合设备驱动、平台策略及运维规则判断。
② Uncorrectable Non-Fatal Error
Uncorrectable Non-Fatal Error表示PCIe硬件无法通过协议自身完全纠正该错误,某次事务可能已经受到影响,但PCIe链路本身仍然可以继续工作。
对此,Linux会启动PCI Error Recovery流程,并通知受到影响的设备驱动。
如果设备驱动认为无需Reset即可恢复,可以返回相应的恢复结果;
如果驱动认为必须Reset设备,则Linux进一步进入Reset和设备重新初始化流程。
③ Uncorrectable Fatal Error
Fatal Error表示错误已使相关PCIe链路的可靠性受到影响。
对于此类错误,恢复流程通常需要执行链路或设备层面的Reset,并结合PCI Error Recovery框架及设备驱动的恢复能力尝试重新初始化;若无法恢复,则可能进入Permanent Failure处理。
AER相关实现主要位于:drivers/pci/pcie/aer.c
( 2 )DPC故障隔离机制
对于严重PCIe错误,仅仅记录错误并不一定足够,还需要尽快限制故障影响范围,避免错误继续沿PCIe层级传播。
DPC允许支持该能力的下游端口在检测到特定错误条件后,对其下游PCIe层级实施快速隔离,使故障设备及相关下游层级暂时不可访问,并为后续错误恢复创造条件。
DPC相关实现主要位于:drivers/pci/pcie/dpc.c
( 3 )PCI Error Recovery与设备驱动恢复
Linux PCI Error Recovery实际上是一个PCI Core与具体设备驱动协同完成的恢复过程。PCIe设备能否真正恢复,在很大程度上依赖具体PCIe设备驱动是否实现了错误恢复能力。
Linux PCI Core提供了统一的PCI Error Recovery框架。PCI设备驱动可以通过:struct pci_error_handlers注册相应的错误恢复回调函数。如:error_detected()、slot_reset()、resume()等。
当PCI Core通知驱动设备发生错误时,驱动可以停止新的I/O请求、保存必要的软件状态,并返回自己能够支持的恢复方式。
6. Linux RAS事件采集与用户态管理:Trace Event与rasdaemon
对于运维而言,还需要将分散在不同子系统中的 RAS 错误信息进行采集并进行长期保存和统计。
Linux 为此提供了Trace Event 机制,同时用户态的rasdaemon 可以监听相关 RAS Trace Event,对硬件错误进行持续采集、记录和统计。
(1)Linux Trace Event机制
Trace Event 是一种结构化事件跟踪机制,按照预先定义的事件格式记录相应字段,适合用户态程序进行自动化采集和解析。
Linux RAS相关子系统在处理硬件错误时,可以产生对应的Trace Event。用户态程序通过 tracing接口监听这些事件,从而获得持续的硬件错误信息。
(2)rasdaemon的作用
rasdaemon是 Linux中常用的开源用户态RAS事件采集程序,上游由 Red Hat 社区工程师主导维护,本身不处于内核硬件错误恢复的关键处理路径。
rasdaemon可以根据当前 Linux内核提供的 RAS Trace Event支持情况,对多种硬件错误事件进行监听,并对事件进行解析、记录和统计。
rasdaemon还可以根据编译和运行配置将采集到的 RAS事件保存到持久化数据库中。
rasdaemon实际能够采集的事件类型取决于处理器架构、内核版本、内核配置以及相应RAS Trace Event是否可用,因此不同服务器平台上可获得的RAS事件范围可能存在差异。