前言
使用 AI 开发前端以后,我发现接口对接有一个很明显的变化:代码可以生成得很快,但接口信息不完整时,确认字段、纠正类型和返工的时间并不会随之减少。
后端提供了接口,并不意味着AI Agent 已经拿到了足够准确的接口契约。请求参数放在哪里、字段表示什么、返回的是对象还是数组、分页数据位于哪一层,这些信息都会影响生成结果。
如果你不提供接口足够的信息,你的Ai 肯定会多写兼容性代码,猜测;你让AI猜测是一个很危险的事情。
为了解决这个问题,我和后端同事尝试了一套流程:根据 Java Controller 生成固定格式的接口文档,确认后交给前端 AI 使用,再通过 Apifox CLI 把接口沉淀到项目中。
一、问题:文档有了,为什么还是需要反复沟通?
我们平时主要通过 Spring Boot 项目集成的 Swagger/OpenAPI 文档,或者 Apifox 对接接口。但在实际开发中,经常遇到这样的情况:
注重代码质量的后端,一般会规范编写注解与注释,借助 IDEA 的 Apifox 插件就能自动同步接口文档,实现相同效果。但如果后端先把接口录入 Apifox,前端对接就会很麻烦。如果使用 Apifox 官方 Skill 读取接口规范,会消耗大量 Token;手动整理接口信息又比较耗费时间,大家可以按需选择。我这套方案主要用来兜底,应对代码规范较差、文档缺失的后端场景。
- 参数有英文名称,却没有中文说明。
- 请求字段是否必填、状态值代表什么,没有写清楚。
- 返回类型只显示统一包装类,没有展开业务数据。
- 部分接口有响应示例,部分接口没有。
- 数据库实体、请求 DTO 和响应 VO 的字段不完全相同,文档没有体现这种差异。
这些问题不一定是工具造成的。开发时间紧张、注释缺失、泛型不明确,或者文档更新没有跟上代码,都可能导致接口信息不完整。
作为前端开发者,我需要先查文档,调试接口,实在搞不懂的再找后端同事确认字段含义,使用调试接口确定返回结构,最后整理成一份可以交给 AI 的说明。原本希望 AI 帮我节省时间,结果自己先成了接口文档的整理者。
如果省掉这一步,直接把不完整的信息交给 AI,它就可能生成类似这样的代码:
kotlin
const rows = res.rows ?? res.data?.rows ?? res.data?.list ?? res.data ?? []这种写法在确实需要适配多种协议时有用途。但对于已经确定的单一接口,它往往意味着返回结构没有核实清楚。在 TypeScript 项目中,后面还可能跟着宽泛的类型、类型断言和额外判断。
我希望 AI 依据明确的接口契约生成代码。无法确认的内容应该暴露出来,而不是被一层层兼容逻辑掩盖。
二、解决方案:把接口整理过程做成 Skill
为此,我整理了一个 java-controller-api-docs Skill,交给后端同事使用。
它是一份约束 AI 工作方式的说明,规定了应该读取哪些 Java 文件、如何判断请求与响应,以及最终文档怎么排版。它本身不是 Java 编译器,也不能保证仅凭静态源码就还原全部运行时行为。
我的目标是让后端写完一个控制器后,就能生成一份结构统一、便于确认、可以直接交给前端 AI 的接口文档。
只读取与当前控制器有关的内容
最初我想让 AI 尽量多分析一些代码,后来发现,这会增加 token 消耗,也容易把业务实现细节带进文档。
现在采用两阶段读取:
- 先读取目标 Controller,提取请求映射、方法参数、返回类型和返回表达式。
- 再按需读取直接关联的请求类、响应类、统一包装类和 MyBatis 实体映射。
生成响应示例时,不默认深入 Service 的业务实现,也不查询真实数据库。只有返回数据类型仍无法确定时,才补充读取被调用的 Service 方法签名。
例如下面的方法没有通过泛型声明业务数据类型:
kotlin
public AjaxResult getInfo(Long supplierId) {
    return success(supplierService.selectSupplierById(supplierId));
}
这时需要结合项目中 success 的实际定义,以及 selectSupplierById 的返回类型,判断数据放在哪个字段、具体是什么类型。通常不需要继续分析这个方法内部的查询和事务逻辑。
若依优先,但以项目实际定义为准
我们的后端主要使用若依,所以 Skill 优先识别 AjaxResult、TableDataInfo 和相关辅助方法。
不过,识别到类名并不等于确认了响应结构。有些项目修改过统一返回类,有些若依类型本身也没有泛型,仍然需要查看实际字段、方法定义和序列化规则。
如果目标接口使用的是自建 Result<T>、ApiResponse<T> 或直接返回 DTO、集合,就按对应类型处理。例如业务数据字段叫 result,文档就应该写 result,不能统一套成 data。
响应示例尤其重要,因为前端 AI 会根据它判断字段位置、对象层级和数组结构。示例值可以是占位值,示例结构必须有依据。
三、文档保持简单,但保留对接所需的信息
我不希望生成的文档充满框架说明、源码行号和重复的响应结构汇总。最终按控制器组织,每个接口只保留:
- 接口名称。
- 请求方式。
- 请求路径。
- 请求参数。
- 响应示例。
路径由类级和方法级注解拼接,例如 /breeding/supplier,不补上域名、端口或部署前缀。如果注解本身包含 /api,则应保留。
当前控制器的接口全部展示完后,再附上相关 Java 实体模型及中文注释。模型只输出一次,避免在每个接口下面重复。
下面用供应商接口展示文档格式。示例用于说明排版,具体字段、必填性和返回值应以实际项目代码为准,不代表运行验证结果。
获取供应商类型选项
请求方式: GET
请求路径: /breeding/supplier/type-options
请求参数: 无
响应示例:
css
{
  "msg": "操作成功",
  "code": 200,
  "data": [
    {
      "label": "鸡苗",
      "value": "鸡苗"
    }
  ]
}
新增供应商
请求方式: POST
请求路径: /breeding/supplier
请求参数: JSON 请求体
css
{
  "address": "示例地址",
  "contactPerson": "示例联系人",
  "farmId": 1,
  "phone": "13800000000",
  "supplierName": "示例供应商",
  "supplierType": "鸡苗"
}
响应示例:
json
{
  "msg": "操作成功",
  "code": 200
}
数据模型
以下仅节选与示例有关的实体字段,实际生成时按当前控制器对应的模型输出。
scala
/**
 * 供应商信息
 */
public class BreedingSupplier extends BaseEntity {
    /** 供应商ID */
    private Long supplierId;

    /** 所属养殖场ID */
    private Long farmId;

    /** 供应商名称 */
    private String supplierName;

    /** 供应商类型 */
    private String supplierType;

    /** 联系人 */
    private String contactPerson;

    /** 联系电话 */
    private String phone;

    /** 联系地址 */
    private String address;
}
对于 Query 和 Path 参数,用参数表和路径示例说明;对于 JSON 请求体,用代码块展示,并在需要时补充字段类型、必填性和中文说明。
这里还需要区分:数据库实体帮助理解业务字段,请求和响应类型决定接口契约。 关联查询字段可能不属于当前数据库表,却会出现在响应中;数据库实体里的字段也不一定允许前端提交或对外返回。因此,不能直接把实体复制成请求或响应结构。
无法确定的中文含义在说明后标记"(推测)"。如果无法确定的是响应字段是否存在、具体类型或嵌套结构,应由后端确认后再交给前端实现,不能把 {} 当成已经完整的响应定义。
四、从源头改善文档:把注释规范写进 AGENTS.md
Skill 能帮助整理信息,但源码没有写明的业务含义,不会因为使用 AI 就自动变得准确。
更有效的做法,是在项目的 AGENTS.md 中约定模型注释规范,让开发 Agent 在创建和修改 Java 类时就补齐中文说明:
markdown
## Java 数据模型注释规范

- Entity、Domain、DTO、VO 提供中文类注释,数据库实体注明表名。
- 每个业务字段提供紧邻字段的中文 JavaDoc。
- 状态字段注明已确认的取值含义;数量字段注明单位。
- 关联查询、计算、临时或请求专用字段注明用途。
- JavaDoc、持久化映射和相关注解的含义保持一致。
- 修改字段含义时同步更新注释,不编造未确认的业务规则。
- 只处理本次新增或修改的相关模型,不批量改动无关代码。
例如:
arduino
/** 封锁状态:0=正常,1=封锁 */
private String lockStatus;

/** 最大饲养容量,单位:只 */
private Integer capacity;

/** 养殖场名称(关联查询字段,非当前表字段) */
private String farmName;
如果字段只有 @Excel(name = "养殖场") 之类的注解,也能提供名称线索,但 JavaDoc 更适合补充业务含义。AGENTS.md 约束开发过程,文档 Skill 负责提取信息,二者需要配合使用。
五、从一次性交付,走向 Apifox 中的持续维护
固定格式的 Markdown 解决了眼前的对接问题,但如果文档一直在聊天记录中流转,时间久了仍然会遇到版本不一致、接口找不到、修改没有同步的问题。
所以我又补上了确认后同步到 Apifox 的流程,让接口按控制器分组保存在对应项目中。
目前采用的是自定义 Skill 与官方 Apifox CLI Skill 配合的方式:
| 组成部分 | 负责内容 |
|---|---|
java-controller-api-docs |
分析 Java 代码,生成约定格式的文档,保留控制器分组和同步范围 |
官方 apifox-cli Skill |
指导 Agent 使用 CLI 查询项目、管理目录、校验数据和操作接口 |
| Apifox CLI | 执行已授权的查询、新增和更新操作 |
这样可以减少自定义 Skill 对工具命令和连接细节的重复维护。CLI 可以从终端调用,不依赖当前 Agent 会话是否加载了 MCP;实际写入仍然需要登录状态和对应项目、分支的权限。
在本次环境中,我安装了 Apifox CLI 2.2.9,验证了登录和项目查询。安装方式、命令及权限要求会随版本变化,实际使用时应以官方指南和本机 --help 为准。
可以把下面这句话交给支持终端操作的 Agent:
objectivec
阅读并按官方指南安装 Apifox CLI 和官方 Agent Skills:
https://apifox.com/apifox-cli-installation-guide.md
按指南完成认证,令牌通过本地认证配置使用,不写入接口文档、仓库或聊天示例。
同步的是结构化接口信息
同步不能只是把 Markdown 粘贴进 Apifox 的描述框。需要把请求方法、路径、参数位置、请求体、响应 schema、字段说明和示例写入对应的结构化字段。
其中,响应 schema 应根据真实类型生成,不能仅凭示例中的 1、null 或空数组推断类型。JSON 内的业务 code 也不能直接当成 HTTP 状态码。
每个控制器创建或复用一个接口文件夹。已有接口需要在正确的项目、分支和模块内,根据方法与路径等信息匹配后更新,保留无关测试用例、脚本和手工配置,避免每次同步都产生重复接口。
官方 CLI 的写入流程要求先获取资源 schema、准备数据并完成校验,再执行创建或更新。同步结束后,还要回读核对目录归属、请求参数、响应结构和示例,不能只看命令退出成功。
下面是我在 Demo 中同步后的页面记录:
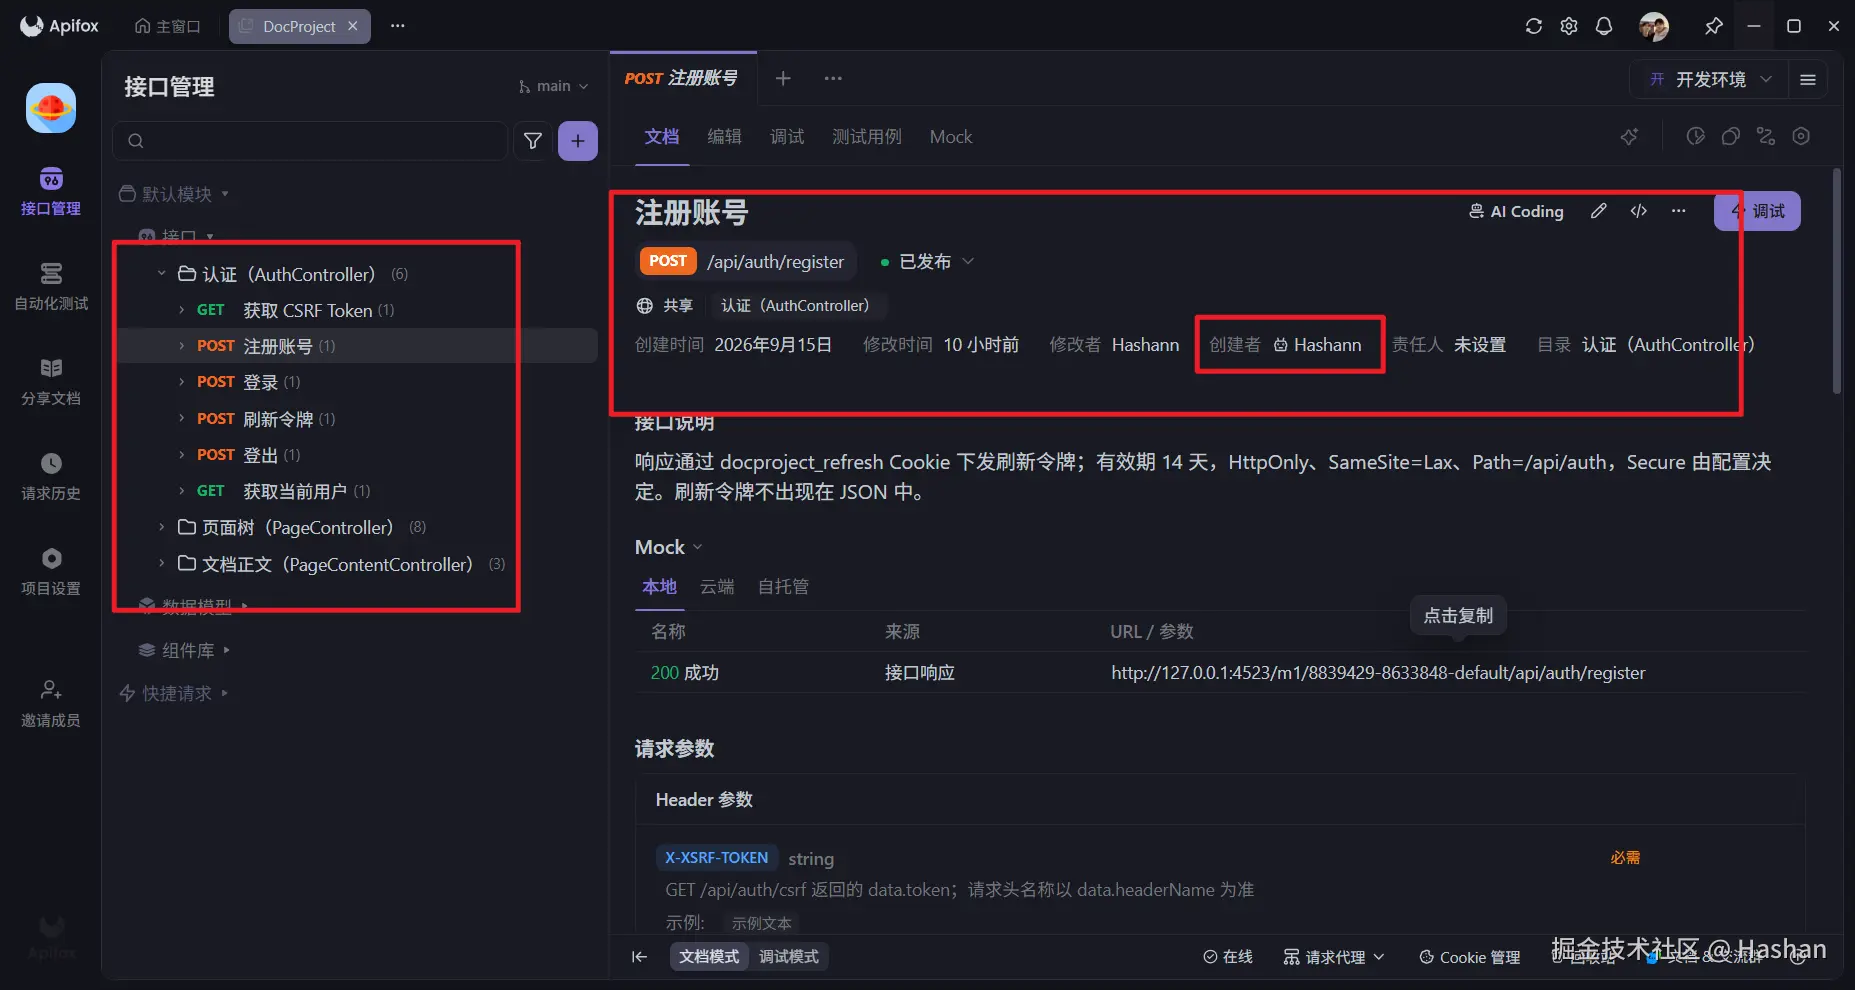
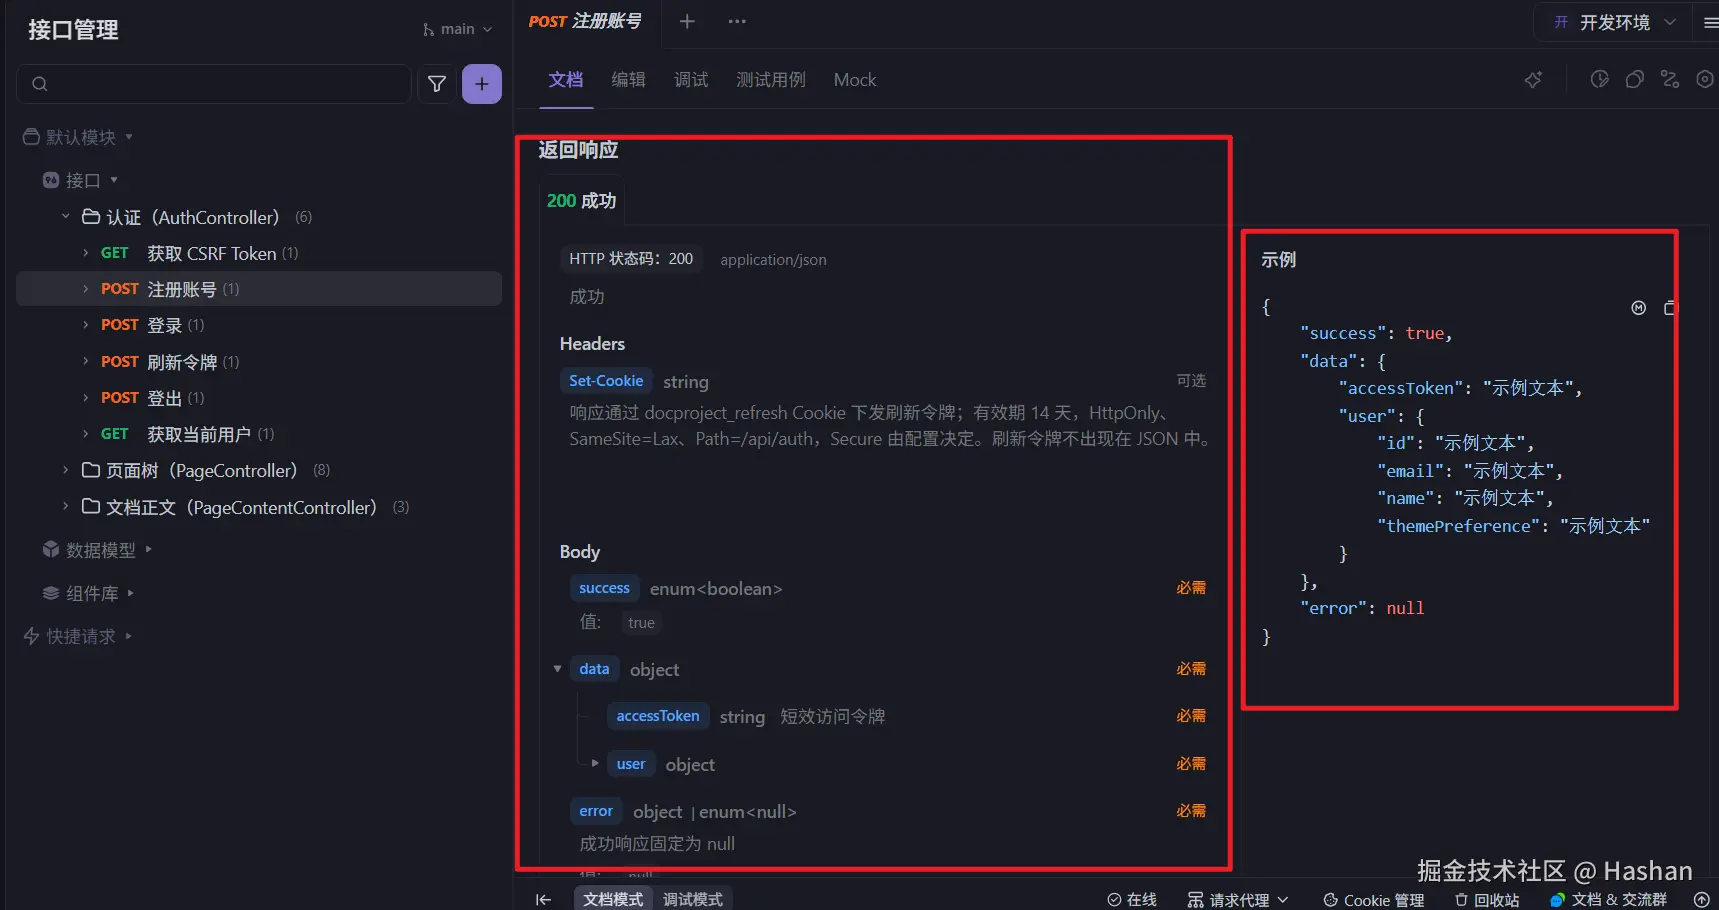
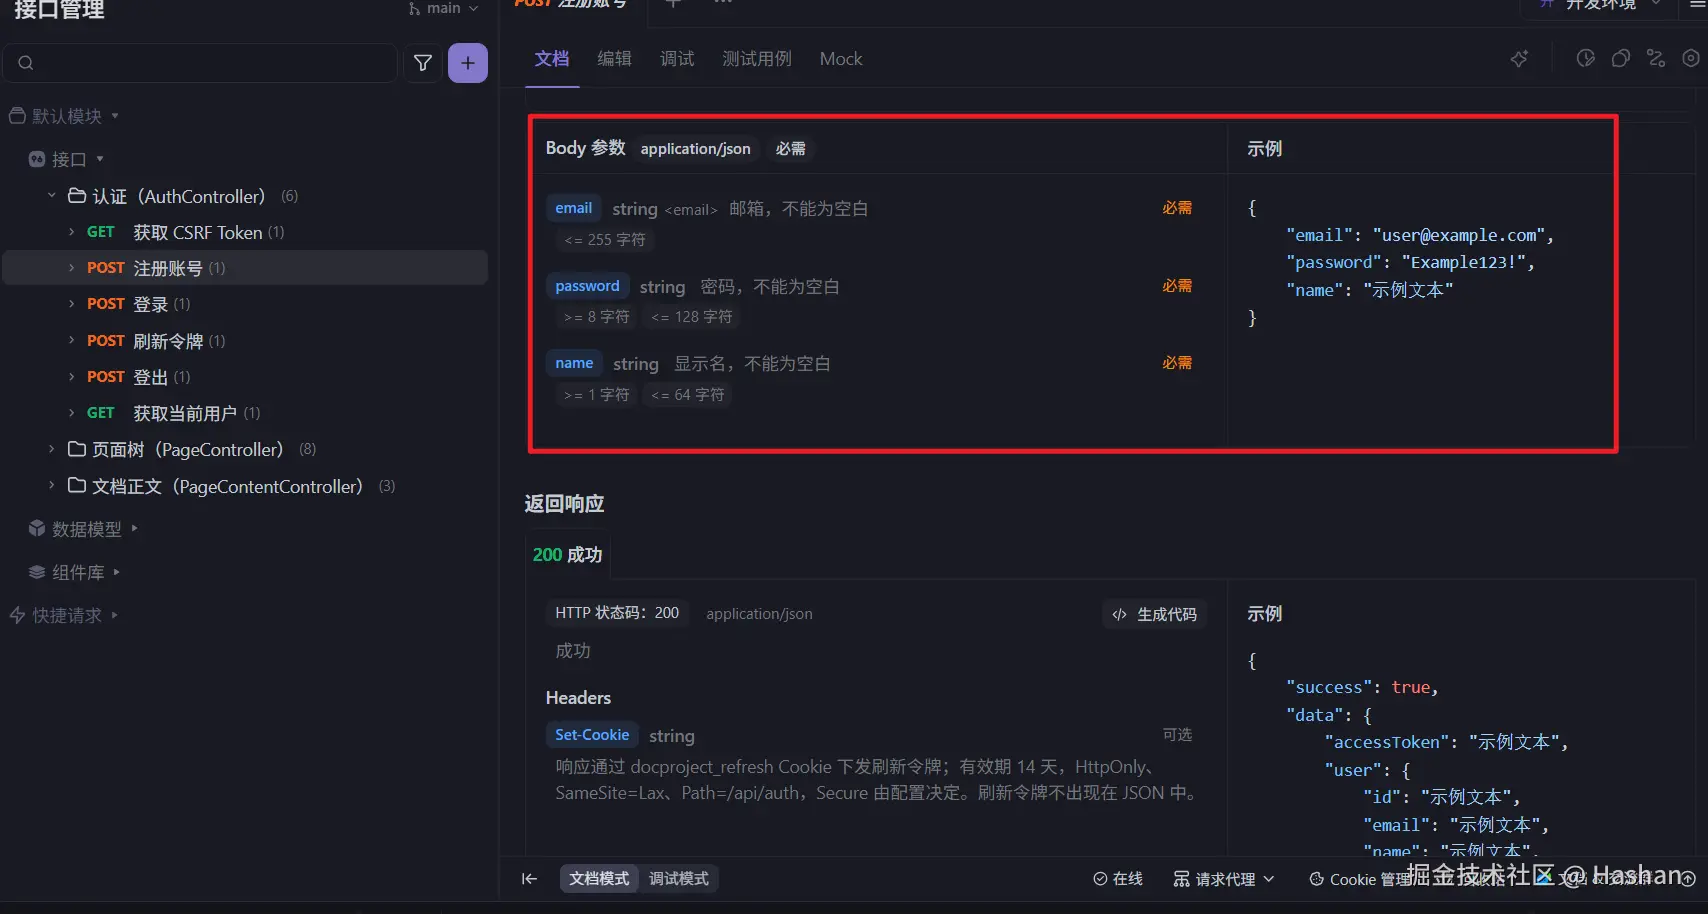 前端也可以通过官方 Apifox Skill 读取同一项目中的接口,减少重复粘贴。接口契约发生变化后,后端重新生成并确认变更,再更新到同一位置。
六、实际使用:从后端交付到前端对接
第一步:后端生成控制器文档
在能够访问后端代码的 Agent 中调用已安装的自定义 Skill:
bash
使用 $java-controller-api-docs,生成 BreedingSupplierController 的接口文档。
只在对话中展示 Markdown,所有接口结束后附上带中文注释的 Java 实体模型。
后端重点确认请求参数的位置和必填性、响应包装层级、字段类型,以及所有标注"(推测)"的内容。静态分析不能覆盖的动态返回、全局响应包装或业务分支,需要补充核实。
第二步:确认后同步到指定项目
xml
文档内容确认,使用官方 apifox-cli Skill 同步到 Apifox。
项目 ID:<实际项目 ID>
目标分支:<实际分支名>
目标分组:业务接口 / 供应商管理(BreedingSupplierController)
CLI 临时 JSON 工作目录:<本地工作目录>

缺少的接口新增,已有接口更新本次确认的参数、响应结构和示例。
保留原有测试和脚本,不删除旧接口。完成后回读核对。
这里明确提供工作目录,是因为 CLI 的 schema 校验和写入可能需要临时 JSON 文件,而自定义 Skill 默认不会主动落盘。需要保存 Markdown 文档时,也应单独指定输出路径。
如果目标分支不允许外部 AI 直接编辑,按 Apifox 的权限提示选择处理方式;不能把写入失败报告成同步完成。
第三步:前端基于确认后的契约实现
前端可以直接使用已确认的 Markdown,也可以通过官方 Skill 从 Apifox 获取接口。关键是明确项目和分组,并同时提供当前前端项目的实现约束:
读取指定 Apifox 项目中"供应商管理"分组的接口,完成当前页面的接口对接。
复用项目已有的请求封装、分页组件和错误处理方式。
根据确认的请求、响应结构编写 TypeScript 类型,保留现有页面字段。
遇到缺失的字段说明或不明确的返回类型时指出问题,不自行增加多套返回结构兼容逻辑。
接口对接完成后,仍要进行真实请求和必要的页面验证。示例能说明预期结构,但不能代替运行结果。
在我和后端同事的协作中,这套方式让接口交付更统一,减少了我手工整理字段和反复确认返回层级的工作。节省下来的时间,可以更多地用于检查 AI 生成代码的类型、组件边界和项目结构。
对我来说,Vibe Coding 中值得先投入的工作之一,就是把交给 AI 的接口信息准备好:源码注释提供依据,固定格式文档便于确认,Apifox 保存团队共同使用的接口契约。