Java 调用 Python 服务,报错后该从哪里查起?
最近处理一个数据质量评测的问题:选好文本数据集,提交任务,页面一直显示处理失败。服务端能找到一条 Python 异常:
text
Precision not allowed in integer format specifier单看这句话,很难把它和数据集联系起来。它说的是格式化错误,似乎改一下 Python 就行。但这个任务最后需要改的地方,在 Java 导出数据的逻辑里。
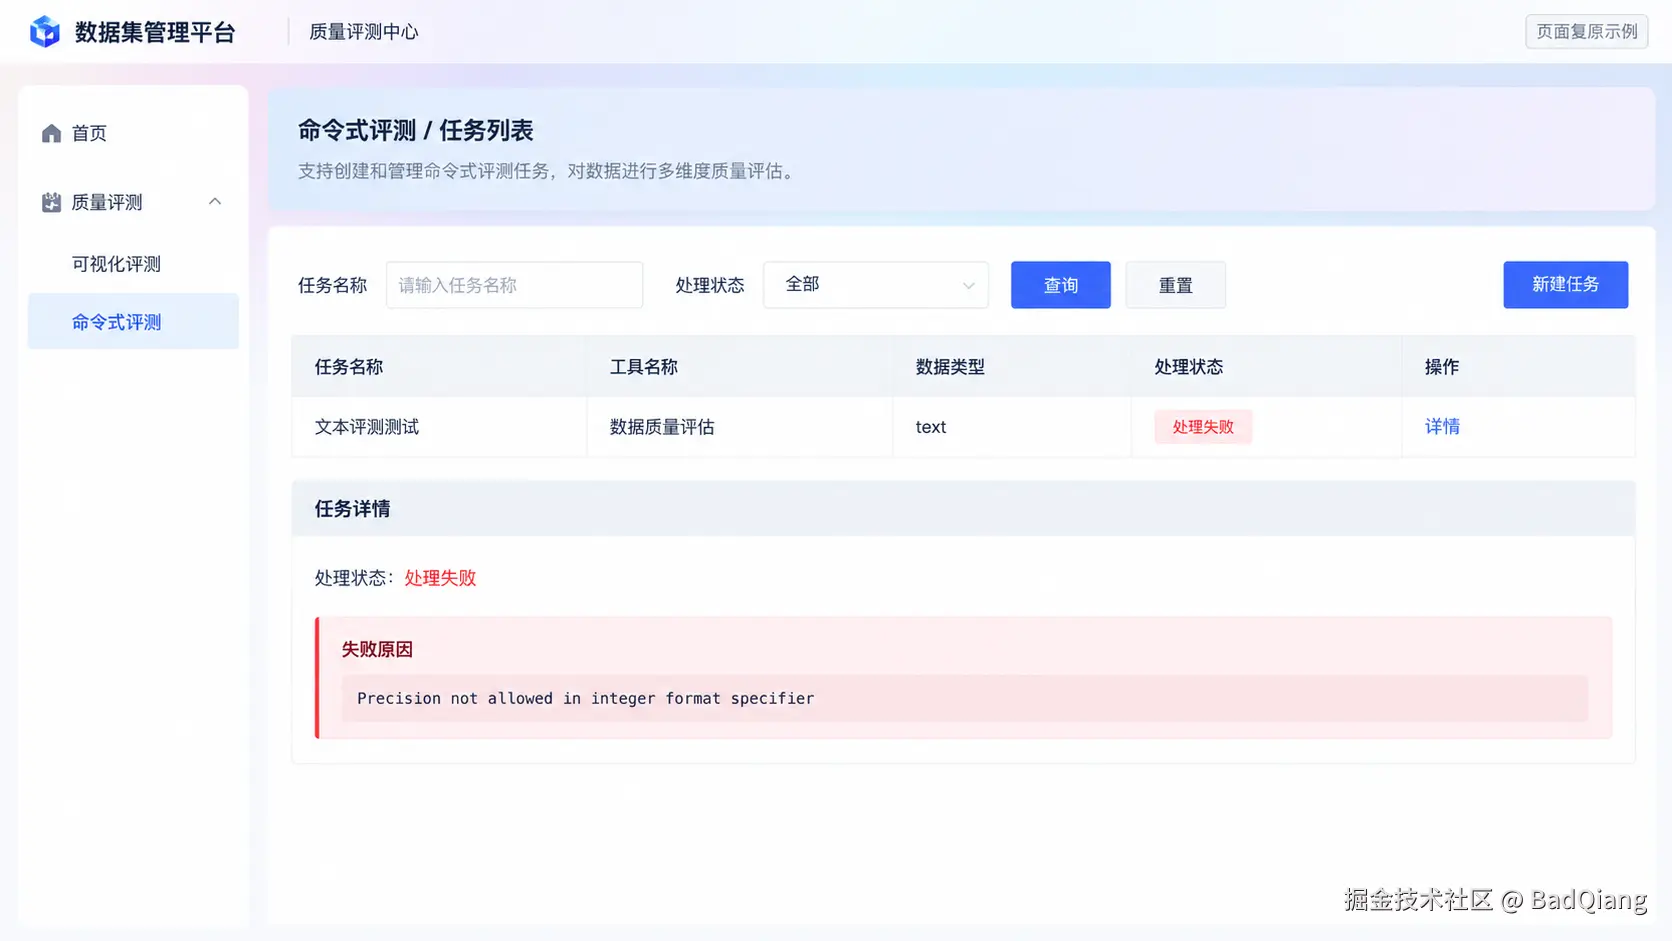 界面复原示例,错误文本来自实际排查记录。
报错发生在计算结果之后
工具会统计文件的有效比例,再把结果格式化成字符串。空结果对应的比例是整数 0,后续却使用了 .2 这种格式。用下面几行代码就能复现相同异常:
python
ratio = 0
print(f"{ratio:.2}%")
格式化代码确实有问题。不过,真正影响这个任务的是:为什么工具算出来的是空结果?
数据库里有非空文本。继续核对任务对应的文件,发现对象存储中的 fileList.txt 是 0 字节,工具日志里下载的文件数量也是 0。
这里有个背景:Java 并不直接把正文传给 Python。它先导出数据,把文件和文件清单上传到对象存储,Python 再按清单下载。
text
用户提交评测任务
    ↓
Java 读取数据集,导出待评测文件
    ↓
上传数据文件和文件清单到对象存储
    ↓
Python 工具下载文件,执行评测
    ↓
生成报告,回传任务结果
清单是空的,Python 自然拿不到输入。于是接下来查的是 Java 如何生成这份清单。
文本数据走到了媒体文件的分支
前端提交的参数中,数据类型长这样:
json
{"dataType": "text"}后端原来只接受数字,或者能转成数字的字符串。text 解析失败后,代码会再根据数据集类型判断。但这个回退逻辑只识别旧的文本类型,当前使用的新文本类型没有被识别出来,最后走了媒体文件导出分支。
媒体分支读取的是 originFilePath,文本正文却存在 input 中。没有文件路径的记录被跳过,整份清单就空了。
这个地方比较容易漏查:数据库查询没有失败,上传空文件也能成功。数据在业务分支里被跳过了,直到后面执行评测才暴露出来。
修复主要是补上命名类型的映射,让 text 能进入文本处理分支。数字类型仍保留兼容,回退判断也改为使用实际的数据集类型。
到这里,原来那条 Python 异常就能解释了:上游导出空清单,下游拿到空结果,最后在输出比例时抛出格式化异常。只改最后的格式化代码,任务依然没有数据可评测。
非空文件也不一定能被读进去
补上导出逻辑还不够。单独拿一份有内容的 TXT 测工具,读取仍然失败。
它在 pandas 读取 TXT 时,把换行符设置成了分隔符,当前安装版本不接受这种用法。结果还是没有有效输入,只是这次文件确实有内容。
工具还有 JSONL 的读取方式,测试这条路径能正常工作。所以这次把导出文件改成 UTF-8 JSONL,使用工具要求的 text 字段:
json
{"text":"这是一条待评测文本"}
{"text":"正文里也可以包含换行\n以及引号\""}
Java 导出时,每条记录序列化成一个 JSON 对象,再追加换行符。省略其他业务代码,写法是:
java
String line = JSON.toJSONString(
    Collections.singletonMap("text", input)
);
dataChannel.write((line + "\n").getBytes(StandardCharsets.UTF_8));
正文中的换行会被转义,不会把同一条记录拆成多行。这也是这里选择 JSONL 的一个好处;直接拼接正文和换行符,遇到多段文本就不容易区分记录边界。
这次外置工具只有编译后的 Python 文件,没有直接改它。TXT 读取和空结果格式化的问题还需要工具维护方处理,当前任务使用的是已经验证可用的 JSONL 路径。
更新服务后,还遇到了一次误判
用正常文本和完整评测配置单独测试,报告已经能生成。服务更新后,页面上却还有任务失败,报错也没变。
核对时间才发现,这个任务的空清单是在发布前生成的。后面的执行步骤虽然由新服务处理,用的仍然是旧文件,并没有重新导出正文。重新创建任务后,页面复测才通过。
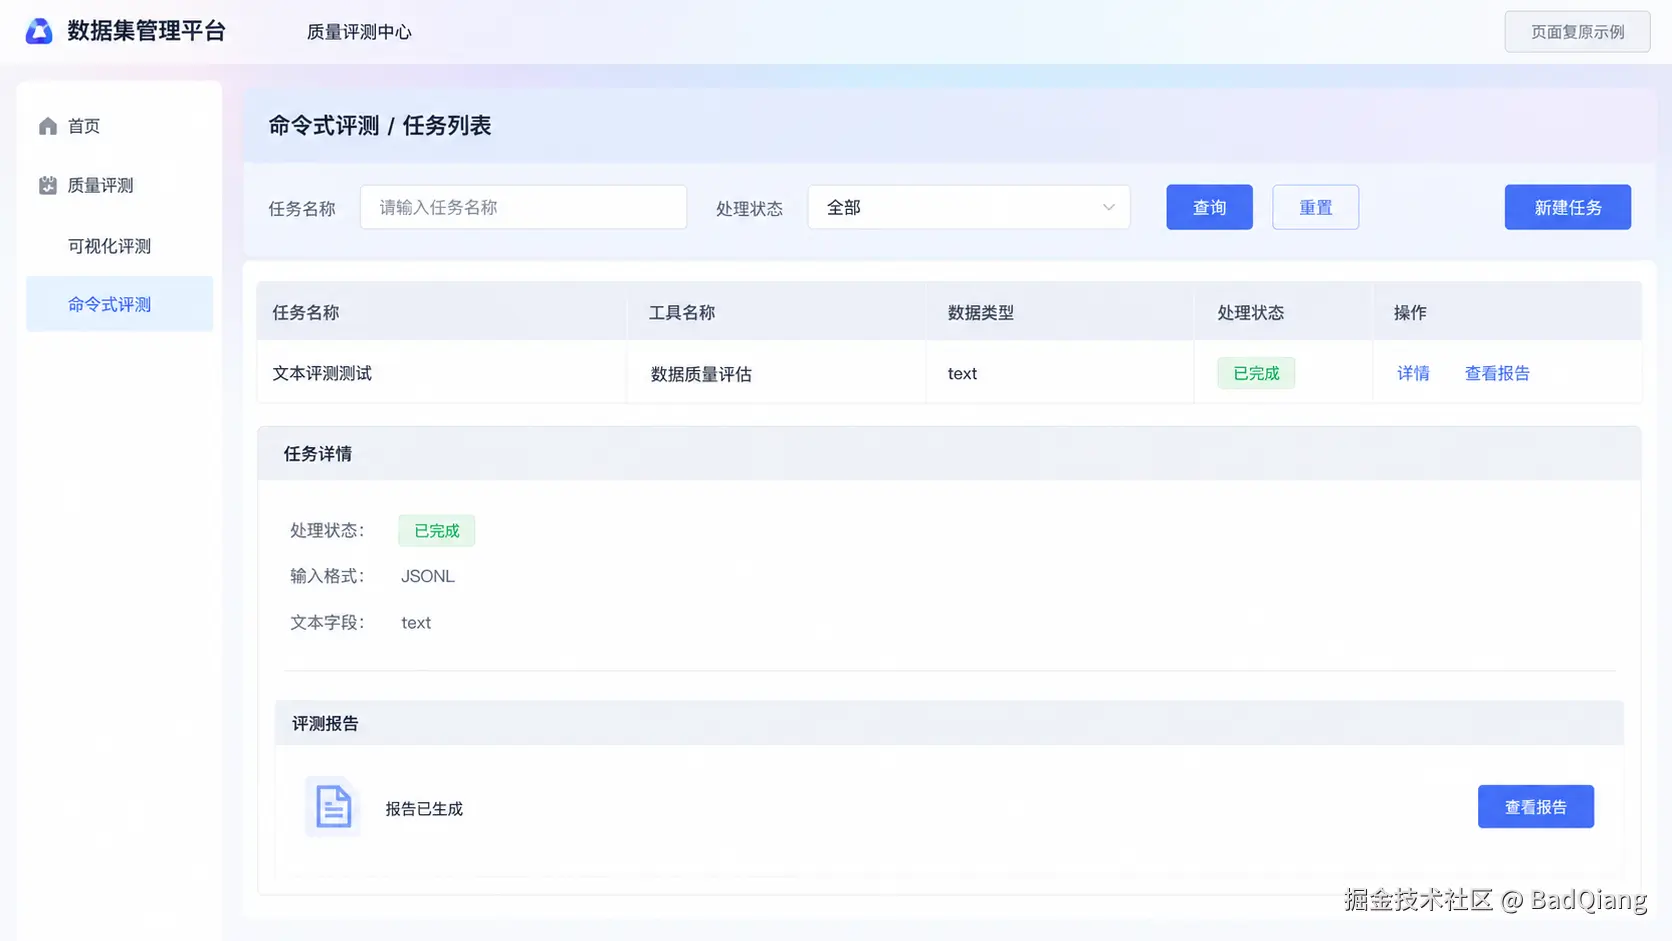 界面复原示例,用于说明完成状态,不是原始评测报告。
这次问题绕的地方在于,同一条 Python 异常背后,既可能是文件根本没生成,也可能是文件生成了但读不进去。查到后面,报错文本本身已经给不了更多信息,得去看这次任务实际生成了什么、工具实际读到了什么。
如果你的服务也是通过文件或对象存储传数据,可以先找出一次失败请求对应的中间文件。对照源数据看一眼内容,往往比反复检查容器状态更有用。