大家好,我是晚安code。
订单导出任务挂了,日志第一行是 java.lang.OutOfMemoryError: Java heap space。有人扫了一眼说「栈溢出了」,反手把 -Xss 调到 4M 重启,第二天同一时间照挂。
这类乌龙在排查现场特别常见。根子在于 JVM 内存结构没理清------哪块区域装什么、各自会抛什么错、对应哪条命令,是后面所有调优和排查的地基。
这篇是 JVM 系列的入门篇「初识」,只讲最基础的四块:程序计数器、虚拟机栈、本地方法栈、堆。每块都给出定义、会出什么问题,示例代码我在本机跑过,报错和诊断命令的输出都是真的截出来的。
一、先把地图摊开:JVM 内存结构分成哪几块
JVM 内存结构(JVM Runtime Data Area,运行时数据区):JVM 启动之后向操作系统要来、专门用来跑 Java 程序的那几块内存。你可以当成一套合租房------有三个房间是每人一间,客厅和厨房是大家共用。
按 JVM 规范,运行时数据区分五块,但归属只有两类:
- 每个线程各留一份的:程序计数器、虚拟机栈、本地方法栈
- 全进程共用一份的:堆、方法区
「线程私有」的意思是,你起一个线程,JVM 就单独给它配一套,线程结束跟着销毁。所以线程开得越多,私有这部分占的内存就越多------记住这句话,第三章讲 -Xss 的代价时要用到。
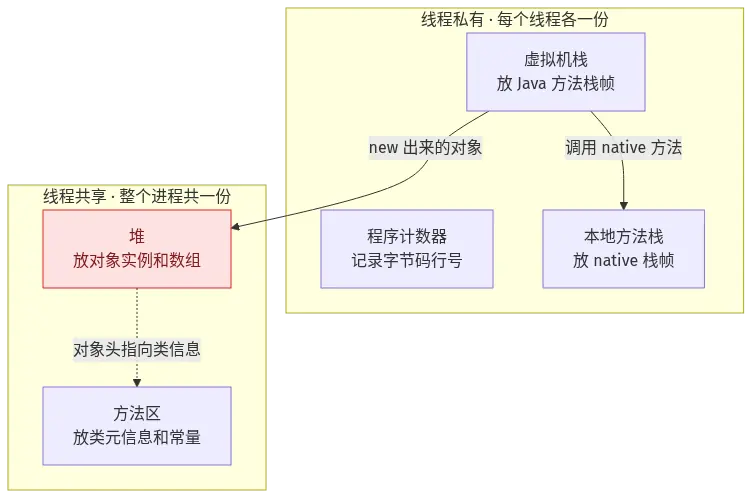
先给一张表,把五块区域的职责和「会不会出事」摆在一起:
| 区域 | 装什么 | 谁持有 | 会不会抛 OOM |
|---|---|---|---|
| 程序计数器 | 当前字节码指令的地址 | 每线程一份 | 不会 |
| 虚拟机栈 | Java 方法的栈帧 | 每线程一份 | 会(实际更常见的是栈溢出) |
| 本地方法栈 | native 方法的栈帧 | 每线程一份 | 会 |
| 堆 | 对象实例、数组 | 全进程一份 | 会,最常遇到 |
| 方法区 | 类元信息、常量 | 全进程一份 | 会 |
方法区(JDK 8 之后叫元空间)是下一篇的主角,这篇只在必要的时候带一句。
二、程序计数器:唯一不会抛 OOM 的一块内存
程序计数器(Program Counter Register):一块很小、线程私有的内存,存的是当前线程正在执行的那条字节码指令的地址。你理解成看书时夹在页缝里的手指头就行------合上书再打开,手指还按在原来那一行。
字节码解释器干活的方式是循环:取一条指令、执行、改一下计数器的值、再取下一条。分支、循环、跳转、异常处理、线程切换后恢复现场,全都得知道「刚才做到哪了」,靠的就是它。
为什么必须是线程私有:CPU 时间片是轮着给的,A 线程跑到一半被切走,B 上来跑一会儿,再切回 A。如果大家共用一个计数器,A 回来时就不知道该从哪继续了。所以每个线程一份,各记各的。
有个细节值得单独拎出来:线程正在执行 native 方法的时候,程序计数器的值是 undefined。因为 native 方法的代码在 C/C++ 里,不受 JVM 字节码那一套管,计数器这时候指无可指。JVMS 第 2.5.1 节写得很直白,原文就是 undefined。
那为什么它不会 OOM?因为这块内存压根不需要扩容------它只需要放得下一个指令地址,宽度在平台确定时就定死了。规范里给五块区域都写了异常情形,唯独程序计数器一个 OutOfMemoryError 都没规定,这是全 JVM 独一份。
顺带说个容易搞混的点:你没法用任何工具直接观测程序计数器。 异常栈里那些 CategoryTreeDemo.java:21 的行号,是 JVM 查 class 文件里的 LineNumberTable 得到的,跟运行时的 pc 寄存器不是同一个东西。两者反映的是同一个"位置",但别在面试里说成"栈帧里能查到程序计数器的值"。
三、虚拟机栈:一个方法一个栈帧,栈溢出从这来
虚拟机栈(Java Virtual Machine Stack):线程私有的内存,描述的是 Java 方法执行的内存模型。每调用一个方法,JVM 就压一个栈帧进去;方法返回,栈帧弹出。跟食堂里那摞餐盘一个道理------后放的压在上面,拿也从最上面拿。
栈帧(Stack Frame):一次方法调用对应的一块内存,里面装四样东西:局部变量表、操作数栈、动态链接、返回地址。
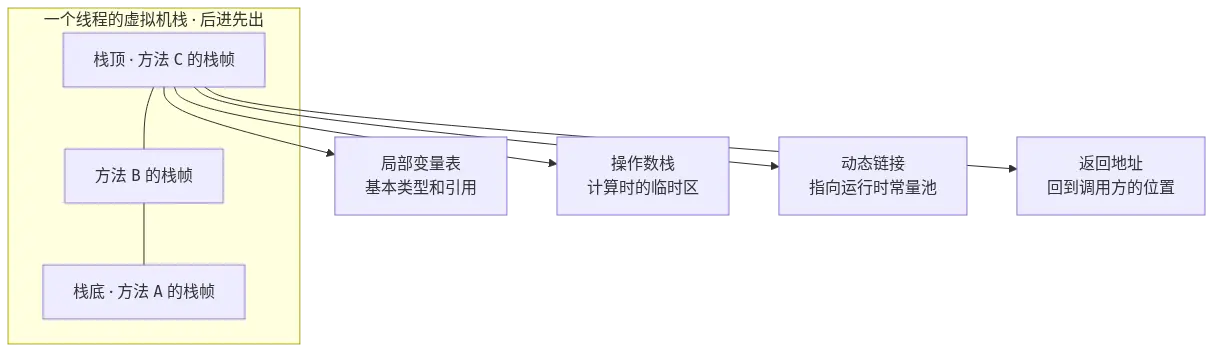
这四样里,新手最容易理解错的是局部变量表:
- 基本类型(int、long、float 这些)直接存值
- 对象类型存的是引用,对象本体在堆里
所以"栈上分配对象"这句流传很广的话是有问题的。栈上放的是指向对象的引用,不是对象本身。唯一的例外是 JIT 的逃逸分析把没跑出方法外的对象拆成标量、直接在栈上放字段------那是编译器的优化,不是你写代码时能指望的东西。
再记一句结论:虚拟机栈这片内存,方法进进出出就是压栈弹栈,它的容量在 HotSpot 上由 -Xss 定死,不会自己长大。 装不下的结果就是 StackOverflowError。
规范里其实规定了两种异常,别记混:
- 栈不允许 动态扩展时,线程请求的栈深度超过最大深度 →
StackOverflowError - 栈允许 动态扩展但扩不出来 →
OutOfMemoryError
HotSpot 属于第一种,栈大小拿 -Xss 一锤定音。所以真实项目里你撞到的几乎都是 StackOverflowError,不是栈的 OOM。
实测:一个配错环的类目树怎么撑爆栈
光说"递归太深会溢出"没意思,我拿一个业务里真会碰上的场景来试:类目树向上找根节点,而运营后台把父子关系配成了环。
先看数据,CategoryTreeDemo 里的类目表:
java
// 类目表:类目 id -> 父类目 id
private static final Map<Long, Long> PARENT_OF = new HashMap<Long, Long>();

static {
    PARENT_OF.put(1001L, 1002L);
    PARENT_OF.put(1002L, 1003L);
    PARENT_OF.put(1003L, 1001L); // 手滑把父级配反了,1003 又指回 1001,成环
}
1001 的父级是 1002,1002 的父级是 1003,1003 的父级又指回 1001。找根节点的递归出口是"父级为 null",可这个环里永远走不到 null:
java
/** 一路向上找根类目;父级为 null 说明自己就是顶层 */
static Long findRoot(Long categoryId) {
    Long parentId = PARENT_OF.get(categoryId);
    if (parentId == null) {
        return categoryId;
    }
    return findRoot(parentId);
}
拿 -Xss512k 跑一下:
bash
java -Xss512k -cp . CategoryTreeDemo输出(真实截取,中间重复帧略):
text
Exception in thread "main" java.lang.StackOverflowError
	at java.util.HashMap.getNode(HashMap.java:573)
	at java.util.HashMap.get(HashMap.java:558)
	at CategoryTreeDemo.findRoot(CategoryTreeDemo.java:21)
	at CategoryTreeDemo.findRoot(CategoryTreeDemo.java:25)
	at CategoryTreeDemo.findRoot(CategoryTreeDemo.java:25)
	...(同一帧重复到被 JVM 截断)
这坨输出里怎么找元凶,有个很实用的套路:从最上面往下扫,找第一处"你自己写的类" 。前两帧是 HashMap 在查表,那是 findRoot 内部的普通调用,属于被牵连的;从第三帧开始,CategoryTreeDemo.findRoot 开始一遍遍重复,第 25 行正是那句 return findRoot(parentId)------递归没出口,实锤。
对比一下第 21 行和第 25 行:21 行只出现一次,25 行重复到刷屏。这就是"逐层往下走"和"原地打转"的区别,看重复帧的起止位置,比读报错文案快得多。
有个坑要说:JVM 默认只打印 1024 帧 ,多的会被截掉。所以日志里那些重复帧是被砍过的,别以为"就循环了几十次"。要看得更深可以调 -XX:MaxJavaStackTraceDepth,不过实际排查里没必要------重复帧只要出现,问题就已经定性了。
最后说 -Xss 本身。栈是每个线程一份,你把它从默认的 1M 调到 4M,线程池里 200 个线程就多占 600M。调之前先想清楚:是单线程递归真的太深了,还是线程数本来就多。前者可以考虑调,后者应该改算法,别把参数当创可贴。
四、本地方法栈:和虚拟机栈长得像,服务对象不一样
本地方法栈(Native Method Stack):作用和虚拟机栈几乎一模一样的内存区域,区别只在于它服务的是 native 方法------那些用 C/C++ 写好、通过 JNI 调进来的方法,而虚拟机栈服务的是 Java 方法。
规范对本地方法栈的要求很松,没规定具体实现。HotSpot 干脆把它和虚拟机栈合成了一块 ,所以你在 HotSpot 上找不到单独给本地方法栈配大小的参数,-Xss 管的是合起来的那整块。
这带来一个很实际的结果:在 HotSpot 上你基本看不到"本地方法栈溢出"这种独立报错。 native 调用压的帧和 Java 方法压的帧挤在同一摞餐盘里,撑爆了,抛的还是 StackOverflowError。
那它什么时候会真的被踩到?主要是大量 JNI 调用的场景:加解密、压缩、图像处理的底层库,不少是 native 实现的,每次调用都要在这块栈上占位置。如果你线上有个类库底层是 JNI,又赶上递归调用,栈溢出的速度会比纯 Java 代码快------因为每层占的栈空间可能更大。
这个区域本身没什么可调的,理解到"HotSpot 上和虚拟机栈是一块"就够了。
五、堆:线程共享的最大一块,也是 OOM 重灾区
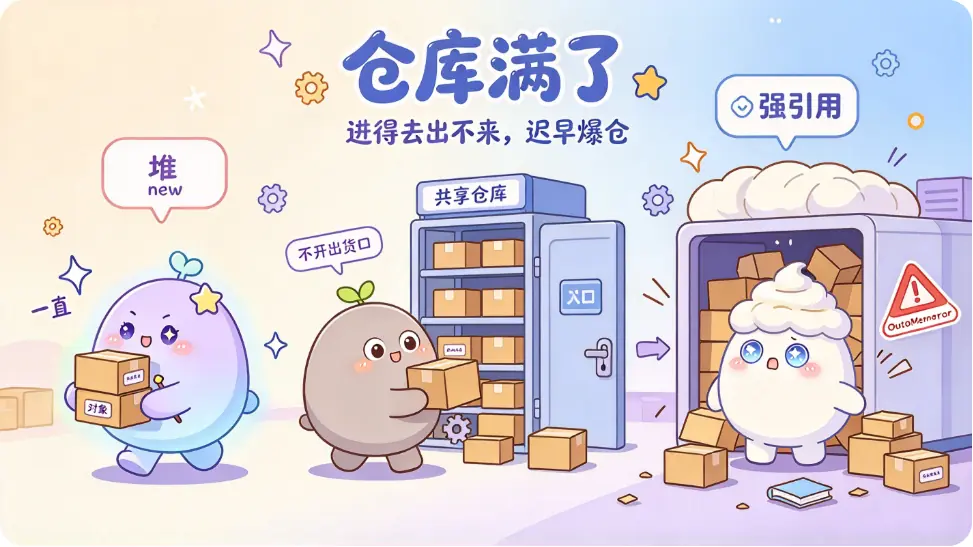
堆(Java Heap) :JVM 管理的内存里最大的一块,所有线程共享,专门用来放对象实例和数组。把它当成仓库------代码里每 new 一个对象,就往仓库里搬一件货;搬进去之后什么时候被清走,由垃圾收集器说了算。
仓库里都堆着什么,列一下比较清楚:
- 所有
new出来的对象和数组,本体都在这 - 从 JDK 7 开始,字符串常量池也从永久代挪进了堆里
- 堆是 GC 的主战场,所以它还有个名字叫「GC 堆」
传统分代的划分是这样的:新生代放刚出炉的对象(绝大多数朝生夕死),熬过几轮 GC 还活着的,晋升到老年代。从 JDK 9 起默认 GC 换成 G1,内存是按 Region 切的,但逻辑上还是分代那套。这块展开又是好几千字,我之前单独写过一篇《JVM 垃圾回收全流程拆解》,这里就不重复了。
参数就两个要紧的:
bash
-Xms512m    # 堆初始大小
-Xmx512m    # 堆最大大小
生产环境通常把这两个设成一样大,为的是避免堆反复扩容收缩带来的额外 GC 和性能抖动。
可能有人会问:
-Xms和-Xmx都设成一样,不就浪费内存了吗?浪费的是"预留但不一定用得上"的部分。设成一样大,JVM 启动时就把这块地址占住,运行时不用再跟操作系统来回要------省下的是伸缩带来的停顿,代价是这部分内存别的进程借不走。对线上服务来说,这笔账通常划算。
实测:一个"分批查询"的导出任务怎么把堆撑爆
这个 bug 特别典型,因为它看上去完全不像 bug------代码本意是"分批查库省内存"。
OrderExportDemo 的主循环:
java
public static void main(String[] args) {
    List<byte[]> loadedPages = new ArrayList<byte[]>();
    int pageNo = 0;

    while (true) {
        loadedPages.add(queryPage(++pageNo)); // 查一页,攒一页
        if (pageNo % 20 == 0) {
            System.out.println("已查 " + pageNo + " 页,全留在内存里没写出去");
        }
    }
}
每一页查回来之后,都 add 进 loadedPages 这个 List 里,从头到尾没释放过。分批查是分了,但查出来的东西全攒在内存里,分批就白分了。
queryPage 每次造一块内存代表一页订单数据:
java
/** 模拟一次分页查询:用一块内存代表这一页的订单数据 */
private static byte[] queryPage(int pageNo) {
    byte[] page = new byte[PAGE_SIZE * 512]; // 每页约 1MB
    page[0] = (byte) pageNo;
    return page;
}
给 64M 堆跑一下,顺便打开堆快照:
bash
java -Xmx64m -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=./export.hprof \
     -cp . OrderExportDemo
真实输出:
text
已查 20 页,全留在内存里没写出去
已查 40 页,全留在内存里没写出去
java.lang.OutOfMemoryError: Java heap space
Dumping heap to ./export.hprof ...
Heap dump file created [61762951 bytes in 0.025 secs]
Exception in thread "main" java.lang.OutOfMemoryError: Java heap space
	at OrderExportDemo.queryPage(OrderExportDemo.java:27)
	at OrderExportDemo.main(OrderExportDemo.java:18)
几个数字值得盯一下。堆上限 64M,堆快照却写出了 61762951 字节,差不多 59M------也就是说 OOM 那一刻,堆里几乎全是这些页数据,别的对象连零头都算不上。堆已经到顶了,回收器也没辙,因为每一页都还被 loadedPages 强引用着,一个都回收不掉。
修法很直接,查一页写一页:
java
byte[] page;
while ((page = queryPage(++pageNo)) != null) {
    writeToFile(page);   // 查一页立刻落盘,写完就不留引用
    page = null;
    loadedPages.clear(); // 如果还要分批统计,攒够一批就清
}
我自己也干过类似的事:看到 OOM 第一反应是把 -Xmx 调大,从 2G 加到 8G,结果第二天同一时间照样挂。堆溢出要先怀疑"有东西该释放没释放",加内存只是把爆炸时间往后推。
六、栈溢出和堆溢出别搞混:区分方法与诊断工具
线上出内存问题,第一步不是改参数,是先把报错看清楚------是栈的事还是堆的事。这一步分错了,后面选命令、改参数全是白干。
先用一张表把两者的差异钉死:
| 栈溢出 StackOverflowError | 堆溢出 OOM: Java heap space | |
|---|---|---|
| 所在区域 | 线程私有,每线程一份 | 全进程共享,就一块 |
| 典型成因 | 递归没有出口、递归太深、调用链太长 | 对象造得比回收得快:缓存没失效、集合攒着不放、一次加载太多数据 |
| 主要排查手段 | 翻异常栈里的重复帧;线程还活着就 jstack |
jmap -histo 看谁占得多;jmap -dump 抓快照 |
| 常用参数 | -Xss |
-Xms / -Xmx / -XX:+HeapDumpOnOutOfMemoryError |
| 加内存管用吗 | 治标,且有代价 | 治标不治本,先找泄漏 |
1)先看进程:jps -l
一切从找到那个 Java 进程开始:
bash
jps -l
text
24764 sun.tools.jps.Jps
27900 JvmTroubleHolder
-l 会打出主类全名,第一行是 jps 自己,忽略。
2)栈的问题:jstack
假设你的服务里有个线程卡在很深的调用链上(没溢出,但已经走不出来了),想知道它卡在哪:
bash
jstack 27900抓到的那个线程(真实截取):
text
"order-sync-worker" #19 prio=5 os_prio=0 tid=0x0000021459afd800 nid=0x75f8 waiting on condition
   java.lang.Thread.State: TIMED_WAITING (sleeping)
	at java.lang.Thread.sleep(Native Method)
	at JvmTroubleHolder.deepCall(JvmTroubleHolder.java:14)
	at JvmTroubleHolder.deepCall(JvmTroubleHolder.java:17)
	at JvmTroubleHolder.deepCall(JvmTroubleHolder.java:17)
	at JvmTroubleHolder.deepCall(JvmTroubleHolder.java:17)
	...(同一帧重复到被截断)
读法和前面那坨 StackOverflowError 一模一样:找重复帧里第一个你自己的类。这里第 17 行重复了 1023 次,就是那个没有出口的递归调用。
可能有人会问:
jstack抓出来满屏重复帧,怎么知道是哪一个方法的问题?看重复帧的第一帧 ------它一定是你自己代码里那个"发起下一层调用"的行。重复帧上面那几帧(比如
Thread.sleep、HashMap.get)是被牵连的叶子节点,它们上面只有一层,说明不了问题。反过来,如果一个方法在栈里只出现一次,那它大概率是无辜的。
注意 jstack 要看的是还活着的进程。如果线程已经因为栈溢出去世了,栈早就退干净了,这时候只能靠异常日志------好在那份日志本身就带重复帧,够用了。
3)堆的问题:jcmd、jmap、jstat
堆的诊断工具多几条,我按"从轻到重"的顺序排。
先看整体水位 ,jcmd 是新版本 JDK 上最稳的选择:
bash
jcmd 27900 GC.heap_info
text
 PSYoungGen      total 75264K, used 16425K
  eden space 64512K, 25% used
  from space 10752K, 0% used
  to   space 10752K, 0% used
 ParOldGen       total 172032K, used 0K
  object space 172032K, 0% used
 Metaspace       used 2944K, capacity 4486K, committed 4864K
新版 JDK 上 jmap -heap 在部分 GC 组合下已经不太好使,jcmd 的 GC.heap_info 是更稳的替代。
想知道谁在占地方,看对象直方图:
bash
jmap -histo:live 27900 | head -12
text
 num     #instances         #bytes  class name
----------------------------------------------
   1:            27       13662232  [B
   2:          2264         297072  [C
   3:           516          63376  java.lang.Class
   4:          2120          50880  java.lang.String
   5:           791          31640  java.util.TreeMap$Entry
第一行 [B 是 byte[],27 个实例占了 13MB,把第二名([C,也就是 char\[\])甩开四十多倍。这种"一类独大"的形状,基本就是泄漏的签名。-histo:live 里的 live 会先触发一次 GC 再统计,所以数出来的是"活着逃过回收的对象",更有参考价值。
要看具体的引用链,就得抓堆快照:
bash
jmap -dump:live,format=b,file=trouble.hprof 27900
text
Dumping heap to C:\...\trouble.hprof ...
Heap dump file created
bash
ls -lh trouble.hprof
text
112M trouble.hprof这个 hprof 文件用 Eclipse MAT 或者 JProfiler 打开,能顺着"谁引用了谁"一路找到那根把对象钉死在内存里的引用。-histo 只能告诉你"凶手是哪一类",快照才能告诉你"凶手被谁扣着"。
想看 GC 是不是在空转 ,用 jstat 采样:
bash
jstat -gcutil 27900 1000 3
text
  S0     S1     E      O      M     CCS    YGC     YGCT    FGC    FGCT     GCT
  0.00   0.00  43.63  43.61  60.57  60.33      2    0.006     2    0.017    0.023
  0.00   0.00  51.56  43.61  60.57  60.33      2    0.006     2    0.017    0.023
  0.00   0.00  57.91  43.61  60.57  60.33      2    0.006     2    0.017    0.023
E(Eden)在涨,O(老年代)纹丝不动------这是正常的对象分配节奏。如果反过来,看到 FGC 次数一路飙升、每次回收后老年代水位都不降,那就是典型的"回收不动了",离 OOM 不远。
最后是事前预防,比事后抓现场省事得多。在启动参数里加一行:
bash
-XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=/data/dump这样下次真 OOM 的时候,JVM 会自己把快照写下来,你人不在现场也拿得到证据。上面那条导出任务的输出里那句 Heap dump file created [61762951 bytes],就是它干的。
这个参数对堆内存溢出有效,但对 StackOverflowError 没用------栈溢出压根没有堆快照可打。这也解释了为什么有人加了它之后,栈溢出时"什么 dump 都没等到"。
4)两个版本上的坑
JDK 9 之后,jvisualvm 和 jhat 不再随 JDK 一起发了。 你在 JDK 8 里用惯的那两个东西,换到新版本会发现找不到命令,得自己单独下(jhat 则是彻底退役了,别再找了)。
本文所有实测输出来自 Windows x64 上的 Corretto 1.8.0_432。不同 JDK 版本、不同 GC 组合下工具的可用性和输出格式会有出入,跑之前先确认下自己环境的版本。
写在最后
说白了,内存区域这块你不需要背得滚瓜烂熟,但得能在看到报错的第一秒判断出:这是栈的事,还是堆的事。是栈,就去翻异常里重复的那几帧,找第一个你自己写的类;是堆,就抓快照看谁占着地方、谁把它扣着不放。
这一步分对了,后面选命令、调参数才不至于瞎折腾------就像开头那个把堆溢出当栈溢出、反手去调 -Xss 的哥们,方向错了,参数调得再准也没用。
下一篇讲方法区和元空间:为什么 JDK 8 要把永久代换掉,以及从堆溢出到元空间溢出之间到底差了什么。感兴趣的可以先收藏。
参考链接
- The Java Virtual Machine Specification, Java SE 8 Edition --- 2.5 Run-Time Data Areas(搜:JVMS 2.5 run-time data areas)
- JDK 8 工具文档:jstack(搜:oracle jdk8 jstack)
- JDK 8 工具文档:jmap(搜:oracle jdk8 jmap)
- JDK 8 工具文档:jcmd(搜:oracle jdk8 jcmd)
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你排查内存问题时踩过最久的坑,是栈的还是堆的?