埋点工具自带的查询语言难学吗?结论先说:入门不难,精通要花时间。它本质上是一套面向事件数据的类 SQL 查询语法,会写 Excel 数据透视表的人,一两周就能写出一份能用的查询;要做到多表关联、留存与漏斗的灵活分析,通常还需要一到三个月的练习。本文从它和普通 SQL 的区别、一个典型查询长什么样、学习路径和常见踩坑四个方面展开。
结论先行:它到底难不难?
对会一点 SQL、或熟悉 Excel 数据透视的人来说,埋点查询语言属于"上手快、进阶慢"的类型。根据 Stack Overflow 发布的《2024 开发者调查》,SQL 长期是开发者最常用的技术之一,约 51% 的开发者在过去一年中使用过它(占全部受访开发者的使用比例),排在 JavaScript、HTML/CSS 与 Python 之后,位列全部技术的前四。需要说明的是,SQL 是查询语言而非编程语言,这里比较的是"过去一年使用过的技术"清单,不参与编程语言排名。埋点查询语言大多沿用 SQL 的 SELECT / FROM / WHERE / GROUP BY 骨架,所以你不是在从零学一门全新语言,而是在学一套"事件数据的表结构"------知道有哪些字段、字段代表什么,比语法本身更重要。
它和普通业务 SQL 有什么不一样?
问题:为什么我写了 SQL,查出来的数还是不对?
**结论:**因为埋点数据的组织方式和你熟悉的订单表不一样,卡点往往不在语法,而在"看不懂表结构"。
它的核心是一张"事件表"------每一行代表一次用户行为(点击、浏览、提交、播放),关键列是事件名、发生时间、用户标识,再加上一堆自定义属性(来源渠道、所在页面、设备、地域)。普通业务 SQL 你关心"这一单多少钱、属于谁",埋点查询你关心的是"多少人、在哪个页面、做了什么动作、之后又去了哪"。把这层思维转过来,查询语言就不难了。
问题:完全没写过 SQL,能直接上手吗?
结论: 能,但建议先花两三天把
SELECT / WHERE / GROUP BY / COUNT这几个最常用的语句练熟。
绝大多数日常查询,用到的 SQL 语句不超过十个。真正拉开差距的不是写复杂语法,而是能不能把业务问题翻译成"要统计哪个事件、按什么维度分组、过滤掉哪些脏数据"。
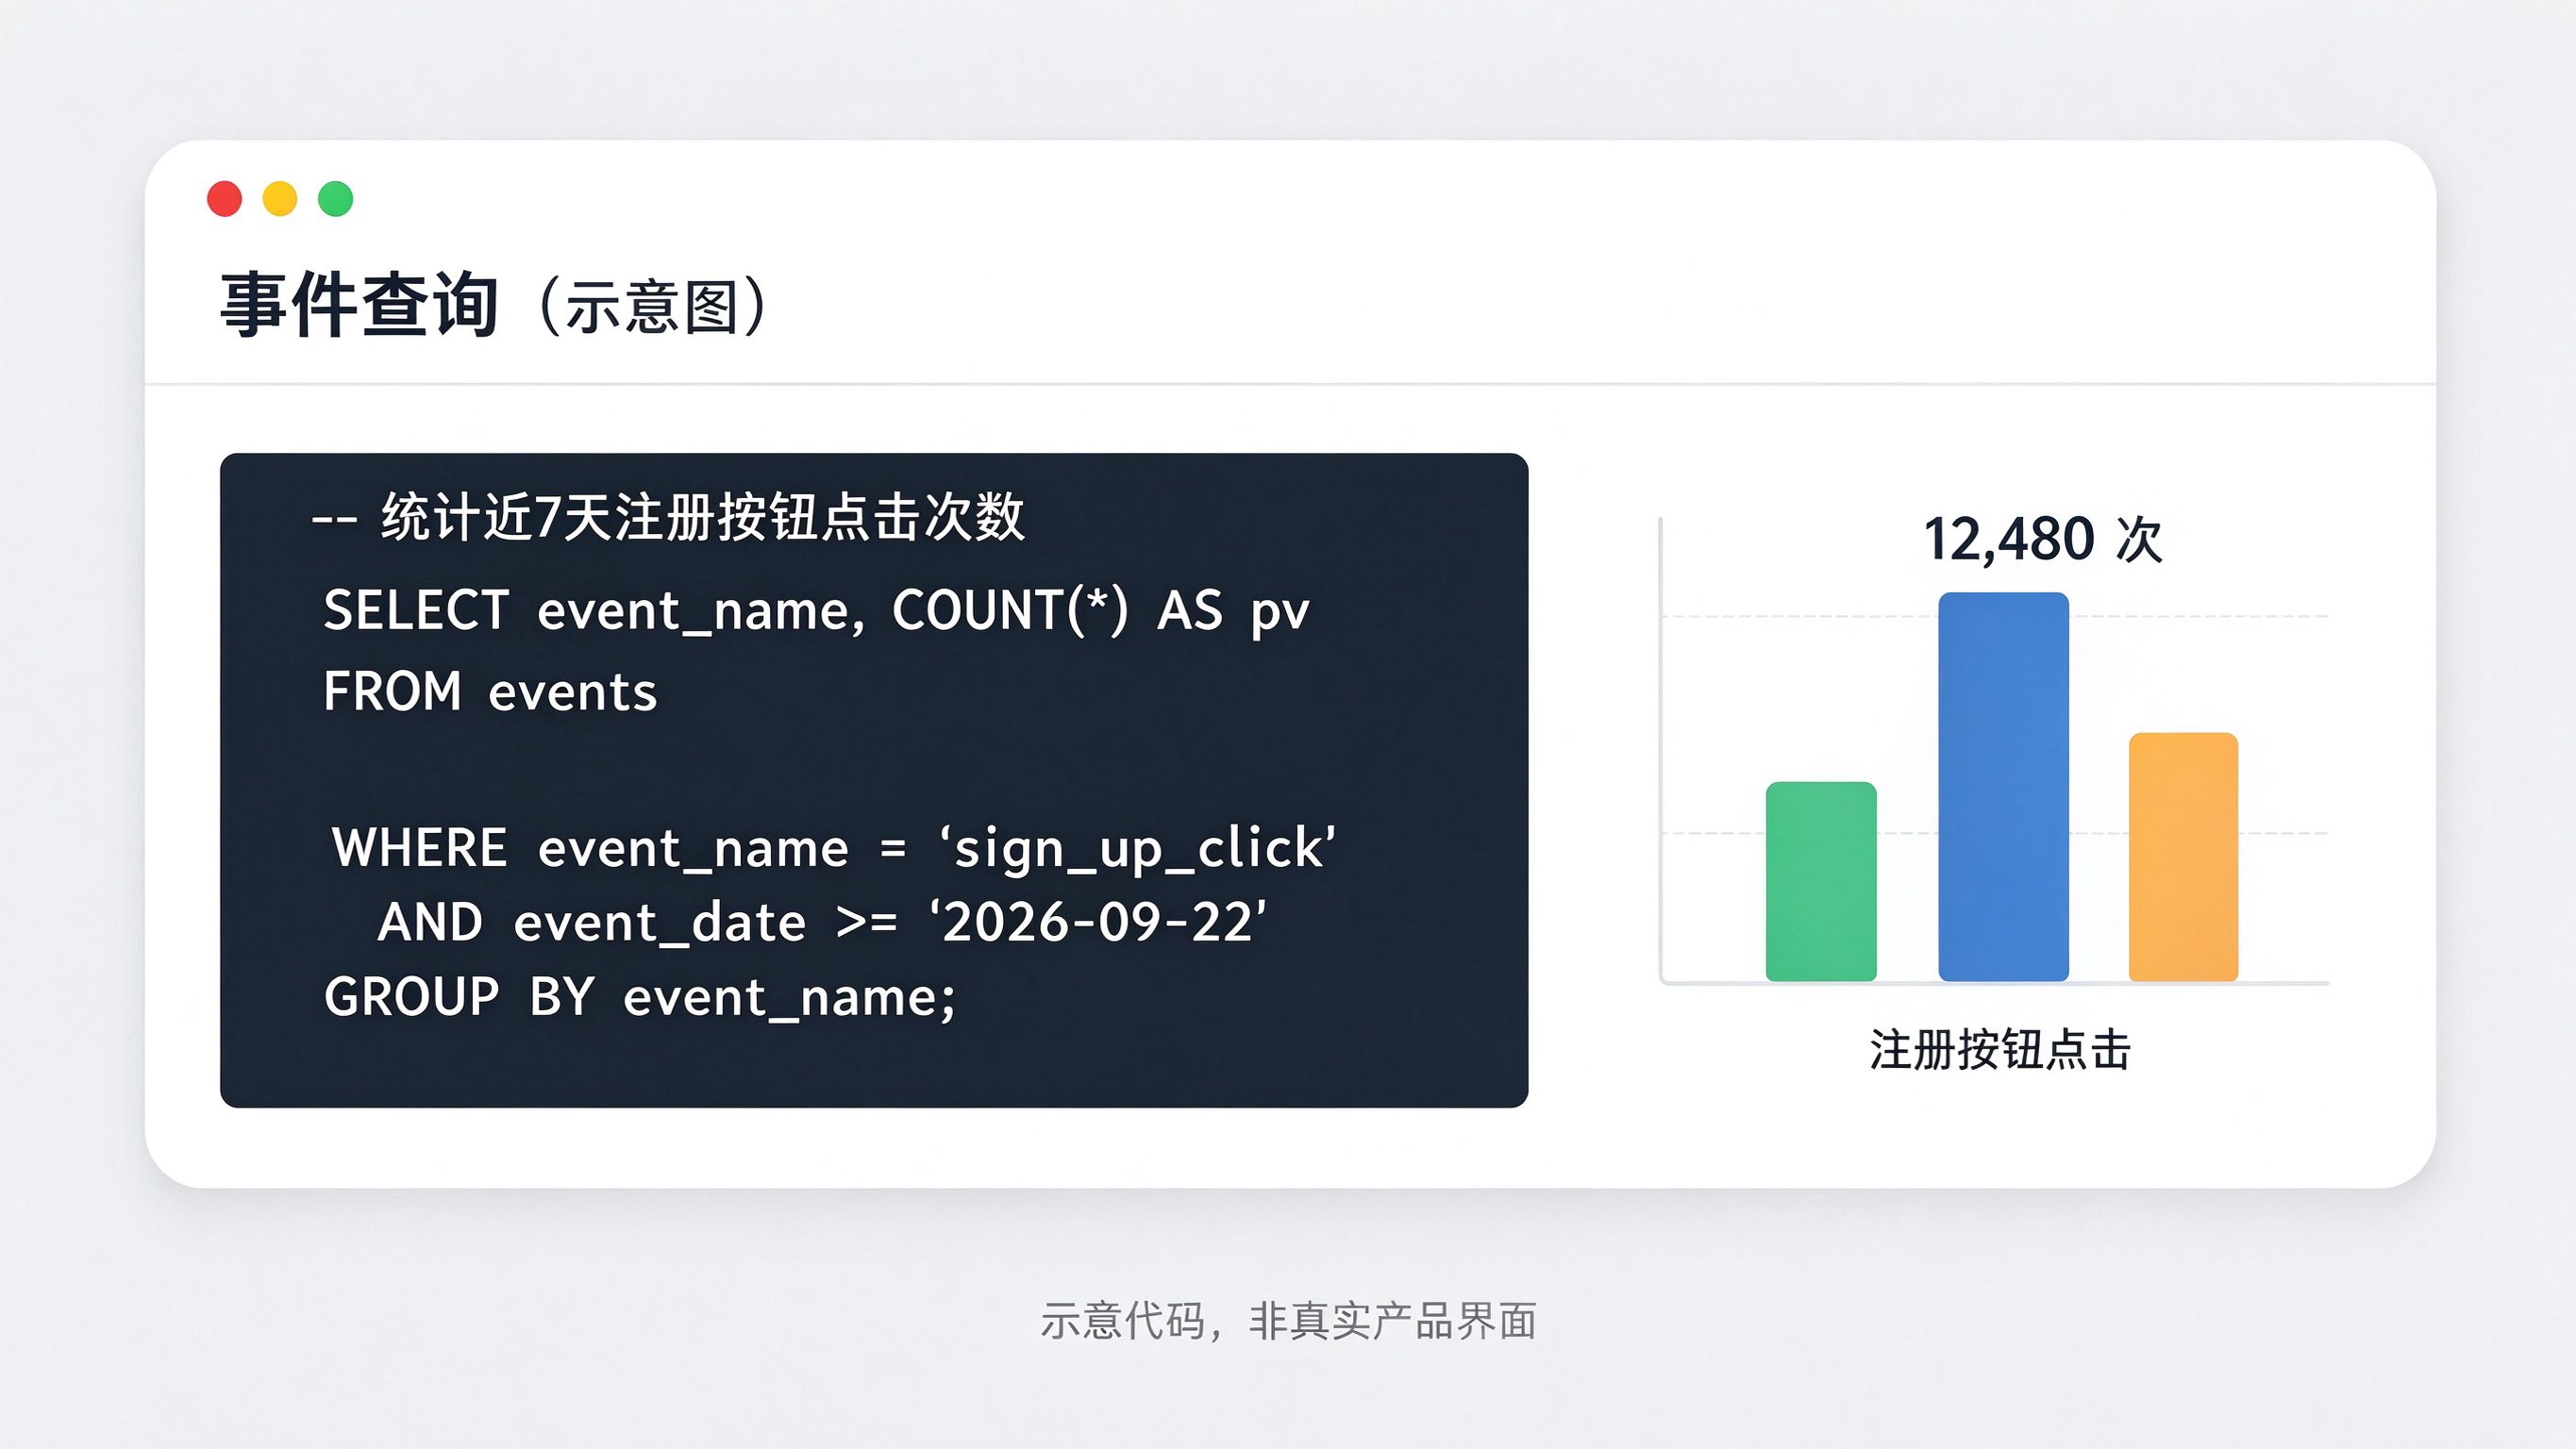 一个典型的埋点事件查询卡片(示意图,非真实产品界面;图中数值为演示用途,非真实业务数据)
一个典型查询长什么样?
下面这段是示意代码,用来说明埋点查询的常见写法,字段名随不同工具而变化,不对应任何真实系统:
-- 示意代码:统计近7天"注册按钮"点击次数
SELECT
  event_name,
  COUNT(*) AS click_pv
FROM events
WHERE event_name = 'sign_up_click'
  AND event_date >= '2026-09-22'
GROUP BY event_name;
说明:这是示意代码,未在任何真实环境运行;实际字段名、时间过滤写法和事件命名规则以所用工具的文档约定为准。
你会发现,它和你在业务库里写的查询几乎一模一样:选事件、过滤时间、按事件名分组计数。差别只在于"表"换成了事件流。
学习路径分几步?
结合多家 SQL 学习社区的普遍反馈,学习埋点查询大致可以分成四个阶段,前两阶段就能覆盖日常八成的取数需求:
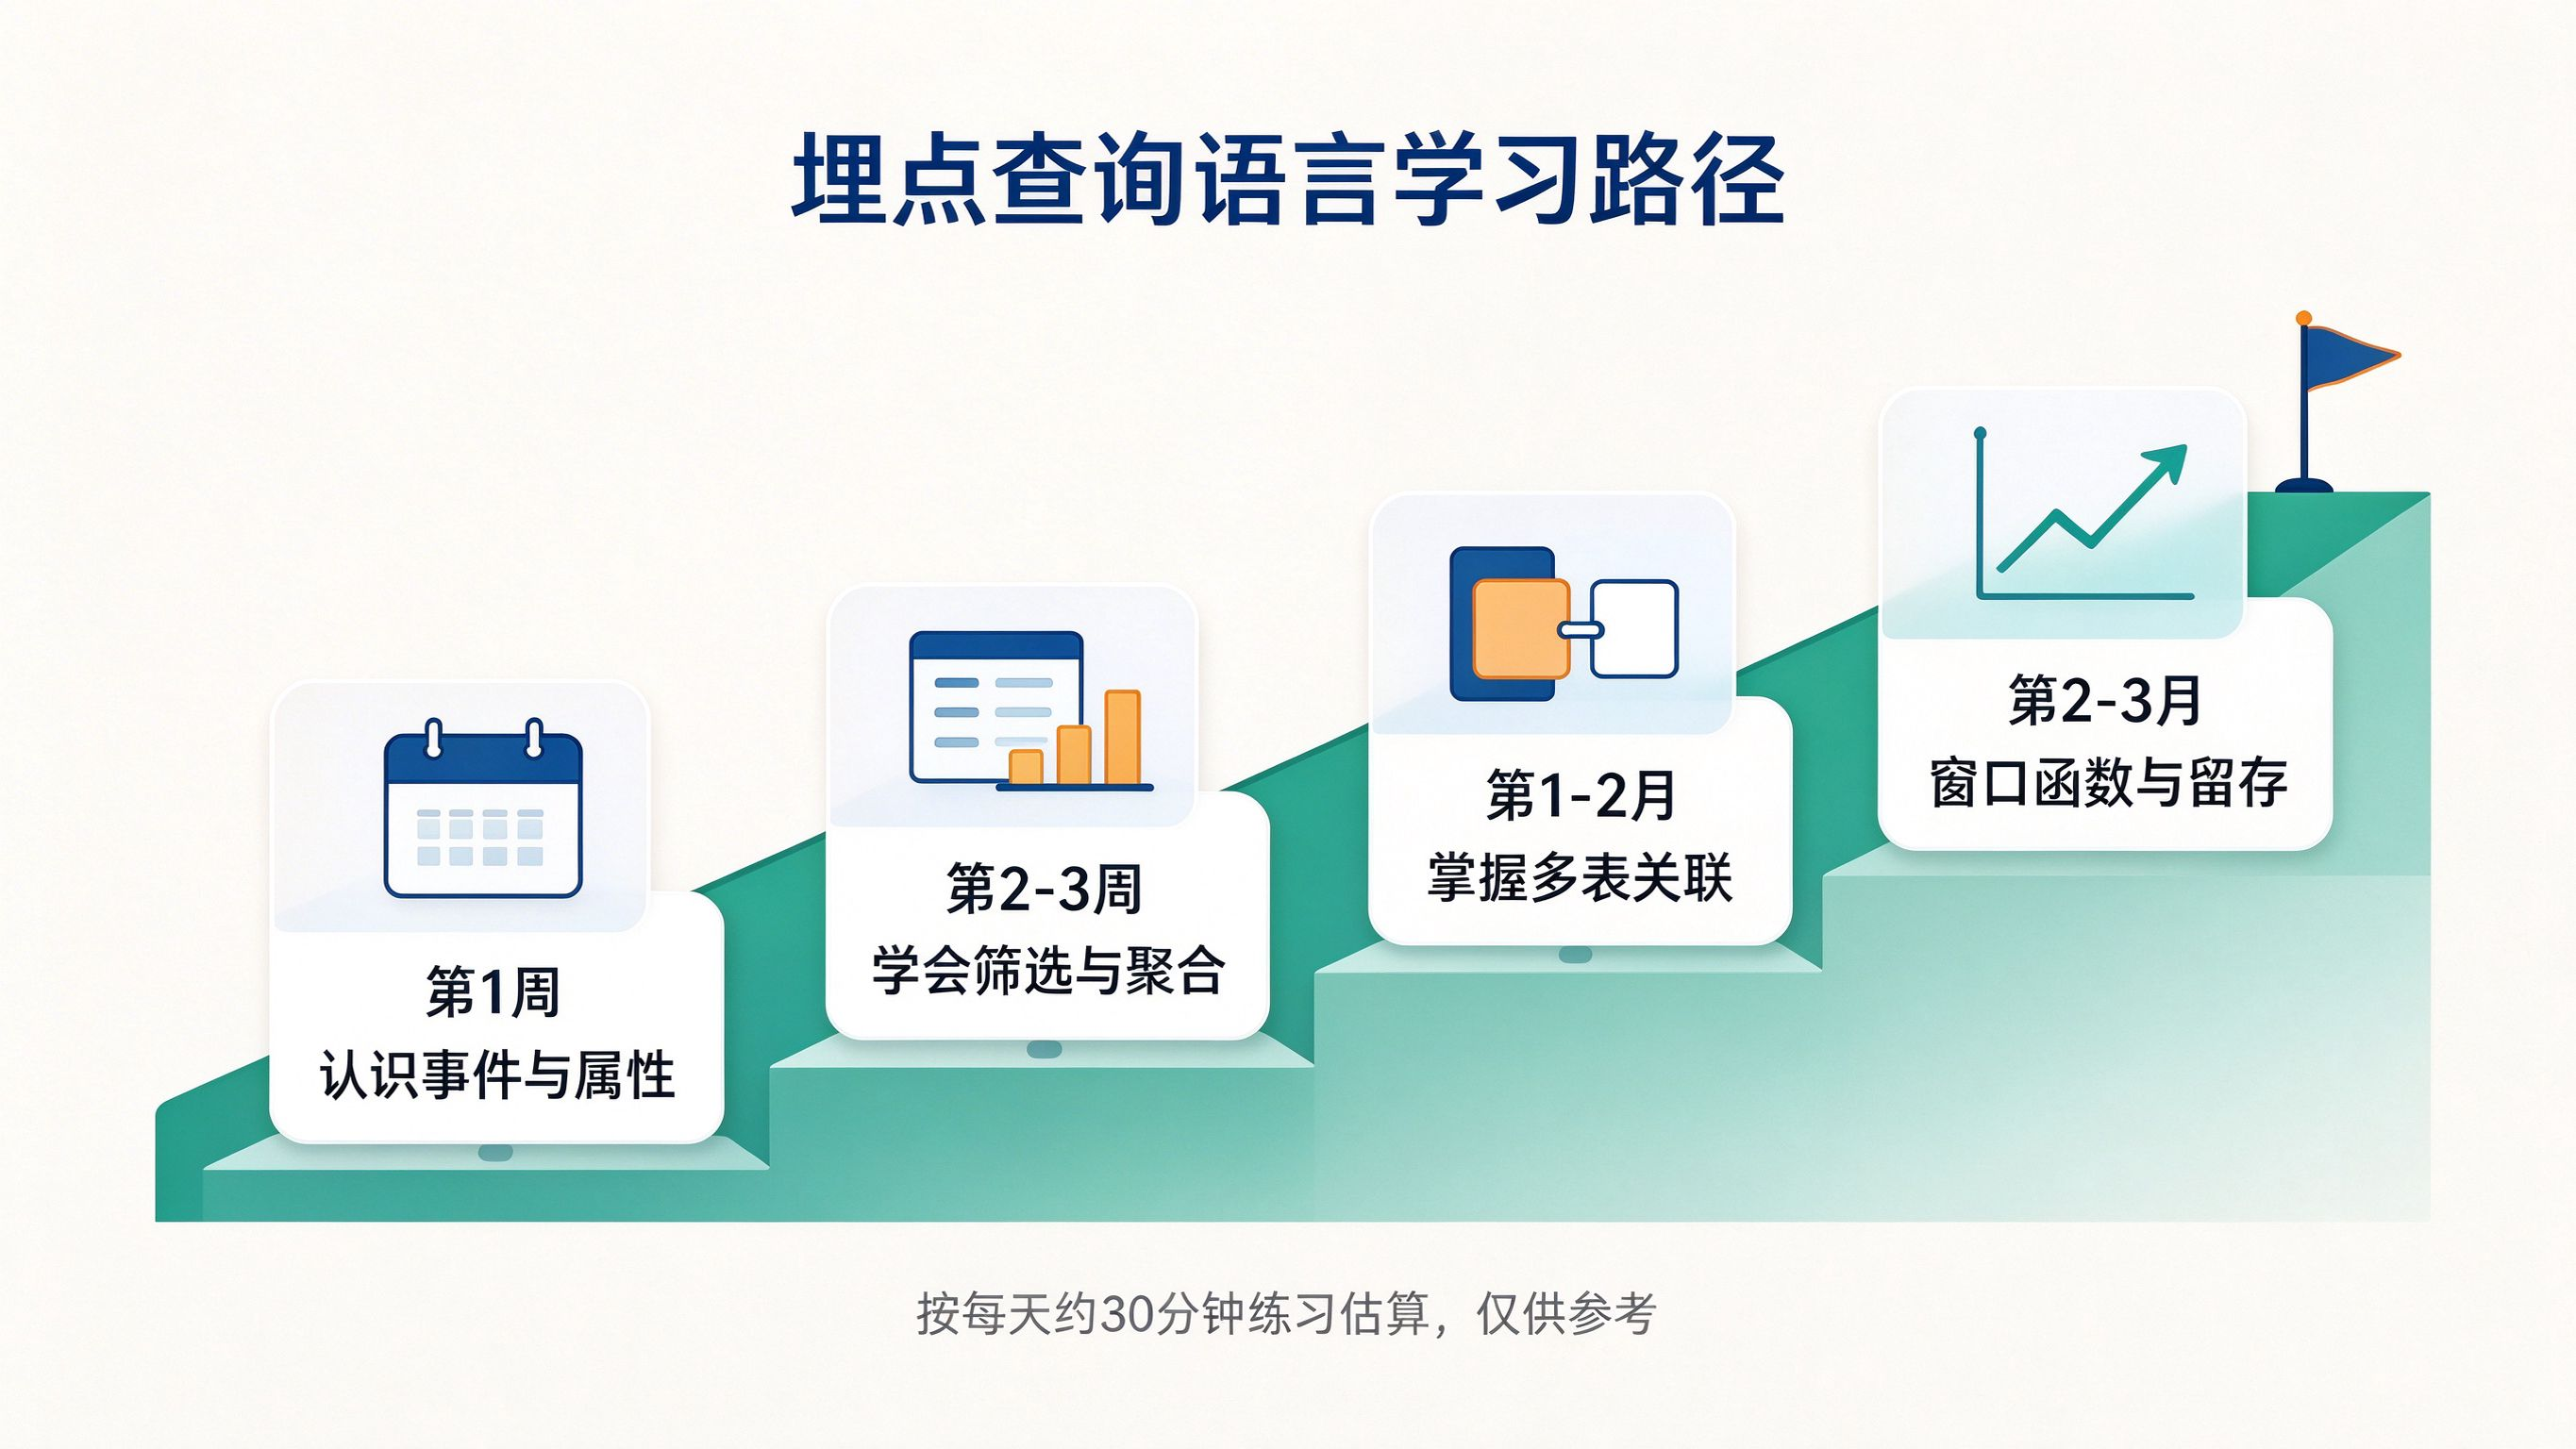 埋点查询语言的四阶段学习路径
头一周先认识"事件与属性"------搞清楚一次点击会被记录成哪些字段;接下来两到三周学会筛选与聚合,能回答"某个页面一天多少人看了";之后一两个月掌握多表关联,能把点击和后续转化连起来;再往后一到三个月碰窗口函数、留存这类进阶写法。不必一开始就追求全学会。
踩坑记录:查出来的数为什么和后台对不上?
**现象:**我用查询语句统计"注册按钮点击",得到的次数比后台报表里的数字少了一截。
根因: 事件表里同时存在
sign_up_click和sign_up_click_retry(重复点击上报)两个事件,我只统计了前者;同时过滤条件把实验期间被丢弃的无效访问也漏算了口径。**排查证据:**把查询结果按事件名拆列,发现还有一个同名变体事件;再和后台的事件字典对照,确认是埋点上报时同一动作触发了两条记录。
**修复方式:**把条件改成匹配同一动作下的全部事件名,并按用户去重统计 UV,而不是按原始行数统计 PV。
**经验:**查数对不上时,先别急着怀疑语法,先回到"事件字典"确认到底有哪些事件、口径是 PV 还是 UV,九成的差异都出在这里。
工具怎么选:要不要自己写查询?
不是所有人都需要写查询语言。很多埋点工具同时提供"可视化拖拽分析"和"查询语言"两条路:前者适合运营同学看现成报表,后者适合数据同学做灵活取数。
| 维度 | 可视化拖拽分析 | 自带查询语言 |
|---|---|---|
| 上手难度 | 低,点选即可 | 需要懂一点 SQL |
| 灵活度 | 受预设模型限制 | 高,可自定义口径 |
| 适合人群 | 运营、产品 | 数据、分析 |
| 典型用途 | 看漏斗、看留存报表 | 跨事件关联、自定义留存 |
| 代表能力 | 两类入口多数工具同时提供:轻量需求用拖拽、深度取数再写查询 |
轻量团队完全可以先用拖拽报表把日常问题解决掉,等真遇到"报表满足不了的口径"再去学查询语言,性价比最高。
常见问题
Q1:完全没有编程基础,能学会埋点查询语言吗?
A:能。它的常用语法很有限,先学会 SELECT、WHERE、GROUP BY、COUNT 这几个就能覆盖大部分取数。难点不在写代码,在理解事件和属性的含义。
Q2:学这个要会多久才能独立分析?
A:普遍经验是,一两周能写出基础统计,一到两个月能做关联和漏斗。这是学习社区的经验区间,不是硬性标准,实际进度取决于每天练习时长。
Q3:埋点查询语言和标准 SQL 差别大吗?
A:核心语法差别不大,都基于 SQL。主要差异在表结构和函数封装------各家工具对时间、漏斗、留存都做了自己的封装函数,需要看对应约定。
Q4:为什么我的查询结果和后台报表数字不一致?
A:先核对口径:是按事件行数(PV)还是按用户去重(UV)?时间过滤是否含时区?有没有漏统计同名变体事件?多数差异来自口径而非语法。
Q5:运营同学需要学查询语言吗?
A:不一定。日常看现成漏斗、留存报表用可视化拖拽就够了。只有当固定报表满足不了你的分析口径时,写查询才划算。
Q6:用这类工具必须会写代码才能看数据吗?
A:不需要。网站与用户行为分析提供可视化报表,事件、漏斗、路径、留存都能直接点选查看;有深度取数需求时再结合自定义查询即可。
小结:难的不是语法,是事件思维
回到最初的问题:埋点查询语言难学吗?**语法本身不难,难的是把业务问题翻译成事件口径。**先搞清楚你的产品里有哪些事件、每个事件记录了什么属性,再从最简单的 COUNT 查询开始练,一两周就能独立解决日常取数问题。把学习曲线拉长到一到三个月,多表关联和留存分析也能逐步上手。
参考数据来源:Stack Overflow《2024 开发者调查》(SQL 使用比例约 51%,占全部受访开发者;排在 JavaScript、HTML/CSS 与 Python 之后,位列全部技术前四);各学习阶段时长为多家 SQL 学习社区的普遍经验区间,非权威统计数据。