一个四节点集群跑了半年没重启过,版本落后两个小版本。升级这件事真正的难点是出了事怎么退回去,把新二进制放上去那一步反而不难。RustFS 官方的二进制升级页给的流程很短,但里面那两条备份命令才是整个流程的核心:备份配置,以及把当前正在跑的那个可执行文件另存一份。少了第二条的升级,等于把回滚路径删掉了。
升级前的两件事:确认健康,留好退路
官方给的第一步是对每个节点检查就绪状态:
bash
curl -fsS http://<node>:9000/health/ready这个检查要在每台机器上各跑一次,全部返回成功再动第一个节点。文档在开头写明了前提:先读目标版本的发行说明,再确认每个节点都健康。这两句话听起来像套话,实际是因为滚动升级的前提就是「一次只下线一个节点」,任何一个节点带着既有问题参与进去,故障排查时就没法确定问题是不是升级引入的。
第二条是备份:
bash
sudo cp /etc/default/rustfs /etc/default/rustfs.bak
sudo cp /usr/local/bin/rustfs /usr/local/bin/rustfs.previous
第一行备份的是环境变量配置。升级本身不会改这个文件,但如果你在发布说明里看到新增的环境变量,改配置这一步就是人工的,忘了就得手动补。第二行是回滚的关键:把当前可执行文件和路径上那个同名文件做一次拷贝。RustFS 的升级流程要求保留正在运行的可执行文件,官方原话就是让它可用于回滚。
这两行命令本身没有难度,但落地的两个位置值得单独看一眼。
/etc/default/rustfs 里放着访问密钥和秘密密钥,官方安装脚本写完这个文件之后会立刻执行 chmod 600,也就是只允许属主读写。备份出来的 rustfs.bak 是它的副本,内容一样敏感,而 /etc/default/ 这个目录并不设防,同主机上的其他账号照样读得到。升级前顺手补一句 sudo chmod 600 /etc/default/rustfs.bak,比事后发现密钥躺在一份可读文件里要省事。
rustfs.previous 是另一回事。它只是个可执行文件,不含任何密钥,但和 rustfs 一样大。真正需要注意的是替换那一刻磁盘上同时躺着三份二进制:旧的、备份的、新拷进来的。
替换之前还要看一眼剩余空间。这一轮里磁盘上同时存在三个占用:正在跑的旧二进制、备份出来的 rustfs.previous、拷进来的新版本。拷到一半盘满了,写出来的 rustfs 是个截断文件,启动时报的是权限或格式错误,比压根没升级更难收拾。先 df -h /usr/local/bin 确认余量,按新版本体积再留一倍比较稳。
换二进制的顺序,每一步都要等就绪
单节点的替换动作只有四步,但顺序不能颠倒:
bash
sudo systemctl stop rustfs
sudo cp rustfs-new /usr/local/bin/rustfs
sudo chmod +x /usr/local/bin/rustfs
sudo systemctl start rustfs
curl -fsS http://<node>:9000/health/ready
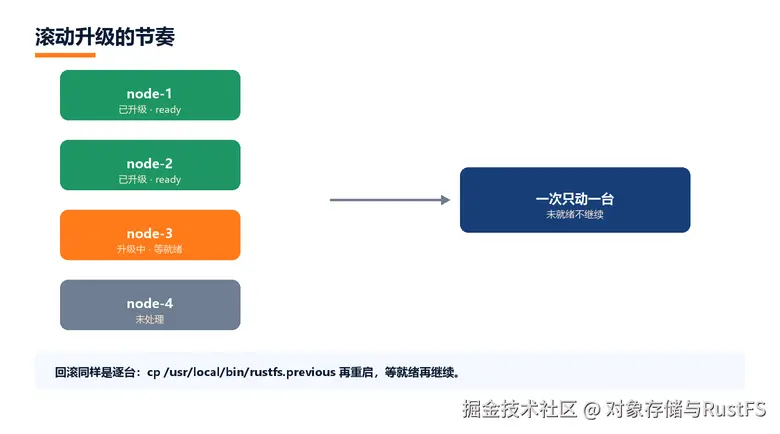
官方文档对节奏的要求写得比较硬:一次只升级一个节点,在重启的节点报告就绪之前不要继续。这条约束的原因是节点间 RPC 复用 9000 端口,节点之间要能互相访问,同时停掉两个就意味着某个瞬间没有节点能对上话。
systemctl stop rustfs 那一下的后果比命令看上去重。这个节点上的分片在这一刻全部离线,集群进入降级模式,读写靠纠删码的冗余撑着继续服务。冗余够不够,取决于这个节点之前还剩多少余量:一块盘已经坏了但还没换的集群,某个纠删集本来就已经少一片,此时再停掉一台机器,剩下的分片可能连最小的读 quorum 都凑不齐。所以动第一个节点之前,值得先确认集群没有正在跑的修复任务:
bash
rc admin heal status rustfs --json | jq '{queue: .healQueueLength, active: .healActiveTasks}'队列不为零就再等一会儿。修复本身在读旧盘写新盘,正吃着 IO 和冗余,这时候再停一台机器,是往已经紧绷的地方又加了一道。官方也提醒过,队列长度为零只能说明积压清了,不能代表离线盘已经换回、更不能代表每个对象都修好了。它表示的只是现在可以开始,不构成已经安全的确认。
chmod +x 这一步也别省。用 cp 覆盖一个已经存在的可执行文件,新文件的权限会沿用源文件(也就是 rustfs-new)的权限,如果那个文件是从别处拷贝来的、没有可执行位,启动时就会以权限错误退出。
混版本窗口里,有几扇门必须先确认没开
新旧版本在同一个集群里共存的那段时间,真正要盯的不是版本号,是几项会改变磁盘格式的特性。官方运维文档开头就写明了前提:替换可执行文件或容器镜像不会改动磁盘上的数据格式,换完重启也不会自动跑迁移步骤。但有几个特性一旦激活,旧版本二进制就读不懂新版本写出去的内容,官方给这类特性起的名字是版本下限(version floor),要求是在混版本滚动升级的全过程里保持未激活。
一共四项,其中三项是双开关:
| 特性门 | 激活条件 | 激活后的后果 |
|---|---|---|
| Local SSE wrapped-DEK JSON 信封 | 替换旧格式 base64(nonce):base64(ciphertext) 的那个发布版本 |
旧节点读不了以 JSON 信封写入的对象。必须先把所有对象变更来源(客户端写入、生命周期、复制)冻结,升级完全部节点再恢复流量。写入新加密对象之后不支持回退 |
| Data-movement 分片校验和 sidecar | RUSTFS_DATA_MOVEMENT_PART_CHECKSUMS_WRITE 与 RUSTFS_DATA_MOVEMENT_PART_CHECKSUMS_FLEET_CONFIRMED 两者同时为真 |
只有全体读写对象元数据的节点都支持这个 sidecar、且整个集群已把该版本当作回滚下限之后才可启用。一旦 rebalance 或 decommission 在两者都开着的状态下迁移了带校验和的旧式分片上传对象,回退就不被支持,旧客户端会忽略 sidecar |
| Pool 元数据版本 2 | RUSTFS_POOL_META_V2_WRITE 与 RUSTFS_POOL_META_V2_FLEET_CONFIRMED 两者同时为真 |
任何一个节点观察到或写入了版本 2,pool.bin 就不再降级,旧二进制和回滚版本都读不了。未处理的 decommission 条目以失败关闭的方式处理,不再写成版本 1 格式 |
| Pool 元数据版本 3 | RUSTFS_POOL_META_V3_WRITE 与 RUSTFS_POOL_META_V3_FLEET_CONFIRMED,已有集群上两者同时为真才激活 |
引入持久代和可恢复的跨池提交协议。一旦提交,只支持 V1/V2 的二进制无法重新加入 |
双开关那层设计值得单独说一句。带 WRITE 后缀的那个表示本节点要写入新格式,带 FLEET_CONFIRMED 后缀的表示运维确认整个集群所有读写方都支持。两个都为真才生效,单个节点误开不会当场造成格式分叉。它们默认都是关着的,但一旦调过就留下来了,所以升级前的检查清单里值得列一行。
混版本只能是过渡状态,不能当作稳态。全部节点升级完成,这次升级才算结束;窗口拖得越久,某一台旧节点撞上新格式的机会越大。中途停下来的集群,比一开始就等的集群更危险。
回滚走的是同一套动作,方向相反
新版本验证不通过时,回滚流程与升级几乎同构,只是源文件不同:
bash
sudo systemctl stop rustfs
sudo cp /usr/local/bin/rustfs.previous /usr/local/bin/rustfs
sudo systemctl start rustfs
curl -fsS http://<node>:9000/health/ready同样是一次一个节点,同样要等就绪再继续。这里有个容易忽略的点:rustfs.previous 是升级之前那份可执行文件的副本,所以它对应的配置组合是当前集群大部分节点的组合。如果你在升级过程中还顺手改了环境变量,回滚二进制而不回滚配置,就落在了一个从未被验证过的组合上。要改就等升级和回滚都结束之后。
换部署形态之后,流程要跟着换
官方把升级分成三条路径,各自的回滚方式不同。二进制部署是上面这套。容器部署的做法是在每个节点上跑同一套 Docker、Podman 或 Compose 流程,保留该节点原有的挂载和配置,回滚时停掉失败的替换容器,再用之前记录的镜像标签重跑一次对应的 run 命令;Compose 场景下改回 docker-compose.yml 里上一个镜像值再重建服务。多节点部署同样是一次一个节点、等就绪再继续。
容器这条路的回滚依赖的是「那个镜像标签还在」。官方发布的标签在远端仓库上,本地被清理掉也能拉回来。真正会卡住的是另一类:自己构建过、或者做过重新打标签的镜像,本地镜像被 docker image prune 或节点重启清掉之后,那个标签在仓库里已经不存在了。回滚命令停在一个没有任何提示的位置,容器没起来,日志也是空的,因为压根没启动过。多节点集群上尤其要当心,因为回滚要逐个节点重复同样的失败。生产环境里让回滚镜像始终留在远端仓库,别把本地缓存当退路。
Helm 和 Operator 那套又是另一回事:升级由工具自己完成滚动,回滚用 helm rollback 回到上一个修订版本。官方对这条路的描述是让 Helm 恢复 chart、values 和镜像配置,这句话里有两层容易漏掉的边界。
第一层是 CRD。自定义资源定义不属于 Helm 的发布历史,helm rollback 不会还原它,官方文档直接写了这一句。Operator 的 CRD 是集群级的、所有 Tenant 命名空间共用,升级流程里要先单独 kubectl apply 上新 CRD 再升控制器。所以回滚之前要确认目标版本对 CRD 的要求,文档里那句判断是:如果这个版本明确支持降级,就还原上一个 Helm 修订、不要套用旧的 CRD 文件;如果它标注了一次性的单向迁移,就别回滚,往前修到下一个可用版本。
第二层是配置本身。升级前的事前准备里有一条是「把现有的部署值和清单纳入版本控制,包括镜像标签、存储拓扑、调度规则和 Secret 引用」。Secret 和 ConfigMap 是集群里的独立对象,helm rollback 管不到它们。如果升级窗口里有人改过这些,回滚之后会剩下一份新版本写入、旧版本运行的不匹配配置。
Kubernetes 那条路径上另外还有两条硬约束值得单独记:升级和回滚过程中都不要删除 PVC;Operator 部署场景下不要在一个维护窗口里同时升级 Operator 和多个 Tenant,先升控制面、确认 CRD 和组件正常,再逐个动 Tenant。
发布说明里最先该看的两类改动
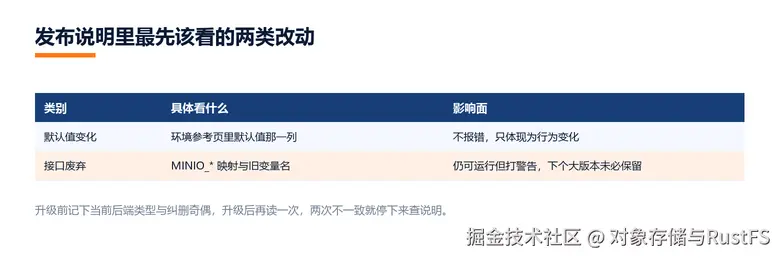
滚动升级的文档把「读发行说明」写在开头,但具体该读什么往往没人说清。有两类改动值得优先看。
第一类是配置语义的变化。RustFS 的很多环境变量有默认值,默认值变了不会在启动时报错,只会在行为上体现出来。一轮升级跨了两个小版本时,环境参考页里默认值那一列的变化就是重点。凡是涉及存储布局、存储级别、缓冲配置的默认值变动,都要按「新默认值会不会影响存量数据」来判断影响面。
第二类是接口层面的废弃。RustFS 保留了 MINIO_* 到 RUSTFS_* 的映射表和几个旧变量名,弃用的写法仍能跑但会打警告。升级之后如果日志里出现这类警告,说明有配置走了旧路径,虽然不影响当前运行,但下一个大版本里未必还留着。
升级之后该验证什么
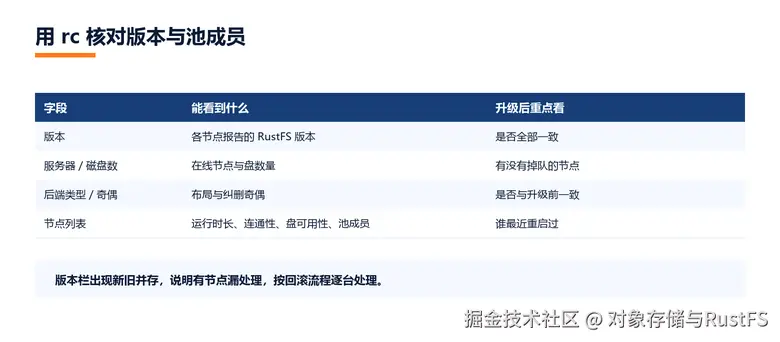
curl -fsS http://<node>:9000/health/ready 只能证明这个节点起来了。要看清楚集群层面的状态,用 rc admin info cluster rustfs,它会报告集群状态、RustFS 版本、服务器和磁盘数量、后端类型与纠删奇偶,节点列表里给出运行时长、网络连通性、磁盘可用性和池成员归属。
版本这栏尤其值得盯一眼。滚动升级过程中某个节点忘了处理的话,集群会停在新旧版本混跑的状态,接口表现往往正常,只有在这一栏里能看到不同版本的节点并列。这一项也正好收束前面那节:混版本是过渡态,全部节点版本一致才算这次升级结束。发现了就按回滚流程逐个处理,不要指望它会自己追上。
一个通用的排错入口
RustFS 二进制还带了一个诊断子命令,rustfs diagnose 用于分析日志文件并报出可能的原因。版本升级之后日志格式可能变化,排查新版本报出的异常时,rustfs diagnose --path 指向日志目录,比在几万行日志里自己找要快。同族的还有 rustfs tls inspect --path,可以检查证书目录的布局与解析状态,升级顺手轮换证书时用它验证一遍。
把这套流程固化成文档里的检查单之后,升级这件事就不再需要每次现场判断。四节点集群一轮滚动升级大约十几分钟,其中绝大部分时间花在等节点就绪上,真正的操作只有四条命令。
还有一条经验:升级窗口里不要同时做别的变更。换证书、扩池、改环境变量,这几件事和滚动升级叠在一起,出问题时无法判断是哪个引入的。真要一起做,顺序上先升版本再动其他,中间留一个观察期。
观察期里值得盯的三个指标是:集群状态是否所有节点都在线、各节点报告的 RustFS 版本是否已全部一致、存储可用容量是否在正常波动范围内。前两项决定这次升级算不算成功,第三项用来排除升级过程中误操作带来的容量变化。
还有一个容易漏的收尾动作。四台机器都升级完、版本栏核对无误之后,把 /etc/default/rustfs.bak 和 /usr/local/bin/rustfs.previous 的处理想清楚:它们留着是有价值的,下一次升级就会覆盖 rustfs.previous,配置文件备份则容易被下一轮升级里冒出来的改动需求带偏。比较稳妥的做法是在确认新版本稳定运行一段时间后,把这一轮的备份归档保存,而不是让它一直躺在原地。归档的时候连权限一起带过去,别把一份 600 权限的配置文件挪进共享目录之后又变回 644。
还有一条和版本相关的经验值得记:跨大版本升级前,先确认目标版本对纠删集宽度和布局的要求有没有变化。这类变化不会在升级日志里出现提示,只在新布局落地的集群上才看得出来。核对方式是升级前在各节点上记下当前的后端类型和纠删奇偶,升级完成后再用 rc admin info cluster rustfs 读一遍,两次结果不一致就停下来查发行说明。
把这一轮的顺序再压缩一下:每台机器四条命令,其中两条是复制、一条是重启、一条是验证。真正消耗时间的是重启之后等就绪,所以集群规模越大总耗时越长,但单节点的操作窗口始终只有一次 systemctl stop 的时长。