📚 本文收录于「流浪」的系列专栏
| 🐧 Linux系统 | ⚙️ C++ |
| 📊 数据结构与算法 | 🐍 Python |
| 🔗 LangChain & LangGraph | 🗄️ MySQL 数据库 |
| 🌿 Git 工具 | 🌐 计算机网络 |
| 🤖 AI | 💯 大厂面试、八股 |
| 📚 学习筑基专栏 |
🏠 博客主页:流浪 | 📝 原创首发于 CSDN
前言: 篇36 摸清了线程的底------Linux 没有真线程,轻量级进程模拟的;线程(二)拆了页表,线程(三)算完了优缺点、数量、私有的账。账算完,执行流还停在纸上。线程(四)动真格:pthread 库从哪来、线程怎么创建、怎么等它干完活。造出来,才算真懂。
一、pthread库从哪来
1.1 Linux 没有线程的系统调用
篇36 的结论先摆回来:Linux 操作系统里,不存在真正意义上的线程。
它所谓的线程概念,是用轻量级进程(LWP)模拟的------线程和进程在内核里都是 task_struct,共享地址空间的那批就叫线程。
推论很直接:Linux 只提供创建轻量级进程的系统调用(clone),不提供线程的系统调用。内核根本不知道「线程」为何物,它只认识 task_struct。
但是用户只认线程。 所有操作系统教材、所有语言的标准库,讲的都是线程,没有一本书教你怎么「创建轻量级进程」。
于是在用户层和内核之间,必须有东西把这个断层填上------把创建轻量级进程的系统调用封装起来,给用户提供一个创建线程的接口。
这个封装就是 pthread 库 ,POSIX 线程库,Linux 下的原生线程库。回答之前自留的那个问题「为什么会有一个库」:因为内核不给线程,用户只要线程,中间必须有人翻译。
1.2 库在哪,怎么链接
pthread 库在系统里是现成的,头文件就是 pthread.h,库文件 libpthread.so。但直接编译会报错------链接的时候要加 -lpthread。
为什么?因为 pthread 不属于 C 标准库。libc 是 gcc 默认链接的,pthread 是独立的第三方库,gcc 默认不会去链接它,必须显式指名。
bash
g++ test_thread.cc -o test_thread -lpthread # 末尾带上 -lpthread怎么证明它真被链接进来了?用 ldd 查看可执行程序依赖的动态库:
bash
$ ldd 可执行文件名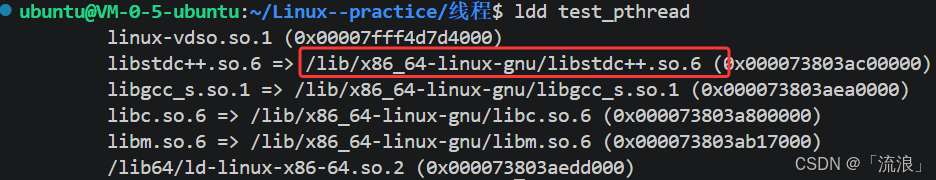
列表里能看到 libpthread,链接才算到位。去掉 -lpthread 再编,报的是 undefined reference to pthread_create------函数声明在头文件里有,实现却在没链接的库里。
注:现代 gcc 更推荐写
-pthread------它除了链接 pthread 库,还会顺带定义_REENTRANT等宏让 libc 头文件启用线程安全版本;-lpthread是老式写法,只负责链接,本文沿用这个写法。
1.3 用户级线程
线程库在用户层把轻量级进程封装成了线程,这套实现完全发生在用户层------库自己维护线程的控制块、栈、状态,内核只负责调度它看到的那些 LWP。
所以 Linux 的线程有个专门的名字:用户级线程。
对照着理解:Windows 的线程是内核亲自管的,有独立的内核线程对象;Linux 的线程是库在用户层拼装出来的,内核只在 clone 那一刻见到一个「申请共享资源的轻量级进程」。
这也解释了一个前面埋过的问题------线程(三)说子线程的栈是库 mmap 出来的 8MB:这件事内核压根不知道,是库自己干的。栈、控制块、返回值的暂存,全是用户层的手笔。
1.4 C++11 的多线程,本质就是 pthread
C++11 给了标准线程库 std::thread,很多同学以为从此不用 pthread 了。在 Linux 下,std::thread 就是对 pthread 的封装------构造线程底层调 pthread_create,join 底层调 pthread_join。
验证方式很朴素:写一段纯 C++11 的多线程代码,编译时不加 -lpthread(或者干脆去掉链接选项),照样编不过------准确说是编译能过、链接阶段报错 ,undefined reference to pthread_create。
原因就是 1.3 说的分层:std::thread 只是换了个面向对象的壳,壳底下调的还是 pthread 的函数,pthread 库没链接进来,壳就是空的。语言标准再新,绕不开底下的操作系统。
1.5 跨平台是怎么做到的
那 std::thread 在 Windows 上呢?Windows 没有 pthread,它封装的是 Windows 自己的线程接口(CreateThread 一族)。
跨平台的套路就浮出来了:给不同操作系统各写一套底层实现代码,然后用条件编译按平台选择,打包成库,对外暴露完全一样的接口。
cpp
#ifdef _WIN32
    // 底层调 CreateThread
#else
    // 底层调 pthread_create
#endif用户写一份代码,任何平台都能编------这就是「为什么会有一个库」的完整答案:内核不提供统一接口,库来提供;平台各不相同,库来抹平。pthread 是 POSIX 标准给出的可移植层,C++11 是语言标准给出的更高一层。
二、创建线程,pthread_create的四个参数
2.1 函数原型
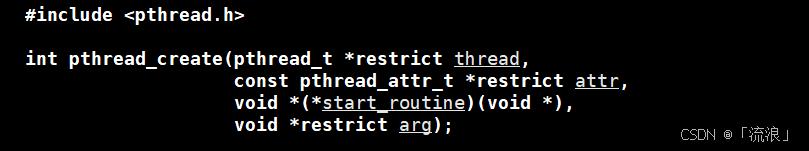
四个参数,逐个拆:
1. 第一个参数 pthread_t *thread,输出型
线程创建成功后,新线程的 ID 通过它带出来------调用方传一个 pthread_t 变量的地址进去,函数往里写。
2. 第二个参数 const pthread_attr_t *attr,输入型
线程属性------栈大小、分离状态、调度策略这些。一般不关心,直接传 nullptr,走默认属性。本文所有示例都传空。
3. 第三个参数,函数指针,新线程的入口
线程的本质是一条执行流(篇36 讲过),执行流执行的就是这个函数------函数返回,线程就结束。
4. 第四个参数 void *arg,传给入口函数的实参
需要传结构体、传多个值,就把它们打包成一个结构体,传结构体地址;不需要就传 nullptr。
2.2 入口函数的签名,void*就是返回值通道
第三个参数的类型要单独拎出来看:void *(*)(void *)------接收一个 void,返回一个 void**。
参数方向好理解:第四参数 arg 传进来的东西,从这里接住 。返回方向的 void* 就有意思了------它就是这个线程的返回值通道。
线程函数里 return (void*)结果;,这个值不会凭空消失,它被线程库暂存起来,等着某个地方来取。
谁来取、怎么取?这就是 TCB 和 pthread_join 的故事------TCB 下一篇细说,怎么取第三章马上讲。线程(三)列过「线程私有清单」,栈、寄存器都是私有的,但这个返回值专门设计出来给别人拿,它是线程留给外界的唯一正式出口。
先记住:入口函数返回 void,不是随手设计的,它就是线程的返回值*。
2.3 创建第一个线程,观察两个执行流
c
void *newidea(void *mes)
{
    while (true)
    {
        std::string name=(char*)mes;
        std::cout << "我是新线程,我的name:"<<name<<" "<<"我的pid是:" << getpid() << std::endl;
        sleep(1);
    }
    return nullptr;
}

int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, newidea, (void *)"pthread-1");
    while (true)
    {
        std::cout << "我是主线程,我的pid是:" << getpid() << std::endl;
        sleep(1);
    }
    return 0;
}
bash
while :; do ps -aL; sleep 1; done 监控。现象从监控命令里直接看:
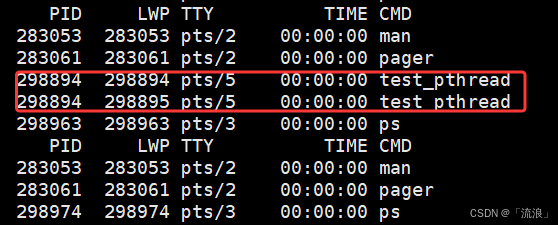
两个线程,PID 一样,LWP 不一样------这就是篇36 讲的:它们是同一个进程里的两条执行流,共享同一个地址空间,内核用两个 task_struct 分别调度。
第一个线程的 LWP 号和 PID 相等------那是主线程,进程创建时自带的那条执行流。LWP 全称 light weight process,轻量级进程,它才是内核眼里的真身份。
2.4 调度看LWP,信号打整个进程
CPU 调度的时候,看的是 LWP,不是 PID。一个进程的时间片,是等分给它内部所有线程的 (粗略说法,实际调度按各线程权重略有出入)------四个线程平分原本属于一个执行流的时间,这正是线程(三)「线程数贴核数」的调度层依据。调度切换的完整逻辑,篇12 讲过,线程切换只是少了换地址空间那一步。
反过来,kill 是冲着进程去的。kill -9 5321 发的 SIGKILL 递达给进程,两个线程同时退出------信号的处理主体是进程,线程(三)讲的「一个线程崩全进程崩」是同一件事的另一面:共享地址空间,命运绑死。
2.5 pthread出错看返回值,不看errno
pthread 系列函数的错误处理是个易错点:成功返回 0,失败直接返回错误码,不设置 errno 。

cpp
int n = pthread_create(&tid, nullptr, func, nullptr);
if (n != 0) {
    fprintf(stderr, "pthread_create: %s\n", strerror(n));   // 拿返回值翻译
}
为什么和 read、write 这些系统调用不一样?回顾线程(三)4.3 讲过的:errno 是每个线程私有的(__errno_location() 返回 TLS 里的地址)。
pthread 库生来就在多线程环境里用,如果还走「函数返回 -1 + 置 errno」的老路,errno 的读写就要和业务代码互相踩------错误码直接走返回值,一次调用一次结果,天然线程安全。
所以查 pthread 的错误,用 strerror(返回值),别用 perror。
三、等待线程,pthread_join
3.1 为什么要等
线程创建完能不能撒手不管?不能。新线程是主线程创建的,创建好之后需要主线程等待 ,否则会造成类似 僵尸进程 的问题,导致内存泄漏。
原理和通信系列 fork 那里讲的僵尸进程一模一样:子进程退出后,内核要保留退出状态等父进程 wait 拿走,父进程不 wait,子进程的进程控制块就一直占着。
线程同理:线程退出后,它的控制块(TCB)和退出状态不能立刻销毁------万一别的线程想看它的返回值呢?这个状态由 pthread 库暂存,谁 join 谁取走,取走之后这块资源才释放。不 join,这些资源就永久挂着,线程一多就是实打实的泄漏。
Linux man 手册里有个词叫 zombie thread(僵尸线程) ------积累得足够多,系统将无法再创建新线程。所以规矩是:每个 joinable 线程都必须被 join 一次。
3.2 函数原型
cpp
int pthread_join(pthread_t thread, void **retval);两个参数,逐个拆:
1. 第一个参数,要等待的线程 ID
就是 pthread_create 第一个参数带出来的那个值。传哪个 ID 就等哪条执行流,阻塞到它终止为止;目标线程已经退出了就立刻返回。
2. 第二个参数 void **retval,收退出状态
接收线程的退出状态,不关心就传 nullptr。
线程的退出状态从哪来?man 手册列了三个来源:
- 线程函数 return 的值------2.2 说的那个 void* 返回值
- 线程被 pthread_cancel 取消------固定是 PTHREAD_CANCELED 这个宏
- 线程调 pthread_exit 主动退------参数就是退出状态
不关心传 NULL,关心就传一个 void* 变量的地址,线程的退出状态写进去。
3.3 void**接住的,正是那个create的void*返回值
现在把两个参数点接上------pthread_join 的第二个参数 void**,接收的就是 2.2 讲的线程函数返回的那个 void*。
两头对齐看就通了:
- pthread_create 第三参数要求入口函数返回 void*------线程把结果从这扔出去
- pthread_join 第二参数是 void* 的地址(void**)------主线程把结果从这接回来
pthread_create 和 pthread_join 就是靠这个 void* 建立关联的 :一个定义出口,一个提供入口。线程函数 return 的值,经库暂存在 TCB 里(下一篇细说),join 时从 TCB 里取出来放到 retval 指向的位置。
取完这一下,整个线程的管理工作才算闭环------创建、运行、退出、回收,四步走完,资源落地。
3.4 等待期间,进程里在发生什么
课堂 demo(代码由浪哥填充) :子线程循环打印,主线程 pthread_join 等待,期间
ps -aL | grep test_thread观察;join 返回后打印拿到的返回值。
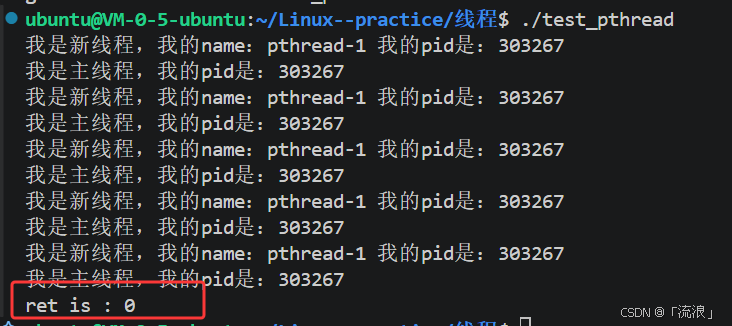
监控里能看到:子线程在跑的时候主线程在 join 处阻塞,主线程在等、子线程在干,子线程退出后 join 返回,两者最终一起结束------进程的最后一条线程走完,进程终止。
传给 join 的 tid 和创建时带出来的是同一个值------主线程等的那个线程,就是当初创建的那个,ID 对得上,管理关系清清楚楚。
3.5 demo验证
cpp
void *newidea(void *mes)
{
    int cnt=5;
    while (cnt)
    {
        std::string name=(char*)mes;
        std::cout << "我是新线程,我的name:"<<name<<" "<<"我的pid是:" << getpid() << std::endl;
        sleep(1);
        cnt--;
    }
    return nullptr;
}

int main()
{
    pthread_t tid;
    pthread_create(&tid, nullptr, newidea, (void *)"pthread-1");
    int cnt=5;
    while (cnt)
    {
        std::cout << "我是主线程,我的pid是:" << getpid() << std::endl;
        sleep(1);
        cnt--;
    }
    void *val;
    pthread_join(tid,&val);
    std::cout << "ret is : " << (long long int)val << std::endl;
    return 0;
}
四、全篇总结
一条线收拢:
- 库的由来:内核只给 clone 不给线程调用,用户只要线程------pthread 库在用户层封装轻量级进程,Linux 的线程是用户级线程;跨平台靠各 OS 各写底层、条件编译、对外同一接口
- 创建:pthread_create 四参数,输出型 tid、输入型 attr、函数指针入口、void* 传参;入口函数返回的 void* 就是线程的返回值通道;出错看返回值不看 errno
- 等待:pthread_join 拿两样东西------等哪个线程、收退出状态;void** 接住的正是那个 void*,join 完成管理闭环;不 join 就是僵尸线程
整个系列到这里,「线程」从概念(篇36)、内存(线程二)、账目(线程三)落到了可操作的接口------能创建、能等待,执行流真正跑起来了。
五、文末面试题
5.1 推导题(按本讲知识点,附答案)
先自己想,再看答案------答案都用本章的逻辑推,不引入新知识。
-
【推导】Linux 为什么会有 pthread 这个库?
答:内核只提供创建轻量级进程的系统调用(clone),不提供线程的系统调用;而用户只认线程。库在用户层把轻量级进程封装成线程接口,内核不提供统一抽象,库来提供。
-
【推导】创建线程后不 join 会发生什么?
答:线程退出后 TCB 和退出状态被库暂存,等待 join 取走后释放;没人 join,资源永久挂着------僵尸线程,积累多了泄漏内存,最终无法再创建线程。所以每个 joinable 线程必须被 join。
-
【推导】pthread_join 的第二个参数怎么用?
答:传 void* 变量的地址(void**),join 把目标线程的退出状态写进去。退出状态三来源:线程函数 return 的值、pthread_exit 的参数、被 cancel 时固定的 PTHREAD_CANCELED。不关心传 NULL。
-
【推导】pthread 函数出错为什么不能查 errno?
答:pthread 系列成功返回 0,失败直接返回错误码,不设置 errno。多线程环境里 errno 虽然线程私有(TLS),但错误码走返回值一次调用一次结果,天然线程安全。查错用 strerror(返回值)。
-
【推导】C++11 的 std::thread 和 pthread 是什么关系?
答:Linux 下 std::thread 就是对 pthread 的封装------构造调 pthread_create、join 调 pthread_join。不链接 pthread 库,纯 C++11 多线程代码照样编不过,语言标准绕不开操作系统。
-
【推导】一个进程的时间片和线程数什么关系?
答:进程的时间片等分给内部所有线程,调度看 LWP。线程开得比核数多,分到的时间被切换开销吃掉------线程(三)「计算密集型贴核数」的调度层依据就在这。
5.2 真题(来源已核实,转述注明)
- pthread_create 的常见失败原因和入口函数的常见错误?
答:失败返回错误码而非 -1,常见 EAGAIN(系统资源不足或超过线程数上限)、EINVAL(属性非法);入口函数签名必须 void*()(void ),签名写错可能编译通过但运行时崩栈;传参不能传主线程栈上即将销毁的变量地址(如循环变量 &i)。
【真题·转述自 启尚博客《C多线程面试题_常见C语言多线程面试题汇总》(blog.wuxhqi.com?p=52734)(题库型,未标注具体公司)】
💬 库的由来、创建的四个参数、join 的 void* 关联------线程从概念落到了能跑的代码,能创建、能等待,执行流跑起来了。觉得有收获,点个赞再走。