Kotlin 后端别再用 GlobalScope:结构化并发与可取消 Scope
在 Kotlin 后端里,GlobalScope.launch 看起来最省事:不用声明 Scope、不用想生命周期,协程就能飞起来。官方 API 文档却把它标成 Delicate :没有 Job,取消不了整批,也等不齐全部完成。JetBrains 博客上 2025 年 12 月的一篇客座文章(问答体,作者是 JetBrains 认证 Kotlin 讲师)也提到:把协程当成「语法更漂亮的线程」是一种反模式,典型症状正是 GlobalScope.launch、生产路径乱 runBlocking、忽略结构化并发。下面只围绕这三件事落地:为什么危险、怎样换成有边界的 Scope、请求内并发怎么写才可取消。
一、GlobalScope 到底缺了什么
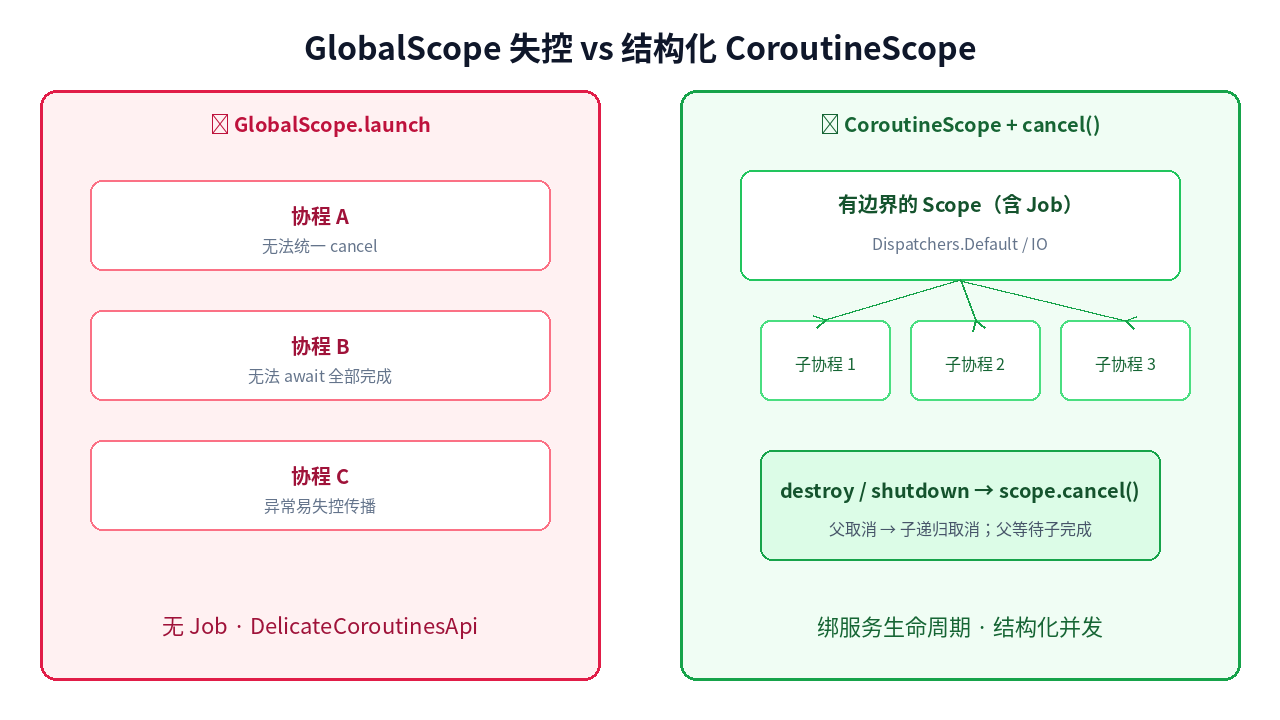
GlobalScope API 文档写得很直白:它是一个 没有 Job 的 CoroutineScope。后果有两条:
- 无法取消在该 Scope 里启动的全部协程;
- 无法等待它们全部结束。
于是生命周期对不上号:组件已经销毁、服务已经下线,后台协程还在拉数、写 socket,轻则资源泄漏,重则更新已不存在的状态。文档用 UI 场景举例:用户离开页面后还在 fetchLastRecordFromServer 并试图刷新界面。后端的对等场景是「实例已摘流,仍在消费队列 / 打下游」。再说资源占用:一个永远收不到取消、也永远等不到下一条请求(Channel 里再没人写入)的协程,会一直挂着、占着 socket,finally 里的 socket.close() 不会被执行。官方文档给过这个例子。
文档还提醒:GlobalScope 默认没有 CoroutineExceptionHandler,launch 里抛出的异常会落到平台「最后手段」行为。文档给出的情形是:Android、Kotlin/Native、JS 上可能直接崩溃,非 Android 的 JVM 上则是往日志里刷一堆未必有用的信息,没法干净地交给调用方。结构化并发下,异常通常能沿父协程传播;逃到全局后,这条链就断了。
另一个常被忽略的坑:不要 用 CoroutineScope().launch { ... } 去「替换」GlobalScope.launch。裸构造出来的 Scope 同样缺少你以为存在的边界,文档明确说它会踩同一类坑。看起来「我新建了 Scope」,实际上仍然没有人在 shutdown 时对它 cancel(),效果和全局漂着差不多。
合法场景极少:需要在整个应用生命周期都活着的顶层后台(例如周期性打统计)。即便如此,也必须显式 Opt-In,并自己装异常处理:
kotlin
import kotlinx.coroutines.CoroutineExceptionHandler
import kotlinx.coroutines.DelicateCoroutinesApi
import kotlinx.coroutines.GlobalScope
import kotlinx.coroutines.delay
import kotlinx.coroutines.launch

// 仅演示「应用级后台」逃生舱写法;多数业务代码不应走这条路
@OptIn(DelicateCoroutinesApi::class)
val globalScopeReporter = GlobalScope.launch(
    CoroutineExceptionHandler { _, e ->
        println("fatal in global reporter: $e")
    }
) {
    while (true) {
        delay(1000)
        // logStatistics()
    }
}
@OptIn(DelicateCoroutinesApi::class) 别当仪式看,它是在提醒你:正在走逃生舱。代码评审里看到裸 GlobalScope.launch 且没有 Opt-In、没有 Handler、没有「为何必须活过整个进程」的注释,基本可以直接打回。
二、结构化并发:父取消子、父等子
Coroutine context and dispatchers 把父子关系讲清楚了:
- 在另一个协程的
CoroutineScope里launch,新协程的 Job 成为父 Job 的子 Job; - 父取消 → 子递归取消;
- 父会等待全部子完成 ,不必自己
join每一个。
脱离结构的两种典型写法:
- 显式换 Scope,例如
GlobalScope.launch,不继承父 Job; - 给子协程塞一个全新的
Job(),覆盖父 Scope 的 Job,独立执行。
文档里的演示很直观:请求协程被 cancel 后,继承父上下文的子协程停掉,而带着独立 Job() 的那条仍继续跑。后端里「网关已超时返回、业务协程还在写库」往往就是同类结构问题:取消信号到了外层,内层却已经「声明独立」。
JetBrains 博客上的一篇客座文章(问答体,作者是 JetBrains 认证 Kotlin 讲师:How Backend Development Teams Use Kotlin in 2025)给出的修法,方向与上面的官方文档一致:停止在 GlobalScope 里起协程;每个协程绑到真实 Scope/生命周期;runBlocking 留给 main() 或测试;并发组合用 coroutineScope / supervisorScope,别逃到全局。
kotlin
import kotlinx.coroutines.async
import kotlinx.coroutines.coroutineScope
import kotlinx.coroutines.supervisorScope

// supervisorScope:子协程失败不会自动取消兄弟;但 await() 会把异常抛出来,块以异常结束时整个 Scope 仍会被取消
suspend fun loadPair(): Pair<Result<String>, Result<String>> = supervisorScope {
    val a = async { "A" }
    val b = async { "B" }
    runCatching { a.await() } to runCatching { b.await() }
}

// 一个失败应取消兄弟任务时用 coroutineScope
suspend fun loadTogether(): String = coroutineScope {
    val first = async { "config" }
    val second = async { "data" }
    first.await() + "/" + second.await()
}对调用方而言,结构化并发还有一个常被低估的好处:函数返回即表示内部并发收尾 。coroutineScope 块结束前,子协程都得了断;你不必在业务代码里维护一份「子 Job 列表」再手动 join。相反,GlobalScope 把「何时结束」抛回给全人类,也就是基本上没人负责。后端接口超时、线程中断、框架取消信号,只有进得了 Job 树,才谈得上协作式取消。
关键是:并发发生在 suspend 作用域内部 ,取消与等待跟着调用栈走。coroutineScope 适合「任一失败就整单失败」;supervisorScope 适合「汇总多个结果、单路失败不立刻拖死兄弟」;但子协程的异常仍会在 await() 处抛出,要容忍部分失败就得自己 runCatching。另外文档提醒,supervisorScope 不会替你装 CoroutineExceptionHandler,launch 子协程失败时异常可能无人处理。选型按业务失败语义,不要为了「看起来高级」默认 supervisor。
官方替代路径还有更朴素的一条:很多时候根本不需要新协程。能串行的 suspend 直接调即可;只有真正要重叠执行时,再在 coroutineScope 里 launch/async。GlobalScope 文档指出,它常被看不到其他入口的初学者拿来创建协程,属于 antipattern,应当避免。
三、后端怎么绑生命周期 Scope
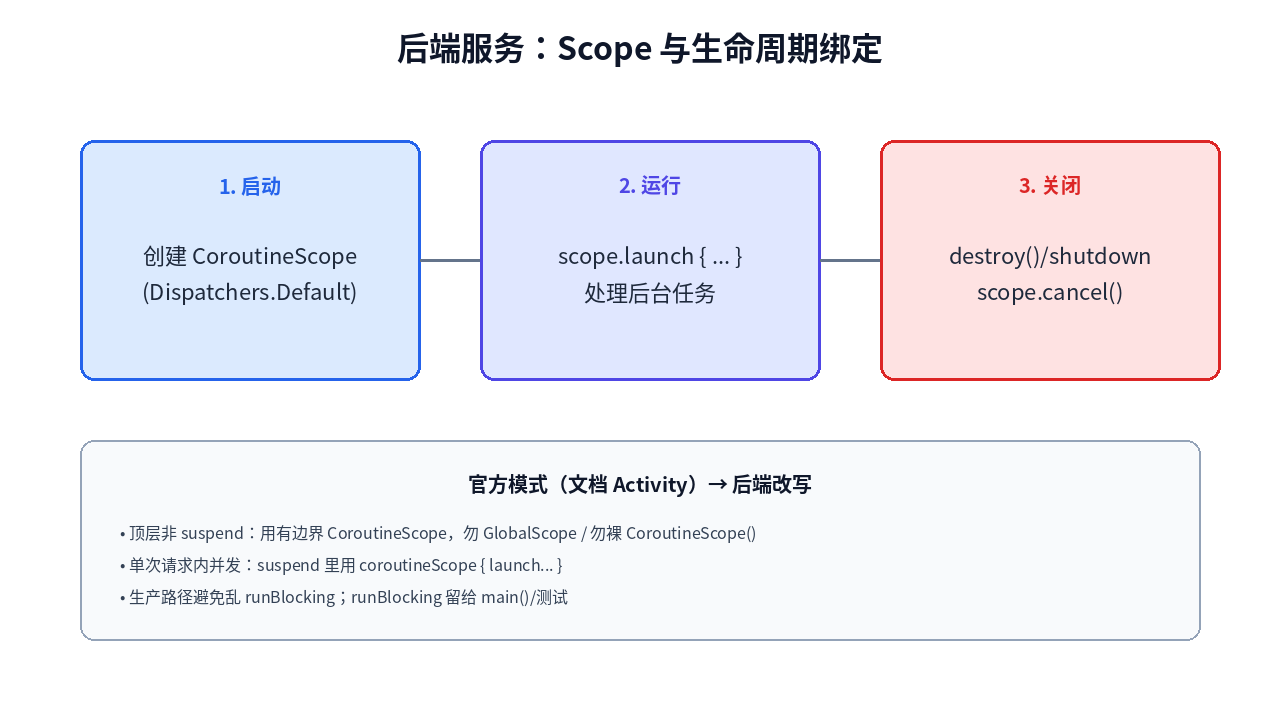
官方文档用 Android Activity 做示例:创建 CoroutineScope(Dispatchers.Default),在 destroy() 里 cancel()。后端没有 Activity,但有 服务组件 / 客户端 / Worker 的启停,同一模式直接搬:启动时建 Scope,关闭时 cancel(),中间只在这个 Scope 上 launch。
把文档里的 Activity.destroy() 念成 DisposableBean.destroy()、close()、shutdown() 或 Ktor 3 里 monitor.subscribe(ApplicationStopped) { ... } 一类钩子即可:名字不同,契约相同:生命周期结束必须 cancel 。若框架已提供现成 Scope,优先用框架的,不要再平行造一个 GlobalScope「备份通道」。kotlinx 文档举的例子是 Android 的 ViewModel;服务端的 Ktor 里,Application 本身就是 CoroutineScope,应用停止时会被取消。
kotlin
import kotlinx.coroutines.CoroutineExceptionHandler
import kotlinx.coroutines.CoroutineScope
import kotlinx.coroutines.Dispatchers
import kotlinx.coroutines.SupervisorJob
import kotlinx.coroutines.cancel
import kotlinx.coroutines.delay
import kotlinx.coroutines.launch

class BackgroundWorker {
    // 与文档 Activity 示例同模式:有边界的 Scope;CoroutineScope 文档建议成员 Scope 配 SupervisorJob 和 CoroutineExceptionHandler
    private val scope = CoroutineScope(
        SupervisorJob() + Dispatchers.Default + CoroutineExceptionHandler { _, e ->
            println("worker coroutine failed: $e")
        }
    )

    fun startPolling() {
        scope.launch {
            while (true) {
                delay(500)
                // pollOnce()
            }
        }
    }

    fun shutdown() {
        scope.cancel() // 父取消 → 子递归取消
    }
}

fun main() {
    val worker = BackgroundWorker()
    worker.startPolling()
    // ...服务运行...
    worker.shutdown()
}
落地清单可以压成四条:
- 不必起协程就别起 :能串行的
suspend函数直接调,别为了「看起来异步」就launch。 - 请求内要并发 :在
suspend里用coroutineScope { launch / async },让并发生命周期等于这次调用。 - 顶层非 suspend :用有边界的
CoroutineScope(如上),在 destroy/shutdown 时cancel();不要GlobalScope,也不要随手写CoroutineScope().launch { ... }(没有人持有这个 Scope,也就没人cancel())。 - 生产路径慎用
runBlocking:官方 API 文档把 runBlocking 定位成阻塞代码与挂起代码之间的桥,用于main函数、测试和非 suspend 回调,并明确说在 suspend 函数里调用它是多余的、会堵线程;上面那篇 JetBrains 博客文章也建议只在main()或测试里用。服务里若在事件循环线程上到处runBlocking,等于把异步模型拧回阻塞,取消链也更难跟。
内存与背压方面,上面那篇 JetBrains 博客文章提到可用 Dispatchers.IO.limitedParallelism(...) 限制 IO 并行度(limitedParallelism 自 kotlinx.coroutines 1.9.0 起是稳定 API),用带上限的 flow.buffer(...) 避免无界堆积;文中示例是 onBufferOverflow = BufferOverflow.DROP_OLDEST,会丢旧数据,只适合允许丢弃的场景。这些是作者的个人实践建议,并非 kotlinx 文档里的「必须如此」,文中「每个线程约 1-2 MB」之类的数字也是作者的经验值,不是官方基准。这里的焦点仍是 Scope 与取消:先把 GlobalScope 挪掉,再谈限流旋钮。该文还提到,堆没涨而 RSS 在涨时,多半是线程栈或直接内存;那是下一层问题,和「协程有没有边界」是两件衣服,别混着改。
四、评审时可以对照的检查表
把协程相关改动丢进评审时,可以按表扫一遍,成本很低:
| 写法 | 问题 | 建议 |
|---|---|---|
GlobalScope.launch |
无 Job,不能 cancel/await 全部 | 仅应用级后台 + @OptIn + CoroutineExceptionHandler |
裸 CoroutineScope().launch |
与 GlobalScope 同类坑 | 不要当「安全替代」 |
有边界 Scope + cancel() |
--- | 绑服务生命周期 |
coroutineScope / supervisorScope |
--- | 请求内并发的默认工具 |
生产路径 runBlocking |
堵线程、难取消 | 留给 main()/测试 |
launch(Job()) 脱离父 Job |
取消传不下去 | 确认是否真要独立;多数业务不要 |
补充两点实操经验:
- 关闭顺序 (作者经验,非文档结论):先停接入(不再接新请求),再
scope.cancel(),再关线程池/客户端;倒过来容易在取消过程中又launch出新任务。 - 日志与调试 :需要时用文档提到的
-Dkotlinx.coroutines.debug让线程名带上协程名,比只看线程池工人号更容易对上「谁还活着」。这解决的是可见性,不能替代正确的 Scope 边界。
五、和「线程思维」掰扯清楚
后端同学从 Java 线程池迁过来时,容易带着三句口头禅:
- 「丢进全局线程池就行」→ 映射成
GlobalScope.launch; - 「这里同步等等结果」→ 映射成到处
runBlocking; - 「子任务独立跑,别影响我」→ 映射成随手
launch(Job())或另起 Scope。
结构化并发不禁止并发,只禁止说不清谁负责收尸 。请求级并发用 coroutineScope;组件级后台用成员 Scope + shutdown 时 cancel();进程级常驻才考虑带 Opt-In 的 GlobalScope。三者分层之后,Dispatcher 选 Default 还是 IO、要不要 limitedParallelism,才是下一层优化。内存排查类的建议,也要建立在「你没有无主协程在漏」的前提上。
若你维护的是长期运行的 Kotlin 服务,不妨在架构图上显式画两个框:请求 Scope (随调用创建/结束)和 组件 Scope(随 Bean/Worker 启停)。代码审查对照这两框,比争论「协程到底算不算轻量线程」更接近生产问题。GlobalScope 不属于其中任一框,所以默认就应该可疑。
小结:结构化并发要的是谁启动,谁负责取消与等待。GlobalScope 让人绕开这些「手续」,同时也丢掉了它的好处;后端要的恰恰是取消、等待、异常边界。先做到「可取消、可等待、可解释」,再谈 Dispatcher 调参与背压,顺序反了,调参只是在给无主协程续命。把手续补回来,标题里的「别再用」才站得住。