数据清洗是数据科学与分析中至关重要的预处理步骤,其核心功能是通过程序逻辑或人工规则,系统性地检测、纠正、填补或剔除数据集中存在的缺失值、异常值、重复项及格式不一致等"脏数据"。执行这一过程的根本目的在于消除底层数据噪音,打破"垃圾进,垃圾出"(Garbage In, Garbage Out)的隐患,从而大幅提升整体数据的准确性、完整性与一致性,确保后续输入统计模型或机器学习算法的信息真实可靠,最终帮助分析人员和决策者基于高质量的客观证据得出科学、有效且具备实际指导意义的洞察结论。
实验数据源参考:UK Data Service 数据下载与配置教程
第一部分:创建 RStudio 项目环境 (Project)
创建 Project 是使用 R 语言的最佳实践,它可以帮您自动设定工作目录,避免以后出现找不到文件(路径报错)的问题。
-
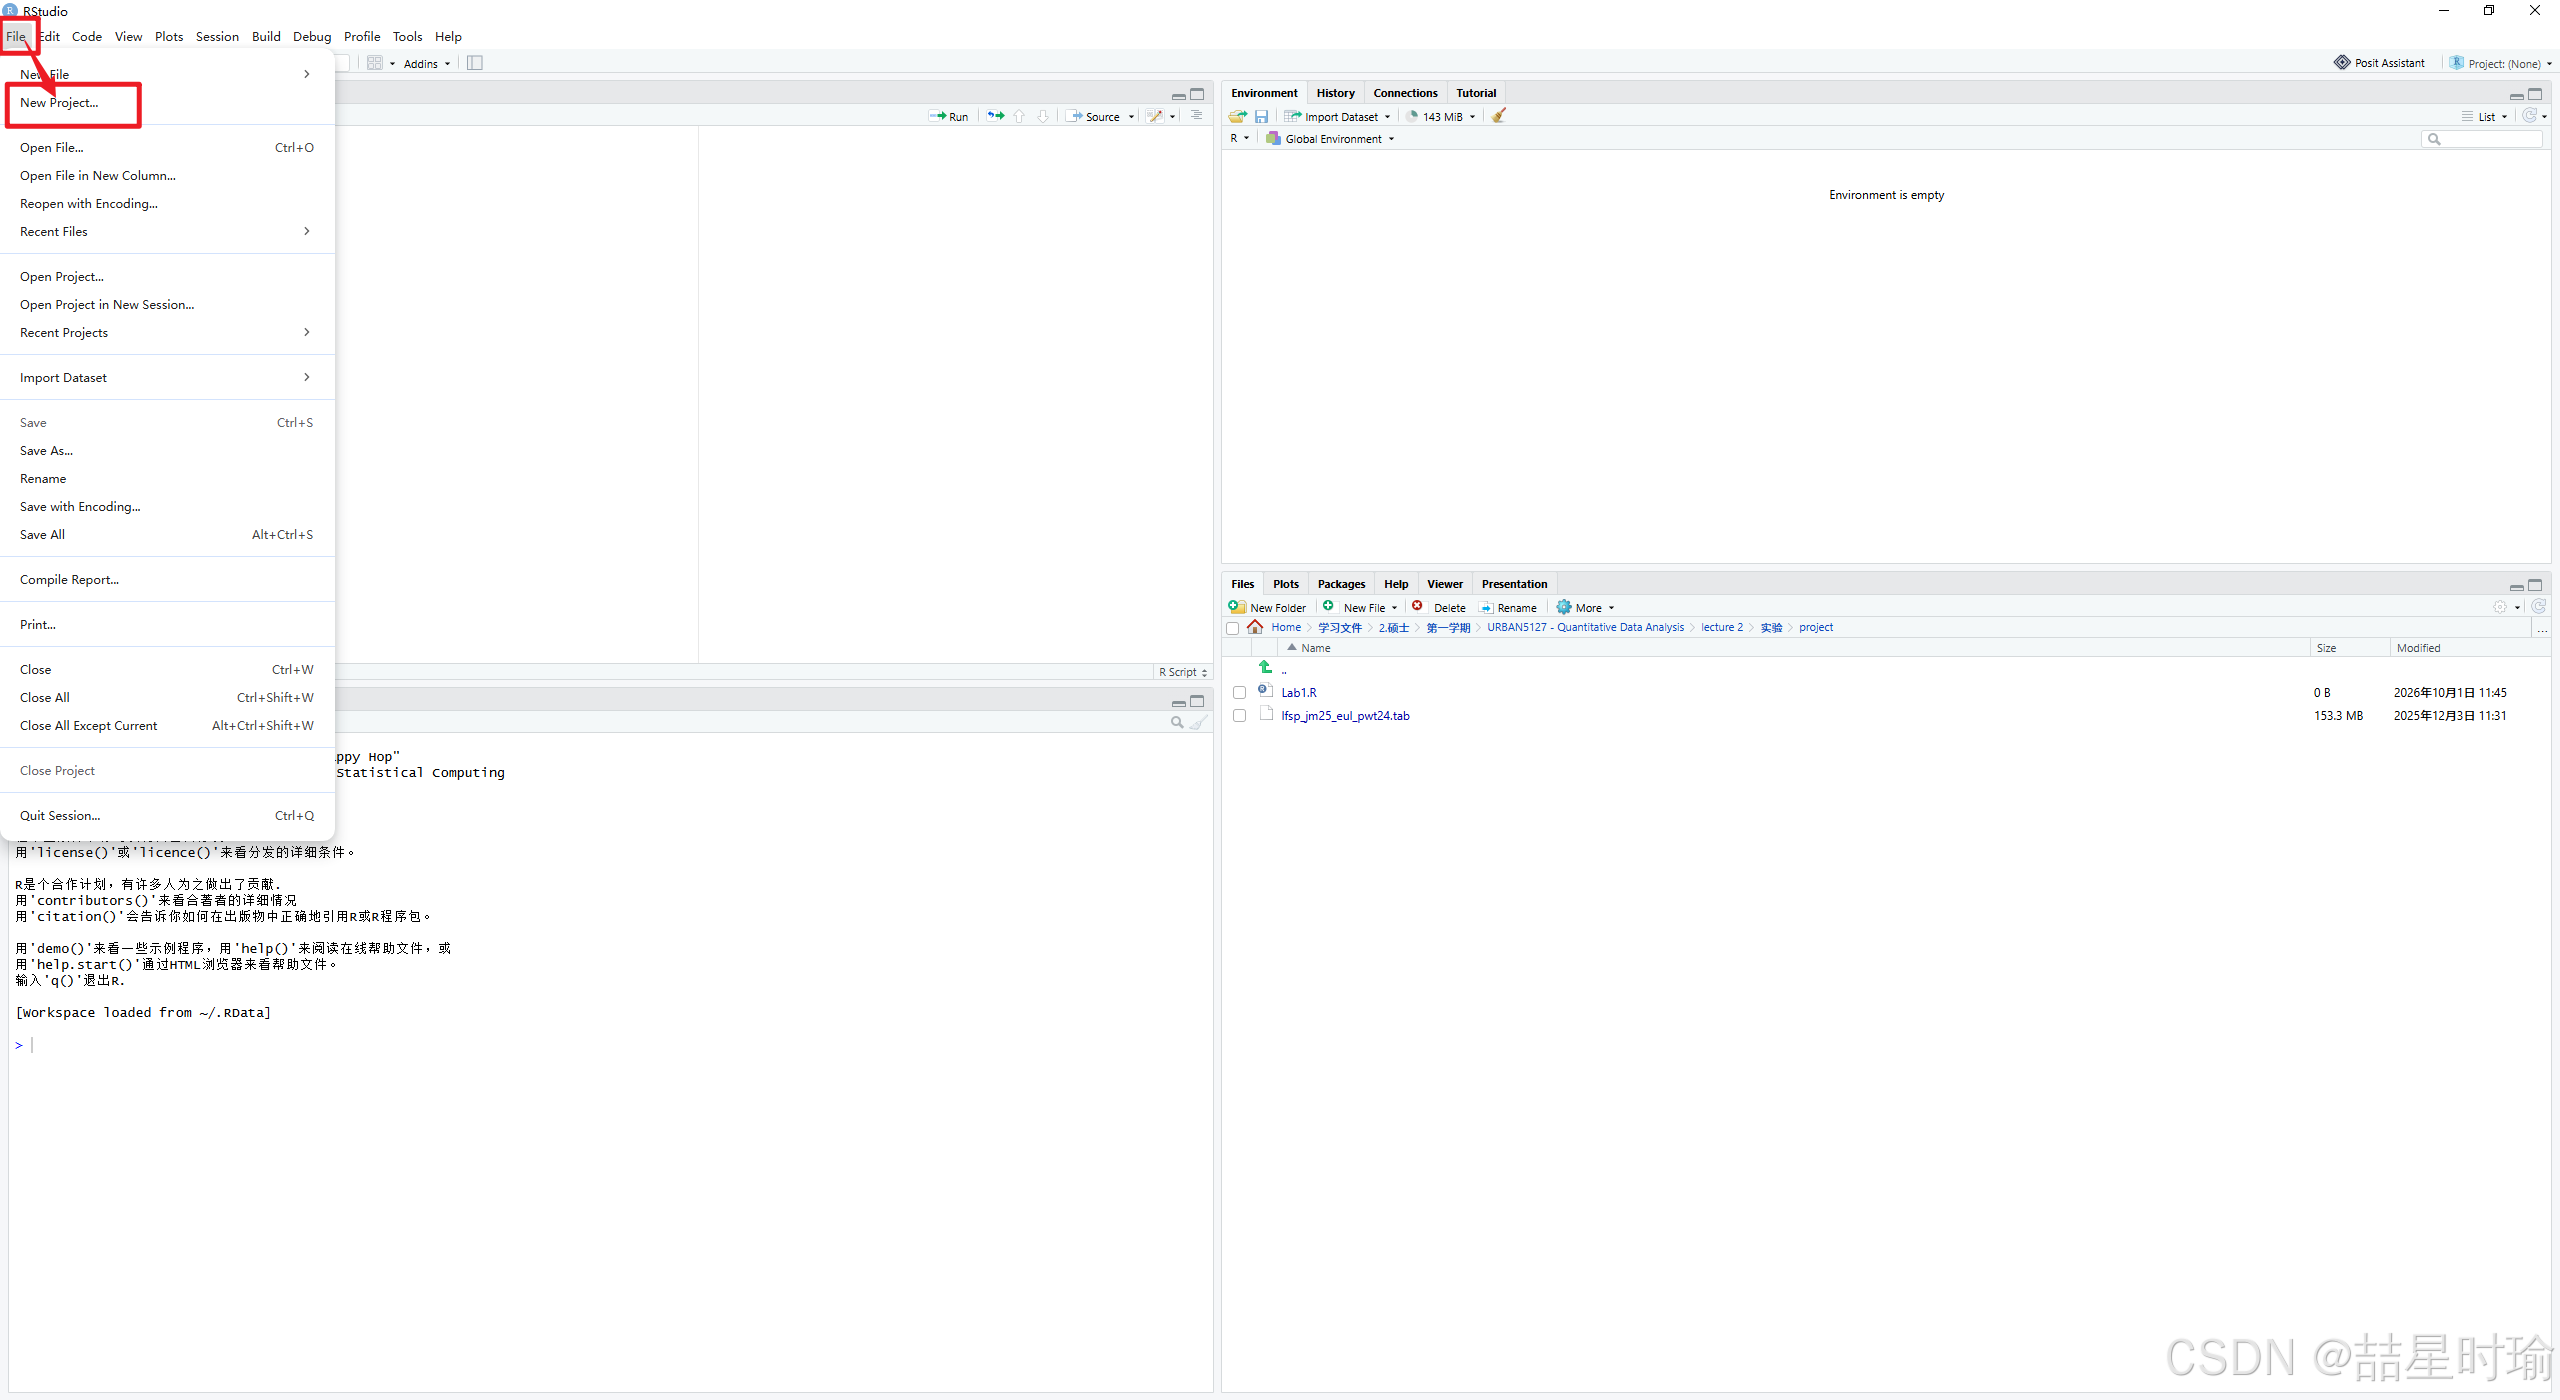
新建项目 :在 RStudio 界面左上角,点击菜单栏的 "File" ,然后在下拉菜单中选择 "New Project..."。
-
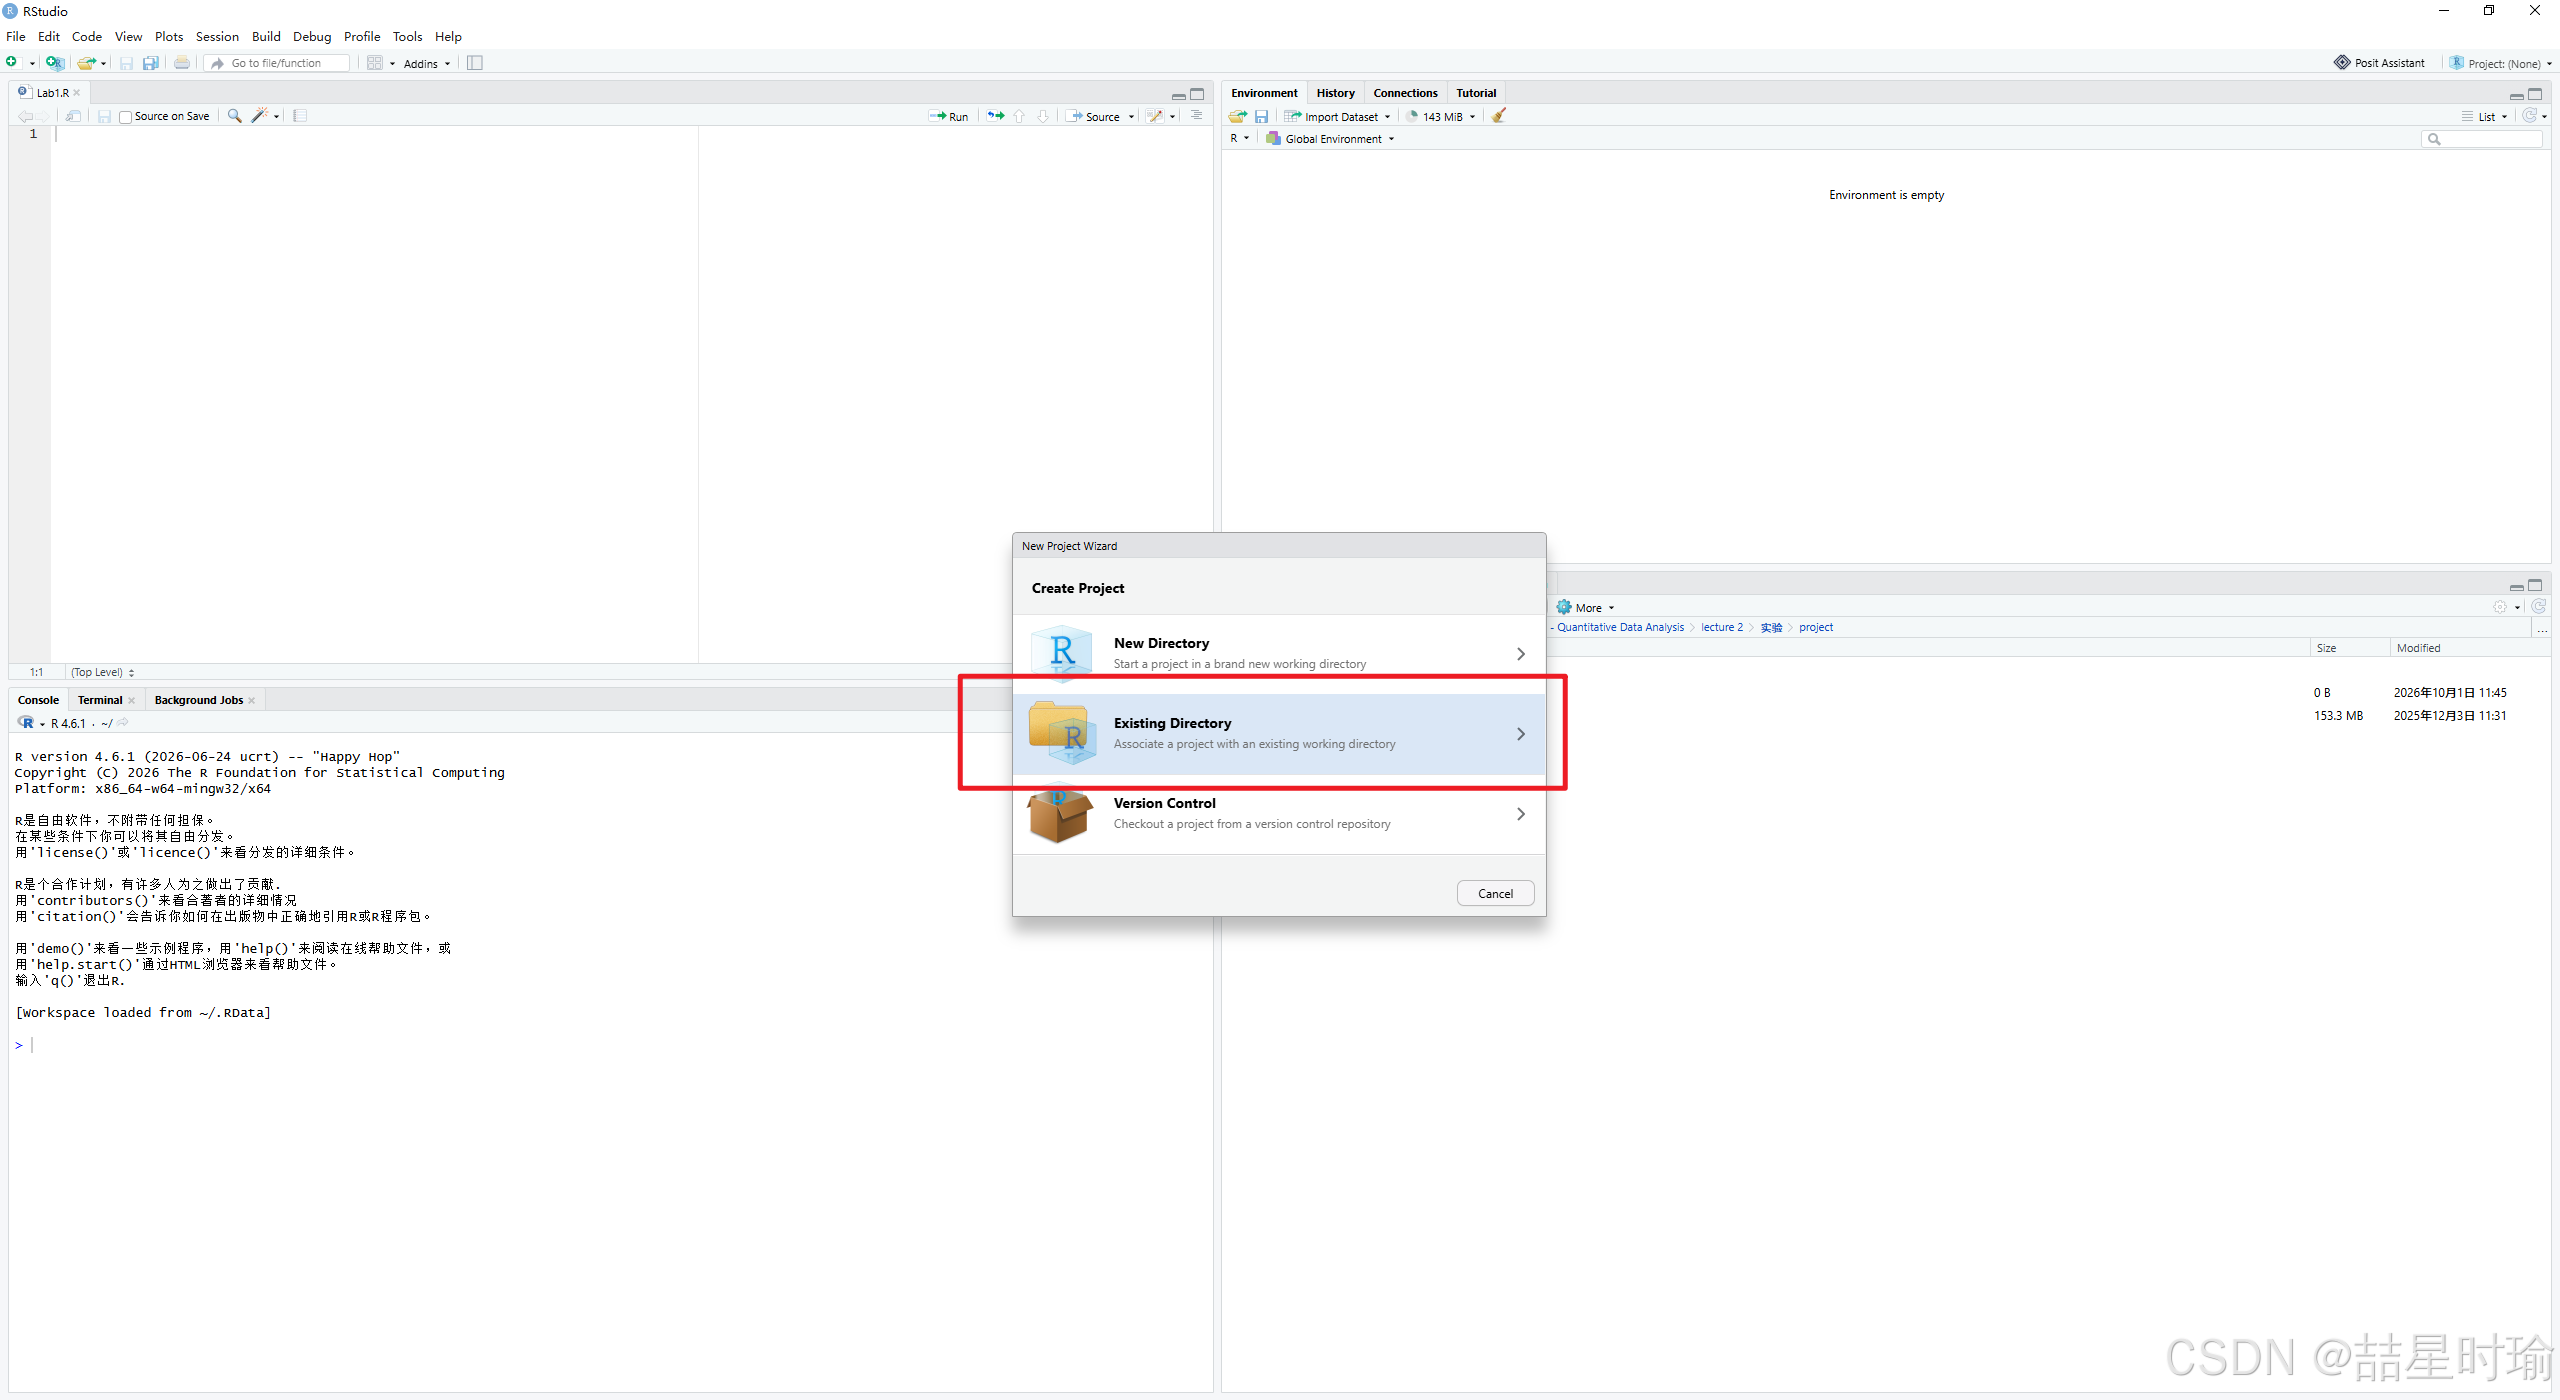
选择目录类型 :在弹出的 "New Project Wizard" 窗口中,点击中间的 "Existing Directory"(现有目录)选项。
-
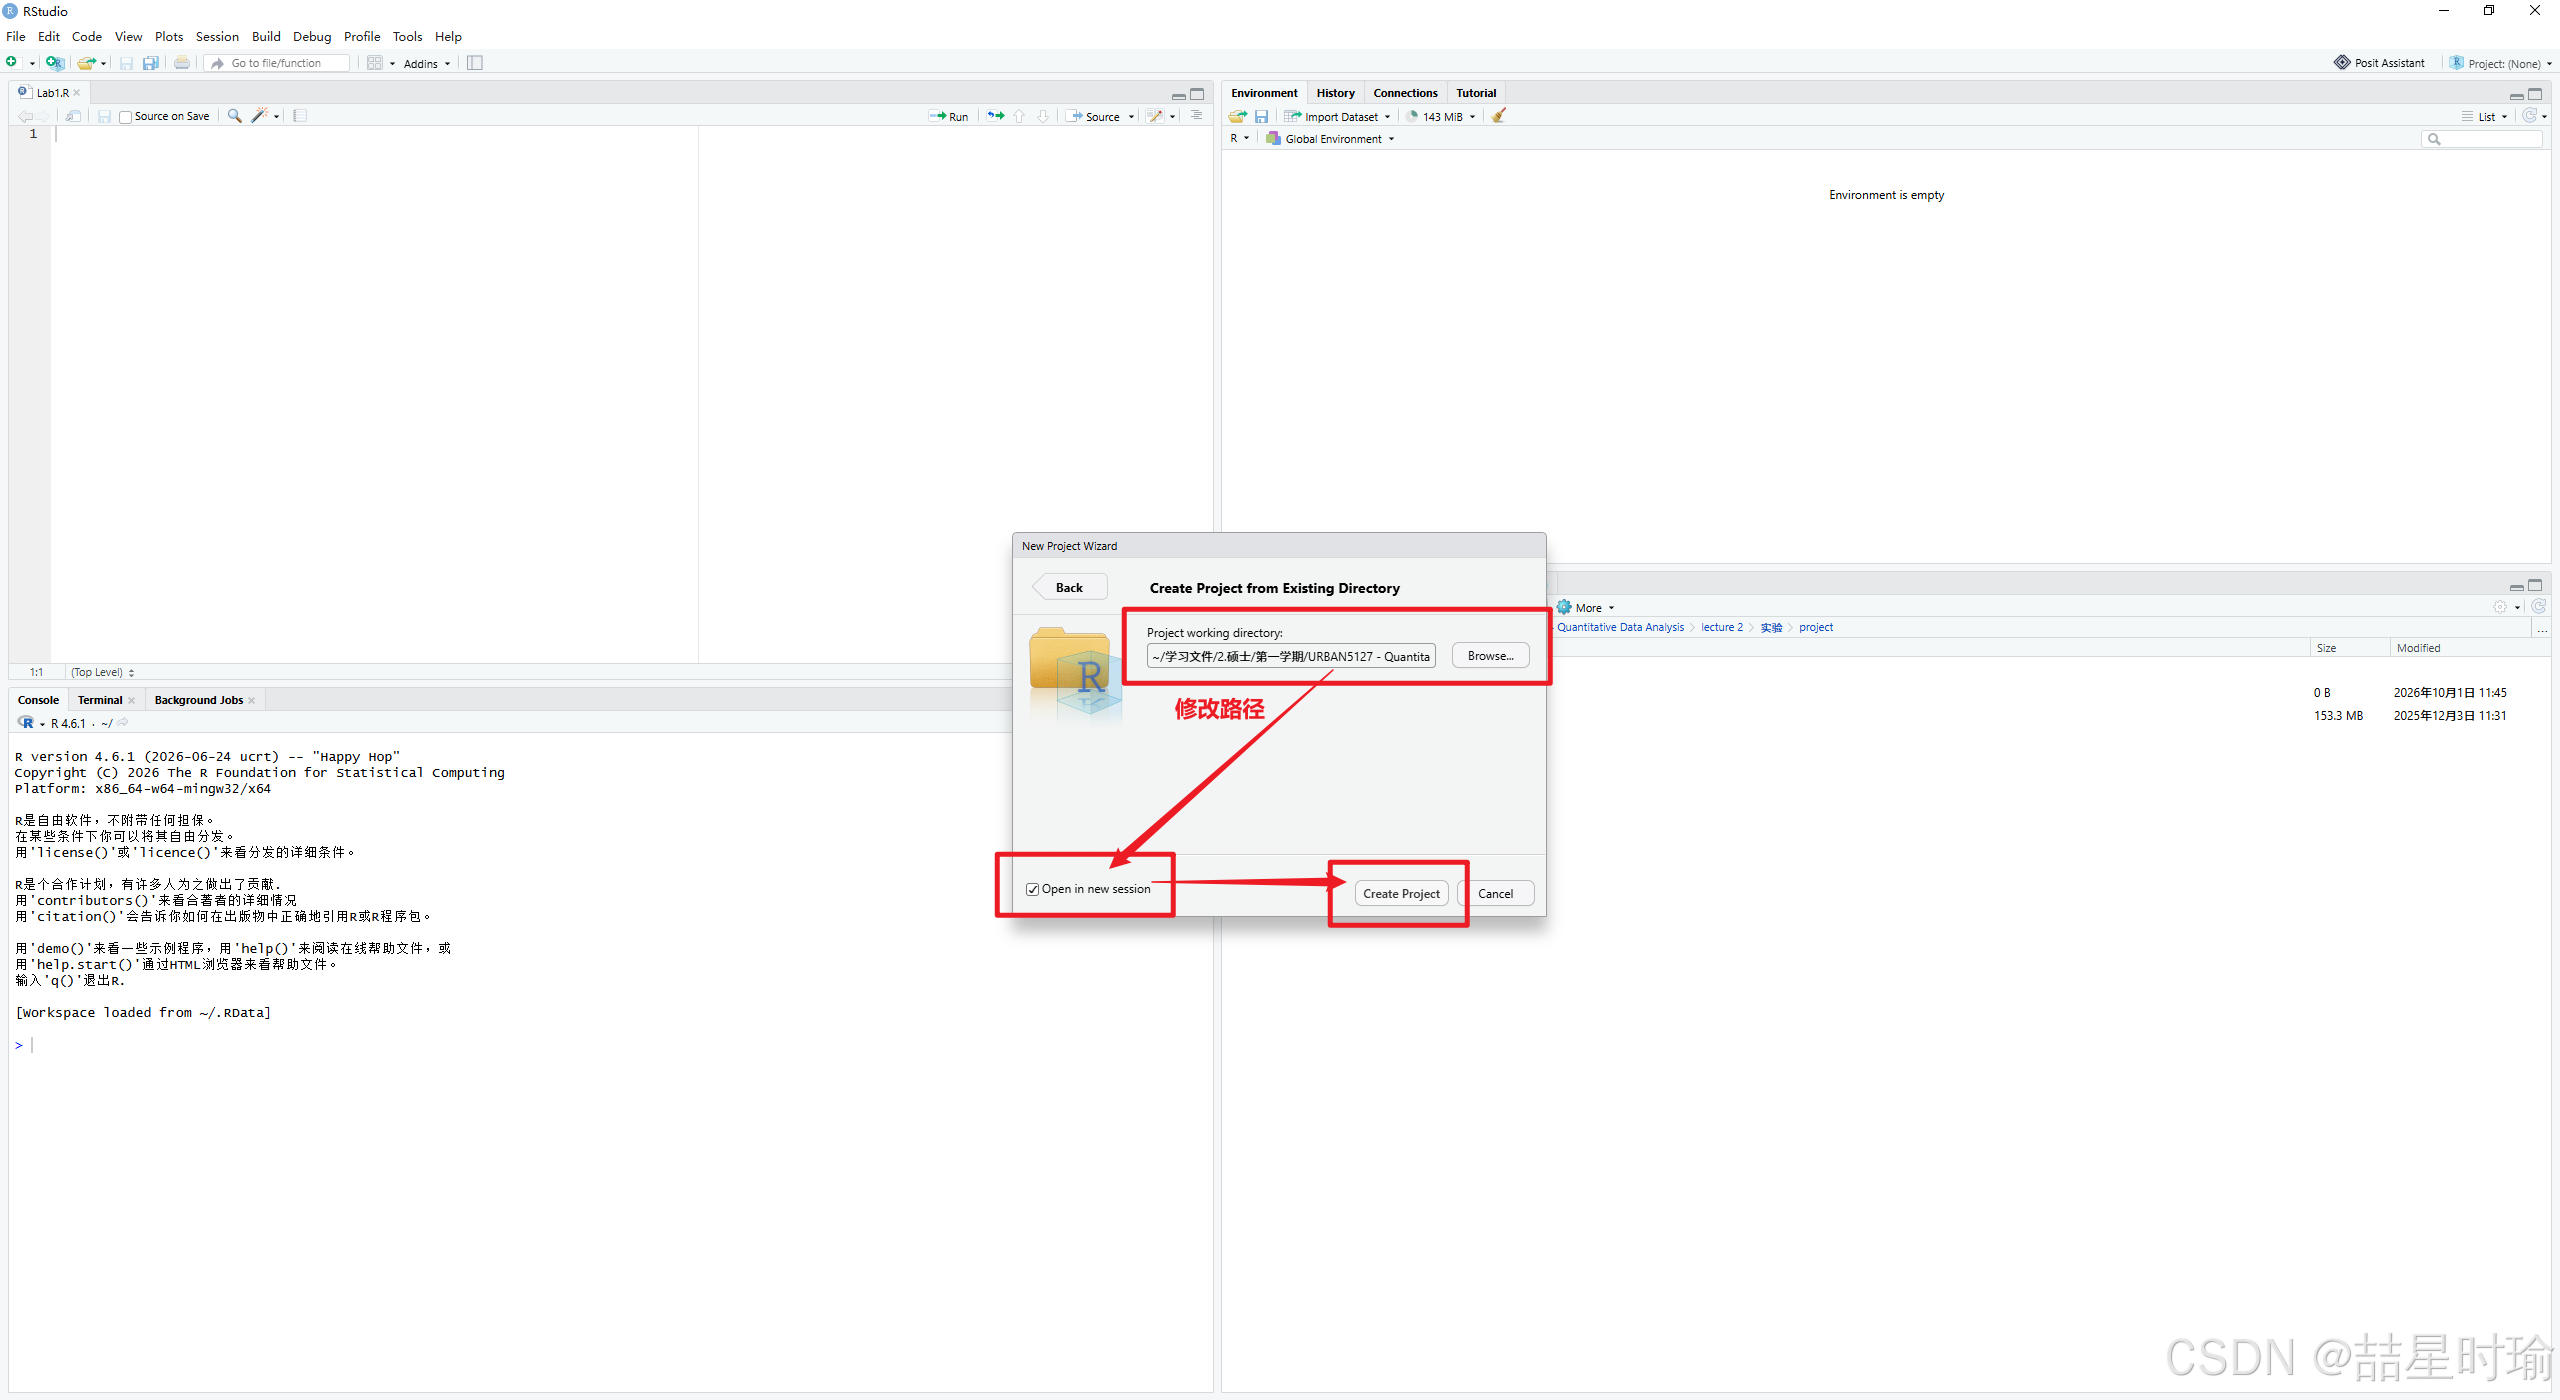
设置工作路径:
-
点击 "Browse..." 按钮,修改路径,找到您存放实验数据的文件夹(例如
~/学习文件/2.硕士/第一学期/URBAN5127 - Quantita.../lecture 2/实验/project)。 -
勾选左下角的 "Open in new session"(在新会话中打开)。
-
点击右下角的 "Create Project" 按钮完成创建。
-
-
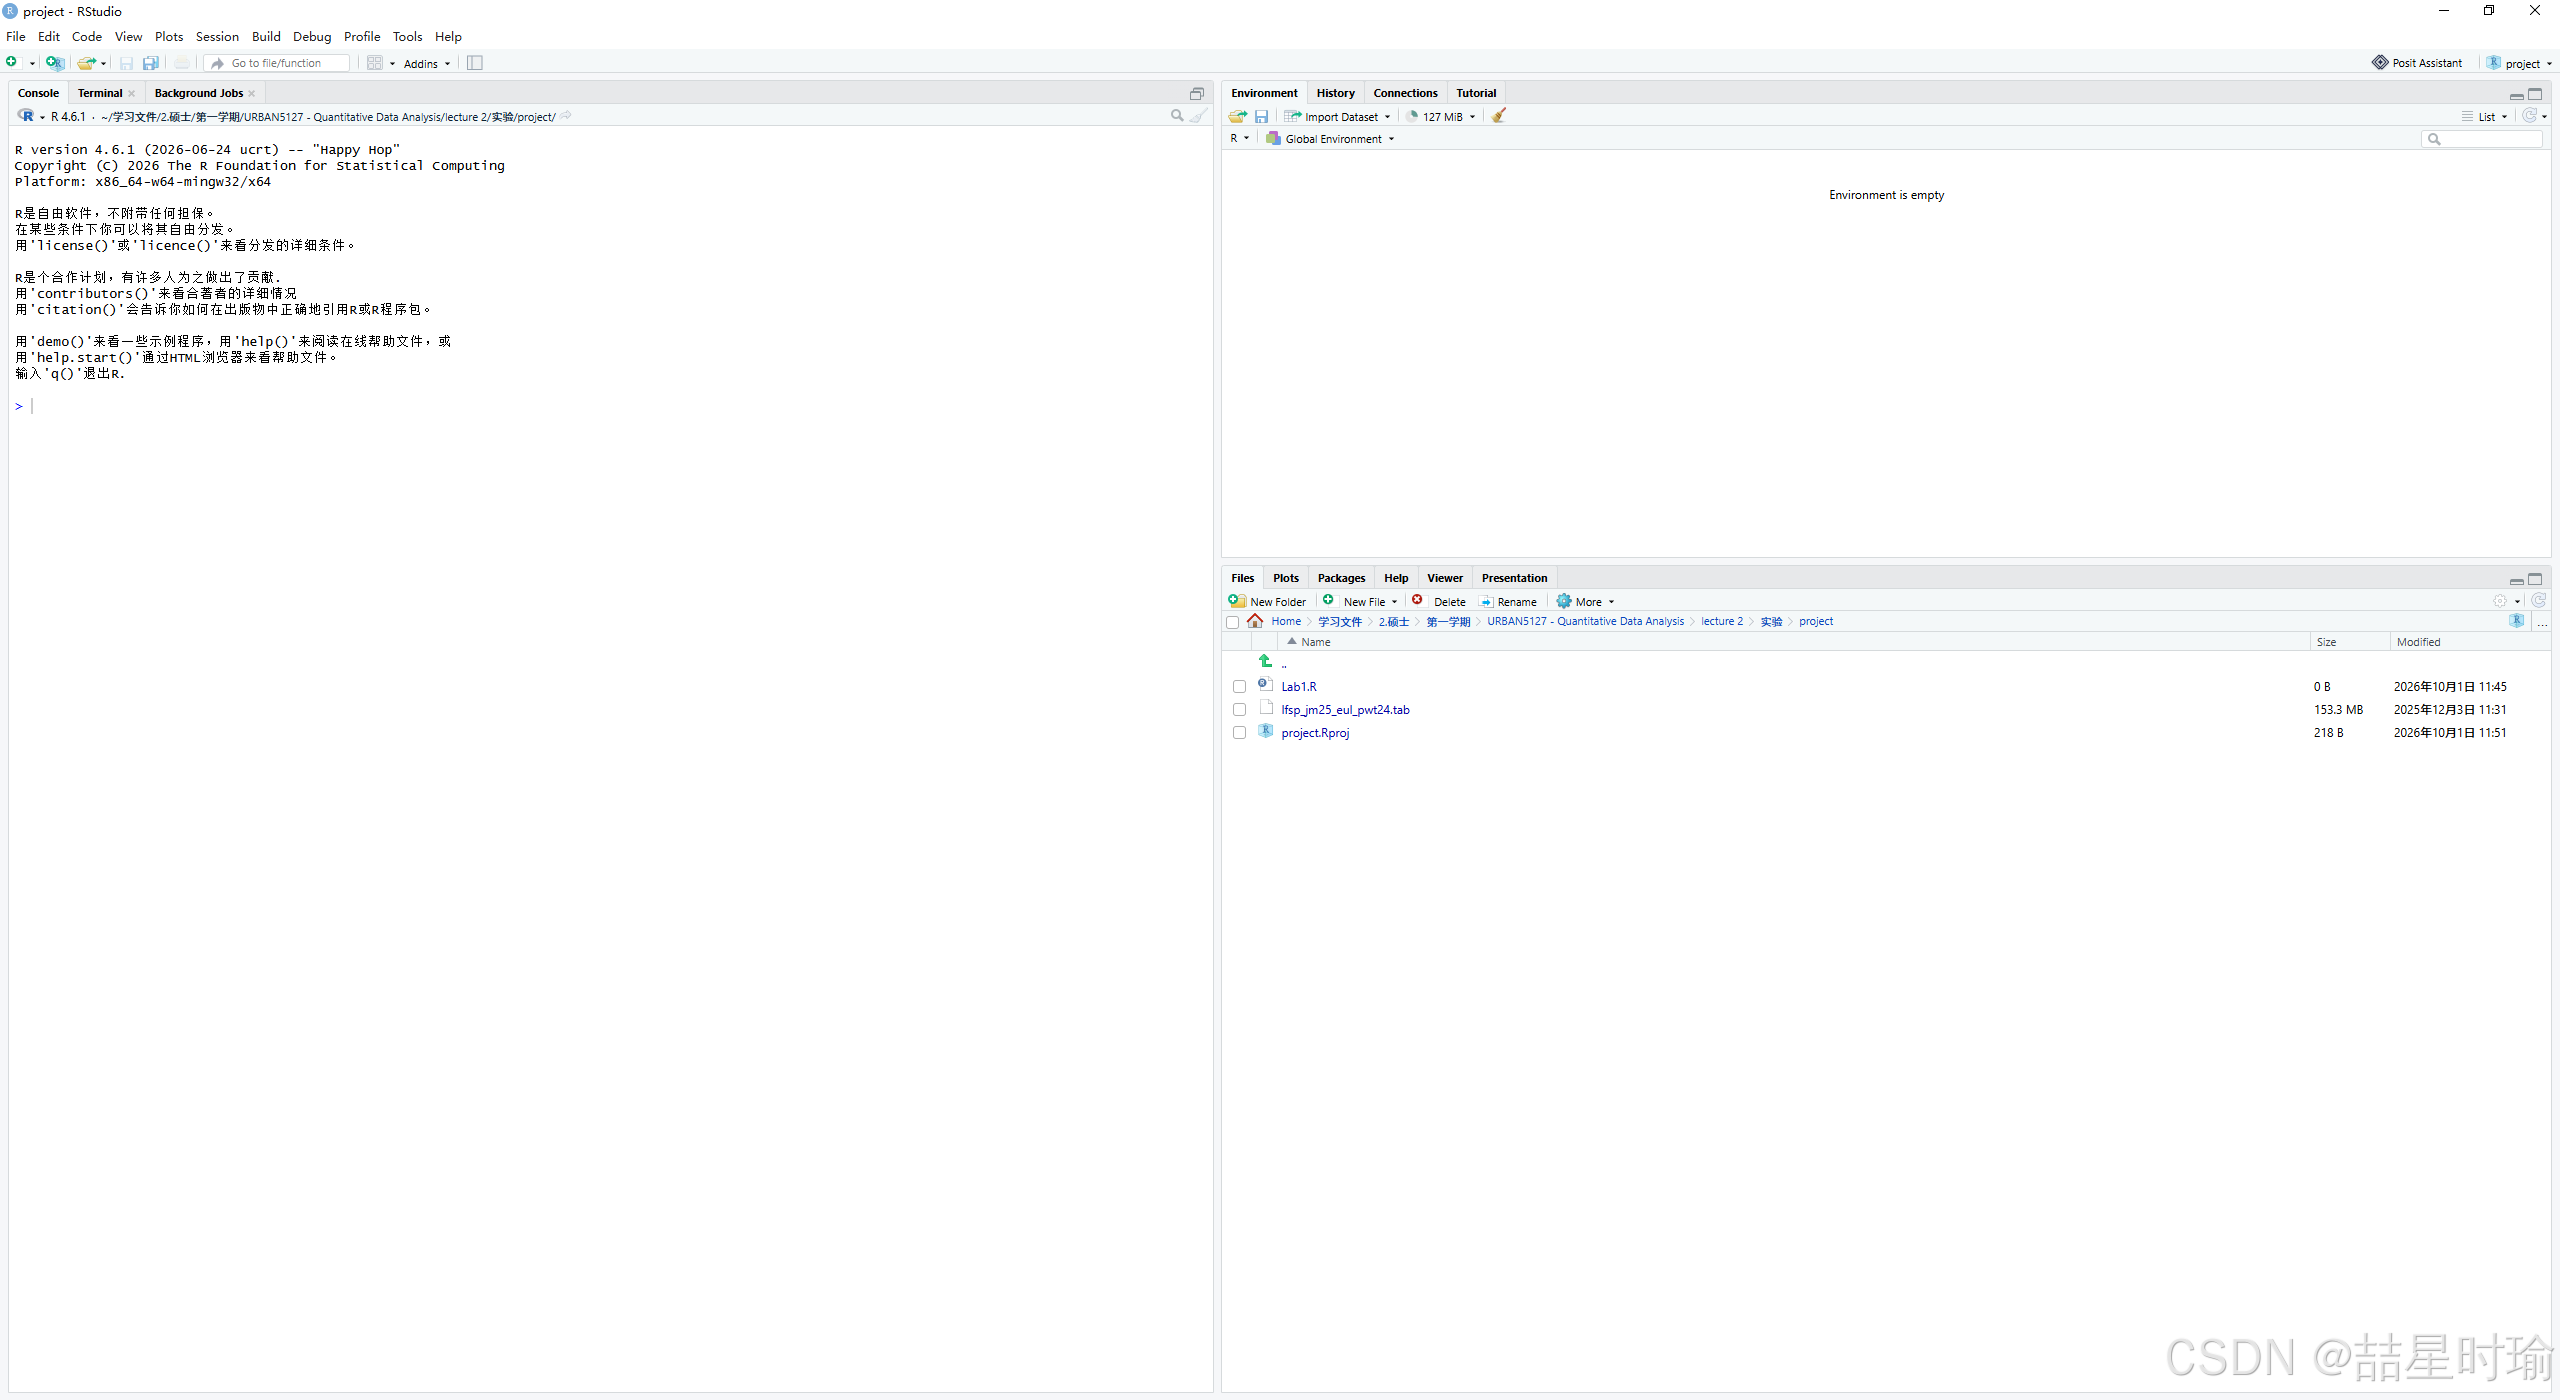
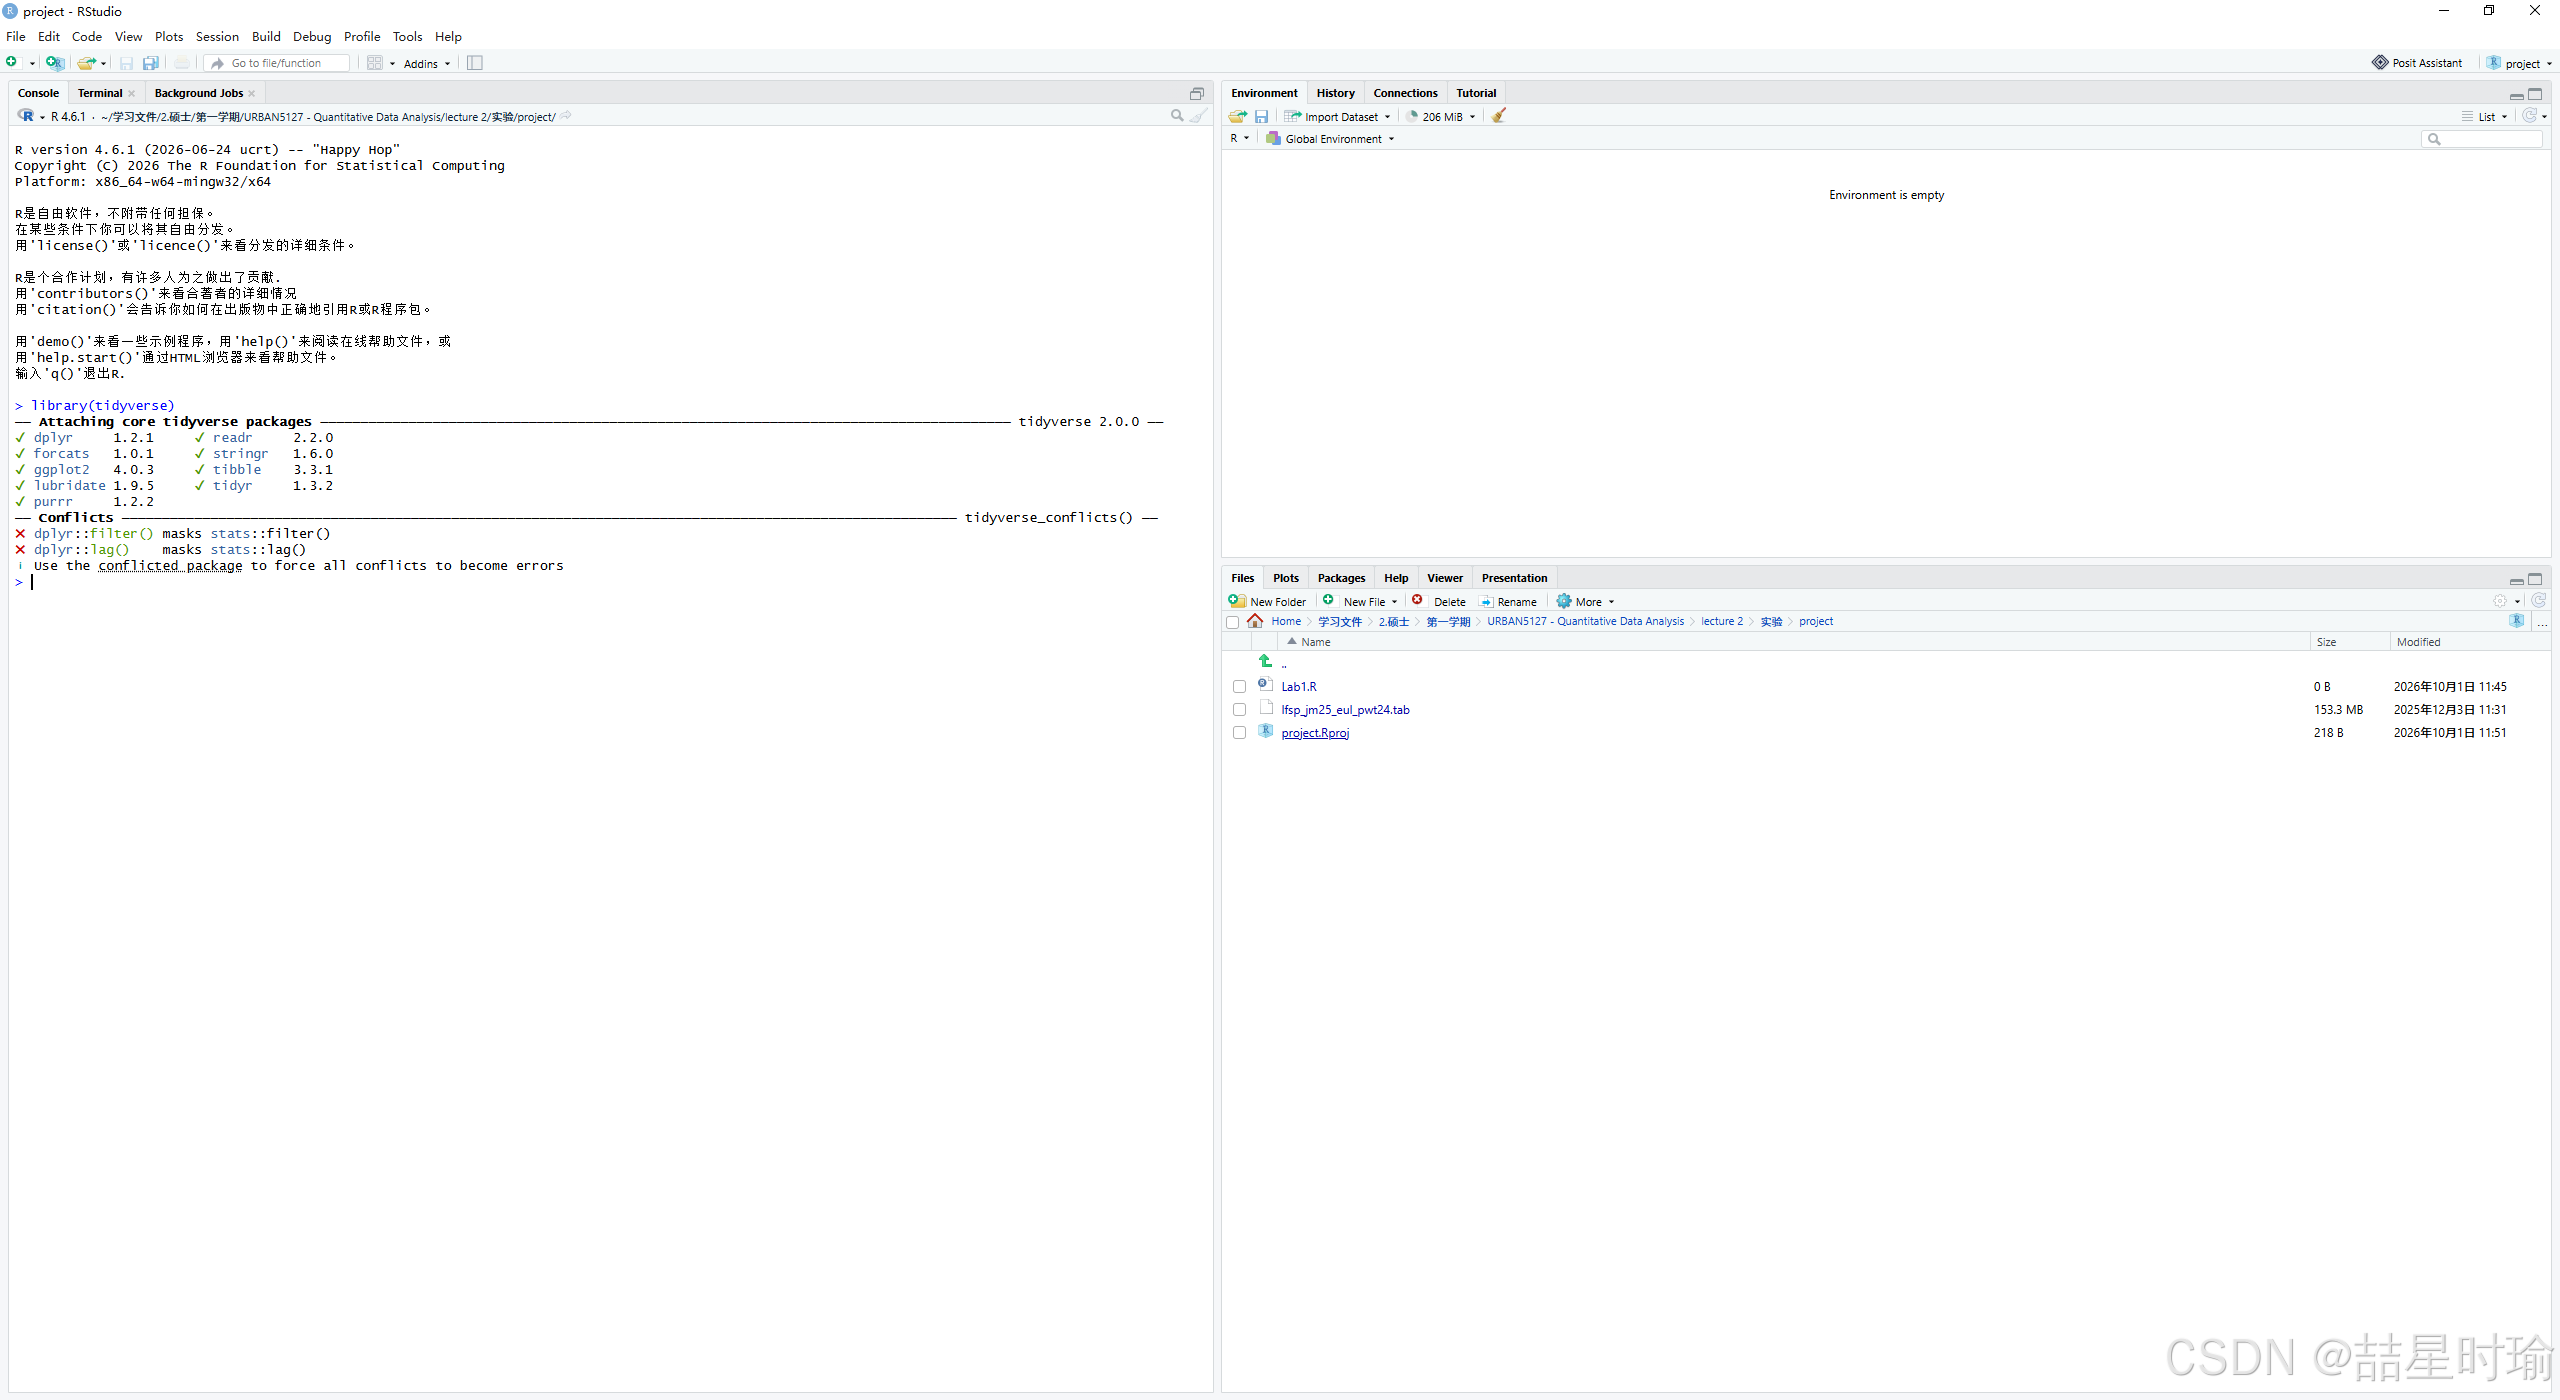
检查环境 :创建成功后,您会在 RStudio 右下角的 "Files" 面板中看到您所在文件夹的内容,包括
Lab1.R脚本文件和数据文件(如lfsp_jm25_eul_pwt24.tab或包含它的文件夹),此时右上角 Environment 面板显示 "Environment is empty"。
第二部分:R 语言数据处理实操
接下来,在控制台 console 中输入以下代码,并逐段运行。
步骤 1:加载核心工具包
在进行任何数据处理前,必须先加载 tidyverse 包。
library(tidyverse)运行后,您会在左下角的 Console(控制台)看到一系列包的加载信息以及一些冲突提示(Conflicts),这是正常的。
步骤 2:读取数据
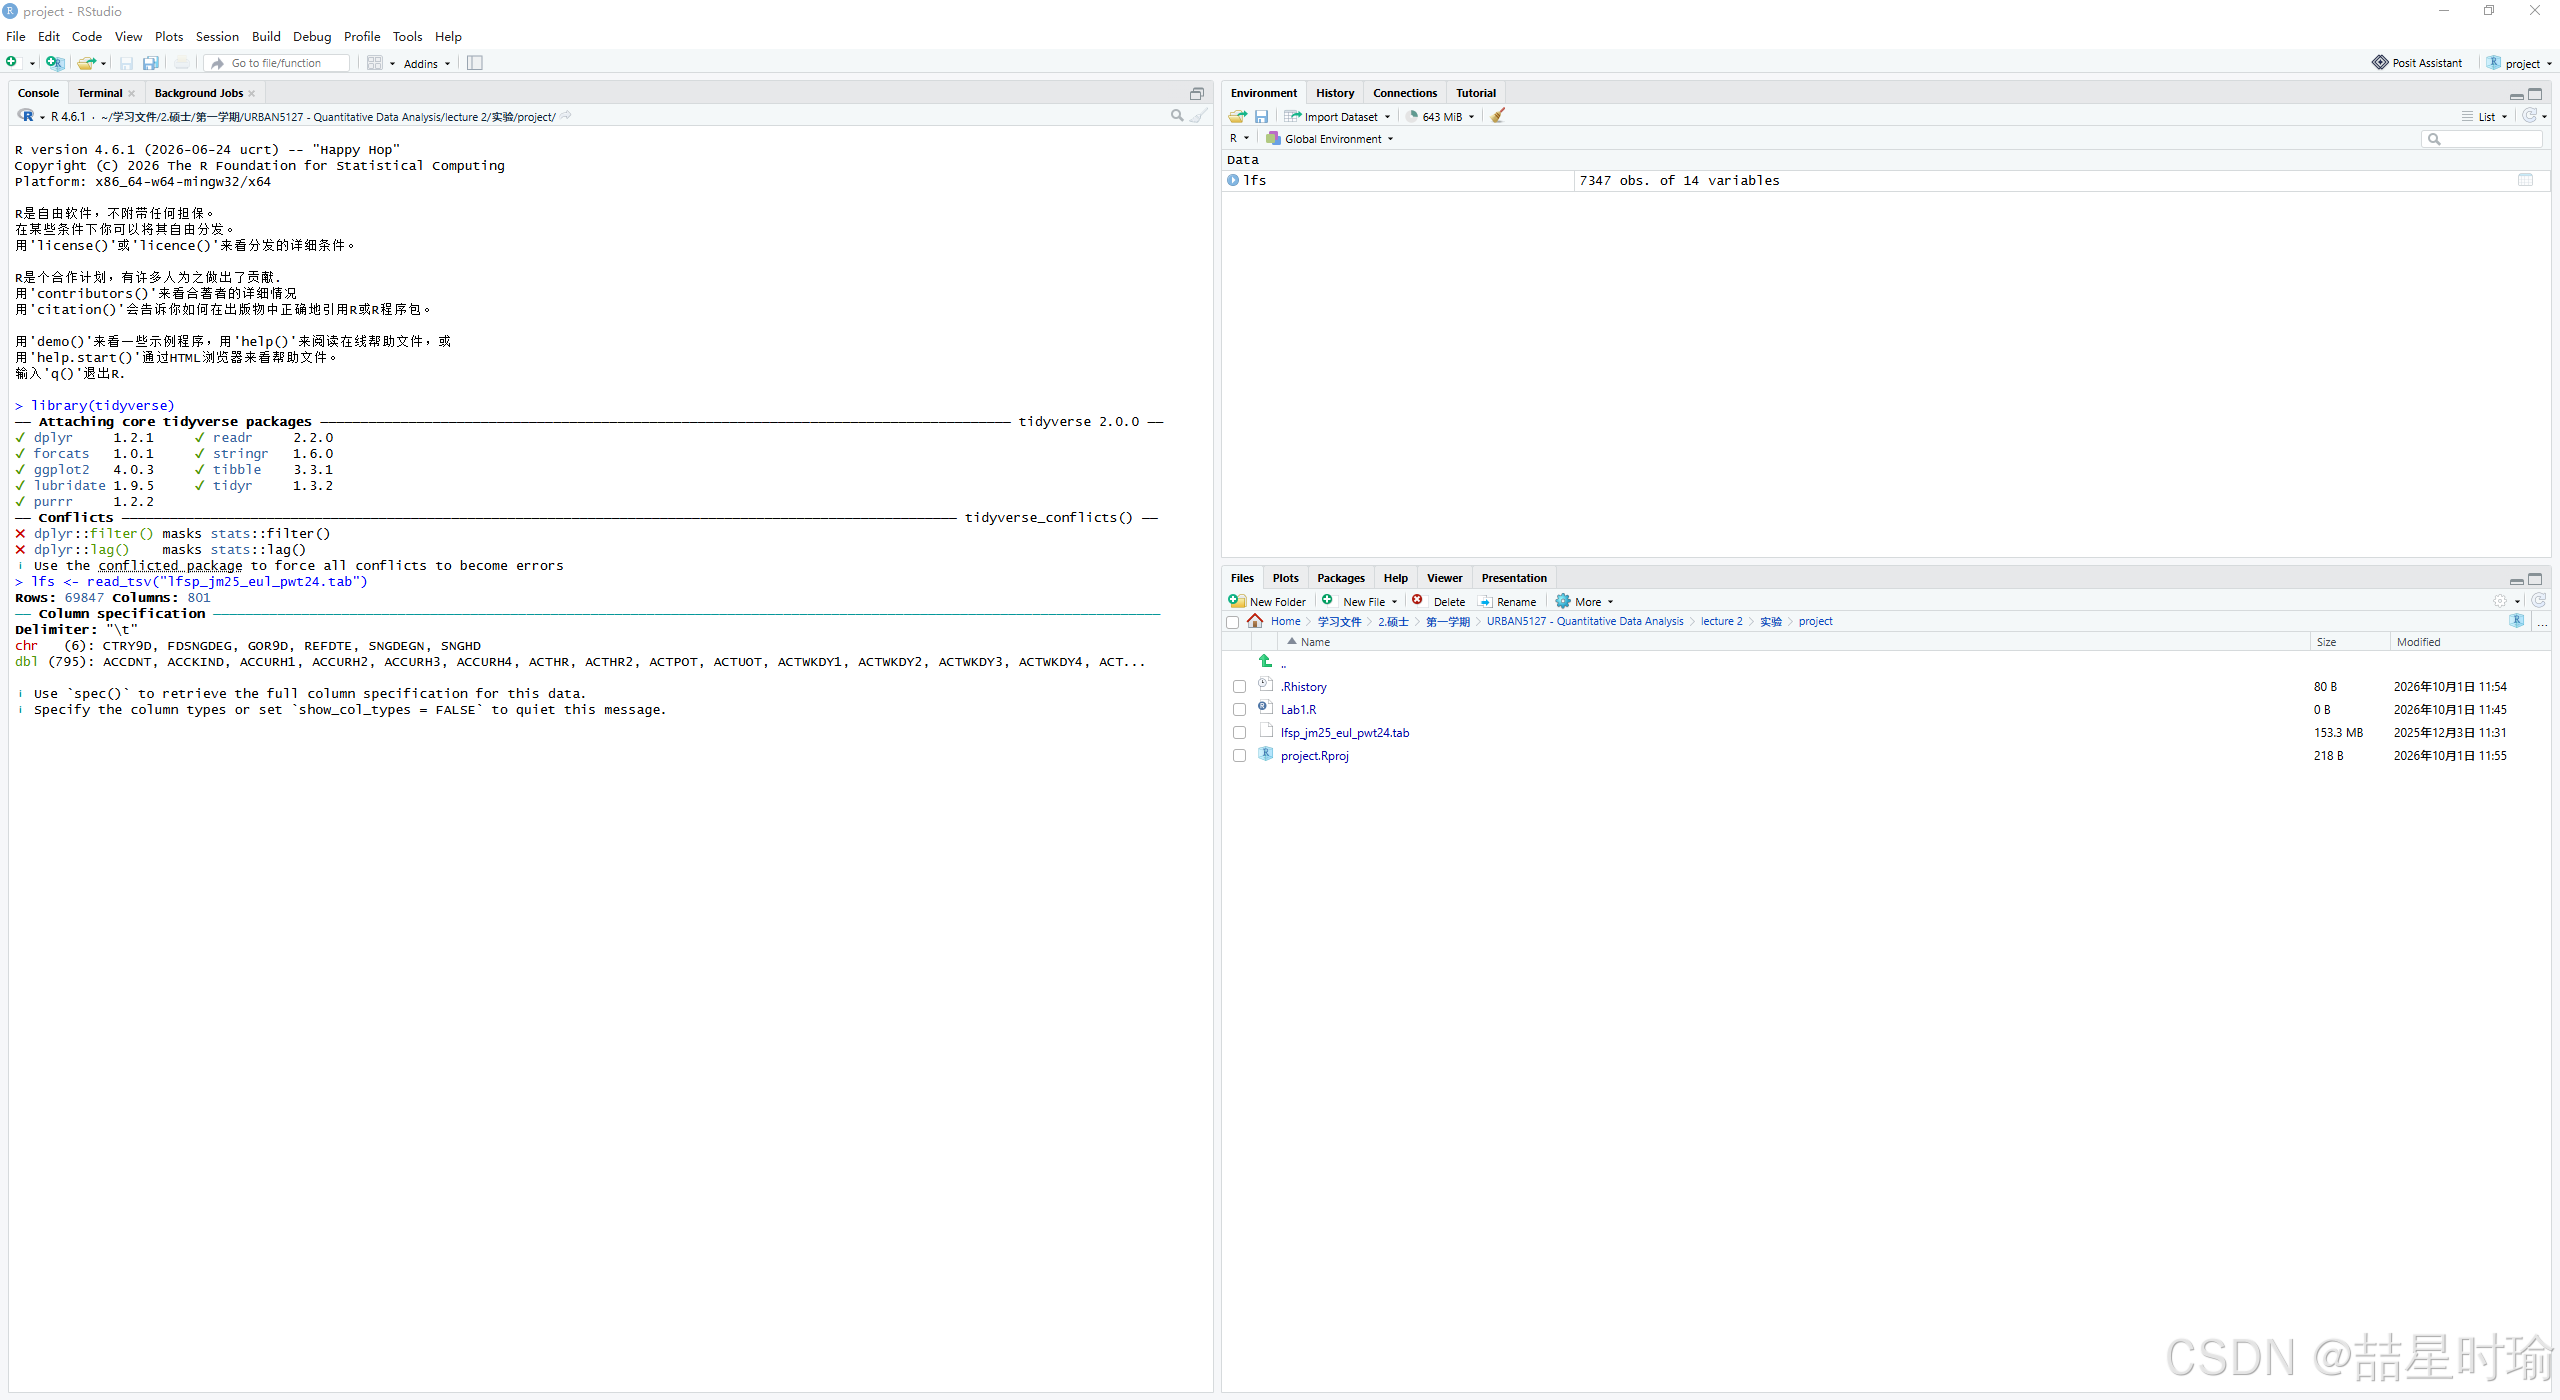
使用 read_tsv 函数读取您下载的制表符分隔数据。确保 .tab 文件和创建的 .project 文件在同一个目录文件夹中
lfs <- read_tsv("lfsp_jm25_eul_pwt24.tab")运行后,右上角的 Environment 面板中会出现 lfs 对象,显示共有 69847 个观测值(obs.)和 801 个变量(variables)。
步骤 3:选择核心变量 (select)
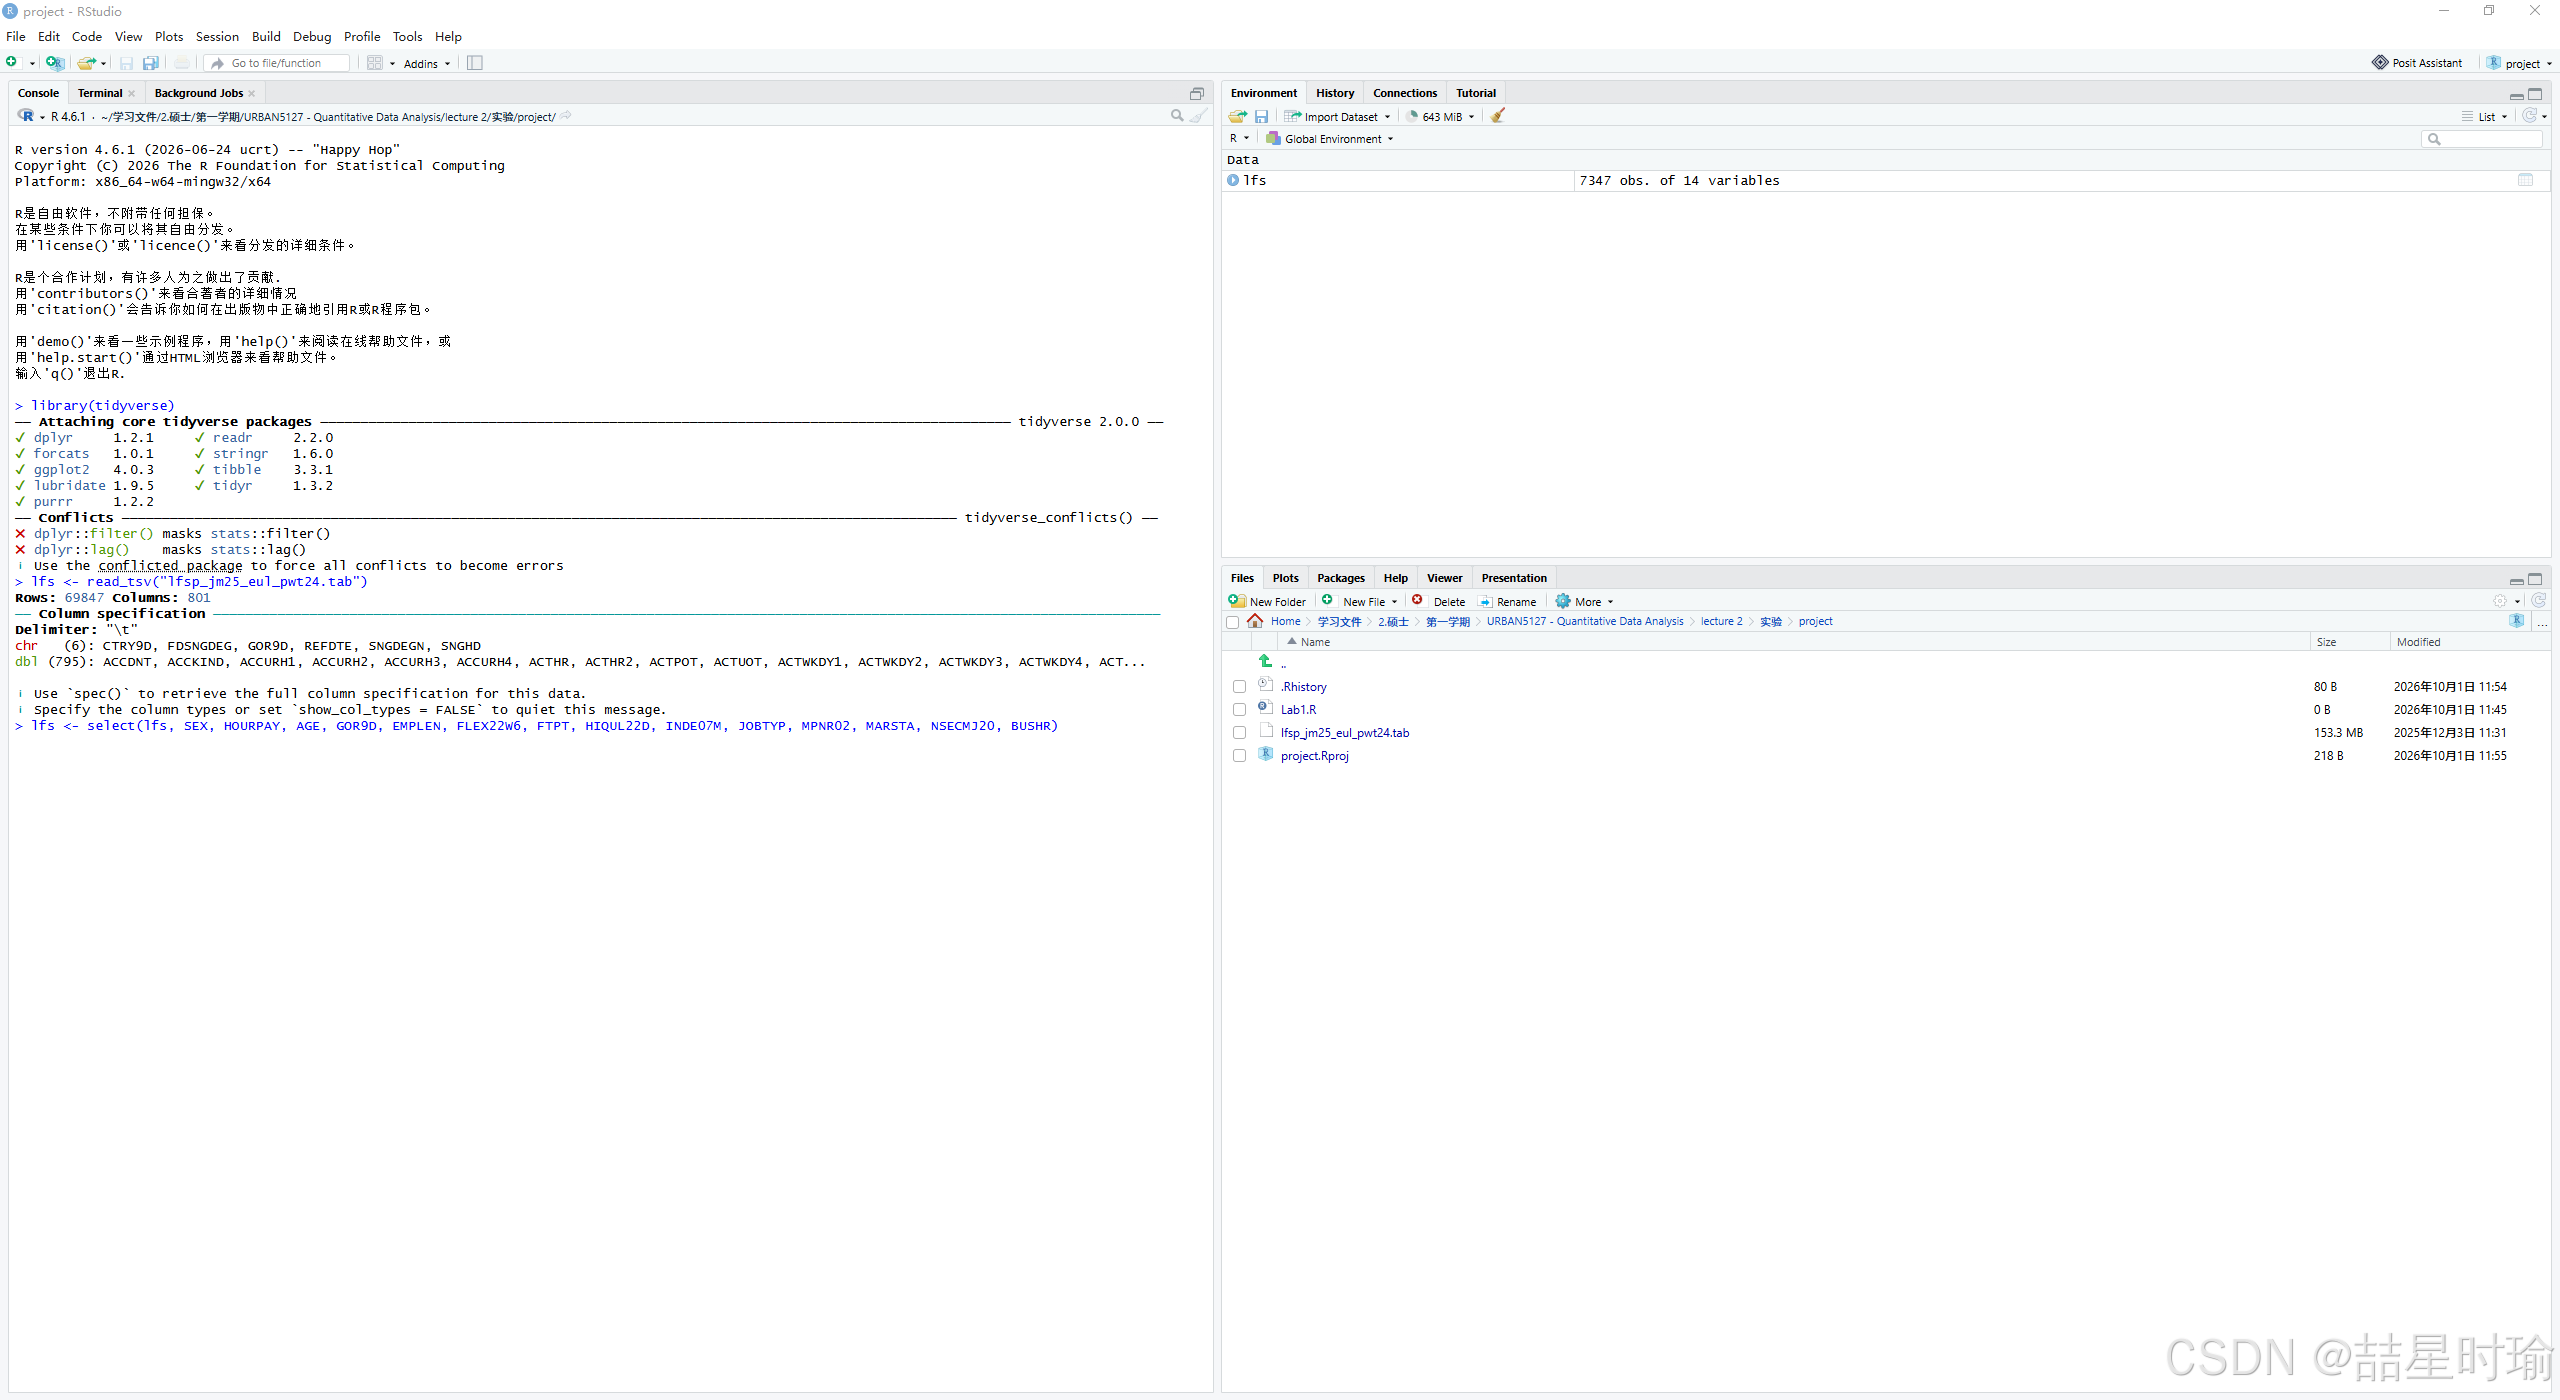
由于原始数据变量太多,我们只提取需要的 14 个变量。
lfs <- select(lfs, SEX, HOURPAY, AGE, GOR9D, EMPLEN, FLEX22W6, FTPT, HIQUL22D, INDE07M, JOBTYP, MPNR02, MARSTA, NSECMJ20, BUSHR)运行后,Environment 面板中的 lfs 对象会更新,变量数从 801 减少到 14 variables。
步骤 4:数据过滤与清洗 (filter)
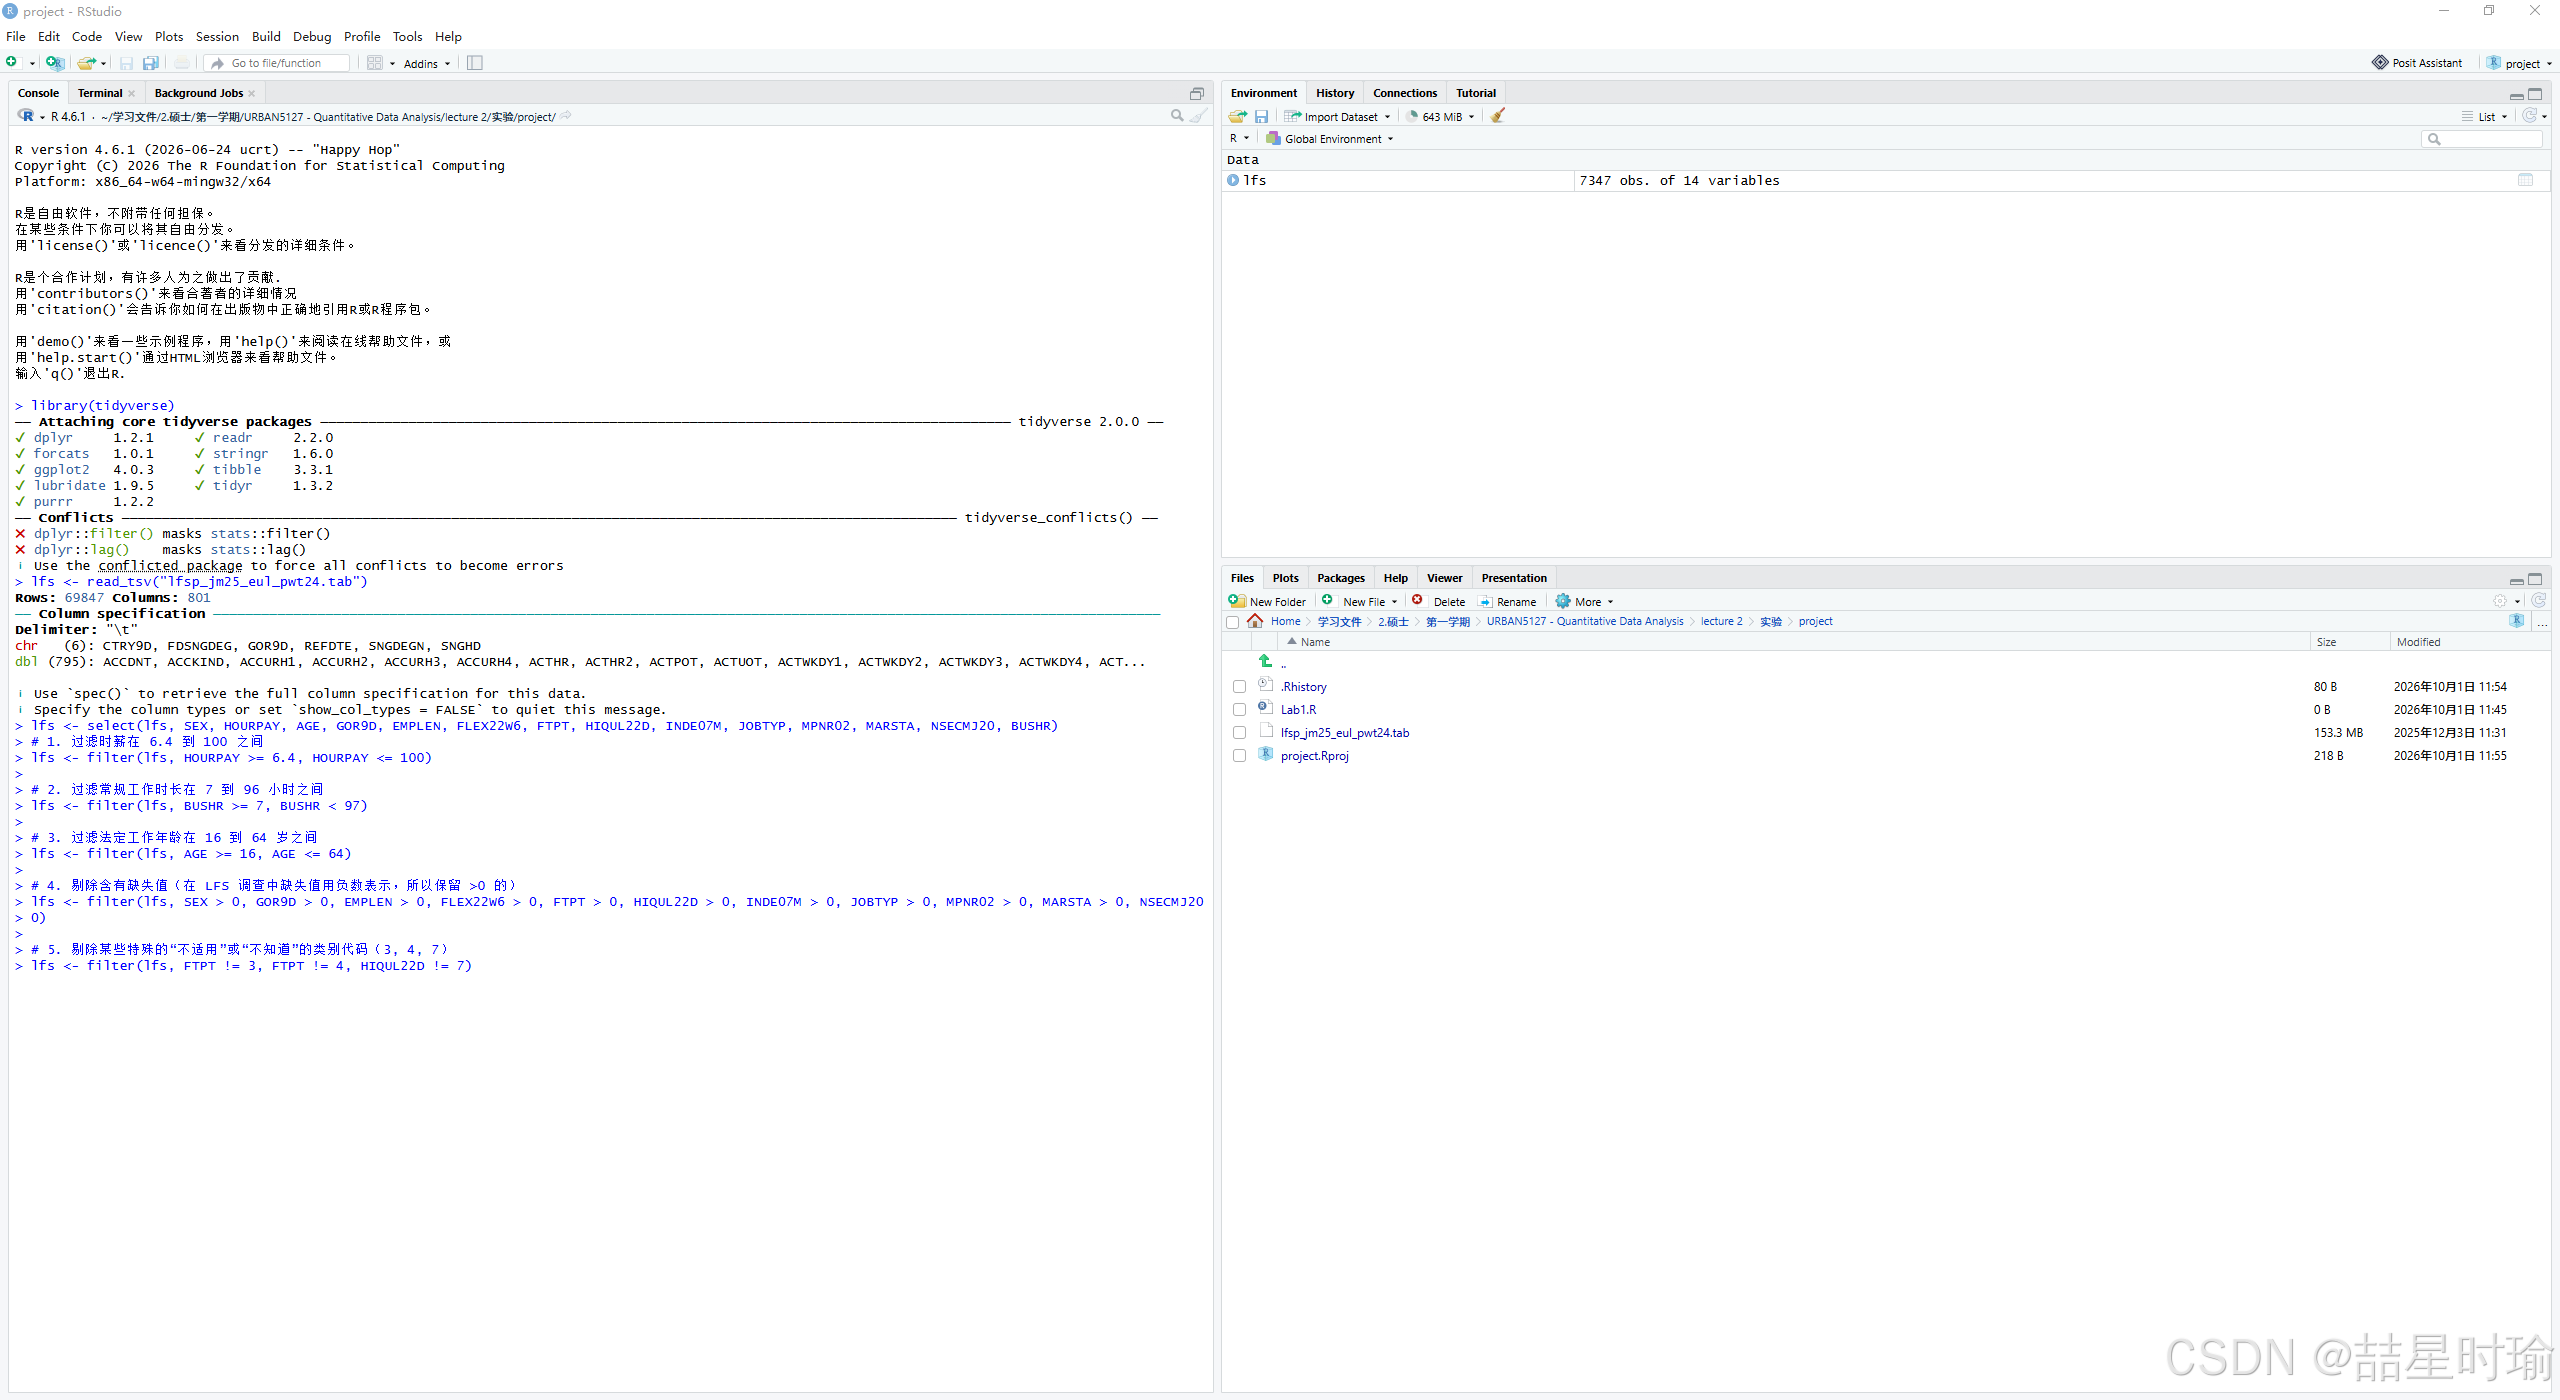
接下来,通过一系列逻辑条件剔除不符合研究要求或含有缺失值的样本。
# 1. 过滤时薪在 6.4 到 100 之间
lfs <- filter(lfs, HOURPAY >= 6.4, HOURPAY <= 100)

# 2. 过滤常规工作时长在 7 到 96 小时之间
lfs <- filter(lfs, BUSHR >= 7, BUSHR < 97)

# 3. 过滤法定工作年龄在 16 到 64 岁之间
lfs <- filter(lfs, AGE >= 16, AGE <= 64)

# 4. 剔除含有缺失值的数据(在 LFS 调查中缺失值用负数表示,所以保留 >0 的)
lfs <- filter(lfs, SEX > 0, GOR9D > 0, EMPLEN > 0, FLEX22W6 > 0, FTPT > 0, HIQUL22D > 0, INDE07M > 0, JOBTYP > 0, MPNR02 > 0, MARSTA > 0, NSECMJ20 > 0)

# 5. 剔除某些特殊的"不适用"或"不知道"的类别代码(3, 4, 7)
lfs <- filter(lfs, FTPT != 3, FTPT != 4, HIQUL22D != 7)
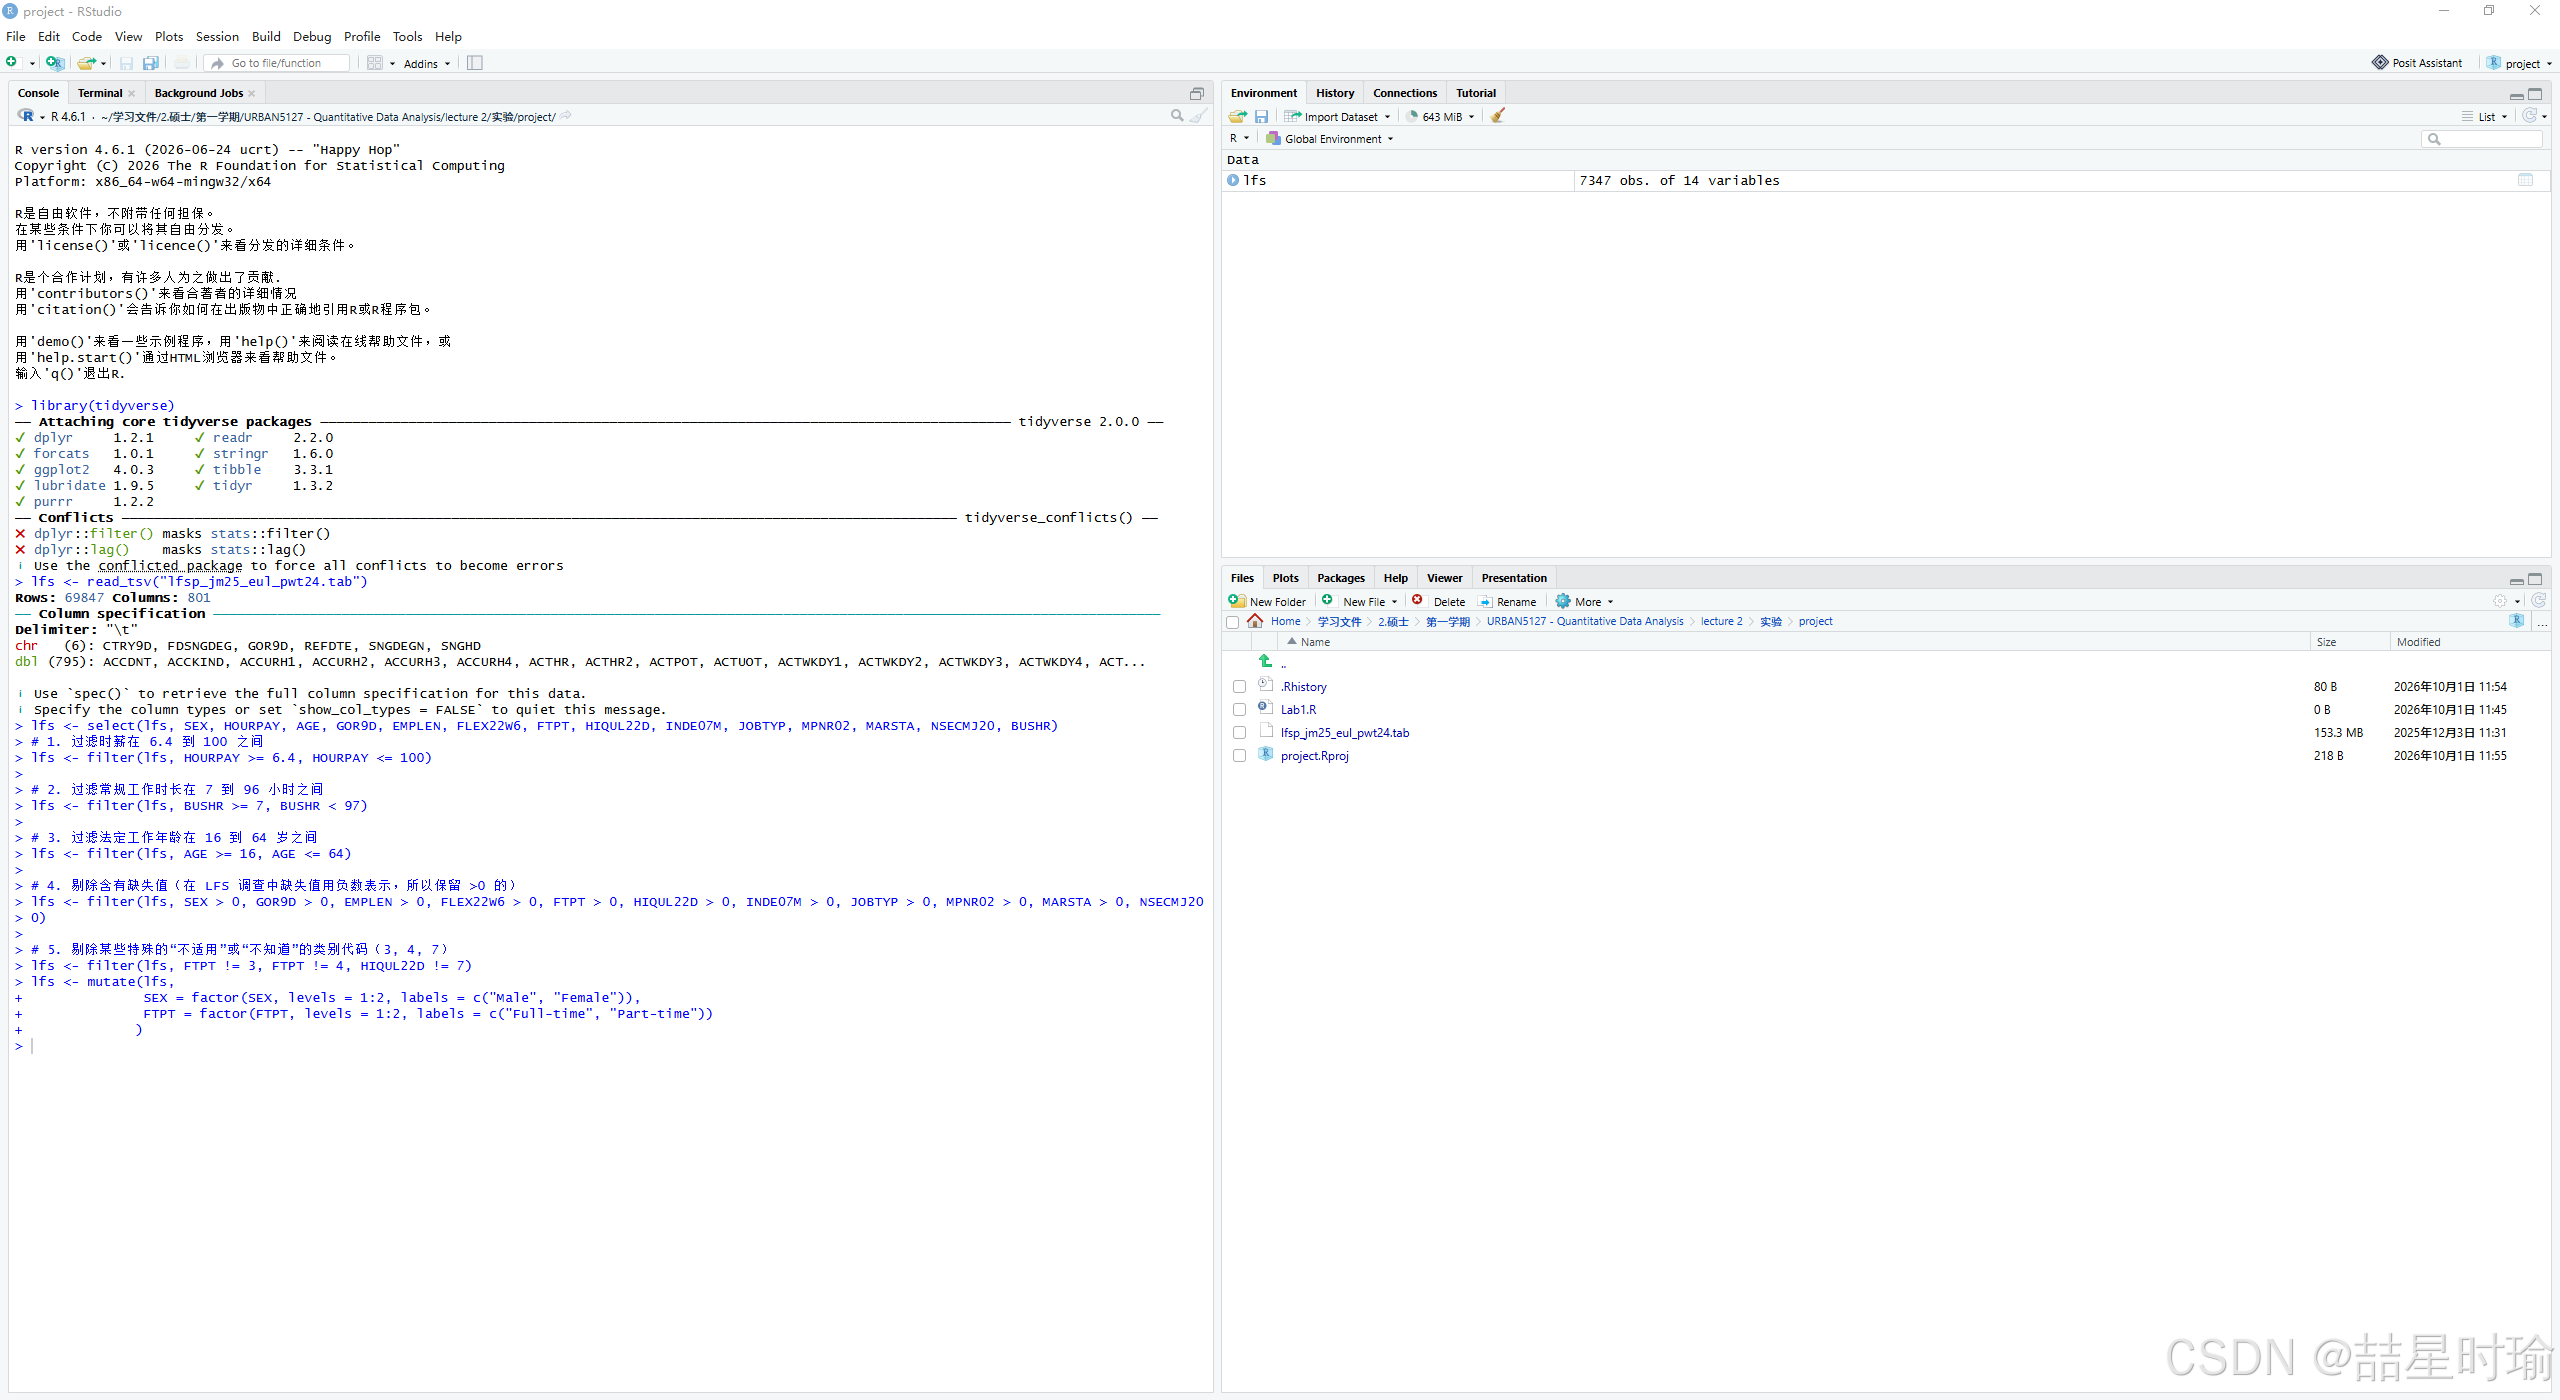
依次运行这些代码后,Environment 面板中的观测值数量会不断减少,最终停留在 7347 obs.。
步骤 5:将分类变量转换为因子 (mutate & factor)
将代表类别的纯数字代码(如 1 和 2)转换为具有实际意义的文本标签。
lfs <- mutate(lfs,
              SEX = factor(SEX, levels = 1:2, labels = c("Male", "Female")),
              FTPT = factor(FTPT, levels = 1:2, labels = c("Full-time", "Part-time"))
)代码在左上角脚本框中输入并运行,该步骤不会改变数据的行数或列数,但改变了数据类型。
步骤 6:概览最终数据 (glimpse)
最后,检查数据清洗的结果是否符合预期。
glimpse(lfs)运行后,您可以在左下角的 Console 看到数据的概览信息 。您应该重点确认:
-
Rows: 7,347:行数正确。 -
$ SEX和$ FTPT的数据类型已变为<fct>(因子),且具体数值变成了"Male", "Female"和"Part-time", "Full-time"等文本标签。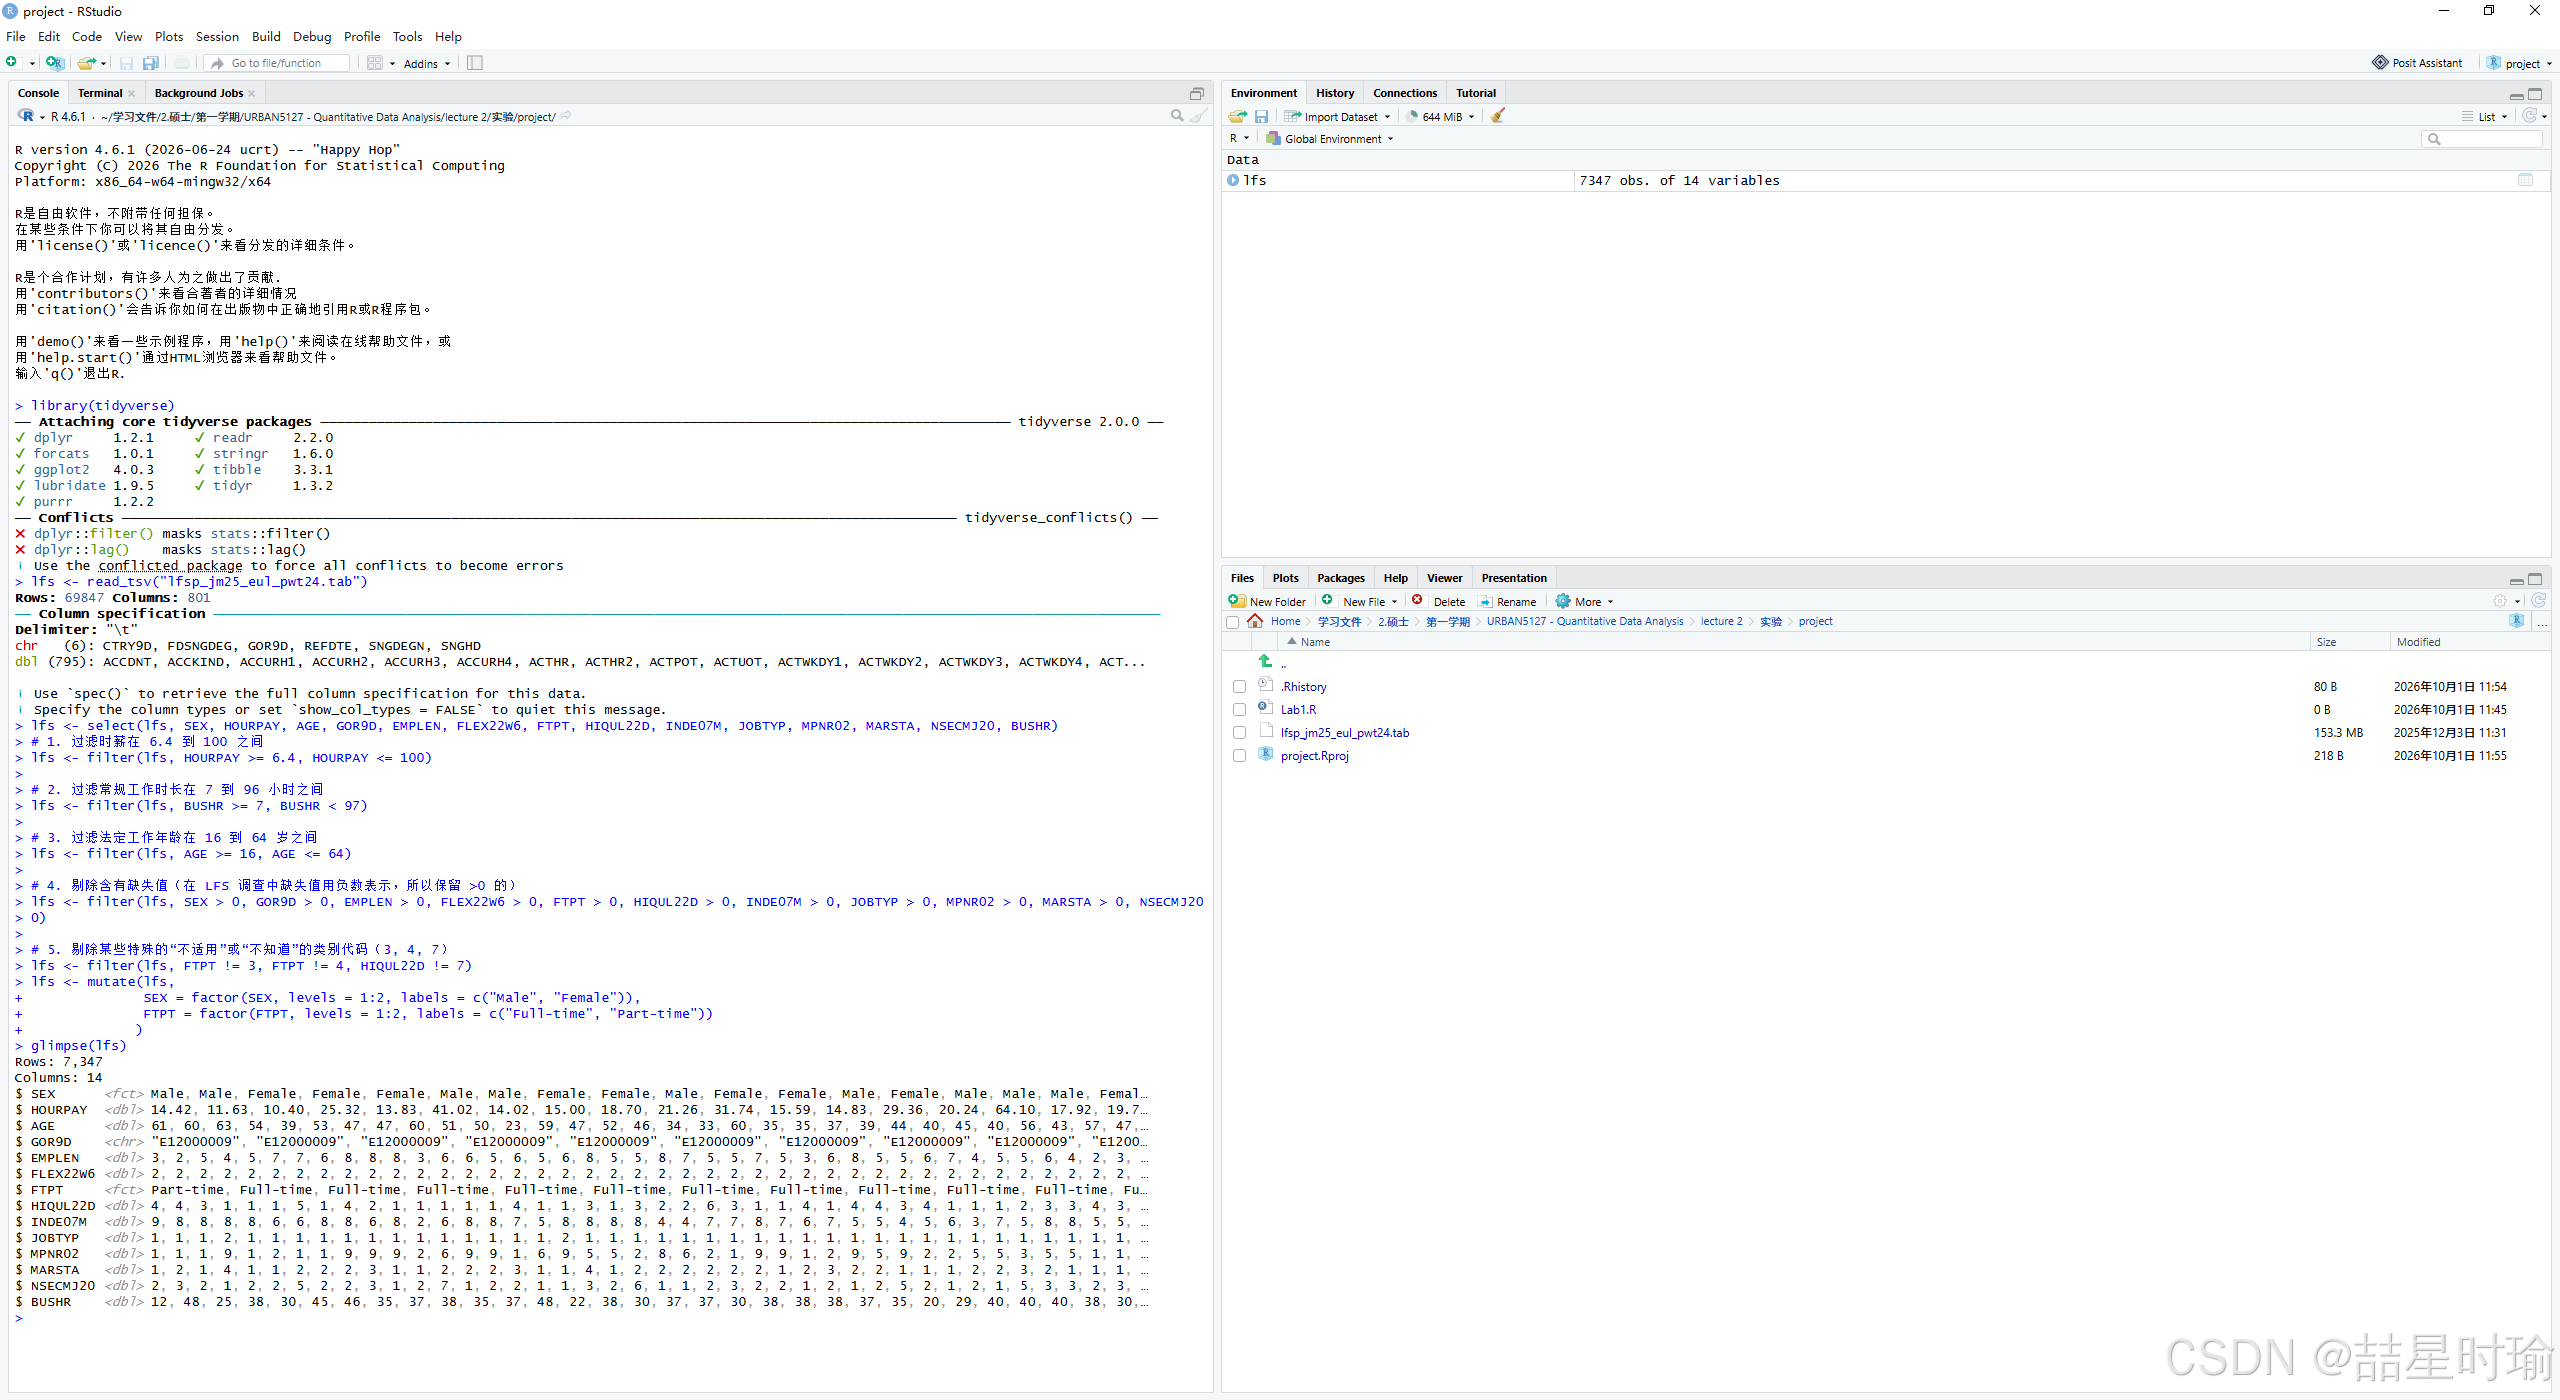
总结
该教程的具体操作是通过 R 语言及 Tidyverse 工具包对庞大且存在冗余的原始劳动力调查(LFS)数据进行了系统性的清洗与预处理。其处理的最终结果是将原本包含 69,847 条记录和 801 个变量的"脏数据",通过提取所需的 14 个核心变量(select)、按严密的逻辑条件剔除异常值与不符合研究范围的无效样本(filter),以及将纯数字代码转换回具有实际意义的文本分类标签(mutate 与 factor),成功提炼、瘦身成了一个仅含 7,347 条高质量有效观测值的干净数据集,为下一步的定量统计和回归分析做好了直接可用的数据准备。
具体实现了:
-
处理硬件与技术故障带来的数据缺失:在利用传感器(如 Smart Citizen Kit)进行环境监测的项目中,数据清洗需要处理因现实执行问题导致的数据断层,例如设备在运输途中电池耗尽、设备死机以及 SD 卡发生故障等情况。
-
修正因"人为干扰(Behavioral Interference)"导致的数据异常:在家庭传感器的实地部署中,清洗过程需要识别并解决因参与者个人行为差异而产生的数据问题,比如参与者未将设备插电、未重置设备,或者人为将传感器违规移动到温室等非目标监测区域,从而引发"人为导致"的数据空白或异常读数。
-
校准大数据的"代表性偏差(Sample Bias)":由于手机 GPS 或运动软件(如 Strava)等大数据往往偏向年轻、精通技术的群体,而系统性地遗漏了老年人或低收入群体,因此数据处理步骤还包括通过链接其他数据进行重新加权。例如,研究团队会将用户轨迹与高分辨率的住宅建筑数据相链接,估算出用户的家庭区域,并结合多重剥夺指数(IMD/SIMD)来分配统计权重,从而消除这种固有的样本偏差。
完整代码
R
# ==========================================
# 第一部分:R 语言基础语法测试(熟悉 R 环境)
# ==========================================

# 1. 基础数学运算
3 + 2

# 2. 变量赋值与打印
result <- 3 + 2  # 将计算结果赋值给名为 result 的对象
result           # 打印 result 的值

# 3. 对已有变量进行运算
result * 2       # 将 result 的值乘以 2,但这不会改变 result 原本的值

# 4. 存储多个值(向量)并进行批量运算
numbers <- c(1, 2, 3, 4, 5)  # 使用 c() 函数创建一个包含多个数字的向量
numbers + 1                  # 向量中的每个数字都加 1

# 5. 使用基础函数
sum(3, 2)        # 调用 sum() 函数计算参数的总和


# ==========================================
# 第二部分:数据分析环境准备与数据导入
# ==========================================

# 1. 安装 Tidyverse 包合集(注意:如果在你的电脑上是首次使用,只需运行一次)
# install.packages("tidyverse")

# 2. 加载 Tidyverse 包(每次重启 R 之后进行数据分析前都需要加载)
library(tidyverse)

# 3. 导入数据
# 使用 read_tsv 函数读取制表符分隔的 .tab 数据文件
# 请确保文件路径正确
lfs <- read_tsv("lfsp_jm25_eul_pwt24.tab")


# ==========================================
# 第三部分:变量选择与数据过滤(数据清洗)
# ==========================================

# 1. 选取需要的变量
# 使用 select 函数保留分析所需的列,覆盖原有的 lfs 数据框
lfs <- select(lfs, SEX, HOURPAY, AGE, GOR9D, EMPLEN, FLEX22W6, FTPT, HIQUL22D,
              INDE07M, JOBTYP, MPNR02, MARSTA, NSECMJ20, BUSHR)

# 查看当前数据的行数和列数(检查点)
dim(lfs)

# 2. 过滤异常/不相关的薪资数据 (HOURPAY)
# 保留时薪大于等于最低工资 6.4 镑的样本
lfs <- filter(lfs, HOURPAY >= 6.4)
# 保留时薪小于等于 100 镑的合理样本
lfs <- filter(lfs, HOURPAY <= 100)

# 3. 过滤异常的工作时长数据 (BUSHR)
# 排除零工或工作时长少于7小时的人(7小时约等于一个全职工作日)
lfs <- filter(lfs, BUSHR >= 7)
# 排除工作时长大于等于 97 小时的样本(因为在问卷中 97 代表 97 小时及以上,具体数值未知)
lfs <- filter(lfs, BUSHR < 97)

# 4. 过滤年龄范围 (AGE)
# 只保留处于传统工作年龄段 (16 - 64岁) 的样本
lfs <- filter(lfs, AGE >= 16, AGE <= 64)

# 5. 清理缺失值
# 问卷中负数代表缺失值或未回答,因此筛选出所有变量均大于 0 的有效样本
lfs <- filter(lfs, SEX > 0, GOR9D > 0, EMPLEN > 0, FLEX22W6 > 0, FTPT > 0,
              HIQUL22D > 0, INDE07M > 0, JOBTYP > 0, MPNR02 > 0, MARSTA > 0, NSECMJ20 > 0)

# 6. 清理其他无用值或难以解释的类别
# FTPT中 3 和 4 是特殊的全职/兼职类别,HIQUL22D中 7 代表"不知道"最高学历
lfs <- filter(lfs, FTPT != 3, FTPT != 4, HIQUL22D != 7)

# 再次查看清洗后的数据维度(最终样本量检查)
dim(lfs)


# ==========================================
# 第四部分:数据类型转换(将数值标签转换为因子)
# ==========================================

# 1. 转换性别 (SEX)
lfs <- mutate(lfs, SEX = factor(SEX,
                                levels = 1:2,
                                labels = c("Male", "Female")))

# 2. 批量转换多个二元或有序分类变量 (FLEX22W6, FTPT, EMPLEN)
lfs <- mutate(lfs,
              FLEX22W6 = factor(FLEX22W6,
                                levels = 1:2,
                                labels = c("Yes", "No")),
              FTPT = factor(FTPT,
                            levels = 1:2,
                            labels = c("Full-time", "Part-time")),
              EMPLEN = factor(EMPLEN,
                              levels = 1:8,
                              labels = c("Less than 3 months", "Three months, less than 6",
                                         "6 months, less than 12", "1 year, less than 2",
                                         "2 years, less than 5", "5 years, less than 10",
                                         "10 years, less than 20", "20 years or more")))

# 3. 转换地理区域 (GOR9D)
lfs <- mutate(lfs,
              GOR9D = factor(GOR9D,
                             levels = c("E12000007","E12000003","E12000009","E12000005",
                                        "E12000008","E12000006","E12000004","E12000001",
                                        "E12000002","W99999999","N99999999","S99999999"),
                             labels = c("London", "Yorkshire and The Humber", "South West",
                                        "West Midlands", "South East", "East of England",
                                        "East Midlands", "North East", "North West",
                                        "Wales", "Northern Ireland", "Scotland")))

# 4. 转换学历 (HIQUL22D) 与 行业部门 (INDE07M)
lfs <- mutate(lfs,
              HIQUL22D = factor(HIQUL22D,
                                levels = 1:6,
                                labels = c("Degree or equivalent", "Higher education",
                                           "A level or equivalent", "GCSE A*-C or equivalent",
                                           "Other qualitfication", "No Qualification")),
              INDE07M = factor(INDE07M,
                               levels = 1:9,
                               labels = c("Agriculture, forestry and fishing", "Energy and water",
                                          "Manufacturing", "Construction",
                                          "Distribution, hotels and restaurants",
                                          "Transport and communication", "Banking and finance",
                                          "Public admin, education and health", "Other services")))

# 5. 转换工作类型 (JOBTYP) 与 公司员工人数 (MPNR02)
lfs <- mutate(lfs,
              JOBTYP = factor(JOBTYP,
                              levels = 1:2,
                              labels = c("Permanent", "Not permanent in some way")),
              MPNR02 = factor(MPNR02,
                              levels = 1:9,
                              labels = c("1-10", "11-19", "20-24", "Don't know but under 25",
                                         "25-49", "50-249", "250-499",
                                         "Don't know but between 50 and 499",
                                         "500 or more")))

# 6. 转换婚姻状态 (MARSTA) 与 职业社会阶层 (NSECMJ20)
lfs <- mutate(lfs,
              MARSTA = factor(MARSTA,
                              levels = 1:6,
                              labels = c("Single, never married",
                                         "Married, living with spouse",
                                         "Married separated from spouse",
                                         "Divorced", "Widowed",
                                         "Currently or previously in civil partnership")),
              NSECMJ20 = factor(NSECMJ20,
                                levels = 1:8,
                                labels = c("Higher managerial and professional",
                                           "Lower managerial and professional",
                                           "Intermediate occupations",
                                           "Small employers and own account workers",
                                           "Lower supervisory and technical",
                                           "Semi-routine occupations",
                                           "Routine occupations",
                                           "Never worked")))


# ==========================================
# 第五部分:最终检查
# ==========================================

# 以电子表格形式在 RStudio 中查看清洗后的数据
# View(lfs)

# 在控制台中概览数据的结构(确认所有 factor 转换正确无误,数值变量依旧是数值类型)
glimpse(lfs)