MySQL运维实战:备份恢复+主从复制+读写分离+MHA高可用(超详细手把手教程)
摘要:MySQL数据库高可用、数据备份、读写分离是后端运维核心技能,也是面试高频考点!本文从零手把手实操,涵盖MySQL数据备份与恢复、主从复制原理与搭建、Amoeba读写分离、MHA高可用集群,附带完整可运行代码、避坑要点,最后补充MHA原主库复用为备用节点的配置方案,零基础也能轻松落地!
环境说明:CentOS 7 + MySQL 5.7(源码安装)
一、MySQL数据备份与恢复(生产必备)
1.1 数据备份的重要性
生产环境中数据是核心资产,任何数据丢失都会造成严重业务损失,常见数据丢失原因:
-
程序代码bug、运算错误
-
人为误操作(删库、删表)
-
磁盘硬件故障、服务器宕机
-
自然灾害(火灾、地震)、服务器盗窃
1.2 数据库备份分类
1.2.1 物理备份
直接备份数据库物理文件(数据文件、日志文件),速度快、恢复简单,适合大数据量场景。分为三种:
-
冷备份(脱机备份):关闭数据库后备份,数据一致性最高
-
热备份(联机备份):数据库运行中备份,依赖binlog日志,不影响业务
-
温备份:锁定数据表(可读不可写)状态下备份
1.2.2 逻辑备份
备份数据库逻辑对象(表、数据、库结构),生成SQL脚本,灵活性高,适合小数据量、跨环境迁移,核心工具:mysqldump。
1.2.3 常见备份方法
- 物理冷备
- 备份时数据库处于关闭状态,直接打包数据库文件
- 备份速度快,恢复时也是最简单的
- 专用备份工具mydump或mysqlhotcopy
- mysqldump常用的逻辑备份工具
- mysqlhotcopy仅拥有备份MylSAM和ARCHIVE表
- 启用二进制日志进行增量备份
- 进行增量备份,需要刷新二进制日志
- 第三方工具备份
- 免费的MySQL热备份软件Percona XtraBackup
1.3 常用备份方式实操
1.3.1 物理冷备份(生产推荐)
核心思路:停止数据库服务 → 打包物理数据文件 → 重启服务
bash
# 【mysql01】MySQL物理冷备份完整流程

# 停止MySQL服务,保证数据文件一致性(冷备份核心要求)
[root@mysql01 ~]# systemctl stop mysqld

# 进入MySQL数据根目录
[root@mysql01 ~]# cd /usr/local/mysql/data

# 创建专属备份存储目录
[root@mysql01 data]# mkdir /mysql_bak

# 打包全部数据文件,携带时间戳,避免备份文件覆盖
[root@mysql01 data]# tar czf /mysql_bak/mysql-backup-$(date +%F).tar.gz *

# 重启MySQL服务,恢复业务运行
[root@mysql01 data]# systemctl start mysqld数据恢复测试:
bash
# 【mysql01】物理冷备份数据恢复实操(模拟故障恢复)
# 停止MySQL服务,防止数据文件被进程占用
[root@mysql01 ~]# systemctl stop mysqld

# 清空数据目录,模拟数据损坏/丢失场景(生产环境禁止随意执行)
[root@mysql01 ~]# rm -rf /usr/local/mysql/data/*

# 启动服务,验证数据库故障失效
[root@mysql01 ~]# systemctl start mysqld

# 再次停止服务,准备执行数据恢复
[root@mysql01 ~]# systemctl stop mysqld

# 解压对应时间戳备份包,还原全部数据文件
[root@mysql01 ~]# tar xzf /mysql_bak/mysql-backup-2025-10-15.tar.gz -C /usr/local/mysql/data/

# 修正数据目录权限,避免MySQL启动权限报错
[root@mysql01 ~]# chown -R mysql:mysql /usr/local/mysql/data

# 重启MySQL服务,完成数据恢复
[root@mysql01 ~]# systemctl start mysqld
1.3.2 逻辑备份(mysqldump)
支持单表、单库、多库、全库备份,是日常运维最常用的备份方式。
bash
# 【mysql01】mysqldump逻辑备份常用命令合集(日常运维主流)

# 备份单个数据库(仅数据,不含建库语句,恢复数据需进入对应的库恢复数据)
[root@mysql01 ~]# mysqldump -u root -phuawei school > /mysql_bak/school.sql

# 备份多个数据库(包含建库语句,可直接恢复)
[root@mysql01 ~]# mysqldump -u root -phuawei --databases school mysql > /mysql_bak/school-mysql.sql

# 备份全库数据,适配整机数据迁移场景
[root@mysql01 ~]# mysqldump -u root -phuawei --opt --all-databases > /mysql_bak/all.sql

# 精准备份单表结构与数据,适配局部数据恢复
[root@mysql01 ~]# mysqldump -u root -phuawei school info > /mysql_bak/info.sql
--opt 包含 --lock-tables,对 InnoDB 会锁表,默认启用,可省略。
InnoDB 引擎生产环境,建议加上
--single-transaction,用快照代替锁表,不影响业务读写:
bash
mysqldump -uroot -phuawei --opt --single-transaction --all-databases > /mysql_bak/all.sql| 参数 | 作用 |
|---|---|
--add-drop-table |
建表前自动加 DROP TABLE IF EXISTS,恢复时先删旧表,避免表已存在报错(你之前 school.sql 里就看到了) |
--add-locks |
导入数据前后加 LOCK / UNLOCK TABLES,加速写入 |
--create-options |
CREATE TABLE 带上引擎、自增等完整表属性 |
--disable-keys |
导入数据前关闭索引,插完数据再重建索引,大幅加快导入速度 |
--extended-insert |
多行合并成一条 INSERT,减少 SQL 语句数量,备份文件更小、恢复更快(不是一行一条 insert) |
--lock-tables |
备份时锁表,保证 MyISAM 数据一致性;InnoDB 不推荐,会锁库 |
--quick |
边读数据边输出,不在内存缓存整张表,适合大表,防止内存溢出 |
--set-charset |
备份文件开头写入字符集设置语句 |
逻辑数据恢复实操:
bash
# 【mysql01】逻辑备份SQL脚本数据恢复实操
[root@mysql01 ~]# mysql -u root -phuawei

# 切换至目标业务数据库
mysql> use school;

# 模拟生产误操作:删除业务数据表
mysql> drop table info;

# 导入备份SQL脚本,恢复表结构与全部数据
mysql> source /mysql_bak/info.sql;

# 查看数据表,校验数据恢复结果
mysql> show tables;
1.3.3 增量备份(binlog日志)
全量备份耗时久,增量备份仅备份新增/修改数据,依托MySQL二进制日志(binlog)实现,生产主流组合:定期全量备份+实时增量备份。
步骤1:开启binlog日志
bash
# 【mysql01】开启binlog二进制日志(增量备份核心依赖)
[root@mysql01 ~]# vim /etc/my.cnf

# 在[mysqld]模块配置binlog,记录所有增删改操作
log-bin=mysql-bin

# 重启MySQL服务,使日志配置生效
[root@mysql01 ~]# systemctl restart mysqld.service
步骤2:全量备份+日志刷新
bash
# 执行全量备份,搭建增量恢复数据基线
[root@mysql01 ~]# mysqldump -u root -phuawei --all-databases > /opt/mysql-all.sql

# 刷新切割binlog日志,旧日志归档,新日志记录后续增量操作
[root@mysql01 ~]# mysqladmin -uroot -phuawei flush-logs
步骤3:模拟增量数据写入
bash
# 【mysql01】模拟增量业务数据写入
[root@mysql01 ~]# mysql -uroot -phuawei

# 新增数据写入
mysql> use school;
mysql> insert into info (name,score,address,hobby) values ('美猴王',75,'武汉',1);
mysql> insert into info (name,score,address,hobby) values ('超人',83,'上海',2);
mysql> exit

# 再次切割日志,固化增量操作日志,便于精准恢复
[root@mysql01 ~]# mysqladmin -uroot -p flush-logs
步骤4:模拟数据删除+增量恢复
bash
# 模拟生产误删增量数据,制造数据故障
[root@mysql01 ~]# mysql -uroot -phuawei
mysql> use school;
mysql> delete from info where id=5; # 删除新增测试数据1
mysql> delete from info where id=6; # 删除新增测试数据2
mysql> exit

# 格式化解析binlog日志,定位误操作SQL语句
[root@mysql01 ~]# mysqlbinlog --no-defaults --base64-output=decode-rows -v /usr/local/mysql/data/mysql-bin.000002

# 回放binlog日志,执行增量数据恢复
[root@mysql01 ~]# mysqlbinlog --no-defaults /usr/local/mysql/data/mysql-bin.000002 | mysql -uroot -phuawei

# 进入数据库,校验数据恢复效果
[root@mysql01 ~]# mysql -uroot -phuawei
mysql> use school;
mysql> select * from info;
二、MySQL主从复制与读写分离(性能优化核心)
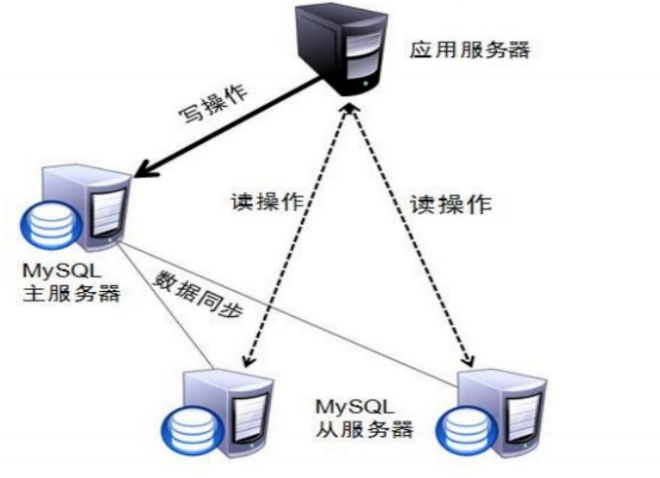
2.1 主从复制核心原理
2.1.1 三大核心组件
-
binlog二进制日志(主库):记录主库所有增删改操作
-
IO线程(从库):连接主库,拉取binlog日志到本地中继日志
-
SQL线程(从库):读取中继日志,重放SQL语句同步数据
2.1.2 完整复制流程
- 主库执行INSERT/UPDATE/DELETE等写操作
- 主库将操作记录到binlog二进制日志
- 从库IO线程请求主库binlog日志
- 主库dump线程推送binlog日志至从库
- 从库IO线程将日志写入本地relay中继日志
- 从库SQL线程重放中继日志,同步数据
- 正常状态:Slave_IO_Running=Yes、Slave_SQL_Running=Yes
- 从库数据和主库完全一致
使用目标:数据冗余和灾难恢复;提升并发能力、避免锁冲突。
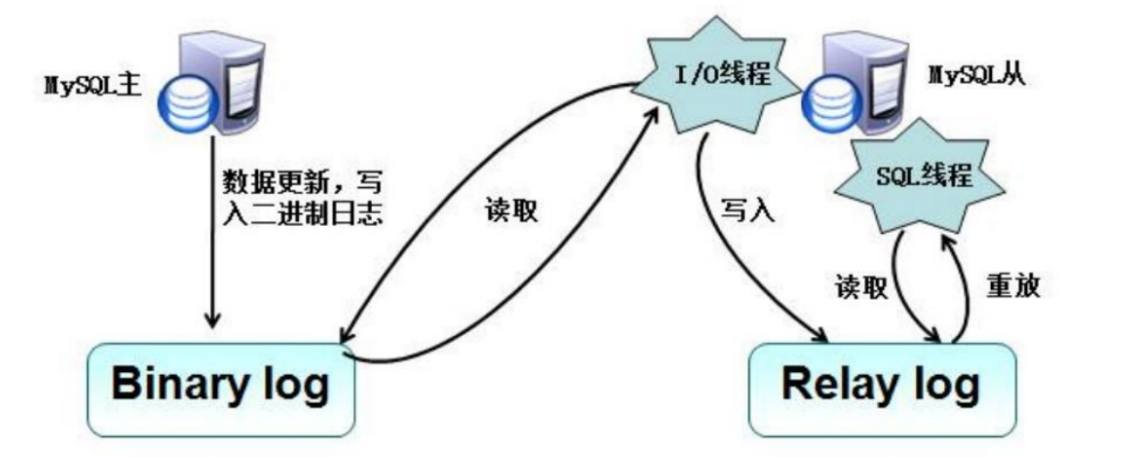
2.1.3 MySQL读写分离原理
- 只在主服务器上写,只在从服务器上读
- 主数据库处理事务性查询,从数据库处理SELECT查询
- 数据库复制用于将事务性查询的变更同步到集群中的从数据库
- 读写分离方案
- 基于程序代码内部实现
- 基于中间代理层实现
- MySQL-Proxy
- Amoeba
- mycat
环境拓扑
| 主机名 | IP地址 | 角色作用 |
|---|---|---|
| mysql-master | 192.168.108.101 | MySQL主库(写操作) |
| mysql-slave01 | 192.168.108.102 | MySQL从库1(读操作) |
| mysql-slave02 | 192.168.108.103 | MySQL从库2(读操作) |
| amoeba | 192.168.108.110 | 读写分离中间件 |
| mysql-client | 192.168.108.111 | 测试客户端 |
2.3 环境初始化(所有节点执行)
bash
# 集群所有节点统一环境初始化配置
# 同步公共时间服务器,保证集群时间一致
[root@all ~]# ntpdate ntp.aliyun.com

# 校验时间同步结果
[root@all ~]# date -R

# 关闭防火墙,以免影响实验
[root@all ~]# systemctl disable firewalld --now
[root@all ~]# setenforce 0

# 清理MySQL残留进程,解决连接占用、启动异常问题
[root@all ~]# pkill -9 mysql;systemctl restart mysqld
2.4 主从复制搭建实操
2.4.1 主库配置(mysql-master)
bash
# 【mysql-master】主库主从复制核心配置
[root@mysql-master ~]# vim /etc/my.cnf
[mysqld]
server-id = 11             # 集群唯一节点ID,主从节点不可重复
log-bin = master-bin       # 开启二进制日志,主从复制核心依赖
log-slave-updates = true   # 允许从库同步日志,适配多级复制与MHA架构

# 重启服务,加载新配置
[root@mysql-master ~]# systemctl restart mysqld

# 创建从库同步专用账号,授权网段访问权限
[root@mysql-master ~]# mysql -u root -phuawei
mysql> GRANT REPLICATION SLAVE ON *.* TO 'myslave'@'192.168.108.%' IDENTIFIED BY '123456';
mysql> FLUSH PRIVILEGES;
mysql> show master status;
2.4.2 从库配置(mysql-slave01/02)
两台从库操作一致,仅server-id不同
bash
# 【mysql-slave01】从库初始化与主从复制配置
[root@mysql-slave01 ~]# systemctl stop mysqld # 停止服务,规避文件占用报错
[root@mysql-slave01 ~]# rm -f /usr/local/mysql/data/auto.cnf # 清除克隆机器重复UUID,解决同步报错
[root@mysql-slave01 ~]# systemctl start mysqld # 重启生成唯一UUID

# 修改从库配置文件
[root@mysql-slave01 ~]# vim /etc/my.cnf
[mysqld]
server-id = 22
relay-log = relay-log-bin                 # 开启中继日志,缓存主库同步日志


# 重启服务加载配置
[root@mysql-slave01 ~]# systemctl restart mysqld

# 关联主库信息,建立主从复制链路
[root@mysql-slave01 ~]# mysql -u root -p
mysql> change master to master_host='192.168.108.101',master_user='myslave',master_password='123456',master_log_file='master-bin.000001',master_log_pos=604;
mysql> start slave;
mysql> show slave status\G;
2.4.3 主从同步验证
bash
# 【mysql-master】创建测试库表并写入测试数据
mysql> create database school;
mysql> use school;
mysql> CREATE TABLE student (id int UNSIGNED AUTO_INCREMENT PRIMARY KEY,name VARCHAR(20) NOT NULL,age tinyint UNSIGNED,gender ENUM('M','F') default 'M')ENGINE=InnoDB AUTO_INCREMENT=10 DEFAULT CHARSET=utf8mb4;
mysql> insert student (name,age)values('路飞',20);

# 【mysql-slave01/02】查询数据,验证主从同步生效
mysql> select * from school.student;
2.5 基于Amoeba的读写分离搭建
2.5.1 读写分离原理
- 写操作(INSERT/UPDATE/DELETE):路由至主库,保证数据一致性
- 读操作(SELECT):轮询路由至从库集群,分担查询压力
- Amoeba:Java开发的轻量SQL代理中间件,零代码侵入、配置简单
bash
应用程序
    ↓
读写中间件(或代码判断)
    ↓
------------------------------------------------------
写 → Master(主库)
读 → Slave 1
     Slave 2
     Slave 3
-------------------------------------------------------
从库可以有 1 台、2 台、多台,共同分担查询压力
主从复制保证数据一致
读写分离保证性能扩容
Amoeba 是一款基于 Java 开发的 MySQL 数据库代理中间件 ,核心定位是SQL 路由 ,帮你在应用与 MySQL 之间实现读写分离、负载均衡、高可用,对应用透明、配置简单,是早期企业实现 MySQL 读写分离的主流方案。
- 角色:应用 ↔ Amoeba ↔ MySQL 主从集群,Amoeba 是中间 "SQL 路由器"。
- 核心能力 :自动识别 SQL 类型,写(INSERT/UPDATE/DELETE)走主库,读(SELECT)走从库,并对从库做负载均衡。
- 依赖前提 :必须先搭好 MySQL 主从复制,Amoeba 只负责路由,不负责数据同步。
- 优势 :零代码侵入、配置基于 XML(比 MySQL Proxy 的 Lua 简单)、轻量易运维。
工作流程(读写分离)
-
应用连接 Amoeba 代理(默认端口 8066),而非直接连 MySQL。
-
Amoeba 解析 SQL:
- 写操作 → 转发到配置的 主库池(writePool)。
- 读操作 → 转发到配置的 从库池(readPool),并按轮询 / 权重做负载均衡。
-
主从复制保证从库数据与主库一致,应用无感知。
核心组件(配置文件)
Amoeba 核心配置在 $AMOEBA_HOME/conf/ 下,共 7 个,最关键 2 个:
| 配置文件 | 作用 |
|---|---|
| amoeba.xml | 代理核心配置:端口、认证、读写池、路由规则、线程池 |
| dbServers.xml | 定义后端 MySQL 节点(主 / 从)、连接信息、连接池 |
路由规则(读写分离核心)
在 amoeba.xml 中配置:
writePool:指定写操作转发的主库节点池。readPool:指定读操作转发的从库节点池(多从库自动轮询)。- 规则优先级:
readPools/writePools>defaultPools。
2.5.2 Amoeba环境部署
bash
# 【amoeba】读写分离中间件环境部署初始化
[root@amoeba ~]# hostnamectl set-hostname amoeba
[root@amoeba ~]# systemctl stop firewalld.service
[root@amoeba ~]# setenforce 0

# 赋予JDK安装包执行权限并完成安装
[root@amoeba ~]# chmod +x jdk-6u14-linux-x64.bin
[root@amoeba ~]# ./jdk-6u14-linux-x64.bin

# 迁移JDK至固定目录,统一环境路径
[root@amoeba ~]# mv jdk1.6.0_14/ /usr/local/jdk1.6

# 配置系统全局环境变量
[root@amoeba ~]# vim /etc/profile
export JAVA_HOME=/usr/local/jdk1.6
export CLASSPATH=$CLASSPATH:$JAVA_HOME/lib:$JAVA_HOME/jre/lib
export PATH=$JAVA_HOME/lib:$JAVA_HOME/jre/bin/:$PATH:$HOME/bin
export AMOEBA_HOME=/usr/local/amoeba
export PATH=$PATH:$AMOEBA_HOME/bin

[root@amoeba ~]# source /etc/profile # 加载环境变量,即刻生效

# 创建Amoeba安装目录并解压部署包
[root@amoeba ~]# mkdir /usr/local/amoeba
[root@amoeba ~]# tar zxvf amoeba-mysql-binary-2.2.0.tar.gz -C /usr/local/amoeba/
[root@amoeba ~]# chmod -R 755 /usr/local/amoeba/
[root@amoeba ~]# /usr/local/amoeba/bin/amoeba
2.5.3 数据库授权Amoeba访问
bash
# 【所有MySQL节点】授权Amoeba中间件远程访问权限
mysql> grant all on *.* to test@'192.168.108.%' identified by '123.com';
mysql> flush privileges;
2.5.4 Amoeba核心配置
- 配置代理账号密码与读写池
bash
# 【amoeba】配置客户端连接信息与读写路由规则
[root@amoeba ~]# vim /usr/local/amoeba/conf/amoeba.xml

# 30行:配置客户端连接Amoeba的账号
<property name="user">amoeba</property>

# 32行:配置客户端连接Amoeba的密码
<property name="password">123456</property>

---117和120-去掉注释-
 115行 <property name="defaultPool">master</property> # 默认数据库池,一般写master,保证未知 SQL 在主库执行,防止数据写从库
 116
 117
 118行<property name="writePool">master</property>    # 指定写请求路由池(仅主库,保证数据一致性)
 119行<property name="readPool">slaves</property>     # 指定读请求路由池(从库集群,实现负载均衡)
120- 配置后端MySQL节点
bash
# 【amoeba】配置后端MySQL集群节点信息
[root@amoeba ~]# vim /usr/local/amoeba/conf/dbServers.xml

---23--注意!!!(mysql5.7,默认没有test数据库所以需要修改为mysql数据库)-(mysql5.5直接忽略)--
<!-- mysql schema -->
<property name="schema">mysql</property>

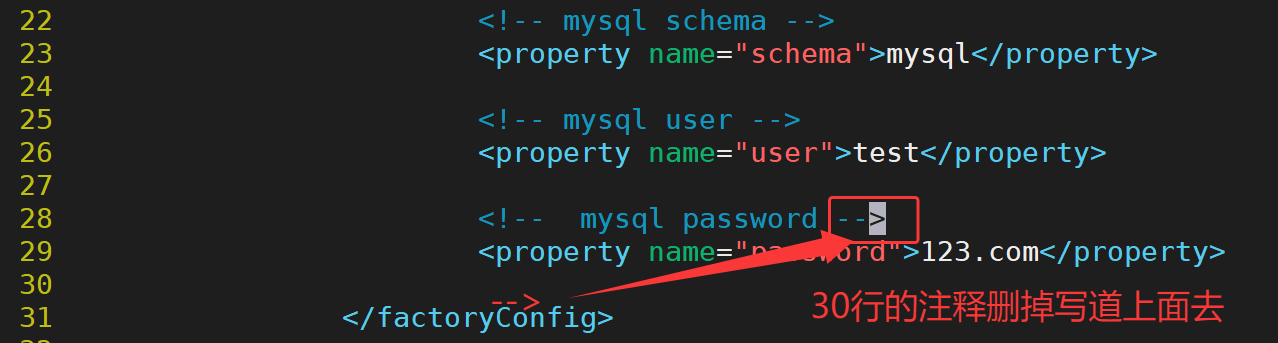
--25行到30行,第30行-->移动到28行后面
 25                         <!-- mysql user -->
 26                         <property name="user">test</property>         # 对接MySQL的授权账号
 27
 28                         <!--  mysql password -->
 29                         <property name="password">123.com</property>  # 对接MySQL的授权密码
 30

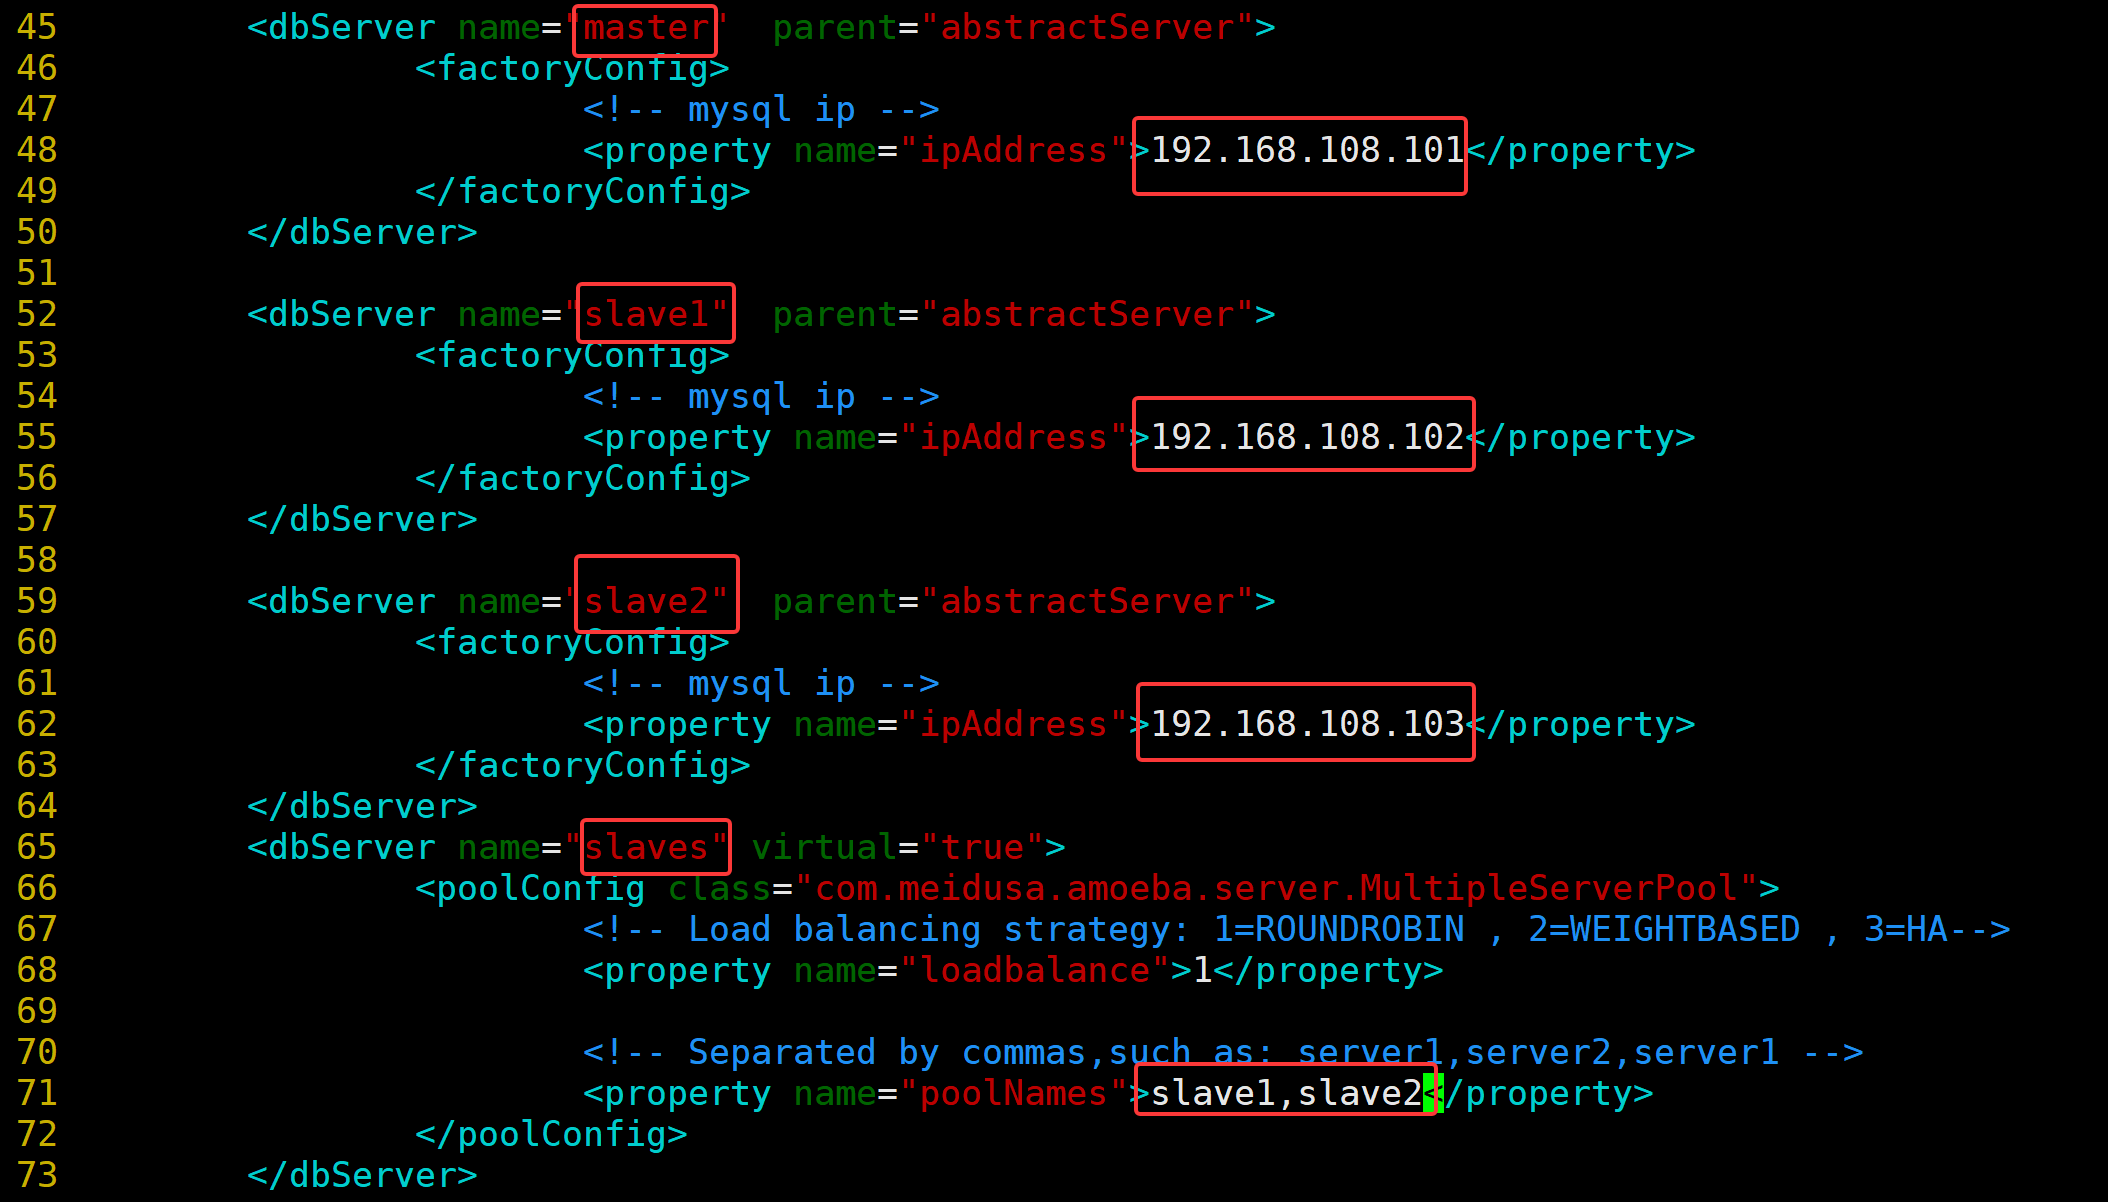
# 定义主库节点,承担全部写请求
45行<dbServer name="master"  parent="abstractServer">          # 修改为amoeba.xml定义的主库写请求路由池的名字
48行<property name="ipAddress">192.168.108.101</property>      # 主库IP地址

# 定义从库节点1,承担读请求负载
--52到57行从库配置
52行<dbServer name="slave1"  parent="abstractServer">
--55-从服务器地址-
55 <property name="ipAddress">192.168.108.102</property>

# 定义从库节点2,承担读请求负载
 ---52到57行复制一份在58行后面
原52行<dbServer name="slave2"  parent="abstractServer">
--55-从服务器地址-
原55 <property name="ipAddress">192.168.108.103</property>

# 配置从库负载均衡池,实现读请求轮询分发
<dbServer name="slaves" virtual="true">                            # 修改为amoeba.xml定义的从库读请求路由池的名字
<poolConfig class="com.meidusa.amoeba.server.MultipleServerPool">
<property name="poolNames">slave1,slave2</property>                # 修改为节点1和节点2的独立从池库的名字
</poolConfig>
</dbServer>
vim conf/dbServers.xml 结果如下
2.5.5 启动服务与读写分离验证
bash
# 后台启动Amoeba读写分离代理服务
[root@amoeba ~]# /usr/local/amoeba/bin/amoeba start&

# 查看Java端口监听,验证服务启动成功(默认8066端口)
[root@amoeba ~]# netstat -anpt | grep java

# 【mysql-client】客户端连接测试
[root@mysql-client ~]# yum install -y mysql

# 通过Amoeba代理连接数据库,所有请求由代理自动分发
[root@mysql-client ~]# mysql -u amoeba -p123456 -h 192.168.108.110 -P8066

# 客户端创建数据库,3个库由于主从同步,都会有数据
mysql> insert into info (name,score,address,hobby) values ('卡卡西',90,'上海',1);

# 关闭从库同步功能
# mysql-slave01
mysql> stop slave;

# mysql-slave02
mysql> stop slave;

# 客户端再写入新的数据,数据不会同步,数据只会出现在主库,从库没有
#mysql-client
mysql> insert into info (name,score,address,hobby) values ('鸣人',80,'上海',2);

# mysql-slave01 手动写入数据,score不一致
mysql> insert into info (name,score,address,hobby) values ('鸣人',81,'上海',2);

# mysql-slave02 手动写入数据,score不一致
mysql> insert into info (name,score,address,hobby) values ('鸣人',83,'上海',2);

# 客户端测试,第一次会向从服务器1读取,第二次会向从2读取
#mysql-client
MySQL [(none)]> select * from school.info;

# 验证了在客户端写的数据是写字在主库,读是在从库读取。
三、MySQL MHA高可用集群(解决主库单点故障)
3.1 MHA核心介绍
MHA(Master High Availability)是MySQL专属开源高可用工具,解决主库单点故障,可在0-30秒完成自动故障切换,最大程度保证数据不丢失,是中小企业MySQL高可用主流方案。
核心组件:
-
MHA Manager:管理节点,监控集群状态、触发故障切换
-
MHA Node:所有MySQL数据节点,负责日志同步、故障修复
3.2 MHA实验环境
| 主机名 | IP地址 | 角色 |
|---|---|---|
| mysql-master | 192.168.108.131 | 主库、安装node组件 |
| mysql-slave01 | 192.168.108.132 | 从库1、备选主库、安装node组件 |
| mysql-slave02 | 192.168.108.133 | 从库2、安装node组件 |
| mha | 192.168.108.130 | 管理节点、安装manager+node组件 |
3.3 环境初始化与主从配置
- 修复克隆主机UUID重复问题
bash
# 【slave01、slave02】修复克隆机器UUID重复问题(MHA集群必备)
# 停止服务,释放数据文件占用
[root@mysql-slave01 ~]# systemctl stop mysqld

# 删除重复UUID配置
[root@mysql-slave01 ~]# rm -f /usr/local/mysql/data/auto.cnf

# 重启自动生成唯一UUID
[root@mysql-slave01 ~]# systemctl start mysqld

[root@mysql-slave02 ~]# systemctl stop mysqld
[root@mysql-slave02 ~]# rm -f /usr/local/mysql/data/auto.cnf
[root@mysql-slave02 ~]# systemctl start mysqld- 安装依赖、配置软链接
bash
# 集群所有MySQL节点安装MHA依赖组件
[root@all ~]# yum -y install perl-Module-Install

# 创建MySQL命令软链接,解决MHA工具识别命令失败问题
[root@all ~]# ln -s /usr/local/mysql/bin/mysqlbinlog /usr/bin/
[root@all ~]# ln -s /usr/local/mysql/bin/mysql /usr/bin/

# 重启服务,加载环境变量配置
[root@all ~]# systemctl restart mysqld- 数据库配置文件修改(5.7专属避坑)
所有从库注释 /etc/my.cnf 中 [client] 下的 default-character-set=utf8
bash
[root@mysql-master ~]# vim /etc/my.cnf
[mysqld]
server-id = 1                                   #三台服务器的 server-id 不能一样
log_bin = master-bin
log-slave-updates = true

[root@mysql-master ~]# systemctl restart mysqld

[root@mysql-slave01 ~]# vim /etc/my.cnf
[client]
#default-character-set=utf8
[mysqld]
server-id = 2
log_bin = master-bin
relay-log = relay-log-bin

[root@mysql-slave01 ~]# systemctl restart mysqld

[root@mysql-slave02 ~]# vim /etc/my.cnf
[client]
#default-character-set=utf8

[mysqld]
server-id = 3
relay-log = relay-log-bin

[root@mysql-slave02 ~]# systemctl restart mysqld- 授权同步与MHA管理账号
bash
# 所有MySQL节点创建集群专属授权账号
mysql> grant replication slave on *.* to 'myslave'@'192.168.108.%' identified by '123';  # 主从同步专用账号
mysql> grant all privileges on *.* to 'mha'@'192.168.108.%' identified by 'manager';     # MHA集群管理账号

# 补充基于主机名(hostname)的授权,规避MHA权限检测报错
# MHA内部会同时使用IP和主机名去连接数据库,只授权IP会导致MHA校验权限失败
mysql> grant all privileges on *.* to 'mha'@'mysql-master' identified by 'manager';
mysql> grant all privileges on *.* to 'mha'@'mysql-slave01' identified by 'manager';
mysql> grant all privileges on *.* to 'mha'@'mysql-slave02' identified by 'manager';

# 批量刷新所有权限,确保生效
mysql> flush privileges; - 搭建一主两从架构
bash
# 主库查看二进制日志状态,记录日志名与偏移量
mysql> show master status;

# 所有从库配置主从同步,关联主库节点
mysql> change master to master_host='192.168.108.131',master_user='myslave',master_password='123',master_log_file='master-bin.000001',master_log_pos=1897;
mysql> start slave;
mysql> show slave status\G;

# 从库开启只读模式,防止人为误写入破坏数据一致性
mysql> set global read_only=1;
3.4 MHA组件安装
安装顺序:所有节点先装node组件 → 管理节点装manager组件
Manager 提供监控、检查、故障转移等人工可操作脚本;Node 节点工具由 MHA 自动调用,主要用于日志保存、差异中继日志应用、清理中继日志。
bash
# 1.所有节点安装MHA所需全部依赖环境
[root@all ~]# yum install epel-release --nogpgcheck -y   # 安装第三方扩展源
[root@all ~]# yum install -y perl-DBD-MySQL perl-Config-Tiny perl-Log-Dispatch perl-Parallel-ForkManager perl-ExtUtils-CBuilder perl-ExtUtils-MakeMaker perl-CPAN

# 2.所有MySQL数据节点安装MHA Node组件
[root@all ~]# tar zxvf mha4mysql-node-0.57.tar.gz
[root@all ~]# cd mha4mysql-node-0.57
[root@all ~]# perl Makefile.PL                     # 生成编译配置文件
[root@all ~]# make && make install                 # 编译并安装组件

# 3.MHA管理节点单独安装Manager管理组件
[root@mha ~]# tar zxvf mha4mysql-manager-0.57.tar.gz
[root@mha ~]# cd mha4mysql-manager-0.57
[root@mha ~]# perl Makefile.PL
[root@mha ~]# make && make install
MHA Manager(管理节点,/usr/local/bin 工具)
- masterha_check_ssh:检查 SSH 免密配置
- masterha_check_repl:检查 MySQL 主从复制状态
- masterha_manager:启动 MHA 管理服务
- masterha_check_status:查看 MHA 运行状态
- masterha_master_monitor:监控主库是否宕机
- masterha_master_switch:故障转移(手动 / 自动)
- masterha_conf_host:增删配置里的数据库节点
- masterha_stop:停止 MHA 管理服务
MHA Node(所有数据库节点,工具由 Manager 自动调用,一般不用手动执行)
- save_binary_logs:保存、复制主库 binlog
- apply_diff_relay_logs:识别中继日志差异,把缺失事件应用到其他从库
- filter_mysqlbinlog:剔除无用回滚事件(MHA 已废弃不用)
- purge_relay_logs:清理中继日志,不会阻塞 SQL 线程
3.5 集群免密SSH配置
所有节点两两免密登录,保证MHA正常通信
bash
# 所有节点生成RSA密钥对(全程回车,无需设置密钥密码)
[root@all ~]# ssh-keygen -t rsa

# MHA管理节点分发密钥,实现管理节点到数据节点免密通信
[root@mha ~]# ssh-copy-id 192.168.108.131
[root@mha ~]# ssh-copy-id 192.168.108.132
[root@mha ~]# ssh-copy-id 192.168.108.133

# 所有数据节点需两两分发密钥,保证集群全节点免密互通
[root@mysql-master ~]# ssh-keygen -t rsa
[root@mysql-master ~]# ssh-copy-id 192.168.108.132
[root@mysql-master ~]# ssh-copy-id 192.168.108.133

[root@mysql-slave01 ~]# ssh-keygen -t rsa
[root@mysql-slave01 ~]# ssh-copy-id 192.168.108.131
[root@mysql-slave01 ~]# ssh-copy-id 192.168.108.133

[root@mysql-slave02 ~]# ssh-keygen -t rsa
[root@mysql-slave02 ~]# ssh-copy-id 192.168.108.131
[root@mysql-slave02 ~]# ssh-copy-id 192.168.108.132
3.6 MHA核心配置(VIP漂移)
- 配置VIP自动切换脚本
bash
# 复制官方VIP漂移脚本至系统命令目录,方便全局调用
[root@mha ~]# cp /root/mha4mysql-manager-0.57/samples/scripts/master_ip_failover /usr/local/bin
bash
[root@mha ~]# vim /usr/local/bin/master_ip_failover
#!/usr/bin/env perl
use strict;
use warnings FATAL => 'all';

use Getopt::Long;

my (
$command, $ssh_user, $orig_master_host, $orig_master_ip,
$orig_master_port, $new_master_host, $new_master_ip, $new_master_port
);
#############################自定义配置区域#########################################
my $vip = '192.168.108.200';        # 高可用虚拟IP
my $brdc = '192.168.108.255';       # 网段广播地址
my $ifdev = 'ens33';                # 服务器物理网卡名称
my $key = '1';                      # 虚拟子网卡序号,生成 ens33:1

# 方案1:使用ifconfig命令管理VIP(CentOS7常用,部分新版系统已弃用ifconfig)
my $ssh_start_vip = "/sbin/ifconfig ens33:$key $vip";
my $ssh_stop_vip = "/sbin/ifconfig ens33:$key down";

my $exit_code = 0;

# 方案2:ip命令版本(推荐,现代Linux系统,取消注释即可替换上面方案)
# 添加VIP + ARP广播刷新交换机MAC表,解决VIP切换后网络不通问题
#my $ssh_start_vip = "/usr/sbin/ip addr add $vip/24 brd $brdc dev $ifdev label $ifdev:$key;/usr/sbin/arping -q -A -c 1 -I $ifdev $vip;iptables -F;";
#my $ssh_stop_vip = "/usr/sbin/ip addr del $vip/24 dev $ifdev label $ifdev:$key";
##################################################################################
GetOptions(
'command=s' => \$command,
'ssh_user=s' => \$ssh_user,
'orig_master_host=s' => \$orig_master_host,
'orig_master_ip=s' => \$orig_master_ip,
'orig_master_port=i' => \$orig_master_port,
'new_master_host=s' => \$new_master_host,
'new_master_ip=s' => \$new_master_ip,
'new_master_port=i' => \$new_master_port,
);

exit &main();

sub main {

print "\n\nIN SCRIPT TEST====$ssh_stop_vip==$ssh_start_vip===\n\n";

if ( $command eq "stop" || $command eq "stopssh" ) {

my $exit_code = 1;
eval {
print "Disabling the VIP on old master: $orig_master_host \n";
&stop_vip();
$exit_code = 0;
};
if ($@) {
warn "Got Error: $@\n";
exit $exit_code;
}
exit $exit_code;
}
elsif ( $command eq "start" ) {

my $exit_code = 10;
eval {
print "Enabling the VIP - $vip on the new master - $new_master_host \n";
&start_vip();
$exit_code = 0;
};
if ($@) {
warn $@;
exit $exit_code;
}
exit $exit_code;
}
elsif ( $command eq "status" ) {
print "Checking the Status of the script.. OK \n";
exit 0;
}
else {
&usage();
exit 1;
}
}
sub start_vip() {
`ssh $ssh_user\@$new_master_host \" $ssh_start_vip \"`;
}
# A simple system call that disable the VIP on the old_master
sub stop_vip() {
`ssh $ssh_user\@$orig_master_host \" $ssh_stop_vip \"`;
}

sub usage {
print
"Usage: master_ip_failover --command=start|stop|stopssh|status --orig_master_host=host --orig_master_ip=ip --orig_master_port=port --new_master_host=host --new_master_ip=ip --new_master_port=port\n";
}- 集群主配置文件
bash
# 创建MHA集群专属配置目录
[root@mha ~]# mkdir /etc/masterha

# 复制官方模板配置文件,快速初始化集群配置
[root@mha ~]# cp /root/mha4mysql-manager-0.57/samples/conf/app1.cnf /etc/masterha/

# 编辑MHA集群核心配置文件
[root@mha ~]# vim /etc/masterha/app1.cnf
[server default]
manager_log=/var/log/masterha/app1/manager.log              # MHA服务运行日志路径
manager_workdir=/var/log/masterha/app1                      # MHA工作临时目录
master_binlog_dir=/usr/local/mysql/data                     # MySQL binlog日志存储路径
master_ip_failover_script=/usr/local/bin/master_ip_failover # VIP漂移脚本路径
user=mha                                                    # MHA集群管理账号
password=manager                                            # MHA集群管理密码
ping_interval=1                                             # 集群节点心跳检测间隔(秒)
repl_user=myslave                                           # 主从同步账号
repl_password=123                                           # 主从同步密码
ssh_user=root                                               # 集群SSH免密登录用户

[server1]
hostname=192.168.108.131     # 原主库节点IP
port=3306                    # MySQL服务默认端口

[server2]
hostname=192.168.108.132     # 从库1节点IP(备选主库)
port=3306
candidate_master=1           # 开启备选主库资格,故障优先切换
check_repl_delay=0           # 忽略日志同步延迟,提升切换效率

[server3]
hostname=192.168.108.133     # 从库2节点IP
port=3306
3.7 集群验证与启动
bash
# 1.校验集群所有节点SSH免密通信是否正常
[root@mha ~]# masterha_check_ssh -conf=/etc/masterha/app1.cnf

# 2.校验MySQL主从复制集群状态是否正常
[root@mha ~]# masterha_check_repl -conf=/etc/masterha/app1.cnf

# 3.主库手动初始化绑定VIP,对外提供统一访问入口
[root@mysql-master ~]# /sbin/ifconfig ens33:1 192.168.108.200/24

# 4.后台启动MHA监控服务,保留故障节点配置,避免节点被剔除
[root@mha ~]# nohup masterha_manager --conf=/etc/masterha/app1.cnf --remove_dead_master_conf --ignore_last_failover < /dev/null > /var/log/masterha/app1/manager.log 2>&1 &

# 5.查看MHA服务运行状态,确认监控启动成功
[root@mha ~]# masterha_check_status --conf=/etc/masterha/app1.cnf
3.8 故障模拟与修复
- 模拟主库宕机,MHA自动切换备选主库(slave01)
bash
# 模拟原主库MySQL服务宕机,触发MHA自动故障切换机制
[root@mysql-master ~]# systemctl stop mysqld

# 实时监控MHA日志,观察VIP漂移、主库切换完整流程
[root@mha ~]# tailf /var/log/masterha/app1/manager.log- 故障原主库修复
bash
# 修复原主库故障,重启MySQL服务
[root@mysql-master ~]# systemctl start mysqld

# 配置原主库为新主库(slave01)的从节点,重新接入集群
[root@mysql-master ~]# mysql -uroot -phuawei
mysql> change master to master_host='192.168.108.132',master_user='myslave',master_password='123',master_log_file='master-bin.000002',master_log_pos=2210;
mysql> start slave;
mysql> show slave status\G;
四、总结
-
数据备份:物理冷备份适合整机快速恢复,mysqldump逻辑备份适合灵活迁移,binlog增量备份实现数据零丢失;
-
主从复制:实现数据冗余,读写分离分担查询压力,大幅提升数据库并发能力;
-
MHA高可用:解决主库单点故障,秒级自动切换,修改启动参数和节点配置可实现原主库复用,完善集群冗余架构,适配生产高可用场景。