今天就这个话题给大家分享一套低成本自测idea可行性的完整流程。简单总结就是:先看研究问题和创新逻辑,再查类似工作,最后用一个很小的实验验证最核心的假设。
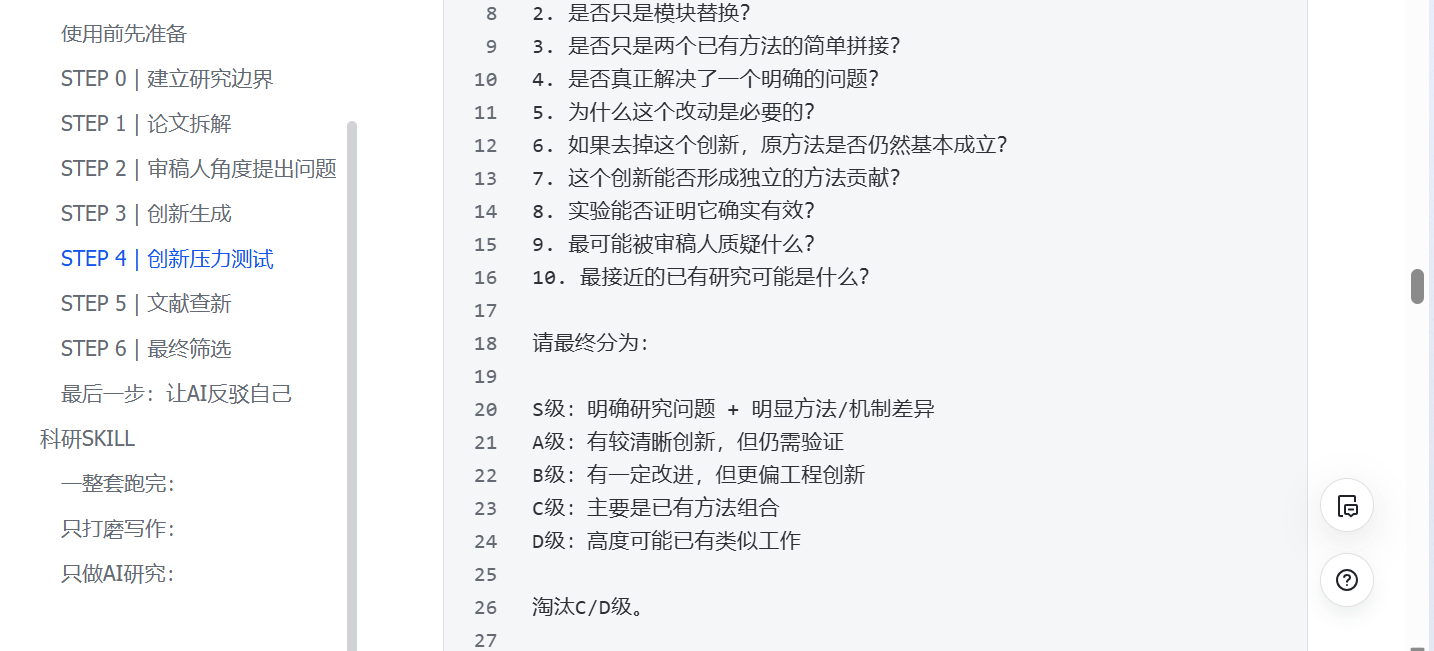
这里为了让你更轻松、更高效地使用这套流程,我把自己整理的常用资料也分享一下:一是AI判断创新点Prompt工作流,可以把一个想法从「研究问题→已有工作→创新空间→逻辑漏洞」快速重新过一遍,比较适合前期筛idea。
二是我整理的涨点论文,专门用来做idea的现实参照:你的改动有没有类似工作?别人为什么这么改?在哪些场景下有效?实验是怎么证明的?
全部资料需要的同学看文末
第一步:纸面先把关,拒绝上来就敲代码
对于一个idea,我一般先看四个维度:创新、价值、逻辑、严谨。创新≠没人做过。单纯填补空白容易陷入无意义小创新,可以挑战旧研究固有假设,或是从现实新现象入手,一定避免"新瓶装旧酒"。
同时拷问自己三个问题:
-
你的idea到底解决什么具体问题?
-
这套设计凭什么可以解决这个问题?
-
为什么前人没有这么做?
如果这三个问题都解释不清楚,我一般不会急着写代码。还要检查问题、假设、方法、实验结论之间是不是能形成闭环,避免为了一个结果硬凑因果。
到这里以后,再去检索arXiv、近两届顶会论文,看看有没有高度相似的工作。如果已经找到一些相似方法,我还会拿它们和自己的idea对照一下:到底是问题不同、方法不同,还是只是换了个模块。
这也是我整理那批涨点论文的一个主要用途,先看看别人真实做过什么,再判断自己的改动到底有没有继续往前走的空间。
如果纸面判断基本成立,再找导师、师兄师姐用几分钟快速过一遍,通常比自己闷头做几周实验划算得多。
第二步:小规模预实验,拒绝all in大工程
纸面评估通过,千万别直接铺全套大实验。先跑 toy 小实验,看 loss 变化,对比基线看有没有正向苗头。 可以做单 batch 过拟合测试,优先排除代码、数据、训练流程 bug,用来区分:是 idea 先天不行,还是仅仅没调好。
第三步:实验翻车别急着直接枪毙idea
把大想法拆成多条可验证假设。先预设:如果idea成立,应该看到哪些中间现象。如果连预期中间现象都看不到,说明底层假设存疑;如果中间现象生效,但最终指标不涨,问题大概率出在后续模块搭配与优化。
另外再多做多数据集验证+完整消融,确认性能提升来自核心创新,而不是堆trick带来的虚假收益。
最后投稿也是最好的校验,不用害怕拒稿,审稿意见是免费的专家反馈。
没有百分百完美的 idea,但这套流程,能帮你避开绝大多数无效选题,少浪费几个月科研时间。
关注下方《学姐带你玩AI》🚀🚀🚀
回复"222"获取全部资料
码字不易,欢迎大家点赞评论收藏