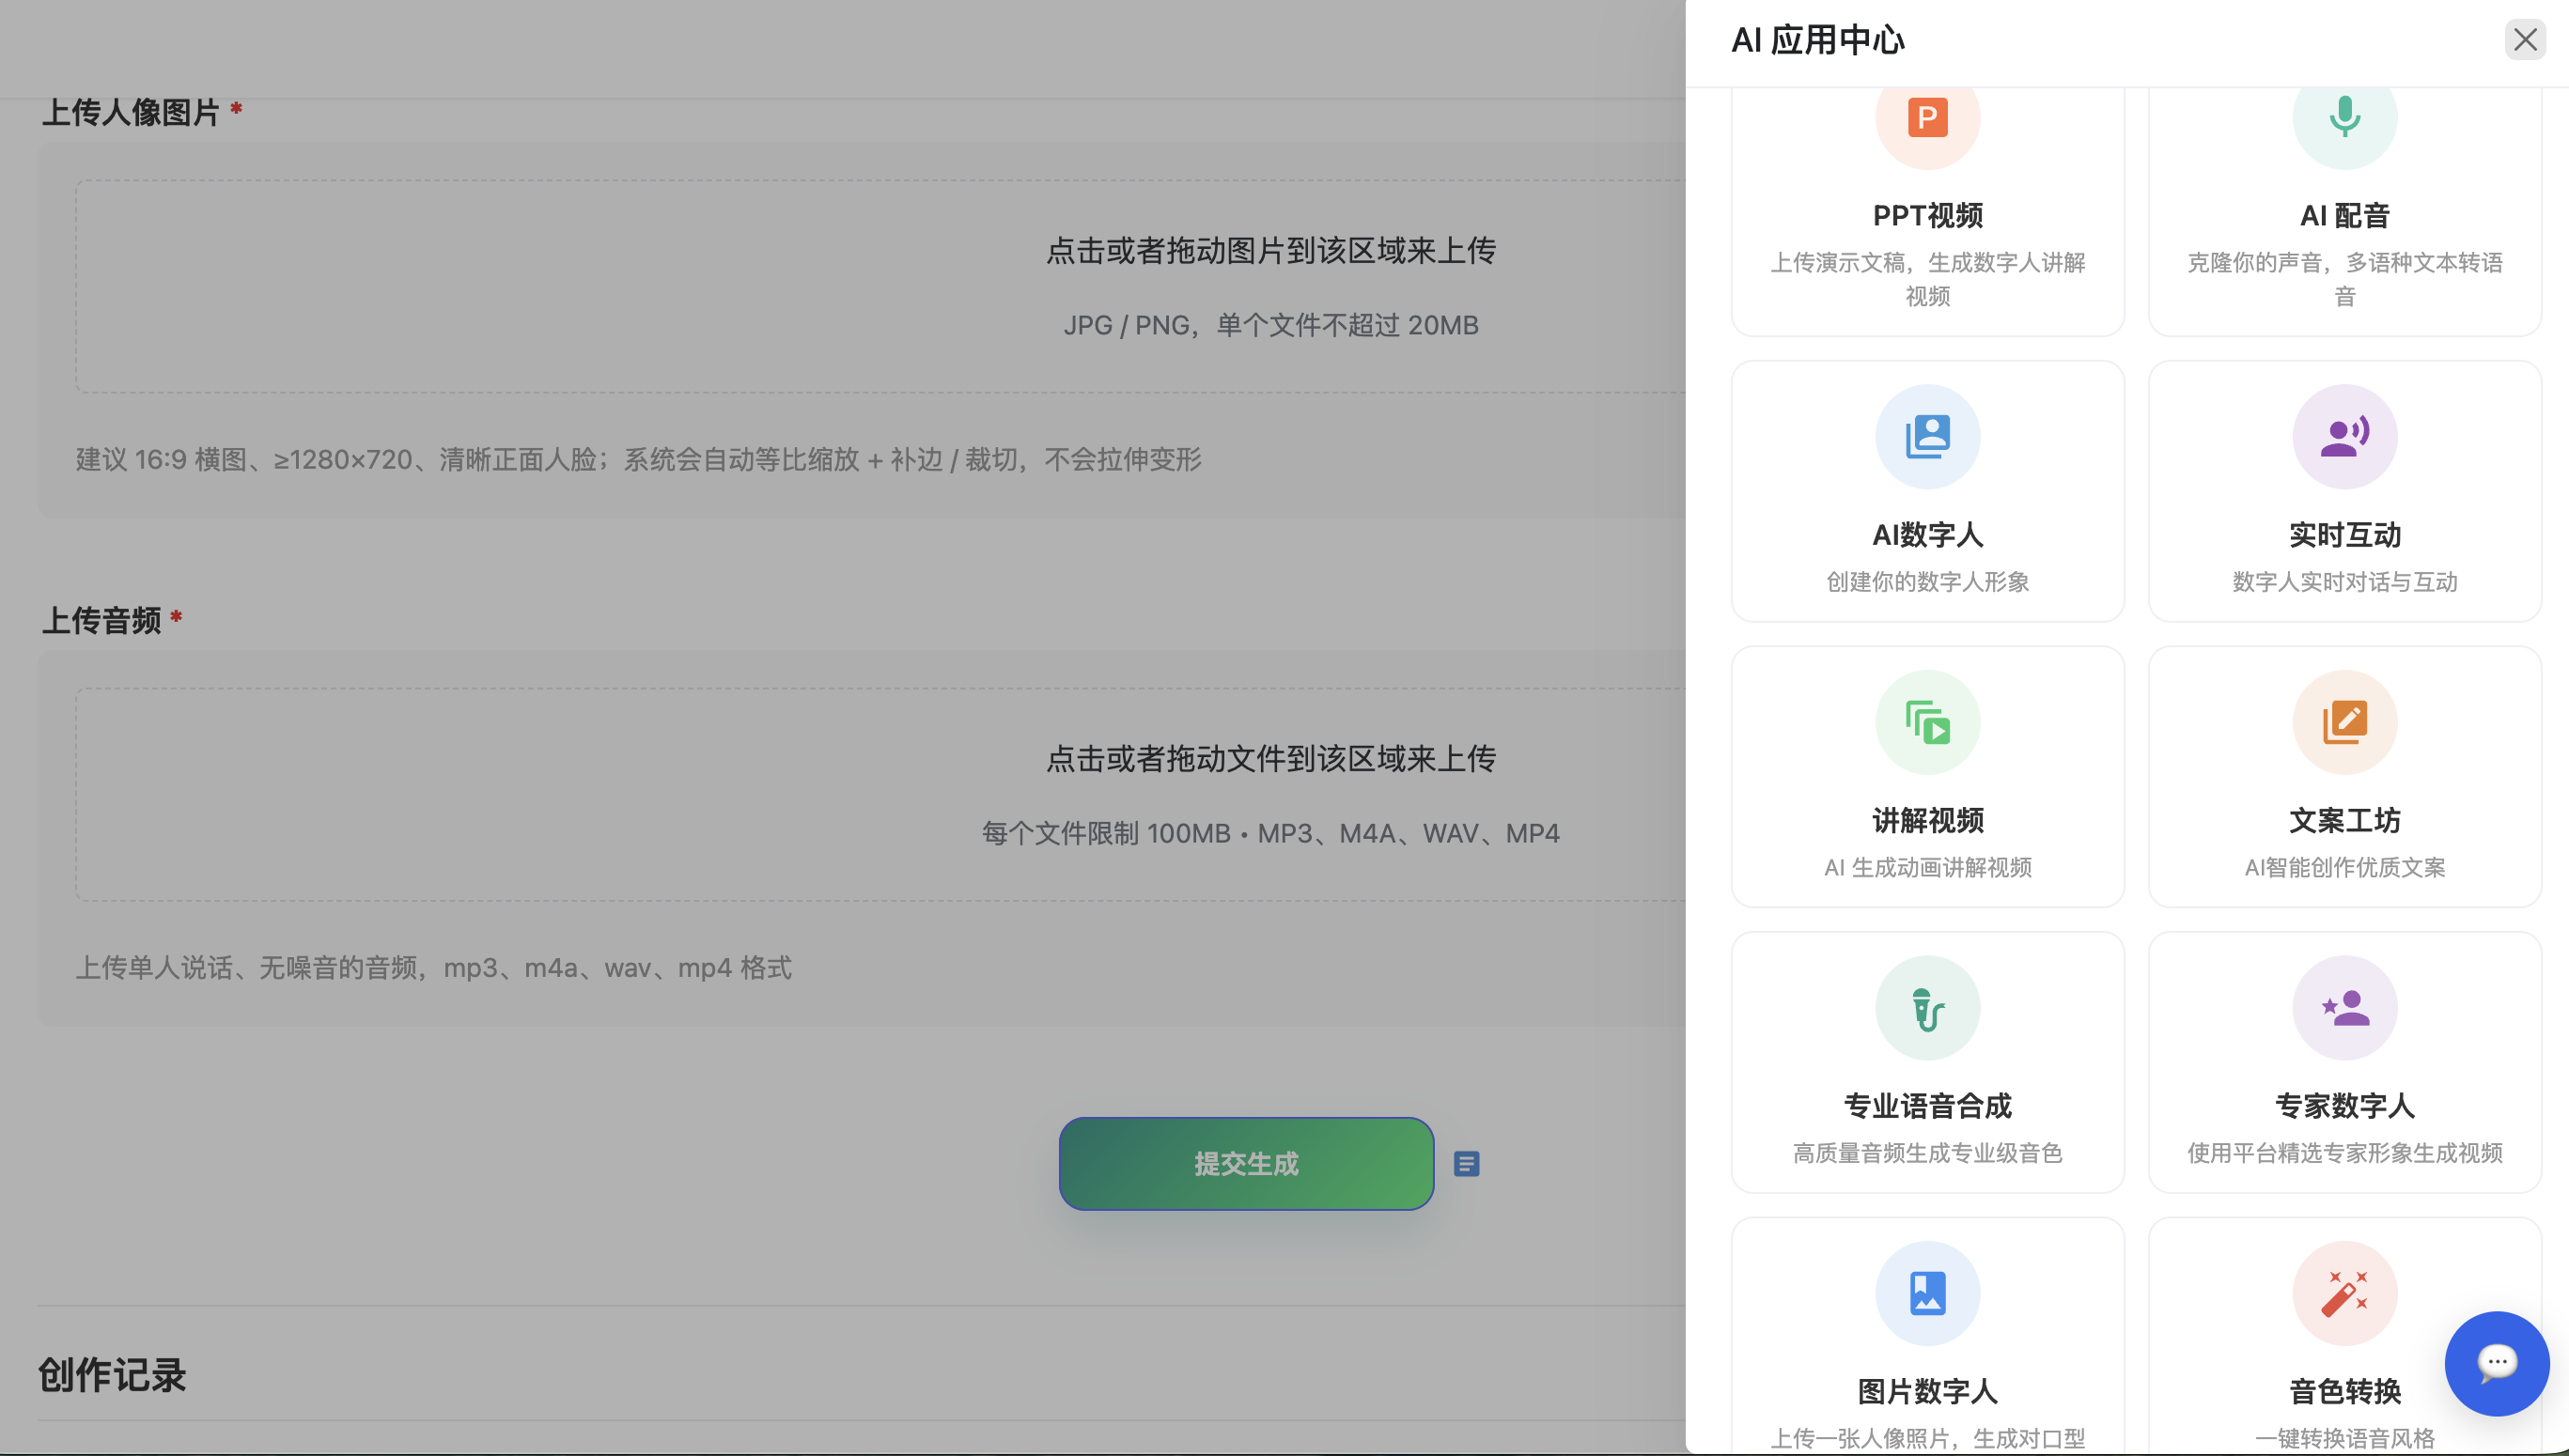
经过长期技术攻关,我们正式推出一项在线服务:
输入一张人物图片和一段音频,即可生成口型精准同步、面部表情自然的数字人视频。
无需专业设备,无需复杂的3D建模,一切都发生在云端。
一、我们要解决什么问题?
过去,制作一个"会说话"的数字人,要么需要专业动捕设备和3D建模团队,要么需要录制大量真人视频来训练专属模型,成本高、周期长、门槛高。
我们希望通过这项服务,让每一个有需求的人都能用最简单的方式获得高质量的数字人视频------
你只需要一张照片,剩下的交给我们。
更重要的是,我们不想只做一个"嘴在动、脸是死的"的数字人。我们要让数字人真正活起来:会说话,也会聆听;有口型,也有情绪。
二、我们的产品能做什么?
核心功能:图片 + 音频 → 口型同步、表情自然的数字人视频。
具体来说,我们的服务具备以下几项关键能力:
- 精准的口型同步。
输入任意音频,数字人的嘴唇运动会与音频内容逐帧对齐,无论是中文、英文还是多语种混合,都能实现自然流畅的唇形匹配。 - 整张脸都在表演,不只是嘴在动。
每一帧的像素都是算出来的,不是把一张静态图贴上去再动嘴。这跟传统"图片 + 嘴部叠加"最根本的区别是:它连下巴、脸颊、眼神光都可以随情绪变,而不只是嘴在动。你语气惊讶,它的眉毛跟着抬;你笑,它也跟着笑。表情跟着语音的情感起伏自然变化,而不是僵硬地只动嘴唇。 - 会聆听的数字人。
大多数 talking-head 模型只吃一路音频------要说话的那一方。放出来的结果就是:说话时嘴型很准,不说话时脸是死的。我们可以做到头像在对方说话时,以对方的声音为条件,持续生成点头、眨眼、挑眉这类聆听动作。这不是回头补一段动画,而是当场算出来的。它让数字人不再是一个单向输出的"播报器",而是一个能对对话做出反应的"交流者"。 - 一张照片即可驱动。
不需要多角度拍摄,不需要3D扫描。你只需要提供一张清晰的正面人物照片,我们的模型就能在保持人物身份特征的前提下,生成自然的说话视频。 - 多风格支持。
无论是写实真人照片、动漫角色还是卡通形象,我们的服务都能生成对应的数字人视频。这种跨风格的处理能力,让产品可以服务于影视制作、社交媒体内容创作、在线教育等多种场景。
三、它为什么能做到?
我们的服务不是在原图上"贴一张嘴",而是让模型真正理解音频与表情之间的关系。
它不直接拼接像素,而是逐帧计算面部动作。
模型会从音频中读懂语气、情绪和节奏,实时推导出整张脸的动作:下巴怎么开合、脸颊怎么变化、眼神光怎么闪动、眉毛怎么抬起。每一帧都是当场算出来的,所以表情才自然、连贯。
它把眉、眼、嘴等区域拆开控制。
传统方案往往只能让嘴动,脸的其他部分保持静止。我们把面部动作按区域拆分,让眉、眼、嘴可以独立又协调地变化。这样,数字人就能呈现出更丰富、更细腻的表情,而不是"嘴动脸不动"。
它的聆听反应是实时生成的,不是事后补动画。
当对方说话时,数字人会根据对方的声音条件,持续生成点头、眨眼、挑眉等聆听动作。你语气惊讶,它的眉毛跟着抬;你笑,它也笑。这些反应不是提前录好的,也不是回头补上的,而是当场算出来的。
它能在动态表情中保持身份特征。
生成丰富表情的同时,我们严格保持人物的身份特征不漂移,让数字人"像本人",而不是变成一个陌生的动画脸。
它支持在线实时交互。
采用流式生成架构,音频推送后快速返回声画同步的视频帧,满足在线交互场景的低延迟需求。
四、应用场景
我们相信这项服务可以服务于多个领域:
短视频与社交媒体
:让静态照片"开口说话",快速制作个性化的口播内容。
在线教育与培训
:将讲师照片转化为数字人讲师,批量生成课程视频,大幅降低录制成本。
电商直播
:用一张商品模特照片生成数字人讲解视频,实现7×24小时不间断的内容输出。
影视与动画制作
:为独立创作者和小型团队提供低成本数字人制作能力,加速创意落地。
虚拟对话与陪伴
:让数字人不仅会说话,还会聆听、点头、微笑,提升互动真实感。
当前AI数字人市场正处于高速增长期。2025年全球AI虚拟人市场规模已达63亿美元,预计2035年将增长至934亿美元,年均复合增长率达30.6%。国内数字人核心市场也已从概念验证迈入规模化商业落地阶段。这些数据表明,市场对高质量、低门槛的数字人服务有着强劲的需求。
作为一个在线服务,我们致力于让这项技术真正好用:
简单
:上传图片和音频,点击生成,无需任何专业背景。
快速
:依托优化的推理架构,快速返回结果。
高质量
:口型同步和表情自然度达到行业领先水平。
会互动
:不仅会说,还会听;不仅有口型,还有情绪。
灵活
:支持多种人物风格,适应不同场景需求。
一张照片,一段声音,一个会说话、也会聆听的数字人。欢迎体验我们的服务。
搜 蔓藤AI