上篇说过,规则引擎再强也有够不着的地方:「施工区锥桶摆放混乱」「行人撑着花伞」「逆光下的临时交通管制」------这类语义级场景,结构化条件根本写不出来。这正是多模态大模型(VLM)推理挖掘的领地:让模型「看图说话」,把画面里的语义读成标签和说明。
本篇拆解这套引擎的四件事:推理输出什么(双输出设计)、说明文本怎么控成本(caption 分级)、任务怎么可靠地跑(流水线与断点续跑)、产出怎么把关(审核门禁)。
一、双输出设计:结构化标签 + 关键说明
引擎支持 Qwen-VL / InternVL / BLIP2 等多模态大模型,模型名称、版本、端点由模型注册表统一管理。每次推理产出两样东西:
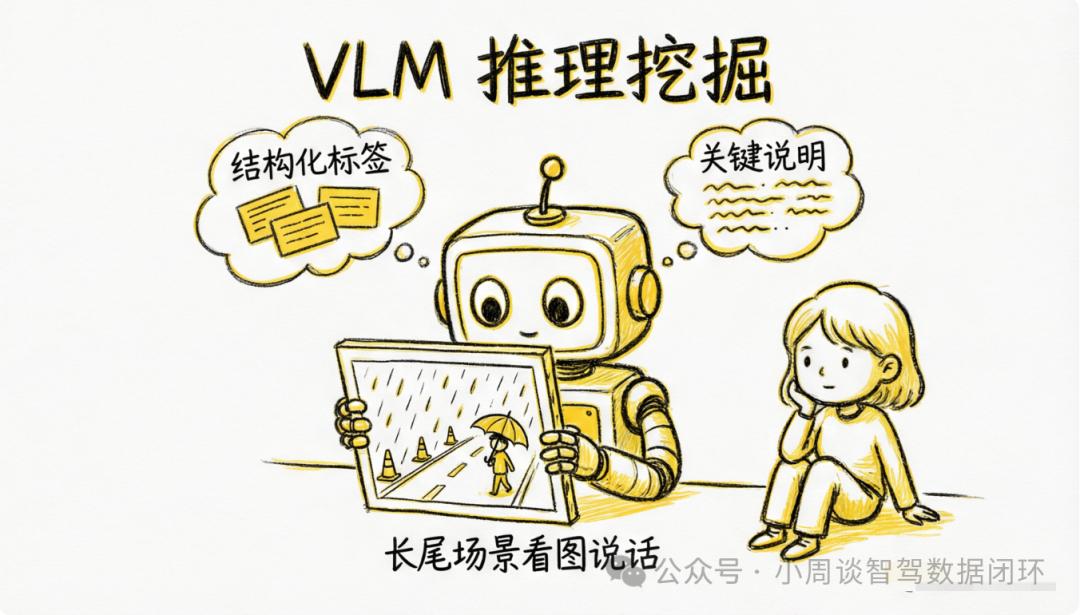
- 结构化标签:映射统一标签字典------模型产出的标签自动走上篇讲的字典映射与去重,未匹配的进候选池待审;模型不会污染标签体系;
- 关键说明(caption):一句话描述画面内容,如「雨天夜间,高速公路上,前方有行人横穿,道路有积水」------给语义检索用的自然语言描述。
两样产出的去向也各有安排:标签走统一标签服务入库;caption 双重落地------作为 CAPTION 类标签写图片标签表(与结构化标签口径同条并存),同时作为 caption 列存入图片向量表,成为「文搜图」的文本向量来源。一次推理,喂饱了结构化过滤和语义检索两条消费路径。
可追溯性上,每条推理结果全量记录置信度、模型名称、版本、推理时间(dwd_mining_inference_job_detail + 标签血缘字段)------任何一张图上的任何一个模型标签,都能回答「哪个模型哪个版本说的,它自己有多大把握」。
二、caption 成本分级:好钢用在刀刃上
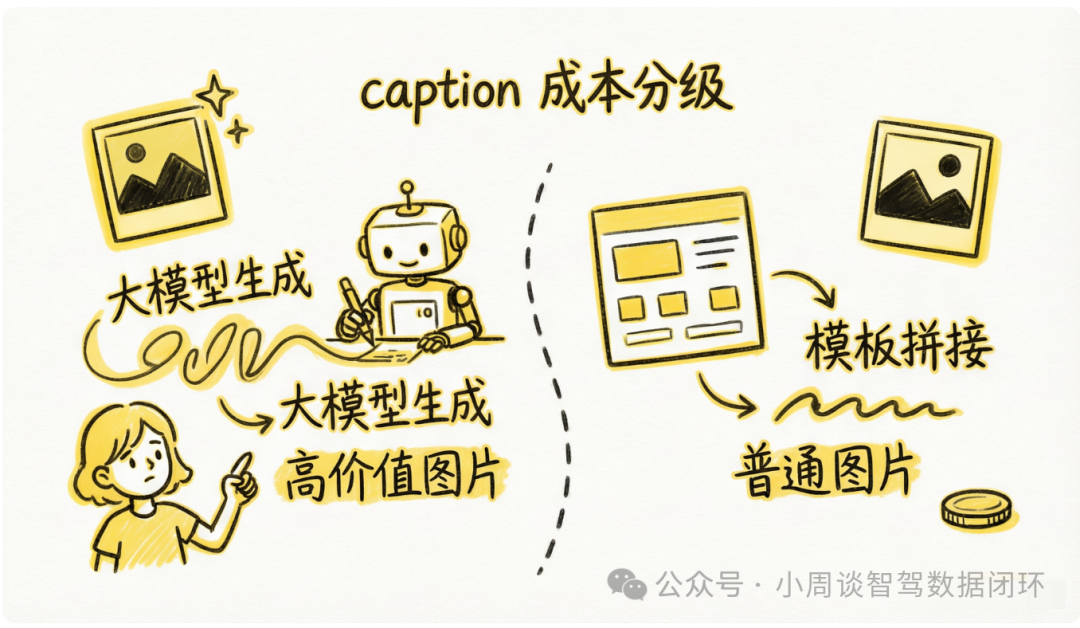
让大模型给几百万张帧每张都写一句自然语言描述,成本会失控。所以 caption 生成分两档:
|--------|--------------------|----------------------------|
| 方式 | 适用范围 | 示例 |
| 大模型生成 | 高价值图片(规则命中 / 事件抽帧) | 「雨天夜间,高速公路上,前方有行人横穿,道路有积水」 |
| 标签模板拼接 | 普通图片(成本控制) | 「场景:高速;天气:雨;时间:夜间;参与者:行人」 |
逻辑很直接:规则命中和事件抽帧的帧本来就少且价值高,值得花算力让模型写好描述;普通帧用已有的结构化标签套模板拼一句,成本几乎为零。两类 caption 进了向量表之后检索体验一致------用户搜「积水路面」,两档描述都能命中。
三、推理任务流水线:从选帧到入湖仓
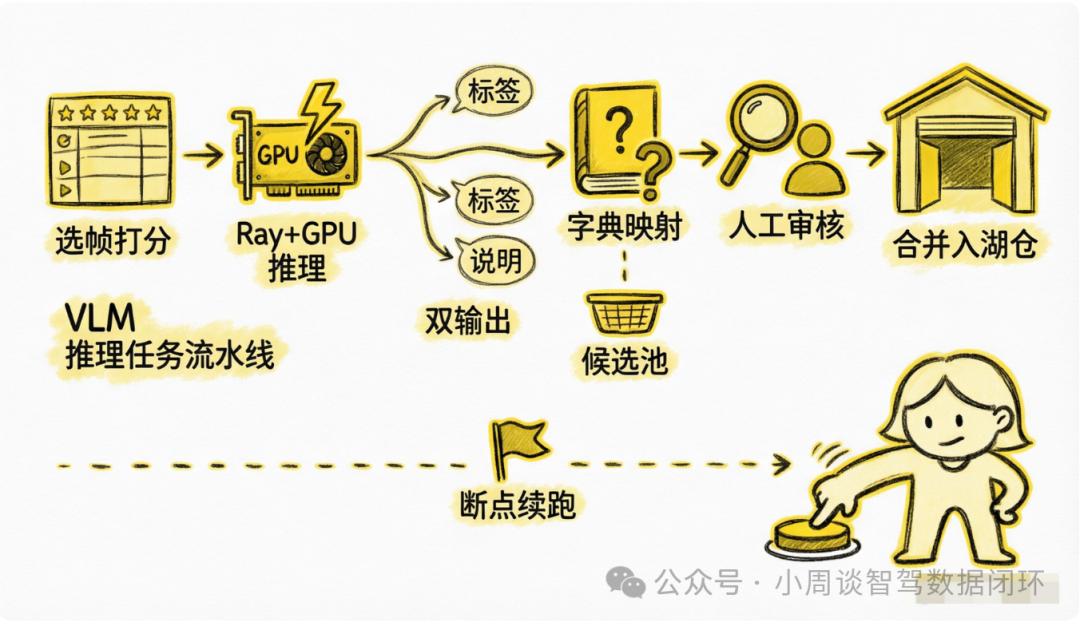
一条推理任务的完整链路是:推理选帧打分 → Ray + GPU 推理 → 双输出 → 字典映射(未匹配进候选池)→ 人工审核 → 临时区写入 → 质量校验 → 合并入湖仓正式表。几个关键工程点:
- 任务要素齐备:数据范围(时间 / 标签过滤 / 抽样比例)、模型与版本、输出目标;经 mining_task_id 挂接任务主表,明细落推理任务表;
- 断点续跑:checkpoint 记录已处理 image 水位------任务中断不从头再来,几百万帧的任务跑到一半挂了也只损失最后一批;
- 幂等写入:先写临时区,经标签映射与质量校验后才合并入正式表------推理结果永远不会半成品入湖;
- 弹性算力:Ray / Spark + GPU 集群弹性伸缩,单卡每日处理不低于 10 万张(视模型规模)。
注意入口的「选帧打分」------不是所有帧都值得推理。结合抽帧篇的 frame_quality_score 与规则命中信号,先把算力花在信息密度最高的帧上,这是整个推理挖掘成本控制的第一闸门。
四、质量门禁:模型产出先过审再上岗
模型标签天然带噪声,所以出口侧的规矩很硬:推理结果支持人工审核修正,审核结论写回标签表;未审核的模型标签不得进入训练集圈选。这也是行业通行的自动标注准入规则------特斯拉 Auto-Labeling 同样以离线自动标注为主、人工团队仅复核难例,业界公开实践里「未审核标签不直接进训练集」是底线而非加分项。
回头看三级漏斗:规则引擎用近乎零成本圈出候选,VLM 推理给候选帧补上语义标签和自然语言描述,审核门禁保证产出可信。到这里,数据已经具备了「结构化标签 + 语义描述」双重表达------万事俱备,只欠把它们变成向量,下一篇进入向量化流水线。
📌 本篇要点回顾:① 双输出:结构化标签(映射字典)+ caption(文搜图的向量来源);② caption 分级控成本:高价值帧模型生成、普通帧模板拼接;③ 选帧打分控入口、断点续跑 + 幂等写入保可靠、单卡日处理 10 万张;④ 未审核模型标签不得进入训练集。
标签和说明都齐了,但要支持「找一批跟这张图相似的场景」,还需要把它们编码成向量。下篇讲向量化流水线:Embedding 模型怎么选、凌晨 6 点前的 GPU 窗口怎么排、向量表为什么是湖仓里唯一的非分区表。