用潜态Workspace Token解决长时序操作记忆
------工作空间模型
目录
[01 Workspace Models完整技术链路](#01 Workspace Models完整技术链路)
[基于Workspace Token的模仿策略训练](#基于Workspace Token的模仿策略训练)
[03 仿真+真机实验结果](#03 仿真+真机实验结果)
[04 写在最后](#04 写在最后)
长时序机器人操作任务需要记住历史关键事件,例如已经投放多少方块、抽屉内物体存放位置。
现有主流方案大多部署时在线调用VLM做关键帧筛选、文本摘要,虽然能提取任务相关记忆,但推理时持续调用大模型会带来很高时延,嵌入式机器人很难承受。
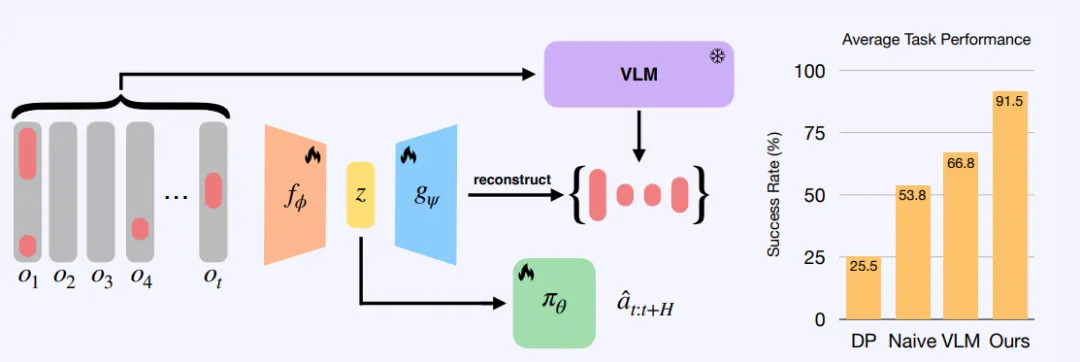
MIT、卡内基梅隆大学提出Workspace Models,整套方法把VLM显著性标注全部放到训练阶段,学习出轻量化潜态记忆表征Workspace Token。部署时不再需要任何VLM参与,直接将token送入扩散策略做动作生成。
这套工作的工程价值在于:机器人领域可以利用"训练算力充裕、部署算力紧缺"的不对称性,把繁重的大模型推理转移到离线训练环节。
01 Workspace Models完整技术链路
整套流水线分为三部分:VLM显著性集合标注流水线、Workspace编码器‑解码器训练、基于Workspace Token的模仿策略训练。
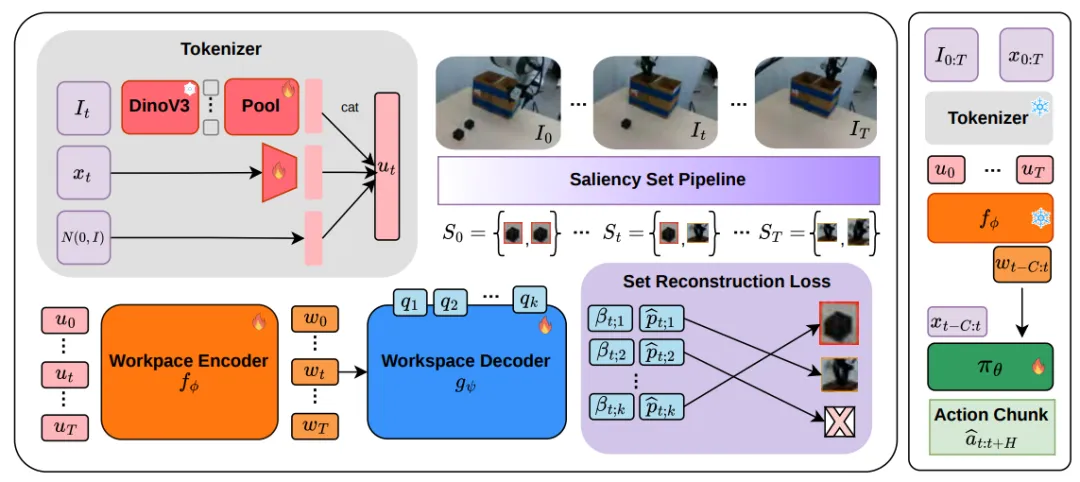
▲图 | Workspace Model 完整训练与推理流水线总览
推理阶段丢弃VLM和解码器,只保留编码器与下游扩散策略。
VLM显著性集合标注流水线(仅训练阶段执行)
利用Qwen3‑VL‑8B‑Instruct识别轨迹内发生关键事件的时间步,再通过MolmoPoint点检测模型输出事件对应的图像关键点,提取DinoV3图像patch,组装成每一时刻的显著性集合。
由一系列DinoV3图像patch构成,代表完成当前动作必须记住的视觉信息;该集合只在训练时作为监督真值,测试阶段不会运行这套VLM流程。
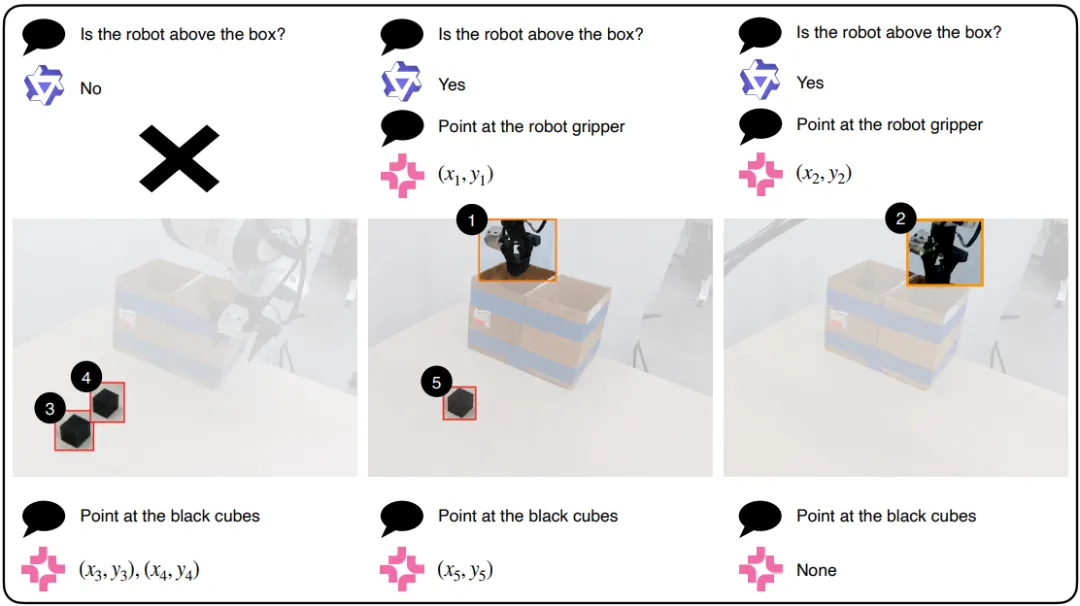
▲图 | 两阶段VLM显著性标注流程
标注流程分为两步:
首先Qwen‑VL做时序事件分类,识别轨迹内哪些时刻发生需要记忆的事件;随后MolmoPoint输出2D点坐标,映射为DinoV3 patch,得到包含持久物体、瞬时事件patch的显著性集合。
Workspace编码器‑解码器集合重建训练
编码器是带因果掩码Transformer,接收图像token、本体感知以及可学习随机输入slot,输出潜态记忆w_t即Workspace Token。
解码器参考DETR集合预测范式,输出固定数量slot,每个slot预测patch特征以及该slot是否激活的概率。训练采用匈牙利算法做最优匹配,计算集合重建损失。
公式总训练损失:
为 patch 特征重建损失;
是 slot 激活状态交叉熵损失;
、
为损失权重。
匈牙利匹配用来把解码器输出slot与真值显著性集合做一一对应,处理集合元素顺序不固定的问题;未匹配的slot标记为空,避免无效预测。
训练完成之后,解码器直接丢弃,推理只保留Workspace编码器。
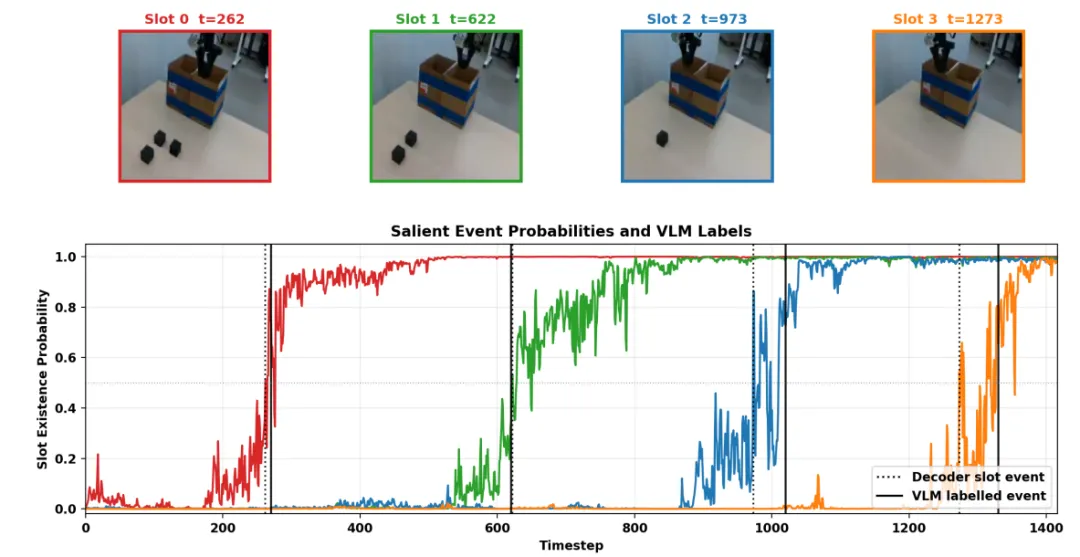
▲图 | 解码器slot激活概率随时间变化可视化
这里有一个值得注意的现象:Workspace编码器输出token具备时序平滑特性,slot激活概率是逐步抬升,而不是在某个时间点硬跳变。
这就缓解了Keyframe基线依赖离散关键帧带来的时间抖动别名问题。
基于Workspace Token的模仿策略训练
冻结Workspace编码器权重,取一小段历史窗口内的Workspace Token序列,联合本体感知状态,输入Diffusion Policy扩散策略,预测未来动作块。
训练、仿真使用ManiSkill3环境;真实硬件采用Franka FR3机械臂搭配RealSense D435相机。
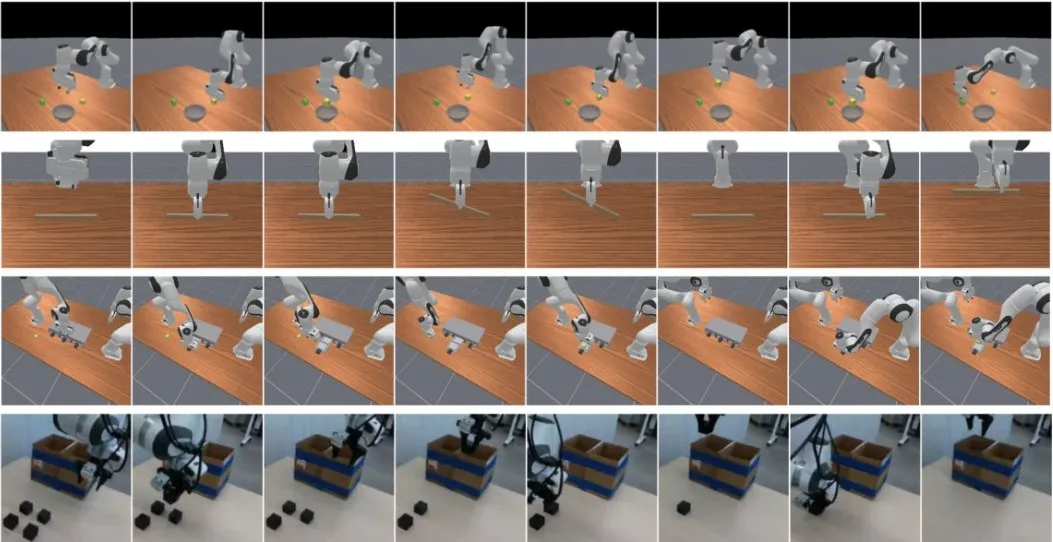
▲图 | 四类仿真演示任务轨迹示例图
03 仿真+真机实验结果
实验一共四项记忆类任务,覆盖计数记忆、空间回忆、上下文适应三类典型记忆需求:
CUBEDROP方块投放计数、DRAWERRECALL抽屉物体回忆、BALANCEBAR质心识别、HALFANDHALF真机方块均分放置
对比基线:VanillaDP(仅当前帧)、HistoryDP(堆叠历史帧)、Keyframe(在线VLM选帧)。
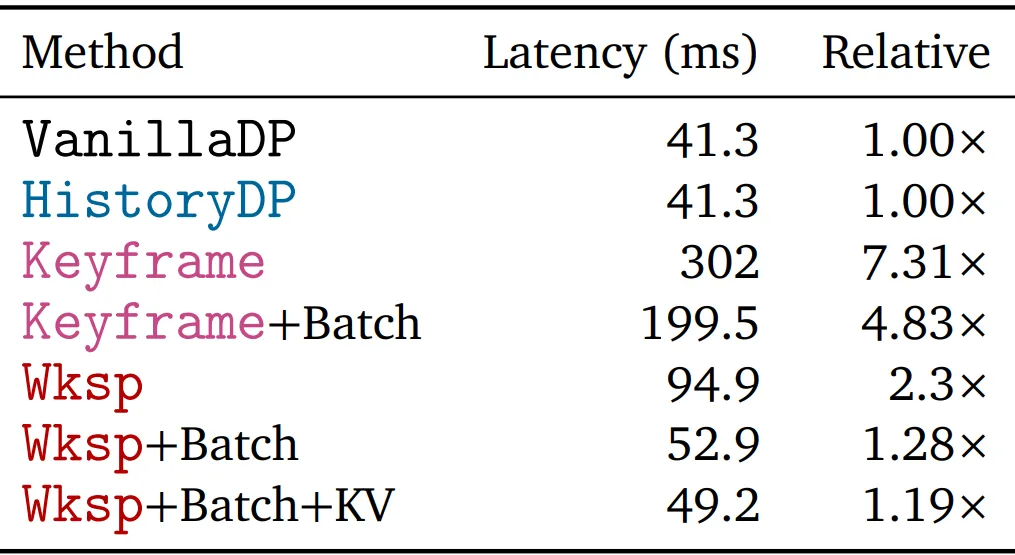
▲表 | 各方案推理时延统计表
时延数据为仿真环境测算;真机上如果Keyframe使用云端API调用VLM,延迟会进一步剧烈放大;Workspace Model经过KV缓存、批处理优化后,时延已经非常接近普通无记忆扩散策略。
Wksp跨任务平均成功率91.5%±2.2%;对比最优基线Keyframe只有66.8%±3.2%。
**意料之外的一点是:**它不只是延迟更低,任务效果也显著优于部署时调用VLM的Keyframe方案。
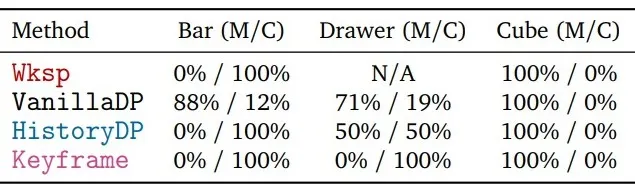
▲表 | 任务失败模式拆解(记忆类M / 控制类C)
失败统计可以看出:
VanillaDP主要栽在记忆错误,记不住历史发生的事件;
HistoryDP、Keyframe记忆判断大多正确,但大量出现控制执行失败。关键帧是离散采样,对帧的时间偏移很敏感,带来时序别名效应,损害精细抓取控制;
Workspace Model依靠平滑潜态表征,同时兼顾记忆信息保存与动作控制精度。
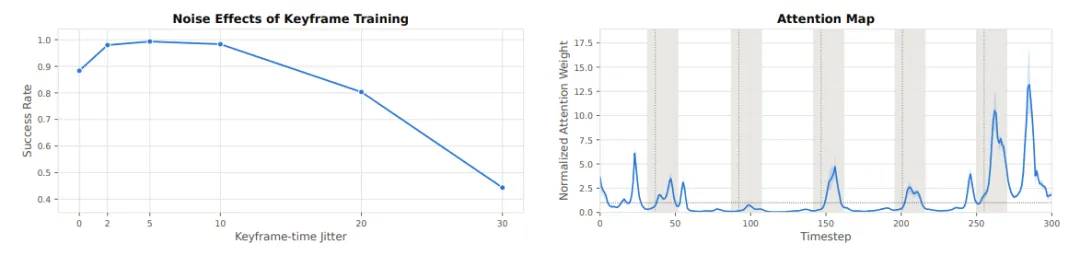
▲图 | 关键帧时序噪声与成功率、注意力权重分析
消融实验也证实:
Keyframe基线性能高度依赖关键帧选取时刻,时间引入噪声之后成功率明显下滑;
Workspace Model的注意力在事件时间附近平滑分布,对时间抖动鲁棒性更强。
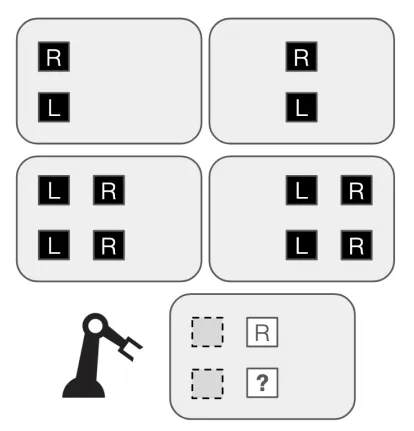
▲图 | 任务配置示意图:黑色方块代表方块,字母代表机器人需要放置方块的目标盒子
04 写在最后
解决机器人记忆不一定非要在机器人运行的时候调用大模型做在线筛选。利用训练、部署算力的非对称,VLM仅作为离线标签器,学习出轻量化潜态记忆Workspace Token。
**实验也出现一个有意思反直觉结果:**不光延迟变低,任务表现反而超过部署时在线跑VLM的Keyframe基线。背后根源是离散关键帧机制带来时序别名问题;而Workspace Model学习得到平滑潜表征,对事件时间抖动鲁棒性更强。
当然这套方案也存在约束,训练数据需要VLM打显著性标签,超长时序场景编码器计算成本上涨,动态场景还需要进一步验证。
它给长时序机器人记忆提供一条务实路线:大模型不一定部署在机器人上,也可以充当训练阶段的监督老师。
参考论文:
论文标题:Workspace Models: Lightweight Robotic Memory via Saliency‑Driven Supervision