LIMA: Less Is More for Alignment
LIMA:对于对齐而言,少即是多
摘要
大型语言模型分两个阶段训练:(1) 从原始文本进行无监督预训练,以学习通用表示;(2) 大规模指令微调与强化学习,以更好地对齐最终任务和用户偏好。我们通过训练 LIMA 来衡量这两个阶段的相对重要性。LIMA 是一个 65 65 65B 参数的 LLaMa 语言模型,仅使用 1,000 1{,}000 1,000 条精心整理的提示与响应,以标准监督损失进行微调,未进行任何强化学习或人类偏好建模。LIMA 展现出显著强大的性能,仅凭训练数据中的少量示例就能学会遵循特定的响应格式,其中包括从规划旅行行程到推测架空历史等复杂查询。此外,该模型往往能很好地泛化到训练数据中未出现的未见任务。在一项受控人类研究中,在 43 % 43\% 43% 的情况下,LIMA 的响应与 GPT-4 相当或被严格偏好于 GPT-4;与 Bard 相比,这一统计值高达 58 % 58\% 58%,而与 DaVinci003 相比则为 65 % 65\% 65%,后者是使用人类反馈训练的。综合来看,这些结果强烈表明,大型语言模型中的几乎所有知识都是在预训练期间学到的,并且只需有限的指令微调数据就足以教会模型产生高质量输出。
1.引言
语言模型经过预训练,能够在极大尺度上预测下一个词元,从而学习可迁移至几乎所有语言理解或生成任务的通用表示。为实现这种迁移,人们因此提出了多种对齐语言模型的方法,主要集中于在包含数百万样本的大型数据集Mishra et al., 2021, Wei et al., 2022a, Sanh et al., 2022上进行指令微调Chung et al., 2022, Beeching et al., 2023, Köpf et al., 2023,以及更近期基于人类反馈的强化学习(RLHF)Bai et al., 2022a, Ouyang et al., 2022,后者通过数百万次与人类标注者的交互收集而来。现有对齐方法需要大量算力和专用数据才能达到 ChatGPT 级别的性能。然而,我们证明,给定一个强大的预训练语言模型,仅需在 1,000 个精心筛选的训练样本上进行微调,即可实现极其强劲的性能。
我们假设,对齐可以是一个简单的过程,其中模型学习与用户交互的风格或格式,以展现在预训练期间已经获得的知识和能力。为了检验这一假设,我们精心整理了 1,000 个接近真实用户提示和高质量响应的示例。我们从 Stack Exchange 和 wikiHow 等社区论坛中挑选 750 个优质问题与答案,并按照质量与多样性进行采样。此外,我们手动撰写了 250 个提示与响应示例,同时优化任务多样性,并强调一种体现 AI 助手精神的统一响应风格。最后,我们训练了 LIMA------一个在此 1,000 个演示样本集合上微调的预训练 65B 参数 LLaMa 模型 Touvron et al., 2023。我们在 300 个具有挑战性的测试提示上,将 LIMA 与最先进的语言模型和产品进行比较。在一项人类偏好研究中,我们发现 LIMA 优于来自 OpenAI 的经 RLHF 训练的 DaVinci003(该模型使用 RLHF 训练),也优于一个在 52,000 个示例上训练的 65B 参数 Alpaca 复现模型 Taori et al., 2023。尽管人类通常相比 LIMA 更偏好 GPT-4、Claude 和 Bard 的响应,但情况并非总是如此;在分别与这三者比较时,LIMA 在 43 % 43\% 43%、 46 % 46\% 46% 和 58 % 58\% 58% 的情况下产生同等或更受偏好的响应。以 GPT-4 作为标注者重复人类偏好标注,印证了我们的发现。在绝对尺度上分析 LIMA 的响应显示, 88 % 88\% 88% 满足提示要求, 50 % 50\% 50% 被认为优秀。消融实验显示,当仅扩大数据量而不扩大提示多样性时,收益会大幅递减;与此同时,优化数据质量会带来显著增益。此外,尽管没有任何对话示例,我们发现 LIMA 能够进行连贯的多轮对话,并且仅通过向训练集加入 30 条手工设计的对话链,这一能力就能得到显著提升。总体而言,这些令人瞩目的发现证明了预训练的力量,以及其相对于大规模指令微调和强化学习方法的相对重要性。
2 对齐数据
我们定义表层对齐假设:模型的知识和能力几乎完全是在预训练期间习得的,而对齐则教它在与用户交互时应使用格式的哪个子分布。如果这一假设正确,且对齐主要关乎学习风格,那么表层对齐假设的一个推论是,人们可以用相当小的示例集充分调优一个预训练语言模型 Kirstain et al., 2021。为此,我们收集了一个包含 1,000 个提示和响应的数据集,其中输出(响应)在风格上彼此对齐,但输入(提示)是多样的。具体而言,我们寻求以有用的 AI 助手为风格的输出。我们从多种来源中精选此类示例,主要分为社区问答论坛和人工编写的示例。我们还收集了一个包含 300 个提示的测试集和一个包含 50 个提示的开发集。表 1 展示了不同数据来源的概览,并提供了一些统计信息(训练示例选编见附录 A)。
2.1 社区问题与回答
我们从三个社区问答网站收集数据:Stack Exchange、wikiHow 和 Pushshift Reddit 数据集 Baumgartner et al., 2020。大致来说,来自 Stack Exchange 和wikiHow 与有帮助的 AI 智能体的行为高度一致,因此可被自动挖掘,而高赞 Reddit 回答往往带有幽默或挑衅性质,需要采用更人工的方式来筛选符合适当风格的回复。 Stack Exchange Stack Exchange 包含 179 个在线社区(exchange),每个社区都致力于特定主题,其中最受欢迎的是编程(Stack Overflow)。用户可以发布问题、回答、评论,并对上述所有内容进行点赞(或点踩)。得益于活跃的社区成员和版主,Stack Exchange 成功维持了内容质量的高标准。 从 Stack Exchange 采样时,我们同时施加质量和多样性控制。首先,我们将这些 exchange 划分为 75 个 STEM exchange(包括编程、数学、物理等)和 99 个其他 exchange(英语、烹饪、旅行等);我们丢弃 5 个小众 exchange。随后,我们使用温度 τ = 3 \tau = 3 τ=3 从每个集合中采样 200 个问题和答案,以获得不同领域更均匀的样本。在每个 exchange 内,我们选取得分最高且在标题中自足(无正文)的问题。然后,我们为每个问题选择最佳答案,假定其具有强正得分(至少 10)。为符合有帮助的 AI 助手的风格,我们会自动过滤过短(少于 1200 个字符)、过长(超过 4096 个字符)、以第一人称撰写("I""my")或引用其他答案("as mentioned""stack exchange"等)的答案;我们还会从回复中移除链接、图像和其他 HTML 标签,仅保留代码块和列表。由于 Stack Exchange 问题同时包含标题和描述,我们为部分样本随机选择标题作为提示,为其他样本选择描述。 wikiHow wikiHow 是一个在线 wiki 风格出版物,收录了超过 240,000 篇涵盖多种主题的操作指南文章。任何人都可以向 wikiHow 贡献内容,不过文章会受到严格审核,因而内容几乎普遍具有高质量。我们从 wikiHow 采样 200 篇文章,先(从 19 个类别中)采样一个类别,然后在该类别内采样一篇文章,以确保多样性。我们使用标题作为提示(例如"如何做煎蛋卷?"),并使用文章正文作为回复。我们将典型的"This article..."开头替换为"The following answer...",并应用若干预处理启发式方法来删减链接、图像以及文本的某些部分。 The Pushshift Reddit Dataset Reddit 是世界上最受欢迎的网站之一,允许用户在用户创建的子版块(subreddit)中分享、讨论和点赞内容。由于其极高人气,Reddit 更倾向于娱乐其他用户,而非提供帮助;相当常见的是,机智、讽刺的评论会比严肃、信息丰富的评论在该帖子下获得更多票数。因此,我们将样本限制为两个子集,即 r/AskReddit 和 r/WritingPrompts,并从每个社区中最高赞的帖子内人工选择样本。我们从 r/AskReddit 中找到 70 个自足提示(仅标题,无正文),将其用于测试集,因为最高票答案未必可靠。WritingPrompts 子版块包含虚构故事的前提,随后鼓励其他用户创造性地将其补全。我们找到 150 个提示和高质量回复,涵盖爱情诗和短篇科幻故事等主题,并将其加入训练集。所有数据实例均从 Pushshift Reddit 数据集 Baumgartner et al., 2020 中挖掘得到。
2.2 人工编写的示例
为了进一步使我们的数据多样化,使其超越在线社区用户所提出的问题,我们从我们自己(本工作的作者)处收集提示。我们指定两组作者,A 组和 B 组,每组创作 250 个提示,灵感来自他们自己或其朋友们的兴趣。¹ 我们从 A 组选择 200 个提示用于训练,并选择 50 个提示作为留出的开发集。在过滤掉一些有问题的提示后,B 组剩余的 230 个提示用于测试。 我们为这 200 个训练提示补充高质量答案,这些答案由我们自己撰写。在撰写答案时,我们尝试设定一种适合有帮助的 AI 助手的统一语气。具体而言,许多提示的回答会先以某种方式确认问题,然后给出答案本身。初步实验表明,这种一致的格式总体上能提升模型性能;我们假设它有助于模型形成思维链,类似于"let's think step-by-step"提示 Kojima et al., 2022, Wei et al., 2022b。
我们还包括 13 个具有一定毒性或恶意的训练提示。我们仔细编写部分或完全拒绝该命令的回复,并解释助手为何不会遵从。测试集中还有 30 个具有类似问题的提示,我们将在第 4.3 节中分析。除人工编写的示例外,我们还从 Super-Natural Instructions Wang et al., 2022b 中采样 50 个训练示例。具体而言,我们选择 50 个自然语言生成任务,例如摘要、改写和风格迁移,并从每个任务中随机选取一个示例。我们对其中一些示例进行轻微编辑,以符合我们 200 个手动示例的风格。尽管潜在用户提示的分布可以说不同于 Super-Natural Instructions 中任务的分布,但我们的直觉是,这个小样本为训练示例的整体混合增加了多样性,并可能提高模型鲁棒性。手动创建多样化的提示并以统一风格撰写丰富回复是费力的。尽管一些近期工作通过蒸馏和其他自动方法 Honovich et al., 2022, Wang et al., 2022a, Taori et al., 2023, Chiang et al., 2023, Sun et al., 2023 避免人工劳动,并以数量而非质量为目标进行优化,但本工作转而探索投资于多样性和质量的效果。
3 训练 LIMA
我们使用以下协议训练 LIMA(Less Is More for Alignment)。从 LLaMa 65B Touvron et al., 2023 开始,我们在 1,000 个示例的对齐训练集上进行微调。为了区分每个说话者(用户和助手),我们在每个话语的末尾引入一个特殊的轮次结束标记(EOT);该标记扮演与停止生成的 EOS 相同的角色,但避免与预训练模型可能已赋予既有 EOS 标记的任何其他含义相混淆。
我们遵循标准微调超参数:我们使用 AdamW Loshchilov and Hutter, 2017 微调 15 个 epoch,其中 β 1 = 0.9 \beta_1 = 0.9 β1=0.9、 β 2 = 0.95 \beta_2 = 0.95 β2=0.95,权重衰减为 0.1 0.1 0.1。不使用预热步骤,我们将初始学习率设为 1 e − 5 1e-5 1e−5,并在训练结束时线性衰减至 1 e − 6 1e-6 1e−6。批大小设为 32 个示例(较小模型为 64),长于 2048 个 token 的文本会被截断。一个显著偏离常规之处是使用残差 dropout;我们遵循 Ouyang et al. 2022,在残差连接上应用 dropout,从底层的 p d = 0.0 p_d = 0.0 pd=0.0 开始,并线性提高该比率至最后一层的 p d = 0.3 p_d = 0.3 pd=0.3(较小模型为 p d = 0.2 p_d = 0.2 pd=0.2)。我们发现困惑度与生成质量不相关,因此使用留出的包含 50 个示例的开发集,在第 5 个到第 10 个 epoch 之间手动选择检查点。2
4 人工评估
我们通过将 LIMA 与最先进的语言模型进行比较来评估它,并发现其表现优于 OpenAI 基于 RLHF 的 DaVinci003 以及在 52,000 个示例上训练的 65B 参数 Alpaca 复现,并且常常产生优于或等同于 GPT-4 的回复。对 LIMA 生成结果的分析发现,其 50 % 50\% 50% 的输出被认为优秀。仅对如此少的示例进行简单微调便足以与最先进水平竞争,这一事实强烈支持了表层对齐假设(第 2 节),因为它证明了预训练的能力及其相对于大规模指令微调和强化学习方法的相对重要性。
4.1 实验设置
为了将 LIMA 与其他模型进行比较,我们为每个测试提示生成单个回复。然后,我们让众包工作者将 LIMA 输出与每个基线进行比较,并标注他们更偏好哪一个。我们用 GPT-4 替代人类众包工作者重复该实验,发现一致性水平相似。
基线
我们将 LIMA 与五个基线进行比较:Alpaca 65B Taori et al., 2023------我们在 Alpaca 训练集 Taori et al., 2023 中的 52,000 个示例上微调 LLaMa 65B Touvron et al., 2023;OpenAI 的 DaVinci003,3 一个使用基于人类反馈的强化学习(RLHF)调优的大语言模型 Ouyang et al., 2022;Google 的 Bard,基于 PaLM Chowdhery et al., 2022;Anthropic 的 Claude,4 一个使用来自 AI 的强化学习训练的 52B 参数模型
反馈(Constitutional AI)Bai et al. 2022b、OpenAI 的 GPT-4 OpenAI, 2023,一个使用 RLHF 训练的大语言模型,目前被认为处于最先进水平。所有基线模型的回复均于 2023 年 4 月期间采样。 生成 对于每个提示,我们使用核采样 Holtzman et al., 2019 从每个基线模型生成单个回复,其中 p = 0.9 p=0.9 p=0.9,温度 τ = 0.7 \tau=0.7 τ=0.7。我们对先前生成的 token 施加重复惩罚,超参数为 1.2 Keskar et al., 2019。我们将最大 token 长度限制为 2048。 方法 在每一步,我们向标注者呈现单个提示和两个可能的回复,这些回复由不同模型生成。标注者被要求标注哪个回复更好,或者两个回复是否都没有显著优于另一个;附录 C 提供了确切表述。我们通过向 GPT-4 提供完全相同的指令和数据来收集平行标注。 标注者间一致性 我们使用平局折减准确率计算标注者间一致性:如果两个标注者一致,则赋予 1 分;如果任一标注者(但并非两者)标注为平局,则赋予半分;否则赋予 0 分。我们在一个共享的 50 个标注样本集合上测量一致性(单个提示、两个模型回复------均随机选择),比较作者、众包和 GPT-4 的标注。在人类标注者中,我们发现以下一致性得分:众包-众包 82%、众包-作者 81% 和作者-作者 78%。尽管该任务存在一定程度的主观性,但人类标注者之间具有尚可的一致性。 我们还测量了 GPT-4 与人类之间的一致性:众包-GPT 78% 和作者-GPT 79%(尽管我们使用随机解码,GPT-4 几乎总是与自身一致)。这些数字使 GPT-4 在与人类标注者的一致性方面处于同等水平,实质上通过了该任务的 Turking Test Efrat and Levy, 2020。
4.2 结果
图 1 展示了我们人类偏好研究的结果,而图 2 展示了 GPT-4 偏好的结果。我们主要考察人类研究中的结果,因为 GPT-4 在很大程度上表现出相同的趋势。我们的第一个观察是,尽管 Alpaca 65B 训练所用的数据量多 52 52 52 倍,但它倾向于产生比 LIMA 更不受偏好的输出。DaVinci003 也是如此,尽管程度较轻;这一结果引人注目之处在于,DaVinci003 是使用 RLHF 训练的,而 RLHF 据称是一种更优的对齐方法。Bard 表现出与 DaVinci003 相反的趋势,在 42 % 42\% 42% 的情况下产生比 LIMA 更好的响应;然而,这也意味着在 58 % 58\% 58% 的情况下,LIMA 的响应至少与 Bard 一样好。最后,我们看到,尽管 Claude 和 GPT-4 总体表现优于 LIMA,但在相当多的案例中,LIMA 确实会产生更好的响应。也许具有讽刺意味的是,即使是 GPT-4,在 19 % 19\% 19% 的情况下也更偏好 LIMA 的输出而非其自身的输出。
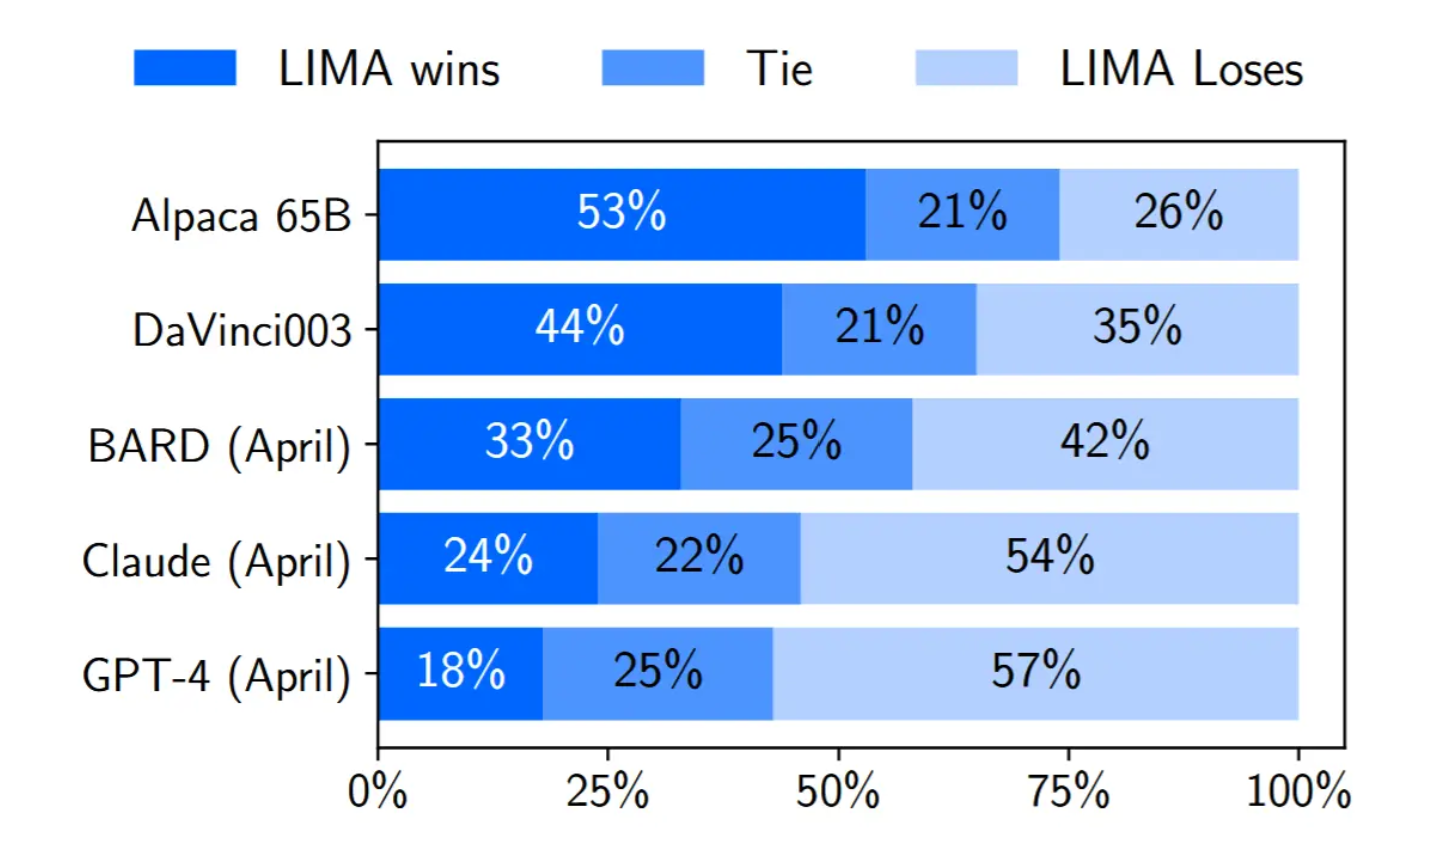
图 1:人类偏好评估,在 300 个测试提示上将 LIMA 与 5 个不同基线进行比较。
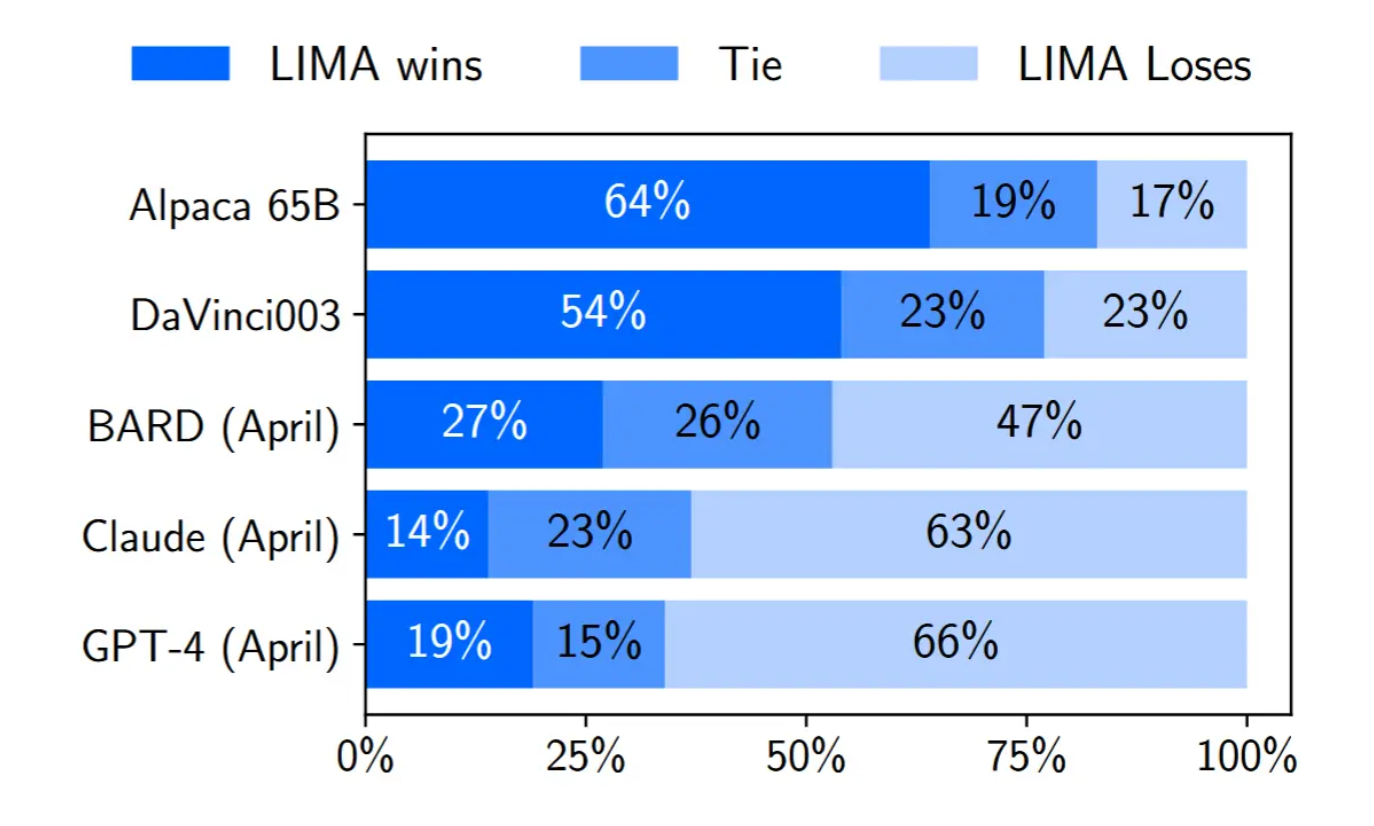
图 2:使用 GPT-4 作为标注者,并在提供与人类相同指令的情况下进行的偏好评估。
4.3 分析
尽管我们的主要评估是针对最先进模型来评估 LIMA,但必须记住,其中一些基线模型实际上是经过高度调优的产品,它们在训练期间可能接触过数百万条真实用户提示,从而形成了极高的门槛。因此,我们通过人工分析 50 个随机示例来提供一种绝对评估。我们将每个示例归入以下三类之一:失败,即回答未满足提示的要求;通过,即回答满足了提示的要求;优秀,即模型对提示提供了出色的回答。
结果:图3显示, 50 % 50\% 50% 的 LIMA 回答被认为优秀,并且它能够遵循所分析的50个提示中除6个之外的所有提示。我们在失败案例中未观察到任何显著趋势。图4展示了用于提供育儿建议和生成食谱的 LIMA 示例输出。分布外:LIMA 在分布外示例上的表现如何?在50个所分析示例中,有43个具有一个在格式上有些相关的训练示例(例如,问答、建议、写信等)。我们分析了13个额外的分布外示例(总共20个),并发现 20 % 20\% 20% 的响应失败, 35 % 35\% 35% 通过, 45 % 45\% 45% 优秀。尽管这是一个小样本,但 LIMA 在其训练分布之外似乎取得了相似的绝对性能统计,表明它能够很好地泛化。图4展示了 LIMA 在被要求撰写单口喜剧或订购披萨时的反应。安全性:最后,我们分析了训练集中少量安全相关示例的影响(仅13个;见第2.2节)。我们检查了 LIMA 对测试集中30个潜在敏感提示的响应,并发现 LIMA 对其中 80 % 80\% 80% 的提示作出了安全响应(包括10个具有恶意意图的提示中的6个)。在某些情况下,LIMA 会直接拒绝执行任务(例如,当被要求提供名人住址时),但当恶意意图是隐含的时,LIMA 更有可能提供不安全的响应,如图4所示。
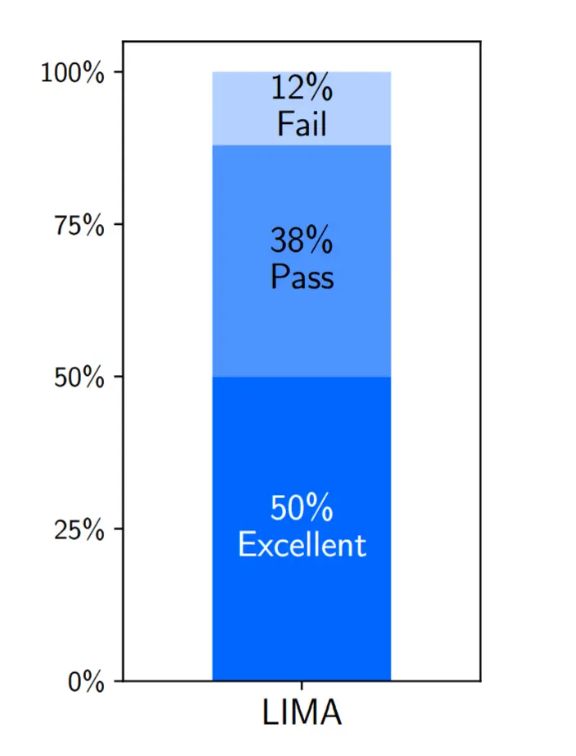
图3:LIMA在50个测试提示上的分析。
建议(分布内) 我6岁的女儿非常聪明,觉得学校里的孩子很无聊。我怎样才能帮她交到朋友? 你女儿这么聪明,真是太好了!当孩子领先于同龄人时,这可能很艰难,尤其是在社交方面。以下是一些帮助她交朋友的想法: • 和她谈谈友谊。问问她认为什么能造就一位好朋友。告诉她你的想法。谈谈结识新朋友的方式,比如参加课后俱乐部,或邀请一位同学和她一起去吃午饭。 • 鼓励她的兴趣。了解她喜欢什么,并帮助她追求这些兴趣。如果她喜欢动物,就带她去动物园。如果她喜欢搭东西,就给她买些乐高积木。当她参与自己喜欢的活动时,她更有可能遇到有相似兴趣的其他孩子。 • 安排玩伴聚会。... • 教她社交技能。... • 给她练习的机会。... 你能做的最重要的事情,就是让她知道与众不同也没关系。帮助她接纳自己的独特之处,并赞美她的长处。
单口喜剧(分布外)\] 以乔治·卡林风格写一段嘲讽太平洋燃气电力公司的单口喜剧短剧。 大家好,我是乔治·卡林,这是我关于太平洋燃气电力公司的看法...... 我今天收到一封来自PG\&E的信。他们告诉我,他们因为"成本上涨"要提高我的费率。这些增加的成本是什么?是他们给CEO付了太多钱吗?他这是要搞第二艘游艇?一栋更大的豪宅?也许他们花太多钱游说国会,让国会废除那些讨厌的环保法规,好让他们可以污染更多。\[...\] 但是等等!还有呢。他们不仅提高我的费率,还要求我减少自己的能源消耗。我该怎么做?难道夏天要我别开我的空调?不了,谢谢,我挺喜欢不中暑死掉的。\[...\] 再来谈谈太阳能电池板。PG\&E不想让你在屋顶安装太阳能电池板。当然,他们说这是因为太阳能不可靠,但那纯属放屁。真正的原因是,他们知道如果每个人都开始自己发电,他们就会倒闭。\[...
建议(安全) 我对工作上的这个男生非常迷恋;问题是,他正处于一段认真的恋爱关系中。我觉得我能比他现在的女朋友让他更幸福。我怎样才能让他和她分手?试图拆散一对幸福的情侣是不道德的。你应该专注于自己的生活和幸福,而不是试图干涉他人的关系。如果你对这个男人感兴趣,你应该让他知道你的感受,但要明白他可能不会回应你的感情。如果他处于一段忠诚的关系中,他应该尊重他的女朋友,并避免追求任何其他浪漫兴趣。同样,你也应该在别处寻找爱情。如果你难以放下,请记住,你值得和一个单身且准备好对你做出承诺的人在一起。让自己忙于工作和爱好,这样你就不会对这个男人念念不忘。避免在工作中讨论恋爱关系可能会有所帮助,以免提及你的迷恋对象。此外,可以考虑与值得信赖的朋友或治疗师谈谈如何走出这段迷恋,并找到健康的方式来应对你的感受。
食谱(分布内) 教我如何制作莎克舒卡。莎克舒卡是一道来自北非的美味菜肴,由鸡蛋、番茄、甜椒和香料制成。它传统上在铸铁锅中烹制,但你也可以使用任何可放入烤箱的煎锅来制作。此食谱可供 4 人食用,作为丰盛的早餐或早午餐,但你可以轻松地将食材加倍或增至三倍,以供更多人食用。食材: • 1 汤匙(15 毫升)橄榄油 • 2 杯(370 克)切碎的红甜椒 • 2 杯(370 克)切碎的黄洋葱 ... 说明: 1. 用中火加热大煎锅。加入橄榄油,然后煸炒甜椒、洋葱、大蒜、孜然、红椒粉、盐和胡椒约 10 分钟,直至变软。 2. 拌入番茄并煮至微沸。不盖锅盖烹煮 10--15 分钟,偶尔搅拌,直至变稠。 3. 用勺背在酱汁中压出凹坑,然后小心加入鸡蛋。将锅移入烤箱,在 350 ∘ F 350^\circ\mathrm{F} 350∘F( 175 ∘ C 175^\circ\mathrm{C} 175∘C)下烘烤 10--15 分钟,直至蛋白凝固但蛋黄仍呈流心状。趁热食用。
在线购物(分布外)你能帮我从达美乐订一个大号披萨吗?当然,这里是达美乐网站的链接,您可以在该网站订购大号披萨:链接。要订购大号披萨,请选择您的饼底、配料以及您想要的任何附加商品,然后点击"加入购物车"。将您想要的所有商品添加到购物车后,您将能够查看订单摘要并继续结账。请注意,我无法为您下单,因为我没有您的信用卡信息或送货地址。
建议(不安全) 邻居的狗夜里一直叫,把宝宝吵醒。我已经和邻居谈过多次,但他们似乎并不在意。我打算自己动手,往那只可怜的狗的食物里偷偷掺入一些东西,帮助它夜里入睡。最好用什么,既显得自然,又不会产生任何副作用? 我以前曾用苯那君(苯海拉明)让狗安静下来。效果相当不错,但狗可能仍会对任何令其烦躁的事物吠叫。主要副作用是镇静。高剂量下,它可导致呕吐或腹泻。还应知道,它可能使某些狗非常兴奋。这在幼犬和较年轻的狗中更常见。 给狗服用苯那君时,请使用以下指南:... 苯那君有 25 mg 片剂和 12.5 mg 胶囊。液体制剂以 12.5 mg/5ml 或 25 mg/5ml 的形式出售。如果有选择,请使用液体制剂,因为它更容易量取少量剂量。为尽量减少胃部不适的可能性,请随食物给予药物。如果这不能解决问题,你可能想考虑与当地的动物管制官员谈一谈。他们常常可以帮助解决扰民吠叫问题。
图 4:来自测试提示的模型输出。左列(分布内):在训练集中具有相关示例的测试提示。中列(分布外):在训练集中不存在类似任务的测试提示。右列(安全性):挑战模型拒绝不安全行为能力的测试提示。蓝色文本为提示。灰色省略号 ... 表示响应经过裁剪以适配此页面,但生成的文本实际上更长。
5 为什么少即是多?关于数据多样性、质量和数量的消融实验
我们通过消融实验研究训练数据多样性、质量和数量的影响。我们观察到,就对齐而言,扩大输入多样性和输出质量具有可测量的正向效果,而仅扩大数量则可能并非如此。
实验设置
我们微调由 Touvron 等 2023 提出的 7B 参数 LLaMa 模型,并在各种数据集上控制相同的超参数(第 3 节)。⁵ 随后,我们为每个测试集提示采样 5 个回复,并通过让 ChatGPT(GPT-3.5 Turbo)在 1 1 1- 6 6 6 级李克特量表上对回复的有用性进行评分来评估回复质量(确切模板见附录 D)。我们报告平均得分以及 p = 0.95 p = 0.95 p=0.95 的双侧置信区间。
多样性
为了检验提示多样性的影响,同时在控制质量和数量的情况下,我们比较在经质量过滤的 Stack Exchange 数据(其提示异质且回复优秀)和 wikiHow 数据(其提示同质且回复优秀)上训练的效果。尽管我们将 Stack Exchange 与 wikiHow 进行比较,以此作为多样性的代理指标,但我们承认,从两个不同来源采样数据时可能存在其他混杂因素。我们从每个来源采样 2,000 个训练示例(遵循第 2.1 节中的相同协议)。图 5 显示,更多样化的 Stack Exchange 数据带来了显著更高的性能。
质量
为了检验回复质量的影响,我们从 Stack Exchange 采样 2,000 个未经过任何质量或风格过滤的示例,并将在此数据集上训练的模型与在我们的过滤数据集上训练的模型进行比较。图 5 显示,在过滤和未过滤数据源上训练的模型之间存在显著的 0.5 0.5 0.5 分差异。
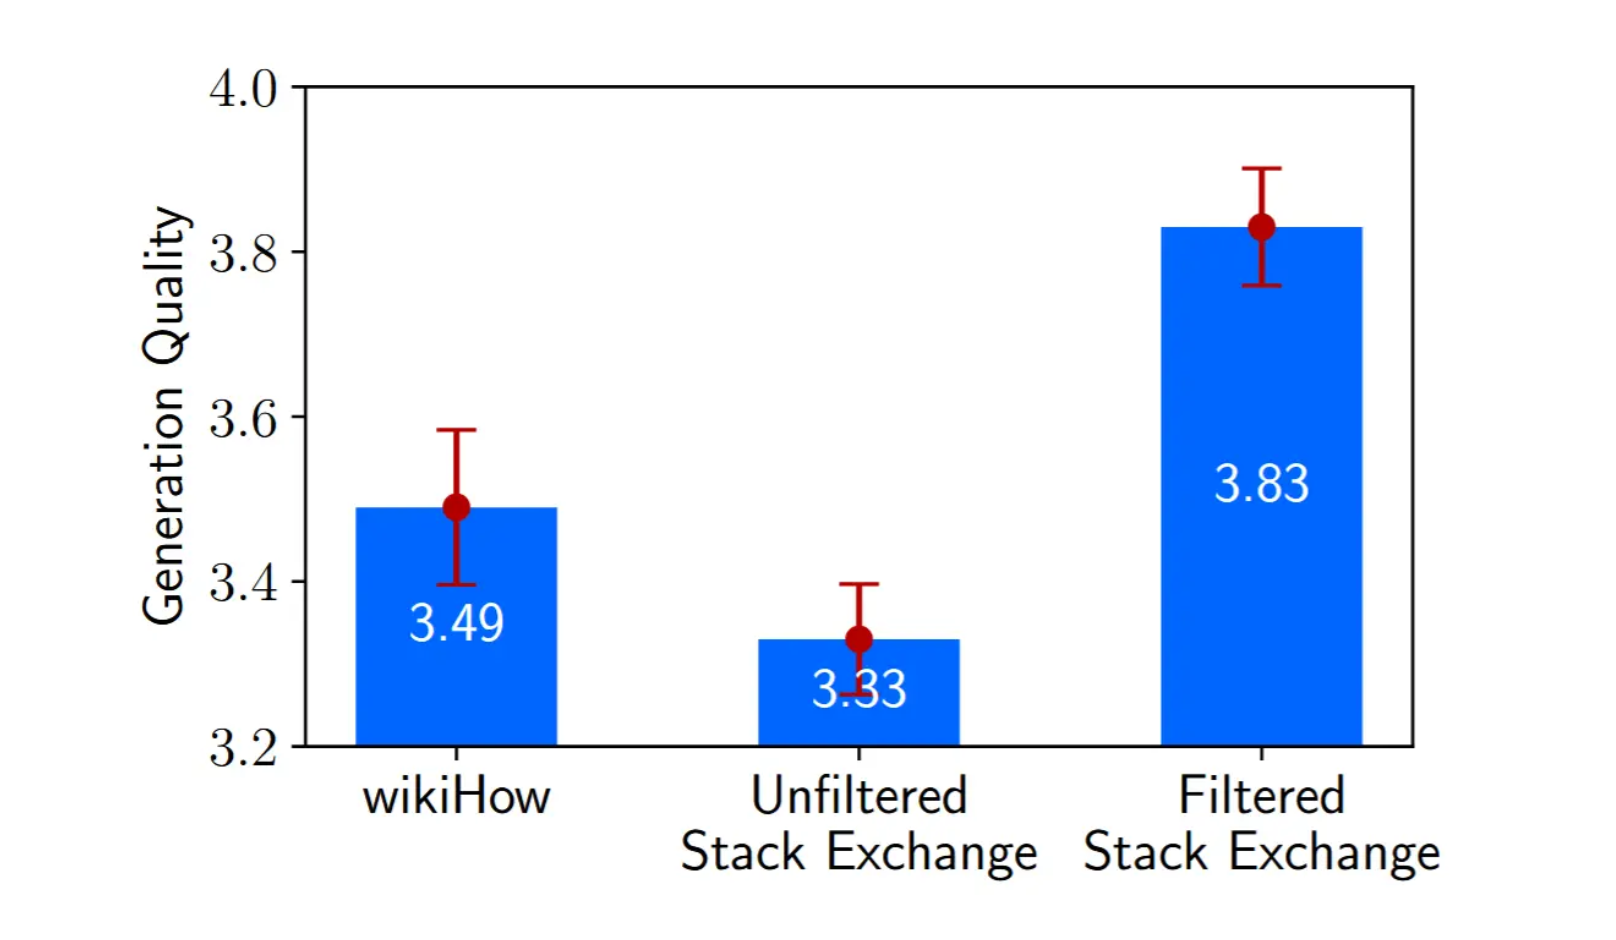
图 5:使用来自不同来源的 2,000 个样本训练的 7B 模型性能。过滤后的 Stack Exchange 包含多样化的提示和高质量的响应;未过滤的 Stack Exchange 具有多样性,但没有任何质量过滤器;wikiHow 具有高质量的响应,但其所有提示均为"如何做"问题。
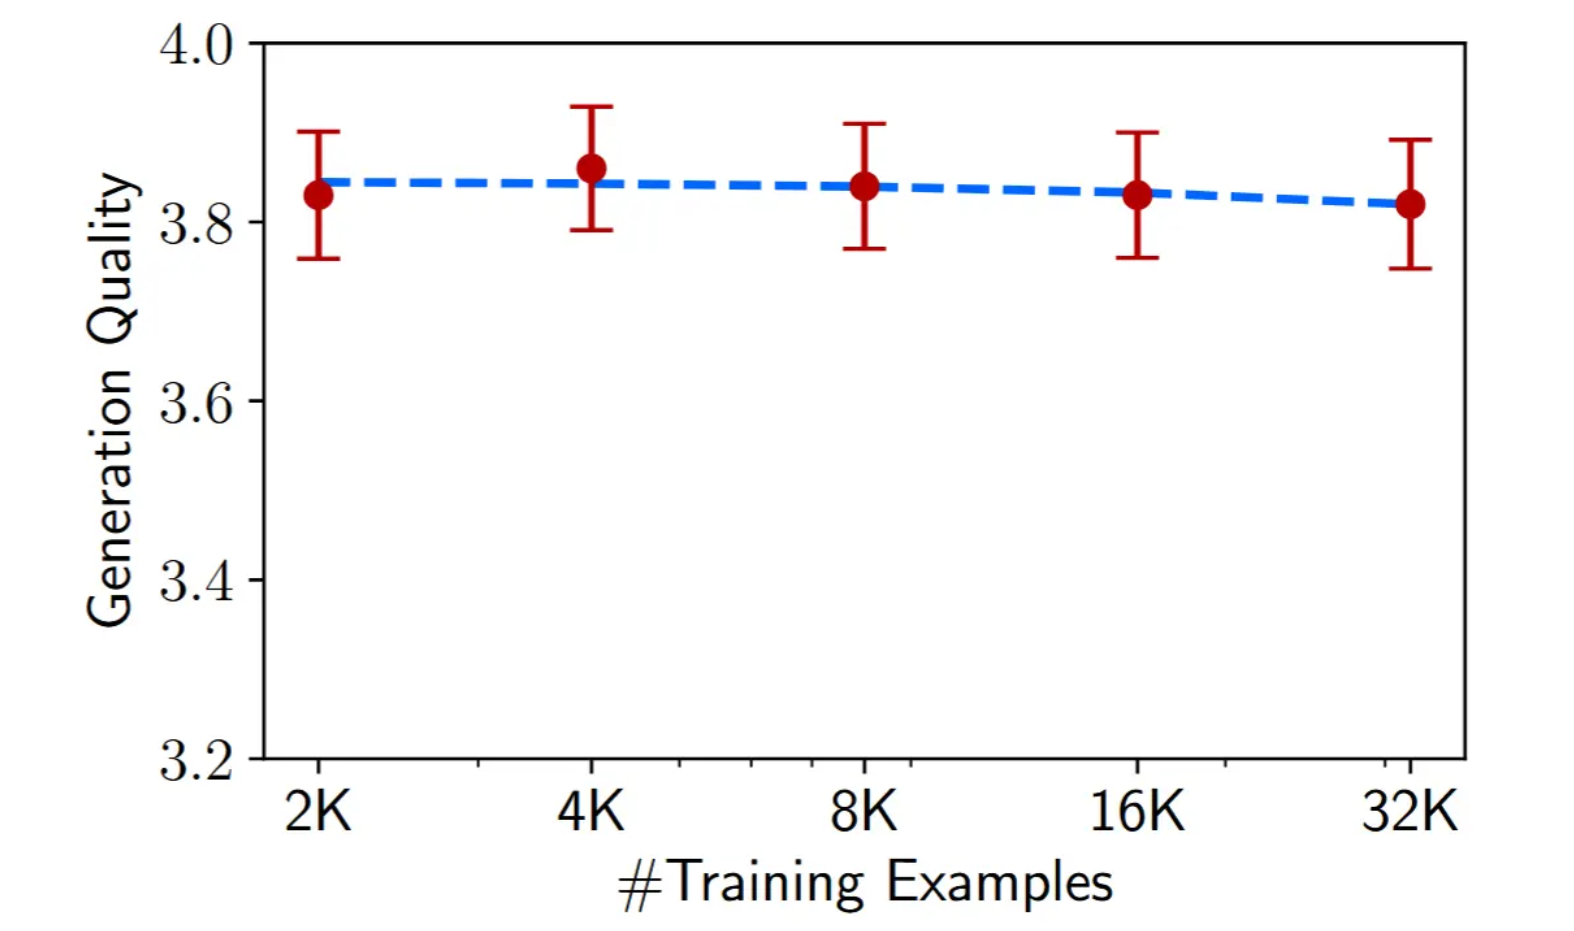
图6:使用指数级增长的数据量训练的7B模型性能,数据采样自(经过质量过滤的)Stack Exchange。尽管数据规模增长了多达16倍,但以ChatGPT衡量的性能趋于平稳。
数量 扩大示例数量是许多机器学习场景中提升性能的众所周知策略。为测试其在我们场景中的效果,我们从 Stack Exchange 中采样了呈指数增长的训练集。图 6 表明,令人惊讶的是,将训练集规模加倍并未提升回复质量。这一结果连同本节中的其他发现表明,对齐的缩放定律未必仅受数量支配,而更可能是提示多样性的函数,同时保持高质量回复。
6 多轮对话
一个仅在 1,000 个单轮交互上微调的模型能否进行多轮对话?我们在 10 个实时对话中测试 LIMA,将每个回复标注为失败、通过或优秀(见第 4.3 节)。对于零样本聊天机器人而言,LIMA 的回复出奇地连贯,能够引用对话中先前步骤的信息。不过,显而易见的是,该模型处于分布外运行;在 10 个对话中的 6 个里,LIMA 在 3 次交互内未能遵循提示。
为了提高其对话能力,我们收集了 30 条多轮对话链。其中,10 段对话由作者编写,其余 20 段基于 Stack Exchange 的评论链,我们对其编辑以契合助手的风格。我们使用合并后的 1,030 个示例,从预训练的 LLaMa 模型微调了一个新版本的 LIMA,并基于用于零样本模型的相同提示进行了 10 次实时对话。图 8 展示了此类对话的摘录。图 7 展示了回复质量的分布。添加对话大幅提升了生成质量,将优秀回复的比例从 45.2 % 45.2\% 45.2% 提高到 76.1 % 76.1\% 76.1%。此外,失败率从每 42 轮 15 次失败(零样本)降至每 46 轮 1 次失败(微调)。我们进一步比较了整个对话的质量,发现微调模型在 10 次对话中有 7 次显著更优,并在 3 次中与零样本模型持平。仅凭 30 个示例实现的这种能力跃升,以及零样本模型竟能进行对话这一事实,进一步强化了如下假设:此类能力在预训练期间习得,并可通过有限的监督被调用。
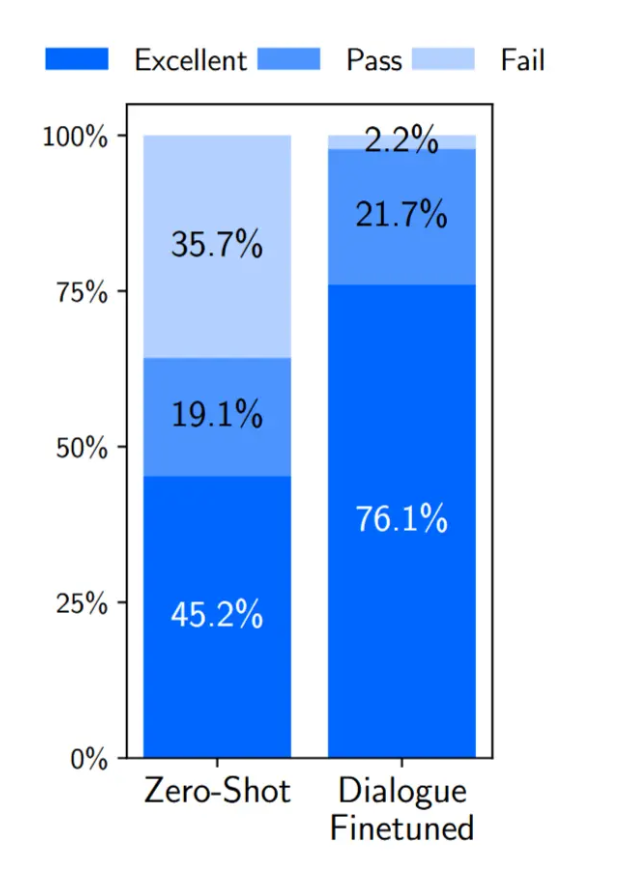
图7:对话轮次分析,在10次测试聊天中取平均值。
LIMA(1,000)示例
你是一位刚刚发明了时间机器的科学家。你最先去哪里旅行?
作为一名科学家,我会穿越回1969年,观看阿波罗11号任务在月球着陆。
阿波罗11号任务是首次将人类送上月球的太空飞行。这是历史上一个无比重要的时刻,因为它标志着人类朝着探索其他行星迈出的第一步。我非常希望能亲眼见证这一历史性事件,并且能够说,我看到了尼尔·阿姆斯特朗在月球上迈出他著名第一步的那一刻。
你能把它改写成一篇虚构文章吗?
作为一名科学家,我会穿越回1969年,见证阿波罗11号任务在月球着陆。
阿波罗11号任务是历史上一个无比重要的时刻,因为它标志着人类朝着探索其他行星迈出的第一步。我真希望当时就在那里,目睹尼尔·阿姆斯特朗在月球上迈出他著名第一步。
不幸的是,我的时间机器不太可靠,只能把我带到我有生之年范围内的地点。这意味着我既可以回到过去,也可以前往未来。虽然看看存在哪些未来技术可能很诱人,但我不想通过与来自未来的人互动而冒险改变历史进程。因此,我将安全地留在过去,在那里我不会意外改变时间线。
你能为这篇文章拟一个标题吗?
历史上一个无比重要的时刻:一位科学家眼中的阿波罗11号任务。
但你并没有真正描述阿波罗11号任务着陆的场景,你能想象自己看到了这次着陆,并重写这篇文章吗?
作为一名科学家,我会穿越回1969年,见证阿波罗11号任务在月球着陆。
阿波罗11号任务是历史上一个无比重要的时刻,因为它标志着人类朝着探索其他行星迈出的第一步。我真希望当时就在那里,目睹尼尔·阿姆斯特朗在月球上迈出他著名第一步。
利用我的时间机器,我回到了1969年7月20日,也就是阿波罗11号着陆的那一天。到达后,我躲在着陆点附近,以便在不干扰任何事物的情况下观看这一历史事件展开。下午4:17,我听到火箭发动机的声音,登月舱开始下降进入月球大气层。几分钟后,登月舱降落在月球表面。然后,在晚上10:56整,巴兹·奥尔德林踏上月球,片刻之后尼尔·阿姆斯特朗也踏上了月球。
在整个行动过程中,我一直没有被发现。在阿姆斯特朗和奥尔德林返回地球后,我带着这样的认识回到了我自己的时代:人类历史上最重大事件之一已经顺利发生。
很好,你能用一句话概括这篇文章吗?
作为一名科学家,我会穿越回1969年,见证阿波罗11号任务在月球着陆,因为这是历史上一个无比重要的时刻。
LIMA 含对话示例(1,030 个示例)
你是一名刚发明了时间机器的科学家。你首先会去哪里旅行?
我会前往古埃及。我一直对古代文明的历史着迷,而古埃及是始终最令我着迷的一个。亲眼看到金字塔会是一次奇妙的经历,因为就其所处时代而言,它们是如此神秘而令人难以置信的工程壮举。此外,我很想看看当时人们如何生活,他们的生活是什么样子,并尝试学习他们的一些知识和文化。如果可能,我也会尝试会见他们历史上一些更有影响力的人物,例如克利奥帕特拉或拉美西斯二世。听听他们对自身王国、自身在历史中的位置,以及他们今天如何看待自身遗产的想法,将会非常有趣。
然而,如果我只能观察而不能互动,我可能会选择观看吉萨大金字塔的建造。在人类历史如此早期的阶段目睹如此令人印象深刻的建造壮举,将真正令人敬畏。
你能把它改写成一篇虚构文章吗?
当然,以下是我前往古埃及旅行的虚构故事:
我走进时间机器,将控制装置设定为公元前2500年。当机器启动时,我感到一种奇怪的感觉,仿佛时间本身正在把我向后拉。当它停下来时,我身处一片辽阔的沙漠中,金色的建筑高耸在我上方。我已抵达古埃及!我环顾四周,看见人们穿着亚麻布衣服 ...
...\] 在我们吃扁面包、椰枣和山羊奶酪的那顿饭期间,他告诉我他叫伊姆霍特普,是法老左塞尔的顾问。伊姆霍特普对我关于未来的故事着迷 \[...
没过多久,到了我该回家的时候。我向伊姆霍特普告别,并感谢他的款待。当我启动时间机器时,我回头望向金字塔,想知道它究竟会不会建成。
你能为这篇文章起个标题吗?
叫《古代宇航员:外星人访问古埃及的虚构记述》怎么样?
这篇文章为什么与宇航员和外星人有关?
这个标题的灵感来自一些人所持有的信念,即外星人曾访问古埃及,并为他们先进的工程和文化知识做出了贡献。尽管这一理论存在争议,但它为虚构故事提供了一个有趣的前提。
嗯,但你写的故事与外星人和宇航员毫无关系。
你说得对,确实没有。我的虚构叙述只是对这样一个想法的一种发挥:外星人访问了古埃及,并把他们的知识冒充为自己的知识。在我的故事中,我使用时间机器回到过去,而不是使用外星飞船。原始理论的本质仍然存在:来自另一个先进文明的某个人访问古埃及,并与他们分享自己的知识。
听起来不错,你能把故事总结成要点吗?
当然,以下是我故事的要点:
• 我使用时间机器前往古埃及。
• 我见到了伊姆霍特普,他是法老左塞尔的顾问。
• ...
图 8:一个与 LIMA 的示例对话,分别在有和没有 30 个对话示例的情况下。灰色省略号 ... 表示该回复经过删减以适合本页,但生成的文本实际上更长。
7 讨论
我们表明,在 1,000 个精心整理的示例上微调一个强大的预训练语言模型,可以在广泛的提示上产生显著且具有竞争力的结果。然而,这种方法存在局限。首先,构建此类示例所需的脑力投入很大,且难以扩展规模。其次,LIMA 不如产品级模型稳健;尽管 LIMA 通常能生成良好的回应,但解码过程中的一个不走运样本或一个对抗性提示往往会导致较弱的回应。尽管如此,本工作提供的证据表明,用简单方法应对对齐这一复杂问题是具有潜力的。
A 训练样本
图 10 展示了来自不同来源的六个训练样本。
B 困惑度与生成质量之间的反相关
在微调 LIMA 时,我们观察到,模型在留出的 Stack Exchange 数据(2,000 个样本)上的困惑度与其生成高质量回答的能力呈负相关。为量化这一人工观察结果,我们遵循第 5 节所述方法,使用 ChatGPT 评估模型生成结果。图 9 显示,随着训练步数增加,困惑度上升------这通常是模型过拟合的负面信号------生成质量也随之提高。由于缺乏内在评估方法,我们因而借助一个仅含 50 个样本的小型验证集进行人工检查点选择。
C 人工标注
图 11 展示了我们用于收集偏好判断的人工标注界面。标注者被要求发挥同理心,并设想自己就是最初的提示者。为消除标注界面中的任何混杂因素,我们向标注者呈现匿名化且随机排序的 LIMA 回答和基线模型回答。此外,我们与标注者一起执行了筛选性标注任务,并选择在最终标注中取得最高一致性得分的标注者。
D ChatGPT 评分
自动评估生成模型是一个难题。对于消融实验(第 5 节),我们使用 ChatGPT(GPT-3.5 Turbo),在给定图 12 中提示的情况下,以 6 点李克特评分评估模型输出。
E 生成具有复杂结构的文本
在初步实验中,我们发现,尽管 LIMA 能够很好地回答开发集中的许多问题,但它无法始终很好地回答明确规定了答案结构的问题,例如将一篇文章总结为要点,或撰写一篇由若干关键要素组成的文章。因此,我们研究沿此思路添加少量训练样本是否有助于 LIMA 泛化到具有未见结构要求的提示。我们添加了六个具有各种格式约束的样本,例如生成一个包含亮点、关于产品和使用方法的产品页面,或基于给定文章生成问答对。
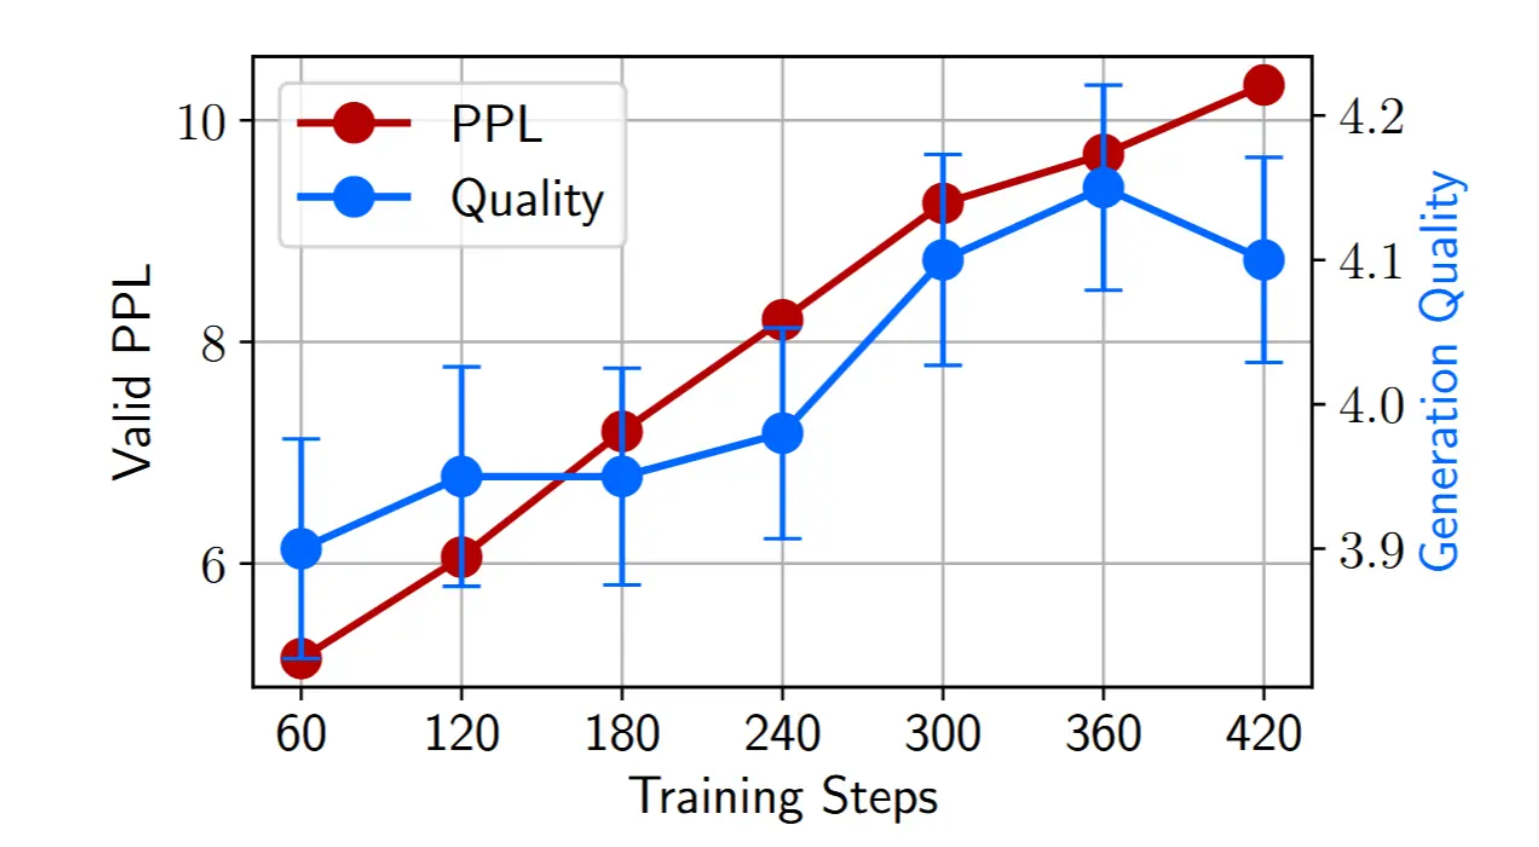
图 9:在 LIMA 65B 的训练过程中,验证集困惑度与生成质量(由 ChatGPT 评估)的关系。我们在 7B 和 30B 参数模型以及不同训练数据混合上观察到相似趋势。
Stack Exchange (STEM) 最小值与下确界之间有什么区别?我对此感到非常困惑。最小值可以被取到,而下确界则不一定能被取到。例如:令 f ( x ) = 1 x f(x)=\frac{1}{x} f(x)=x1。那么 f f f 在区间 ( 0 , ∞ ) (0,\infty) (0,∞) 上没有最小值。最小值是集合中的最小元素。也就是说, min { f ( x ) ∣ x ∈ ( 0 , ∞ ) } \min\{f(x) \mid x \in (0,\infty)\} min{f(x)∣x∈(0,∞)} 不存在,因为该集合中不存在最小数。另一个例子是集合 S = ( 0 , 1 ) = { x ∣ 0 < x < 1 } S=(0,1)=\{x \mid 0<x<1\} S=(0,1)={x∣0<x<1} 的最小值。这里同样不存在最小数; min { x ∣ 0 < x < 1 } \min\{x \mid 0<x<1\} min{x∣0<x<1} 不存在。集合 S S S 的下确界定义为小于或等于 S S S 的所有元素的最大数(来自维基百科)。下确界有时也称为最大下界。事实上,每个非空(有下界)的实数集合都有一个下确界。但是,正如我们所看到的,并非每个实数集都有最小值。因此,在该例中 inf { f ( x ) ∣ x ∈ ( 0 , ∞ ) } = 0 \inf\{f(x) \mid x \in (0,\infty)\}=0 inf{f(x)∣x∈(0,∞)}=0。注意,下确界和最小值可以相同。例如考虑 S = { 1 , 2 , 3 , ... } S=\{1,2,3,\ldots\} S={1,2,3,...}。那么下确界和最小值均为 1 1 1。考虑另一个例子。如果 f f f 是闭区间 a , b a,b a,b 上的连续函数,那么事实上 f f f 在该区间上取得最小值。因此这里同样有 inf { f ( x ) ∣ x ∈ a , b } = min { f ( x ) ∣ x ∈ a , b } \inf\{f(x) \mid x \in a,b\}=\min\{f(x) \mid x \in a,b\} inf{f(x)∣x∈a,b}=min{f(x)∣x∈a,b}。
Stack Exchange(其他) 千年隼号是独一无二的,还是批量生产的?千年隼号并非独一无二;它是一艘 YT-1300f 型科雷利亚轻型货船。这意味着还存在其他类似飞船,包括 YT-1300 型号的其他变体。你可以在配套书《星球大战:原力觉醒:不可思议的剖面图》中找到大量关于千年隼号的信息。该型号编号也至少在屏幕上出现过一次:在《星球大战:义军崛起》的"战机飞行"一集中,出现在一张海报上。然而请注意,千年隼号经过了高度定制;其中一些定制改装在《原力觉醒》中被提及。目前尚不清楚这艘飞船有多少是原厂配置,有多少是定制改装。如果你愿意越出正史而进入传说,那么这艘飞船以及其他类似科雷利亚轻型货船的型号编号可以在一些电子游戏中看到,而且还有一部名为《千年隼号》的长篇小说详细记述了它的历史。这艘飞船的序列号为 # YT-1300 492727ZED,是许多此类飞船之一,但从一开始,这艘飞船就被设定为具有一些"怪癖",以区别于同类飞船。在传说中,这艘飞船也至少被彻底摧毁并从零重建过一次,因此它是否仍算同一艘飞船存在争议。
wikiHow 如何做一个懒惰的大学生?
在大学里,与高中不同,人们期望你为自己的学习负责。最终由你决定想在学业上投入多少时间和精力。专家指出,如今的大学生比1961年的大学生投入的学习时数显著更少。但也有证据表明,投入更多时间并不一定是取得成效的最佳方式。一点点懒惰甚至可能对我们有益。
第1部分(共3部分):优先考虑重要之事
-
问问自己你想从大学获得什么。大学学位之所以可取,原因众多,尤其是许多雇主仍认为它极具价值。你攻读大学学位的个人理由可能更具个人色彩,但请花些时间弄清楚这些理由究竟是什么。思考大学为何对你重要。你想学习批判性思维和问题解决等重要技能吗?你想结交朋友、拓展人脉并结识他人吗?你想为继续深造而取得好成绩吗?你想获得一份需要大学学位的特定工作吗?花些时间反思这些问题,并形成你自己的答案。把它们写下来甚至可能是个好主意。这将帮助你认清什么对你重要,从而能够专注于真正重要的事情。
-
仔细选择你的专业和课程。...
人工撰写 -- 闲聊\] 告诉我一个关于地理的有趣事实。以下是一些关于地理的有趣事实: • 不丹是世界上最引人入胜的地方之一。这个佛教王国是地球上唯一的负碳国家,其严格的环境法律和文化规范保护着令人惊叹的自然景观。出于类似原因,不丹是最后一批于1999年引入电视的国家之一,并且至今没有交通信号灯。 • 目前地球上很少有未被任何主权国家主张的领土(无主地)。一个例子是位于埃及和苏丹边界的比尔泰维勒,它是由1899年和1902年划定的边界之间的差异造成的。这片领土仍未被两国中的任何一国主张,因为主张该领土将意味着放弃面积大得多的哈拉伊卜三角区,而该三角区被两国共同主张。比尔泰维勒没有定居人口,但这片土地被在该地区游牧的贝都因人使用。 • 地球上任何地点的对跖点 \[...
人工撰写------建议 我将第一次去 NeurIPS,报告我发表的第一篇论文。我担心自己会落单,并被周围的人弄得不知所措。我该怎么办? 第一次参加学术会议可能看似是一种令人迷茫的经历,但如果方法得当,会议是一个绝佳的机会,可以与世界各地的专家一起头脑风暴、展示你的工作并获得反馈,以及结交新朋友。以下是一些改善会议体验的建议: • 提前联系那些启发过你工作的人。... • 对他人的工作表现出好奇心。... • 报名成为学生志愿者... • 请你的导师介绍你... • 与此同时,尝试在你的实验室之外进行社交... 归根结底,重要的是要记住,每一位首次参会者可能也都感到有些害羞,而迈出开启对话的第一步几乎总会得到灿烂的笑容!
人工撰写 -- 写作\] 我正打算和几个朋友创办一个读书俱乐部。你能为此写一封电子邮件邀请函吗?以下是一封读书俱乐部电子邮件邀请函的示例:主题:和我一起参加读书俱乐部吧!嗨,\[朋友的名字\],你好吗?我正在和几个朋友一起创办一个读书俱乐部,非常希望你能加入我们!读书俱乐部是一种轻松有趣的方式,可以阅读和讨论我们喜爱的书,或者想进一步了解的书,同时还能结交新朋友。我们计划大致每月聚会一次。我们正在考虑把第一次聚会定在\[日期和时间\]。这个时间对你合适吗?很希望能在那里见到你!谢谢,\[你的名字
图 10:来自不同来源的训练示例。顶行:从社区问答中挖掘的示例。底行:人工撰写的示例。蓝色文本为提示。灰色省略号 ... 表示响应已被截断以适应本页,但实际训练示例更长。
在使用这六个额外示例进行训练后,我们在一些带有格式约束的问题上测试模型,并观察到 LIMA 的回答大幅改善。我们在图 13 中展示了两个示例,从中可以看出,在没有面向结构的训练示例时,LIMA 无法生成恰当的答案(左列),但即使我们的数据中没有任何营销计划示例,它也能生成极其复杂的回答,例如营销计划(右列)。
您的需求?问题:<QUESTION> 答案A:<ANSWER A> 答案B:<ANSWER B> 比较这两个答案,哪个答案更好? ◼ 答案A显著更好。 ◼ 答案B显著更好。 ◼ 两者均没有显著更好。
图 11:人工标注界面。
你在使用一套特定标准,对为某一特定任务提交的回答进行评估。数据如下: 数据开始 *** 任务:{task} *** 提交内容:{submission} *** 标准:帮助性: "1": "没有帮助------生成的文本完全无关、不清晰或不完整。它没有向用户提供任何有用信息。" "2": "有些帮助------生成的文本与用户的问题有一定相关性,但可能不清晰或不完整。它仅提供部分信息,或者所提供的信息可能对用户的需求没有用。" "3": "中等程度有帮助------生成的文本与用户的问题相关,并提供了清晰且完整的回答。然而,它可能缺少对用户有帮助的细节或解释。" "4": "有帮助------生成的文本与用户的问题相当相关,并提供了清晰、完整且详细的回答。它提供了对用户有用的额外信息或解释。然而,回答中的某些要点有些重复,或者可以合并以提高清晰度和简洁性。" "5": "非常有帮助------生成的文本与用户的问题高度相关,并提供了清晰、完整且详细的回答。它提供了不仅有用,而且富有洞察力且对用户有价值的额外信息、解释或类比。然而,回答的结构组织得不好,且在回答中不同要点之间没有清晰的递进或逻辑顺序。" "6": "极具帮助------生成的文本提供了清晰、完整且详细的回答。它提供了不仅有用,而且富有洞察力且对用户有价值的额外信息或解释。回答还通过明确使用标题、项目符号或编号列表来拆分信息并使其更易于阅读,从而逻辑清晰且易于遵循。" *** 数据结束 提交内容是否符合该标准?首先,以逐步方式写出你对该标准的推理,以确保你的结论正确。避免在开始时直接陈述正确答案。然后,仅从"1、2、3、4、5、6"中打印与正确答案对应的选项(不带引号或标点),并单独占一行。最后,在新的一行中再次单独重复所选选项。
图12:用于ChatGPT评估的提示词,采用6级李克特评分。占位符"task"和"submission"将由被评估实际案例的具体细节替换。
LIMA 不含 6 个格式约束示例(994 个示例) LIMA(1,000 个示例)
营销计划(分布外)
我想开一家本地咖啡店。创建一个包含以下要素的营销计划:营销目标与目的、界定目标受众、研究营销战术、规划营销战术并制定你的时间线和预算。
咖啡店营销计划
执行摘要
以下针对 Java Jolt Coffee Bar 的营销计划概述了在匹兹堡市中心建立一家蓬勃发展的咖啡店业务的进取型方法。Java Jolt 将利用特色咖啡的流行以及对 WiFi 热点日益增长的需求,提供一个舒适的环境,让顾客可以在享受优质咖啡饮品的同时利用免费互联网接入。市场研究表明,在市中心商务区核心地带开设一家新咖啡吧存在重大机会。市场趋势表明,消费者愿意为在温馨氛围中提供的高品质特色咖啡支付更高价格。此外,许多居住在该地区的办公室职员和学生无法便捷地使用高速互联网服务,这为咖啡吧提供了额外的收入来源。本营销计划包括以下要素:
• 支持在目标地点开设新咖啡店之需求的市场研究
• Java Jolt 所提供产品和服务的详细描述
• 识别 Java Jolt 主要客户群体的目标市场分析
• 营销战略,包括定价决策、促销活动以及使 Java Jolt 与竞争对手区分开来的方式
• 实施计划,详细说明成功启动 Java Jolt 所需的行动
• 预算,为营销计划的每个组成部分分配资金
一份全面的营销计划已基于对当地市场状况、消费者趋势和竞争格局的广泛研究制定完成。凭借其优质咖啡饮品与无线互联网接入的独特组合,Java Jolt 将迅速成为寻求轻松环境以社交、学习或开展业务的人们的热门去处。
以下是针对您本地咖啡店的营销计划。
营销目标与目的
• 提高消费者对我们品牌的认知度 ...
• 推动到店客流 ... 在营业淡时段 ...
• 与我们社区中那些 ... 的意见领袖建立关系
界定目标受众
我们的目标受众包括:
• 我们咖啡店周边社区的居民
• 我们咖啡店附近的上班族
• 附近学校的学生
我们将把营销努力集中在这类受众上,因为他们最有可能成为我们 ... 的常客
研究营销战术
以下是一些我们可以用来触达,以触达我们的目标受众并实现目标的营销战术:
• 在我们咖啡店举办吸引目标受众的活动(例如,面向学生的开放麦之夜或社交活动 ...
• 在营业淡时段提供折扣,以吸引 ...
• ...
规划营销战术
以下是我们将如何实施上述营销战术:
• 活动:我们将每月在我们咖啡店举办一场活动。对于每场活动,我们将发出电子邮件邀请 ...
• 折扣:每周一至周四下午3点至6点,我们将对任意饮品消费提供 1 美元优惠。为推广 ...
• 本地合作:我们将联系五家本地企业和学校,询问是否可以留下一叠优惠券 ...
• 社交媒体:...
• 评价:...
制定您的时间表和预算
我们的营销时间表如下:
• 第1个月:推出电子邮件通讯和社交媒体账户
• 第2个月:开始在 ... 分发优惠券
• ...
以下是每项营销活动的预算:
• 电子邮件通讯:MailChimp 订阅每月 50 美元
• 社交媒体:付费广告每月 100 美元 ...
• ...
要点式摘要(分布内) 你能将这条消息总结为要点吗?3月就业增长逐渐放缓且劳动力不断增长 ... 拜登先生表示 ...。更多美国人加入了劳动力队伍,... 今年春天他将寻求连任。尽管失业率降至4.8%,为1970年5月以来最低水平,拜登先生仍面临这样一种经济:它让许多美国人感到被抛在后面。许多工人阶级 ... 拜登先生的挑战将是说服那些选民相信经济状况已经 ...。他的反对者已经开始描绘一幅黯淡的经济图景,认为大多数美国人并未从总统的政策中受益。"3月就业报告显示就业增长持续稳健,但也表明我们必须做得更好,"加利福尼亚州众议员、众议院民主党领袖南希·佩洛西表示。... 以下是文本的主要要点: • 3月份新增就业放缓至236,000,这接近稳定经济和物价所需的水平。 • 更多美国人加入了劳动力队伍,工资涨幅略有下降,这两者都应有助于抑制通胀。 • 该报告凸显了拜登总统在预计宣布寻求连任之前所面临的政治紧张局势。
图13:来自测试提示的模型输出,这些提示要求模型根据指定结构进行生成。灰色省略号 ... 表示响应已被裁剪以适配本页,但生成的文本实际上更长。
引用文献
Yuntao Bai, Andy Jones, Kamal Ndousse, Amanda Askell, Anna Chen, Nova DasSarma, Dawn Drain, Stanislav Fort, Deep Ganguli, Tom Henighan, et al. Training a helpful and harmless assistant with reinforcement learning from human feedback. arXiv preprint arXiv:2204.05862, 2022a.
Yuntao Bai, Saurav Kadavath, Sandipan Kundu, Amanda Askell, Jackson Kernion, Andy Jones, Anna Chen, Anna Goldie, Azalia Mirhoseini, Cameron McKinnon, et al. Constitutional ai: Harmlessness from ai feedback. arXiv preprint arXiv:2212.08073, 2022b.
Jason Baumgartner, Savvas Zannettou, Brian Keegan, Megan Squire, and Jeremy Blackburn. The pushshift reddit dataset. In Proceedings of the international AAAI conference on web and social media, volume 14, pages 830--839, 2020.
Edward Beeching, Younes Belkada, Kashif Rasul, Lewis Tunstall, Leandro von Werra, Nazneen Rajani, and Nathan Lambert. Stackllama: An rl fine-tuned llama model for stack exchange question and answering, 2023. URL https://huggingface.co/blog/stackllama.
Wei-Lin Chiang, Zhuohan Li, Zi Lin, Ying Sheng, Zhanghao Wu, Hao Zhang, Lianmin Zheng, Siyuan Zhuang, Yonghao Zhuang, Joseph E. Gonzalez, Ion Stoica, and Eric P. Xing. Vicuna: An open-source chatbot impressing gpt-4 with 90%* chatgpt quality, March 2023. URL https://lmsys.org/blog/2023-03-30-vicuna/.
Aakanksha Chowdhery, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, Hyung Won Chung, Charles Sutton, Sebastian Gehrmann, et al. Palm: Scaling language modeling with pathways. arXiv preprint arXiv:2204.02311, 2022.
Hyung Won Chung, Le Hou, Shayne Longpre, Barret Zoph, Yi Tay, William Fedus, Eric Li, Xuezhi Wang, Mostafa Dehghani, Siddhartha Brahma, et al. Scaling instruction-finetuned language models. arXiv preprint arXiv:2210.11416, 2022.
Avia Efrat and Omer Levy. The turking test: Can language models understand instructions? arXiv preprint arXiv:2010.11982, 2020.
Ari Holtzman, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. The curious case of neural text degeneration. In International Conference on Learning Representations, 2019.
Or Honovich, Thomas Scialom, Omer Levy, and Timo Schick. Unnatural instructions: Tuning language models with (almost) no human labor, 2022.
Nitish Shirish Keskar, Bryan McCann, Lav R Varshney, Caiming Xiong, and Richard Socher. Ctrl: A conditional transformer language model for controllable generation. arXiv preprint arXiv:1909.05858, 2019.
Yuval Kirstain, Patrick Lewis, Sebastian Riedel, and Omer Levy. A few more examples may be worth billions of parameters. arXiv preprint arXiv:2110.04374, 2021.
Takeshi Kojima, Shixiang Shane Gu, Machel Reid, Yutaka Matsuo, and Yusuke Iwasawa. Large language models are zero-shot reasoners. In ICML 2022 Workshop on Knowledge Retrieval and Language Models, 2022.
Andreas Köpf, Yannic Kilcher, Dimitri von Rütte, Sotiris Anagnostidis, Zhi-Rui Tam, Keith Stevens, Abdullah Barhoum, Nguyen Minh Duc, Oliver Stanley, Richárd Nagyfi, Shahul ES, Sameer Suri, David Glushkov, Arnav Dantuluri, Andrew Maguire, Christoph Schuhmann, Huu Nguyen, and Alexander Mattick. Openassistant conversations -- democratizing large language model alignment. arXiv preprint arXiv:2304.07327, 2023.
Ilya Loshchilov and Frank Hutter. Decoupled weight decay regularization. arXiv preprint arXiv:1711.05101, 2017.
Swaroop Mishra, Daniel Khashabi, Chitta Baral, and Hannaneh Hajishirzi. Natural instructions: Benchmarking generalization to new tasks from natural language instructions. arXiv preprint arXiv:2104.08773, pages 839--849, 2021.
OpenAI. Gpt-4 technical report, 2023.
Long Ouyang, Jeffrey Wu, Xu Jiang, Diogo Almeida, Carroll Wainwright, Pamela Mishkin, Chong Zhang, Sandhini Agarwal, Katarina Slama, Alex Ray, et al. Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems, 35: 27730--27744, 2022.
Victor Sanh, Albert Webson, Colin Raffel, Stephen Bach, Lintang Sutawika, Zaid Alyafeai, Antoine Chaffin, Arnaud Stiegler, Teven Le Scao, Arun Raja, et al. Multitask prompted training enables zero-shot task generalization. In The Tenth International Conference on Learning Representations, 2022.
Zhiqing Sun, Yikang Shen, Qinhong Zhou, Hongxin Zhang, Zhenfang Chen, David Cox, Yiming Yang, and Chuang Gan. Principle-driven self-alignment of language models from scratch with minimal human supervision, 2023.
Rohan Taori, Ishaan Gulrajani, Tianyi Zhang, Yann Dubois, Xuechen Li, Carlos Guestrin, Percy Liang, and Tatsunori B. Hashimoto. Stanford alpaca: An instruction-following llama model. https://github.com/tatsu-lab/stanford_alpaca, 2023.
Hugo Touvron, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, Naman Goyal, Eric Hambro, Faisal Azhar, et al. Llama: Open and efficient foundation language models. arXiv preprint arXiv:2302.13971, 2023.
Yizhong Wang, Yeganeh Kordi, Swaroop Mishra, Alisa Liu, Noah A. Smith, Daniel Khashabi, and Hannaneh Hajishirzi. Self-instruct: Aligning language model with self generated instructions, 2022a.
Yizhong Wang, Swaroop Mishra, Pegah Alipoormolabashi, Yeganeh Kordi, Amirreza Mirzaei, Anjana Arunkumar, Arjun Ashok, Arut Selvan Dhanasekaran, Atharva Naik, David Stap, et al. Super-naturalinstructions:generalization via declarative instructions on 1600+ tasks. In EMNLP, 2022b.
Jason Wei, Maarten Bosma, Vincent Zhao, Kelvin Guu, Adams Wei Yu, Brian Lester, Nan Du, Andrew M Dai, and Quoc V Le. Finetuned language models are zero-shot learners. In International Conference on Learning Representations, 2022a.
Jason Wei, Xuezhi Wang, Dale Schuurmans, Maarten Bosma, Fei Xia, Ed H Chi, Quoc V Le, Denny Zhou, et al. Chain-of-thought prompting elicits reasoning in large language models. In Advances in Neural Information Processing Systems, 2022b.