摘要 :模糊综合评价是一种基于模糊数学作为模型基础的评价方法。它用隶属度 刻画事物的中间状态,通过因素集、评语集、权重集和模糊评价等矩阵进行模糊合成,最终得到评价等级。本文梳理模糊数学基础、模糊综合评价建模流程、典型例题、优缺点以及多级模糊综合评价,并结合高校教师课堂教学质量案例进行说明。
关键词 :模糊综合评价 ;隶属度 ;扎德算子 ;层次分析法 ;数学建模 ;评价模型
1. 模糊数学概述
现实中的描述大致可以分为三类:
-
确定性描述:如"水加温到 100 度会烧开"。
-
随机性描述:如"掷骰子朝上或朝下"。
-
模糊性描述:如"今天天气很热"。
随机性和模糊性都属于"不确定性",但二者不同:
-
随机性:事件发生条件不确定,但事物本身的性态和类属是确定的。
-
模糊性:事物本身的性态和类属不确定,表现为"亦此亦彼"。
模糊性可以理解为:客观事物在中介过渡时体现出的"亦此亦彼"性。比如美丑、气味、色泽等,很难用绝对清晰的边界划分。
1965 年,美国加州伯克利教授 L.A.Zadeh(扎德) 发表《Fuzzy sets》,标志模糊数学诞生。其基本思想是:用"属于程度"代替"属于或不属于",从而刻画中介状态。
有观点认为数学发展经历了三个阶段:
-
经典数学:研究和处理精确的必然现象;
-
统计数学:研究和处理事物的偶然性、随机性;
-
模糊数学:研究和处理事物的模糊性。
2. 模糊理论核心概念
2.1 特征函数与隶属度
设 UU 为所论全集,A⊆U。经典集合的特征函数为:
但很多情况下,不能清晰界定 x 是否属于集合 A。此时需要定义"属于 A 的程度"。
由此得到隶属度定义:
设所论全集为 U,称映射
确定 U上的一个模糊子集 A。映射 ΨA 称为 A的隶属函数,简称隶属度。
2.2 常见隶属函数
常见类型包括:
偏小型
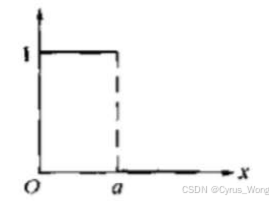
或线性偏小型:
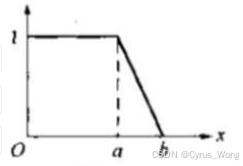
偏大型
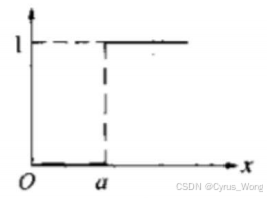
或线性偏大型:
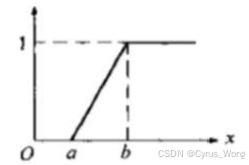
中间型
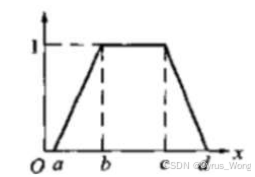
此外还有抛物线型、正态型等隶属函数。实际建模中可根据指标性质选择。
3. 模糊关系与模糊矩阵
3.1 模糊关系
设论域为 U 和 V,U×V上的模糊子集 R 的隶属函数为映射:
称 R 为 U 到 V 的模糊关系。
3.2 模糊矩阵
若对于任意 i=1,2,...,m,j=1,2,...,n,都有 rij∈0,1,则称矩阵
为模糊矩阵。
3.3 扎德算子
∀a,b∈0,1,定义 Zadeh 算子:
模糊矩阵运算:
,模糊矩阵的并
,模糊矩阵的交
,模糊矩阵的余
组合运算:
设 ,
,则
,即先取小,再取大。
例如:
则
并运算结果;交运算结果
;余运算结果
;组合运算结果
。
4. 模糊综合评价建模流程
模糊综合评价的核心是确定:
-
因素集:评价指标集合;
-
评语集:评价等级集合;
-
权重集:各指标的重要性权重;
-
评价矩阵:专家或调查得到的隶属度矩阵;
-
合成算子:常用扎德算子;
-
评价结果:模糊合成后归一化,按最大隶属度原则确定等级。
4.1 总流程
-
设定评价指标因素集 U;
-
设定评语集 V;
-
用民意测验或专家打分实施评价;
-
建立评价矩阵 R;
-
确定评价指标权重集 A;
-
按数学模型进行综合评价;
-
归一化处理,得出具有可比性的综合评价结果。
4.2 因素集
刻画被评价对象的 m 种因素,即评价指标。
4.3 评语集
刻画每个因素所处状态的 n种决断,即评价等级。
例如:
V={优秀,较好,一般,合格,差}
4.4 建立评价矩阵
针对单因素 ui,确定评价对象对评价等级 vj 的隶属度。
若对某一指标,22% 的人说"优秀",39% 说"较好",26% 说"一般",13% 说"合格",没有人说"差",则:
所有单因素评价结果组成评价矩阵:
一般做归一化处理:
4.5 确定权重集
权重是因素集 U上的模糊子集:
其中:
4.6 模糊综合评价
将评价因素集 U 上的模糊集合 WW 经模糊关系变换为评语集 VV 上的模糊集合 B:
扎德算子"∘"表示模糊矩阵组合关系:
最后进行归一化,并按最大隶属度原则确定评价结果。
5. 单级模糊综合评价例题
题目
设某公司对所属职员的综合素质考核因素集:
U={u1,u2,u3,u4}={思想修养,集体观念,劳动观念,工作业绩}
评语集:
V={v1,v2,v3,v4}={很好,较好,一般,不好}
权重分配为:
A={0.5,0.2,0.2,0.1}
对 10 人进行调查,结果如下表:
| 指标 | 很好 | 较好 | 一般 | 不好 |
|---|---|---|---|---|
| 思想修养 | 4 | 5 | 1 | 0 |
| 集体观念 | 6 | 3 | 1 | 0 |
| 劳动观念 | 1 | 2 | 6 | 1 |
| 工作业绩 | 1 | 2 | 5 | 2 |
求解
模糊评价矩阵为:
权重向量:
A=(0.5,0.2,0.2,0.1)
由模糊评价模型:
归一化后:
B=(0.33,0.42,0.17,0.08)
最大隶属度为 0.42,对应"较好"。因此该职员综合素质应评为 较好。
6. 其他模糊算子
实际建模中,可根据问题特点选择不同模糊合成算子。
| 算子 | 表达式 | 特点 | 类型 |
|---|---|---|---|
| M(∧,∨) | 权重作用不明显,综合程度弱,利用 R信息不充分 | 主因素决定型 | |
| M(⋅,∨) | 权重作用明显,综合程度弱,利用 R信息不充分 | 主因素突出型 | |
| M(∧,⊕) | 权重作用不明显,综合程度强,利用 R 信息比较充分 | 加权平均型 | |
| M(⋅,⊕) | 权重作用明显,综合程度强,利用 R 信息充分 | 加权平均型 |
常见选择:
-
主因素决定型:M(∧,∨);
-
主因素突出型:M(⋅,∨);
-
加权平均型:M(⋅,⊕)。
7. 模糊综合评价的优缺点
优点
-
结果清晰,系统性较强;
-
能较好解决模糊、难以量化的问题;
-
适合各种非确定性问题的评价。
缺点
-
计算相对复杂;
-
指标权重矢量的确定主观性较强;
-
可能出现"超模糊现象"。
超模糊现象
当指标集 U较大,即指标个数较多时,在权重和为 1 的约束下,相对隶属度权系数往往偏小,权矢量与模糊矩阵 R不匹配,结果会出现超模糊现象:
-
分辨率差;
-
无法区分谁的隶属度更高;
-
甚至造成评判失败。
此时可用 分层模糊评估法 或多级模糊综合评价改进。
8. 多级模糊综合评价
一级模糊综合评价是基础。它把一级评价因素集指标统一综合,但一级模糊评价的指标之间相关性往往不强。
多级模糊综合评价的思想是:
-
先对每组相关性较强的指标进行一级模糊评价;
-
得到每组指标对评语集的隶属度;
-
再在更高层权重向量下进行二级或多级模糊合成;
-
得到最终评价结果。
多级模糊综合评价更适合解决多指标、指标之间相关性不强的情况,结果更全面合理。
示例:学术奖学金评价
因素集:
U={专业课成绩,非专业课成绩,国家竞赛成绩,省级竞赛成绩,校级竞赛成绩,国家级奖项,省级奖项,校级奖项,志愿服务}
评语集:
V={一等,二等,无奖学金}
权重集:
可分为四组:
-
考试成绩 U1(0.4)
-
竞赛成绩 U2(0.3)
-
个人荣誉 U3(0.2)
-
志愿服务 U4(0.1)
先对 U1 进行一级模糊评判。假设:
则:
表示只看学习成绩,76% 认为可获一等,24% 认为可获二等。
同理得到:
最终综合评判:
最大隶属度为 0.439,对应"一等"。因此该学生获得一等奖学金。
9.某高校教师课堂教学质量评价
某高校对一位教师的课堂教学质量进行评价。
1. 评价指标因素集
U={教学态度,教学内容,教学方法,教学效果}
2. 评语集
V={优秀,良好,中等,合格,不合格}
3. 权重集
假设由层次分析法 AHP 得到权重:
W=0.2,0.3,0.3,0.2
4. 调查投票结果
调查 10 名学生,对 4 个指标分别投票,结果如下:
| 指标 | 优秀 | 良好 | 中等 | 合格 | 不合格 |
|---|---|---|---|---|---|
| 教学态度 | 4 | 4 | 1 | 1 | 0 |
| 教学内容 | 3 | 4 | 2 | 1 | 0 |
| 教学方法 | 2 | 3 | 3 | 1 | 1 |
| 教学效果 | 3 | 3 | 2 | 1 | 1 |
每行除以 10,得到模糊评价矩阵 R。
-
加权平均型算子得到:
B=(0.29,0.35,0.21,0.10,0.05)
最大隶属度为 0.35 ,对应 "良好"。结果区分度较好。
-
扎德算子得到:
B=(0.3,0.3,0.3,0.1,0.1)
归一化后"优秀、良好、中等"三者并列,区分度较差。这也体现了扎德算子容易出现"超模糊现象"的缺点。
因此,在实际数学建模中,如果希望结果更平滑、区分度更好,通常推荐使用加权平均型算子 M(⋅,⊕)。
import numpy as np

# ==============================
# 1. 因素集与评语集
# ==============================
factors = ['教学态度', '教学内容', '教学方法', '教学效果']
grades = ['优秀', '良好', '中等', '合格', '不合格']

# ==============================
# 2. 权重集(可由 AHP、熵权法得到)
# ==============================
W = np.array([0.2, 0.3, 0.3, 0.2])
print("权重 W =", W)

# ==============================
# 3. 专家/学生投票人数
# 行:评价因素
# 列:评语等级:优秀、良好、中等、合格、不合格
# ==============================
votes = np.array([
    [4, 4, 1, 1, 0],  # 教学态度
    [3, 4, 2, 1, 0],  # 教学内容
    [2, 3, 3, 1, 1],  # 教学方法
    [3, 3, 2, 1, 1],  # 教学效果
], dtype=float)

# ==============================
# 4. 构造模糊评价矩阵 R
# 每行归一化,使每行元素之和为 1
# ==============================
R = votes / votes.sum(axis=1, keepdims=True)
print("\n评价矩阵 R =")
print(R)

# ==============================
# 5. 定义模糊合成算子
# ==============================
def zadeh_operator(W, R):
    """
    扎德算子 M(∧, ∨):先取小,再取大
    B_j = max_i min(W_i, R_ij)
    """
    m, n = R.shape
    B = np.zeros(n)
    for j in range(n):
        B[j] = np.max(np.minimum(W, R[:, j]))
    return B


def weighted_average_operator(W, R):
    """
    加权平均型算子 M(·, ⊕)
    B = W @ R
    """
    return W @ R


# ==============================
# 6. 归一化函数
# ==============================
def normalize(B):
    return B / B.sum()


# ==============================
# 7. 最大隶属度原则
# ==============================
def max_membership(B, grades):
    idx = np.argmax(B)
    return grades[idx], idx, B[idx]


# ==============================
# 8. 使用加权平均型算子计算
# ==============================
B_weighted = weighted_average_operator(W, R)
B_weighted_norm = normalize(B_weighted)
grade_w, idx_w, val_w = max_membership(B_weighted_norm, grades)

print("\n===== 加权平均型算子 M(·, ⊕) =====")
print("模糊评价向量 B =", B_weighted)
print("归一化后 B =", B_weighted_norm)
print(f"最大隶属度:{grade_w}({val_w:.4f})")


# ==============================
# 9. 使用扎德算子计算
# ==============================
B_zadeh = zadeh_operator(W, R)
B_zadeh_norm = normalize(B_zadeh)
grade_z, idx_z, val_z = max_membership(B_zadeh_norm, grades)

print("\n===== 扎德算子 M(∧, ∨) =====")
print("模糊评价向量 B =", B_zadeh)
print("归一化后 B =", B_zadeh_norm)
print(f"最大隶属度:{grade_z}({val_z:.4f})")

# ==============================
# 10. 计算结果
# ==============================
print("\n结果:")
print(f"采用加权平均型算子,该教师课堂教学质量综合评价为:{grade_w}")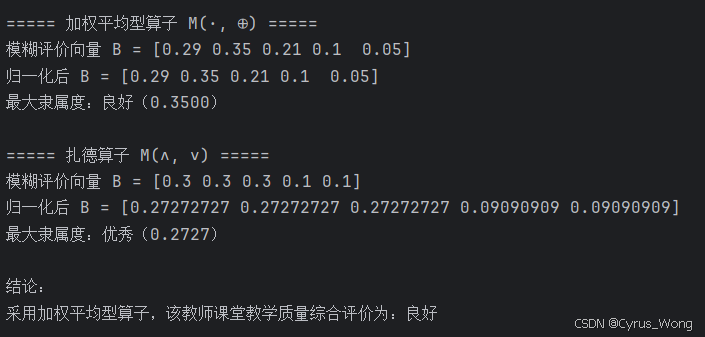
10.如何套用到你自己的题目
只需要修改三处:
-
factors:改成你的评价指标; -
grades:改成你的评价等级; -
W和votes:改成你的权重和数据。
如果有多级指标,可以先对每组指标做一次模糊综合评价,得到 B1,B2,...,再组成上层评价矩阵继续合成即可。