✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
本系统名为《基于大数据的京东商品销售数据分析与可视化》,主要面向京东平台商品销售数据的离线分析场景,围绕商品分类、价格趋势、商品评分、销量趋势、店铺经营状况以及商品挖掘分析等维度展开。系统底层采用Hadoop与HDFS完成数据存储,借助Spark与Spark SQL进行数据清洗、聚合与统计计算,并结合Pandas、NumPy完成部分指标处理,最终通过Echarts将分析结果以图表形式呈现。开发语言支持Python与Java两个版本,后端分别对应Django与Spring Boot,前端采用Vue、ElementUI、HTML、CSS、JavaScript与jQuery构建交互页面,数据库使用MySQL存储分析结果与基础配置信息。整体流程为数据采集与整理、大数据计算、结果落库、接口服务、前端可视化展示,能够较完整地体现大数据处理链路在电商销售分析中的应用方式。
选题背景
近几年电商平台的商品数据量越来越大,京东作为国内主流电商平台之一,商品种类多、订单量大,销售过程中会产生大量与分类、价格、评分、销量和店铺相关的数据。这些数据如果只靠人工整理,很难在短时间内看出趋势,也不容易发现商品之间的差异。传统方式大多停留在简单表格统计,面对稍大规模的数据就显得吃力,数据清洗、聚合和趋势计算都要花费不少时间。Hadoop和Spark这类大数据技术逐渐成熟之后,离线批处理分析的门槛降低了不少,学生也能在普通实验环境中完成一定规模的数据分析任务。对于计算机专业大四学生来说,把京东商品销售数据作为毕设对象,既能接触真实业务场景,又能把Hadoop、HDFS、Spark SQL、Django或Spring Boot这些技术串起来,选题难度相对可控,也比较贴近当前数据处理类课题的方向。
选题意义
从实际意义来看,这个系统能把京东商品销售中的分类、价格、评分、销量、店铺和商品挖掘等信息集中呈现出来,帮助使用者比较直观地看到不同品类商品的销售差异和价格变化,对商家调整商品结构或定价思路有一定参考价值。对计算机专业学生来说,完成这样一个毕设,可以把大数据存储、Spark计算、后端接口和前端可视化几个环节真正连起来,不再只是停留在课堂练习层面。系统本身规模不算大,功能也主要围绕销售数据分析展开,谈不上多么复杂的商业决策支持,但作为毕业设计,它能够把所学的大数据相关技术落到一个具体场景中,锻炼数据清洗、指标计算和结果展示的能力。另外,这类选题的资料相对容易查找,技术路线也比较清晰,对后续想做数据分析方向的同学来说,是一个比较合适的入门实践。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
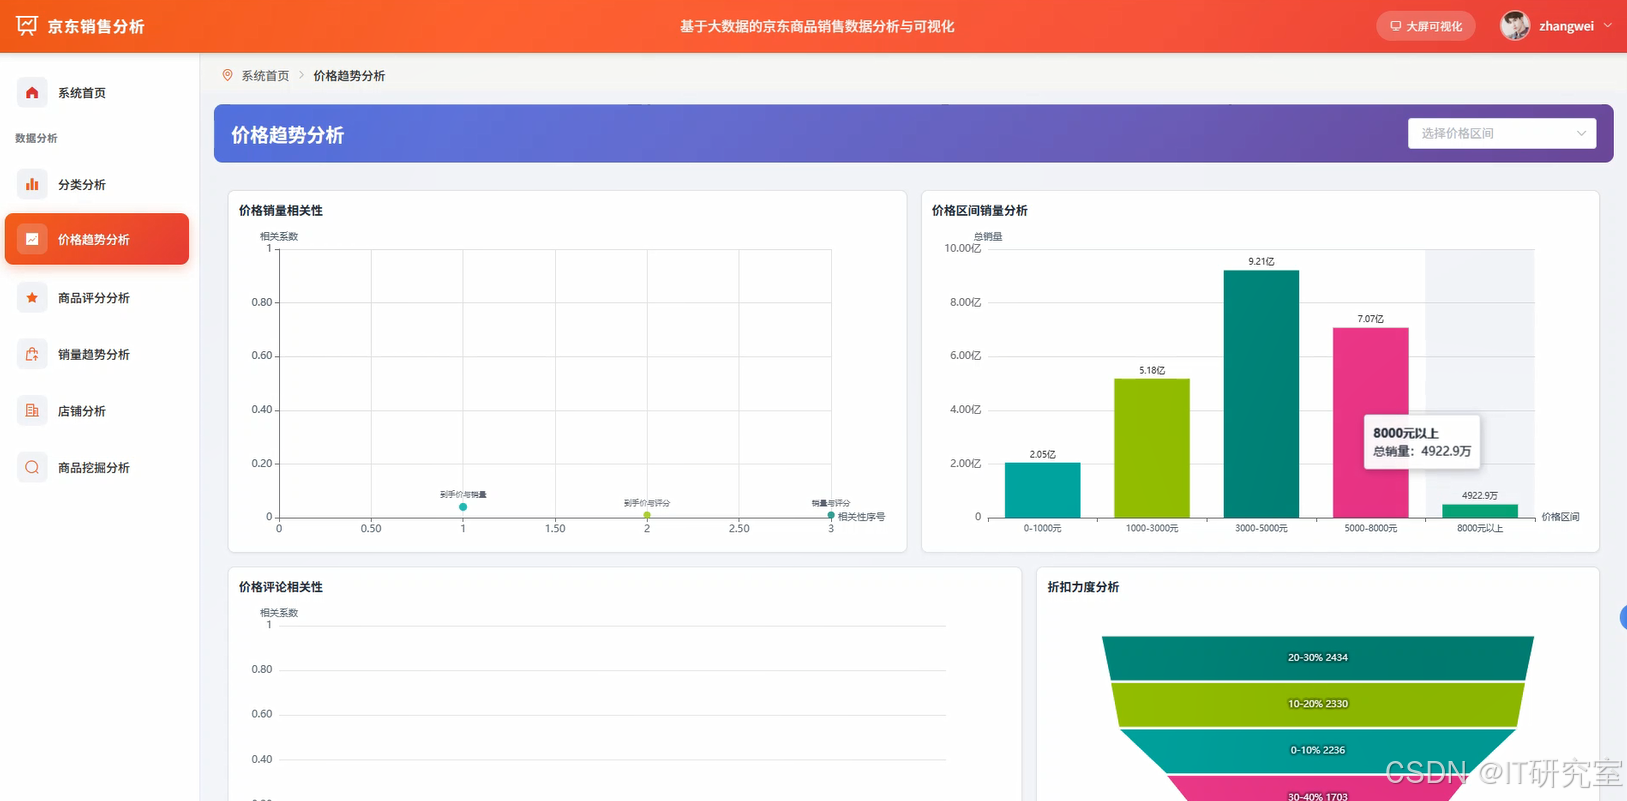
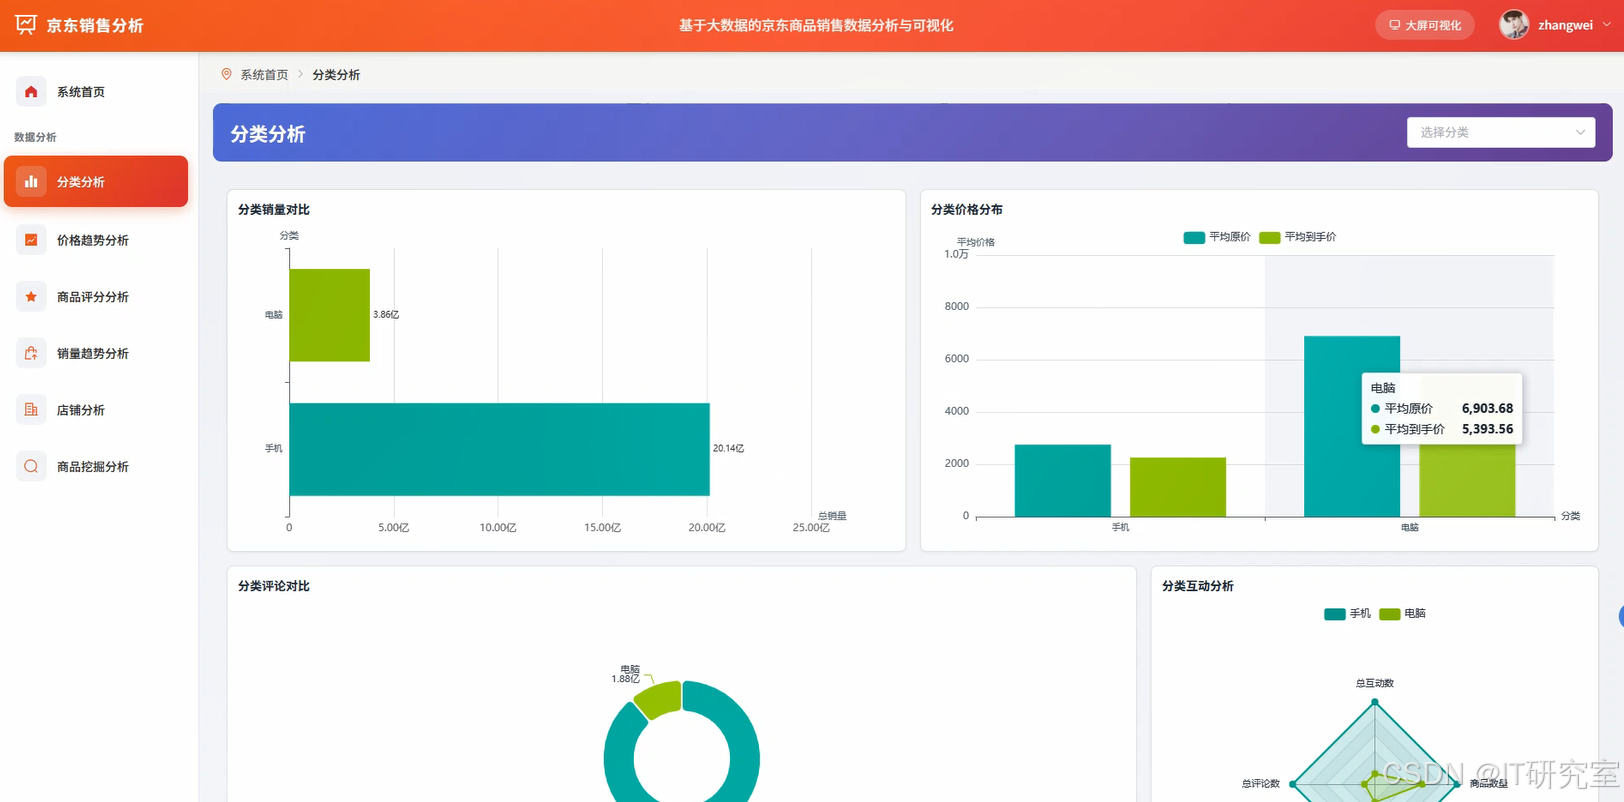
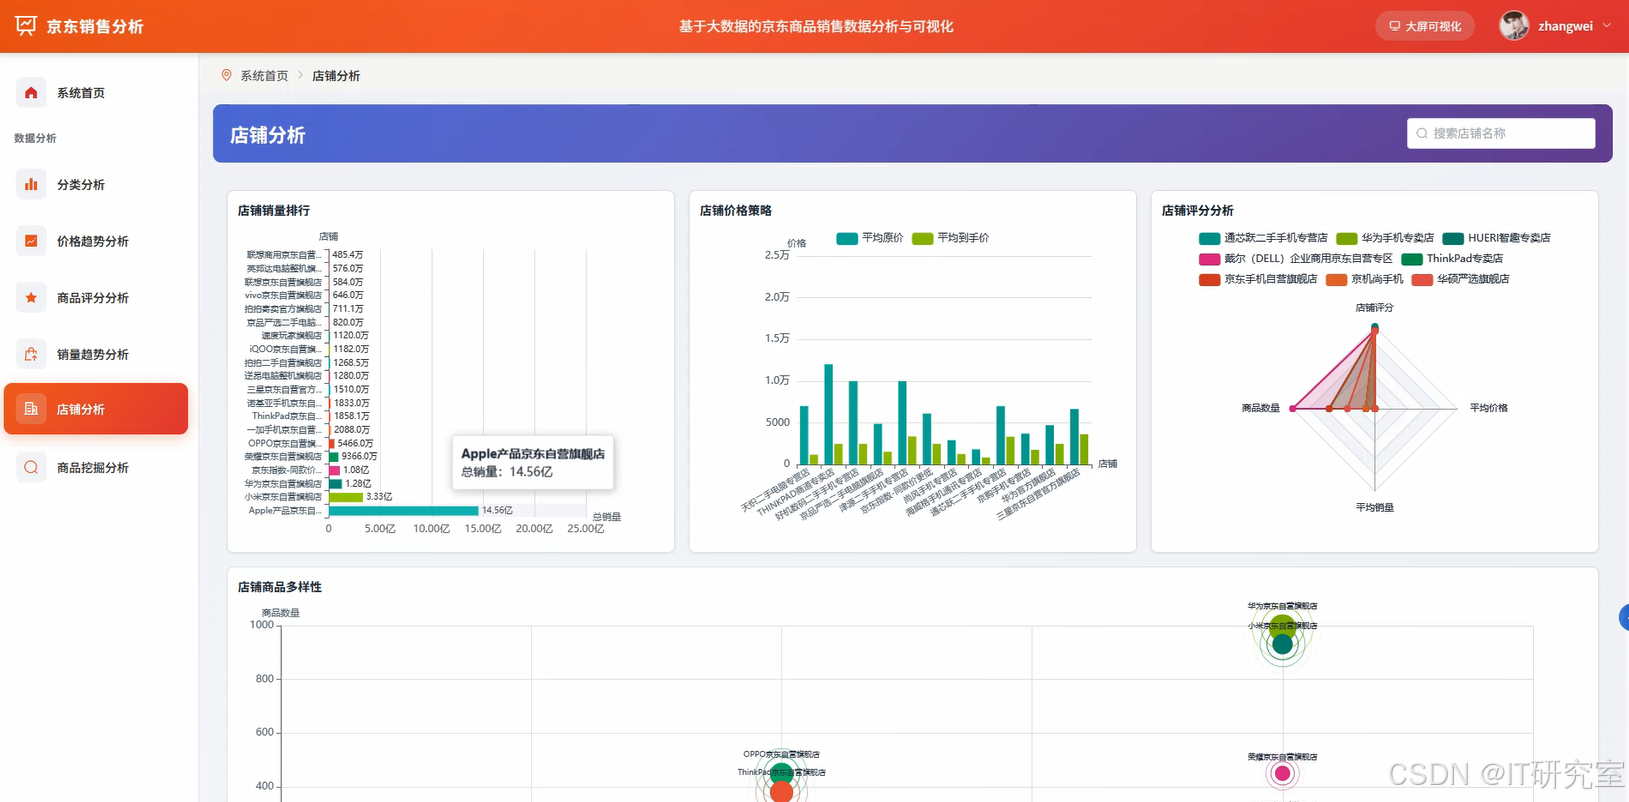
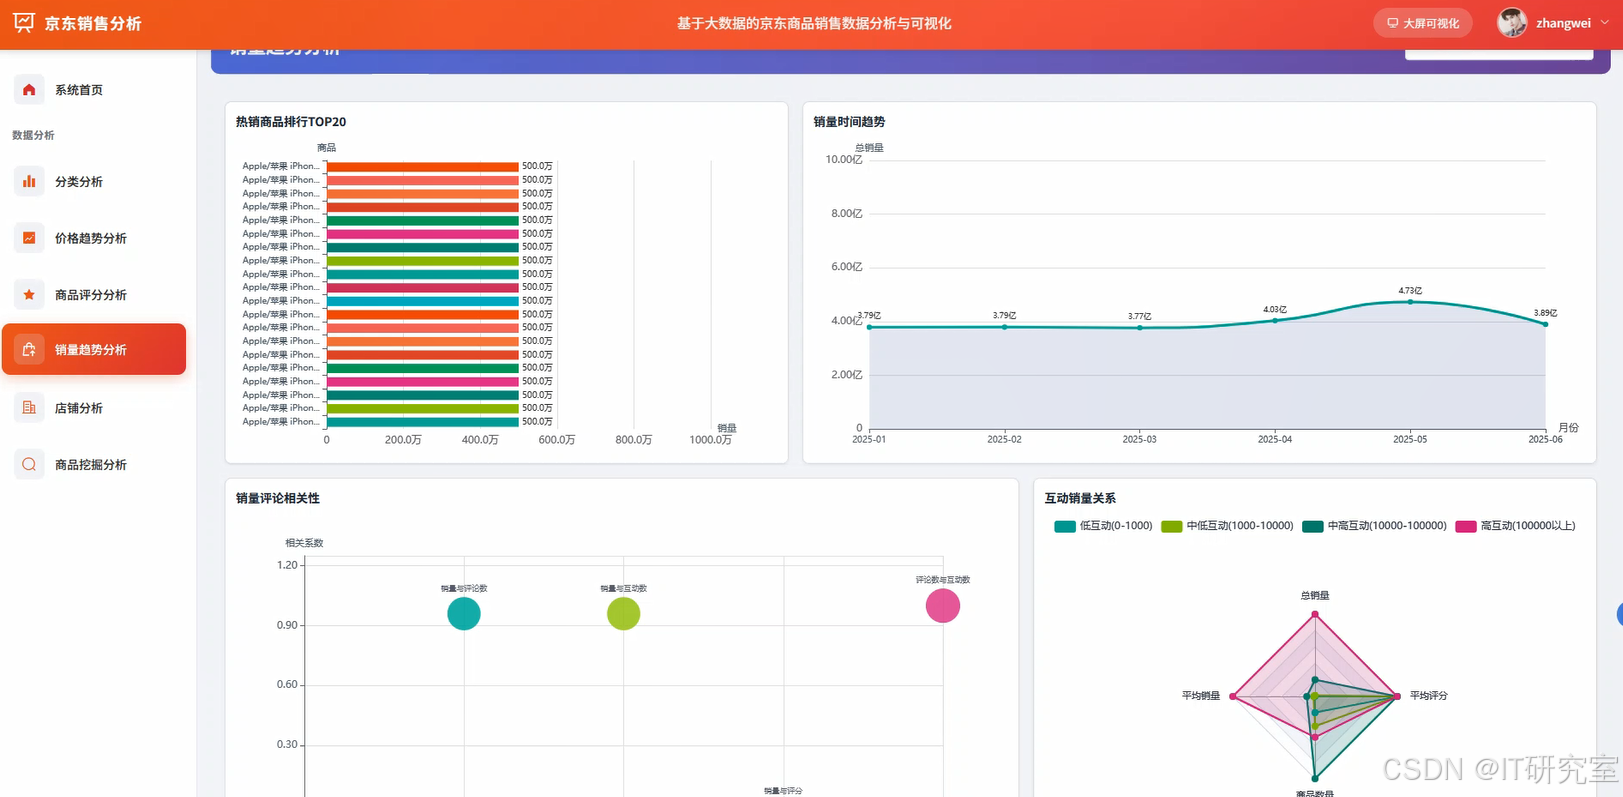
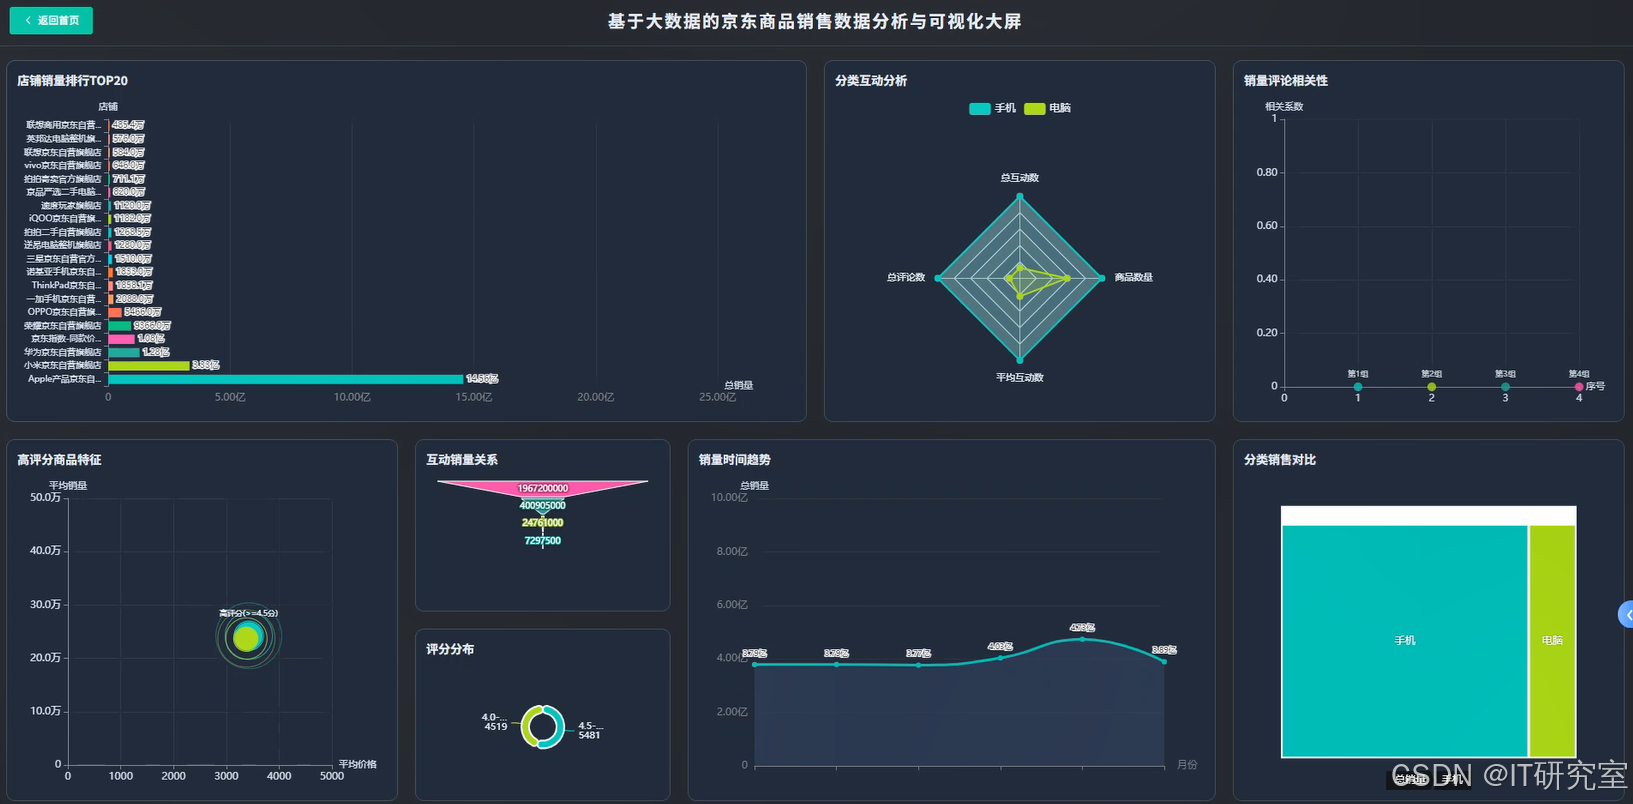
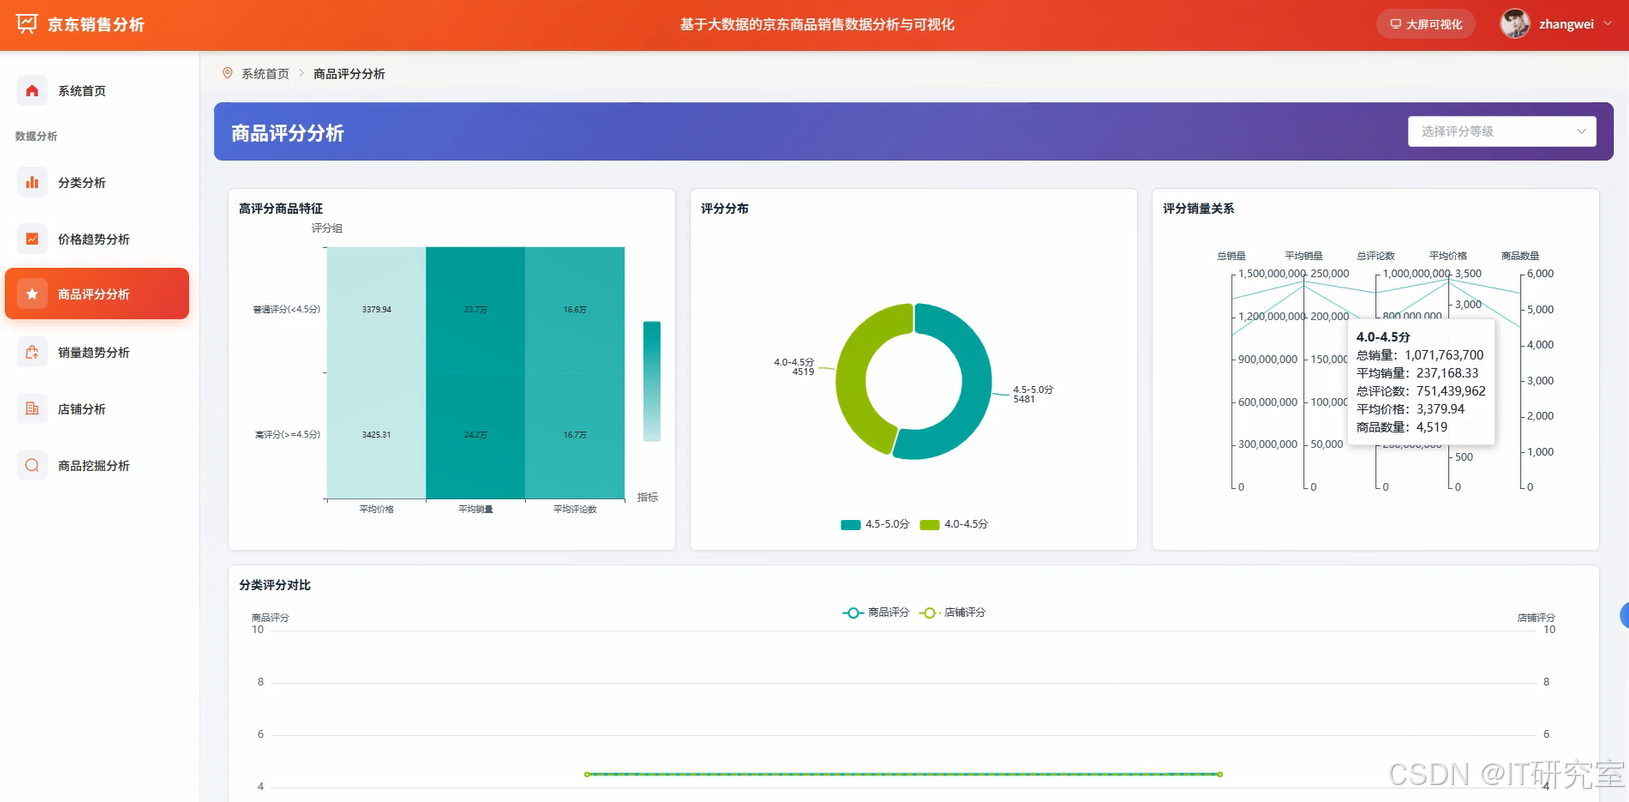
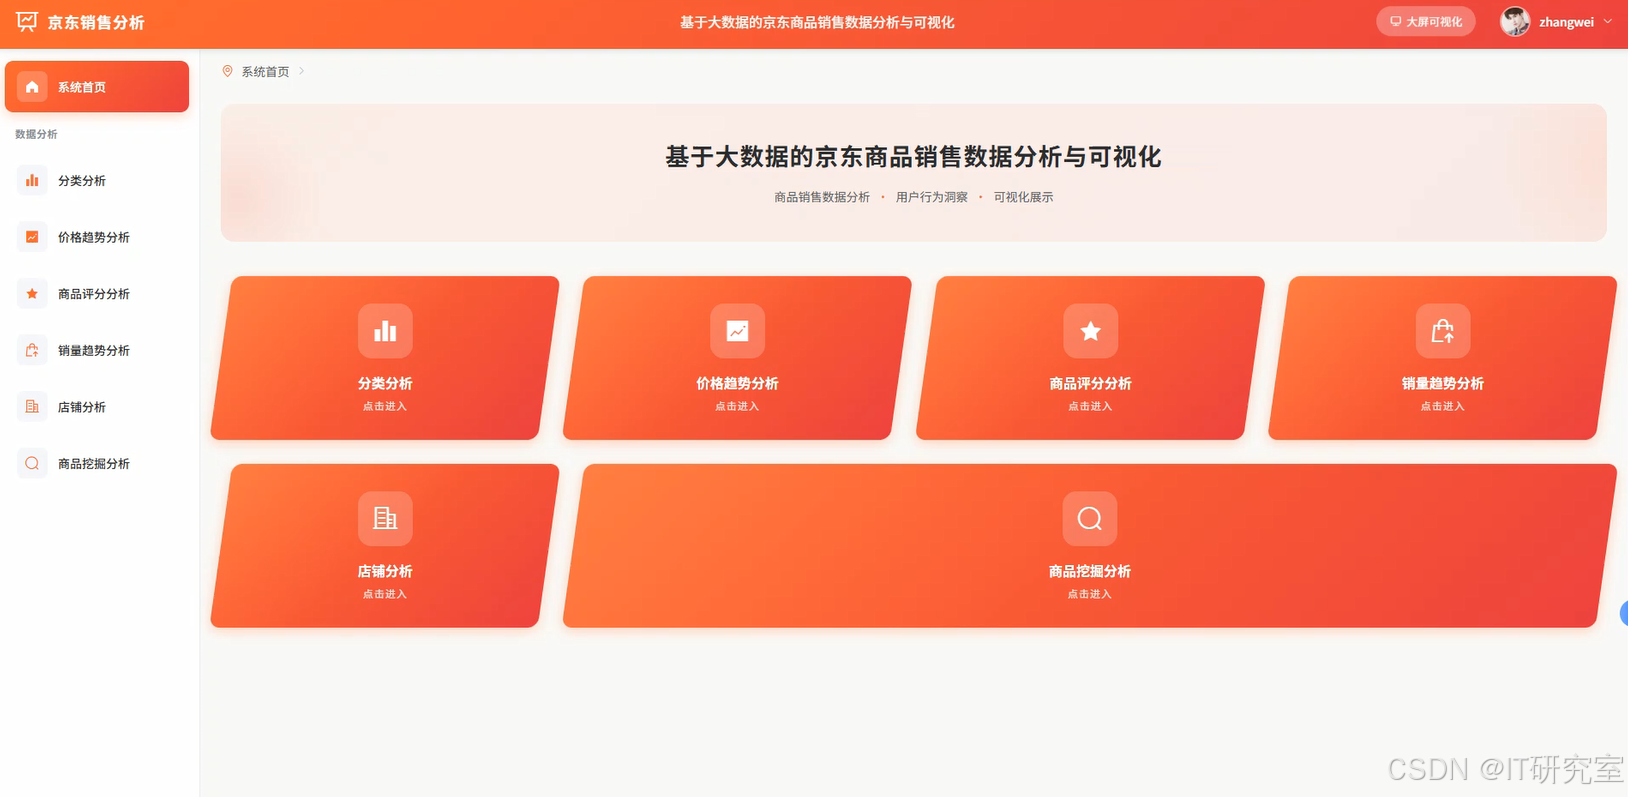
- 基于大数据的京东商品销售数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, sum, avg, count, desc, when
import pandas as pd
import numpy as np

spark = SparkSession.builder.appName("JD_Sales_Analysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()

def category_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/jd/sales.csv")
    df_clean = df.dropna(subset=["category", "sales", "price"])
    df_clean = df_clean.withColumn("sales_amount", col("sales") * col("price"))
    category_result = df_clean.groupBy("category").agg(sum("sales").alias("total_sales"), sum("sales_amount").alias("total_amount"), avg("price").alias("avg_price"), count("product_id").alias("product_count"))
    category_result = category_result.orderBy(desc("total_sales"))
    category_pd = category_result.toPandas()
    category_pd["sales_ratio"] = category_pd["total_sales"] / category_pd["total_sales"].sum()
    category_pd["amount_ratio"] = category_pd["total_amount"] / category_pd["total_amount"].sum()
    category_pd["rank"] = category_pd["total_sales"].rank(ascending=False, method="min")
    category_pd = category_pd.sort_values(by="total_sales", ascending=False)
    category_pd.to_csv("hdfs://localhost:9000/jd/result/category_result.csv", index=False)
    return category_pd

def price_trend_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/jd/sales.csv")
    df_clean = df.dropna(subset=["price", "sale_date", "category"])
    df_clean = df_clean.withColumn("month", col("sale_date").substr(1, 7))
    price_trend = df_clean.groupBy("month", "category").agg(avg("price").alias("avg_price"), sum("sales").alias("month_sales"), count("product_id").alias("product_count"))
    price_trend = price_trend.orderBy("month", "category")
    price_pd = price_trend.toPandas()
    price_pd["price_change"] = price_pd.groupby("category")["avg_price"].diff()
    price_pd["price_change_rate"] = price_pd.groupby("category")["avg_price"].pct_change()
    price_pd["moving_avg"] = price_pd.groupby("category")["avg_price"].transform(lambda x: x.rolling(window=3, min_periods=1).mean())
    price_pd["trend_flag"] = np.where(price_pd["price_change"] > 0, "上涨", np.where(price_pd["price_change"] < 0, "下降", "持平"))
    price_pd = price_pd.fillna(0)
    price_pd.to_csv("hdfs://localhost:9000/jd/result/price_trend_result.csv", index=False)
    return price_pd

def sales_trend_analysis():
    df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/jd/sales.csv")
    df_clean = df.dropna(subset=["sales", "sale_date", "category", "price"])
    df_clean = df_clean.withColumn("month", col("sale_date").substr(1, 7))
    df_clean = df_clean.withColumn("sales_amount", col("sales") * col("price"))
    sales_trend = df_clean.groupBy("month", "category").agg(sum("sales").alias("total_sales"), sum("sales_amount").alias("total_amount"), avg("sales").alias("avg_sales"))
    sales_trend = sales_trend.orderBy("month", "category")
    sales_pd = sales_trend.toPandas()
    sales_pd["sales_growth"] = sales_pd.groupby("category")["total_sales"].diff()
    sales_pd["sales_growth_rate"] = sales_pd.groupby("category")["total_sales"].pct_change()
    sales_pd["cumulative_sales"] = sales_pd.groupby("category")["total_sales"].cumsum()
    sales_pd["sales_level"] = pd.cut(sales_pd["total_sales"], bins=[0, 1000, 5000, 10000, float("inf")], labels=["低", "中", "高", "极高"])
    sales_pd = sales_pd.fillna(0)
    sales_pd.to_csv("hdfs://localhost:9000/jd/result/sales_trend_result.csv", index=False)
    return sales_pd

category_analysis()
price_trend_analysis()
sales_trend_analysis()
spark.stop()
五、系统视频
基于大数据的京东商品销售数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的京东商品销售数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇