作者:来自 Elastic Jeffrey Rengifo
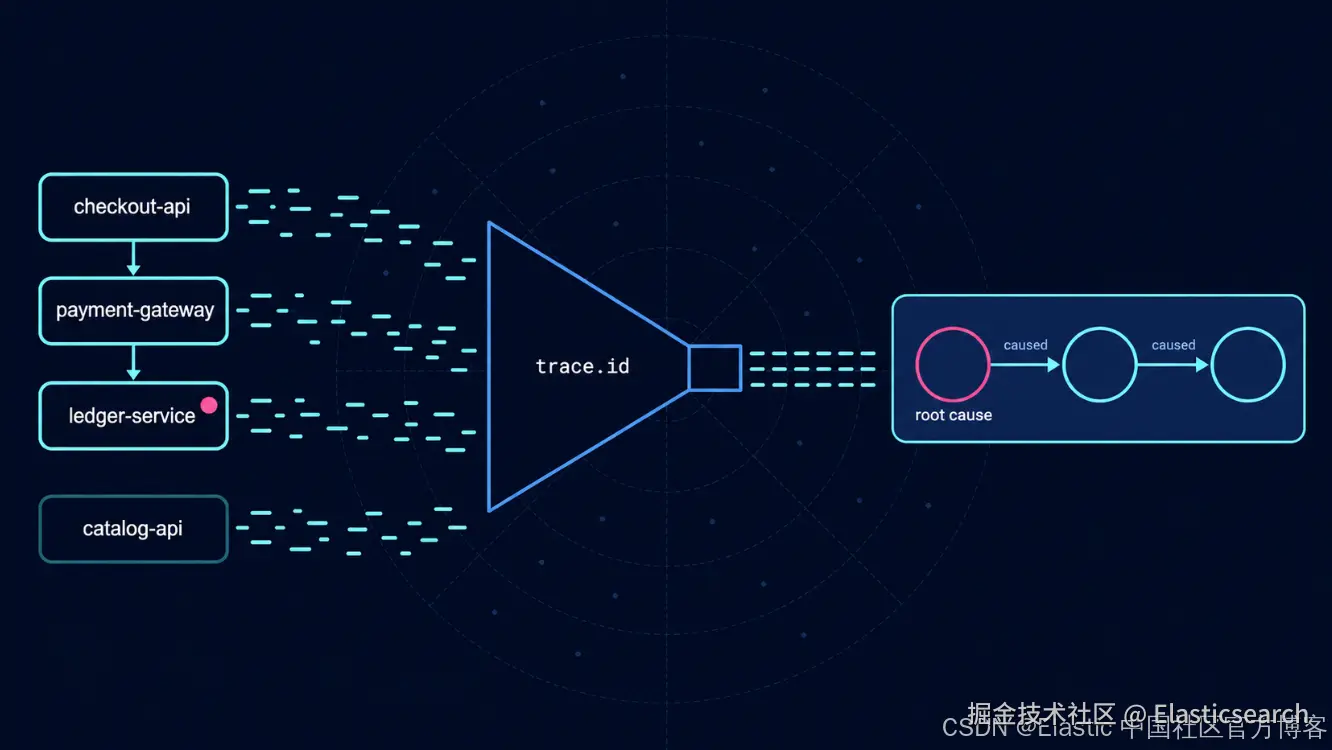
指标显示三个服务的错误率完全相同,均为 19.1%。针对同一批 4,688 条 OpenTelemetry 日志记录的四条 ES|QL 查询,将 956 条故障链中的 955 条追溯到了其中一个服务,而且无需任何服务依赖模型。
Elasticsearch 会在数据摄取时将原始日志转换为结构化、可搜索的数据。按照收集和分析日志教程,端到端地了解整个过程。立即开始免费云试用,或者现在就在你的本地机器上尝试 Elastic。
指标显示三个服务的错误率完全相同,均为 19.1%,因此必须通过日志进行根因分析来确定排序。按照错误日志的数量进行排序后,catalog-api 以 1,820 个错误位居首位,尽管它对收到的每个请求都返回了 200。针对同一批 4,688 条日志记录执行四条 ES|QL 查询后,发现真正的问题是 ledger-service:956 条故障链中有 955 条始于该服务,其连接池大小为 8,但可用连接数为 0。整个过程无需服务依赖模型,也无需在故障事件之间维护任何内容,只需要每条记录中都有一个 trace.id。
在本文中,我们使用 Elastic Distribution of OpenTelemetry(EDOT) 为四个 Python 服务添加 instrumentation,使其中一个服务达到饱和状态,然后使用 ES|QL 找出最先发生故障的服务。指标会告诉你出了问题;而日志则会告诉你为什么出问题,前提是你按照请求而不是按照服务对日志进行分组。
前置条件
-
Elasticsearch 和 Kibana 9.1 或更高版本。
-
Python 3.10 或更高版本。
-
Elastic Cloud Managed OTLP 端点及其 API 密钥。Kibana 会在 Add data > OpenTelemetry 下显示这两项。
配套笔记本会重现此故障事件,并运行下面的每一条查询,因此你可以使用自己的集群跟随操作。
从日志进行根因分析:为什么错误计数无法构建因果图
因果图是一种有向图,其节点是发生故障的组件,边则记录哪个故障导致了哪个故障。读取因果图的过程是机械性的:从用户报告问题的服务开始,沿着边反向追踪,而那个无法继续向后追溯的节点就是根因。
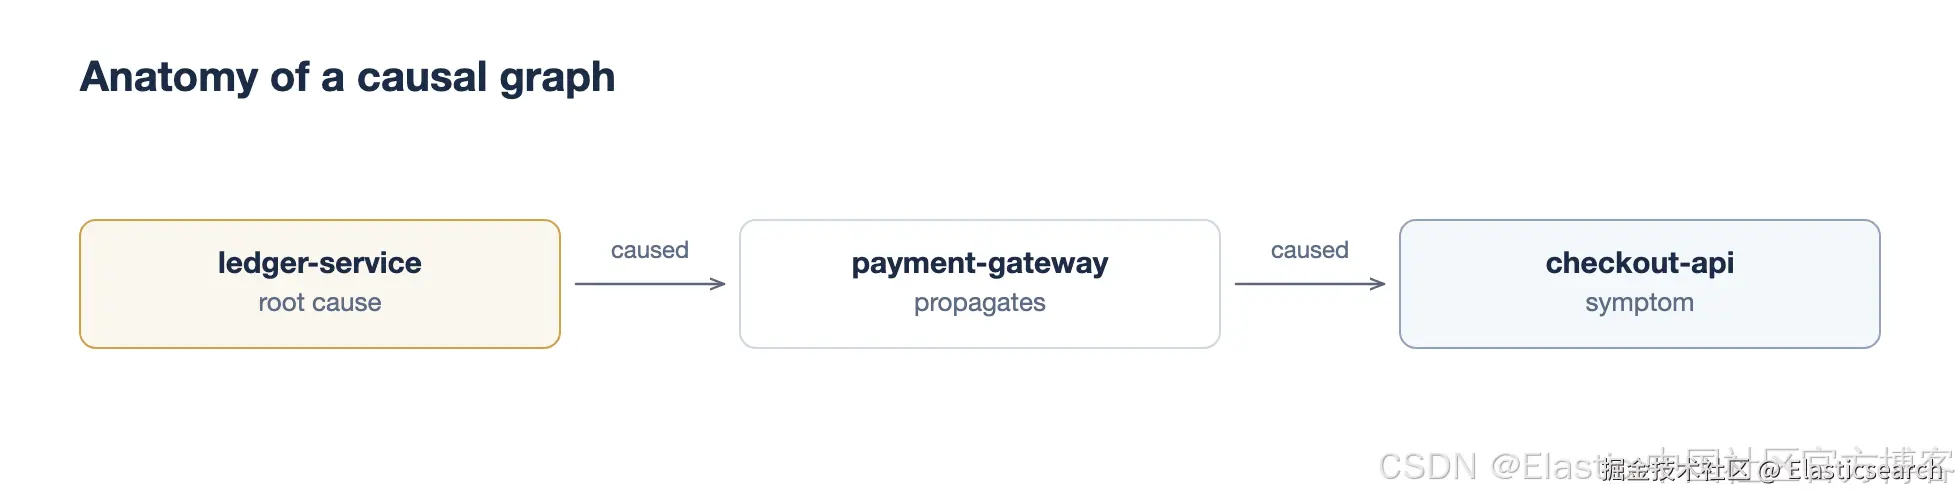
因果边可以根据服务依赖模型预先声明,该模型涵盖模型能够预见的每一种故障,并且随着 架构 发生变化,需要与架构同步维护。本文则采用另一种方式:事后从日志字段中推导因果边。这种方式针对的是单个故障事件,而不是所有可能的故障,并且无需维护任何模型。
仅靠错误计数只能得到节点,无法得到边。级联中的每个服务都会针对每个失败请求记录一个错误,因此它们的错误计数会趋于一致。与此同时,一个健康的服务如果在常规事件中记录错误,只要该事件足够常见,其错误数就会超过所有这些服务。在本实验中,catalog-api 接收的流量少于 checkout-api,但记录的错误几乎是后者的两倍,因为它超过一半的请求都会报错,而级联中的服务只有五分之一的请求报错。
trace.id 字段提供了错误计数无法提供的结构:
-
具有相同
trace.id的两个错误属于同一个请求,因此其中一个可能是另一个的原因。 -
具有不同
trace.id的两个错误彼此无关,无论它们的时间戳有多接近。
使用 EDOT 进行 instrumentation 的四个 Python 服务
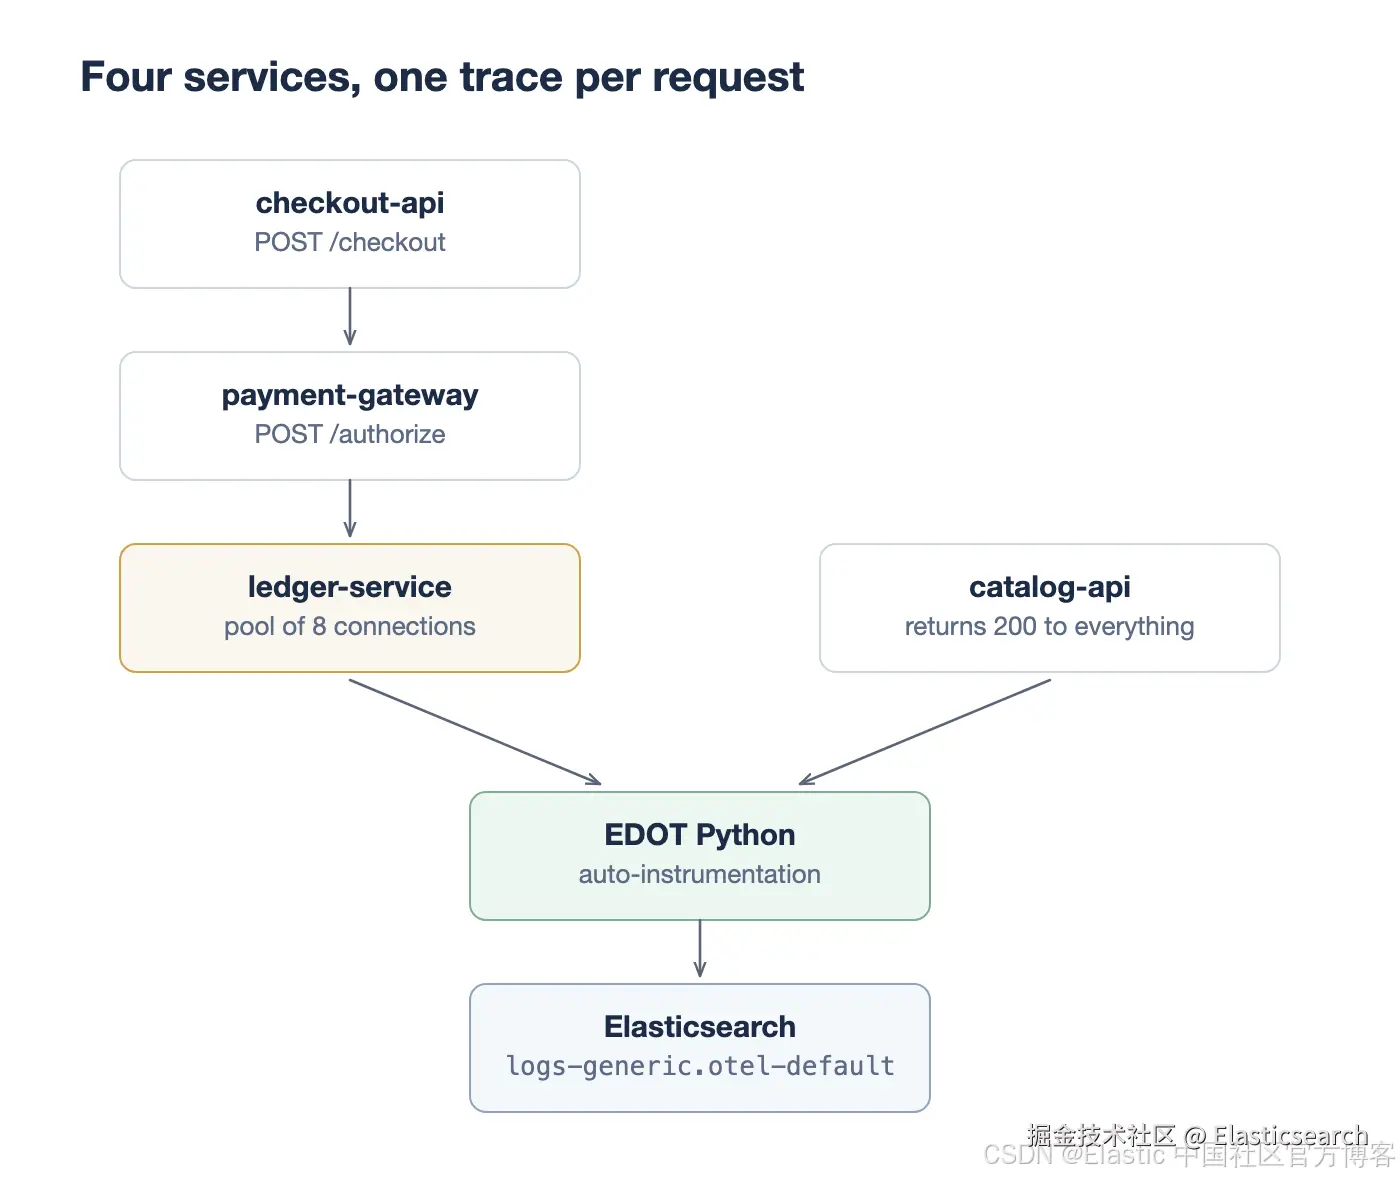
checkout-api 接收订单并调用 payment-gateway,后者调用 ledger-service,而 ledger-service 使用一个固定的、包含 8 个数据库连接的连接池。catalog-api 位于这条路径之外,在每次图像缓存未命中时记录一个 ERROR,但仍然返回 200。
按照文档中的设置说明,安装 EDOT Python 以及正在使用的库所需的 instrumentation:
ini
`

1.  pip install elastic-opentelemetry flask requests
2.  edot-bootstrap --action=install

`AI写代码
edot-bootstrap 会检查已安装的软件包,并添加匹配的 instrumentation,包括 opentelemetry-instrumentation-logging,该组件会将 trace 上下文附加到日志记录中。
每个服务都是使用标准库 logger 编写的普通 Flask 代码。下面是 ledger-service,也就是发生故障的服务:
kotlin
`
1. POOL_SIZE = 8
2. ACQUIRE_TIMEOUT_S = 0.25
4. pool = threading.BoundedSemaphore(POOL_SIZE)
5. state = {"hold_ms": 15}
7. @app.post("/reserve")
8. def reserve():
9. order_id = request.json.get("order_id")
10. if not pool.acquire(timeout=ACQUIRE_TIMEOUT_S):
11. logger.error(
12. "connection pool exhausted, no connection available after %.0fms",
13. ACQUIRE_TIMEOUT_S * 1000,
14. extra={
15. "db.connection_pool.size": POOL_SIZE,
16. "db.connection_pool.available": 0,
17. "error.kind": "pool_timeout",
18. "order.id": order_id,
19. },
20. )
21. return jsonify({"error": "pool_timeout"}), 503
22. try:
23. time.sleep(state["hold_ms"] / 1000.0)
24. return jsonify({"reservation_id": f"res-{order_id}"}), 200
25. finally:
26. pool.release()
`AI写代码ledger-service 文件中不包含任何 OpenTelemetry 代码。extra 中的每个键都会成为 Elasticsearch 中可搜索的字段。
两个调用方会添加一个字段,其他服务则不会。当 payment-gateway 因其依赖服务发生故障而失败时,它会记录具体是哪个依赖服务:
bash
`
1. logger.error(
2. "ledger rejected reservation with status %s, cannot authorize payment",
3. resp.status_code,
4. extra={
5. "error.kind": "authorization_failed",
6. "upstream.service": "ledger-service",
7. "upstream.status_code": resp.status_code,
8. "order.id": order_id,
9. },
10. )
`AI写代码将服务指向你的 OTLP 端点,并通过 opentelemetry-instrument 启动它们:
ini
`

1.  export OTEL_EXPORTER_OTLP_ENDPOINT="https://<your-managed-otlp-endpoint>"
2.  export OTEL_EXPORTER_OTLP_HEADERS="Authorization=ApiKey%20<your-api-key>"
3.  export OTEL_RESOURCE_ATTRIBUTES="service.

5.  opentelemetry-instrument python ledger_service.py

`AI写代码
OTEL_EXPORTER_OTLP_HEADERS 使用 URL 编码,因此 ApiKey 后面的空格必须写成 %20。
流量生成器每秒产生大约 12 个结账请求和 8 个产品查询,然后将 ledger 连接的占用时间从 15ms 提高到 900ms。在 8 个连接且每个连接占用 900ms 的情况下,该服务每秒大约只能处理 8.9 个请求,因此连接池会达到饱和,请求在获取连接时超时。没有任何服务返回硬编码的错误。记录的运行过程包括 2 分钟基线、4 分钟饱和和 1 分钟恢复,共产生 4,053 次成功结账和 956 次失败。
trace 关联的日志记录包含什么?
将 OTLP 发送到 Managed OTLP 端点后,日志会以原生 OpenTelemetry 结构存储在 logs-generic.otel-default 中,不进行任何 schema 转换。下面是本次运行中的一条 ERROR 记录,其中省略了 scope 和主机元数据:
bash
`
1. {
2. "@timestamp": "2026-07-26T09:03:45.139Z",
3. "resource": {
4. "attributes": {
5. "service.name": "ledger-service",
6. "deployment.environment": "obs-labs-causal-graph"
7. }
8. },
9. "trace_id": "f9b32dca62c1e142537413a047fb9b69",
10. "span_id": "c4548cab42cbdd15",
11. "severity_text": "ERROR",
12. "body": { "text": "connection pool exhausted, no connection available after 250ms" },
13. "attributes": {
14. "error.kind": "pool_timeout",
15. "order.id": "10c9e056ae8c",
16. "db.connection_pool.size": 8,
17. "db.connection_pool.available": 0
18. }
19. }
`AI写代码三个细节决定了这些查询可以实现什么:
-
trace_id和span_id无需任何应用代码进行设置即可产生,因为 logging instrumentation 会将活动 span 上下文附加到请求中产生的日志记录。 -
extra中的每个键都会保留原有的点号,并写入attributes下,而 Elasticsearch 会使用其短名称公开每个字段。代码写入的字段upstream.service,就是查询使用的字段。资源属性也是如此,因此service.name和deployment.environment可以按照原样进行查询。 -
ECS 名称仍然可以解析。
trace.id、span.id、log.level和message是trace_id、span_id、severity_text和body.text的内置别名,因此下面的查询会使用可读性更好的名称。
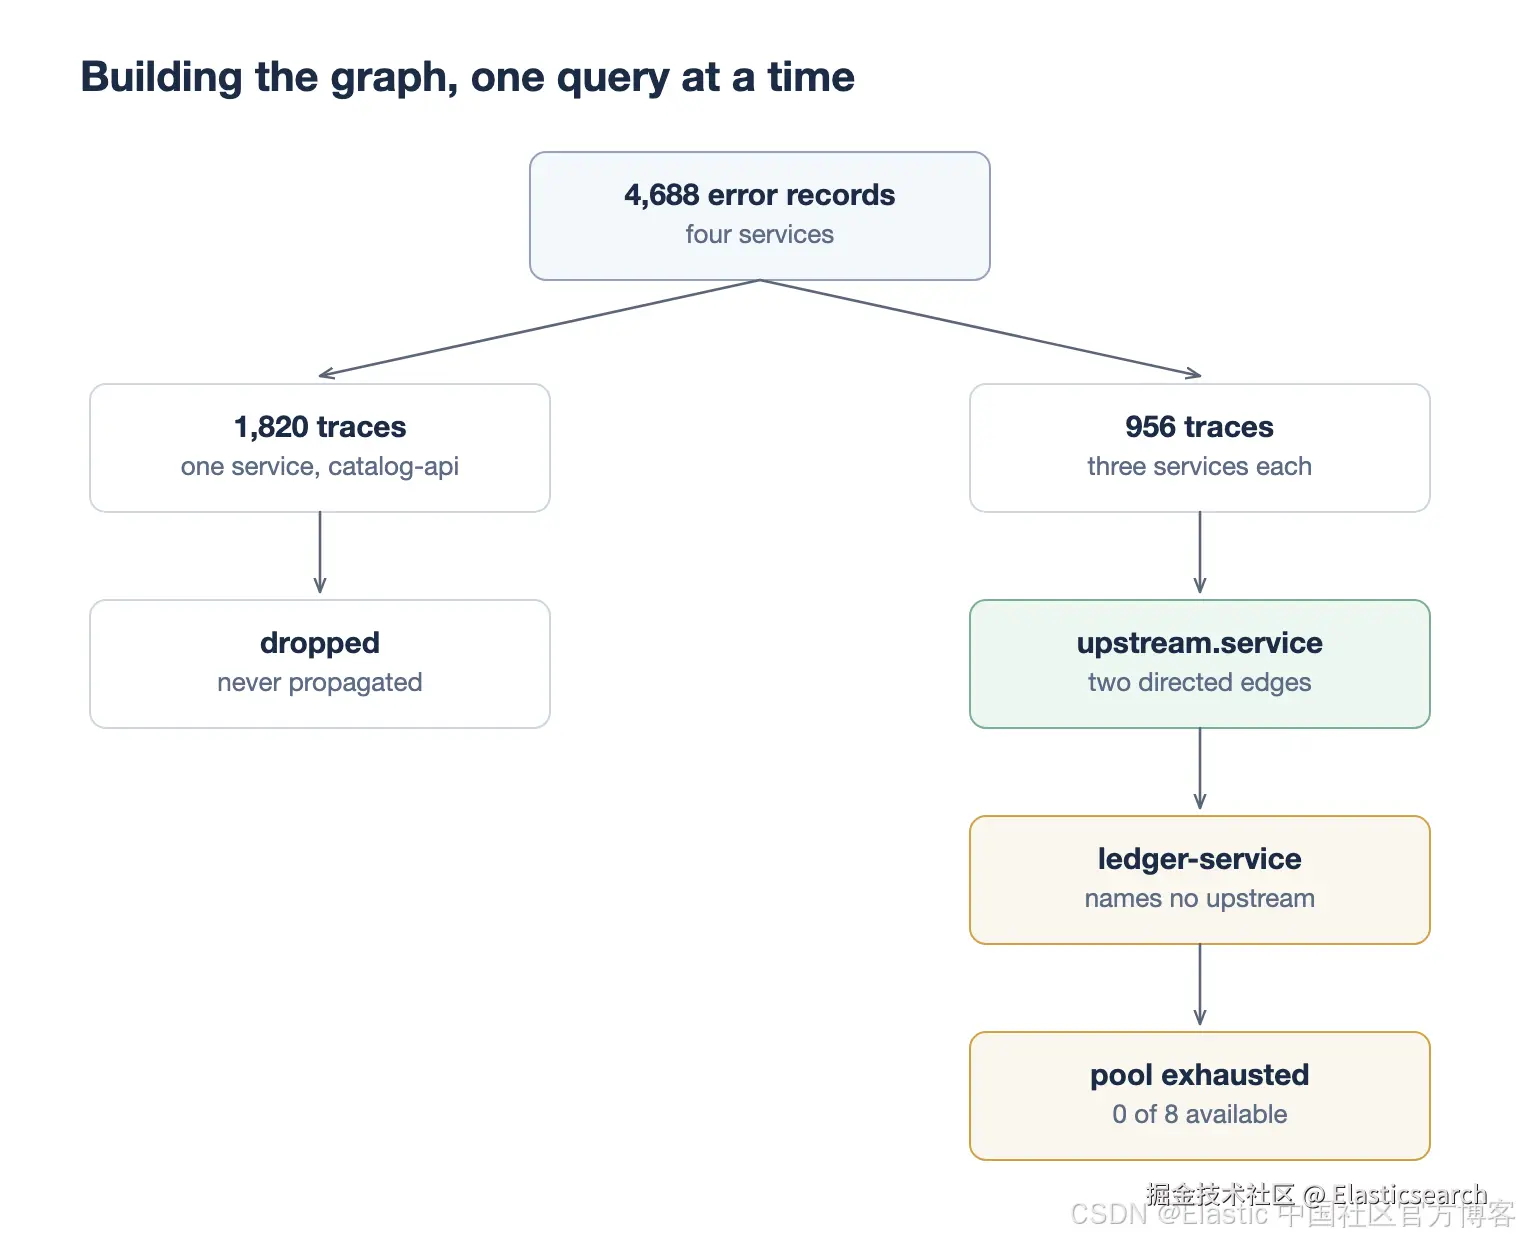
接下来的四个步骤会逐步为图添加一个部分,从没有边的节点开始:
第 1 步:按故障率和错误量对服务进行排名
首先,计算每个服务的故障率:
sql
`

1.  FROM traces-*.otel-*
2.  | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3.      AND deployment.environment == "obs-labs-causal-graph" AND kind == "Server"
4.  | STATS failed = COUNT(*) WHERE status.code == "Error", total = COUNT(*) BY service.name
5.  | EVAL failed_pct = ROUND(100.0 * failed / total, 1)
6.  | SORT failed_pct DESC

`AI写代码
less
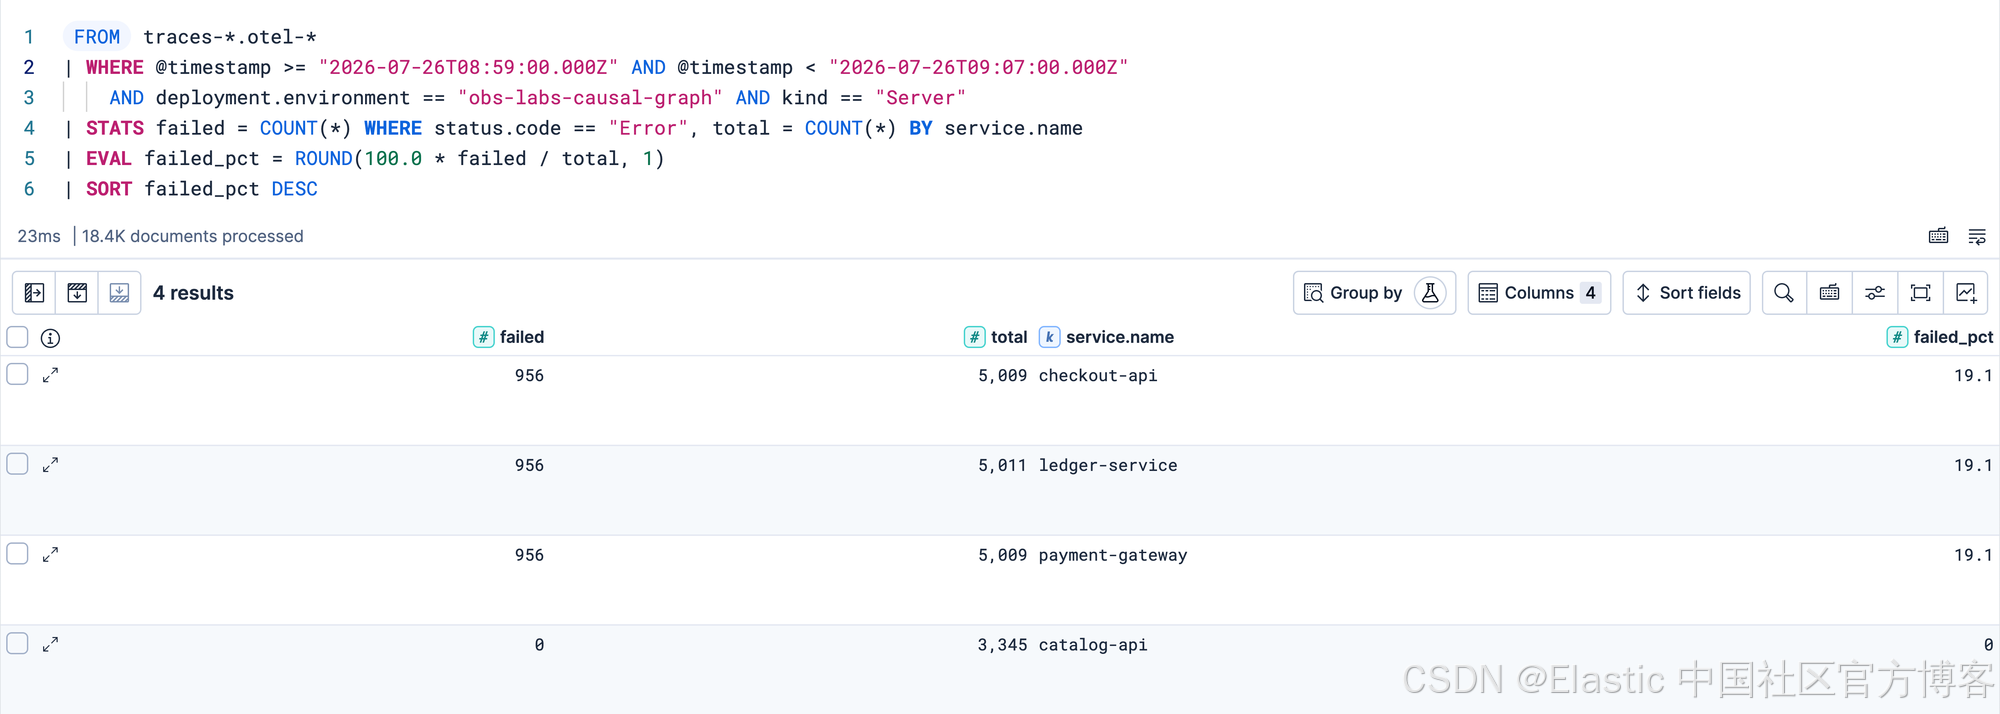checkout-api、ledger-service 和 payment-gateway 的故障率均为 19.1%,每个服务都有 956 次故障。由于在同步调用链中,当最深层的调用发生故障时,每一跳都会失败,因此这些故障率完全相同。指标只能指出受影响的服务,却无法对它们进行排序。
现在,在相同时间窗口内,统计每个服务的 ERROR 记录数:
sql
`

1.  FROM logs-*.otel-*
2.  | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3.      AND deployment.environment == "obs-labs-causal-graph" AND log.level == "ERROR"
4.  | STATS errors = COUNT(*), traces = COUNT_DISTINCT(trace.id) BY service.name
5.  | SORT errors DESC

`AI写代码
less
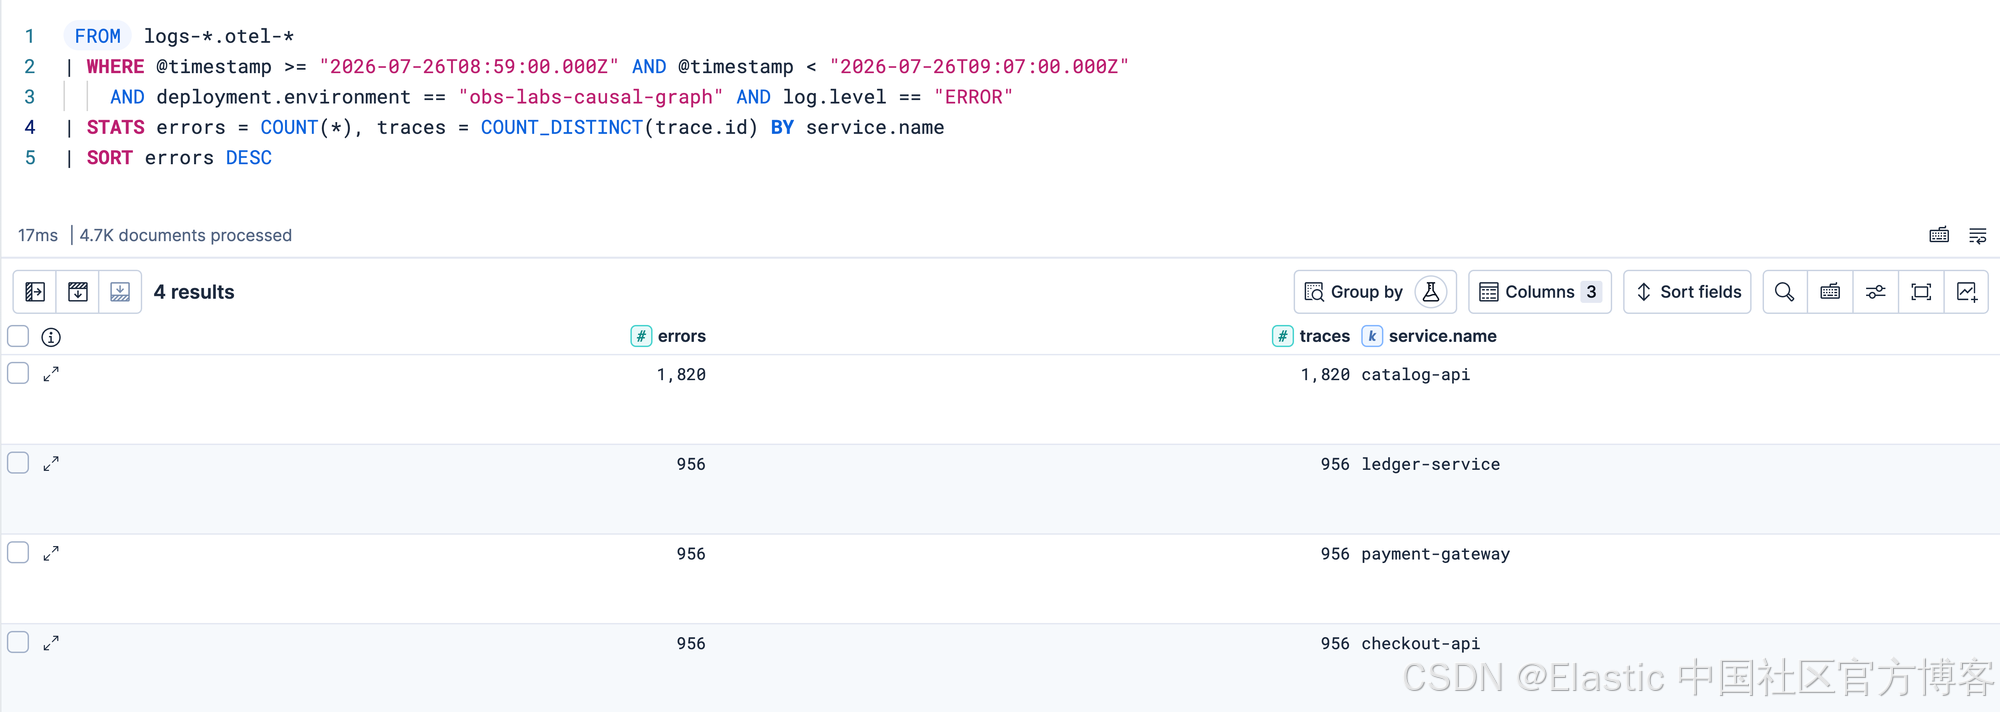catalog-api 以 1,820 条错误记录位居首位,几乎是其他任何服务的两倍,而且它的 3,345 个请求全部返回了 200。按照错误数量进行排序,实际上是按照日志记录的详细程度对服务进行排名,而这与故障从哪里开始毫无关系。
第 2 步:按 trace ID 对错误日志进行分组
按 trace.id 进行分组,并统计每个请求中记录错误的不同服务数量:
sql
`

1.  FROM logs-*.otel-*
2.  | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3.      AND deployment.environment == "obs-labs-causal-graph" AND log.level == "ERROR"
4.  | STATS services = COUNT_DISTINCT(service.name) BY trace.id
5.  | STATS traces = COUNT(*) BY services
6.  | SORT services ASC

`AI写代码
less
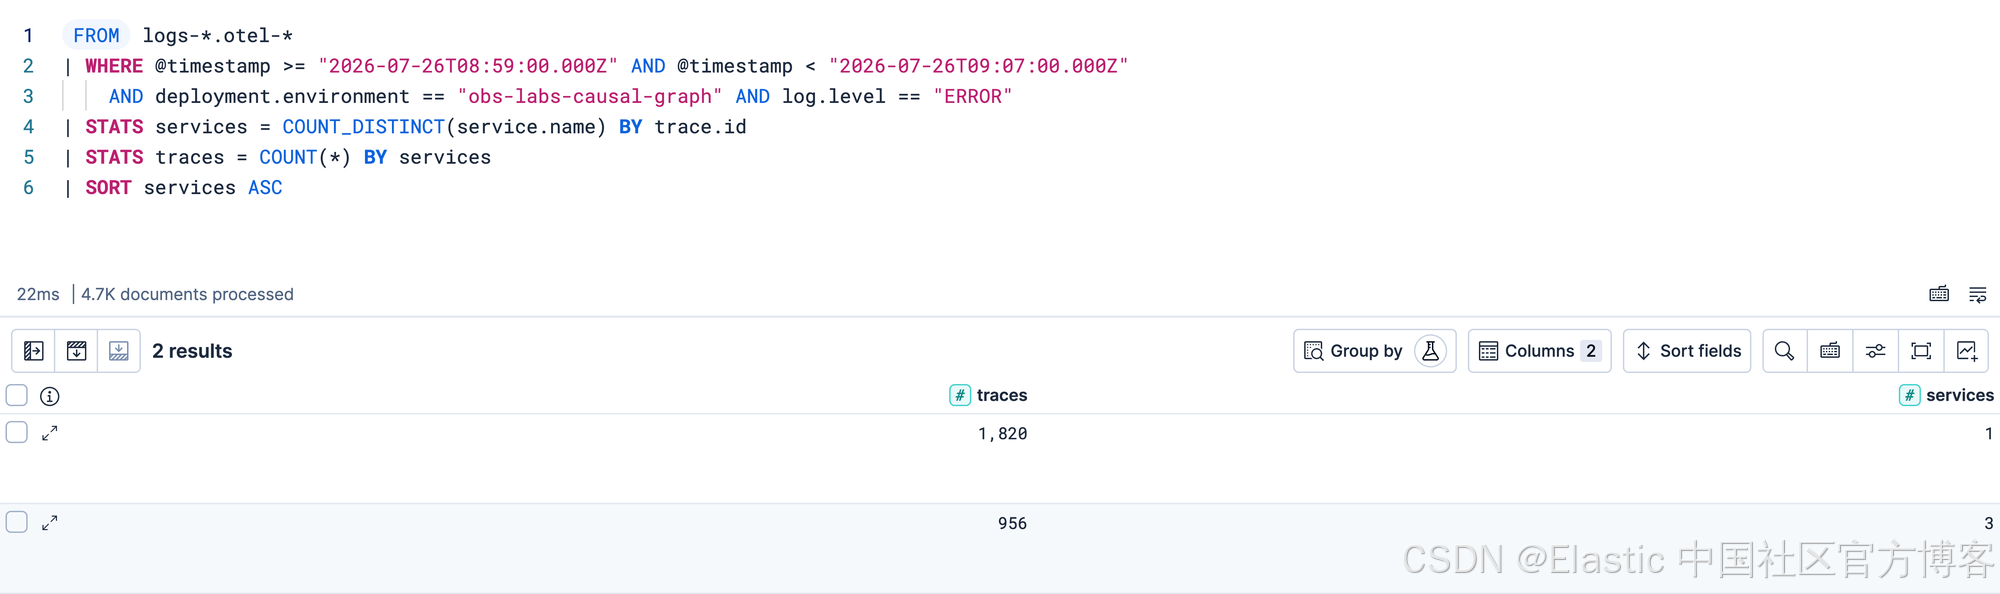这批数据分成两类。只有一个服务发生错误的 trace 是局部问题,没有向外传播;有三个服务发生错误的 trace 则属于级联故障。
| Trace 类型 | Trace 数量 | 记录错误的服务 |
|---|---|---|
| 单服务,从未传播 | 1,820 | catalog-api |
| 三服务级联 | 956 | checkout-api、ledger-service、payment-gateway |
catalog-api 没有出现在任何级联故障中,因此该查询会在无需任何人阅读消息的情况下,将这个错误量最高的服务排除在调查之外。
第 3 步:找出每个 trace 中最先发生故障的服务
在级联故障中,最先记录错误的服务就是候选根因。ES|QL 没有窗口函数,因此我们构建一个由时间戳和服务名称组成的可排序字符串,在每个 trace 中取最小值,然后再将服务名称截取出来:
sql
`
1. FROM logs-*.otel-*
2. | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3. AND deployment.environment == "obs-labs-causal-graph" AND log.level == "ERROR"
4. | EVAL marker = CONCAT(DATE_FORMAT("yyyy-MM-dd HH:mm:ss.SSS", @timestamp), "|", service.name)
5. | STATS origin_marker = MIN(marker), services = COUNT_DISTINCT(service.name) BY trace.id
6. | WHERE services > 1
7. | EVAL origin_service = SUBSTRING(origin_marker, 25)
8. | STATS cascade_traces = COUNT(*) BY origin_service
9. | SORT cascade_traces DESC
`AI写代码从 8.16.0 开始,MIN() 接受 keyword 字段,而格式化后的时间戳固定为 23 个字符,因此最早的标记在字典序上也是最小的标记。SUBSTRING(origin_marker, 25) 会跳过时间戳和分隔符。
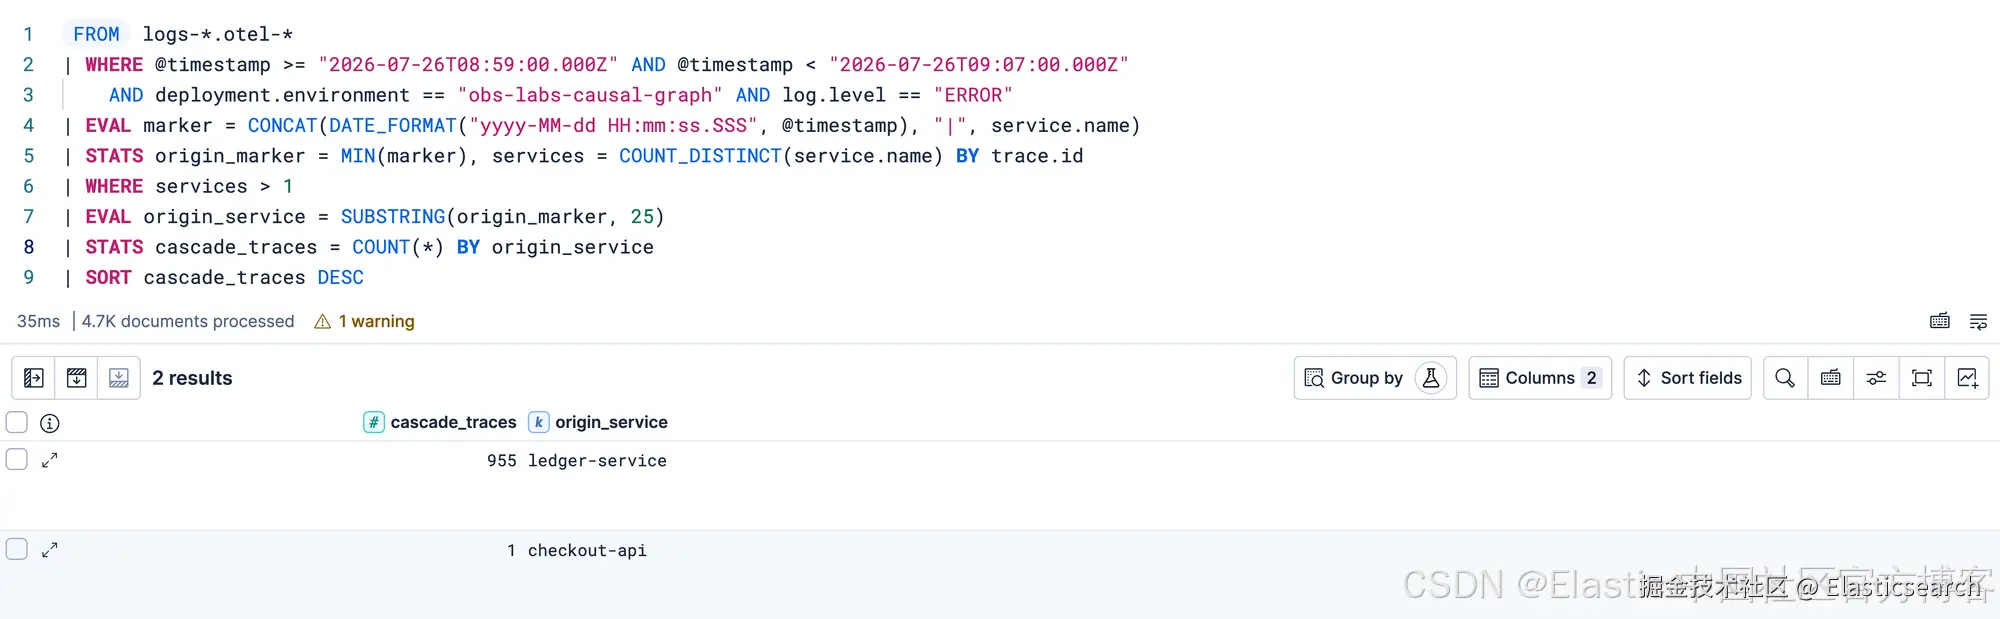
ledger-service 是 956 条级联故障中 955 条的起点,checkout-api 是其中 1 条的起点。
跨服务的时间戳排序有多可靠?
不要假设它可靠,而是进行测量:
less
`
1. FROM logs-*.otel-*
2. | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3. AND deployment.environment == "obs-labs-causal-graph" AND log.level == "ERROR"
4. | EVAL ms = DATE_FORMAT("yyyy-MM-dd HH:mm:ss.SSS", @timestamp)
5. | STATS spread_ms = DATE_DIFF("milliseconds", MIN(@timestamp), MAX(@timestamp)),
6. distinct_ms = COUNT_DISTINCT(ms),
7. services = COUNT_DISTINCT(service.name) BY trace.id
8. | WHERE services > 1
9. | STATS cascade_traces = COUNT(*),
10. median_spread_ms = MEDIAN(spread_ms),
11. max_spread_ms = MAX(spread_ms),
12. traces_with_a_collision = COUNT(*) WHERE distinct_ms < services
`AI写代码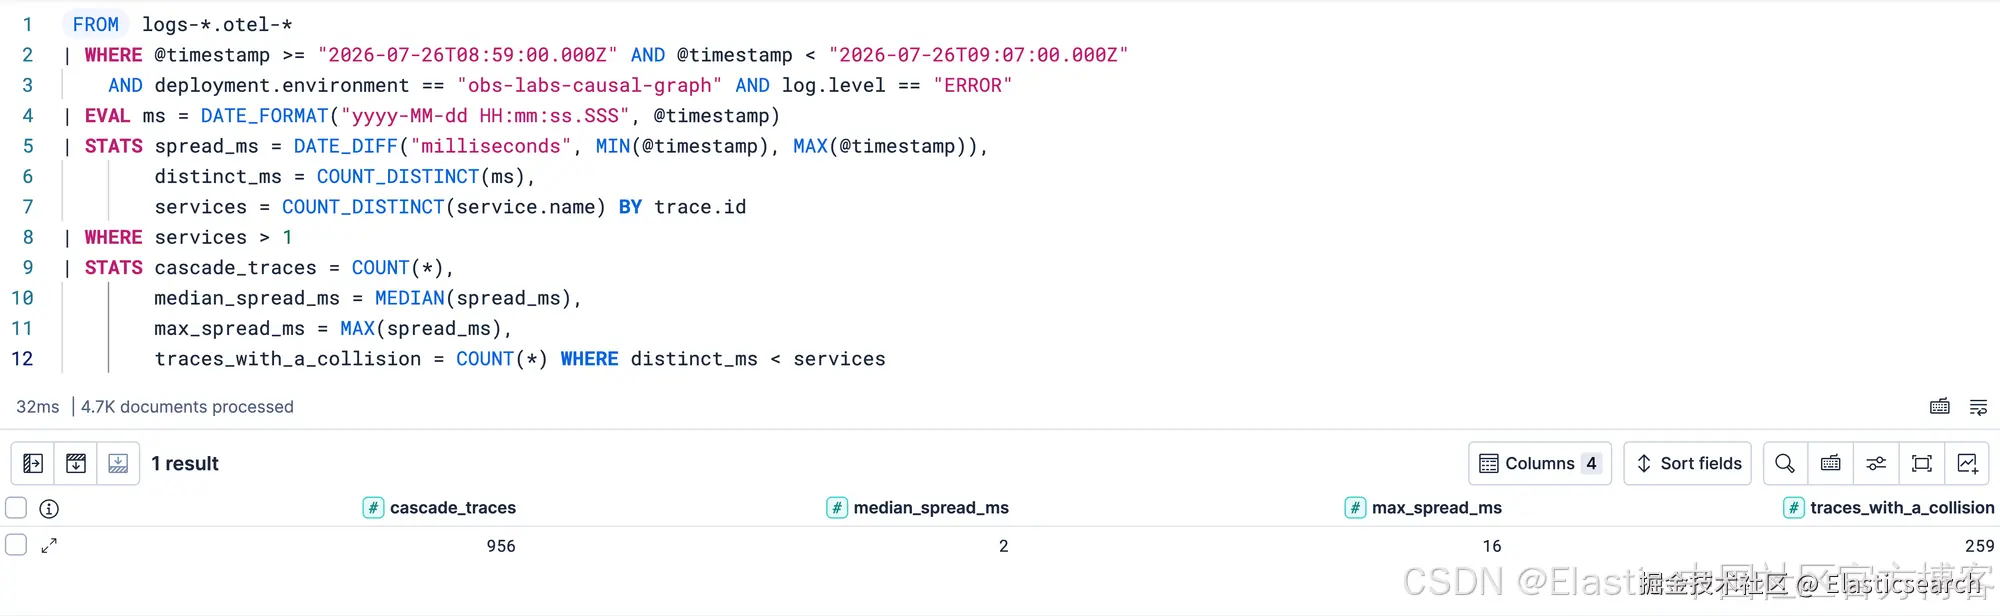
在 956 条级联故障中,第一个错误与最后一个错误之间的时间差中位数为 2ms ,最大值为 16ms,而 259 个 trace (占总数的 27%)至少包含一次毫秒级时间戳碰撞。之所以会如此频繁地发生碰撞,是因为这些调用跳转都是本地 HTTP 调用,而 @timestamp 只能精确到毫秒。
发生碰撞并不意味着结果一定错误。按字母顺序排序时,checkout-api 排在 ledger-service 之前,而 ledger-service 排在 payment-gateway 之前。当 ledger-service 和 payment-gateway 落在同一毫秒内时,MIN() 仍然会返回 ledger-service,而这正是正确的起点。只有 checkout-api 和 ledger-service 之间发生时间戳并列时,结果才会出错。这就是为什么 259 个 trace 存在碰撞,而其中只有一个报告了错误的起点。
在快速调用跳转中,以及主机之间的时钟偏差超过所测量的时间间隔时,时间戳排序的可靠性会下降。应将其视为一个强有力的提示,而不是确定性证据。
第 4 步:根据 upstream.service 构建因果边列表
upstream.service 字段记录调用方正在等待哪个依赖,因此包含该字段的每条错误记录都是一条有向边。使用一个 CONCAT 即可将这些边组合成一个边列表:
less
`

1.  FROM logs-*.otel-*
2.  | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3.      AND deployment.environment == "obs-labs-causal-graph"
4.      AND log.level == "ERROR" AND upstream.service IS NOT NULL
5.  | EVAL edge = CONCAT(upstream.service, " -> ", service.name)
6.  | STATS traces = COUNT_DISTINCT(trace.id), first_seen = MIN(@timestamp), last_seen = MAX(@timestamp) BY edge
7.  | SORT traces DESC

`AI写代码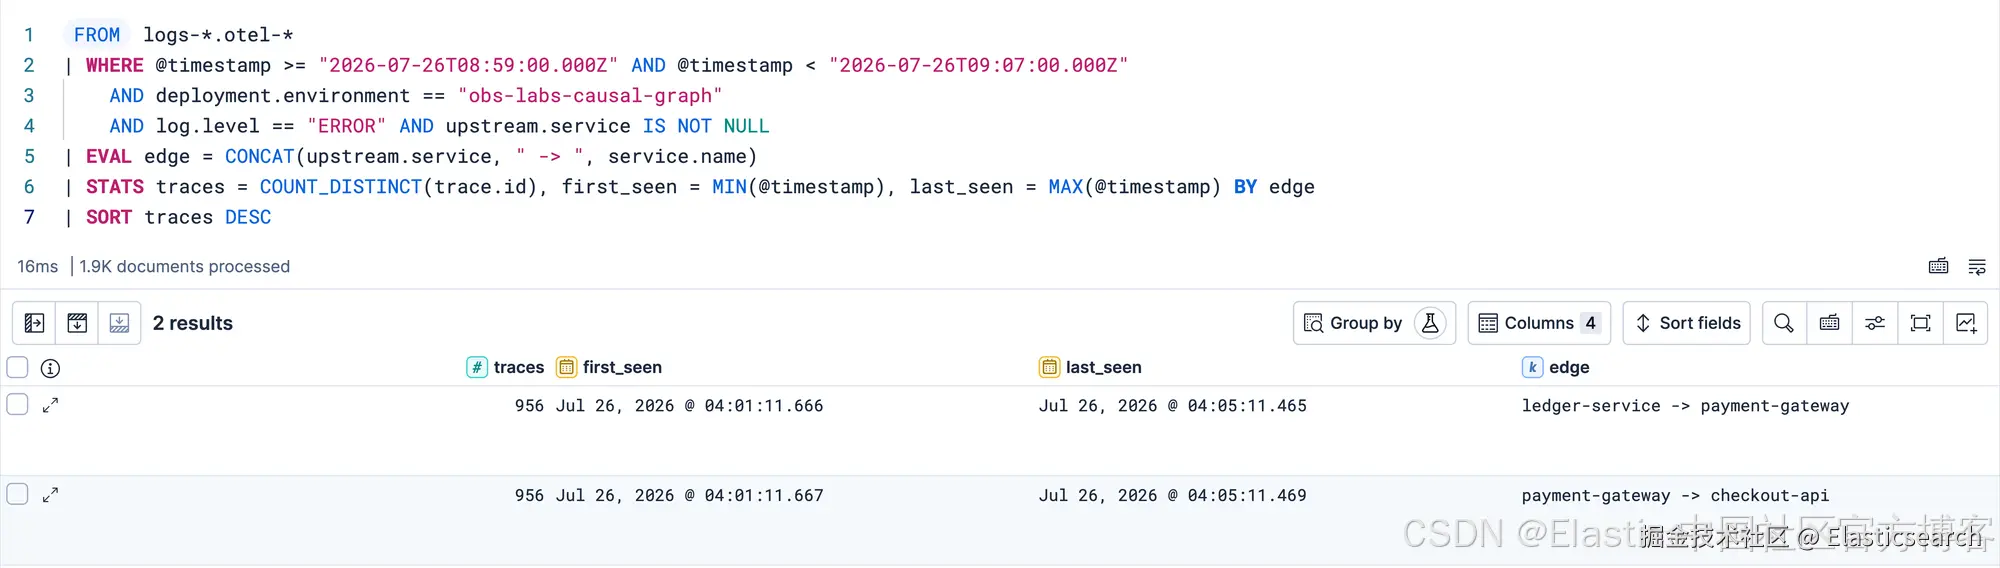
两条边均在全部 956 条级联故障中被观察到:
markdown
`

1.  ledger-service  -> payment-gateway   956 traces
2.  payment-gateway -> checkout-api      956 traces

`AI写代码
这个边列表不使用任何时间戳比较,因此既不需要时钟同步,也不需要处理并列情况。在全部 956 个 trace 中,它都与时间戳方法的结果一致,包括时间戳方法判断错误的那一个。
| 时间戳排序 | 声明的上游服务 | |
|---|---|---|
| 需要的代码更改 | 无 | 每条错误日志增加一个字段 |
| 本次运行中的正确结果 | 956 中有 955 个 | 956 中有 956 个 |
| 失败场景 | 调用跳转耗时低于 1 毫秒、时钟发生漂移 | 字段缺失 |
哪些服务在未指定上游服务的情况下发生故障?
图的根节点就是作为源出现、但从未作为目标出现的节点。通过查询哪些服务在发生故障时没有指定上游服务,可以找出候选根节点:
sql
`

1.  FROM logs-*.otel-*
2.  | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3.      AND deployment.environment == "obs-labs-causal-graph" AND log.level == "ERROR"
4.  | STATS errors = COUNT(*), traces = COUNT_DISTINCT(trace.id),
5.          names_an_upstream = COUNT_DISTINCT(upstream.service) BY service.name
6.  | WHERE names_an_upstream == 0
7.  | SORT errors DESC

`AI写代码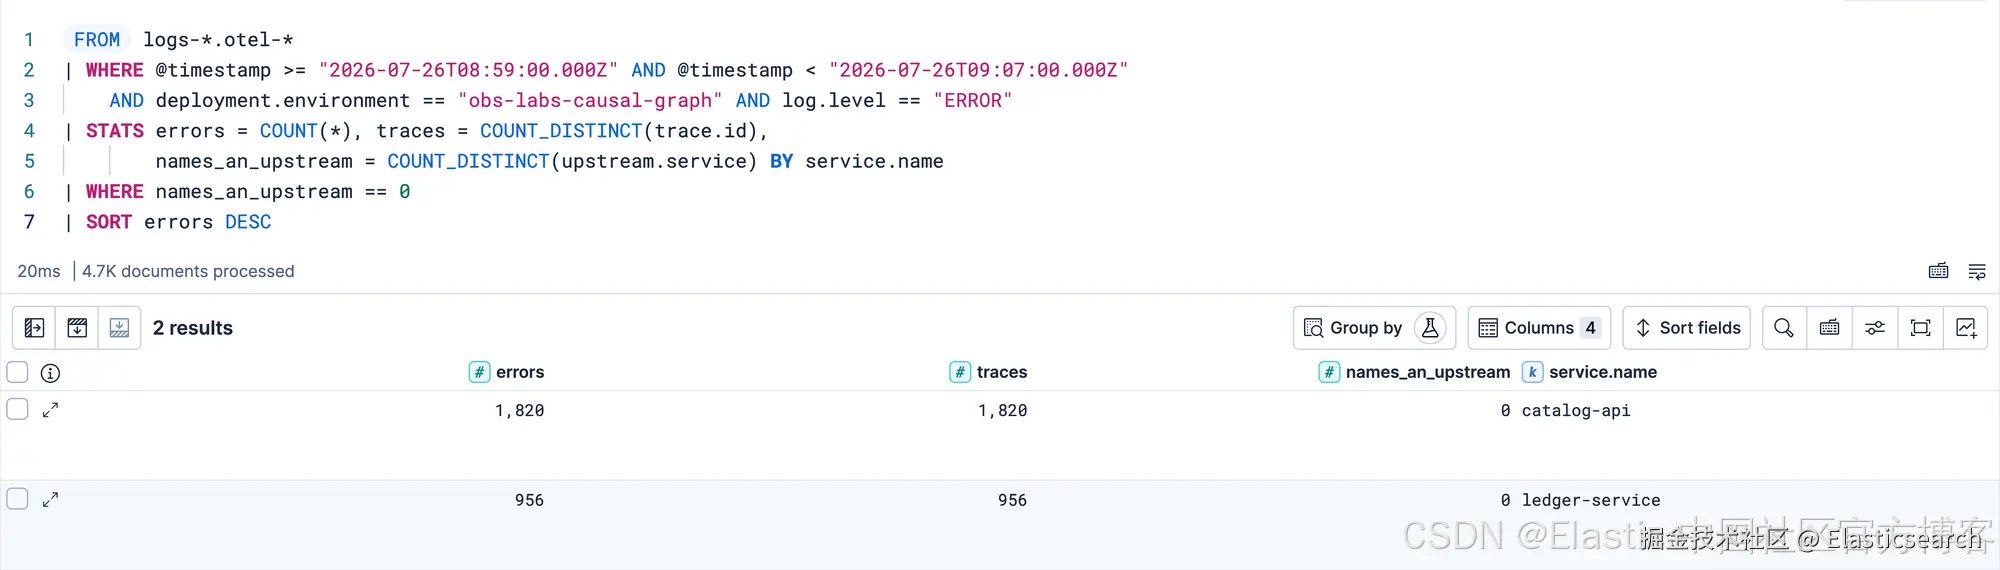
这会返回 catalog-api 和 ledger-service。将其与第 2 步中的级联故障参与服务取交集后,只剩下一个服务:ledger-service。
这两个查询生成的是某个故障事件的传播结构,而不是一个可重复使用的因果模型。这些边不包含任何概率信息,也无法说明该时间窗口内未发生的故障。它们是观测结果,并且只适用于你所查询的这些 trace。
根因服务报告了什么
现在读取该服务报告的内容,同时保留连接池的数值,让证据能够随着故障模式一起传递:
less
`
1. FROM logs-*.otel-*
2. | WHERE @timestamp >= "2026-07-26T08:59:00.000Z" AND @timestamp < "2026-07-26T09:07:00.000Z"
3. AND deployment.environment == "obs-labs-causal-graph"
4. AND log.level == "ERROR" AND service.name == "ledger-service"
5. | STATS events = COUNT(*), first_seen = MIN(@timestamp), last_seen = MAX(@timestamp)
6. BY error.kind,
7. db.connection_pool.size,
8. db.connection_pool.available
9. | SORT events DESC
`AI写代码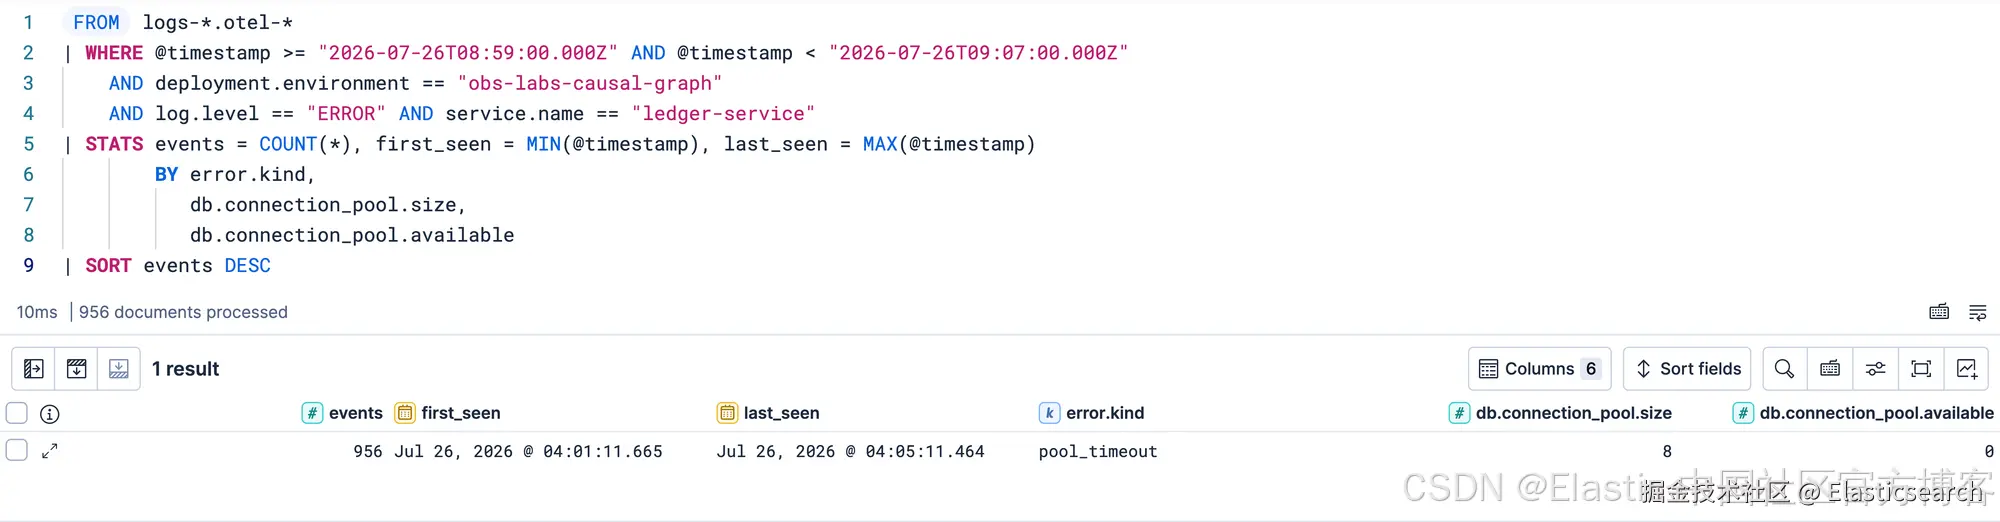
在全部 956 个故障事件中,只有一种故障模式:pool_timeout。它贯穿整个四分钟的饱和期,其中 db.connection_pool.size 为 8,db.connection_pool.available 为 0。下一条查询会完整显示与之对应的消息:
arduino
`connection pool exhausted, no connection available after 250ms`AI写代码展开一个三个错误共享同一毫秒时间戳的 trace,可以看到即使不依赖时间戳,整个故障链仍然完整:
sql
`

1.  FROM logs-*.otel-*
2.  | WHERE trace.id == "f9b32dca62c1e142537413a047fb9b69"
3.  | KEEP @timestamp, service.name, log.level, message, upstream.service
4.  | SORT @timestamp ASC

`AI写代码
less
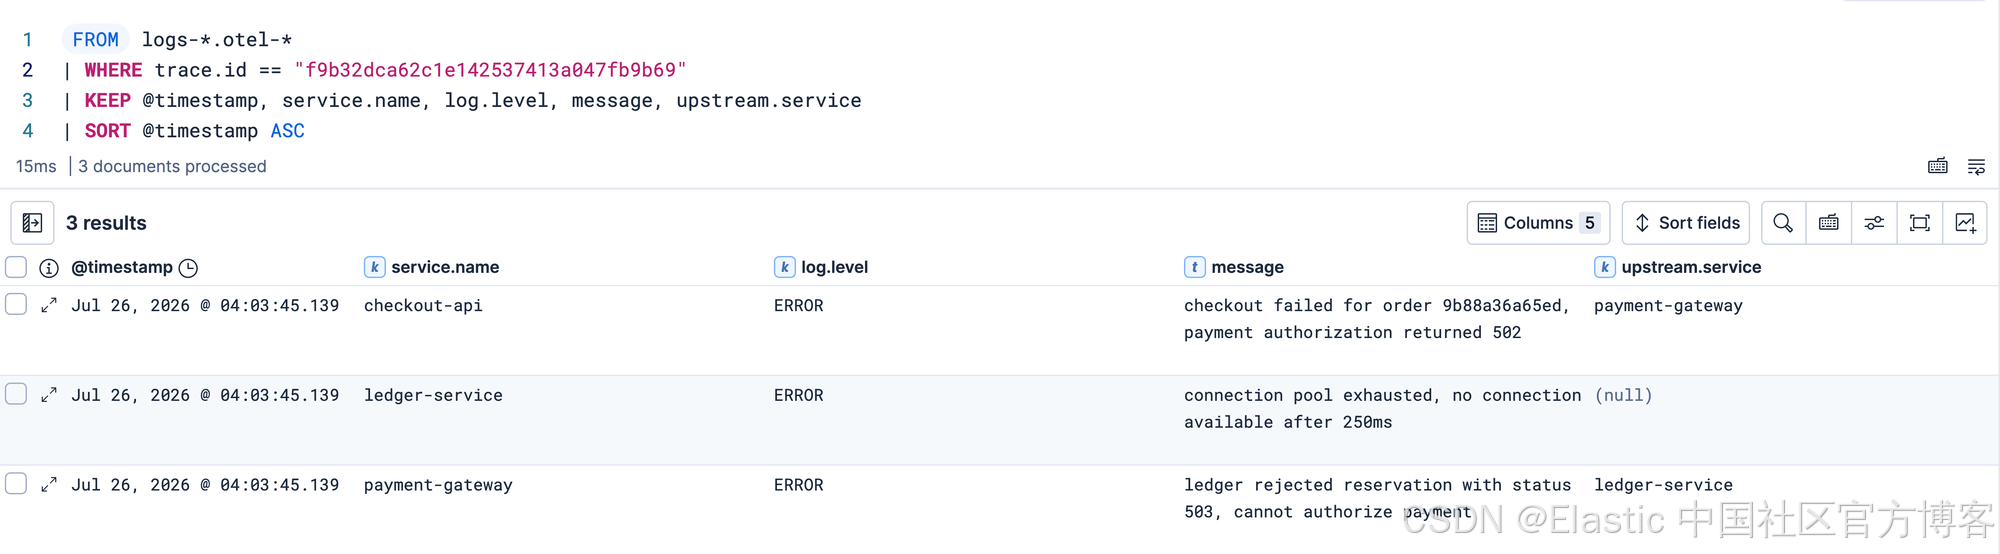upstream.service 对 ledger-service 显示为 (null),对 payment-gateway 显示为 ledger-service,对 checkout-api 显示为 payment-gateway。
为错误日志添加 trace ID 和结构化字段
这些查询需要你的日志具备三项内容,其中只有一项需要付出额外工作:
-
每条记录都包含
trace.id。 OpenTelemetry 自动 instrumentation 会为活动 span 内产生的日志自动提供该字段。访问日志和后台线程不在这个范围内。本实验中的 Werkzeug 访问日志没有 trace 上下文,因此无法用于关联分析。 -
使用结构化字段,而不是格式化字符串。 将
error.kind作为字段,可以统计不同的故障模式。而将相同的词写在句子中则无法做到这一点。 -
在错误中标明上游依赖。 当依赖发生故障时,你的服务记录错误日志,只需在其中增加一个键
upstream.service即可。
本实验复现的模式在生产环境的故障事件中很常见:吸收上游故障所产生的溢出流量的组件,记录的错误往往比真正引发故障的组件更多。同样的排序问题也适用于自动化调查,在这种场景中,trace 范围内的证据可以让根因结论能够通过具体的记录和查询进行验证。
结论:日志证明了什么,而指标无法证明什么
指标报告三个服务都以 19.1% 的故障率发生故障。错误量则报告 catalog-api 存在问题,但实际上它运行正常。将相同的 4,688 条日志记录按 trace.id 分组后,我们隔离出 956 条级联故障,确定 ledger-service 是它们的起点,并返回了解释故障原因的消息。
有两种技术可以得到这一结果。按时间戳排序无需修改代码,在 956 条 trace 中有 955 条判断正确,唯一的错误是由毫秒级时间戳并列造成的。读取声明的 upstream.service 字段则需要在错误日志中增加一个额外的键,并且在每条 trace 中都判断正确。
这两种方法都不需要服务依赖模型,而且如果日志没有 trace.id,两种方法都无法发挥作用。这个字段就是全部投入。
资源
-
配套笔记本,用于重现故障事件并运行本文中的每条查询。
-
使用 ES|QL 调试 LLM 延迟、成本和 GPU 饱和问题,了解更多针对 OpenTelemetry 数据的查询模式。
-
EDOT Python 配置参考,用于控制服务导出的信号。
在你自己的数据上尝试从日志进行根因分析
-
针对你自己的
logs-*数据运行第 2 步中的查询,并检查有多少故障 trace 包含多个发生错误的服务。 -
检查一个服务的错误日志,确认其中是否标明了发生故障的依赖。