标准卷积和转置卷积
学 CNN 的时候,标准卷积大概是第一个真正弄懂的东西,再往后走会陆续碰到转置卷积和其它卷积。它们名字里都带卷积,公式长得也像,但干的事情差得挺远,刚接触时很容易混。
先给一张速览表,脑子里有个整体印象再往下看:
| 标准卷积 | 转置卷积 | |
|---|---|---|
| 作用 | 提取特征 / 下采样 | 上采样 / 放大尺寸 |
| 要点 | 滑动窗口,核不翻转;逐元素乘再求和;打补丁式地看局部 | 每个输入像素铺一个核块;重叠处累加;是标准卷积的逆操作 |
一、这两种卷积分别来自哪
标准卷积。 卷积这个概念本身很老,但把它作为神经网络的基本算子,奠基性工作是 LeCun 那一批人。
1989 年他们把手写数字识别和反向传播、卷积结合起来,1998 年的 LeNet-5 已经是现代 CNN 的雏形。2012 年 AlexNet 之后,标准卷积基本成了计算机视觉的默认算子,VGG、ResNet 都在用。
顺带说一句,深度学习里说的"卷积",严格讲是互相关(cross-correlation),核不翻转。这个后面会专门讲。
转置卷积。 它的名字有很多版本:transposed convolution、deconvolution、fractionally-strided convolution。
名字乱是有道理的,因为它数学上就是标准卷积的"转置"------反向传播求梯度时自然冒出来的那个操作,所以叫转置卷积最准确。它不是什么被单独"发明"出来的东西。
几个关键节点:Zeiler 在 2010 和 2014 年最早把它用在特征可视化和反卷积网络里;2015 年 FCN 用它做语义分割的上采样,从此火起来;2016 年 Odena 系统指出了它会带来棋盘效应。棋盘这个问题很关键,后面单独讲。
二、标准卷积
用一个小窗口(卷积核)在图上从左到右、从上到下滑,每滑到一个位置,把窗口里的像素和核对应相乘再求和,得到一个输出值。它管用的原因在于两点:每个输出只看一个小邻域而不是全图;同一个核滑遍全图,参数不随位置变。
输入矩阵X:
X=1324
卷积核W:
W= 101210101
设 stride=1、padding=1。padding=0 时 3×3 的卷积核放到 2×2 的图上根本盖不住,所以要先把图周围补一圈 0,补完之后变成 4×4:
Xpad= 0000013002400000
输出尺寸公式:
out=⌊stridein+2×padding−kernel⌋+1
代入本次的参数(in=2,padding=1,kernel=3,stride=1):out = ⌊(2+2×1−3)/1⌋ + 1 = 2,也就是输出 2×2。
要得到输出矩阵的每个位置的值,就是把卷积核盖在 Xpad 上、从左上角开始逐格滑动。
第一次运算 (卷积核盖在最左上角、对应输出矩阵位置 (0,0)),核覆盖的是 Xpad 的前 3 行、前 3 列,切出来的 3×3 窗口是:
窗口(0,0)= 000013024
(因为 Xpad 是 4×4,左上角的核只压住它的第 0--2 行、第 0--2 列,最右一列和最下一行这次用不到。)
然后做的是逐元素乘再求和 :把这个窗口的 9 个元素,和卷积核 W 里同一位置的 9 个元素一一相乘,再全部加起来。写成式子就是下面这样(第一行是窗口最上面一行与核最上面一行相乘,依此类推):
+ + 1×0+2×0+1×00×0+1×1+0×21×0+0×3+1×4=5
注意这里的乘法是点乘,不是线代里的矩阵乘法。
接着卷积核向右滑一格(对应输出矩阵位置 (0,1)),覆盖 Xpad 的第 0--2 行、第 1--3 列:
窗口(0,1)= 013024000
+ + 1×0+2×0+1×00×1+1×2+0×01×3+0×4+1×0=5
再向下滑一格(对应输出矩阵位置 (1,0)),覆盖第 1--3 行、第 0--2 列:
窗口(1,0)= 000130240
+ + 1×0+2×1+1×20×0+1×3+0×41×0+0×0+1×0=7
最后到右下角(对应输出矩阵位置 (1,1)),覆盖第 1--3 行、第 1--3 列:
窗口(1,1)= 130240000
+ + 1×1+2×2+1×00×3+1×4+0×01×0+0×0+1×0=9
所以输出是:
Output=5759
有两个地方需要澄清一下:
第一,卷积核不翻转。数学教材里的卷积要求核翻转 180°,但深度学习里做的是互相关,不翻转。PyTorch、TensorFlow 的 conv 都是不翻转的,所以别纠结要不要先把核转一下,不用。
第二,逐元素乘之后再求和。窗口和核是"对应位置相乘",然后把 9 个乘积加起来变成一个数。这其实不是矩阵乘法,是点乘加归约。写成矩阵形式是 Wᵀx,但落到计算就是逐元素乘加。
三、转置卷积
标准卷积是把尺寸变小,转置卷积反过来,把尺寸变大。
最直观的理解方式是:每个输入像素,在输出图上"盖"一个和核一样大的方块,方块里每个位置填"输入值 × 对应核权重";如果多个输入像素的方块重叠了,重叠处就把值加起来。
**标准卷积是核滑过图,转置卷积是图铺到核上。**视角反过来了,这就是它名字里"转置"的来历。
输出尺寸公式(跟标准卷积长得像但方向相反):
out=(in−1)×stride+kernel−2×padding
还是 2×2 输入、3×3 核,这次设 stride=2。
X=1324,W= 101210101
代入本次参数(in=2,stride=2,kernel=3,padding=0):out = (2−1)×2 + 3 − 0 = 5,也就是输出 5×5。
此时可以得知输出矩阵大小为5×5,只不过该矩阵里面的元素值都是0。 需要做的是往空矩阵里填值,依次把输入矩阵的值铺到输出矩阵上。
每个输入像素 (i,j) 铺的位置,是左上角在 (i×stride, j×stride) 处的一个 3×3 块,块里每个元素的值是「输入值 × 核里同一位置的元素」,也就是用输入值去乘卷积核。
第 1 步:把每个输入像素铺成一个块。
输入像素 (0,0),值 1,左上角放在 (0,0),铺下 1×W:
1×W= 1×11×01×11×21×11×01×11×01×1 = 101210101
输入像素 (0,1),值 2,左上角放在 (0,2),铺下 2×W,和左边的块重叠一列:
2×W= 202420202
输入像素 (1,0),值 3,左上角放在 (2,0),铺下 3×W,和上面的块重叠一行:
3×W= 303630303
输入像素 (1,1),值 4,左上角放在 (2,2),铺下 4×W,四角都重叠:
4×W= 404840404
第 2 步:把每个输入像素的贡献完整算出来,再叠加。
前面算出的 4 个 3×3 块,只是每个输入像素的"贡献片段"。它们位置不同、互相重叠,要全部叠到一张 5×5 的画布上、重叠处相加,才是最终输出。
最不容易出错的做法是:对每个输入像素,先单独算出它对整张 5×5 输出图的贡献,然后 4 张贡献图逐位置相加。
输入像素 (0,0),值 1,块左上角在 (0,0),对 5×5 的贡献是:
C00= 1010021000101000000000000
输入像素 (0,1),值 2,块左上角在 (0,2),对 5×5 的贡献是:
C01= 0000000000202004200020200
输入像素 (1,0),值 3,块左上角在 (2,0),对 5×5 的贡献是:
C10= 0030300630003030000000000
输入像素 (1,1),值 4,块左上角在 (2,2),对 5×5 的贡献是:
C11= 0000000000004040084000404
第 3 步:4 张贡献图逐位置相加。
C00+C01+C10+C11= 10403216303010074284020604
核对几个位置,看看每个数是怎么加出来的:
- (0,0) = 1 :只有 C00 有值(1),其余三张都是 0 → 1。
- (0,2) = 3 : C00 给 1, C01 给 2,其余为 0 → 1+2 = 3。
- (2,2) = 10 :四张都有值, C00 的右下角 1、 C01 的左下角 2、 C10 的右上角 3、 C11 的左上角 4 → 1+2+3+4 = 10。这里是四块交汇处,被盖了 4 次。
- (2,0) = 4 : C00 给 1, C10 给 3 → 1+3 = 4。
- (4,4) = 4 :只有 C11 的右下角 4 → 4。
把值矩阵和覆盖次数放一起看,就能理解为什么有的位置亮有的位置暗:
覆盖次数= 1121111211224221121111211 输出值= 10403216303010074284020604
覆盖次数是 4 的位置(如 (2,2)),值由 4 个块累加,最大;
覆盖次数是 1 的位置,只有 1 个块的贡献;
覆盖次数是 2 的位置,夹在中间。
同一张输出图上,不同位置的累加次数不一样,值自然有大有小------规律性的一亮一暗,就是棋盘格的来源。
棋盘效应
这是转置卷积最要命的问题。理解它的关键,在于同一个输出位置,可能被不同数量的块盖到。盖到的块越多,叠加的值越大;盖到的越少,值越小。这种覆盖次数的不均匀,就是棋盘的根源。
先看一维,最简单。输入是 a b c ,stride=2,每个元素向右铺一个长度为 3 的块:
- 步长:2。意思是,每处理完一个输入元素,下一个输入元素的起始位置要向后移动 2 格。
- 块大小 :3。意思是,每个输入元素
a, b, c都会变成一个长度为 3 的连续块(复制成 3 份,如[a a a])。
less
输入:   a       b       c
块:    [a a a] [b b b] [c c c]
位置:  0 1 2 3 4 5 6
计算每个块的覆盖范围(位置索引)
我们需要把这些块放到一个一维的坐标轴上。公式通常是:
起始位置 = 输入索引 × 步长
- 元素 a (输入索引 0) :
- 起始位置 = 0×2=0
- 块长度 = 3
- 覆盖位置:0, 1, 2
- 贡献:位置 0, 1, 2 各加 1 次。
- 元素 b (输入索引 1) :
- 起始位置 = 1×2=2
- 块长度 = 3
- 覆盖位置:2, 3, 4
- 贡献:位置 2, 3, 4 各加 1 次。
- 元素 c (输入索引 2) :
- 起始位置 = 2×2=4
- 块长度 = 3
- 覆盖位置:4, 5, 6
- 贡献:位置 4, 5, 6 各加 1 次。
数一下每个位置被几个块盖到:
| 位置 | 0 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|---|
| 被谁盖到 | a | a | a+b | b | b+c | c | c |
| 覆盖次数 | 1 | 1 | 2 | 1 | 2 | 1 | 1 |
一维的覆盖次数就是 1, 1, 2, 1, 2, 1, 1 这样波动。
二维是两个方向相乘:一个输出位置横向被盖 k 次、纵向被盖 m 次,就一共被 k×m 个块盖到。所以 3×3 核、stride=2 时,覆盖次数矩阵是(详情参考上述第三节):
覆盖次数= 1121111211224221121111211
这些覆盖次数,落到图像上就是明暗。 块要相加,覆盖 4 次的位置是 4 个块的贡献累加,覆盖 1 次的位置只有 1 个块的贡献。
下图是转置卷积在纯色块上的输出,网格纹理很明显。(注意 :并不是第三节用于举例的矩阵所对应的棋盘效应效果图,因为该例子值太杂且尺寸太小,生成的效果图不明显)。
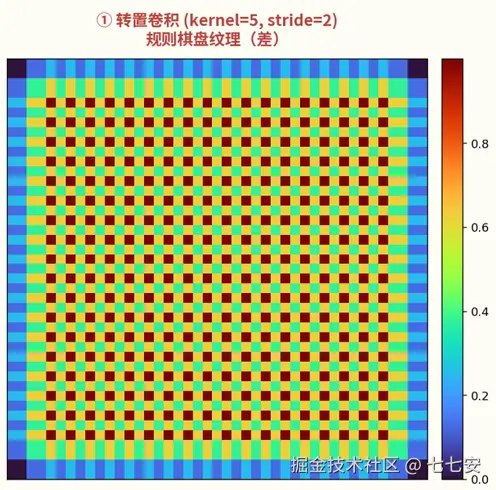
图 1:转置卷积棋盘效应图
反过来想:什么时候没有棋盘? 当核尺寸能被步长整除时(比如 kernel=4、stride=2),相邻块刚好首尾相接、不重叠,覆盖次数处处相等,棋盘就消失了。所以棋盘的本质是核大于步长、且两者不整除------块之间既重叠又不均匀,才拼出格子。
四、两者放在一起看
| 对比项 | 标准卷积 | 转置卷积 |
|---|---|---|
| 解决的问题 | 特征提取 | 尺寸放大(上采样) |
| 核是否翻转 | 不翻转 | 不翻转 |
| 乘法类型 | 点乘 + 求和 | 点乘 + 累加 |
| 输出尺寸公式 | (in+2p-K)/s+1 | (in-1)×s+K-2p |
| 归一化 | 固定(窗口大小) | 无 |
| 额外输入 | 无 | 无 |
| 典型伪影 | 无明显 | 棋盘效应 |
| 数据要求 | 完整 | 完整 |
同一组输入,两种输出。 同样是 2×2 输入、同一个 3×3 核:
标准卷积(s=1, p=1),输出 2×2:
Output=5759
转置卷积(s=2),输出 5×5:
Output= 10403216303010074284020604
尺寸上的差异最能说明问题:标准卷积输出尺寸保持或缩小,转置卷积是放大。这就是它们在网络里角色不同的直接体现。
怎么选:
| 你要干什么 | 用哪个 |
|---|---|
| 提取特征、下采样 | 标准卷积 |
| 放大尺寸、上采样 | 转置卷积(受不了棋盘就改用插值上采样 + 卷积) |
| 既要放大又要平滑 | 插值上采样 + 标准卷积 |