论文题目: Object-Driven Multi-Layer Scene Decomposition From a Single Image(从单张图像出发的目标驱动多层场景分解)
会议: ICCV 2019
摘要: 本文研究如何预测图像可见内容背后的颜色与深度信息。作者希望从单张 RGB 图像构建 Layered Depth Image(LDI),用多层结构表示场景并包含原本被遮挡的区域。不同于已有工作,本文允许层数随场景自适应变化,并引入语义编码,以更好地补全部分遮挡的目标。方法以目标实例为驱动,尤其改善被遮挡中间目标的预测。框架分两步:首先分别补全每个目标的颜色和深度,同时估计场景布局;随后依据预测层重新组合场景,并约束重组结果与原始输入结构一致。该表示可用于 3D Photography、Novel View Synthesis 和 Diminished Reality,而输入只需一张 RGB 图像。
一、研究背景与核心问题
单张 RGB 图像只能看到当前视角下的表面,但机器人抓取、自动驾驶和 3D Photography 都希望进一步理解被遮挡区域。单一深度图无法保存遮挡后的几何与纹理,而完整 3D 重建又往往带来更高的计算和存储成本。Layered Depth Image(LDI) 提供了一个折中方案:沿每条视线保存多层 RGB-D,第一层是当前最前面的表面,第二层记录其后的下一表面,必要时还可以继续向后扩展。
此前从单张图像预测 LDI 的方法通常只输出固定两层,即 foreground/background。作者认为这会遇到两个问题:真实场景的遮挡层数并不固定;同时,直接做前景/背景预测也没有充分利用目标类别信息。人类补全一个被挡住的 chair 或 table 时,会依赖"它是什么"的语义先验,而不仅仅依赖可见像素。
因此本文的核心思路是:先把场景拆成"完整物体 + 无物体的场景布局",再依据深度将这些结果重新组合成多层表示。 场景检测出多少实例,就可以产生多少对象层,因此层数不再预先写死。
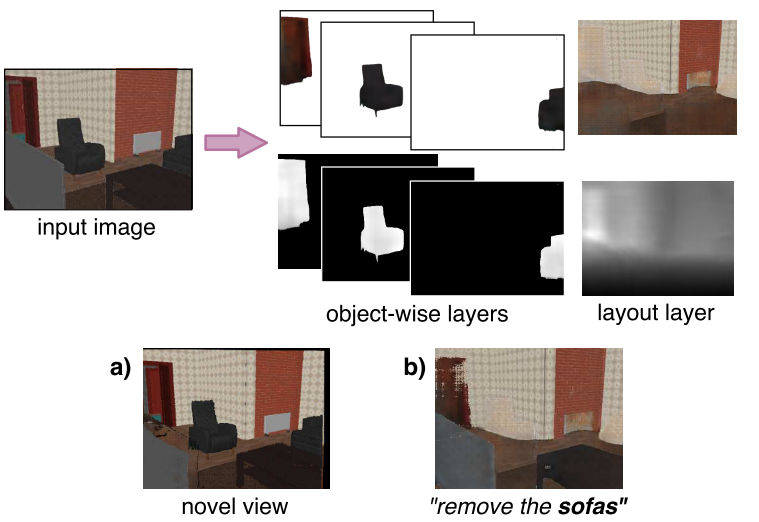
论文 Figure 1:目标驱动场景分解及其 View Synthesis、Object Removal 应用
Figure 1 展示了最终输出:每个对象都有独立 RGB-D 层,另外还有 layout layer。正因为对象已经分离,模型既能改变观察视角,也能直接删除指定对象。
二、方法整体框架:先逐物体补全,再重新组合场景
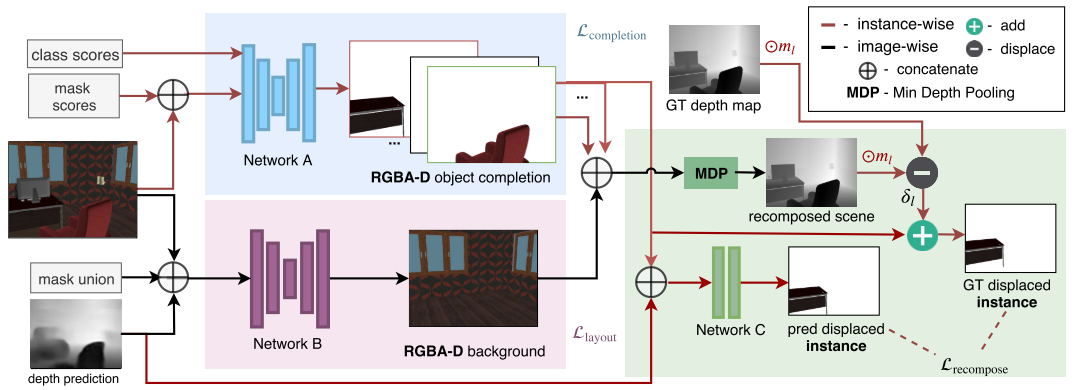
论文 Figure 2:Object-Driven Multi-Layer Scene Decomposition 整体框架
Figure 2 重点看三个模块:Network A 完成每个目标,Network B 预测 scene layout,Minimum Depth Pooling(MDP)负责重新组合。
首先,Mask R-CNN 为每个实例提供 mask probability 和 class score。Network A 对检测到的物体逐实例运行,预测完整的 RGBA-D;其中 RGB 表示纹理,A 表示物体区域,D 表示深度。与此同时,Network B 根据输入 RGB、预估深度以及所有实例 mask 的 union,预测移除物体后的场景布局,包括墙、地板、天花板、窗户等结构。
整体流程可以概括为:
输入 RGB → 多个完整 Object RGBA-D + Layout RGBA-D → 深度排序与重组 → Multi-Layer LDI
2.1 训练数据如何获得?
这项任务缺少大规模遮挡后真值。作者利用包含 3D mesh、instance 和 semantic annotation 的 SunCG 与 Stanford 2D-3D 自动渲染监督数据。每个当前视角可见的实例被单独渲染,提取完整颜色、mask、depth 和类别;结构元素则合并成 layout layer。只有当前视角至少部分可见的实例才进入该视角的多层表示,避免把隔壁房间等完全不可见内容错误加入训练数据。
与基于相邻帧 warping 的方式相比,mesh 能直接提供遮挡后的完整物体信息,因此更适合训练 object-wise completion。
三、Object Completion:利用 Mask 和类别先验补全遮挡目标
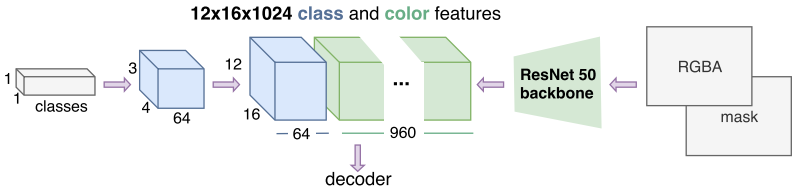
论文 Figure 3:Object Completion Encoder 与语义类别分支
Network A 有两条输入路径:图像与 mask confidence 进入 ResNet-50 图像分支,class probabilities 进入类别分支,两者在 bottleneck 拼接,再由 decoder 输出五通道 RGBA-D。这里引入类别信息的目的很明确:当一个目标大部分被遮挡时,仅靠局部纹理有很多可能解,而类别能够提供"这个物体通常长什么样"的先验。
训练时,作者先根据 IoU 将预测 mask 与 ground-truth instance 匹配,并舍弃 IoU < 0.3 的错误对应。随后采用加权 L1 completion loss:
其中 (y) 是完整 RGBA-D 真值,() 是预测结果。作者令可见物体及邻域的权重为 0.7,被遮挡区域提高到 1.5,其余区域仅为 0.2,因此训练会更关注真正需要 hallucination 的区域。
作者还增加了一个 auto-encoder 预训练阶段:只使用完整可见、未碰到图像边界的物体,让网络先学习完整 RGBA-D 的 latent representation,再冻结 decoder 并训练 completion encoder。直观理解就是:先学会"完整物体应该长什么样",再让被遮挡输入映射到这个完整物体空间。
四、Layout Prediction 与 MDP:让独立预测满足全局深度关系
Network B 使用带 skip connection 的 U-Net 预测 object-free layout,输入包括 RGB、单目 depth prior 和所有 instance mask 的 union。为了同时保持颜色、深度和边缘结构,作者组合 reconstruction loss、VGG-16 第一 block 的 perceptual loss 与 adversarial loss:
其中 (),(
)。perceptual loss 主要帮助保持房间轮廓等低层边缘。
真正决定多层表示是否合理的是 Minimum Depth Pooling(MDP)。它将所有 object layer 和 layout layer 拼接,在每个像素选择 depth 最小、即距离相机最近的 RGBA-D,重新构成第一层。理想情况下,这个重组结果应与原始输入及其可见深度一致。
由于各物体独立预测的深度可能存在整体偏移,作者进一步通过 Network C 学习每个实例的 depth displacement,并使用 re-composition loss () 校正。于是模型形成一个闭环:
独立补全 → 深度重组 → 检查能否恢复原场景 → 反向校正各层深度。
五、实验结果与消融分析
5.1 实验设置
实验使用 SunCG 和 Stanford 2D-3D 。SunCG 采用 11k 图像训练、2k 测试;Stanford 2D-3D 筛选出约 14k 有较好真值覆盖的图像,其中 13k 训练、1k 测试。测试阶段实例 mask 和类别来自 Mask R-CNN,而不是 ground truth;单目 depth prior 来自已有 depth prediction 模型。LDI Prediction 主要使用 MPE 和 RMSE ,View Synthesis 另外使用 SSIM。
5.2 SunCG:多层表示与核心消融
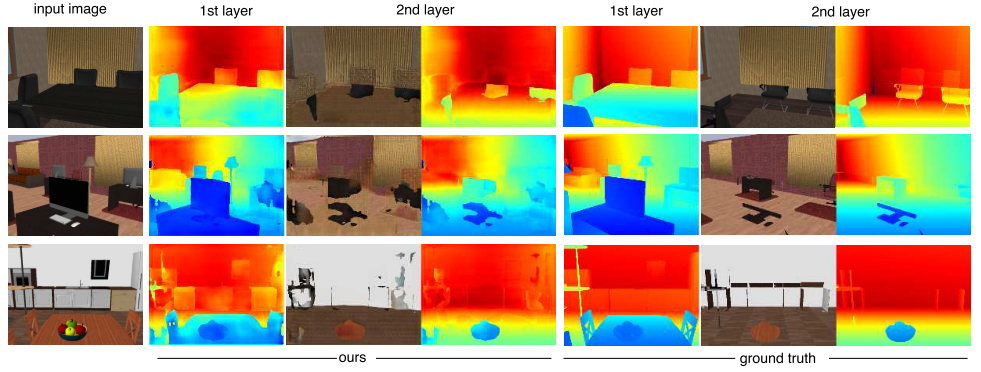
论文 Figure 4:SunCG 上前两层 LDI 的定性预测
Figure 4 重点看第二层。它需要恢复第一层后方的物体或布局,而且场景中确实存在"前景物体---中间物体---背景"的多级遮挡,这说明固定 foreground/background 并不足够。
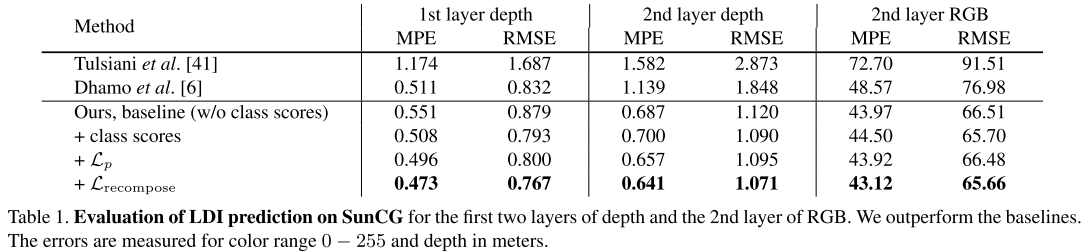
论文 Table 1:SunCG 上 LDI Prediction 主实验与消融
完整模型的第一层 depth MPE/RMSE 为 0.473/0.767 ,第二层 depth 为 0.641/1.071 ,第二层 RGB 为 43.12/65.66。作为对比,Dhamo et al. 的第二层 depth MPE 为 1.139,Tulsiani et al. 为 1.582,本文在遮挡后的第二层上优势更明显。
这张表同时解释了模块分工:加入 class scores 后第一层 depth MPE 从 0.551 降到 0.508,说明语义先验能够帮助物体补全;继续加入 perceptual loss 和 (L_{\text{recompose}}) 后,完整模型进一步降到 0.473,并使第二层 depth MPE 达到 0.641。也就是说,类别信息主要解决"补成什么物体",re-composition 则进一步约束"这些物体在全局场景里应该处于什么深度"。
5.3 Stanford 2D-3D:真实场景中的表现
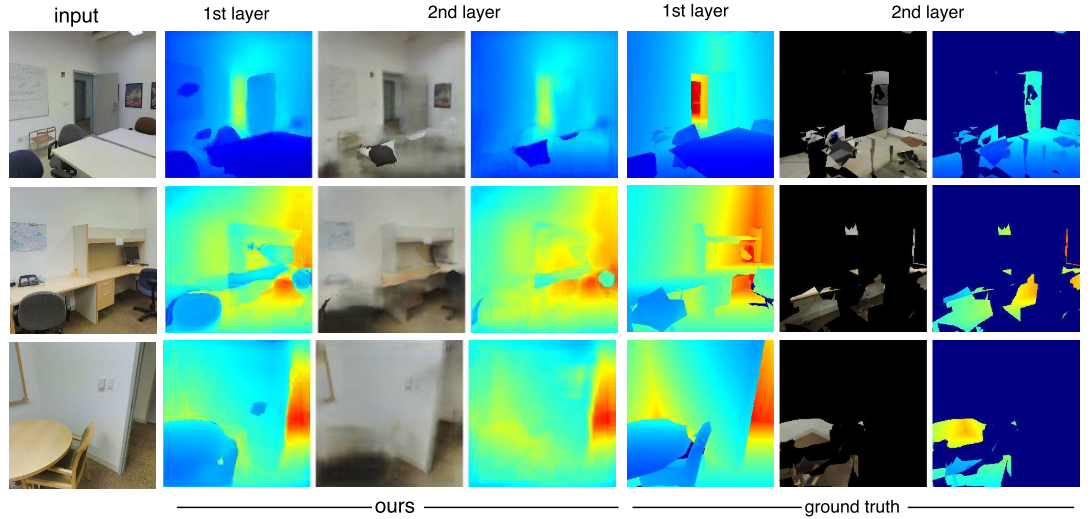
论文 Figure 5:Stanford 2D-3D 上前两层 LDI 预测
Figure 5 同时暴露了真实 mesh 数据的问题:第二层 Ground Truth 中存在明显 information hole,因此作者只在有有效真值的区域计算误差。
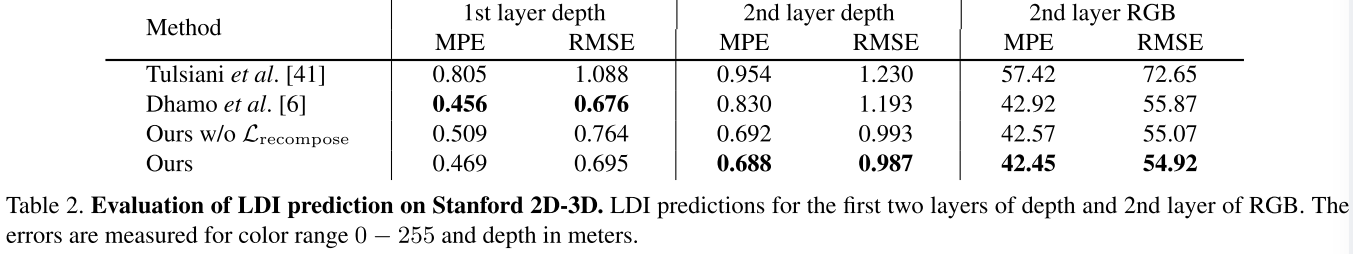
论文 Table 2:Stanford 2D-3D 上 LDI Prediction 对比
完整模型的第二层 depth MPE/RMSE 为 0.688/0.987 ,第二层 RGB 为 42.45/54.92,均优于两种基线;但第一层 depth 上 Dhamo et al. 的 0.456/0.676 略优于本文的 0.469/0.695。作者将这一差异与真实 mesh 的 holes 以及 missed detections 联系起来,因此结论应限定为:本文的主要优势集中在真正需要恢复遮挡内容的第二层,而不是所有指标都领先。
5.4 View Synthesis 与 Object Removal
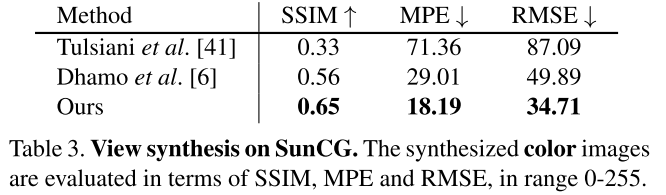
论文 Table 3:SunCG 上 View Synthesis 定量结果
本文的新视角结果达到 SSIM = 0.65、MPE = 18.19、RMSE = 34.71;Dhamo et al. 为 0.56、29.01、49.89,Tulsiani et al. 为 0.33、71.36、87.09。说明更准确的遮挡层可以直接转化成更好的 novel-view rendering。
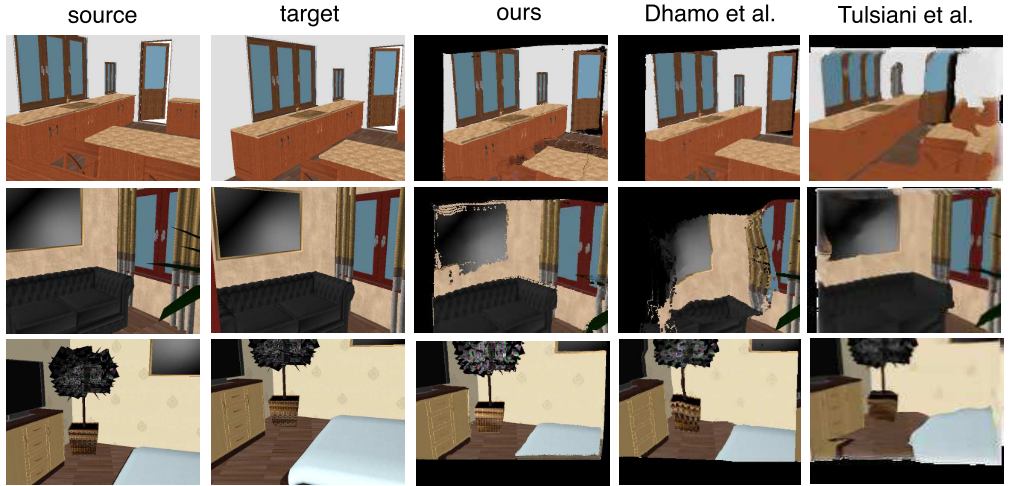
论文 Figure 7:不同方法的 View Synthesis 可视化对比
Figure 7 可以看到 object-wise depth 带来的更清晰目标边界。视角变化时,被遮挡区域需要从后续层填补,边界越模糊,warping 后越容易出现缺口和形变。
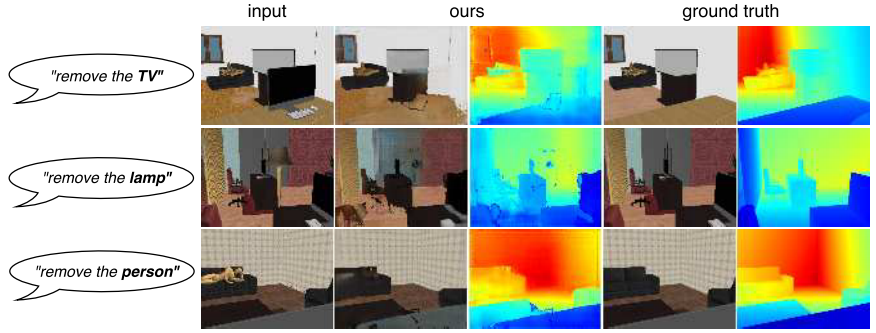
论文 Figure 6:指定类别 Object Removal 结果
Figure 6 展示 "remove the TV"、"remove the lamp" 和 "remove the person"。由于每个 object 本来就是独立层,移除指定对象后,可以直接由后方 object/layout layer 补上原本被遮挡的区域。这里说明 View Synthesis 和 Object Removal 并不是两个额外训练任务,而是同一种 object-driven layered representation 自然支持的应用。
六、总结与思考
如果把本文压缩成一句话,可以概括为:
与其直接预测固定数量的"前景/背景层",不如先恢复每个物体和场景布局的完整 RGBA-D,再根据深度关系动态组织成多层场景。
核心贡献并不只是"层数更多",而是把 instance semantics、occlusion completion 和 scene geometry 放进同一个表示:Network A 根据 mask 与类别先验补全被遮挡物体,Network B 恢复场景布局,MDP 与 re-composition loss 再确保这些独立结果能够在全局深度上重新组成原场景。
论文在结论中也指出了仍待改进的方向,包括让生成纹理更加清晰真实、在效率允许的情况下结合 global 与 local context,以及进一步利用目标之间的空间关系。
从方法设定上看,这篇工作的关键启发是:遮挡恢复并不只是"把看不见的像素画出来",还要回答这些内容属于哪个物体、处于哪一层,以及与其他物体有什么深度关系。 一旦表示层面把这些关系拆清楚,新视角合成和目标移除就都可以成为同一场景表示上的自然操作。