给搜索的法规条文做了个「版本核验」流程:怎么确认手上的条文还是现行有效版
由于职业特点,做数据合规的时候,我经常要脱敏、要引法条,但法律法规大部分都是公开的,也没有必要专门花钱去买专业数据库、API。AI时代,可以说找法条更容易了,用workbudy直接给查法条的指令就行。大家都知道网络信息鱼龙混杂、尤其是AI自动生成又加剧了噪音。就这事,多用几次就出现了痛点:1.同一份法条,从不同网站复制来的版本,条号是不一样的;2.非权威版本的法条,在转载的过程中存在转译的现象,并一定是原文口径;3.AI幻觉有时也会存在误搜集;4.每次问AI,要保证准确要一套提示词、还可能要多轮对话,效率可以再提升。
最严重的一次,我手上有一份被大量转载的《网络安全法》文本,看起来格式干净、章节完整、条号连续,拿去用之前我照例做了核验------结果发现它引用的条号是修正前的旧号。修正之后新增了条款,后面所有条号都往后挪了,但那些转载版没跟着改。
这些文本在网上躺着,被无数人复制到自己的合规文档里。不是「有点过时」,是结构性地错了,而错误藏在最不容易被肉眼发现的地方------一句「本法第X条」的引用里。
这件事之后,我就想着做个skill,利用workbuddy把这个流水线搭起来。
一、三类处理形态
AI通过网络搜索回来"疑似法条"的文本,形态其实很杂:
| 输入类型 | 典型来源 | 问题 |
|---|---|---|
| 二手转载版 | 地方政府网站、公众号推文、律所文章 | 条号可能停在旧版本,格式还很干净 |
| 开源库采集版 | GitHub 上的法规数据仓库 | 全文齐备,但字段混乱、部分缺条 |
| 官方公报 PDF | gov.cn 政策库、公报 | 最权威,但竖排扫描件抽文字会乱码 |
| 国标 | 全国标准平台 | 性质完全不同,是另一个法律问题(后面第五节单说) |
第一类是最危险的。因为「看起来最像真的」------排版整齐、条号连号、没有任何可疑标记。人对它的信任度天然最高,而它恰恰错得最系统。
我定的输入判定标准是:凡是要写进正式合规文档的条文,一律视为"待核验",不管它从哪来。 包括从我上次自己存的文档里复制出来的。
法律、法规不受著作权法保护,条文是可以自由引用和转载的。被转载 ≠ 是最新版。这两件事完全解耦,但人的直觉会把它们绑在一起。
二、我是怎么让 WorkBuddy 把原文找齐的
AI 一次搜索给回来的东西,质量很不稳定。所以我不让它"搜到什么用什么",而是按权威性分了四路去取,互相兜底:
| 管线 | 定位 | 覆盖范围 | 速度 |
|---|---|---|---|
| A. 开源结构化库 | 全文获取首选 | 法律 448 + 行政法规 727,条文级 JSON | 速度特别快、基本就是秒级 |
| B. 官网公开重采 | 全层级兜底 | 全部(含部门规章) | 有点慢,需要逐站 HTML 解析、烧token |
| C. 北大法宝 MCP | 只做核验,不做批量 | 法律/行政法规/部门规章/司法解释 | 实时,权威,是我这套流程里唯一的付费数据源(不接也能跑,只是争议条文要人工去查) |
| S. 国标管线 | 检索 + 元数据 | 全国标准平台 JSON 接口 | 检索秒级 |
这个分工解决的是"AI 一次搜索不够可信"的问题。真正撑住质量的是两点:
第一,同一个条文必须有两个来源。 北大法宝是条文级的、一次只能取一条,平台也不允许我批量拿。所以我把它当"裁判"用,不当"资料库"用------只在有争议的时候,去取那一条权威原文来定性。大量文本还是走开源库那条快路。
第二,两个来源不一致的时候,不是简单"以法宝为准",而是先弄清楚开源库错在哪。 因为不改错的地方、只改对的地方,核验结论才敢用。
除此之外,还有一条只在修正版法律时才用的专项检查(见第四节),它是整套流程里最容易被漏掉、但恰恰最关键的一步。
我还给自己定了条规矩:每一步没拿到结果,都要说清楚为什么没拿到、实际是从哪拿到的。 拿到什么就说什么,不许悄悄糊过去。
三、技能会实际跑一遍的五个步骤
第 1 步:先把"是哪一版"说清楚
第 2 步:取原文,每份都带上来源
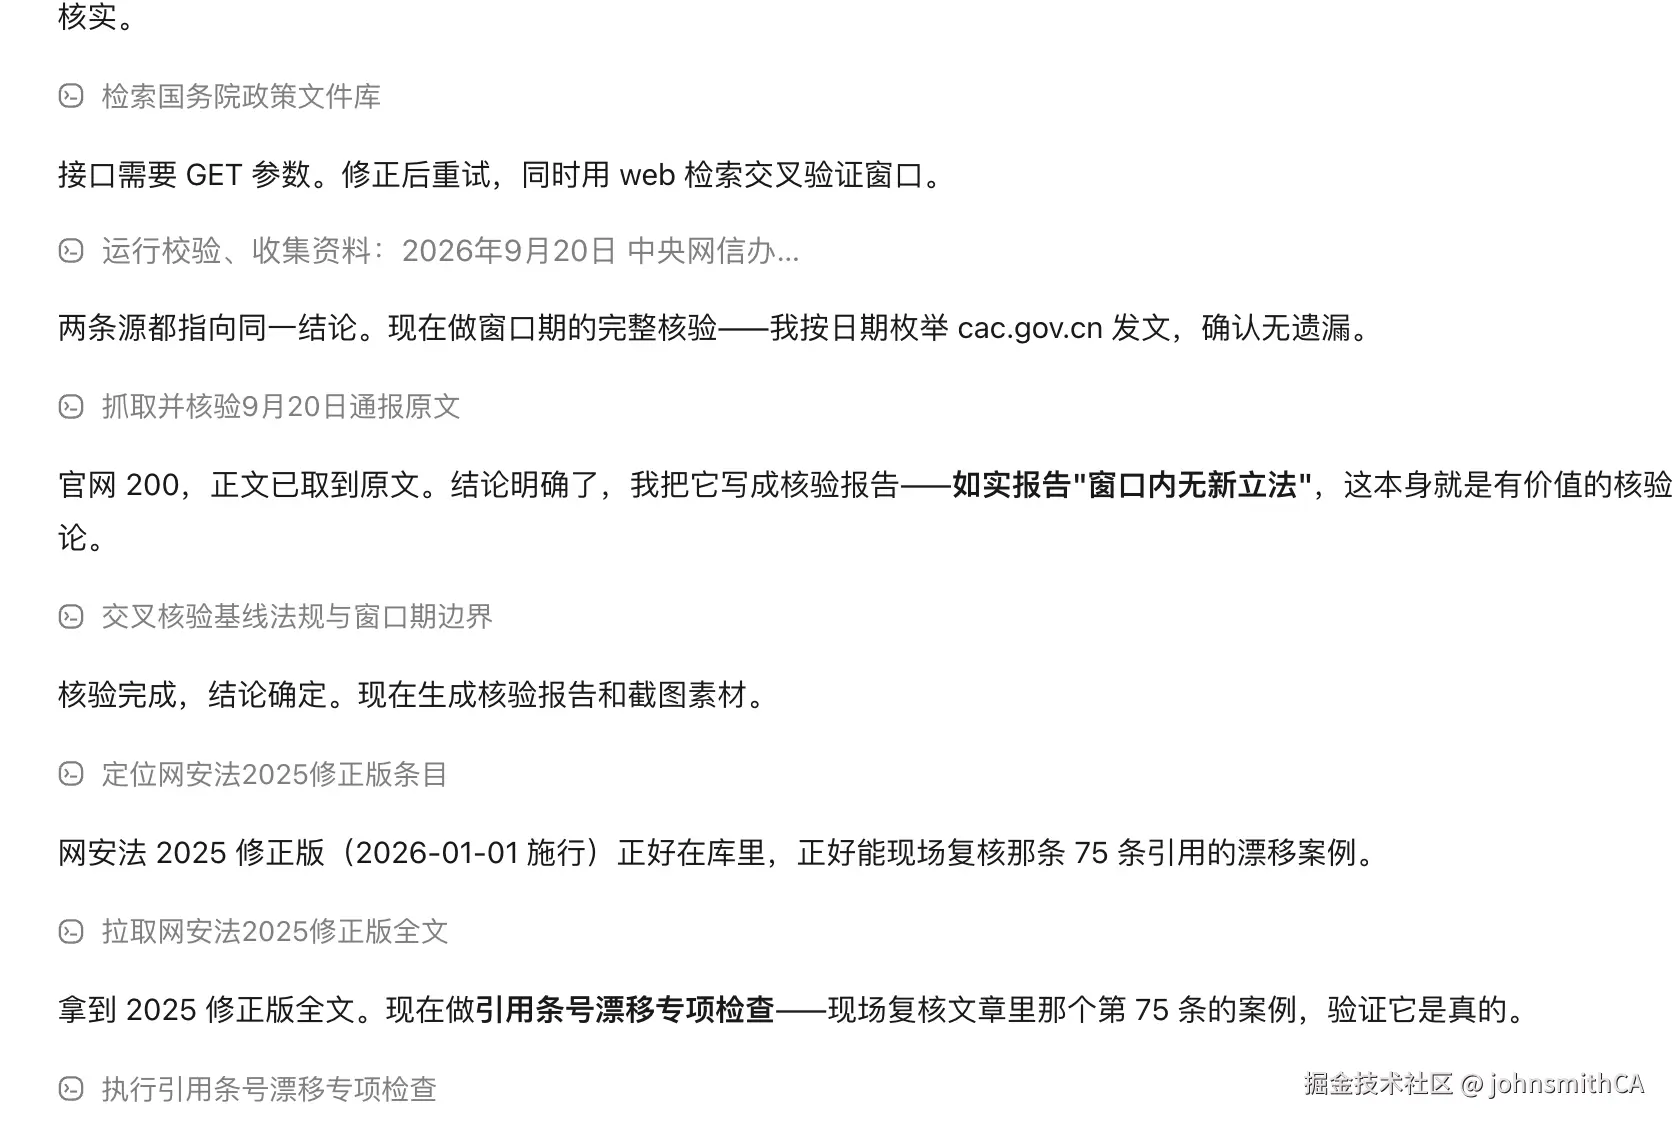
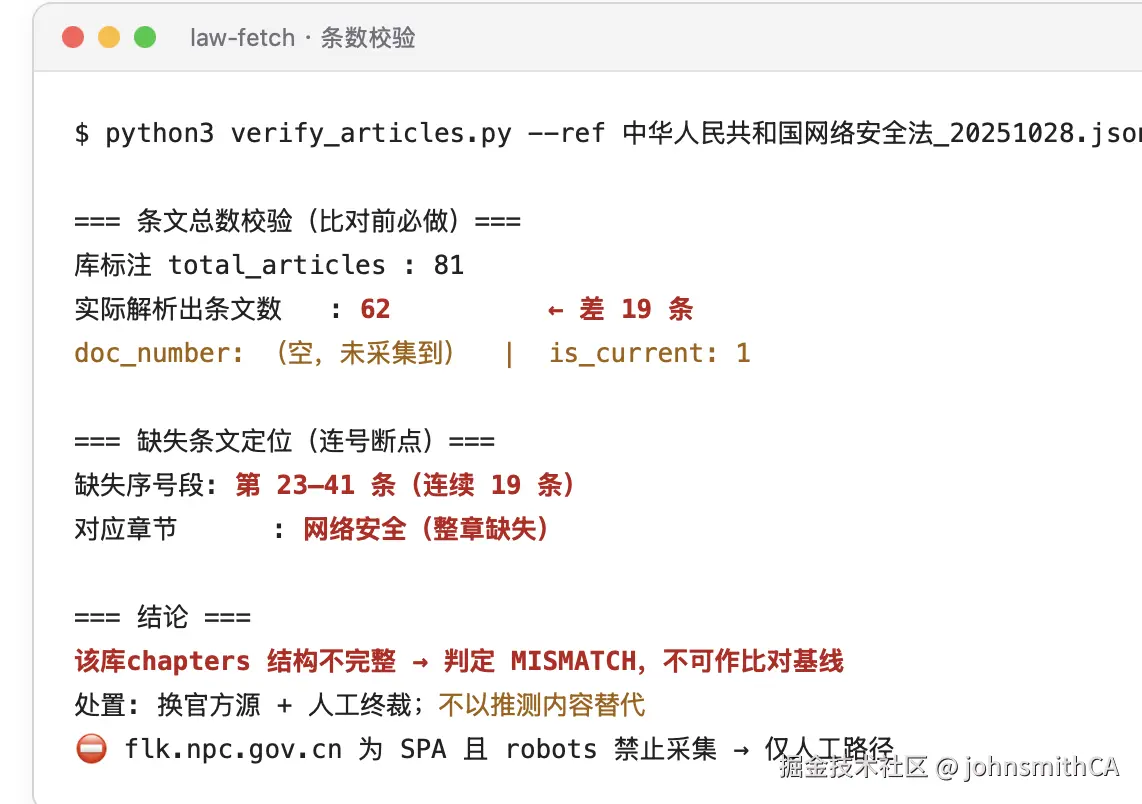
其中更要紧的检查:比之前先数一下条文条数,跟官方公布的条数对一对。我最近一次核验就靠这道防线抓到问题:拉《网络安全法》2025 修正版当比对基线,库自己标的是 81 条,实际解析出来只有 62 条------少的是第 23 到 41 条,整整 19 条连续缺失,正好是「网络安全」那一整章。
这里踩过一个坑:一开始我图省事,比对时用了一种"全文转纯文本"的口径,结果每条文后面都粘着章节标题,比出来的差异一大半都是这种假差异。改成按结构拆开、再比,才对得上。
这类缺条最阴的地方在于:如果我图省事先拿它跑比对,缺失的 19 条永远不会被发现有问题。残缺文本和正确文本在比对结果里长得一模一样,都是"无差异"。所以这个数不是白数的------没差异和是一回事,缺东西和内容对是另一回事。
第 3 步:逐条比,不抽样
为什么不抽样? 因为条号漂移是成片出现的,不会只错一处。随手抽十处,很可能十处都"看着正常"------因为漂移一般只发生在中间偏后的位置,抽样十有八九抽不到。
为什么要先把标题行剥掉再比? 不剥会产生大量假差异。假差异一多,真差异就淹没了。比对这件事的敌人不一定是数据错,很可能是噪音。
第 4 步:查"引用条号"有没有跟着漂(修正版必做)
这是我在网安法那次真正学到的。
修正一部法律有两种可能:改的是条文内容 ,或者改的是条文数量 。后者一旦发生,后面所有条号都整体位移,于是所有「本法第X条」的引用都可能失效------而这部分错误在全文比对里完全看不出来,因为比对只会告诉你「第75条的正文和第75条不一样」,它不知道第75条里那句「依照本法第三十条」指的到底是哪个 30 条。
具体到那次:网安法 2025 修正新增了 2 条,导致原第 75 条引用的「第三十条」,实际应该是「第三十二条」。差 2 个条号,肉眼扫过去根本不会发现。
第 5 步:有争议的,去问权威,然后出报告
比对出来的差异,不等于就是错------格式、排版差异可以忽略,内容错了就必须改。所以每一条差异我都去北大法宝取一次权威原文来定性,附上可溯源链接,然后才写进报告。这一步不能省:一段有差错的条文,你不能靠"我觉得它应该没问题"就放过去。
四、产出核验报告
最终产出是 核验报告.md,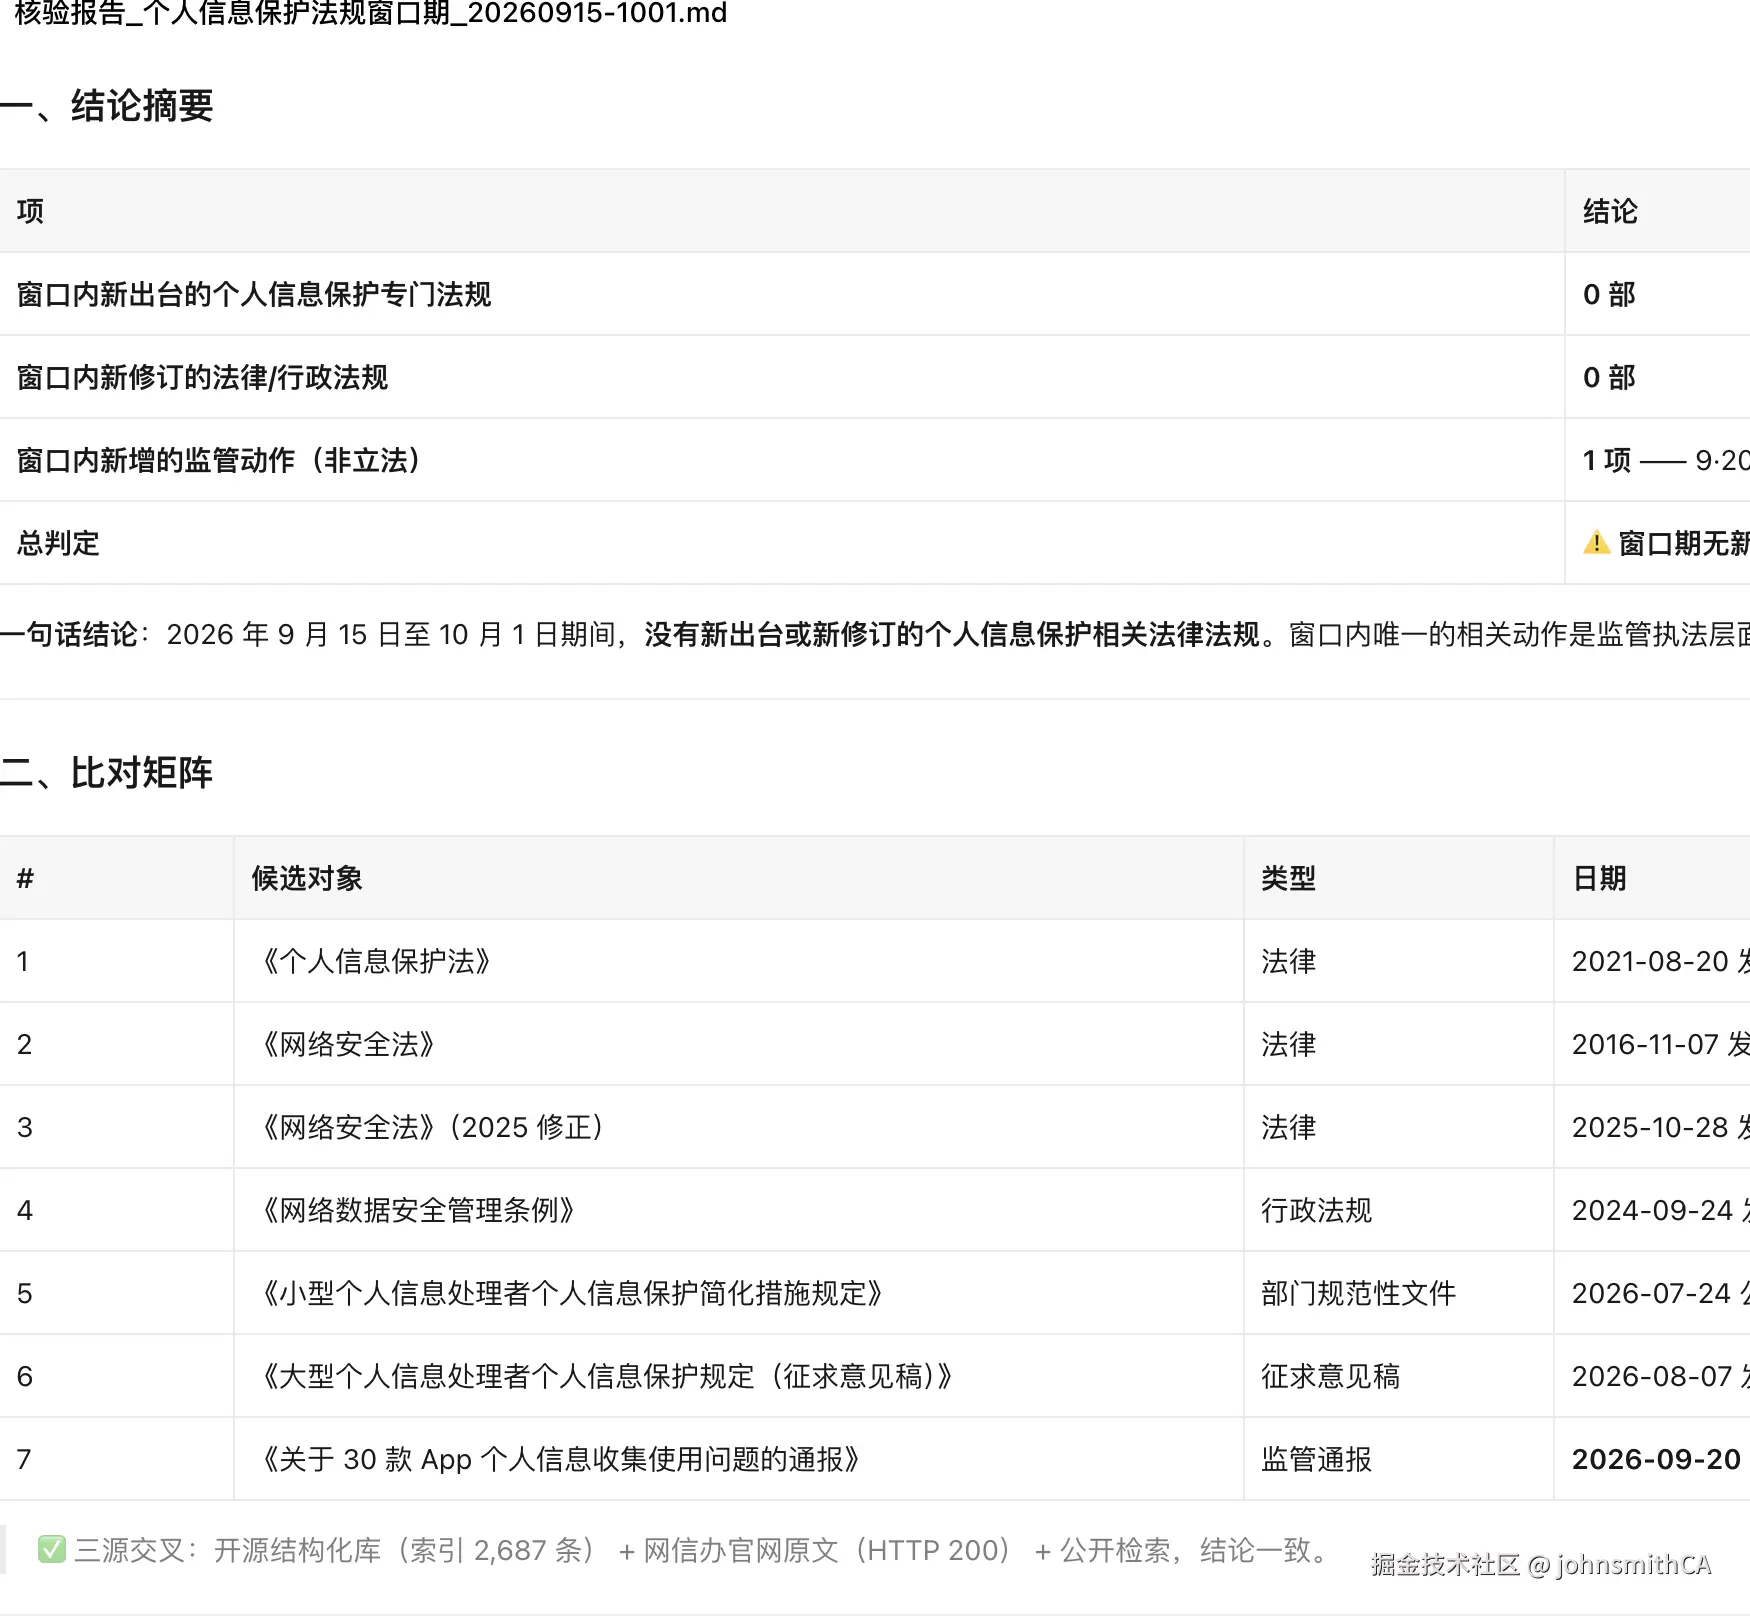 核心是一张比对矩阵(法规 × 来源 × 结论)加差异裁决记录。矩阵的形态大概是这样:
| 法规 | 来源 | 条文数 | 结论 | 关键差异 |
|---|---|---|---|---|
| 《网络安全法》(2025修正) | 二手转载版 | 与官方一致 | MISMATCH | 6 处交叉引用条号未随修正更新 |
| 《网络安全法》(2025修正) | 开源库采集版 | 与官方一致 | DIFF | 第75 条引用号正确,格式需重建 |
| 《数据安全法》 | 开源库采集版 | 一致 | PASS | --- |
我坚持在结论里区分三档,而不是笼统的"通过/不通过",因为:
- PASS = 逐字一致,可以直接引用
- DIFF = 有差异但核实为无害(格式、排版),内容可用
- MISMATCH = 内容性错误,禁止直接引用,必须先修正
产出物还必须带两样东西:核验日期 和来源清单。法规会变,同一份报告今天有效不代表下周有效------没有日期的核验报告,价值接近于零。
五、一个我特意让AI停下来没做的事,做数据合规,工具也要首先依法守法
本人法治素养要求这条还是必须单独讲,因为这是法规工作里最容易踩、也最容易被炫技冲动掩盖的坑。
国家标准分两种,法律地位完全相反,国家标准中,强制性标准因具法规性质依《著作权法》第五条不受保护、推荐性标准受著作权法保护,采标ISO/IEC者还须叠加国际组织版权限制。
我一度想在程序化拿不到的时候去找第三方镜像绕行。这个念头本身就是错的 ------官方预览页"正文异步加载、防下载"不是待攻破的技术障碍,它就是版权保护措施本身。程序化拿不到 ≠ 可以另找地方拿。GB/T 的合规路径只有人工预览 + 元数据 + 购买正版这三条,没有第四条。
顺带说,法规工作里另有一条纯技术性但同样要守的边界:国家法律法规数据库(flk.npc.gov.cn)是权威性最高的官方库,但它没有公开接口,且 robots.txt 明文禁止自动化采集。程序化获取不要碰它。 它的正确用法是人工浏览器终裁---争议条文的最高可信度基准。央行网站也是同样的 Disallow: /。要不要采不采,是合规判断,不是技术难度问题。
六、怎么用
打开 workbuddy-专家·技能·连接器-搜技能,装技能、开通 mcp 连接器-对话框里直接提核验要求。
日常用起来跟在对话框里问法条没区别,只是多了一句"帮我核验一下是不是现行有效版"。就会把上面那五步走一遍,最后给一份三档结论的报告。
结语
做这套流程的出发点很小:我不希望自己写进合规文档的每一个条号,都要先在心里打个问号。上述均为本人实践完成。能力边界我也定的很清楚,有所为、有所不为,只是给普通人能用而不是试图替代专业工作。只做文本获取与正版性核验 ,不提供法律意见、不做法律判断。碰到具体的法律适用问题,得去找线下执业律师。AI 生成内容仅供参考,不构成且不能替代律师等专业人士的意见。
这套核验流程已经封装成一个可复用的技能,需要的同学可以评论区交流,我看到会回。
#WorkBuddy #AI办公